Computer Vision (CV)
Computer Vision (CV) ist das KI-Fachgebiet, das Maschinen ermöglicht, Bilder und Videos zu interpretieren. Hier geht es um die Funktionsweise, zentrale Aufgaben, Anwendungen und Herausforderungen.
Computer Vision (CV) ist der Bereich der künstlichen Intelligenz (KI), der es Computern ermöglicht, Bilder, Videos und andere visuelle Daten auszuwerten: Welche Objekte sind vorhanden? Wo befinden sie sich? Wie bewegen sie sich und was geschieht in einer Szene? Moderne Systeme lernen diese Fähigkeiten anhand von Beispielen. Ein mit Tausenden gelabelten Bildern trainiertes Modell lernt die visuellen Muster, die ein Auto, einen Riss oder einen Tumor kennzeichnen, und wendet sie auf bisher ungesehene Bilder an. Deshalb stützt sich das Fachgebiet heute auf maschinelles Lernen (ML) und vor allem auf Deep Learning (DL).
So funktioniert Computer Vision#
Für einen Computer ist ein Farbbild ein Raster aus Zahlen. Ein Foto mit 640×480 Pixeln enthält 921.600 Werte – je einen Intensitätswert von 0 bis 255 pro Pixel und für jeden der drei Farbkanäle. Eine Computer-Vision-Pipeline wandelt dieses Raster in fünf Schritten in eine Entscheidung um.
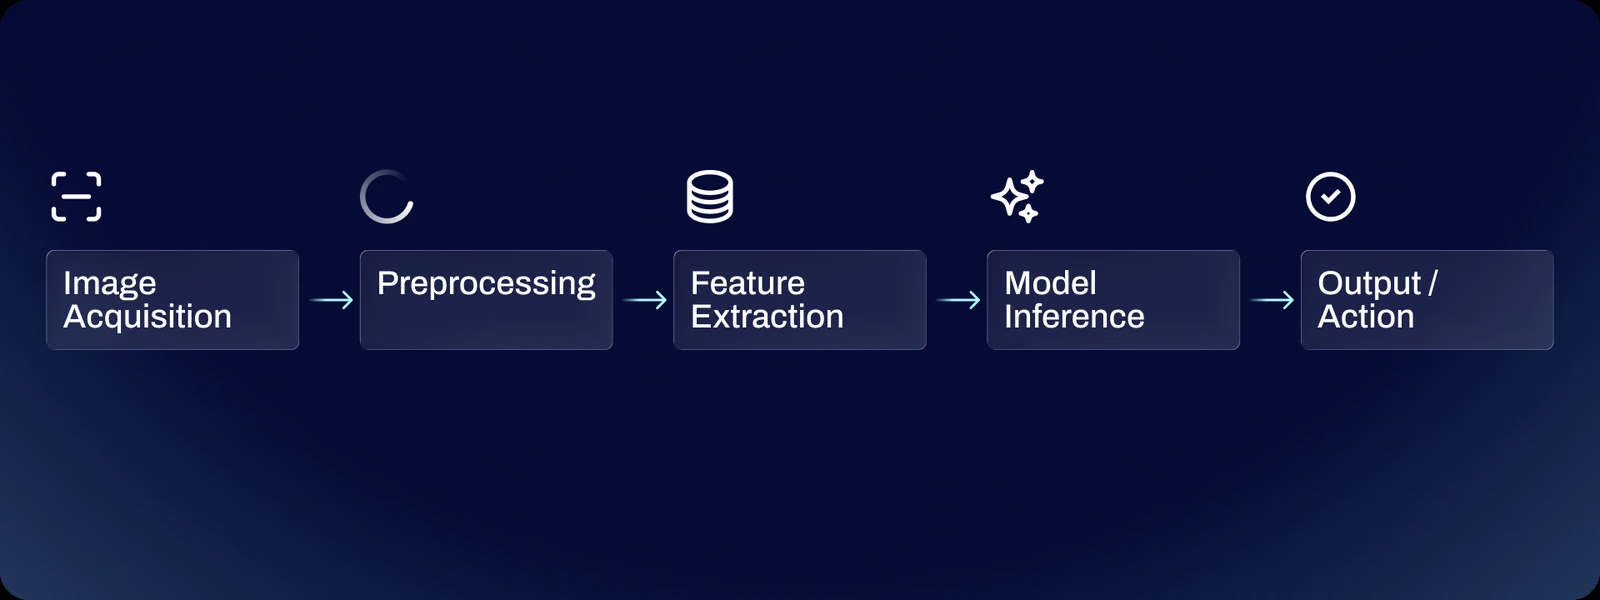
Eine Kamera oder ein Sensor nimmt das Bild auf. Die Vorverarbeitung, häufig mit OpenCV, passt Größe und Werte an, damit das Modell immer Eingaben im selben Format erhält. Anschließend führt das Modell die Merkmalsextraktion durch: Die frühen Schichten eines faltenden neuronalen Netzes (CNN) reagieren auf Kanten und Farbverläufe, mittlere Schichten kombinieren diese zu Texturen und Teilen, und tiefe Schichten reagieren auf ganze Objekte. Vision Transformer (ViTs) bilden ähnliche Repräsentationen, indem sie das Bild in Ausschnitte zerlegen und mithilfe von Selbstaufmerksamkeit jeden Ausschnitt mit allen anderen in Beziehung setzen. Ein aufgabenspezifischer Kopf wandelt die Merkmale in eine Ausgabe um, etwa ein Klassenlabel, eine Gruppe von Bounding Boxes oder eine Pixelmaske. Das umgebende System reagiert darauf, indem es beispielsweise ein fehlerhaftes Teil aussortiert, ein Fahrzeug abbremst oder einen Alarm auslöst.
Modelle lernen diese Merkmale durch überwachtes Lernen. Beim Training trifft das Modell Vorhersagen für gelabelte Bilder, eine Verlustfunktion misst die Abweichung jeder Vorhersage von der Grundwahrheit und die Rückpropagierung passt die Gewichte an, um diesen Fehler zu verringern. Große öffentliche Datensätze wie ImageNet mit über 14 Millionen gelabelten Bildern und COCO mit 80 alltäglichen Objektkategorien liefern die Vortrainingsdaten, auf denen die meisten benutzerdefinierten Modelle mithilfe von Transfer Learning aufbauen.
Von handgefertigten Merkmalen zu Deep Learning#
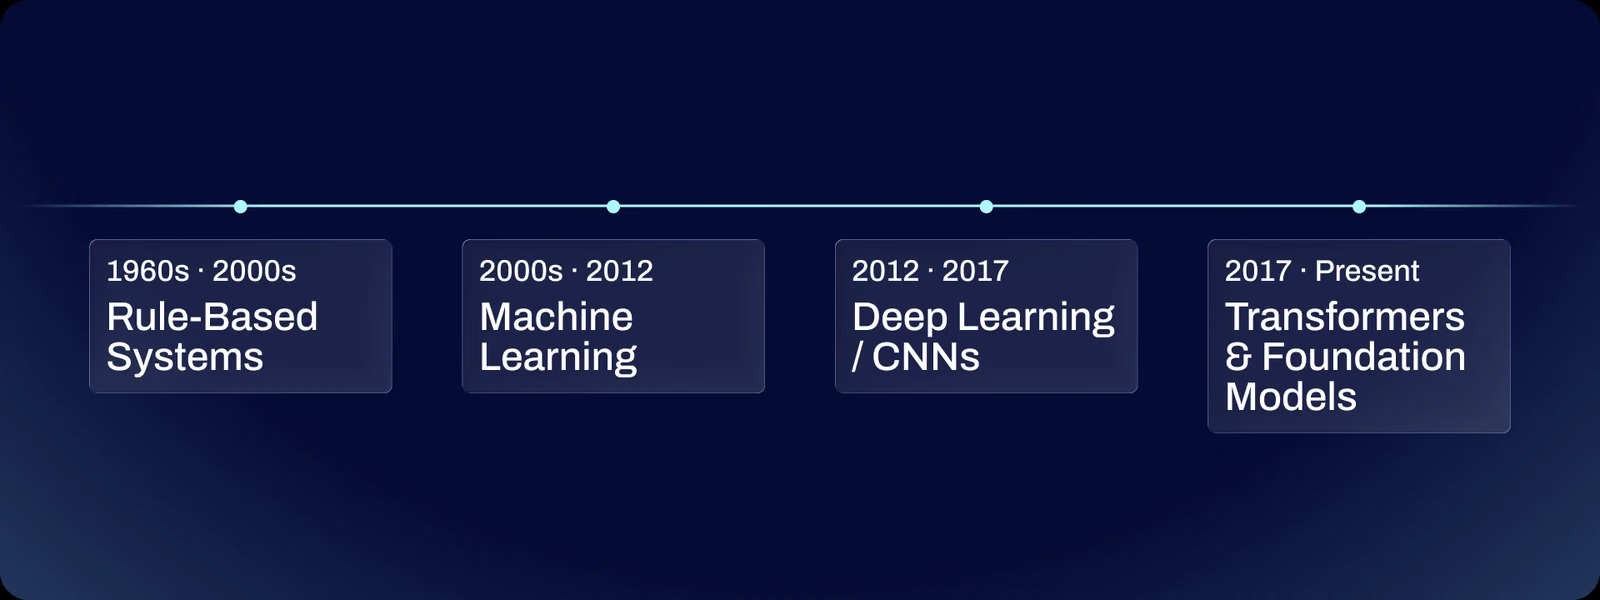
Frühe Computer Vision beruhte auf von Hand entwickelten Merkmalen. Ingenieurinnen und Ingenieure schrieben Detektoren für Kanten, Ecken und Gradientenmuster wie SIFT und HOG und übergaben diese Merkmale anschließend an einen Klassifikator. Die resultierenden Systeme versagten bei Änderungen von Beleuchtung, Blickwinkel oder Hintergrund. Der Wendepunkt kam 2012, als AlexNet die ImageNet-Herausforderung mit einer Top-5-Fehlerrate von 15,3 % gewann, verglichen mit 26,2 % für den nächstbesten Beitrag. Seitdem lernen CNNs und seit 2020 auch Vision Transformer ihre Merkmale direkt aus Daten. Vision-Language-Modelle (VLMs) kombinieren heute Bilder mit Text, sodass ein Modell offene Fragen zu einem Foto beantworten oder in einfacher Sprache beschriebene Objekte finden kann. Die VLM-Bestenliste misst, wie genau diese Modelle Objekte in realen Datensätzen erkennen.
Zentrale Aufgaben der Computer Vision#
Jede Aufgabe beantwortet eine andere Frage zu einem Bild:
- Objekterkennung: Findet jedes Objekt und zeichnet eine Box darum, ergänzt um eine Klasse und einen Konfidenzwert. So lassen sich Objekte zählen und lokalisieren.
- Instanzsegmentierung: Weist jedem Objekt eine eigene Pixelmaske zu, sodass zwei nebeneinanderstehende Personen getrennt bleiben.
- Semantische Segmentierung: Weist jedem Pixel eine Klasse zu, etwa Straße, Gehweg oder Himmel.
- Tiefenschätzung: Sagt anhand eines einzelnen Bildes voraus, wie weit jedes Pixel von der Kamera entfernt ist.
- Bildklassifizierung: Weist dem gesamten Bild ein einzelnes Label zu, etwa „fehlerhaft“ oder „in Ordnung“.
- Posenschätzung: Lokalisiert Keypoints wie Körpergelenke, um Haltung und Bewegung zu messen.
- Orientierte Bounding Boxes (OBB): Passt gedrehte Boxen an Objekte in beliebigen Winkeln an, etwa Schiffe und Flugzeuge in Satellitenbildern.
- Objektverfolgung: Verknüpft Erkennungen über Videobilder hinweg, sodass jedes Objekt eine einheitliche ID behält.
Die Auswahl einer Aufgabe richtet sich nach der Ausgabe, die die Anwendung benötigt:
Ultralytics YOLO26 deckt sieben dieser Aufgaben mit einer Python-API ab: Derselbe Aufruf YOLO() lädt ein Modell für Erkennung, Instanzsegmentierung, semantische Segmentierung, Tiefe, Klassifizierung, Posenschätzung oder OBB. model.track() ergänzt das Tracking von Videos. Dieses Beispiel führt auf einem Beispielbild eine Objekterkennung aus:
from ultralytics import YOLO

# Ein vortrainiertes YOLO26-Nano-Modell zur Objekterkennung laden
model = YOLO("yolo26n.pt")

# Inferenz für ein Beispielbild einer Straße ausführen
results = model("https://ultralytics.com/images/bus.jpg")
result = results[0]

# Die Anzahl erkannter Objekte pro Klasse ausgeben und das annotierte Bild speichern
print(result.verbose())
result.save(filename="bus_detections.jpg")
Die ausgegebene Zeile zählt die Erkennungen pro Klasse. Das gespeicherte Bild zeigt jedes erkannte Objekt mit seiner Box, seinem Label und seinem Konfidenzwert.
Computer Vision im Vergleich zu verwandten Fachgebieten#
- Bildverarbeitung: Wandelt ein Bild durch Schärfen, Entrauschen, Skalieren oder Anpassen des Kontrasts in ein anderes Bild um. Computer-Vision-Pipelines nutzen diese Verfahren zur Vorverarbeitung, bevor sie die Szene interpretieren.
- Maschinelles Sehen: der industrielle Einsatz von Computer Vision für Inspektionen und die Führung von Robotern, meist mit fest installierten Kameras, kontrollierter Beleuchtung und spezieller Hardware an einer Produktionslinie.
- Bilderkennung: ein gängiges Synonym für Bildklassifizierung, das manchmal ungenau für jede Aufgabe verwendet wird, bei der erkannt werden soll, was ein Bild enthält.
Anwendungen in der Praxis#
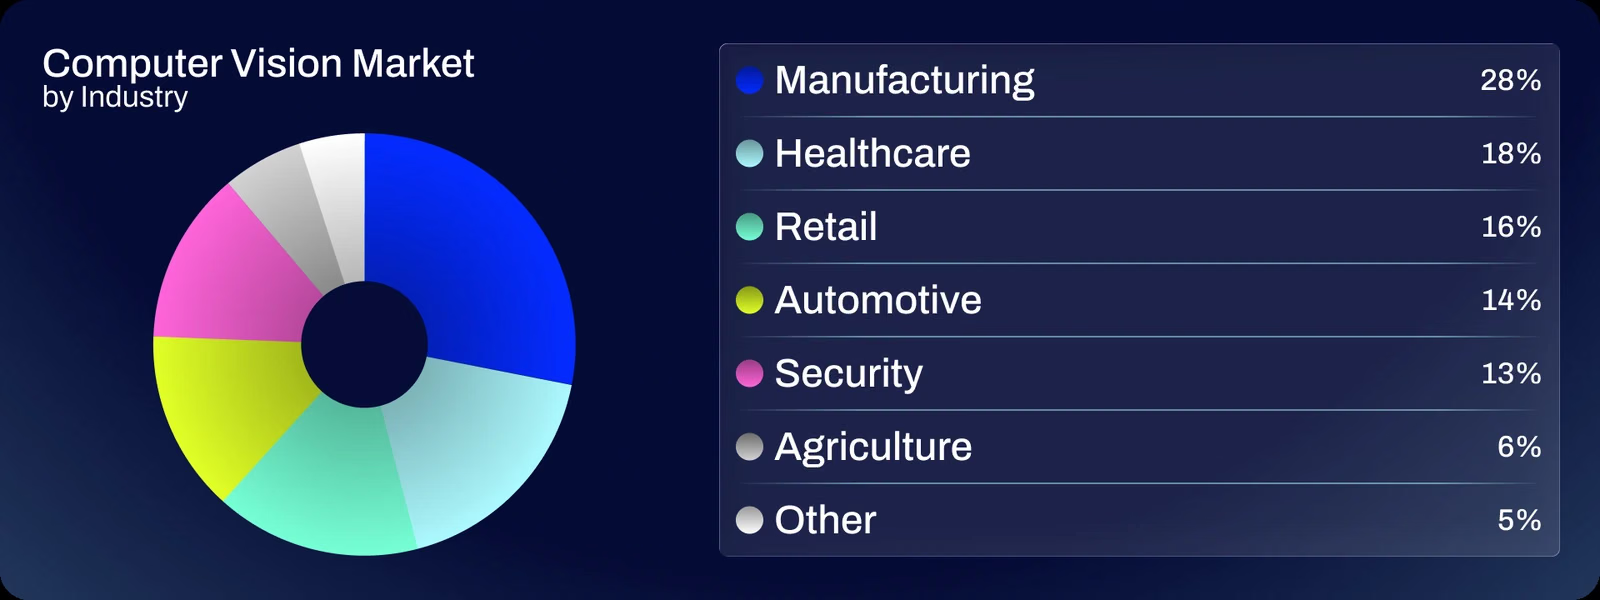
- Fertigung: Kameras prüfen jedes Teil bei voller Produktionsgeschwindigkeit auf Risse, Kratzer und falsch ausgerichtete Komponenten und überwachen den Verschleiß von Maschinen, bevor es zu einem Ausfall kommt.
- Medizinische Bildgebung: Modelle markieren Tumore, Frakturen und Netzhauterkrankungen auf Röntgen-, CT- und Netzhautaufnahmen, damit Radiologinnen und Radiologen sie überprüfen können.
- Autonome Fahrzeuge: Autos erkennen in Echtzeit Fahrspuren, Schilder, Fußgänger und andere Fahrzeuge und kombinieren Kameraausgaben mit Radar und LiDAR zu einem 3D-Modell ihrer Umgebung.
- Einzelhandel: Regalkameras erkennen leere Verkaufsflächen und falsch platzierte Produkte. Kassenlose Geschäfte verfolgen, welche Artikel Kundinnen und Kunden mitnehmen.
- Landwirtschaft: Drohnen und Sprühgeräte unterscheiden Pflanze für Pflanze Nutzpflanzen von Unkraut, sodass Herbizide und Dünger nur dort eingesetzt werden, wo sie nötig sind.
- Sicherheit und intelligente Städte: Systeme zählen Personen und Fahrzeuge, überwachen den Verkehrsfluss und nutzen die Anomalieerkennung, um ungewöhnliche Ereignisse in gesperrten Bereichen zu melden.
Herausforderungen und Einschränkungen#
Ein Modell ist nur so gut wie seine Trainingsdaten. Das Labeln von Daten, also das Zeichnen von Boxen oder Masken auf Tausenden von Bildern, erfordert oft mehr Aufwand als das Training des Modells selbst. Auch die Bedingungen ändern sich nach der Bereitstellung: Regen, Blendlicht, nächtliche Beleuchtung, Verdeckung oder eine versetzte Kamera verändern die Eingaben gegenüber den Trainingsdaten. Datenerweiterung simuliert solche Bedingungen während des Trainings. Die Validierung anhand zurückgehaltener Bilder erkennt Overfitting vor der Veröffentlichung.
Die Rechenleistung ist die nächste Einschränkung. Kameras, Drohnen und Smartphones führen Modelle mit knappen Leistungs- und Speicherbudgets aus. Daher setzen Edge-KI-Anwendungen auf kleine Modelle und Modellquantisierung, um Echtzeitgeschwindigkeit zu erreichen, ohne Videos in die Cloud zu übertragen.
Systeme, die Menschen analysieren, werfen Fragen zu Verzerrungen und Datenschutz auf. Ein Datensatz, in dem manche Gruppen unterrepräsentiert sind, führt zu einem Modell, das bei diesen Gruppen unterschiedlich gut funktioniert. Gesichts- und Körperdaten gelten in den meisten Datenschutzgesetzen als sensible personenbezogene Daten. Seit Februar 2025 verbietet der EU AI Act Strafverfolgungsbehörden die biometrische Fernidentifizierung in Echtzeit an öffentlich zugänglichen Orten. Ausgenommen sind eng begrenzte Fälle, etwa die Suche nach Entführungsopfern oder die Abwehr einer unmittelbar drohenden terroristischen Gefahr.









