Migliora la robustezza dei modelli di IA con l’augmentation dei dati
Scopri come aggiungere variazioni realistiche ai dati di training tramite l’augmentation aiuta a migliorare la robustezza dei modelli di IA e le prestazioni nel mondo reale.
 Abirami Vina10 min di lettura
I test sono una fase fondamentale nello sviluppo di qualsiasi soluzione tecnologica. Permettono ai team di capire come funziona davvero un sistema prima della sua messa in produzione e di correggere tempestivamente i problemi. Questo vale in molti settori, compreso quello dell'IA, in cui ci si aspetta che i modelli gestiscano le condizioni imprevedibili del mondo reale una volta messi in produzione.
Per esempio, la visione artificiale è un ramo dell'IA che insegna alle macchine a comprendere immagini e video. I modelli di visione artificiale come Ultralytics YOLO26 supportano attività quali il rilevamento degli oggetti, la segmentazione di istanze e la classificazione delle immagini.
Possono essere utilizzati in molti settori per applicazioni come il monitoraggio dei pazienti, l'analisi del traffico, il pagamento automatico e il controllo qualità nella produzione industriale. Tuttavia, anche con modelli avanzati e dati di addestramento di alta qualità, le soluzioni di IA visiva possono incontrare difficoltà di fronte a variazioni del mondo reale, come cambiamenti di illuminazione, movimento o oggetti parzialmente oscurati.
Questo accade perché i modelli apprendono dagli esempi forniti durante l'addestramento. Se non hanno già incontrato condizioni come riflessi, sfocatura dovuta al movimento o visibilità parziale, è meno probabile che riconoscano correttamente gli oggetti in questi scenari.
Un modo per migliorare la robustezza del modello è ricorrere all'aumento dei dati. Invece di raccogliere grandi quantità di nuovi dati, gli sviluppatori possono apportare modifiche contenute e significative alle immagini esistenti, per esempio regolando l'illuminazione, ritagliando o mescolando le immagini. Questo aiuta il modello a imparare a riconoscere gli stessi oggetti in una più ampia varietà di situazioni.
In questo articolo vedremo come l'aumento dei dati migliori la robustezza dei modelli e l'affidabilità dei sistemi di IA visiva quando vengono messi in produzione al di fuori di ambienti controllati. Iniziamo!
Come verificare la robustezza di un modello#
Prima di approfondire l'aumento dei dati, vediamo come capire se un modello di visione artificiale è davvero pronto per l'uso nel mondo reale.
Un modello robusto continua a funzionare bene anche quando le condizioni cambiano, invece di funzionare soltanto con immagini nitide e annotate alla perfezione. Ecco alcuni fattori pratici da considerare per valutare la robustezza di un modello di IA:
- Variazioni dell'illuminazione: i modelli possono comportarsi diversamente in presenza di luce intensa o fioca, riflessi o ombre, condizioni che possono influire sul livello di sicurezza del rilevamento degli oggetti.
- Occlusione parziale: nelle scene di tutti i giorni, gli oggetti sono spesso coperti da altri elementi o risultano visibili solo in parte. Un modello più robusto riesce a riconoscerli anche quando le informazioni visive sono incomplete.
- Scene affollate: gli ambienti con molti oggetti sovrapposti possono rendere più difficile il rilevamento. I modelli che funzionano bene in questi casi sono generalmente più affidabili in contesti complessi.
Buoni risultati su immagini nitide e acquisite alla perfezione non garantiscono prestazioni elevate nel mondo reale. Test regolari in condizioni diverse aiutano a capire quanto regge un modello una volta messo in produzione.
Che cos'è l'aumento dei dati?#
L'aspetto di un oggetto in una foto può cambiare in base all'illuminazione, all'angolazione, alla distanza o allo sfondo. Perché un modello di visione artificiale addestrato funzioni bene in ambienti imprevedibili, il dataset da cui apprende deve includere questo tipo di variazioni.
L'aumento dei dati amplia un dataset di addestramento creando esempi aggiuntivi a partire dalle immagini già disponibili. Per farlo si applicano modifiche intenzionali, come ruotare o capovolgere un'immagine, regolarne la luminosità o ritagliarne una parte.
Per esempio, immagina di avere una sola foto di un gatto. Ruotando l'immagine o modificandone la luminosità, puoi creare diverse nuove versioni a partire da quella foto. Ogni versione appare leggermente diversa, ma raffigura comunque lo stesso gatto. Queste variazioni aiutano il modello a imparare che un oggetto può avere aspetti diversi pur restando lo stesso.
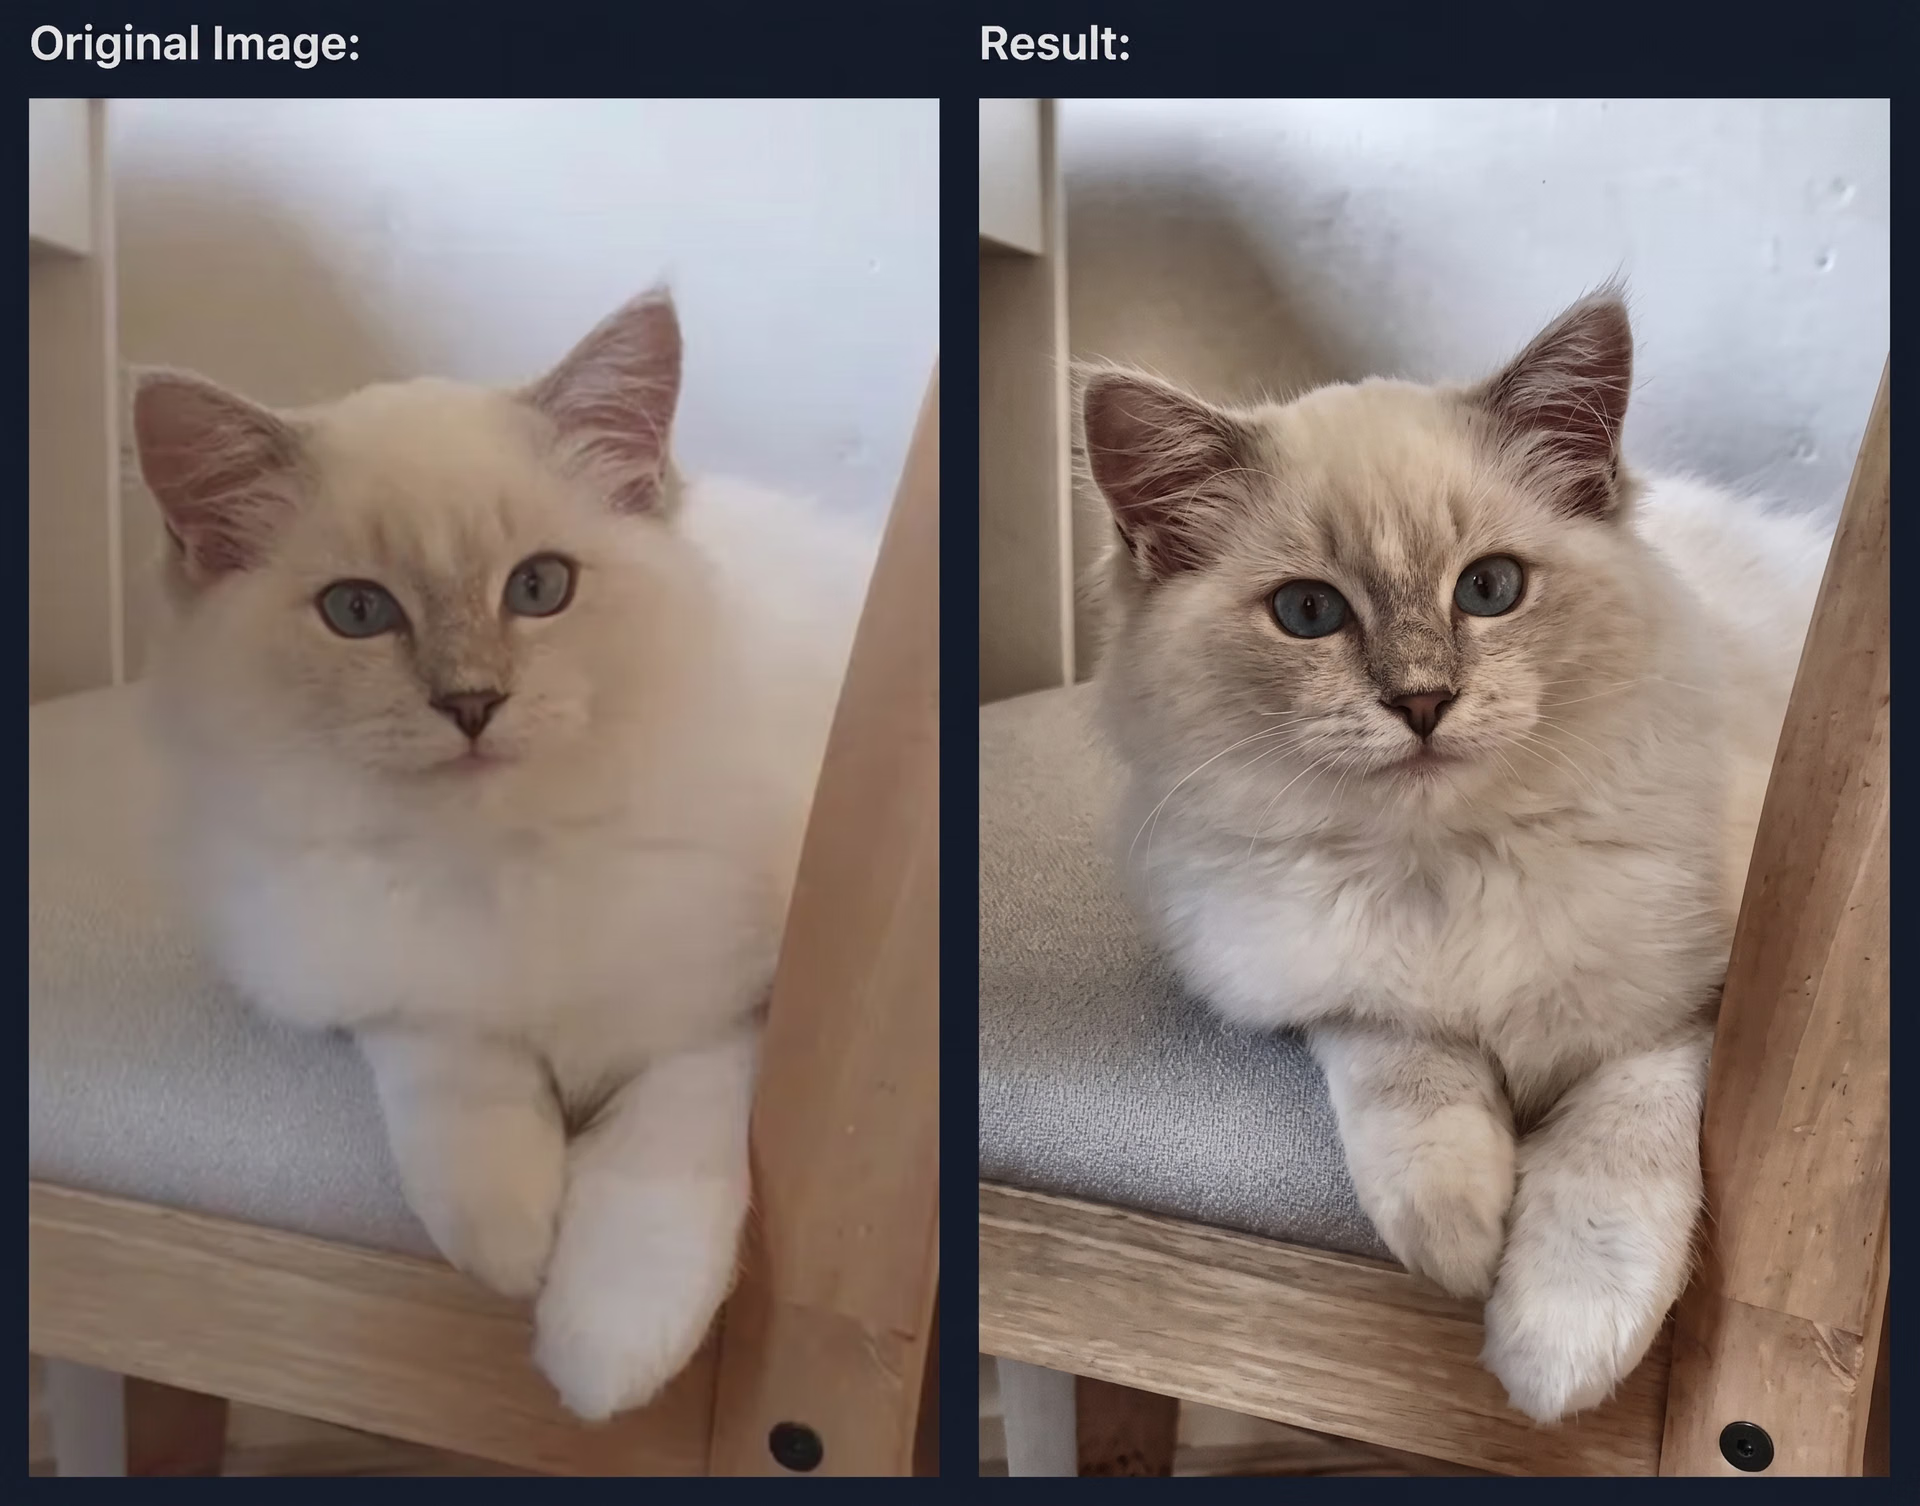
Fig. 1. Esempio di aumento dei dati su un'immagine di un gatto (Fonte)
Come l'aumento dei dati migliora le prestazioni del modello#
Durante l'addestramento del modello, l'aumento dei dati può essere integrato direttamente nella pipeline di addestramento. Invece di creare e archiviare manualmente nuove copie delle immagini, si possono applicare trasformazioni casuali man mano che ciascuna immagine viene caricata.
Questo significa che il modello vede ogni volta una versione leggermente diversa dell'immagine, più luminosa, capovolta o parzialmente nascosta. Tecniche come la cancellazione casuale possono persino rimuovere piccole aree dell'immagine per simulare situazioni reali in cui un oggetto è coperto o solo parzialmente visibile.
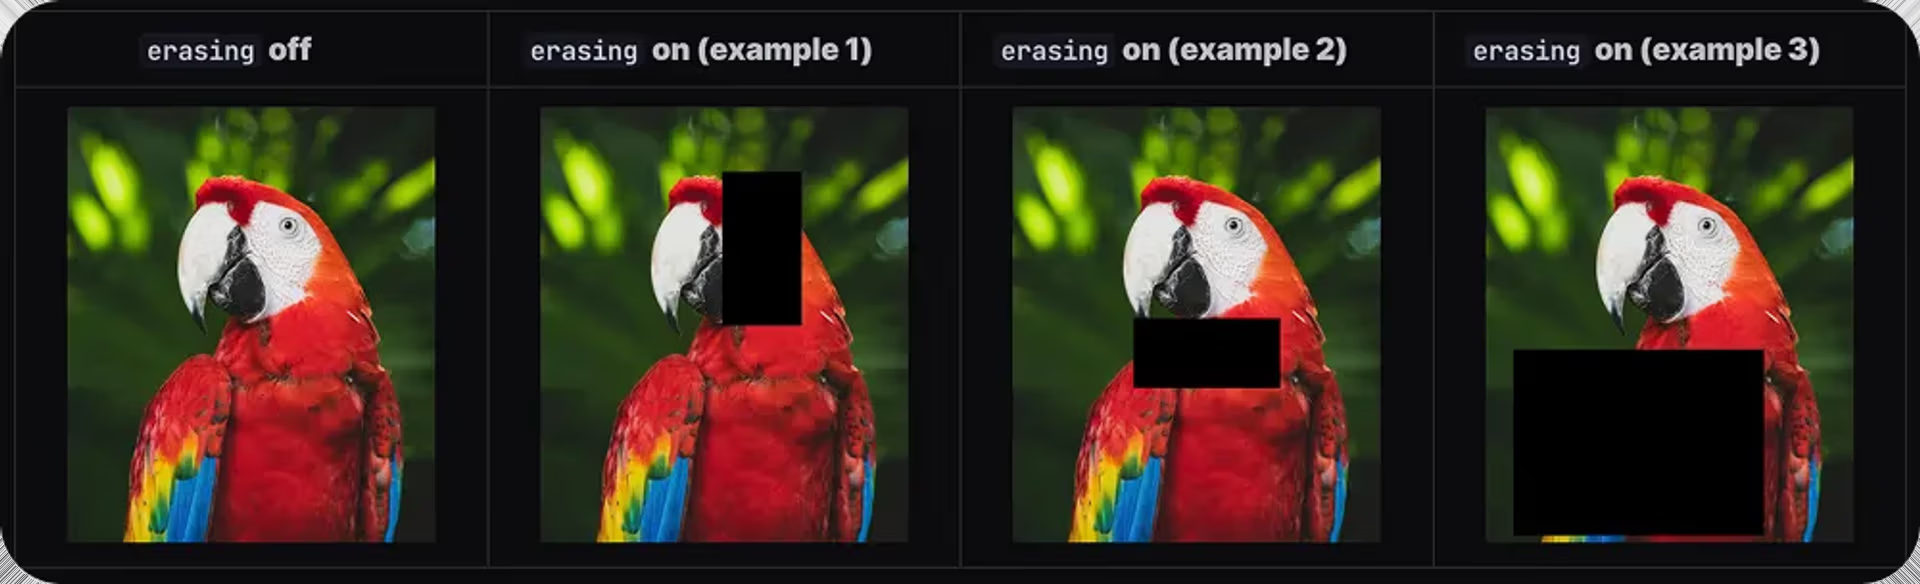
Fig. 2. Esempi di aumento dati con cancellazione casuale (Fonte)
Osservare molte versioni diverse della stessa immagine permette al modello di imparare quali caratteristiche sono importanti, invece di dipendere da un unico esempio perfetto. Questa varietà rende il modello di AI più robusto, affinché possa funzionare in modo più affidabile nelle condizioni del mondo reale.
Tecniche comuni di aumento dei dati#
Ecco alcune tecniche di aumento dei dati usate per introdurre variazioni nelle immagini di addestramento:
- Trasformazioni geometriche: queste tecniche modificano la posizione spaziale di un oggetto all'interno di un'immagine. Ruotare, capovolgere, ridimensionare, ritagliare o spostare un'immagine permette al modello di capire come si può osservare un oggetto da angolazioni o distanze diverse.
- Regolazioni di colore e illuminazione: nel mondo reale l'illuminazione è raramente uniforme. A seconda dell'ambiente o della fotocamera usata, le immagini possono essere troppo luminose, troppo scure o presentare leggere variazioni di colore. Regolare luminosità, contrasto, tonalità e saturazione permette ai modelli di gestire questi cambiamenti visivi e di funzionare bene in scene diverse.
- Variazioni della qualità dell'immagine: la sfocatura o il rumore visivo possono rendere le immagini poco nitide. Aggiungere sfocatura o rumore durante l'addestramento aiuta il modello a gestire la sfocatura da movimento, le immagini con poca luce o i risultati di qualità inferiore delle fotocamere, rendendolo meno sensibile alle imperfezioni visive.
- Aumenti basati sull'occlusione: negli ambienti reali, spesso altri oggetti ne nascondono parzialmente alcuni. Questo fenomeno è detto occlusione. Nascondere o mascherare piccole aree di un'immagine durante l'addestramento aiuta il modello a imparare a rilevare gli oggetti anche quando ne è visibile solo una parte.
- Aumenti con più immagini: queste tecniche combinano parti di più immagini in un unico esempio di addestramento, aumentando il numero di oggetti visibili e migliorando la capacità del modello di gestire scene complesse o affollate.
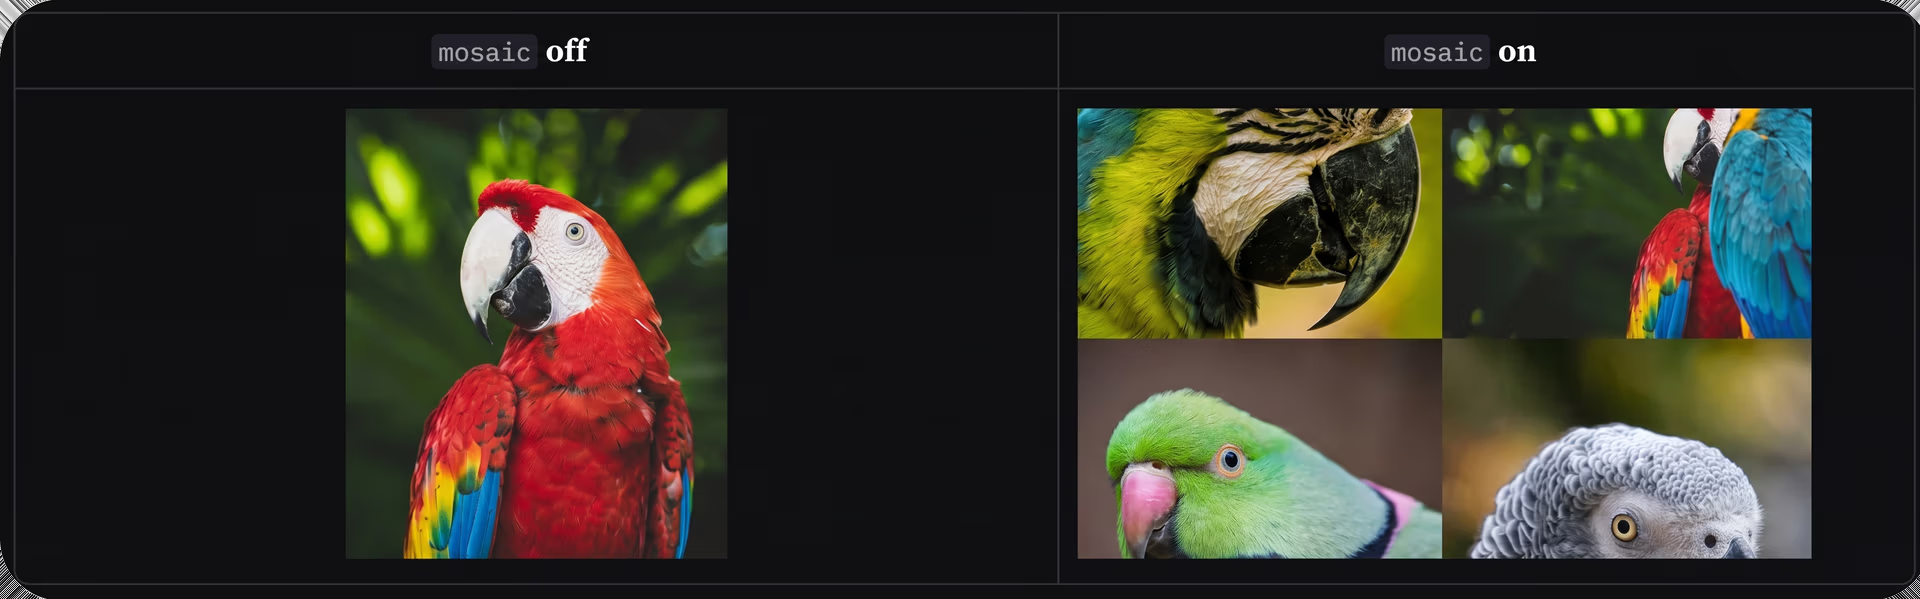
Fig. 3. Esempio di aumento con più immagini (Fonte)
Aumento dei dati semplificato con il pacchetto Python di Ultralytics#
Gestire i dataset, creare varianti delle immagini e scrivere codice per le trasformazioni può aggiungere passaggi allo sviluppo di un'applicazione di computer vision. Il pacchetto Python di Ultralytics semplifica il processo offrendo un'unica interfaccia per addestrare, eseguire e distribuire i modelli Ultralytics YOLO, come YOLO26. Per semplificare i flussi di lavoro di addestramento, il pacchetto include funzionalità integrate di aumento dei dati, testate da Ultralytics e ottimizzate per i modelli YOLO.
Supporta anche utili integrazioni che eliminano la necessità di strumenti separati o codice personalizzato. In particolare, per l'aumento dei dati, il pacchetto si integra con Albumentations, una libreria di aumento delle immagini ampiamente utilizzata. Questa integrazione consente di applicare automaticamente gli aumenti durante l'addestramento, senza bisogno di script aggiuntivi o codice personalizzato.
Gestire annotazioni e dataset aumentati#
Un altro fattore che influisce sulla robustezza del modello è la qualità dell'annotazione. Etichette pulite e accurate, create e gestite con strumenti di annotazione come Ultralytics Platform o Roboflow, aiutano il modello a capire dove si trovano gli oggetti e che aspetto hanno.
Durante l'addestramento, gli aumenti dei dati, come capovolgimenti, ritagli e rotazioni, vengono applicati dinamicamente e le annotazioni vengono adattate automaticamente per corrispondere alle modifiche. Quando le etichette sono precise, il processo funziona senza intoppi e fornisce al modello molti esempi realistici della stessa scena.
Se le annotazioni sono imprecise o incoerenti, gli errori possono essere ripetuti nelle immagini aumentate, rendendo l'addestramento meno efficace. Partire da annotazioni precise impedisce che questi errori si propaghino e contribuisce a migliorare la robustezza del modello.
Potenziare le applicazioni di vision AI con l'aumento dei dati#
Vediamo ora alcuni esempi di come l'aumento dei dati contribuisce alla robustezza dei modelli di AI nelle applicazioni del mondo reale.
Migliorare la precisione del rilevamento degli oggetti negli ambienti reali#
Le immagini sintetiche vengono spesso usate per addestrare sistemi di rilevamento degli oggetti quando i dati reali sono limitati, sensibili o difficili da raccogliere. Consentono ai team di generare rapidamente esempi di prodotti, ambienti e angolazioni della fotocamera senza dover acquisire ogni scenario nella realtà.
Tuttavia, a volte i dataset sintetici possono apparire troppo puliti rispetto alle riprese del mondo reale, in cui l'illuminazione cambia, gli oggetti si sovrappongono e le scene contengono elementi di sfondo disordinati. L'aumento dei dati aiuta a colmare questa lacuna introducendo variazioni realistiche, come diverse condizioni di illuminazione, rumore o posizioni degli oggetti, affinché il modello impari a gestire le condizioni che incontrerà una volta distribuito.
Per esempio, in un recente studio, un modello Ultralytics YOLO11 è stato addestrato interamente su immagini sintetiche, con l'aggiunta di tecniche di aumento dei dati per introdurre ulteriori variazioni. Questo ha contribuito ad ampliare la capacità del modello di riconoscere gli oggetti. Il modello ha ottenuto buoni risultati nei test con immagini reali, pur non avendo mai visto dati del mondo reale durante l'addestramento.
Rendere più affidabili le soluzioni di diagnostica per immagini#
I dataset di diagnostica per immagini sono spesso limitati e le scansioni possono variare in base al tipo di apparecchiatura, alle impostazioni di acquisizione o all'ambiente clinico. Le differenze nell'anatomia dei pazienti, nelle angolazioni, nell'illuminazione o nel rumore visivo possono rendere difficile per i modelli di computer vision apprendere schemi che si generalizzino bene tra pazienti e ospedali.
L'aumento dei dati aiuta ad affrontare il problema creando diverse varianti della stessa scansione durante l'addestramento, per esempio aggiungendo rumore, spostando leggermente l'immagine o applicando piccole distorsioni. Queste modifiche rendono i dati di addestramento più rappresentativi delle reali condizioni cliniche.
Per esempio, in uno studio di diagnostica per immagini pediatrica, i ricercatori hanno usato Ultralytics YOLO11 per la segmentazione anatomica e lo hanno addestrato su dati medici aumentati. Hanno introdotto variazioni come l'aggiunta di rumore, lievi spostamenti di posizione e piccole distorsioni per rendere le immagini più realistiche.
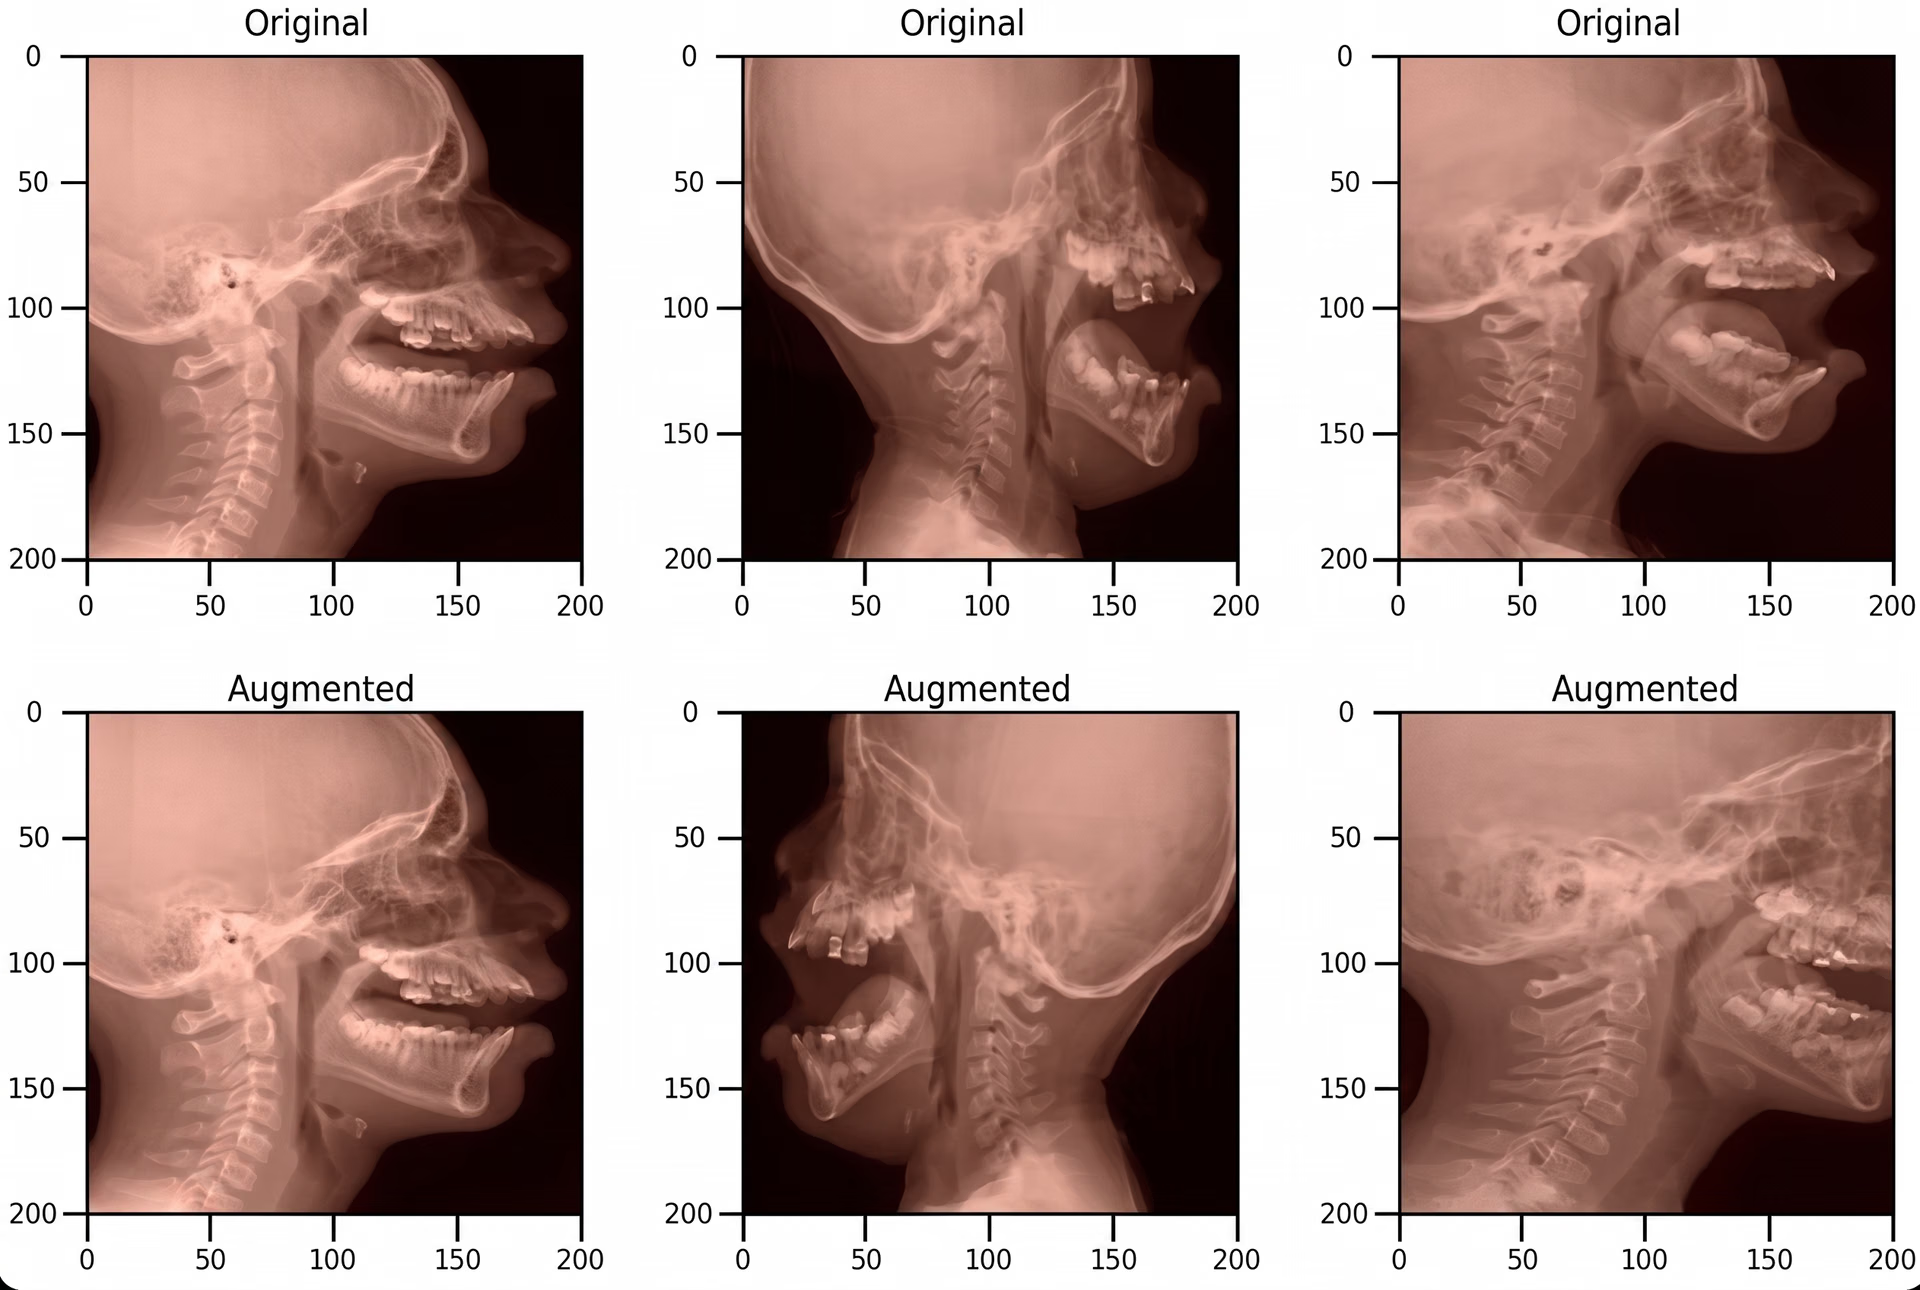
Fig. 4. Immagini mediche pediatriche originali e aumentate (Fonte)
Imparando da queste variazioni, il modello si è concentrato sulle caratteristiche anatomiche significative invece che sulle differenze superficiali. Questo ha reso i risultati della segmentazione più stabili tra scansioni e casi clinici diversi.
Punti chiave#
Raccogliere dati diversificati è difficile, ma l'aumento dei dati consente ai modelli di imparare da una gamma più ampia di condizioni visive. Ne risulta una maggiore robustezza del modello nella gestione di occlusioni, cambiamenti di illuminazione e scene affollate. In generale, questo li aiuta a funzionare in modo più affidabile al di fuori degli ambienti di addestramento controllati.
Unisciti alla nostra community ed esplora le ultime novità della vision AI nel nostro repository GitHub. Visita le nostre pagine dedicate alle soluzioni per scoprire come applicazioni come l'AI nella produzione industriale e la computer vision in ambito sanitario favoriscono il progresso, e consulta le nostre opzioni di licenza per dare vita alla tua prossima soluzione di AI.
Scritto da
Creatore di contenuti · Ultralytics
Commenti
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.









