Distribuisci modelli di computer vision in 42 regioni globali
Porta i modelli addestrati dai test nel browser agli endpoint di produzione in pochi clic, con scalabilità automatica, monitoraggio del deployment e 20 formati di esportazione.
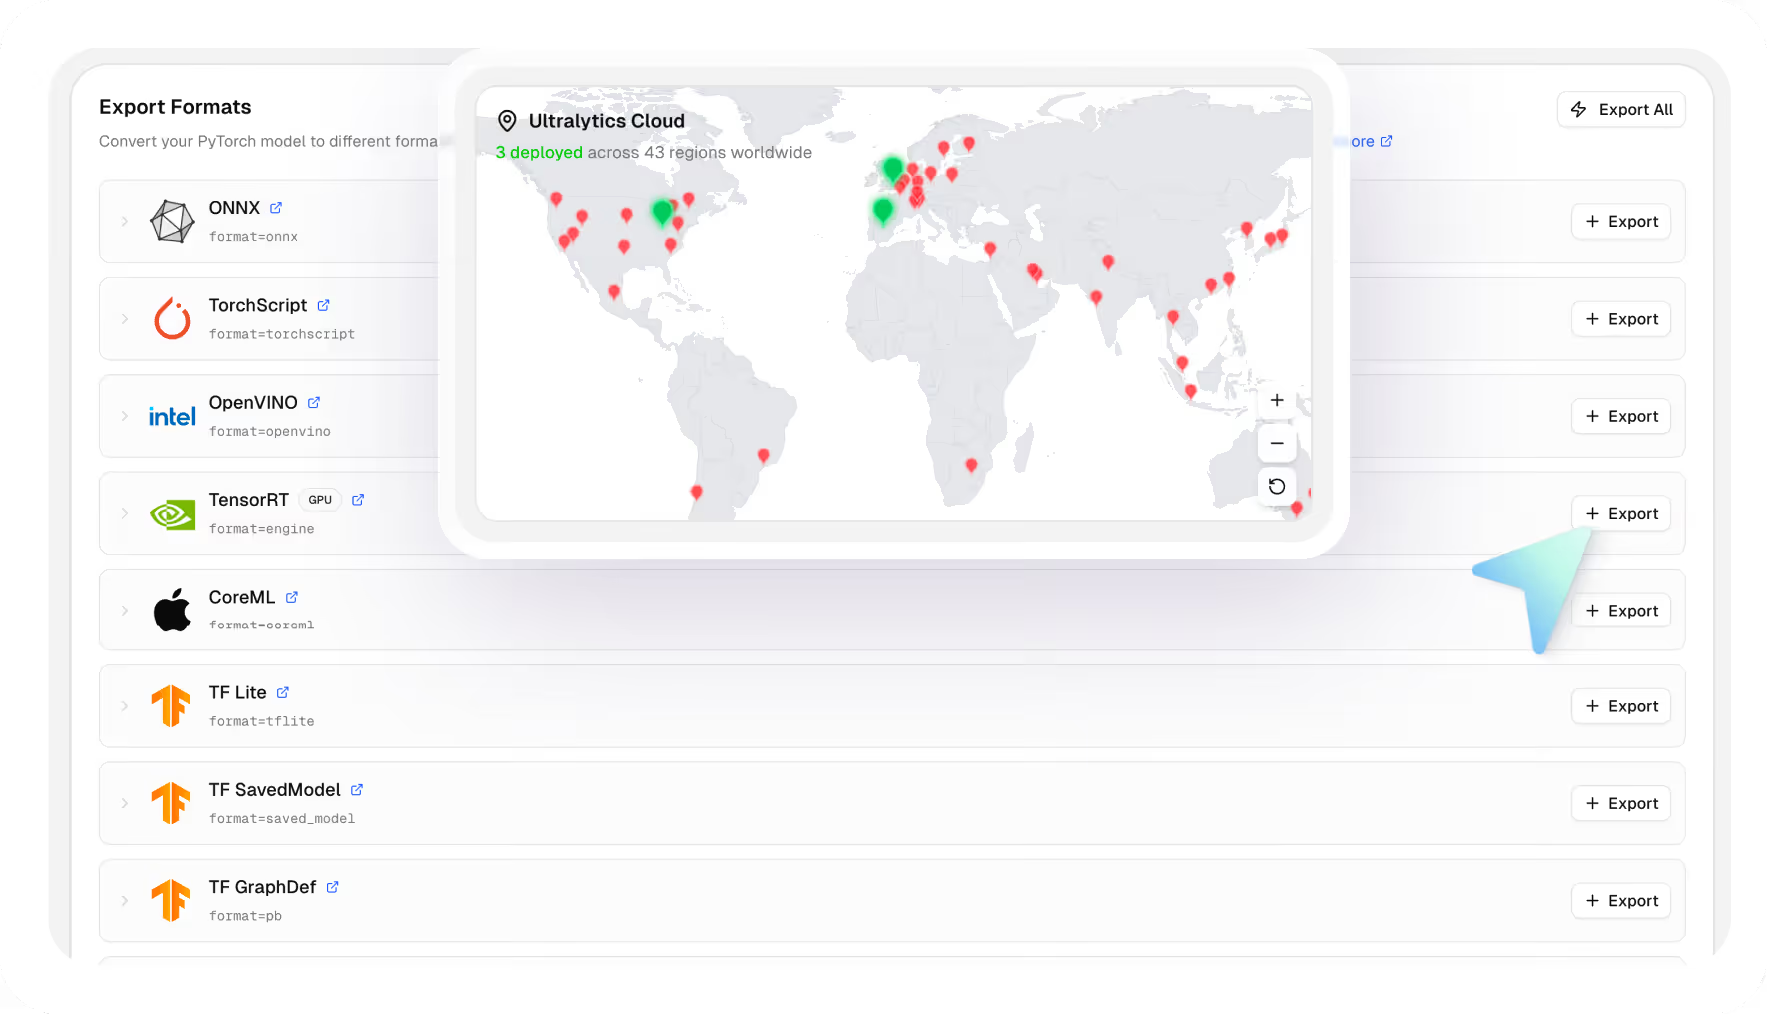
Implementa su scala produttiva globale
Porta i modelli addestrati in produzione con disponibilità mondiale, un ampio supporto per l'esportazione e il volume di utilizzo dimostrato dall'ecosistema Ultralytics.
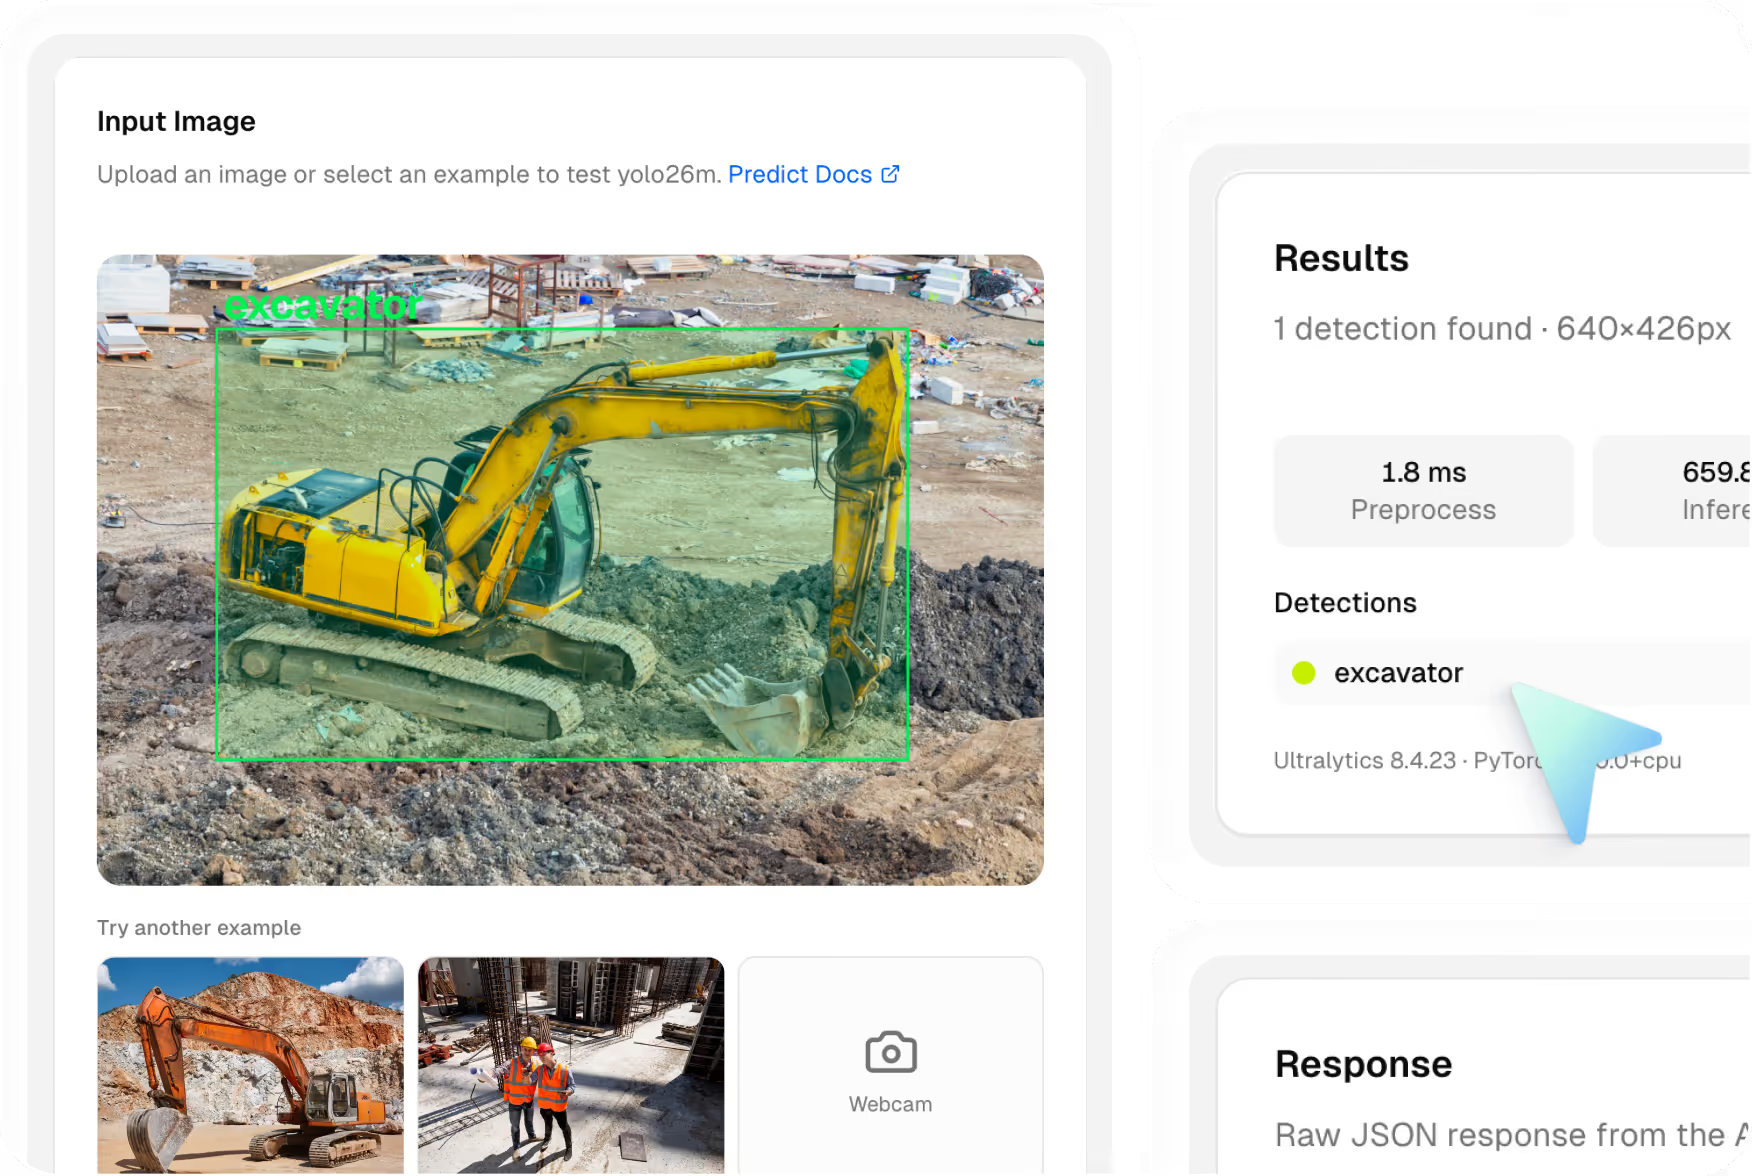
Testa il tuo modello nel browser
Ogni modello addestrato include la funzionalità della scheda Predict integrata. Carica un'immagine o apri la fotocamera: i riquadri di delimitazione compaiono all'istante.
Esegui il deployment in 42 regioni in tutto il mondo
Esegui il deployment dei tuoi modelli su endpoint dedicati in tutto il continente americano, in Europa, in Asia-Pacifico e in Medio Oriente. Ciascun endpoint dispone di un URL proprio, scalabilità automatica e monitoraggio per richieste, latenza, errori e log.
Auto-scaling che si adatta al tuo traffico
Gli endpoint dedicati aumentano la capacità durante i picchi di traffico e si riducono a zero quando sono inattivi.
- Ridimensionamento a zero per impostazione predefinita: Nessun costo quando il tuo endpoint non riceve richieste.
- Nessun limite di frequenza: Gli endpoint dedicati non hanno limiti di throughput.
- Risorse configurabili: Scegli CPU (1-8 core) e memoria (1-32 GB) in base al tuo carico di lavoro.
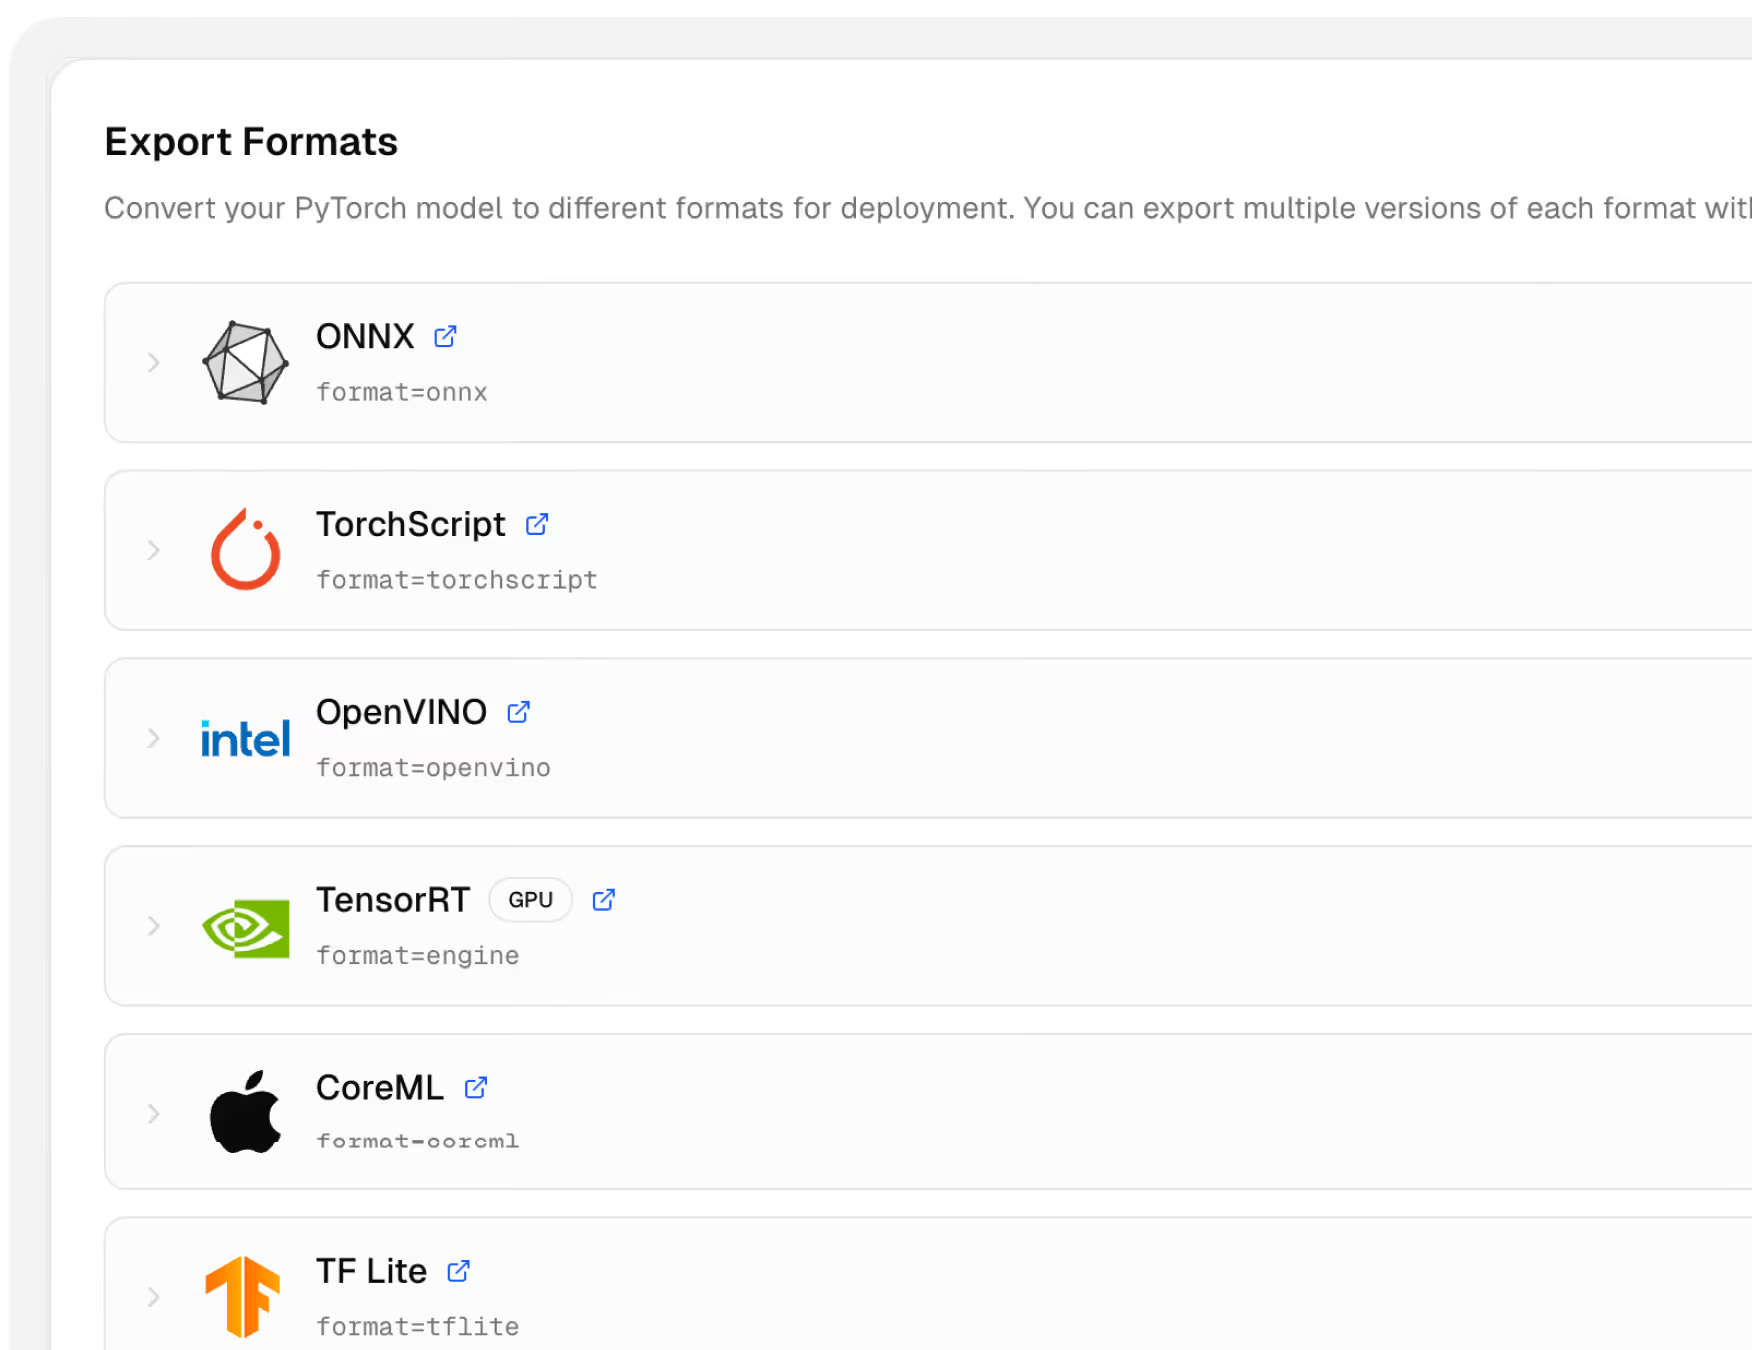
20 formati di esportazione. Il tuo modello. Qualsiasi ambiente.
Ultralytics Platform supporta il deployment su cloud ed edge per prestazioni elevate. Tutti i modelli Ultralytics YOLO sono ottimizzati nativamente per funzionare in modo efficiente in diversi ambienti, offrendo alta accuratezza, prestazioni affidabili e compatibilità anche sui dispositivi edge con risorse di calcolo limitate.
Monitora tutto in produzione
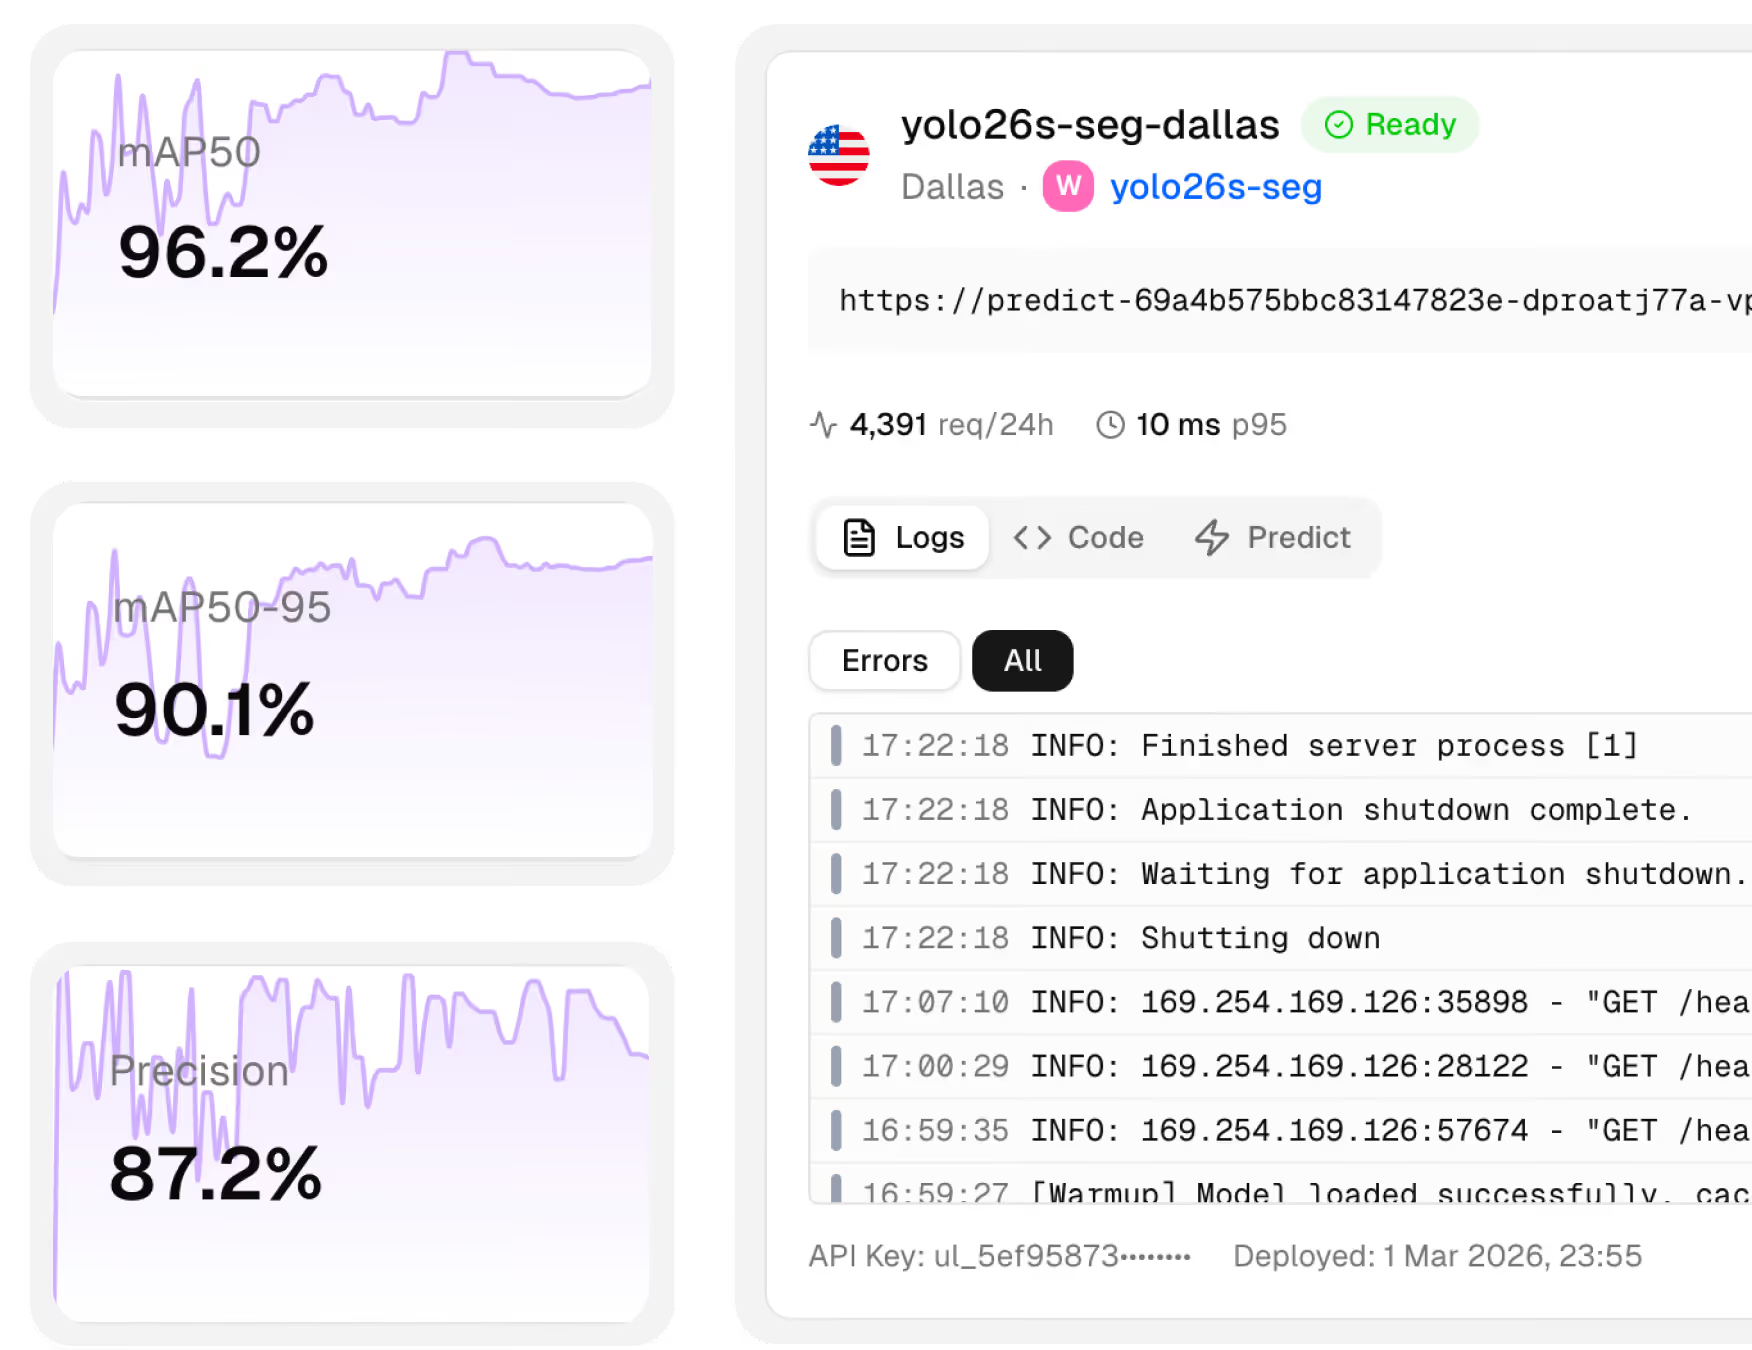
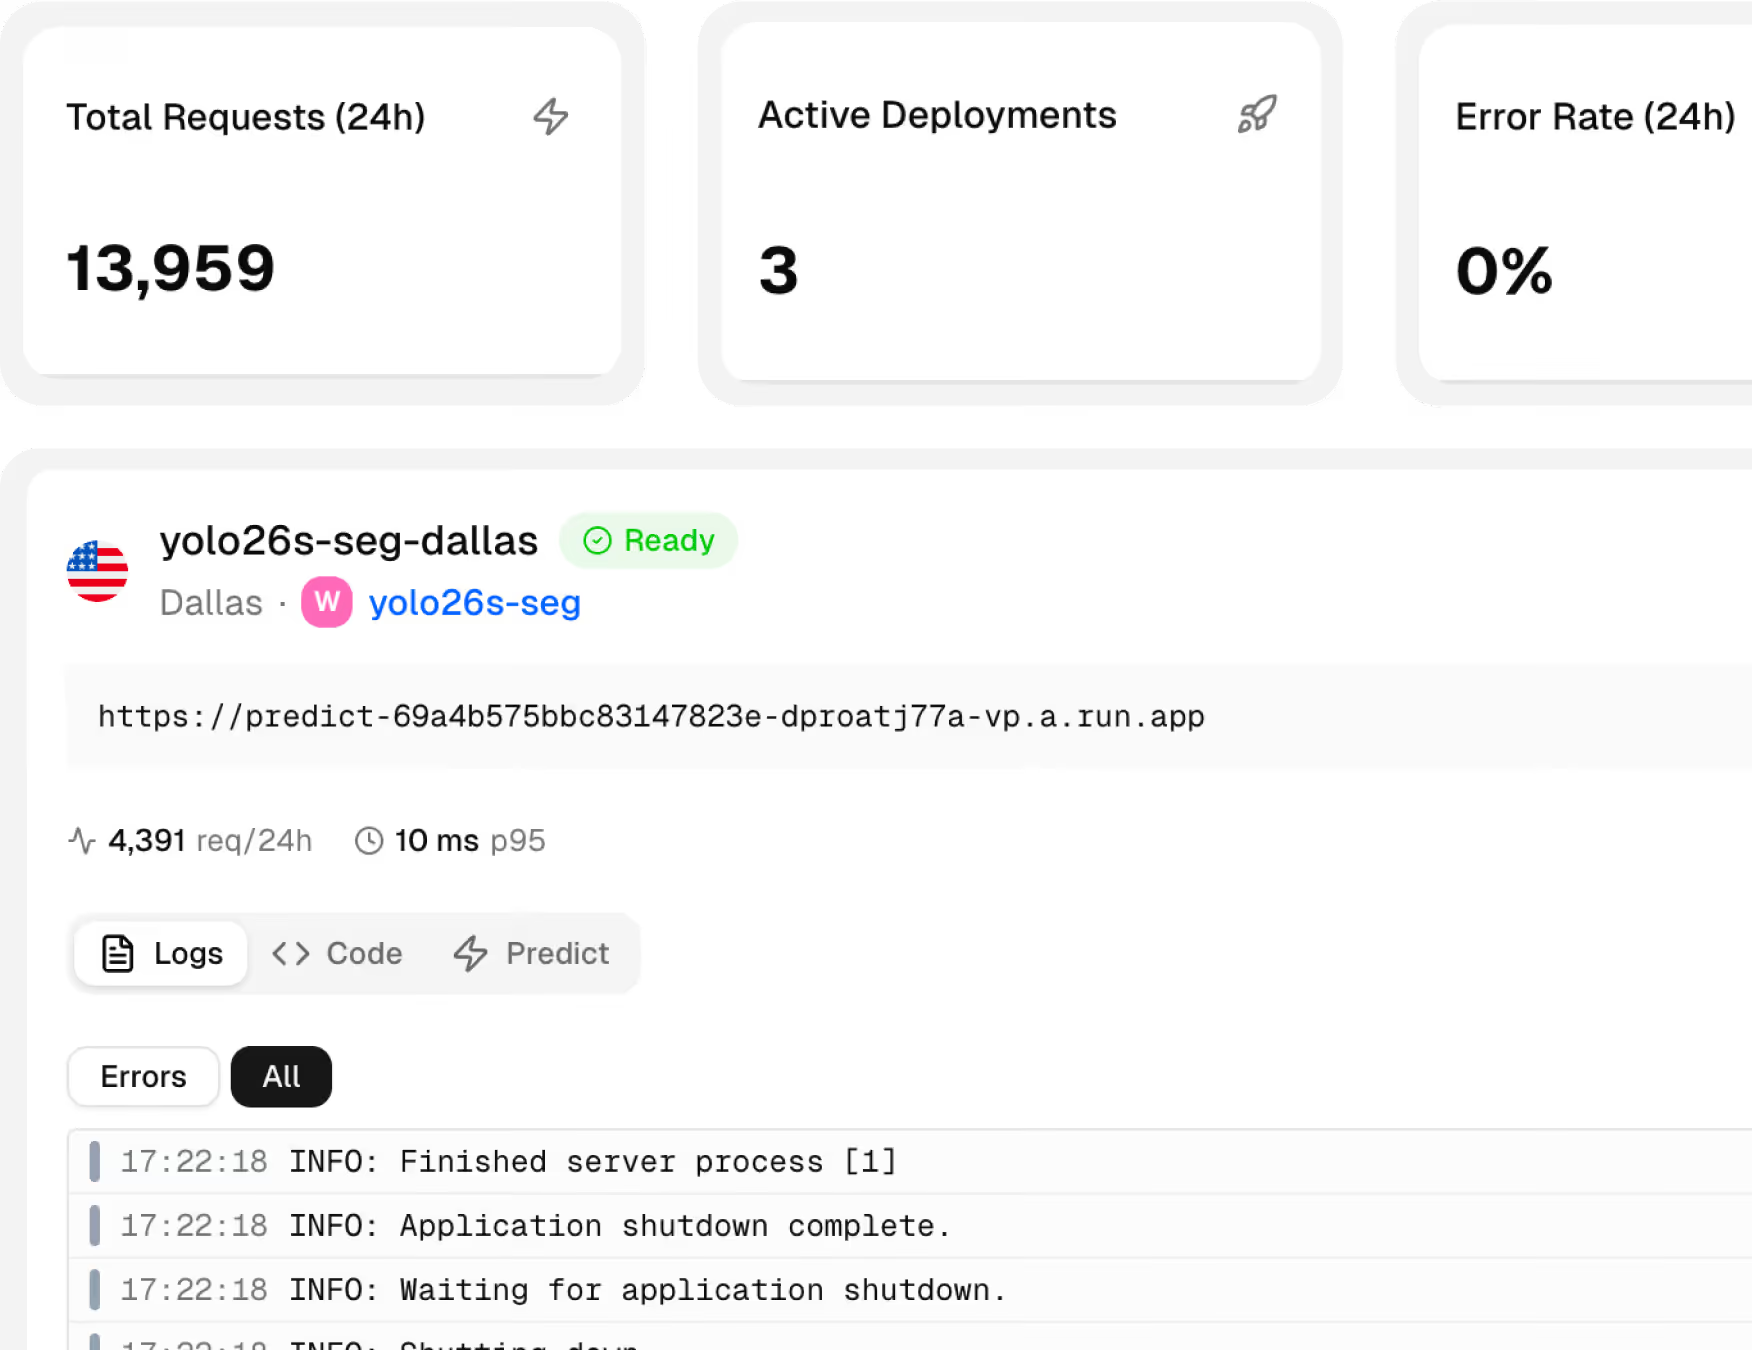
Tieni traccia delle richieste, della latenza, degli errori e dei log degli endpoint dalla dashboard dei deployment. Gli endpoint dedicati a pagamento offrono anche statistiche di previsione in tempo reale ed esempi temporanei che puoi esaminare e salvare in un dataset.
- Richieste, latenza ed errori: Volume HTTP nelle 24 ore, latenza P95 ponderata per il volume e avvisi sui tassi di errore superiori al 5%.
- Controlli di integrità e log: Integrità dell'endpoint in tempo reale con ripetizione automatica, oltre a log filtrati per gravità per diagnosticare rapidamente i problemi.
- Esempi temporanei: Esamina le previsioni campionate sugli endpoint dedicati a pagamento. Gli esempi vengono conservati nella memoria dell'endpoint; salva le immagini utili in un dataset per conservarle.
- Statistiche di previsione: Conteggi delle classi, confidenza, tempo di inferenza e mappe di calore spaziali, dove supportato dal task del modello. Le statistiche si azzerano quando l'istanza di serving viene sostituita.
Integra in pochi minuti
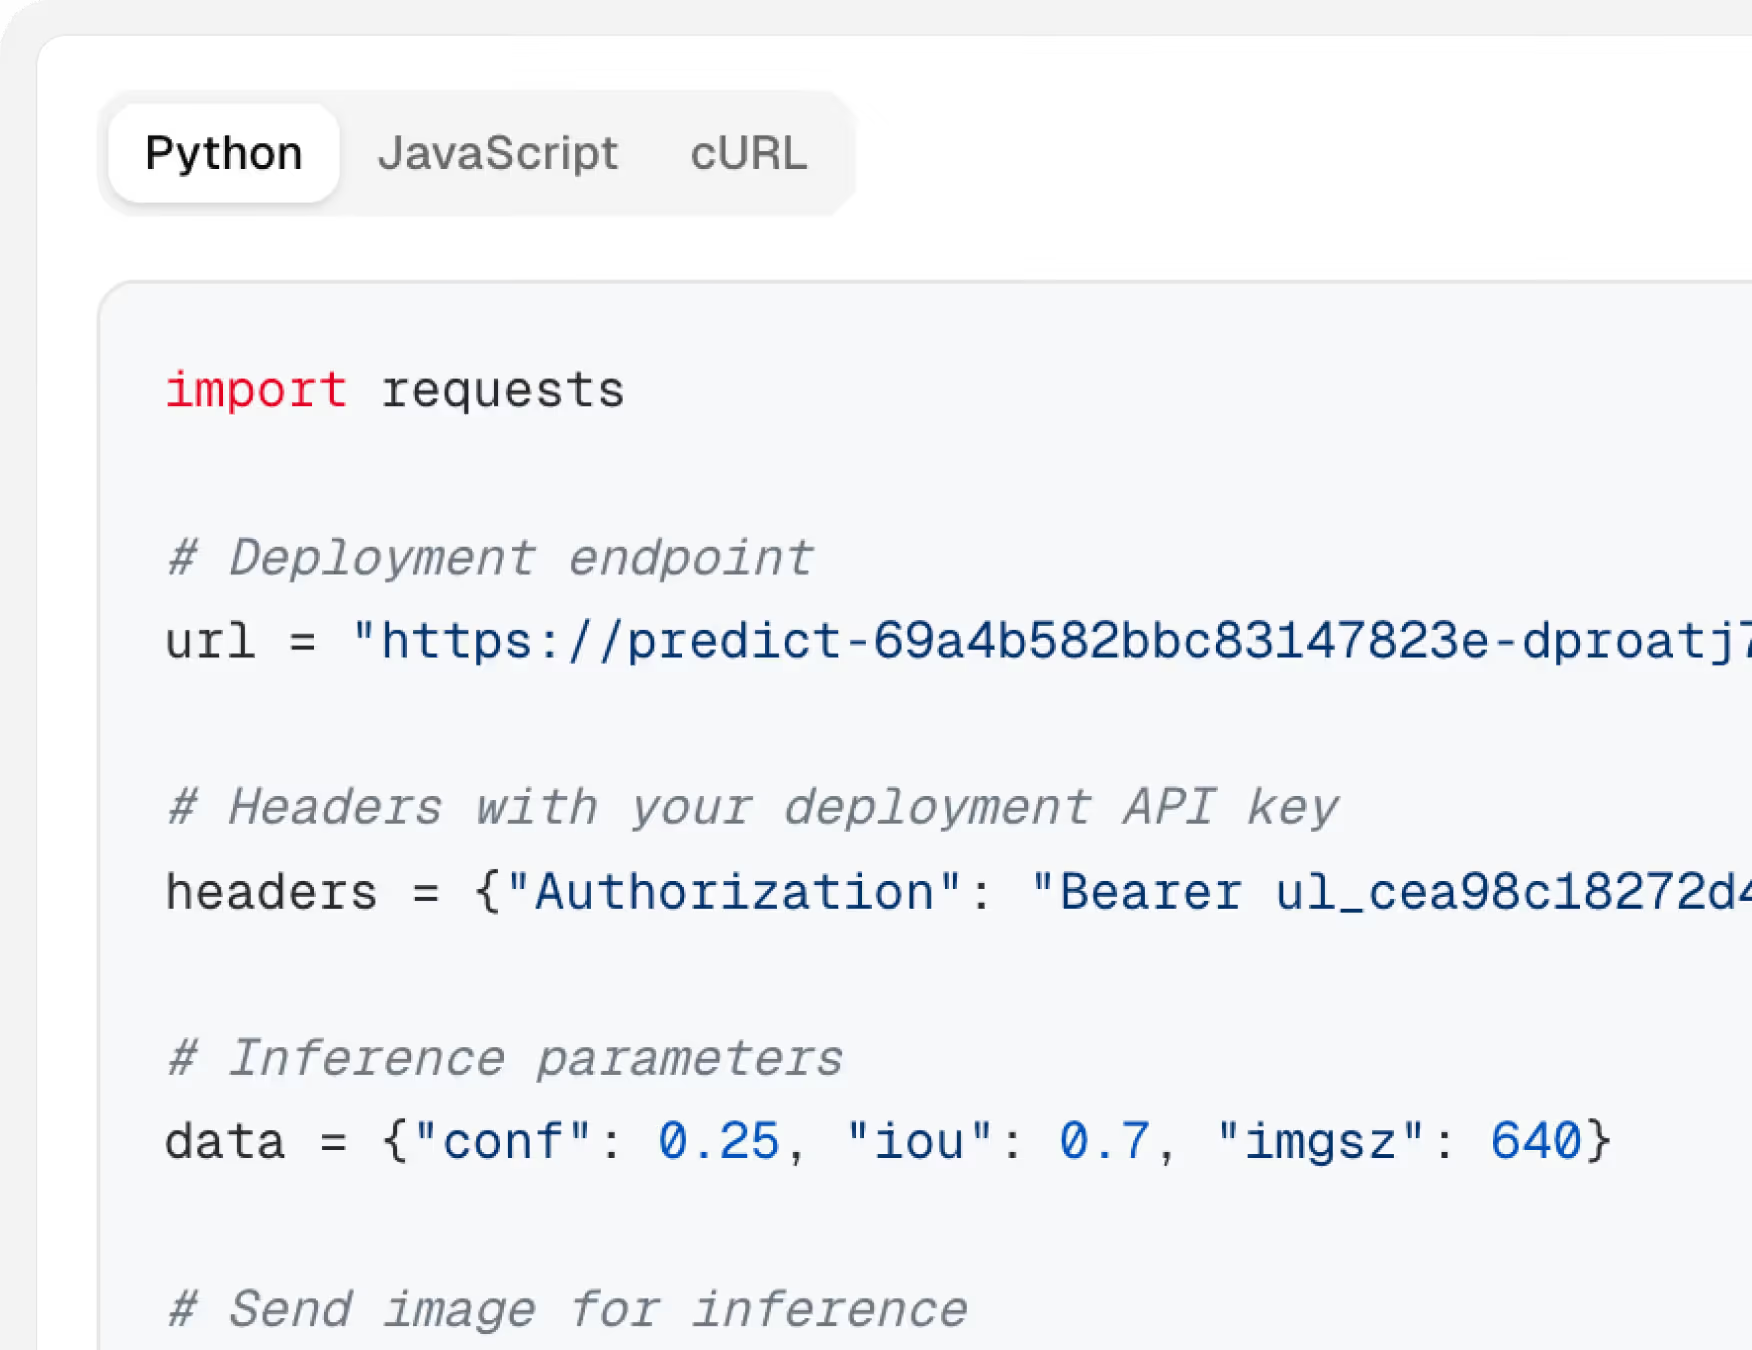
Ogni endpoint sottoposto a deployment include esempi di codice generati automaticamente in Python, JavaScript e cURL, già compilati con l'URL effettivo del tuo endpoint e la chiave API. Copia, incolla e inizia a inviare richieste di inferenza da qualsiasi applicazione.
Prova l'inferenza con YOLO26
Trascina un'immagine qui o rilasciala per vedere il rilevamento degli oggetti in tempo reale
Scopri come eseguire il deployment!
Guarda come testare un modello addestrato, eseguirne il deployment su un endpoint globale e monitorare richieste, latenza e previsioni in tempo reale.
Devi prima addestrare un modello?
Ultralytics Platform riunisce annotazione, addestramento e deployment in un'unica piattaforma.
Esplora le soluzioni per settore
Scopri come i team applicano la computer vision di Ultralytics negli ambienti di produzione.

Visione artificiale per immagini aeree

Computer vision nel settore aerospaziale


Computer vision nella robotica

Computer vision nella logistica

Computer vision nel commercio al dettaglio

Computer vision nel settore sanitario

Computer vision nella produzione

Computer vision nel settore automobilistico

Computer vision in agricoltura
Visione artificiale per immagini aeree
Computer vision nel settore aerospaziale
Computer vision nella robotica
Computer vision nella logistica
Computer vision nel commercio al dettaglio
Computer vision nel settore sanitario
Computer vision nella produzione
Computer vision nel settore automobilistico
Computer vision in agricoltura
Visione artificiale per immagini aeree
Computer vision nel settore aerospaziale
Computer vision nella robotica
Computer vision nella logistica
Computer vision nel commercio al dettaglio
Computer vision nel settore sanitario
Computer vision nella produzione
Computer vision nel settore automobilistico
Computer vision in agricoltura
Sicurezza di livello enterprise, certificata
Certificati e sottoposti ad audit indipendenti, così i tuoi dati rimangono protetti durante il transito e quando sono inattivi.
SOC 2 Type I

ISO 27001:2022
GDPR e CCPA
Domande frequenti
Sì. Ogni modello può essere implementato contemporaneamente in più regioni. Il tuo piano determina il numero totale di endpoint disponibili: 3 per Free, 10 per Pro e un numero illimitato per Enterprise. Questo ti consente di offrire il servizio agli utenti di tutto il mondo con endpoint a bassa latenza in ogni regione.
Gli endpoint dedicati vengono fatturati in base a CPU, memoria e volume di richieste. Con lo scale-to-zero abilitato per impostazione predefinita, paghi solo il tempo di inferenza attivo. Non paghi nulla quando il tuo endpoint non riceve richieste. L'inferenza condivisa è inclusa nel tuo piano della piattaforma.
L'inferenza condivisa viene eseguita su un servizio multi-tenant distribuito in 3 regioni ed è limitata a 20 richieste al minuto. È ideale per lo sviluppo e i test rapidi. Gli endpoint dedicati sono servizi single-tenant implementati in una qualsiasi delle 43 regioni, senza limiti di frequenza, con latenza costante e risorse configurabili, progettati per carichi di lavoro di produzione scalabili.
Il deployment di un endpoint dedicato richiede in genere da uno a due minuti. Questo include il provisioning del container, l'avvio e un controllo iniziale dello stato per verificare che il servizio sia pronto. Quando l'endpoint è pronto, inizia ad accettare immediatamente le richieste di inferenza.
Il deployment di un modello è il processo che rende disponibile un modello di computer vision addestrato per ricevere ed elaborare dati del mondo reale. Una volta implementato, le applicazioni di computer vision possono inviare immagini e fotogrammi video al modello tramite API e ricevere previsioni, abilitando attività che vanno dall'ispezione automatizzata della qualità al rilevamento degli oggetti in tempo reale nei sistemi di produzione. Su Ultralytics Platform, il deployment è integrato direttamente nel workflow di training end-to-end. Una volta addestrato il modello, puoi testarlo nel browser, implementarlo su un endpoint dedicato in una qualsiasi delle 43 regioni globali e monitorarne le prestazioni, tutto dallo stesso workspace.
Inizia oggi la distribuzione!
Porta i tuoi modelli addestrati in produzione in 42 regioni globali con scalabilità automatica e monitoraggio del deployment.