Computer Vision (CV)
La visione artificiale (CV) è il campo dell'IA che consente alle macchine di interpretare immagini e video. Scopri come funziona, le attività principali, le applicazioni e le sfide.
La visione artificiale (CV) è il campo dell'intelligenza artificiale (AI) che consente ai computer di estrarre informazioni da immagini, video e altri dati visivi: quali oggetti sono presenti, dove si trovano, come si muovono e cosa accade in una scena. I sistemi moderni apprendono queste capacità dagli esempi. Un modello addestrato su migliaia di immagini etichettate impara gli schemi visivi che definiscono un'auto, una crepa o un tumore e li applica a immagini mai viste: per questo oggi il campo si basa sull'apprendimento automatico (ML) e, soprattutto, sull'apprendimento profondo (DL).
Come funziona la visione artificiale#
Per un computer, un'immagine a colori è una griglia di numeri. Una foto da 640×480 contiene 921.600 valori, uno per ogni pixel di ciascuno dei tre canali di colore, ognuno con un'intensità da 0 a 255. Una pipeline di visione artificiale trasforma quella griglia in una decisione attraverso cinque fasi.
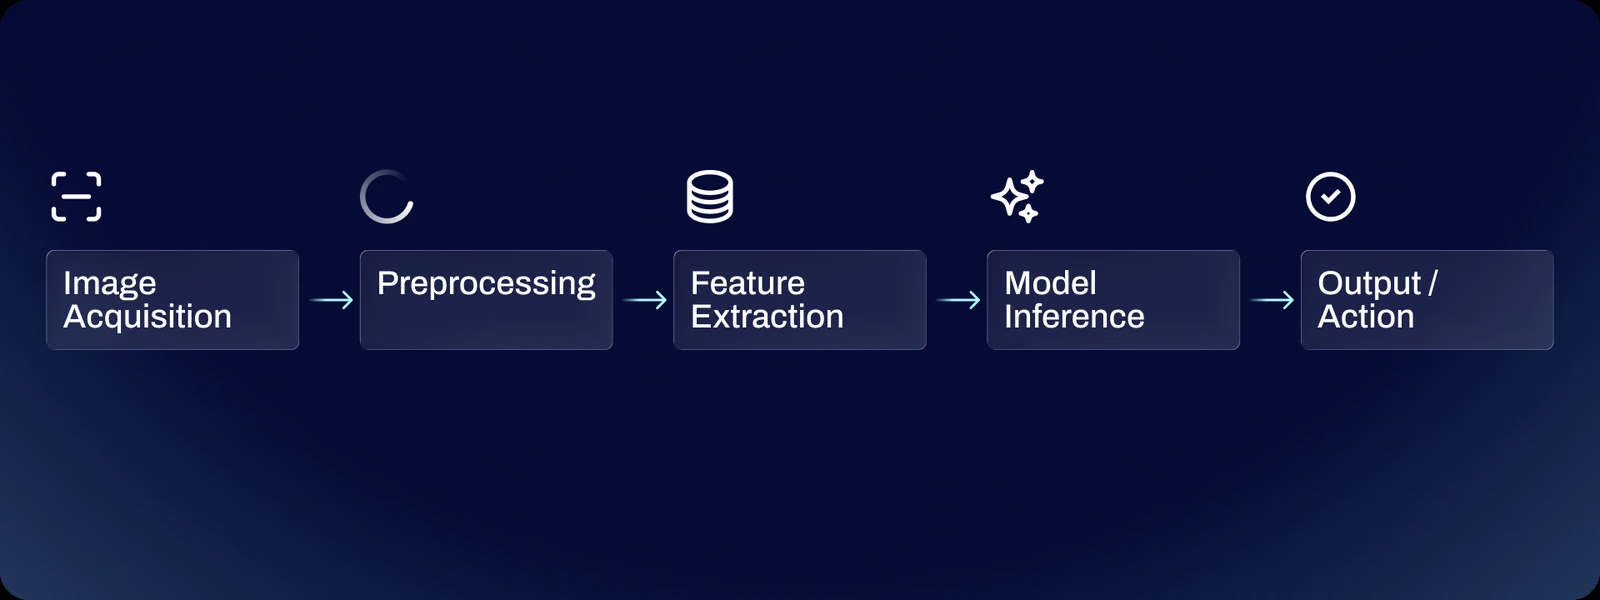
Una fotocamera o un sensore acquisisce l'immagine e la preelaborazione, spesso con OpenCV, la ridimensiona e normalizza affinché il modello riceva sempre input nello stesso formato. Il modello esegue quindi l'estrazione delle caratteristiche: i primi strati di una rete neurale convoluzionale (CNN) rispondono ai bordi e ai gradienti di colore, quelli intermedi li combinano in texture e parti, mentre quelli profondi rispondono agli oggetti interi. I Transformer della visione (ViT) raggiungono rappresentazioni simili dividendo l'immagine in patch e mettendo in relazione ogni patch con tutte le altre tramite self-attention. Una testa specifica per il compito converte le caratteristiche nell'output, ad esempio un'etichetta di classe, un insieme di riquadri delimitatori o una maschera di pixel; il sistema circostante agisce di conseguenza, ad esempio scartando un pezzo difettoso, frenando un veicolo o generando un avviso.
I modelli apprendono queste caratteristiche tramite apprendimento supervisionato. Durante l'addestramento, il modello esegue previsioni su immagini etichettate, una funzione di loss misura la distanza tra ciascuna previsione e il ground truth e la retropropagazione regola i pesi per ridurre l'errore. Grandi dataset pubblici, come ImageNet, con oltre 14 milioni di immagini etichettate, e COCO, con 80 categorie di oggetti di uso comune, forniscono il preaddestramento da cui parte la maggior parte dei modelli personalizzati tramite transfer learning.
Dalle caratteristiche progettate a mano all'apprendimento profondo#
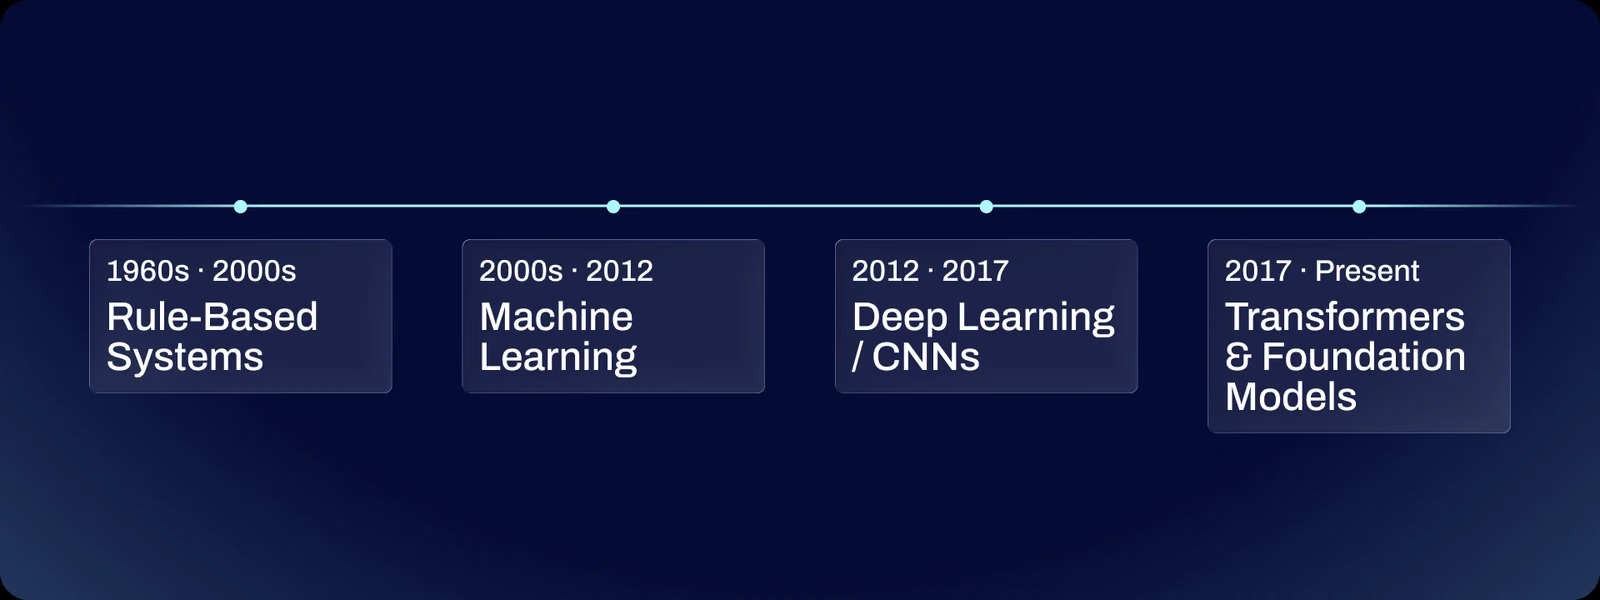
Le prime tecniche di visione artificiale si basavano su caratteristiche progettate manualmente. Gli ingegneri scrivevano rilevatori di bordi, angoli e schemi di gradienti come SIFT e HOG, poi passavano queste caratteristiche a un classificatore; i sistemi risultanti fallivano ogni volta che cambiavano illuminazione, punto di vista o sfondo. La svolta arrivò nel 2012, quando AlexNet vinse la competizione ImageNet con un tasso di errore top-5 del 15,3%, contro il 26,2% del concorrente successivo. Da allora, le CNN e, dal 2020, i Vision Transformer apprendono direttamente le caratteristiche dai dati. I modelli visione-linguaggio (VLM) associano ora immagini e testo, così un modello può rispondere a domande aperte su una foto o individuare oggetti descritti in linguaggio semplice. La classifica VLM misura la precisione con cui questi modelli rilevano oggetti nei dataset del mondo reale.
Attività fondamentali della visione artificiale#
Ogni attività risponde a una domanda diversa su un'immagine:
- Rilevamento degli oggetti: individua ogni oggetto e lo racchiude in un riquadro con la relativa classe e un punteggio di confidenza, consentendo di contare e localizzare gli oggetti.
- Segmentazione di istanze: assegna a ogni oggetto la propria maschera di pixel, mantenendo separate due persone che si trovano una accanto all'altra.
- Segmentazione semantica: assegna a ogni pixel un'etichetta di classe, come strada, marciapiede o cielo.
- Stima della profondità: prevede la distanza di ogni pixel dalla fotocamera a partire da una singola immagine.
- Classificazione delle immagini: assegna un'unica etichetta all'intera immagine, come "difettoso" o "OK".
- Stima della posa: individua punti chiave, come le articolazioni del corpo, per misurare postura e movimento.
- Riquadri delimitatori orientati (OBB): adatta riquadri ruotati a oggetti con angoli arbitrari, come navi e aerei nelle immagini satellitari.
- Tracciamento degli oggetti: collega i rilevamenti nei diversi fotogrammi di un video, così ogni oggetto mantiene un ID coerente.
La scelta di un'attività parte dall'output richiesto dall'applicazione:
Ultralytics YOLO26 copre sette di queste attività con un'unica API Python: la stessa chiamata YOLO() carica un modello di rilevamento, segmentazione delle istanze, segmentazione semantica, profondità, classificazione, pose o OBB, e model.track() aggiunge il tracking video. Questo esempio esegue il rilevamento degli oggetti su un'immagine di esempio:
from ultralytics import YOLO

# Carica un modello nano YOLO26 pretrained per il rilevamento
model = YOLO("yolo26n.pt")

# Esegui l'inferenza su un'immagine di esempio di una strada
results = model("https://ultralytics.com/images/bus.jpg")
result = results[0]

# Stampa il conteggio degli oggetti rilevati per classe e salva l'immagine annotata
print(result.verbose())
result.save(filename="bus_detections.jpg")
La riga stampata conta i rilevamenti per classe; l'immagine salvata mostra ciascuno con il relativo riquadro, l'etichetta e il punteggio di confidenza.
Visione artificiale e campi correlati#
- Elaborazione delle immagini: trasforma un'immagine in un'altra applicando nitidezza, riduzione del rumore, ridimensionamento o regolazione del contrasto. Le pipeline di visione artificiale usano queste operazioni come preelaborazione prima di interpretare la scena.
- Visione artificiale industriale: applicazione della visione artificiale a ispezione e guida dei robot in ambito industriale, di solito con telecamere fisse, illuminazione controllata e hardware dedicato sulla linea di produzione.
- Riconoscimento delle immagini: sinonimo comune di classificazione delle immagini, talvolta usato in senso ampio per qualsiasi attività che identifichi il contenuto di un'immagine.
Applicazioni nel mondo reale#
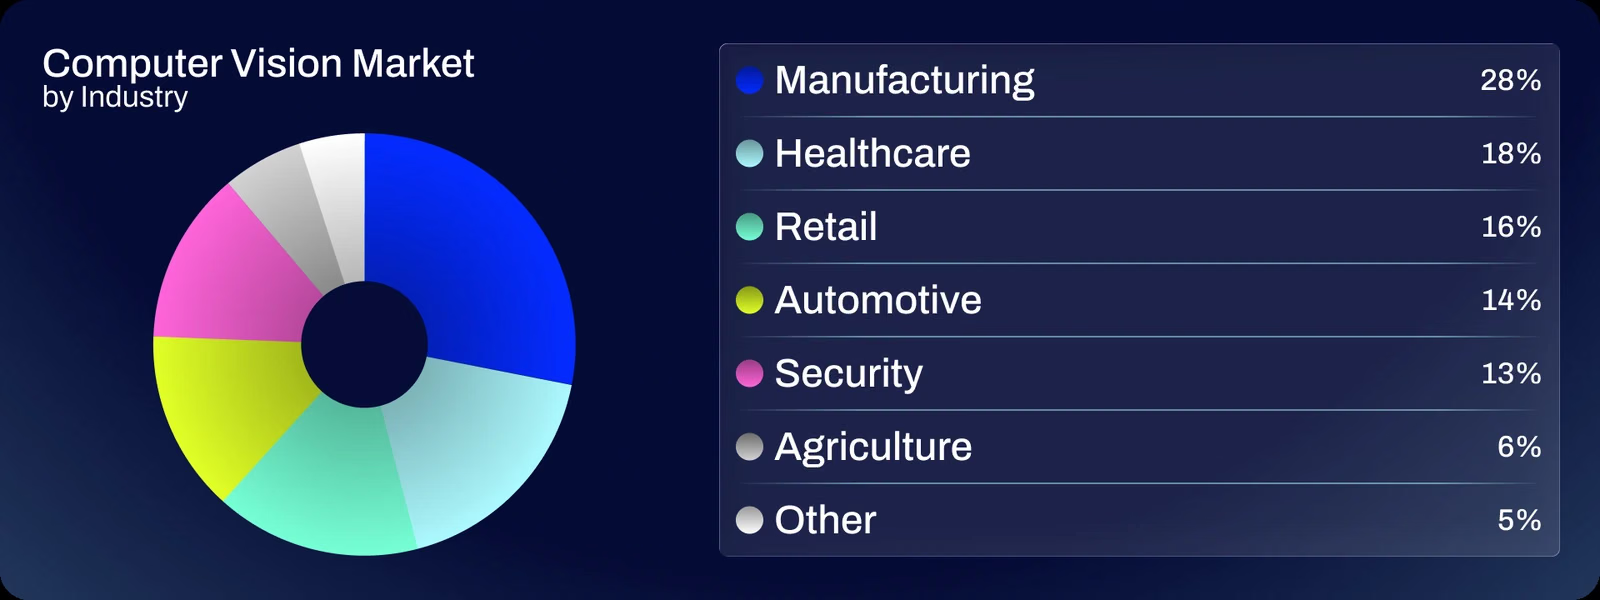
- Produzione industriale: le telecamere ispezionano ogni pezzo alla velocità della linea per individuare crepe, graffi e componenti disallineati, e monitorano l'usura dei macchinari prima che si guastino.
- Diagnostica per immagini: i modelli segnalano tumori, fratture e patologie retiniche in radiografie, TC e fotografie della retina, affinché i radiologi le esaminino.
- Veicoli autonomi: le auto rilevano in tempo reale corsie, segnali, pedoni e altri veicoli e fondono i dati delle telecamere con radar e LiDAR per creare un modello 3D dell'ambiente circostante.
- Vendita al dettaglio: le telecamere sugli scaffali rilevano spazi vuoti e prodotti fuori posto, mentre i negozi senza casse monitorano gli articoli prelevati da ogni cliente.
- Agricoltura: droni e irroratrici distinguono le colture dalle erbe infestanti, pianta per pianta, così erbicidi e fertilizzanti vengono applicati solo dove servono.
- Sicurezza e città intelligenti: i sistemi contano persone e veicoli, monitorano il flusso del traffico e usano il rilevamento delle anomalie per segnalare eventi insoliti nelle aree riservate.
Sfide e limiti#
Un modello è valido solo quanto il suo dataset di addestramento, e l'etichettatura dei dati, che consiste nel disegnare riquadri o maschere su migliaia di immagini, spesso richiede più impegno dell'addestramento stesso. Dopo la distribuzione, inoltre, le condizioni cambiano: pioggia, riverbero, illuminazione notturna, occlusioni o una telecamera spostata alterano gli input rispetto a quelli visti dal modello durante l'addestramento. L'aumento dei dati simula queste condizioni durante l'addestramento e la convalida su immagini tenute da parte individua l'overfitting prima del rilascio.
La potenza di calcolo è il vincolo successivo. Telecamere, droni e telefoni eseguono modelli con budget limitati di potenza e memoria, quindi le distribuzioni di IA edge privilegiano modelli piccoli e la quantizzazione dei modelli per raggiungere la velocità in tempo reale senza inviare video al cloud.
I sistemi che analizzano le persone sollevano preoccupazioni riguardo a bias e privacy. Un dataset che sottorappresenta alcuni gruppi produce un modello dalle prestazioni disomogenee tra i gruppi; inoltre, nella maggior parte delle leggi sulla privacy, i dati del volto e del corpo sono considerati dati personali sensibili. Da febbraio 2025, l'EU AI Act vieta alle forze dell'ordine l'identificazione biometrica remota in tempo reale negli spazi accessibili al pubblico, salvo eccezioni limitate, come la ricerca di vittime di rapimento o la prevenzione di una minaccia terroristica imminente.









