Unir o processamento de linguagem natural e a visão computacional
Descobre como o processamento de linguagem natural (NLP) e a visão computacional (CV) podem trabalhar em conjunto para transformar setores com sistemas de IA multimodais mais inteligentes.
 Abirami Vina9 min de leitura

O processamento de linguagem natural (NLP) e a visão computacional (CV) são dois ramos distintos da inteligência artificial (AI) que ganharam muita popularidade nos últimos anos. Graças aos avanços da AI, esses dois ramos estão mais interligados do que nunca.
Um ótimo exemplo disso é a geração automática de legendas para imagens. A visão computacional pode analisar e compreender o conteúdo de uma imagem, enquanto o processamento de linguagem natural pode gerar uma legenda para descrevê-la. A geração automática de legendas para imagens é usada com frequência em plataformas de redes sociais para melhorar a acessibilidade e em sistemas de gerenciamento de conteúdo para ajudar a organizar e marcar imagens com eficiência.
As inovações em NLP e IA visual levaram a muitos casos de uso em diversos setores. Neste artigo, vamos analisar mais de perto o NLP e a visão computacional e explicar como funcionam. Também vamos explorar aplicações que usam essas duas tecnologias em conjunto.
Entenda o NLP e a IA de visão#
O NLP se concentra na interação entre computadores e a linguagem humana. Ele permite que máquinas compreendam, interpretem e gerem texto ou fala de maneira significativa. Pode ser usado em tarefas como tradução, análise de sentimentos ou sumarização.
Já a visão computacional ajuda as máquinas a analisar e trabalhar com imagens e vídeos. Ela pode ser usada em tarefas como detecção de objetos em uma foto, reconhecimento facial, rastreamento de objetos ou classificação de imagens. A tecnologia de IA visual permite que as máquinas compreendam e interajam melhor com o mundo visual.
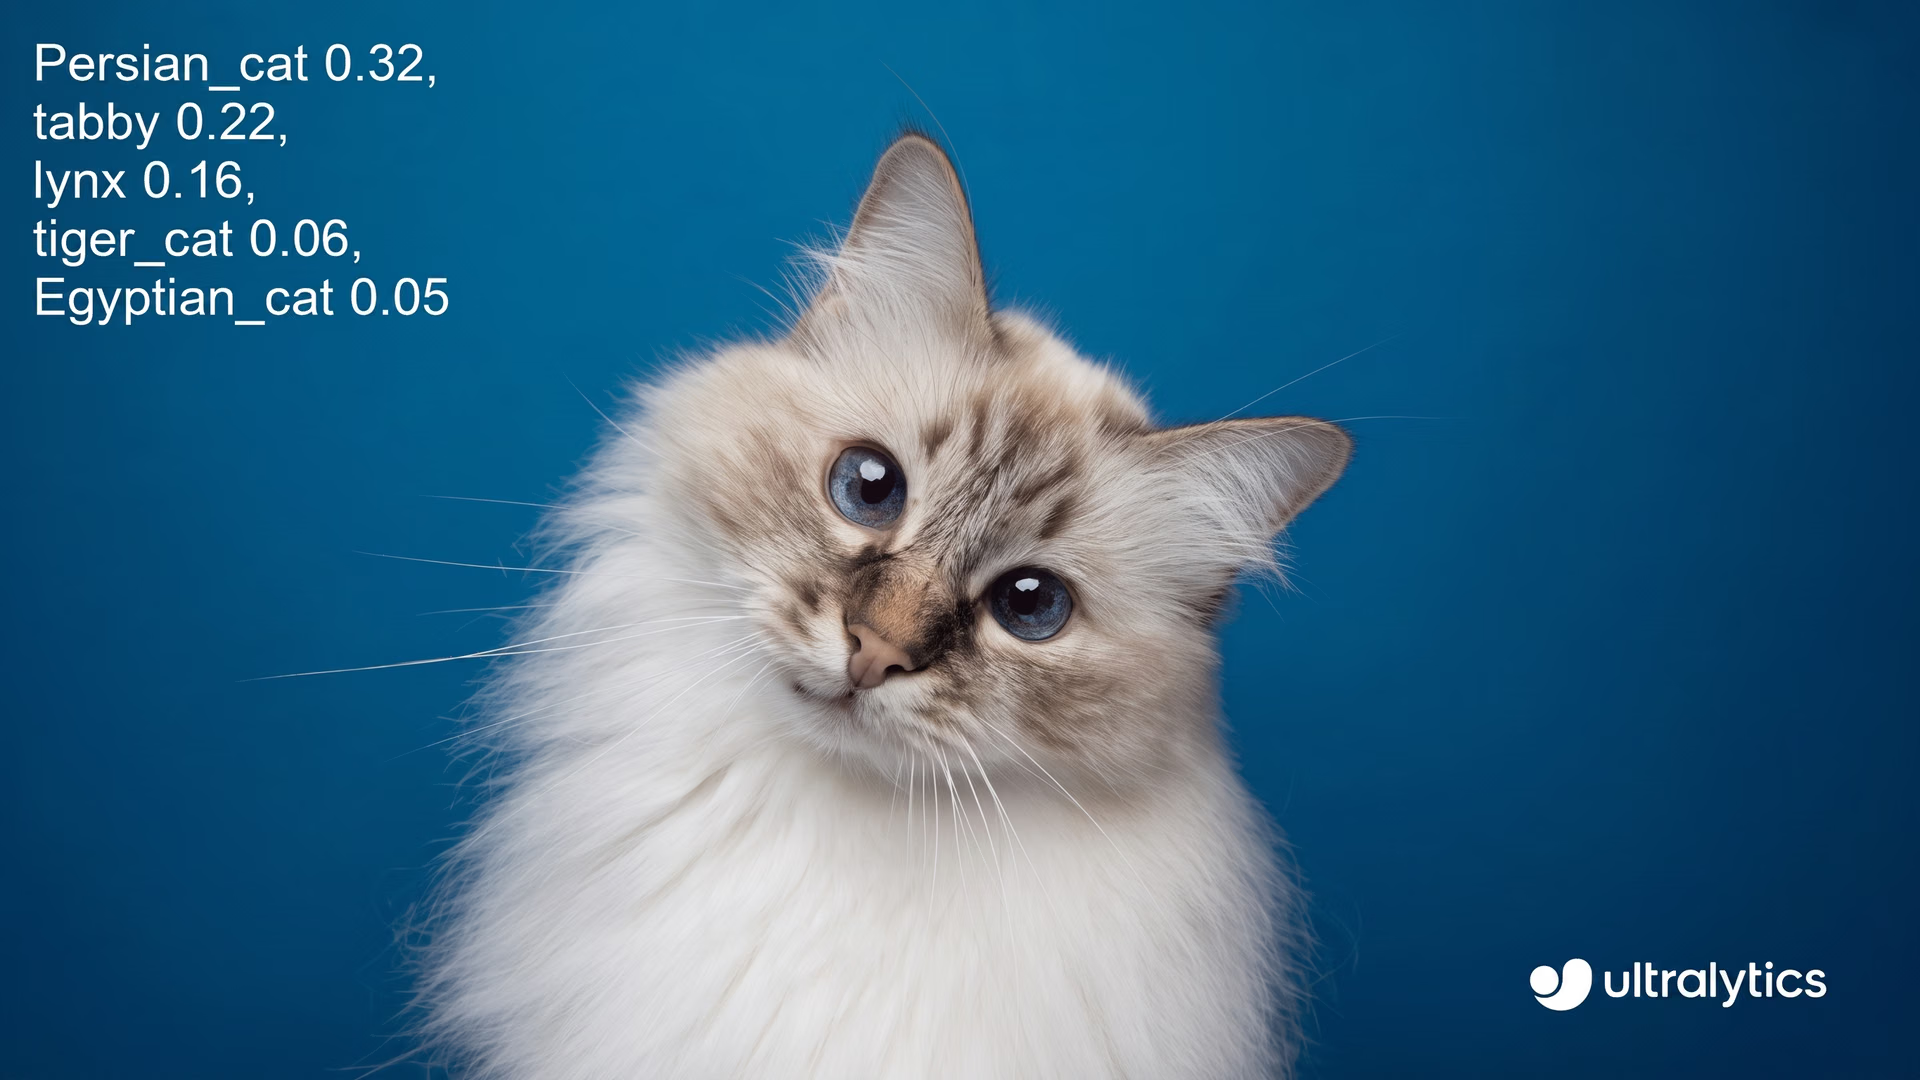
Fig. 1. Exemplo de classificação de imagens.
Quando integrada à visão computacional, a NLP pode atribuir significado aos dados visuais combinando texto e imagens, o que permite uma compreensão mais profunda. Como diz o ditado, "uma imagem vale mais que mil palavras"; quando combinada com texto, ela se torna ainda mais poderosa e oferece informações mais ricas.
Exemplos de uso conjunto do NLP e da visão computacional#
Provavelmente você já viu NLP e visão computacional trabalhando juntas em ferramentas do dia a dia sem nem perceber, como quando seu celular traduz o texto de uma imagem.
Na verdade, o Google Tradutor usa tanto o processamento de linguagem natural quanto a visão computacional para traduzir texto em imagens. Quando você tira uma foto de uma placa de rua em outro idioma, a visão computacional identifica e extrai o texto, enquanto o NLP o traduz para o idioma de sua preferência.
O NLP e a CV trabalham em conjunto para tornar o processo simples e eficiente, permitindo que os usuários compreendam e interajam com informações em vários idiomas em tempo real. Essa integração ajuda a superar barreiras de comunicação.

Fig. 2. Recurso de tradução do Google.
Veja outras aplicações em que o NLP e a visão computacional trabalham juntos:
- Carros autônomos: A CV pode ser usada para detectar placas de trânsito, faixas e obstáculos, enquanto o NLP pode processar comandos de voz ou o texto nas placas.
- Leitores de documentos: A IA visual pode reconhecer texto em documentos digitalizados ou manuscritos, enquanto o processamento de linguagem natural pode interpretar e resumir as informações.
- Busca visual em aplicativos de compras: A visão computacional pode identificar produtos em fotos, enquanto o NLP processa termos de busca para melhorar as recomendações.
- Ferramentas educacionais: A CV pode reconhecer anotações manuscritas ou entradas visuais, enquanto o NLP pode fornecer explicações ou feedback com base no conteúdo.
Conceitos-chave que conectam a visão computacional e o NLP#
Agora que vimos como a visão computacional e o processamento de linguagem natural são usados, vamos explorar como eles se combinam para possibilitar a IA cross-modal.
A IA multimodal combina a compreensão visual da visão computacional com a compreensão da linguagem do NLP para processar e relacionar informações em textos e imagens. Por exemplo, na área da saúde, a IA multimodal pode ajudar a analisar um raio X e gerar um resumo claro e escrito de possíveis problemas, ajudando os médicos a tomar decisões mais rápidas e precisas.
Compreensão de linguagem natural (NLU)#
A compreensão da linguagem natural é um subcampo do NLP que se concentra em interpretar e extrair significado do texto por meio da análise de intenção, contexto, semântica, tom e estrutura. Enquanto o NLP processa texto bruto, o NLU permite que as máquinas compreendam a linguagem humana com mais eficiência. Por exemplo, a análise sintática é uma técnica de NLU que converte texto escrito em um formato estruturado que as máquinas conseguem compreender.

Fig. 3. A relação entre NLP e NLU.
A NLU trabalha com a visão computacional quando os dados visuais contêm textos que precisam ser compreendidos. A visão computacional, usando tecnologias como o reconhecimento óptico de caracteres (OCR), extrai textos de imagens, documentos ou vídeos. Isso pode envolver tarefas como digitalizar um recibo, ler o texto de uma placa ou digitalizar anotações manuscritas.
Em seguida, a NLU processa o texto extraído para entender seu significado, contexto e intenção. Essa combinação permite que os sistemas façam mais do que apenas reconhecer textos. Eles podem categorizar despesas a partir de recibos ou analisar o tom e os sentimentos. Juntas, a visão computacional e a NLU transformam textos visuais em informações significativas e úteis.
Engenharia de prompts#
A engenharia de prompts é o processo de criar prompts claros, precisos e detalhados para orientar sistemas de IA generativa, como modelos de linguagem grandes (LLMs) e modelos de visão e linguagem (VLMs), a produzir os resultados desejados. Esses prompts funcionam como instruções que ajudam o modelo de IA a compreender a intenção do usuário.
Uma engenharia de prompts eficaz exige compreender os recursos do modelo e elaborar entradas que maximizem sua capacidade de gerar respostas precisas, criativas ou esclarecedoras. Isso é especialmente importante para modelos multimodais que trabalham tanto com texto quanto com imagens.
Veja, por exemplo, o modelo de texto para imagem DALL·E da OpenAI. Se você pedir que ele crie “uma imagem fotorrealista de um astronauta montado em um cavalo”, ele poderá gerar exatamente isso com base na sua descrição. Isso é útil em áreas como o design gráfico, onde profissionais podem transformar rapidamente ideias em texto em maquetes visuais, economizando tempo e aumentando a produtividade.

Fig. 4. Imagem criada com o DALL-E da OpenAI.
Talvez você esteja se perguntando como isso se relaciona com a visão computacional — isso não é simplesmente IA generativa? Na verdade, as duas áreas estão intimamente relacionadas. A IA generativa se baseia nos fundamentos da visão computacional para criar resultados visuais totalmente novos.
Modelos de IA generativa que criam imagens a partir de prompts de texto são treinados com grandes conjuntos de dados de imagens associadas a descrições textuais. Isso permite que aprendam as relações entre a linguagem e conceitos visuais, como objetos, texturas e relações espaciais.
Esses modelos não interpretam dados visuais da mesma forma que os sistemas tradicionais de visão computacional, por exemplo, ao reconhecer objetos em imagens do mundo real. Em vez disso, usam o conhecimento que aprenderam sobre esses conceitos para gerar novos elementos visuais com base nos prompts. Ao combinar esse conhecimento com prompts bem elaborados, a IA generativa pode produzir imagens realistas e detalhadas que correspondem às entradas do usuário.
Perguntas e respostas (QA)#
Os sistemas de perguntas e respostas foram desenvolvidos para entender perguntas em linguagem natural e fornecer respostas precisas e relevantes. Eles usam técnicas como recuperação de informações, compreensão semântica e aprendizado profundo para interpretar e responder às consultas.
Modelos avançados como o GPT-4o da OpenAI podem realizar respostas a perguntas visuais (VQA), ou seja, analisar imagens e responder a perguntas sobre elas. No entanto, o GPT-4o não executa diretamente tarefas de visão computacional. Em vez disso, ele usa um codificador de imagens especializado para processar imagens, extrair características e combiná-las com sua compreensão da linguagem para fornecer respostas.

Fig. 5. Recurso do ChatGPT para responder a perguntas visuais. Imagem do autor.
Outros sistemas podem ir além, integrando completamente recursos de visão computacional. Esses sistemas podem analisar imagens ou vídeos diretamente para identificar objetos, cenas ou texto. Quando combinados com o processamento de linguagem natural, eles conseguem responder a perguntas mais complexas sobre conteúdo visual. Por exemplo, podem responder a “Quais objetos estão nesta imagem?” ou “Quem aparece nesta gravação?”, detectando e interpretando os elementos visuais. Para ver como os modelos atuais de visão e linguagem localizam objetos em imagens, confira o ranking de VLMs.
Aprendizado zero-shot (ZSL)#
O aprendizado zero-shot (ZSL) é um método de aprendizado de máquina que permite que modelos de IA lidem com tarefas novas, nunca vistas, sem serem especificamente treinados para elas. Para isso, ele usa informações adicionais, como descrições ou relações semânticas, para conectar o que o modelo já conhece (classes vistas) a novas categorias que ainda não viu.
No processamento de linguagem natural, o ZSL ajuda os modelos a compreender e trabalhar com tópicos para os quais não foram treinados, com base nas relações entre palavras e conceitos. De maneira semelhante, na visão computacional, o ZSL permite que os modelos reconheçam objetos ou cenas que nunca encontraram antes, relacionando características visuais, como asas ou penas, a conceitos conhecidos, como pássaros.
O ZSL conecta o NLP e a CV ao combinar a compreensão da linguagem com o reconhecimento visual, o que o torna especialmente útil para tarefas que envolvem ambos. Por exemplo, em perguntas e respostas visuais, um modelo pode analisar uma imagem e entender uma pergunta relacionada para fornecer uma resposta precisa. O ZSL também é útil em tarefas como a geração de legendas para imagens.
Principais conclusões#
A integração do processamento de linguagem natural com a visão computacional levou a sistemas de IA capazes de compreender textos e imagens. Essa combinação está sendo usada em diversos setores, desde ajudar carros autônomos a ler placas de trânsito até aprimorar diagnósticos médicos e tornar as redes sociais mais seguras. À medida que essas tecnologias melhoram, elas continuarão facilitando o dia a dia e criando novas oportunidades em diversas áreas. Para saber mais, visite nosso repositório do GitHub e participe da nossa comunidade. Explore aplicações de IA em carros autônomos e na agricultura em nossas páginas de soluções.
Escrito por
Criador de conteúdo · Ultralytics
Comentários
Faça uma pergunta, compartilhe seus resultados ou ajude alguém.









