Exportação do Ultralytics YOLO para LiteRT
Saiba como a nova integração de exportação LiteRT leva a inferência do Ultralytics YOLO para ambientes móveis, embarcados, de borda e de navegador em um formato unificado.
Na Ultralytics, estamos observando uma mudança cada vez maior em direção à execução de modelos de visão computacional diretamente nos dispositivos onde são necessários, em vez de depender de uma conexão com a nuvem. Aplicativos móveis, sistemas embarcados, sensores de IoT e ferramentas baseadas em navegador precisam cada vez mais executar inferências localmente, muitas vezes em hardware com orçamentos limitados de energia e capacidade computacional. Por isso, estamos animados para anunciar que agora é possível exportar modelos Ultralytics YOLO diretamente para LiteRT.
Atender a essa demanda exige um formato de modelo que funcione em todos esses ambientes sem obrigar os desenvolvedores a manter pipelines de exportação separados para cada um.
Essa capacidade já existia por meio de um pacote não oficial de terceiros, mas essa nova integração é resultado de uma colaboração oficial com o Google. Trabalhamos em estreita colaboração com a equipe do LiteRT para criar um pipeline de ponta a ponta para exportar modelos Ultralytics YOLO para TFLite via LiteRT. Com essa integração, um único modelo Ultralytics YOLO exportado pode ser implantado em ambientes móveis, embarcados, de borda e de navegador, unificando o que os formatos de exportação TFLite e TF.js anteriores tratavam separadamente em um único formato simplificado.
O que é LiteRT?#
LiteRT (abreviação de Lite Runtime) é o runtime de alto desempenho do Google para IA no dispositivo. É a próxima geração e o novo nome do TensorFlow Lite (TFLite), e executa o mesmo formato de modelo .tflite que os desenvolvedores já conhecem.
LiteRT é uma estrutura de código aberto projetada especificamente para inferência no dispositivo, também conhecida como computação de borda. Ela oferece aos desenvolvedores ferramentas para executar modelos treinados em dispositivos móveis, embarcados e de IoT, computadores tradicionais e, por meio do LiteRT.js, diretamente em navegadores e no Node.js. O formato de exportação LiteRT otimiza modelos para tarefas como detecção de objetos, segmentação, estimativa de pose e classificação, para que sejam executados rapidamente e offline em uma ampla variedade de dispositivos.
Por que exportar modelos Ultralytics YOLO para LiteRT?#
Agora, um único formato de modelo atende a todos os alvos de implantação:
• Dispositivos móveis e embarcados. Android, iOS, Desktop, Linux embarcado e microcontroladores (MCUs).
• Aceleradores de borda. Compatível com o Coral Edge TPU para acelerar ainda mais.
• Navegador e Node.js. O LiteRT.js executa o mesmo modelo .tflite na Web com aceleração WebGPU/WASM, eliminando a necessidade de uma exportação separada para TensorFlow.js.
• Desktop
Essa consolidação é importante porque elimina uma fonte real de atrito nas implantações em produção. Em vez de manter um pipeline de exportação para dispositivos móveis, outro para o navegador e um terceiro para aceleradores de borda, as equipes agora podem exportar uma vez e implantar em qualquer lugar onde o LiteRT seja executado.
Principais recursos dos modelos LiteRT#
• Otimização no dispositivo. Reduz a latência ao processar dados localmente, aumenta a privacidade ao não transmitir dados pessoais e minimiza o tamanho do modelo para economizar espaço.
• Suporte a várias plataformas. Executa no Android, iOS, Linux embarcado, microcontroladores e navegadores modernos.
• Aceleração de hardware. Aproveita o XNNPACK na CPU e a aceleração da GPU via OpenCL, Metal e WebGPU. Por padrão, a aceleração da GPU é executada em FP16 para oferecer ainda mais velocidade.
• Quantização. Compatível com FP32, INT8 estático, ativação INT16 estática e INT8 dinâmico para compactar modelos e acelerar a inferência com perda mínima de precisão.
• Suporte a diversas linguagens. Compatível com Java/Kotlin, Swift, Objective-C, C++, Python e JavaScript.
Primeiros passos com a exportação para LiteRT#
O pacote Ultralytics para Python e a Ultralytics Platform oferecem um ambiente completo e unificado para treinar, avaliar e implantar modelos YOLO nas cinco tarefas de visão computacional. O formato de exportação LiteRT é compatível com os modos Export, Predict e Validate, para que um modelo possa ser exportado e, em seguida, usado imediatamente para inferência ou validação local da precisão.
A exportação de um modelo exige apenas um comando:
from ultralytics import YOLO

# Carregar um modelo YOLO26
model = YOLO("yolo26n.pt")

# Exporte o modelo para o formato LiteRT
model.export(format="litert") # cria 'yolo26n.tflite'
Para equipes que implantam em hardware com recursos limitados, o LiteRT também é compatível com a exportação quantizada, permitindo compactar modelos para acelerar a inferência com perda mínima de precisão:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

# INT8 dinâmico: pesos int8, ativações FP32 - não são necessários dados de calibração
model.export(format="litert", quantize="w8a32")

# INT8 estático: pesos int8 + ativações int8 - requer dados de calibração
model.export(format="litert", quantize=8, data="coco8.yaml")
Após a exportação, é possível carregar o modelo e executá-lo diretamente para inferência:
from ultralytics import YOLO

# Carregue o modelo LiteRT exportado
model = YOLO("yolo26n.tflite")

# Executar inferência
results = model("https://ultralytics.com/images/bus.jpg")
Atualmente, a exportação para LiteRT é compatível com Linux x86_64 e macOS. O próprio modelo .tflite exportado é executado em todas as plataformas compatíveis com LiteRT, incluindo dispositivos móveis, embarcados, de borda e navegadores.
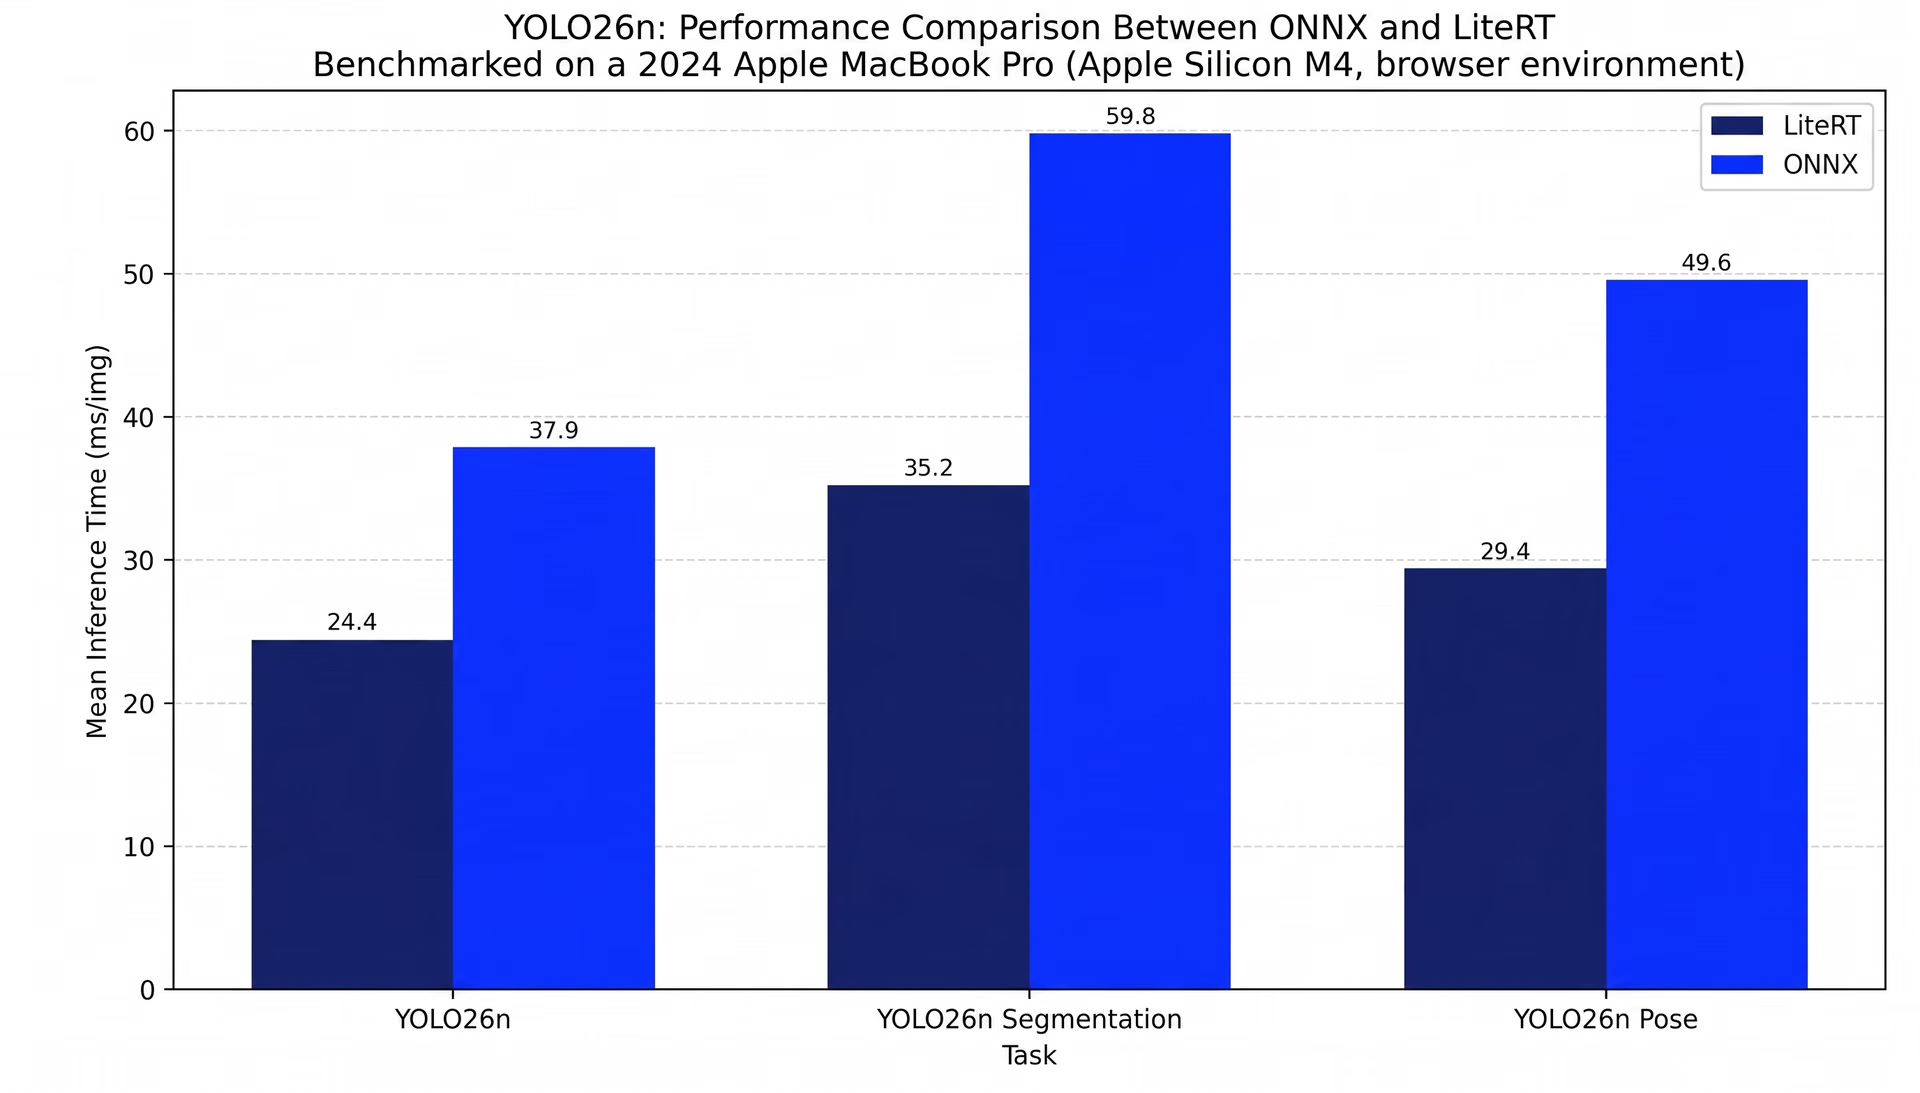 Fig. 1. Comparação de desempenho entre ONNX e LiteRT.
A imagem acima apresenta uma comparação do tempo médio de inferência para detecção, segmentação e estimativa de pose no YOLO26n, executado no navegador por meio de @ultralytics/yolo, o pacote npm da Ultralytics para inferência no cliente com WebGPU/WASM via ONNX Runtime Web. Testado em um Apple MacBook Pro de 2024 (Apple Silicon M4), em um ambiente de navegador controlado.
Levando Ultralytics YOLO para a borda#
Com o LiteRT, implantar modelos Ultralytics YOLO em ambientes móveis, embarcados, de borda e de navegador não exige mais pipelines de exportação separados para cada alvo. Uma exportação, um formato de modelo e um caminho consistente do treinamento à produção, onde quer que a inferência precise acontecer.
Tem curiosidade sobre IA de visão? Descubra nossas opções de licenciamento para levar a visão computacional aos seus projetos. Acesse nosso repositório no GitHub para explorar toda a variedade de integrações de exportação da Ultralytics e confira a Ultralytics Platform para começar a criar seus próprios fluxos de trabalho de IA de visão de ponta a ponta.









