Florence-2: o mais recente modelo de visão e linguagem da Microsoft
Conheça o Florence-2, o modelo de visão e linguagem da Microsoft para deteção de objetos, segmentação, legendagem e fundamentação, com um forte desempenho zero-shot.
 Abirami Vina9 min de leitura
Em junho de 2024, a Microsoft apresentou o Florence-2, um modelo multimodal de visão e linguagem (VLM) concebido para lidar com uma vasta gama de tarefas, incluindo deteção de objetos, segmentação, legendagem de imagens e fundamentação. O Florence-2 estabelece uma nova referência no desempenho zero-shot, o que significa que consegue executar tarefas sem treino específico prévio, e tem um tamanho de modelo inferior ao de outros modelos de visão e linguagem de ponta.
O Florence-2 é mais do que apenas mais um modelo. A sua versatilidade e o seu melhor desempenho podem ter um impacto significativo em vários setores, melhorando a precisão e reduzindo a necessidade de treino extensivo. Neste artigo, vamos explorar as principais funcionalidades do Florence-2, comparar o seu desempenho com o de outros VLMs e abordar as suas potenciais aplicações.
O que é o Florence-2?#
O Florence-2 consegue executar várias tarefas numa única estrutura unificada. As capacidades do modelo devem-se, em parte, ao seu grande conjunto de dados de treino, denominado FLD-5B. O FLD-5B inclui 5,4 mil milhões de anotações em 126 milhões de imagens. Este conjunto de dados abrangente foi criado especificamente para dotar o Florence-2 das capacidades necessárias para executar uma vasta gama de tarefas de visão com elevada precisão e eficiência.
Veja mais de perto as tarefas compatíveis com o Florence-2:
- Detecção de objetos: O modelo pode identificar e localizar objetos em imagens com alta precisão.
- Segmentação: Essa tarefa consiste em dividir uma imagem em segmentos significativos para facilitar a análise e a interpretação.
- Geração de legendas para imagens: O Florence-2 é capaz de gerar legendas descritivas para imagens, fornecendo contexto e detalhes.
- Localização visual: O modelo pode associar frases ou palavras específicas de uma legenda às regiões correspondentes da imagem.
- Desempenho zero-shot: O modelo pode realizar tarefas sem treinamento específico.
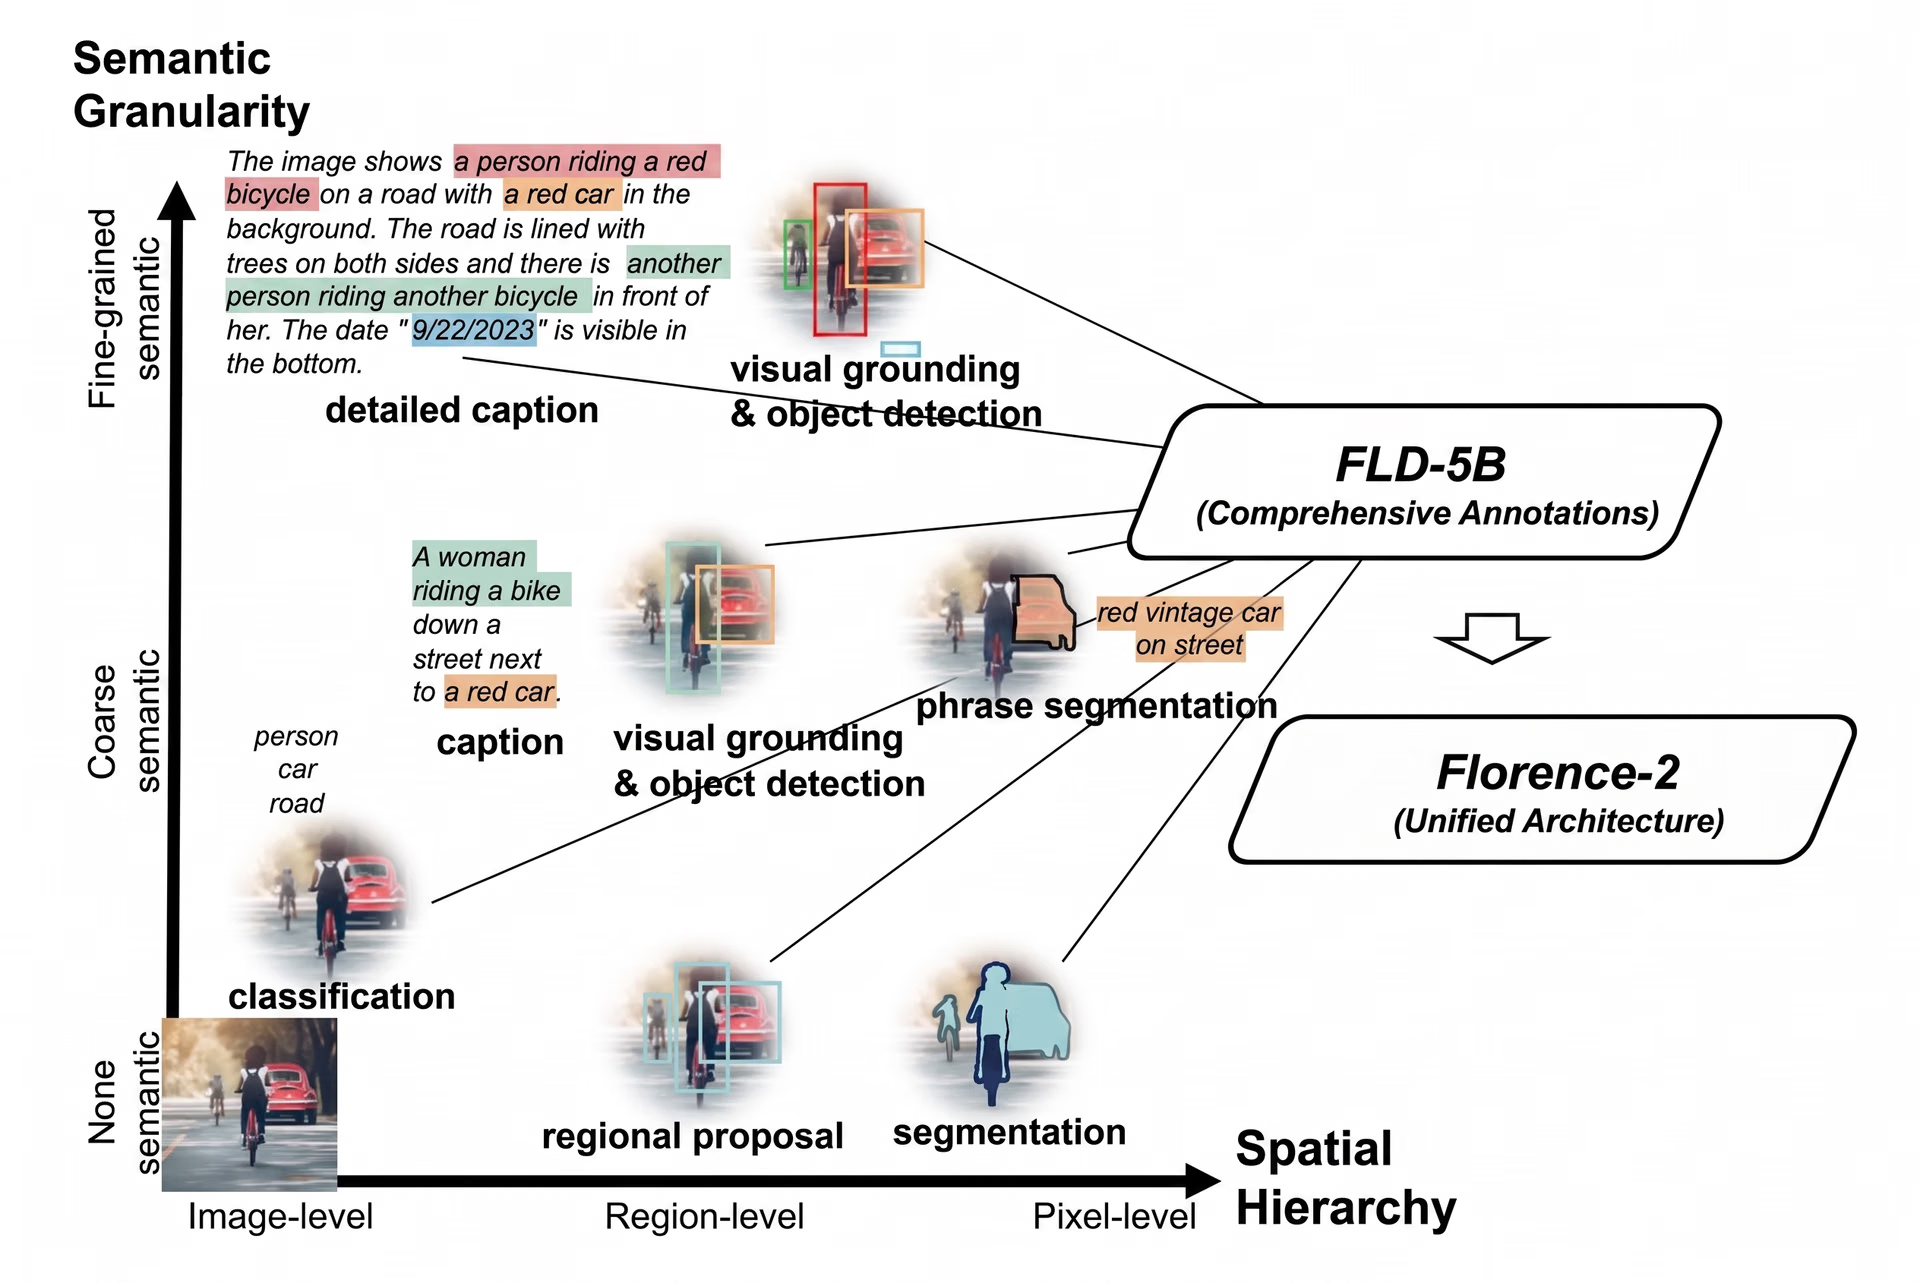
Fig. 1 Compreender como o Florence-2 foi treinado.
O modelo suporta tarefas baseadas em texto e em regiões. São adicionados tokens especiais de localização ao vocabulário do modelo para tarefas que envolvem regiões específicas de uma imagem. Estes tokens ajudam o modelo a compreender diferentes formas, como retângulos à volta de objetos (representação por caixas), formas de quatro lados (representação por caixas quadriláteras) e formas com vários lados (representação por polígonos). O modelo é treinado com uma função de perda de entropia cruzada padrão, que o ajuda a aprender comparando as previsões com as respostas corretas e ajustando os parâmetros internos em conformidade.
Criação do conjunto de dados FLD-5B#
O conjunto de dados FLD-5B inclui vários tipos de anotações: descrições de texto, pares de regiões e texto, e combinações de texto, expressões e regiões. Foi criado através de um processo de duas etapas que envolveu a recolha e anotação de dados. As imagens foram obtidas em conjuntos de dados populares, como ImageNet-22k, Objects365, Open Images, Conceptual Captions e LAION. As anotações do conjunto de dados FLD-5B são maioritariamente sintéticas, ou seja, foram geradas automaticamente em vez de serem rotuladas manualmente.
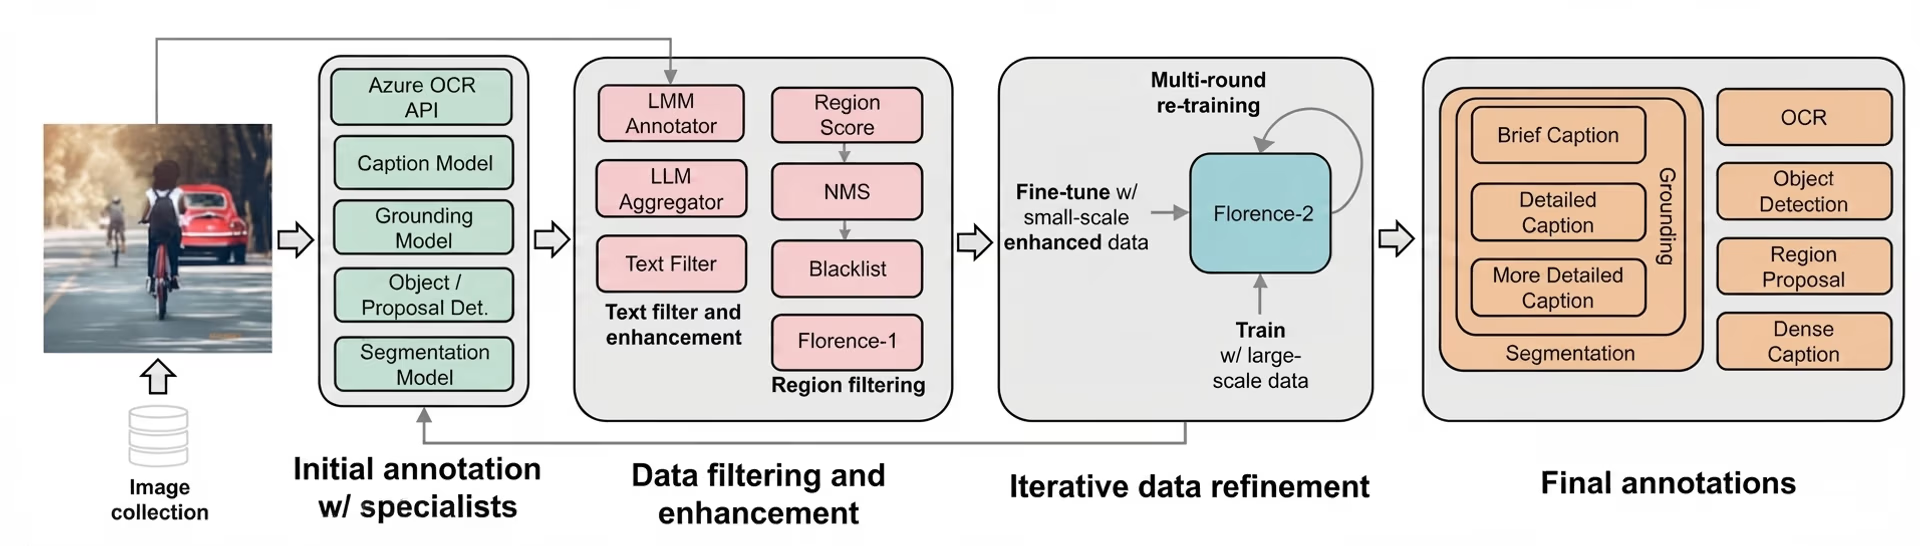
Fig. 2 Criação do conjunto de dados FLD-5B.
Inicialmente, modelos especializados em tarefas específicas, como detecção de objetos ou segmentação, criaram essas anotações. Em seguida, um processo de filtragem e aprimoramento foi usado para garantir que as anotações fossem detalhadas e precisas. Após a remoção de ruídos, o conjunto de dados passou por um refinamento iterativo, no qual as saídas do Florence-2 foram usadas para atualizar e aprimorar continuamente as anotações.
Entendendo a arquitetura do modelo Florence-2#
A arquitetura do Florence-2 segue uma abordagem de aprendizado sequência a sequência. Isso significa que o modelo processa uma sequência de entrada (como uma imagem com um prompt de texto) e gera uma sequência de saída (como uma descrição ou um rótulo) passo a passo. Na estrutura sequência a sequência, cada tarefa é tratada como um problema de tradução: o modelo recebe uma imagem de entrada e um prompt específico para a tarefa e gera a saída correspondente.
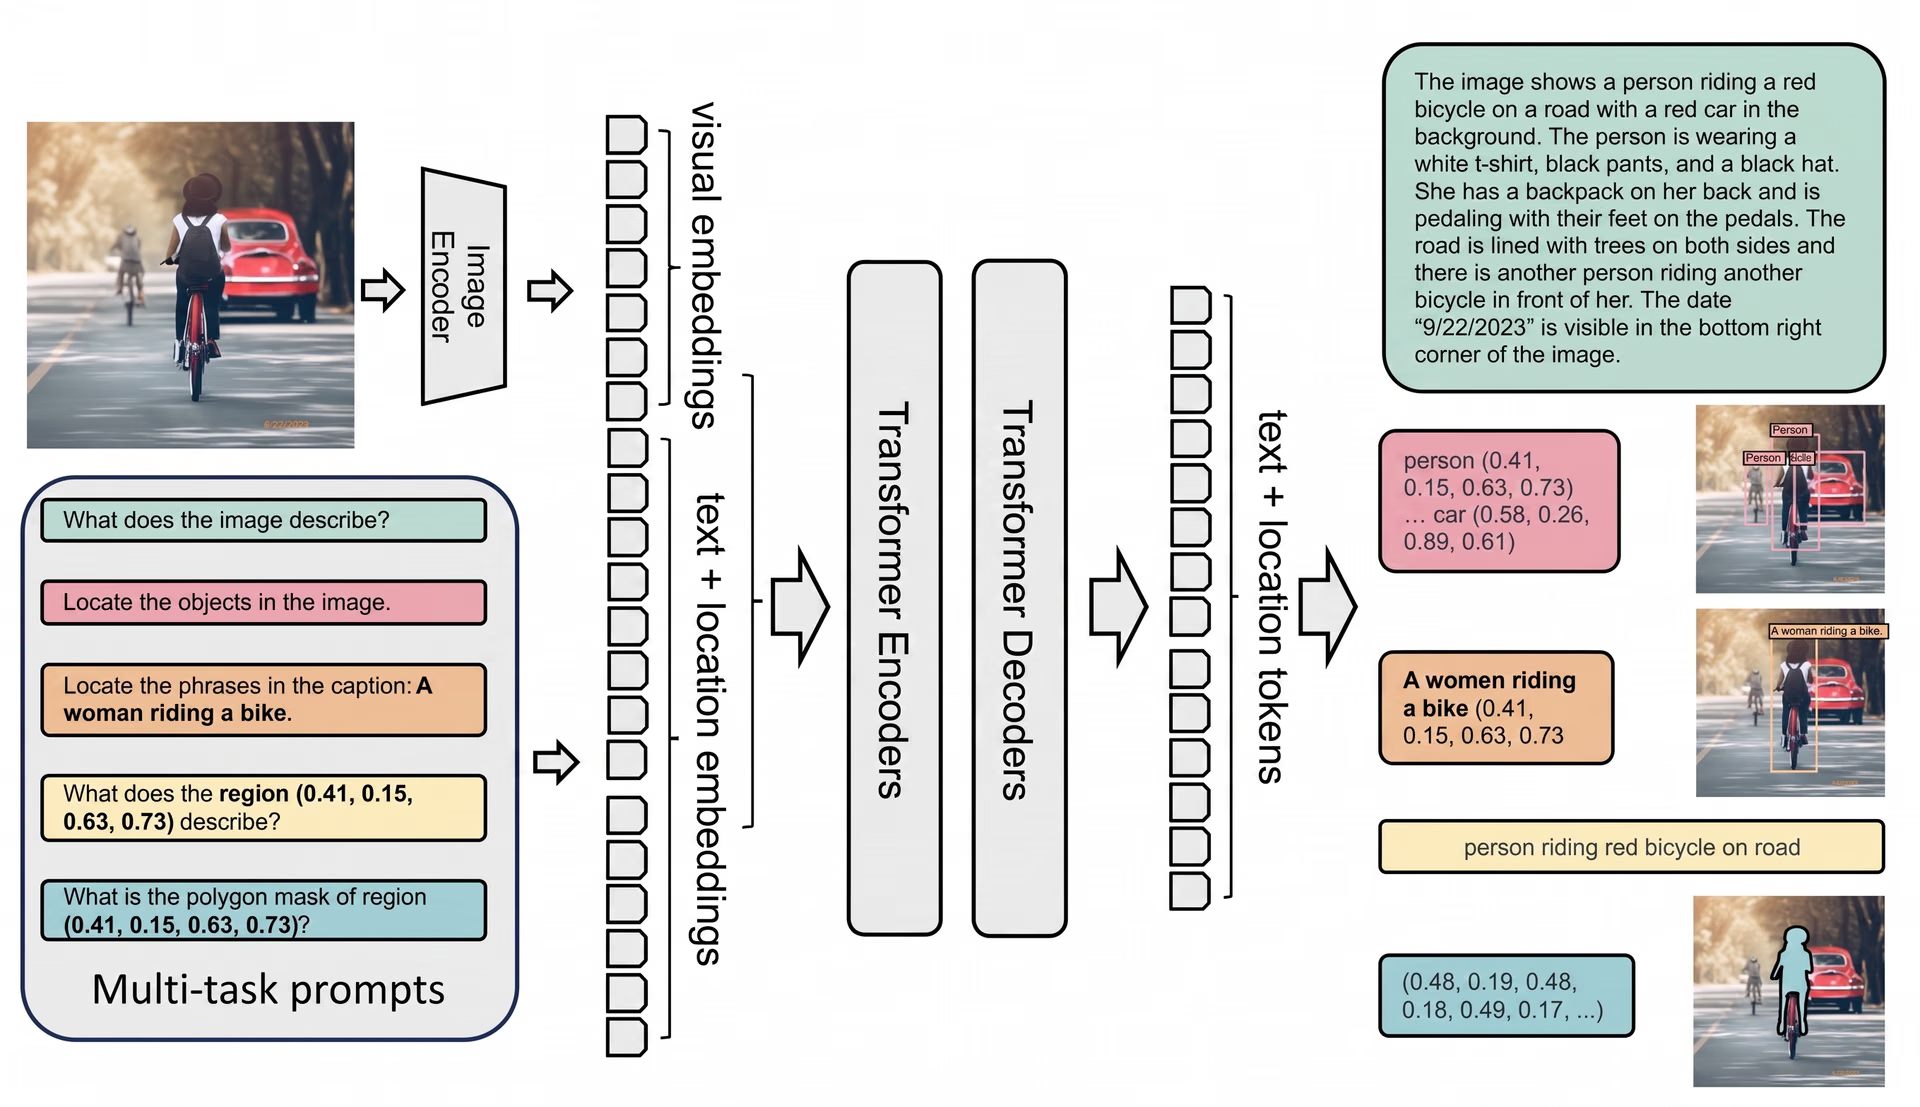
Fig. 3 Arquitetura do modelo de visão e linguagem Florence-2.
No centro da arquitetura do modelo está um Transformer codificador-decodificador multimodal, que combina um codificador de imagens e um codificador-decodificador multimodal. O codificador de imagens, chamado DaViT (Dual Attention Vision Transformer), processa as imagens de entrada convertendo-as em embeddings de tokens visuais — representações compactas da imagem que capturam informações espaciais (onde as coisas estão) e semânticas (o que as coisas são). Esses tokens visuais são então combinados com embeddings de texto (representações do texto), permitindo que o modelo mescle dados textuais e visuais.
Comparação do Florence-2 com outros VLMs#
O Florence-2 distingue-se de outros modelos de visão e linguagem pelas suas fortes capacidades zero-shot. Ao contrário de modelos como o PaliGemma, que dependem de um ajuste fino extensivo para se adaptarem a várias tarefas, o Florence-2 funciona bem logo à partida. Além disso, o Florence-2 consegue competir com modelos maiores, como o GPT-4V e o Flamingo, que muitas vezes têm muito mais parâmetros, mas nem sempre igualam o desempenho do Florence-2. Por exemplo, o Florence-2 obtém melhores resultados zero-shot do que o Kosmos-2, apesar de o Kosmos-2 ter mais do dobro dos parâmetros.
Em testes de referência, o Florence-2 demonstrou um desempenho sólido em tarefas como a legendagem no COCO e a compreensão de expressões referenciais. Superou modelos como o PolyFormer e o UNINEXT em tarefas de deteção e segmentação de objetos no conjunto de dados COCO. É uma opção muito competitiva para aplicações do mundo real em que o desempenho e a eficiência de recursos são cruciais. Podes anotar automaticamente conjuntos de dados de deteção com o Florence-2 na Ultralytics Platform e compará-lo com outros modelos de visão e linguagem no VLM Leaderboard.
Aplicações do Florence-2#
Florence-2 pode ser usado em muitos setores diferentes, como entretenimento, acessibilidade, educação etc. Vamos ver alguns exemplos para entender melhor.
Aplicações da geração de legendas para imagens#
Quando você está em uma plataforma de streaming tentando decidir o que assistir, talvez leia o resumo de um filme para ajudar na escolha. E se a plataforma também pudesse fornecer uma descrição detalhada do pôster do filme? O Florence-2 pode tornar isso possível com a geração de legendas para imagens, que cria textos descritivos para imagens. O Florence-2 pode gerar descrições detalhadas de pôsteres de filmes, tornando as plataformas de streaming mais inclusivas para pessoas com deficiência visual. Ao analisar os elementos visuais de um pôster, como personagens, cenários e texto, o Florence-2 pode criar descrições detalhadas que transmitam o conteúdo e o clima do pôster. A imagem abaixo mostra o nível de detalhe que o Florence-2 pode fornecer em sua descrição.
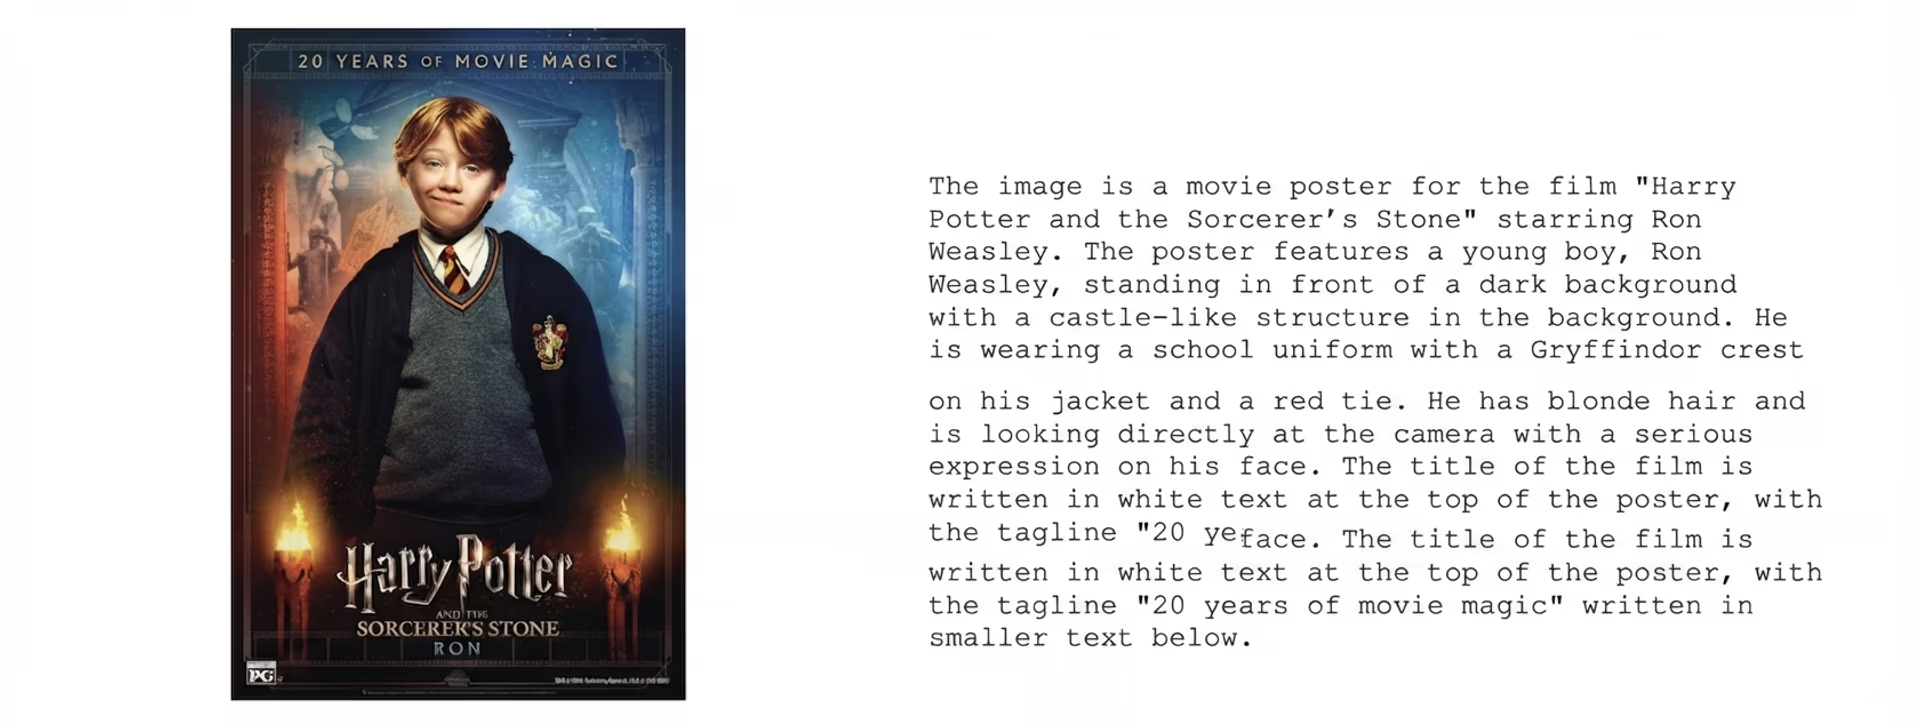
Fig. 4. Exemplo de legenda para imagem gerada pelo Florence-2.
Veja outros exemplos de situações em que a geração de legendas para imagens pode ser útil:
- Comércio eletrónico: a legendagem de imagens pode fornecer descrições detalhadas de imagens de produtos, ajudando os clientes a compreender melhor as funcionalidades e os detalhes dos produtos.
- Viagens e turismo: Ela pode fornecer descrições detalhadas de pontos turísticos e atrações em guias e aplicativos de viagem.
- Educação: A geração de legendas para imagens pode rotular e descrever imagens e diagramas educacionais, ajudando no ensino e no aprendizado.
- Imóveis: Ela pode fornecer descrições detalhadas de imagens de imóveis, destacando recursos e comodidades para possíveis compradores.
Uso da localização visual durante o preparo de alimentos#
O Florence-2 também pode ser usado para enriquecer experiências culinárias. Por exemplo, um livro de receitas online poderia usar o Florence-2 para localizar visualmente e rotular partes de uma imagem complexa de uma receita. A localização visual ajuda ao conectar partes específicas da imagem ao texto descritivo correspondente. Cada ingrediente e etapa pode ser rotulado e explicado com precisão, facilitando o acompanhamento da receita por quem cozinha em casa e ajudando a entender o papel de cada componente no prato.
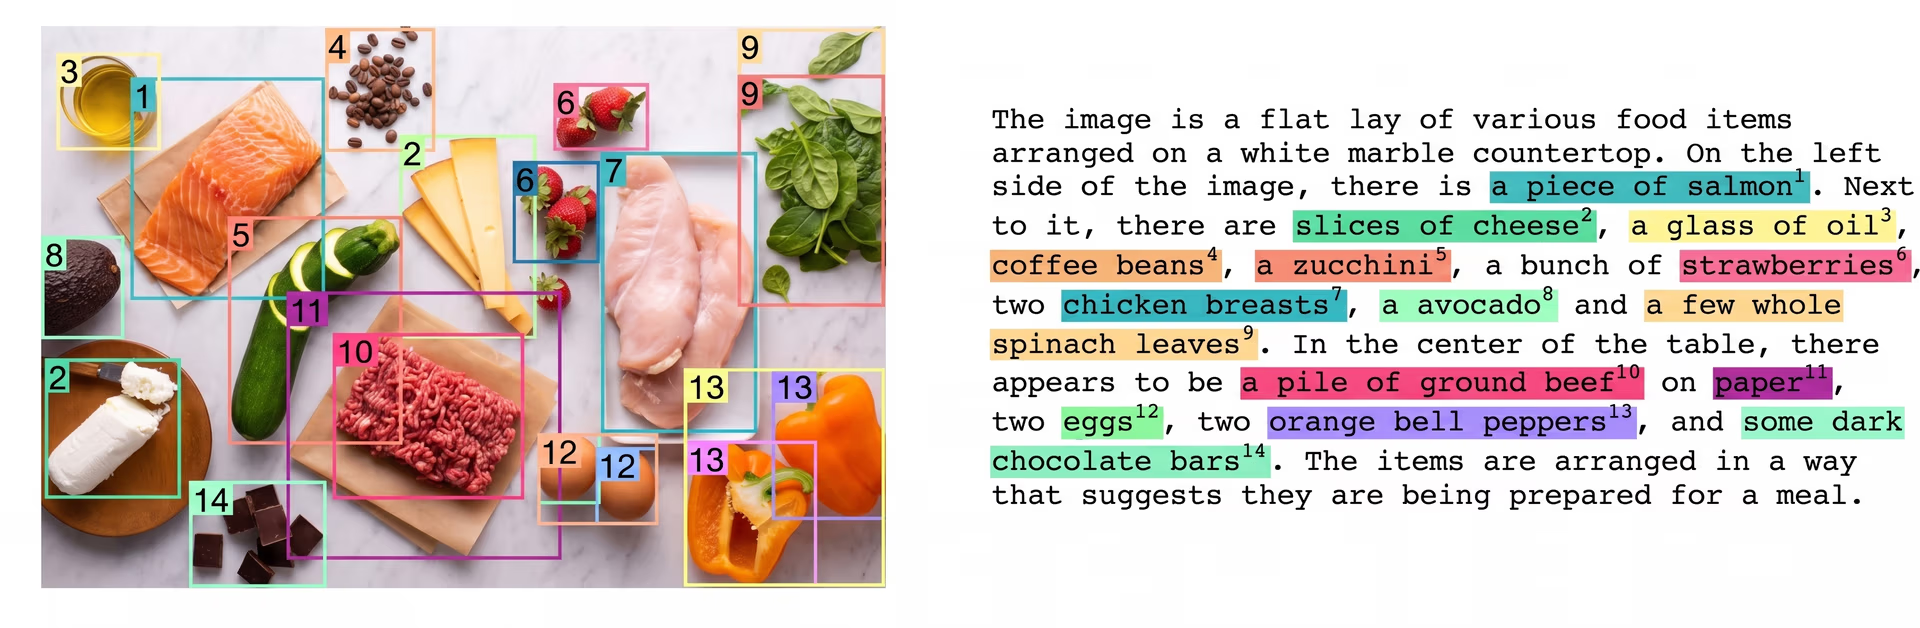
Fig. 5. Exemplo de localização visual usando o Florence-2.
OCR baseado em regiões para documentos financeiros#
O OCR com processamento baseado em regiões, que se concentra na extração de texto de áreas específicas de um documento, pode ser útil em áreas como a contabilidade. Áreas designadas de documentos financeiros podem ser analisadas para extrair automaticamente informações importantes, como detalhes de transações, números de contas e datas de vencimento. Ao reduzir a necessidade de inserção manual de dados, essa abordagem minimiza erros e acelera o processamento. Instituições financeiras podem usá-la para simplificar tarefas como o processamento de faturas, a conciliação de recibos e a compensação de cheques, agilizando as transações e melhorando o atendimento ao cliente.
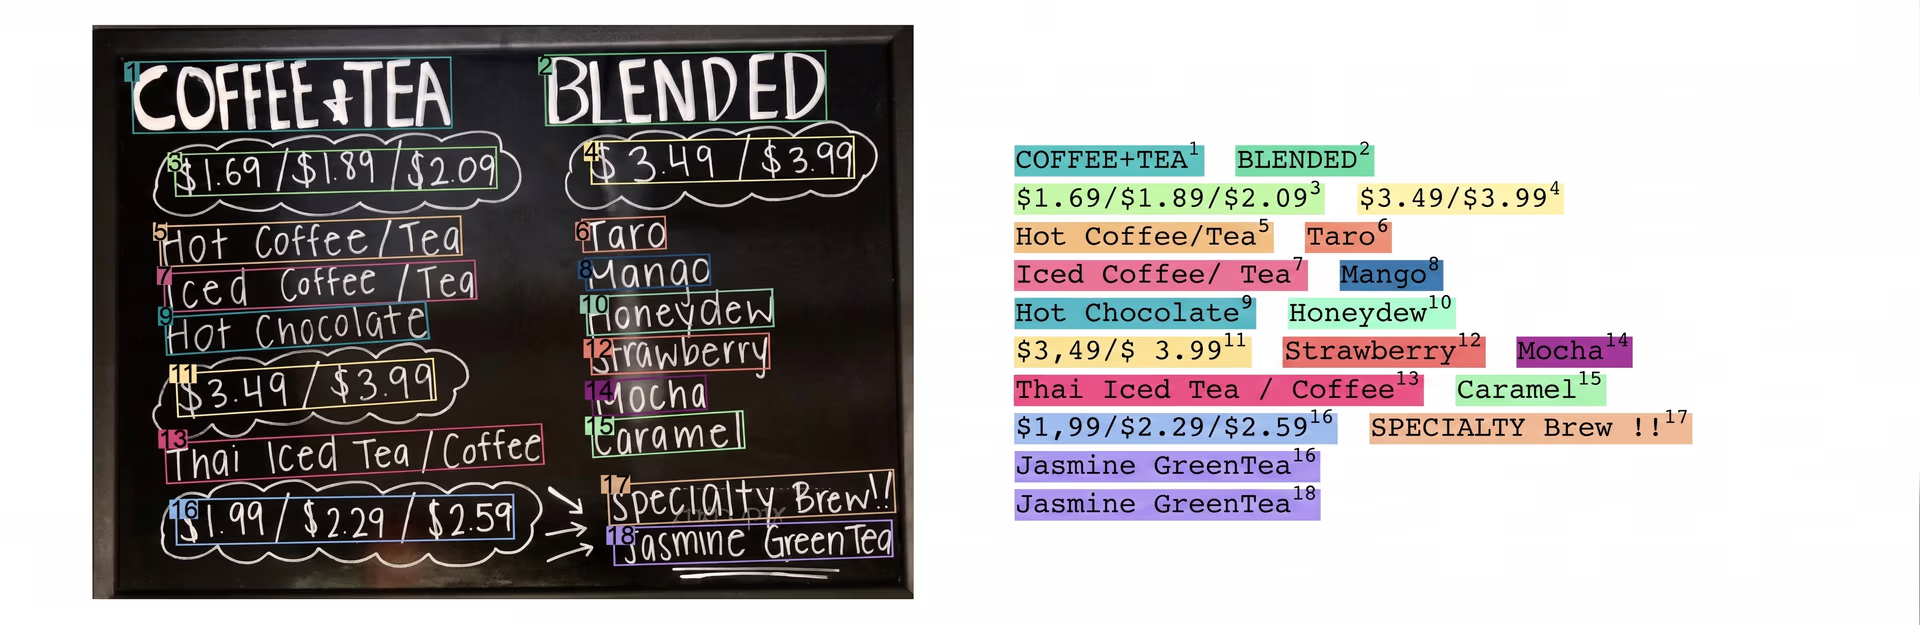
Fig. 6. Exemplo de extração de OCR baseada em regiões usando o Florence-2.
Segmentação baseada em regiões em aplicações industriais#
A segmentação baseada em regiões, que consiste em dividir uma imagem em partes significativas para realizar análises direcionadas e inspeções detalhadas, pode impulsionar aplicações industriais que melhoram a precisão e a eficiência de vários processos. Ao se concentrar em áreas específicas de uma imagem, essa tecnologia permite a inspeção e a análise detalhadas de componentes e produtos. No controle de qualidade, ela pode identificar defeitos ou inconsistências nos materiais, como rachaduras ou desalinhamentos, garantindo que apenas produtos de alta qualidade cheguem ao mercado.
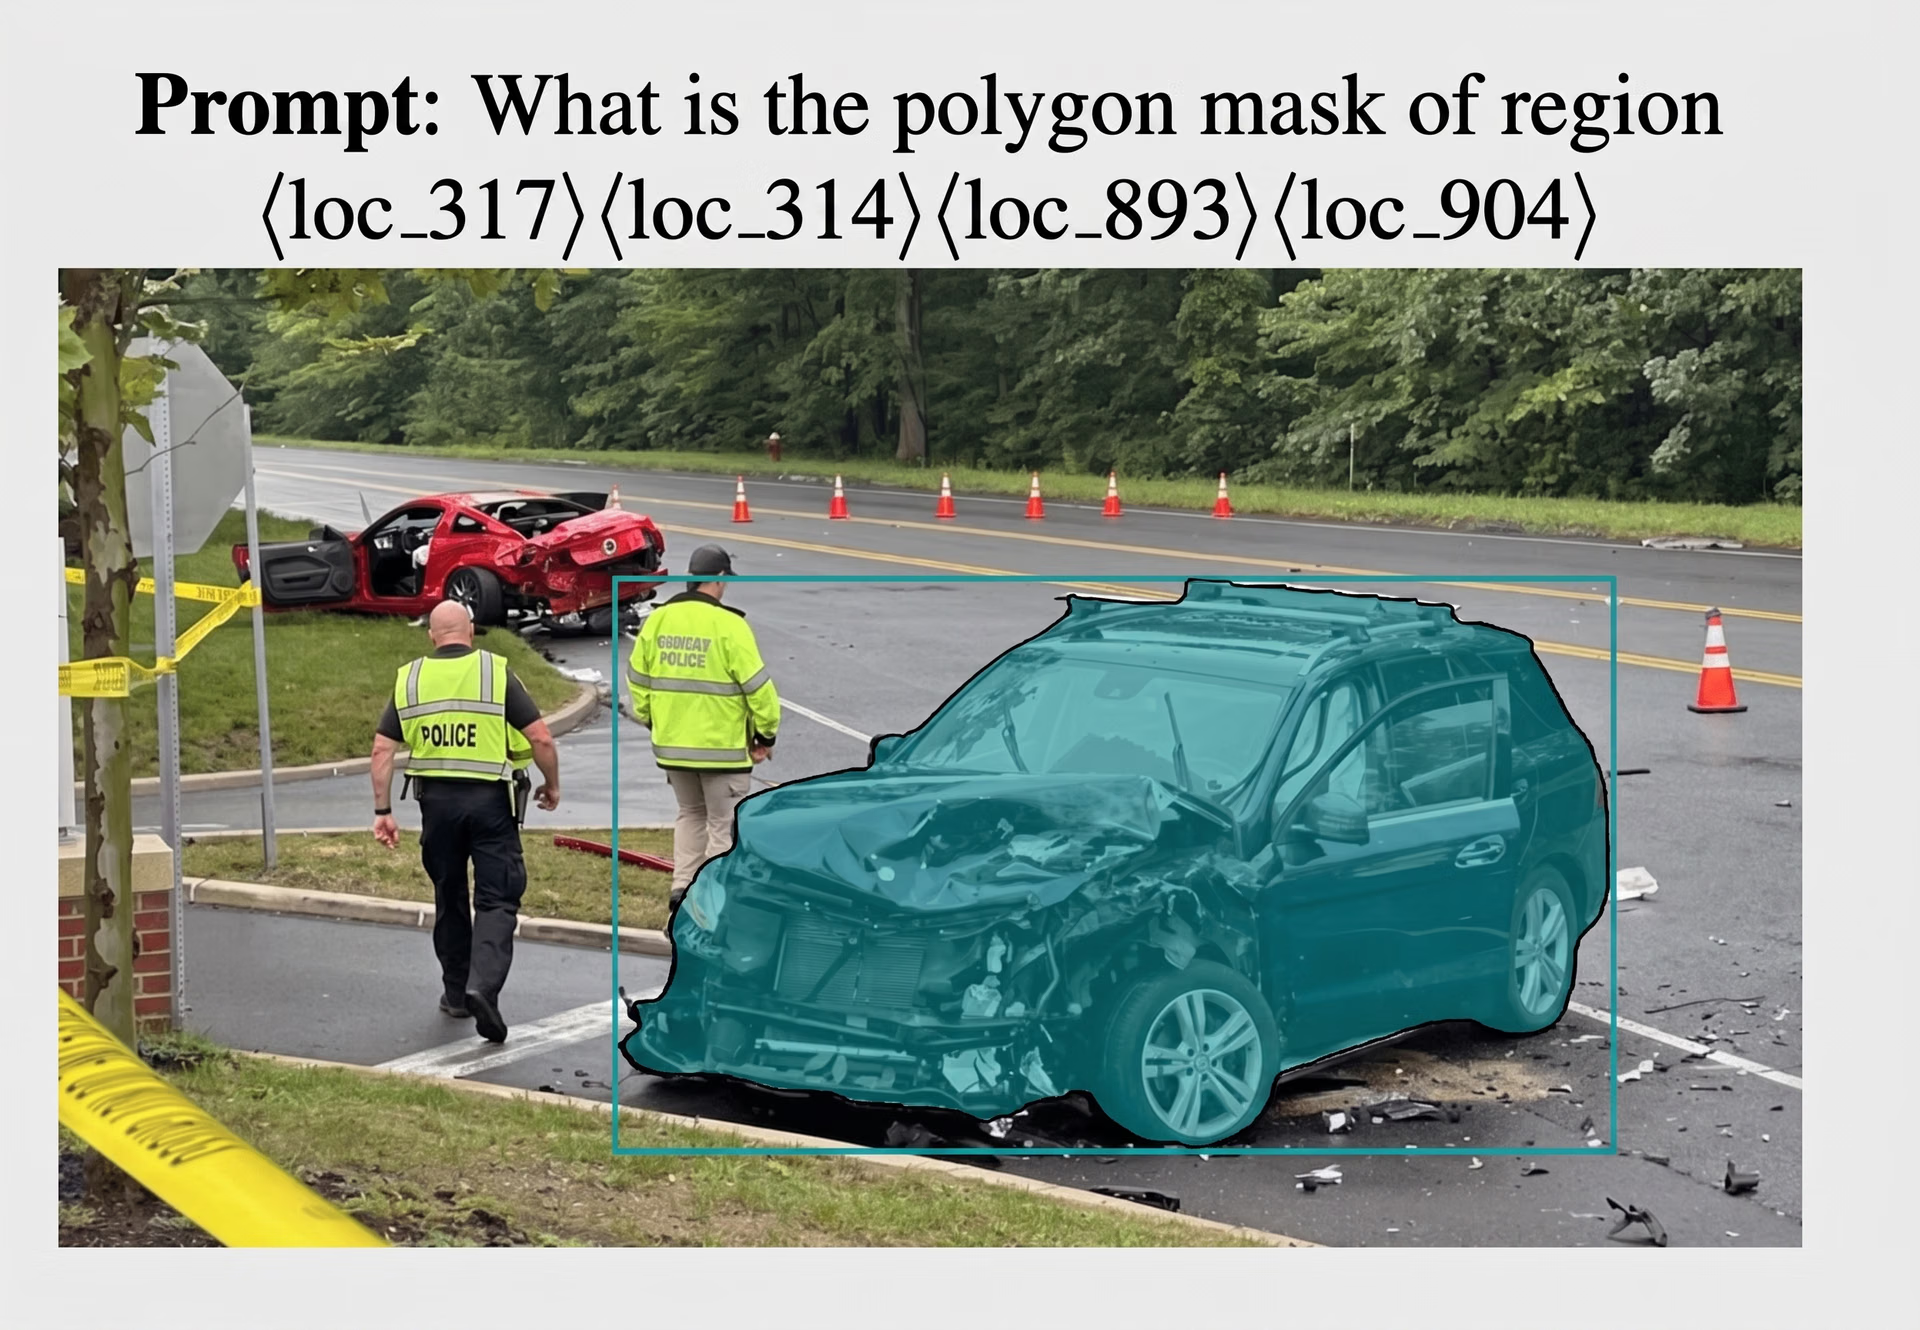
Fig. 7. Exemplo de segmentação baseada em regiões usando o Florence-2.
Ela também aprimora as linhas de montagem automatizadas, orientando braços robóticos até peças específicas e otimizando o posicionamento e a montagem dos componentes. Da mesma forma, na gestão de estoque, ela ajuda a rastrear e monitorar as condições e a localização das mercadorias, resultando em uma logística mais eficiente e menos tempo de inatividade. De modo geral, a segmentação baseada em regiões aumenta a precisão e a produtividade, reduzindo custos e elevando a qualidade dos produtos em ambientes industriais.
Principais conclusões#
Começamos a observar uma tendência para modelos de IA mais leves que mantêm um elevado desempenho. O Florence-2 representa um grande avanço para os modelos de visão e linguagem. Consegue executar várias tarefas, como deteção de objetos, segmentação, legendagem de imagens e fundamentação, com um desempenho zero-shot impressionante. Apesar do tamanho reduzido, o Florence-2 é eficiente e multifuncional, o que o torna útil em aplicações de vários setores. Modelos como o Florence-2 estão a abrir novas possibilidades e a ampliar o potencial da inovação em IA.
Descobre mais sobre IA visitando o nosso repositório no GitHub e juntando-te à nossa comunidade. Consulta as nossas páginas de soluções para saberes mais sobre aplicações de IA na indústria transformadora e na agricultura.
Escrito por
Criador de conteúdo · Ultralytics
Comentários
Faça uma pergunta, compartilhe seus resultados ou ajude alguém.









