O Ultralytics YOLO26 agora oferece suporte à estimativa monocular de profundidade
Saiba como a nova tarefa de estimativa de profundidade do Ultralytics YOLO26 prevê profundidade métrica por pixel a partir de uma única imagem RGB, sem precisar de um sistema estéreo ou LiDAR.
Até agora, adicionar profundidade a um fluxo de trabalho YOLO significava montá-lo por conta própria. O padrão estabelecido era usar YOLO para detecção e combiná-lo com um modelo de profundidade separado de outro projeto, como MiDaS ou Depth Anything. Isso significava uma segunda dependência, uma segunda estrutura e dois conjuntos de formatos de entrada e saída para compatibilizar.
A estimativa monocular de profundidade agora é uma tarefa nativa no Ultralytics YOLO26. Uma única imagem RGB produz um valor de distância para cada pixel, usando o mesmo pacote, fluxo de trabalho e caminho de exportação que a detecção, a segmentação e a pose.
O que é estimativa de profundidade?#
A estimativa de profundidade prevê um mapa de profundidade por pixel a partir de uma única imagem RGB, sem precisar de uma segunda câmera ou de sensores adicionais. Cada pixel de saída contém um valor de profundidade em metros, que representa a distância estimada entre a câmera e aquele ponto da superfície.
A saída é um mapa denso de ponto flutuante com forma (H, W), alinhado à entrada, em que cada pixel contém uma distância absoluta em metros; uma distância em relação à câmera, não uma ordenação relativa do que está mais perto ou mais longe.
A profundidade é uma tarefa independente, com seu próprio checkpoint, e sua única saída é o mapa de profundidade; ela não retorna caixas delimitadoras nem máscaras de segmentação. Portanto, combinar detecção com profundidade exige executar dois modelos e duas passagens de inferência. A diferença em relação à prática anterior é que agora ambos estão em um único pacote, compartilhando uma instalação, uma interface de treinamento e predição, um caminho de exportação e uma única versão para acompanhar, em vez de exigir a manutenção de uma segunda estrutura junto à primeira.
Essa saída por pixel é o que torna a profundidade útil para detectar obstáculos e espaço livre, verificar folgas, compreender a disposição da cena e entender o que está à frente de quê.
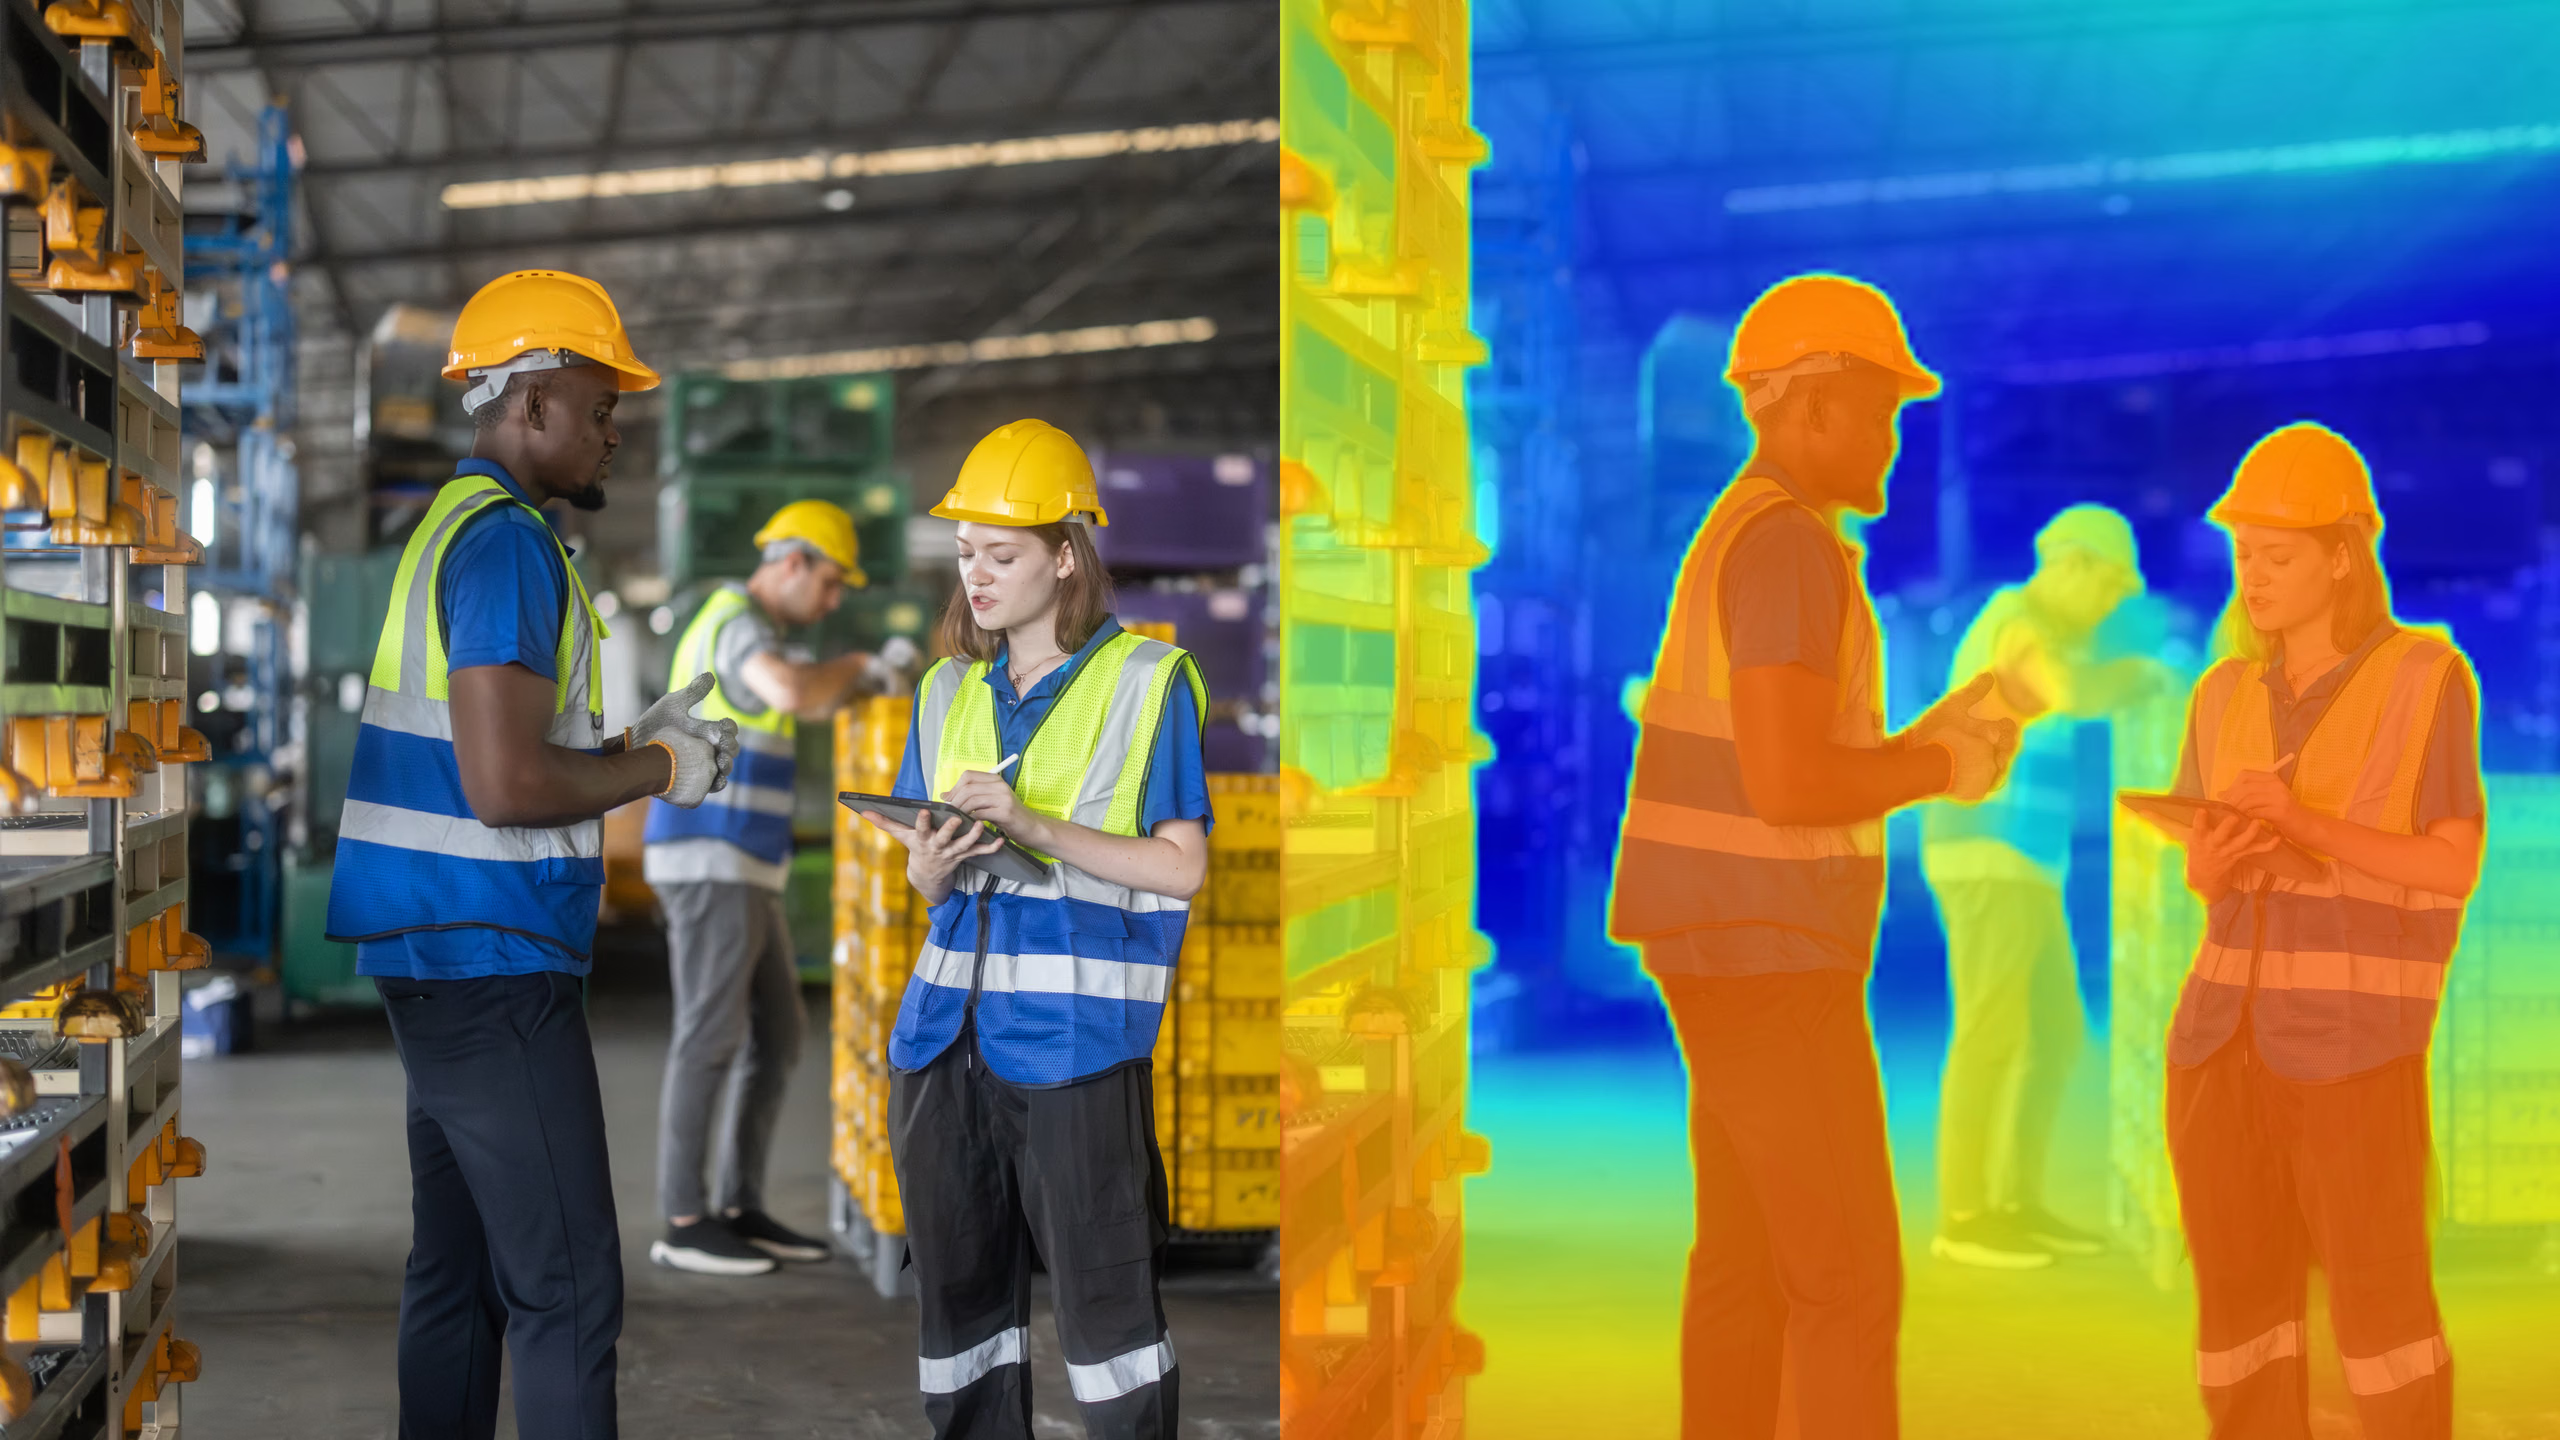 Fig. 1. Estimativa de profundidade do Ultralytics YOLO26 para monitorização de segurança e conformidade.
O Ultralytics YOLO26 inclui cinco modelos de profundidade pré-treinados, desde yolo26n-depth até yolo26x-depth, treinados com uma ampla mistura de vários conjuntos de dados, que abrange cerca de 2,19 milhões de imagens interiores e exteriores. No conjunto NYU Depth V2, os modelos variam entre uma precisão δ1 de 0,882 no modelo nano e 0,933 no modelo extra-large, permitindo escolher o equilíbrio entre velocidade e precisão adequado ao teu destino de implementação.
Profundidade ilimitada por definição#
A maioria dos modelos de profundidade limita as previsões a um intervalo fixo, como 0–10 metros, o que funciona bem em cenas interiores, mas falha em exteriores. Em vez disso, o Ultralytics prevê a profundidade numa escala logarítmica sem limite definido.
A diferença fica evidente nos testes. Um modelo com limite estabiliza quase imediatamente quando é treinado com dados mistos de interiores e exteriores e tem um desempenho muito fraco em conjuntos de dados de maior alcance, como o KITTI, onde os objetos podem estar a 80 metros de distância. A abordagem do Ultralytics YOLO26 não tem esse limite, por isso continua a melhorar com mais dados e funciona bem desde alguns centímetros até algumas centenas de metros. No KITTI, δ1 chega a 0,942 a 80 m de alcance. Isto significa que uma família de modelos lida igualmente bem com uma cena de mesa e uma cena de autoestrada.
Comparação entre a profundidade do Ultralytics YOLO26 e o Depth Anything V2#
Se atualmente executas o Depth Anything juntamente com o YOLO, a diferença está na velocidade e nos custos computacionais associados. A estimativa de profundidade do Ultralytics YOLO26 é até 20,3× mais rápida do que o Depth Anything V2 Base e 7,7× mais rápida do que o Depth Anything V2 Small, com um modelo muito menor: menos de 10 milhões de parâmetros na versão nano, contra cerca de 24 milhões no checkpoint mais pequeno do DA V2.
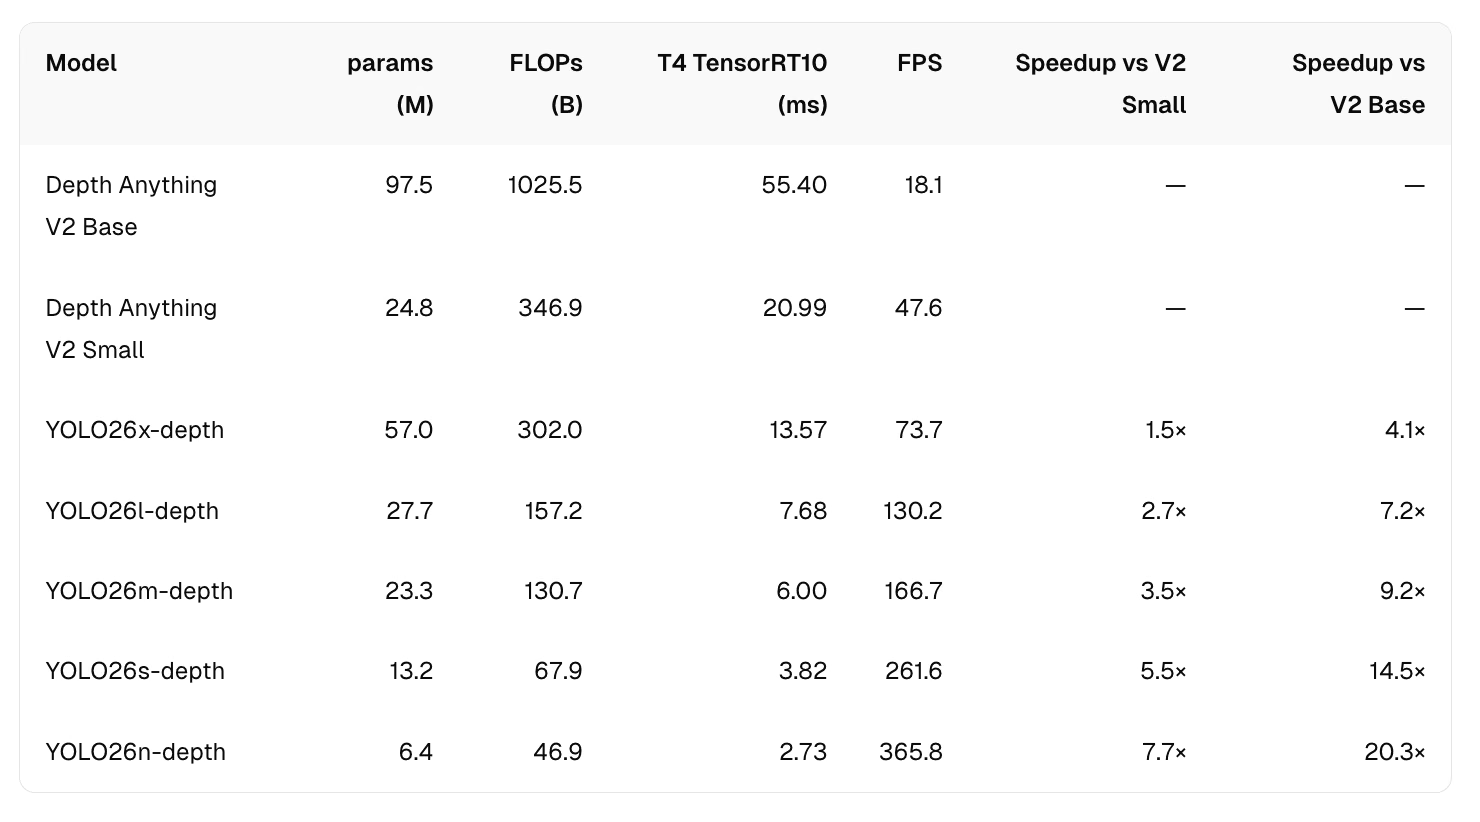 Fig. 2. Testes de velocidade da estimativa de profundidade do Ultralytics YOLO26 em comparação com o Depth Anything V2.
Essa diferença é o objetivo do design. Os modelos do Depth Anything V2 são substancialmente maiores; o Ultralytics YOLO26-Depth foi concebido para oferecer um forte desempenho de profundidade com um tamanho e uma velocidade que reduzem os custos computacionais por fotograma e permitem a implementação em hardware que esses modelos não conseguem alcançar. Os valores de precisão por modelo no NYU Depth V2 e no KITTI estão publicados na documentação, para que possas compará-los com os requisitos que realmente tens.
Onde pode ser executado#
É essa diferença de tamanho que determina onde a estimativa de profundidade pode realmente ser usada. A maioria das equipas que avalia esta tecnologia não tem falta de ideias, mas sim de capacidade computacional. Drones de baixo consumo, robôs quadrúpedes, dispositivos vestíveis, câmaras de tablier, equipamento para videoconferências e PCs industriais atingem todos um limite de potência e custo antes de atingirem um limite de precisão.
A estimativa de profundidade inclui cinco modelos pré-treinados, para que possas escolher o tamanho adequado ao destino em vez do tamanho que vence um benchmark. Como a profundidade é uma tarefa nativa do Ultralytics YOLO26, usa o mesmo processo de exportação que a deteção, a segmentação e a pose, com os seguintes formatos: ONNX, TensorRT, CoreML, NCNN, LiteRT.
Como começar a usar a estimativa de profundidade do Ultralytics YOLO26#
O pacote Python da Ultralytics oferece uma interface única e unificada para treinar, validar e executar inferências em todas as tarefas do YOLO26, incluindo a estimativa de profundidade. Para executar um modelo de profundidade pré-treinado, basta um único comando:
from ultralytics import YOLO
from ultralytics import YOLO

# Carregar um modelo
model = YOLO("yolo26n-depth.pt")  # carregar um modelo oficial
model = YOLO("path/to/best.pt")  # carregar um modelo personalizado

# Fazer previsões com o modelo
results = model("https://ultralytics.com/images/bus.jpg")  # fazer uma previsão numa imagem

# Aceder aos resultados
for result in results:
    depth_map = result.depth.data.cpu().numpy()  # torch.Tensor → NumPy float32, forma (H, W), metros
Ou através da CLI:
yolo depth predict model=yolo26n-depth.pt source='https://ultralytics.com/images/bus.jpg'  # predict with official model
yolo depth predict model=path/to/best.pt source='https://ultralytics.com/images/bus.jpg'   # predict with custom model
A distância absoluta depende da tua câmara e da tua cena. Se a forma do mapa de profundidade estiver correta, mas a escala não, model.calibrate() ajusta apenas duas variáveis na cabeça de profundidade do modelo — uma escala e um desvio — usando cerca de 100 fotogramas anotados, em segundos, sem treino nem alterações ao resto da rede.
Ajuste fino com os teus próprios dados#
Para adaptar um modelo de profundidade pré-treinado à tua câmara ou domínio, começa pelos pesos pré-treinados, usa AdamW e reduz a taxa de aprendizagem bastante abaixo do valor predefinido para treino do zero, para que o ajuste fino aperfeiçoe o modelo em vez de o substituir:
from ultralytics import YOLO
from ultralytics import YOLO
model = YOLO("yolo26s-depth.pt")  # começar pelos pesos pré-treinados
model.train(
    data="path/to/your_dataset.yaml",
    epochs=20,
    imgsz=640,
    optimizer="AdamW",
    lr0=1e-4,  # ~100x abaixo do valor predefinido para treino do zero
    warmup_bias_lr=1e-4,  # manter também um aquecimento gradual
)
Como a cabeça logarítmica predefinida não tem limites, esta abordagem funciona de imediato, quer o teu conjunto de dados seja de curto ou longo alcance, sem precisar de ajuste de max_depth. Se apenas a escala absoluta estiver desajustada para a tua câmara específica, model.calibrate() ajusta uma correção leve, em forma fechada, com uma pequena divisão de dados anotados, em segundos e sem alterar os pesos da rede.
Os conjuntos de dados associam cada imagem RGB a um ficheiro de profundidade .npy numa estrutura de pastas correspondente. A Ultralytics inclui configurações integradas para NYU Depth V2, KITTI, Hypersim, SUN RGB-D e ARKitScenes, para que a maioria das equipas possa começar imediatamente a validar com um benchmark padrão.
Principais casos de utilização da estimativa de profundidade#
Como esta nova funcionalidade funciona com uma única câmara convencional, a estimativa monocular de profundidade abre inúmeras oportunidades para produtos e setores que, de outra forma, não conseguiriam justificar o custo, o consumo de energia ou o esforço de calibração de uma configuração estéreo ou LiDAR. Vejamos alguns dos principais setores e casos de utilização que podem beneficiar desta funcionalidade:
- Robótica e navegação autónoma. Os robôs móveis e os drones podem estimar a distância aos obstáculos e o espaço livre a partir de uma única câmara integrada, permitindo planear trajetórias em tempo real sem hardware de profundidade dedicado.
- Visibilidade industrial e logística. Verificação de distâncias livres, deteção de espaço desimpedido e análise do contexto de prateleiras ou corredores a partir de uma única câmara fixa, sempre que não seja viável adicionar um segundo sensor.
- Monitorização de segurança e conformidade. Zonas de segurança para empilhadores e armazéns, deteção de incidentes ferroviários e deteção de pessoas caídas ou objetos deixados para trás em sistemas CCTV existentes: contexto de distância adicionado a imagens de câmaras já instaladas, em conjunto com os sensores de segurança certificados existentes, e não em substituição deles.
- Inspeção de infraestruturas e ativos. Análise da distância livre em linhas aéreas, inspeção de ativos e corrosão com drones e levantamentos aéreos, em que a mesma família de modelos tem de lidar tanto com detalhes em grande plano como com cenas de longo alcance.
- Assistência ao condutor e perceção automóvel. A saída de profundidade ilimitada e de longo alcance permite que a mesma família de modelos que processa uma cena interior em grande plano também generalize para cenas de condução a mais de 80 m.
- RA e conteúdo espacial. A colocação convincente de objetos virtuais numa cena real ou a aplicação de efeitos que têm em conta a profundidade começa por saber a que distância da câmara está realmente cada píxel.
Levar a estimativa de profundidade a todas as implementações do Ultralytics YOLO26#
Com a estimativa de profundidade agora disponível como tarefa nativa do Ultralytics YOLO26, as equipas podem aproveitar a distância por píxel de qualquer câmara RGB em vários setores, usando o mesmo fluxo de trabalho de treino, validação, previsão e exportação que já conhecem da deteção, da segmentação e da pose, e mantendo menos uma dependência de terceiros.
Ao definir o âmbito da tua implementação com a estimativa de profundidade do Ultralytics YOLO26, considera alguns pontos importantes:
- O Ultralytics YOLO Depth foi concebido para câmaras RGB. Funciona com qualquer câmara padrão, incluindo webcams, telemóveis, câmaras industriais ou drones. No entanto, outras modalidades, como nuvens de pontos LiDAR, radar, sonar, bandas térmicas e multiespectrais ou dados de malhas e IFC, não são compatíveis com o formato de entrada do modelo.
- Distância métrica para decisões de perceção. A saída é uma distância real em metros, o que a torna adequada para navegação, verificação de distâncias livres e monitorização. No entanto, para qualquer aplicação que exija uma tolerância certificada, o equipamento de metrologia dedicado continua a ser o instrumento adequado.
- Inferência por imagem. A profundidade é processada de forma independente em cada fotograma, tal como acontece em todas as outras tarefas do Ultralytics YOLO26, pelo que pode ser integrada num fluxo de processamento existente por fotograma sem alterações. O raciocínio ao longo de uma sequência continua a ser da responsabilidade da camada da tua aplicação.
- O Ultralytics YOLO26-Depth tem melhor desempenho em superfícies opacas e texturadas. O vidro, os espelhos, a água parada, o metal polido e o céu aberto são inerentemente ambíguos para qualquer método que use uma única câmara, por isso convém validar o modelo com cenas representativas do teu ambiente.
Tens curiosidade sobre IA de visão? Explora as nossas opções de licenciamento para integrar a visão computacional nos teus projetos. Visita o nosso repositório do GitHub para conhecer todas as tarefas e integrações da Ultralytics e consulta a Ultralytics Platform para começares a criar os teus próprios fluxos de trabalho de IA de visão de ponta a ponta.









