Dataset distillation là gì? Tổng quan nhanh
Tìm hiểu cách dataset distillation tăng tốc quá trình training model và cắt giảm chi phí tính toán bằng cách thay thế các dataset lớn bằng một tập nhỏ các mẫu tổng hợp được tối ưu hóa.
Việc training model có thể là phần tốn nhiều thời gian nhất trong công việc của một data scientist. Tuy nhiên, phần lớn thời gian của họ, thường từ 60% đến 80%, thực tế được dành cho việc chuẩn bị dữ liệu: thu thập, làm sạch và sắp xếp dữ liệu để modeling. Khi dataset lớn hơn, thời gian chuẩn bị cũng tăng theo, làm chậm các thử nghiệm và khiến việc lặp lại trở nên khó khăn hơn.
Để giải quyết vấn đề này, các nhà nghiên cứu đã dành nhiều năm tìm cách tinh gọn quy trình training. Các phương pháp như dữ liệu tổng hợp, nén dataset và các phương pháp tối ưu hóa tốt hơn đều nhằm giảm chi phí và trở ngại khi làm việc với dataset quy mô lớn, đồng thời tăng tốc workflow machine learning.
Một câu hỏi quan trọng được đặt ra là liệu chúng ta có thể thu nhỏ đáng kể một dataset mà vẫn đạt được hiệu năng tương đương với việc training model trên toàn bộ dữ liệu hay không. Chưng cất dataset là một câu trả lời đầy hứa hẹn.
Phương pháp này tạo ra một phiên bản cô đọng của dataset training lớn, đồng thời bảo toàn các pattern thiết yếu mà model cần để học hiệu quả. Đây là hướng đi giúp training nhanh hơn, giảm nhu cầu compute và thử nghiệm hiệu quả hơn. Có thể hình dung nó như một tờ ghi chú ôn tập cho model: một tập hợp nhỏ các ví dụ dữ liệu tổng hợp được thiết kế để dạy những pattern cốt lõi giống như dataset đầy đủ.
Trong bài viết này, chúng ta sẽ tìm hiểu cách chưng cất dataset hoạt động và cách nó hỗ trợ machine learning và deep learning có khả năng mở rộng trong các ứng dụng thực tế. Hãy bắt đầu!
Tìm hiểu về chưng cất dataset#
Chưng cất dataset là quy trình cô đọng một dataset training lớn thành một tập dữ liệu nhỏ hơn nhiều nhưng vẫn truyền đạt cho model gần như cùng lượng thông tin với dataset ban đầu. Nhiều nhà nghiên cứu cũng gọi quy trình này là cô đặc dataset vì mục tiêu là nắm bắt các pattern thiết yếu xuất hiện trong toàn bộ dataset.
Dataset đã chưng cất khác với dữ liệu tổng hợp được tạo ngẫu nhiên hoặc việc đơn giản chọn một tập con nhỏ hơn từ các ảnh thực. Đây không phải là một dataset giả ngẫu nhiên hay bản sao rút gọn của dataset ban đầu.
Thay vào đó, dataset được tối ưu có chủ đích để nắm bắt những pattern quan trọng nhất. Trong quy trình này, từng pixel và feature được điều chỉnh và tối ưu để một neural network được training trên dữ liệu đã chưng cất học gần như tương tự như khi được training trên toàn bộ dataset.
Ý tưởng này lần đầu xuất hiện trong một bài báo arXiv năm 2018 của Tongzhou Wang, Jun-Yan Zhu, Antonio Torralba và Alexei A. Efros. Các thử nghiệm ban đầu sử dụng những dataset đơn giản như MNIST và CIFAR-10, nhờ đó dễ dàng chứng minh rằng một vài mẫu đã chưng cất có thể thay thế hàng nghìn ảnh thực.
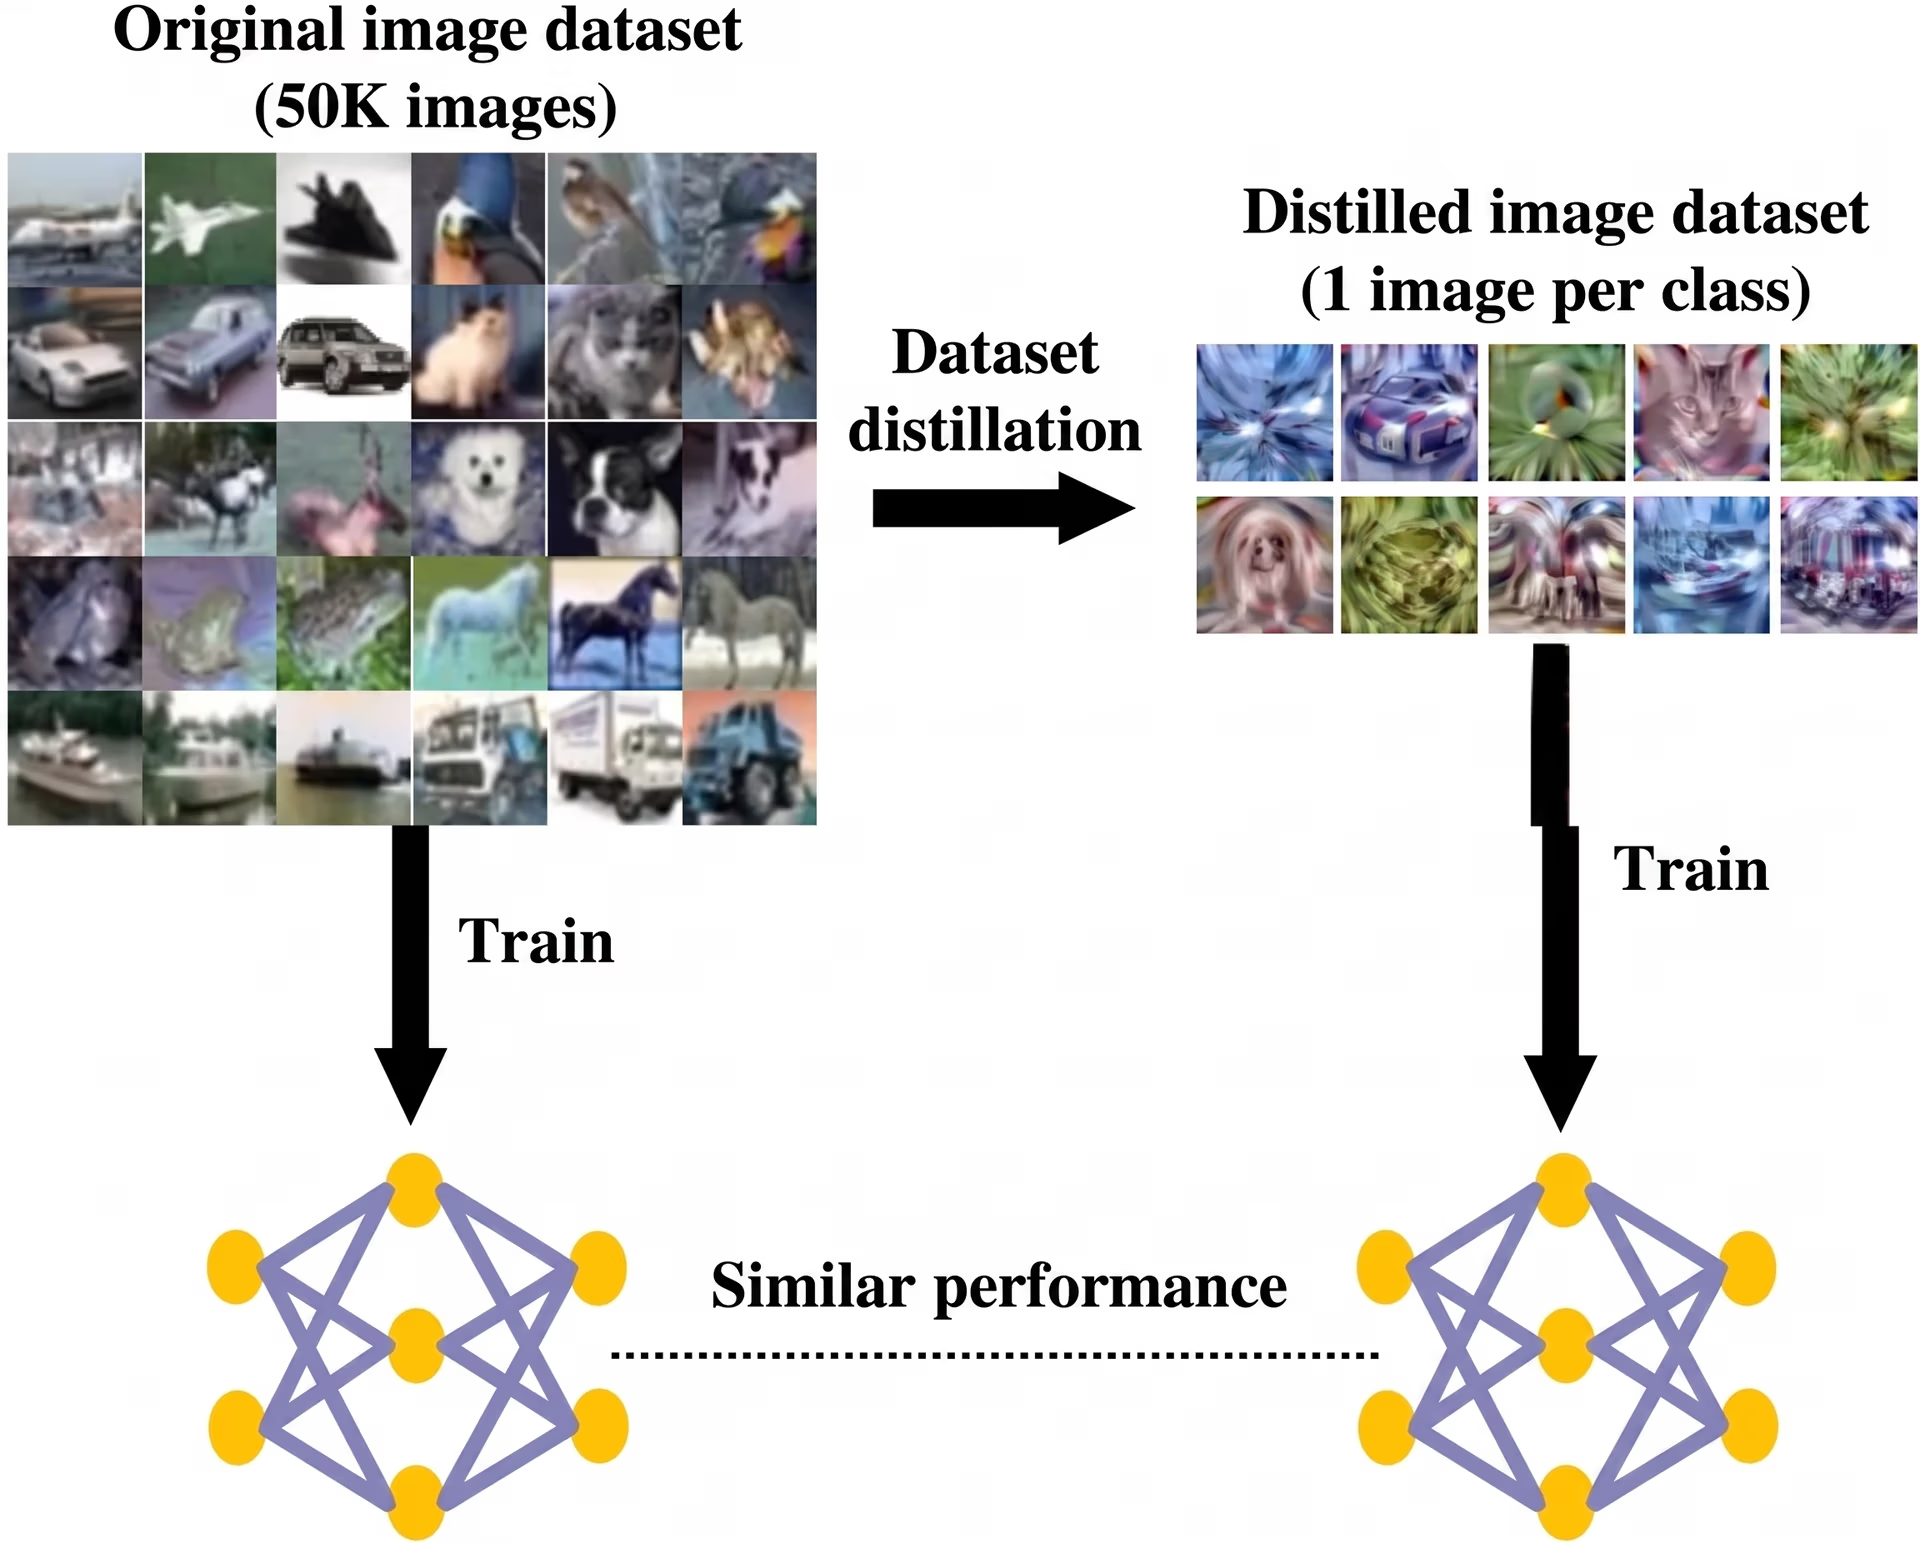
Hình 1. Sử dụng chưng cất dataset cho dữ liệu ảnh (Nguồn)
Kể từ đó, các nghiên cứu tiếp theo đã phát triển chưng cất dataset hơn nữa, bao gồm những phương pháp được công bố tại ICML và ICLR giúp quy trình cô đặc hiệu quả và có khả năng mở rộng hơn.
Tầm quan trọng của chưng cất dataset#
Chưng cất dataset cải thiện hiệu quả training và rút ngắn chu kỳ phát triển. Bằng cách giảm lượng dữ liệu mà model cần học, phương pháp này làm giảm yêu cầu về compute.
Điều này đặc biệt hữu ích cho continual learning, trong đó model được cập nhật theo thời gian; neural architecture search, trong đó nhiều thiết kế model được thử nghiệm; và edge training, trong đó model chạy trên các thiết bị nhỏ có bộ nhớ và nguồn điện hạn chế. Nhìn chung, những lợi ích này khiến chưng cất dataset trở thành lựa chọn hiệu quả cho việc khởi tạo nhanh, fine-tuning nhanh và xây dựng prototype ban đầu trong nhiều workflow machine learning.
Tổng quan về cách chưng cất dataset hoạt động#
Chưng cất dataset tạo ra các mẫu training tổng hợp, hay được tạo nhân tạo. Những mẫu này giúp model học theo cách gần giống với việc training trên dữ liệu thực. Phương pháp này hoạt động bằng cách theo dõi ba yếu tố chính trong quá trình training thông thường.
Thứ nhất là hàm loss, tức điểm số lỗi của model cho biết các dự đoán sai đến mức nào. Thứ hai là các tham số model, tức các weight nội bộ của network được cập nhật trong quá trình học.
Thứ ba là quỹ đạo training, mô tả cách lỗi và weight thay đổi từng bước theo thời gian. Sau đó, các mẫu tổng hợp được tối ưu để khi model training trên chúng, lỗi giảm xuống và weight được cập nhật giống như khi sử dụng dataset đầy đủ.
Tìm hiểu từng bước về chưng cất dataset#
Dưới đây là phân tích chi tiết hơn về cách quy trình chưng cất dataset hoạt động:
- Bước 1 - Khởi tạo pixel tổng hợp: Quy trình bắt đầu với ảnh tổng hợp đóng vai trò là các input có thể học. Ban đầu, những ảnh này có rất ít cấu trúc và trông như các trang giấy trắng. Theo thời gian, chúng được tối ưu thành các ví dụ giàu thông tin.
- Bước 2 - Tối ưu bằng gradient matching và backpropagation: Khi model training trên các ảnh tổng hợp này, nó tạo ra các gradient cho biết mỗi pixel nên thay đổi như thế nào để khớp hơn với hành vi training của dữ liệu thực. Backpropagation là phương pháp network sử dụng để học từ sai sót. Phương pháp này truyền lỗi ngược qua model để xác định pixel và weight nào gây ra lỗi, sau đó cập nhật chúng một chút. Sử dụng các gradient đó, backpropagation điều chỉnh ảnh tổng hợp từng bước để chúng trở nên giàu thông tin hơn cho training.
- Bước 3 - Khớp hành vi qua các bước training: Phương pháp này cũng khớp các quỹ đạo training, tức những thay đổi từng bước mà model trải qua trong quá trình học. Điều này đảm bảo dataset đã chưng cất dẫn dắt model theo một lộ trình học tương tự lộ trình model sẽ đi qua khi sử dụng dataset đầy đủ.
- Bước 4 - Validation và khả năng khái quát hóa: Cuối cùng, dataset đã chưng cất được đánh giá trên dữ liệu validation thực để kiểm tra hiệu năng của model đã training trên các ví dụ mới. Việc này xác nhận rằng dữ liệu tổng hợp dạy các pattern rộng và có tính chức năng, thay vì khiến model ghi nhớ các mẫu cụ thể.
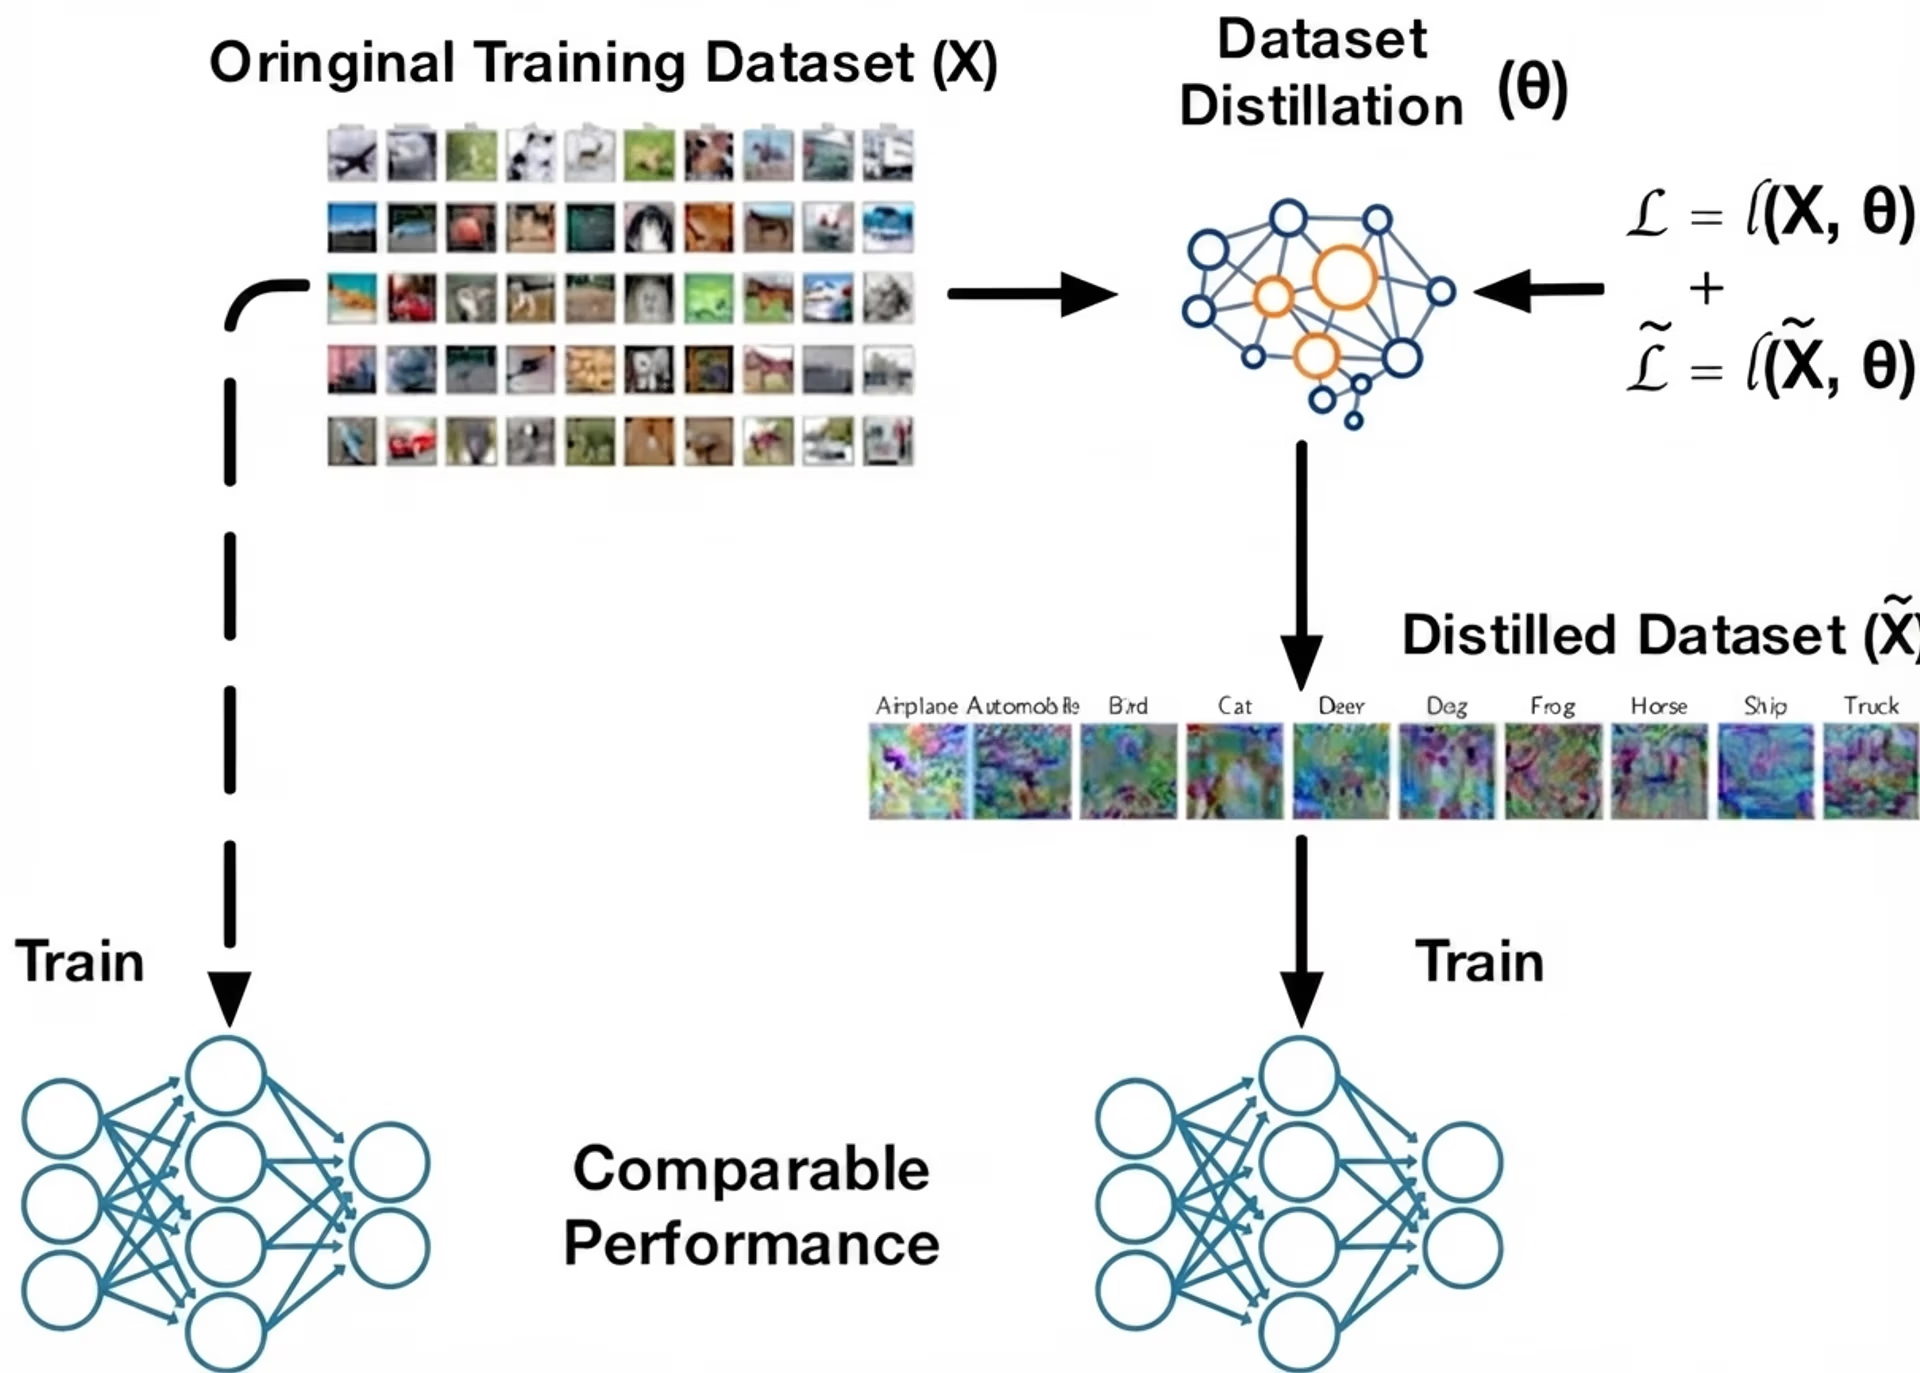
Hình 2. Phân tích chưng cất dataset (Nguồn)
Các phương pháp chưng cất dataset chính#
Tất cả phương pháp chưng cất dataset đều dựa trên cùng một ý tưởng cốt lõi, dù sử dụng các thuật toán khác nhau để đạt được mục tiêu đó. Hầu hết các phương pháp thuộc ba nhóm: khớp hiệu năng, khớp phân phối và khớp tham số.
Tiếp theo, hãy xem từng nhóm và tìm hiểu cách chúng hoạt động.
Khớp hiệu năng#
Khớp hiệu năng trong chưng cất dataset tập trung vào việc tạo ra một tập training nhỏ, được tối ưu để model đạt độ chính xác gần tương đương với khi được training trên dataset ban đầu đầy đủ. Thay vì chọn một tập con ngẫu nhiên, các mẫu đã chưng cất được tối ưu để model training trên chúng tạo ra các dự đoán tương tự, hành vi loss tương tự trong quá trình training hoặc độ chính xác cuối cùng tương tự model được training trên dataset ban đầu.
Meta learning là một phương pháp phổ biến được sử dụng để cải thiện quy trình này. Dataset đã chưng cất được cập nhật qua các episode training lặp lại, nhờ đó trở nên hiệu quả trong nhiều tình huống có thể xảy ra.
Trong các episode này, phương pháp mô phỏng cách một student model học từ các mẫu đã chưng cất hiện tại, kiểm tra hiệu năng của student đó trên dữ liệu thực, rồi điều chỉnh các mẫu đã chưng cất để chúng trở thành những teacher tốt hơn. Theo thời gian, tập dữ liệu đã chưng cất học cách hỗ trợ quá trình học nhanh và khả năng khái quát hóa tốt, ngay cả khi student model bắt đầu với các weight khởi tạo khác nhau hoặc sử dụng kiến trúc khác. Điều này giúp dataset đã chưng cất đáng tin cậy hơn và không bị ràng buộc với một lần training duy nhất.
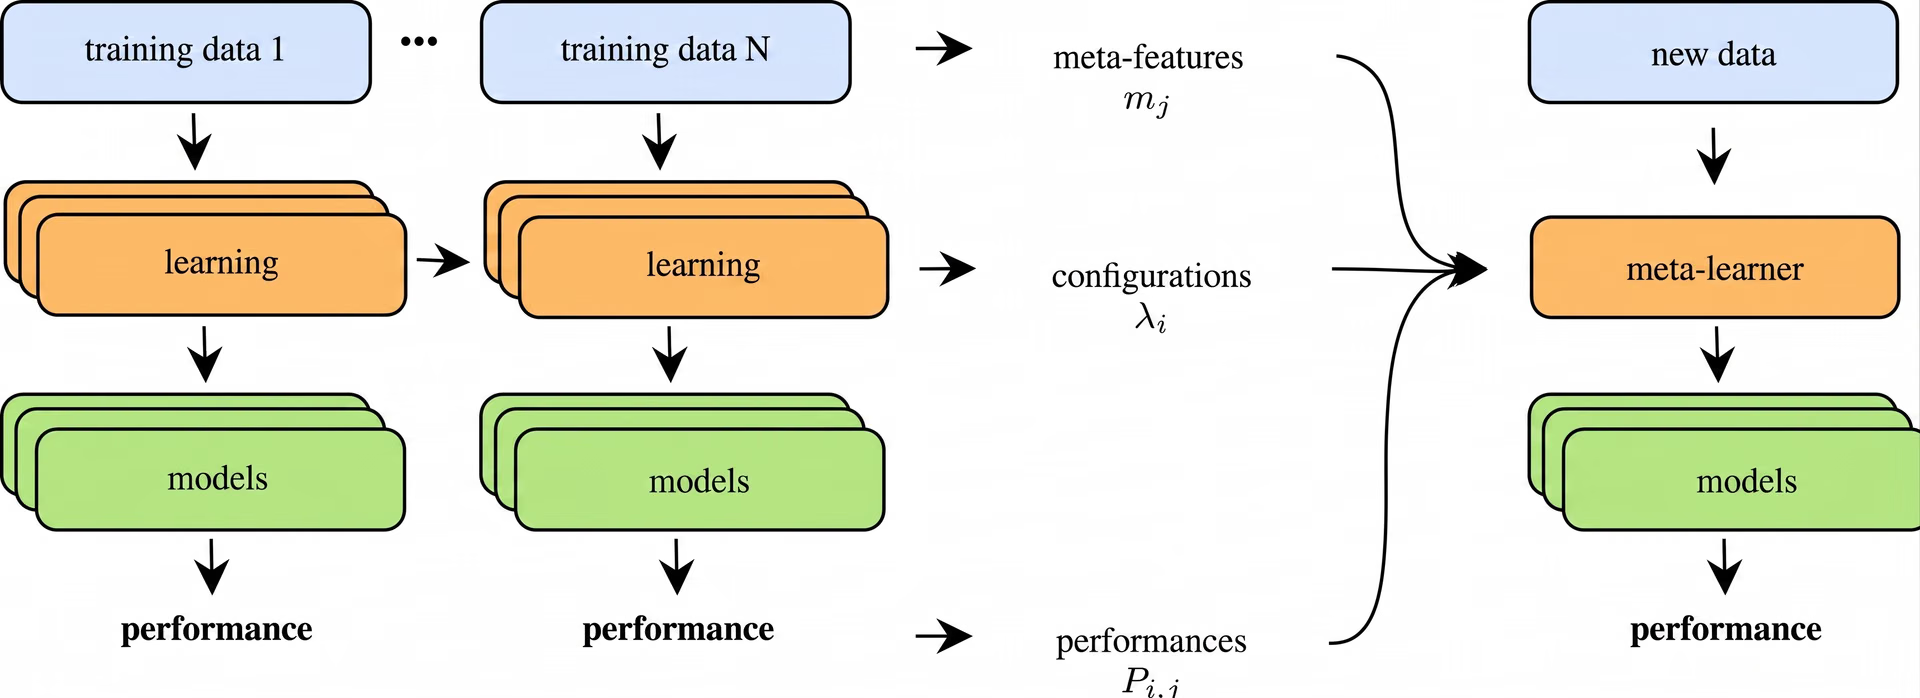
Hình 3. Quy trình meta-learning (Nguồn)
Các kỹ thuật khớp phân phối#
Trong khi đó, khớp phân phối tạo ra dữ liệu tổng hợp khớp với các pattern thống kê của dataset thực. Thay vì chỉ tập trung vào độ chính xác cuối cùng của model, phương pháp này tập trung vào các feature nội tại mà neural network tạo ra trong quá trình học.
Tiếp theo, hãy xem xét hai kỹ thuật thúc đẩy khớp phân phối.
Khớp phân phối một lớp#
Khớp phân phối một lớp tập trung vào một lớp duy nhất của neural network và so sánh các feature mà lớp đó tạo ra từ dữ liệu thực với dữ liệu tổng hợp. Những feature này, còn được gọi là activation, nắm bắt những gì model đã học tại vị trí đó trong network.
Bằng cách khiến dữ liệu tổng hợp tạo ra các activation tương tự, phương pháp này khuyến khích dataset đã chưng cất phản ánh những pattern quan trọng giống dataset ban đầu. Trong thực tế, các mẫu tổng hợp được cập nhật lặp lại cho đến khi activation tại lớp được chọn khớp sát với activation từ các ảnh thực.
Phương pháp này tương đối đơn giản vì mỗi lần chỉ căn chỉnh một cấp độ biểu diễn. Nó có thể đặc biệt hiệu quả trên các dataset nhỏ hơn hoặc những tác vụ không yêu cầu khớp các hierarchy feature sâu và nhiều giai đoạn. Bằng cách căn chỉnh rõ ràng một feature space, khớp một lớp cung cấp tín hiệu ổn định và có ý nghĩa cho việc học với dataset đã chưng cất.
Khớp phân phối đa lớp#
Khớp phân phối đa lớp phát triển từ ý tưởng so sánh dữ liệu thực và dữ liệu tổng hợp bằng cách thực hiện việc này trên nhiều lớp của neural network thay vì chỉ một lớp. Các lớp khác nhau nắm bắt những loại thông tin khác nhau, từ cạnh và texture đơn giản ở các lớp đầu đến hình dạng và pattern phức tạp hơn ở các lớp sâu.
Bằng cách khớp feature qua các lớp này, dataset đã chưng cất được thúc đẩy để phản ánh những gì model học ở nhiều cấp độ. Vì căn chỉnh feature trên toàn network, phương pháp này giúp dữ liệu tổng hợp bảo toàn các tín hiệu phong phú hơn mà model dựa vào để phân biệt các class.
Điều này đặc biệt hữu ích trong computer vision, tức các tác vụ trong đó model học cách hiểu ảnh và video, vì các pattern hữu ích được phân bố qua nhiều lớp. Khi các phân phối feature khớp tốt ở nhiều độ sâu, dataset đã chưng cất trở thành một đại diện thay thế mạnh và đáng tin cậy hơn cho dữ liệu training ban đầu.
Các phương pháp khớp tham số#
Một nhóm quan trọng khác trong chưng cất dataset là khớp tham số. Thay vì khớp độ chính xác hoặc phân phối feature, phương pháp này khớp cách weight của model thay đổi trong quá trình training. Bằng cách khiến việc training trên dataset đã chưng cất tạo ra các cập nhật tham số tương tự training trên dữ liệu thực, model đi theo một lộ trình học gần như giống hệt.
Tiếp theo, chúng ta sẽ lần lượt tìm hiểu hai phương pháp khớp tham số chính.
Khớp một bước#
Khớp một bước so sánh những gì xảy ra với weight của model sau đúng một bước training trên dữ liệu thực. Sau đó, dataset đã chưng cất được tinh chỉnh để model training trên đó trong một bước tạo ra cập nhật weight rất tương tự. Vì chỉ tập trung vào một cập nhật duy nhất, phương pháp này đơn giản và chạy nhanh.
Nhược điểm là một bước không phản ánh toàn bộ quy trình học, đặc biệt với các tác vụ khó hơn, trong đó model cần nhiều cập nhật để xây dựng feature phong phú hơn. Vì vậy, khớp một bước thường hiệu quả nhất trên các bài toán đơn giản hoặc dataset nhỏ, nơi các pattern hữu ích có thể được tiếp thu nhanh chóng.
Khớp tham số đa bước#
Ngược lại, khớp tham số đa bước xem xét cách weight của model thay đổi qua nhiều bước training, thay vì chỉ một bước. Chuỗi cập nhật này chính là quỹ đạo training của model.
Dataset đã chưng cất được xây dựng để khi model training trên các mẫu tổng hợp, quỹ đạo của nó bám sát quỹ đạo mà model sẽ đi theo trên dữ liệu thực. Bằng cách khớp một đoạn học dài hơn, tập dữ liệu đã chưng cất nắm bắt được nhiều cấu trúc hơn trong quy trình training ban đầu.
Vì phản ánh cách quá trình học diễn ra theo thời gian, khớp đa bước thường hiệu quả hơn đối với các dataset lớn hoặc phức tạp, nơi model cần nhiều cập nhật để tiếp thu các pattern hữu ích. Phương pháp này cần nhiều compute hơn vì phải theo dõi nhiều bước, nhưng thường tạo ra dataset đã chưng cất có khả năng khái quát hóa và hiệu năng tốt hơn khớp một bước.
Cách tạo và tối ưu dataset tổng hợp hoạt động#
Sau khi hiểu rõ hơn về các phương pháp chưng cất chính, giờ chúng ta có thể xem xét cách dữ liệu tổng hợp được tạo ra. Trong chưng cất dataset, các mẫu tổng hợp được tối ưu để nắm bắt tín hiệu học tập quan trọng nhất, nhờ đó một tập nhỏ có thể thay thế dataset lớn hơn nhiều.
Tiếp theo, chúng ta sẽ xem dữ liệu đã chưng cất được tạo và đánh giá như thế nào.
Tạo và đánh giá ảnh đã chưng cất#
Trong quá trình chưng cất dataset, các pixel tổng hợp được cập nhật qua nhiều bước training. Neural network học từ các ảnh tổng hợp hiện tại và gửi phản hồi dựa trên gradient, cho biết mỗi pixel nên thay đổi như thế nào để khớp tốt hơn với các pattern trong dataset thực.
Điều này khả thi vì quy trình có tính khả vi (nghĩa là mọi bước đều trơn tru và có gradient được xác định rõ, nên những thay đổi nhỏ ở pixel dẫn đến các thay đổi có thể dự đoán trong loss), cho phép model điều chỉnh dữ liệu tổng hợp một cách trơn tru trong quá trình gradient descent.
Khi quá trình tối ưu tiếp diễn, các ảnh tổng hợp bắt đầu hình thành cấu trúc có ý nghĩa, bao gồm hình dạng và texture mà model nhận biết được. Những ảnh tổng hợp đã tinh chỉnh này thường được sử dụng cho các tác vụ phân loại ảnh vì chúng nắm bắt các tín hiệu trực quan cốt lõi mà classifier cần học.
Dataset đã chưng cất được đánh giá bằng cách training model trên chúng và so sánh kết quả với các model được training trên dữ liệu thực. Các nhà nghiên cứu đo độ chính xác validation và kiểm tra xem tập tổng hợp có bảo toàn các feature phân biệt (những pattern hoặc tín hiệu mà model dựa vào để phân biệt class này với class khác) cần thiết cho việc tách các class hay không. Họ cũng kiểm tra tính ổn định và khả năng khái quát hóa qua các lần chạy hoặc cấu hình model khác nhau để đảm bảo dữ liệu đã chưng cất không dẫn đến overfitting.
Các ứng dụng thực tế của chưng cất dữ liệu#
Tiếp theo, chúng ta sẽ xem xét kỹ hơn các ví dụ cho thấy dataset đã chưng cất tăng tốc training và giảm chi phí compute như thế nào mà vẫn duy trì hiệu năng cao, ngay cả khi dữ liệu bị giới hạn hoặc có tính chuyên biệt cao.
Sử dụng chưng cất dataset cho các ứng dụng computer vision#
Trong computer vision, mục tiêu là training model để hiểu dữ liệu trực quan như ảnh và video. Các model này học những pattern như cạnh, texture, hình dạng và object, sau đó sử dụng chúng cho các tác vụ như phân loại ảnh, object detection hoặc segmentation. Vì các bài toán vision thường có biến thiên lớn về ánh sáng, background và góc nhìn, hệ thống computer vision thường cần dataset lớn để khái quát hóa tốt, khiến việc training tốn kém và chậm.
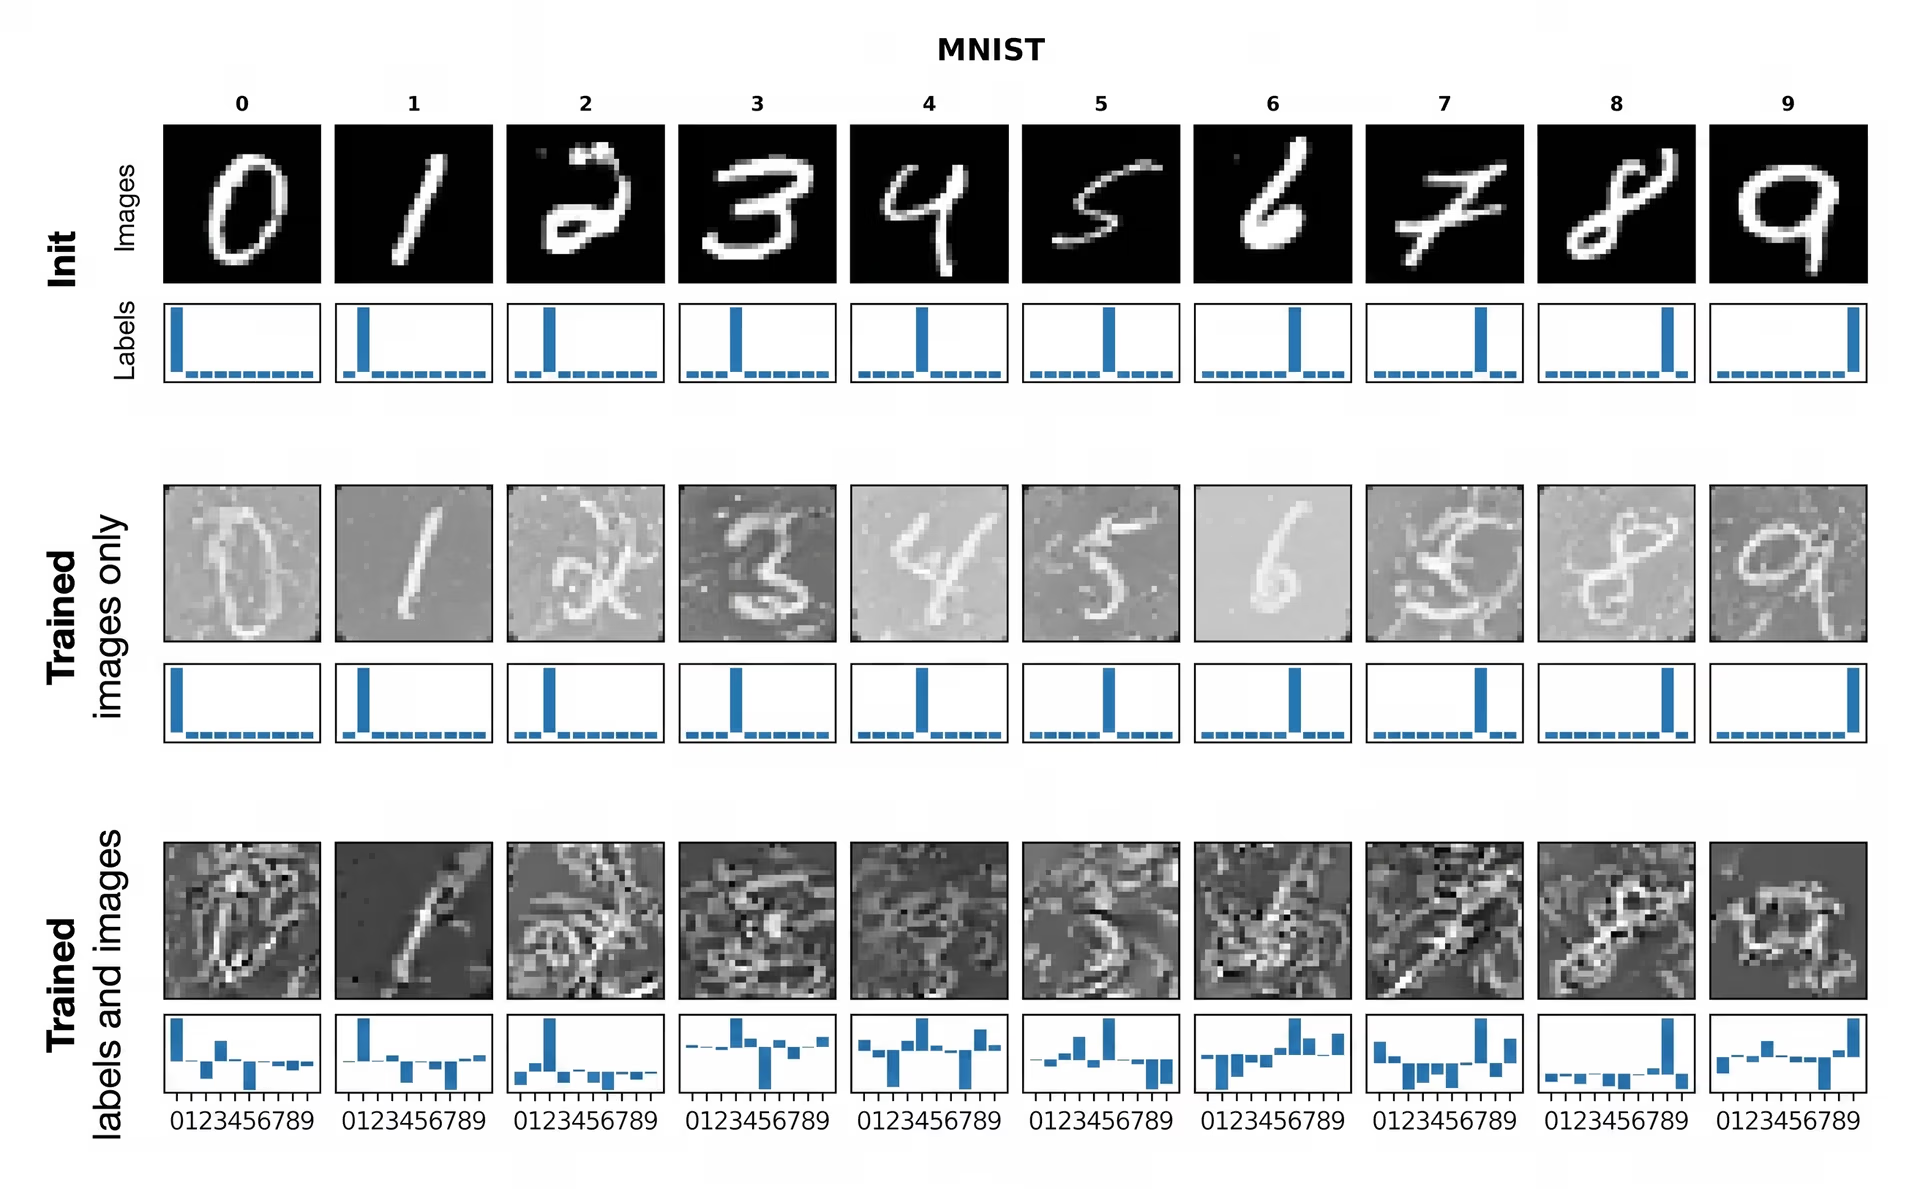
Hình 4. Ví dụ về chưng cất dataset (Nguồn)
Đối với các trường hợp sử dụng phân loại ảnh như ảnh quét y tế, giám sát động vật hoang dã hoặc phát hiện lỗi trong nhà máy, model thường phải đối mặt với sự đánh đổi khó khăn giữa độ chính xác và chi phí training. Những tác vụ này thường liên quan đến các dataset khổng lồ.
Chưng cất dataset có thể nén tập training ban đầu thành một số lượng nhỏ ảnh tổng hợp nhưng vẫn chứa các tín hiệu trực quan quan trọng nhất cho classifier. Trên các benchmark lớn như ImageNet, những tập đã chưng cất chỉ sử dụng khoảng 4.2% số ảnh ban đầu đã được chứng minh là vẫn duy trì độ chính xác phân loại cao. Điều này có nghĩa là một proxy tổng hợp rất nhỏ có thể thay thế hàng triệu mẫu thực với lượng compute thấp hơn nhiều.
Neural architecture search#
Neural architecture search, hay NAS, là kỹ thuật tự động khám phá nhiều thiết kế neural network khả thi để tìm ra thiết kế hoạt động tốt nhất cho một tác vụ. Vì NAS phải training và đánh giá số lượng lớn model ứng viên, việc chạy trên dataset đầy đủ có thể chậm và tiêu tốn rất nhiều compute.
Chưng cất dataset hỗ trợ bằng cách tạo ra một tập training tổng hợp rất nhỏ nhưng vẫn chứa tín hiệu học tập chính của dữ liệu ban đầu, nhờ đó mỗi kiến trúc ứng viên có thể được kiểm thử nhanh hơn nhiều. Điều này cho phép NAS so sánh các thiết kế hiệu quả, đồng thời vẫn duy trì thứ hạng tương đối đáng tin cậy giữa các kiến trúc tốt và kém, giảm chi phí tìm kiếm mà không làm suy giảm đáng kể chất lượng model cuối cùng.
Continual learning và triển khai edge#
Các hệ thống continual learning, tức những model liên tục cập nhật khi dữ liệu mới đến thay vì chỉ được training một lần, cần các bản cập nhật nhanh và tiết kiệm bộ nhớ. Các thiết bị edge như camera, điện thoại và cảm biến cũng chịu những giới hạn tương tự vì có ngân sách compute và lưu trữ hạn chế.
Chưng cất dataset hữu ích trong cả hai trường hợp bằng cách nén một tập training lớn thành một tập tổng hợp rất nhỏ, nhờ đó model có thể thích ứng hoặc retrain bằng một tập replay nhỏ thay vì toàn bộ dataset. Chẳng hạn, nghiên cứu về meta-learning dựa trên kernel cho thấy chỉ 10 mẫu đã chưng cất có thể đạt độ chính xác trên 64% trên CIFAR-10, một benchmark phân loại ảnh tiêu chuẩn. Vì tập replay rất gọn, các bản cập nhật trở nên nhanh hơn nhiều và thiết thực hơn, đặc biệt khi model cần được refresh thường xuyên.
Chưng cất dataset cũng có thể kết hợp với knowledge distillation cho các large language model. Một dataset nhỏ đã chưng cất có thể giữ lại các tín hiệu tác vụ quan trọng nhất từ teacher model, nhờ đó student model được nén có thể được training hoặc refresh hiệu quả hơn mà không mất nhiều hiệu năng. Vì các dataset này rất nhỏ, chúng đặc biệt hữu ích cho việc sử dụng trên edge hoặc on-device, nơi lưu trữ và compute bị giới hạn nhưng vẫn cần model duy trì độ chính xác sau các lần cập nhật.
Ưu và nhược điểm của chưng cất dữ liệu#
Dưới đây là một số lợi ích của việc sử dụng chưng cất dataset:
- Phù hợp cho thử nghiệm nhanh. Bạn có thể kiểm thử kiến trúc, loss hoặc hyperparameter mới mà không phải training lại trên dataset khổng lồ mỗi lần.
- Tiềm năng cải thiện quyền riêng tư. Việc chia sẻ các mẫu tổng hợp đã chưng cất có thể an toàn hơn chia sẻ các điểm dữ liệu người dùng thực, vì các ví dụ thô không bị đưa ra trực tiếp.
- Thường mạnh hơn việc chỉ chọn một tập con. Thay vì chỉ chọn các ví dụ, phương pháp chưng cất chủ động tối ưu chúng để có lượng thông tin tối đa.
Mặc dù chưng cất dataset mang lại một số lợi ích, dưới đây là những hạn chế cần lưu ý:
- Overfitting: Dữ liệu đã chưng cất thường hoạt động tốt nhất với kiến trúc được sử dụng trong quá trình chưng cất và có thể chuyển giao kém sang các model rất khác biệt.
- Nhạy cảm với hyperparameter. Kết quả có thể phụ thuộc nhiều vào các yếu tố như learning rate, khởi tạo hoặc số bước chưng cất.
- Khó mở rộng lên độ phức tạp thực tế. Các phương pháp hoạt động tốt trên benchmark có thể giảm độ chính xác trên những dataset lớn, lộn xộn hoặc có độ phân giải cao.
Những điểm chính#
Chưng cất dataset giúp một tập nhỏ các mẫu tổng hợp có thể dạy model gần hiệu quả như dataset đầy đủ. Điều này khiến machine learning nhanh hơn, hiệu quả hơn và dễ mở rộng hơn. Khi model ngày càng phát triển và cần nhiều dữ liệu hơn, dataset đã chưng cất cung cấp một cách thiết thực để giảm chi phí compute mà không phải hy sinh độ chính xác.
Hãy tham gia cộng đồng của chúng tôi và xem repository GitHub của chúng tôi để khám phá thêm về AI. Nếu bạn muốn xây dựng dự án vision AI của riêng mình, hãy xem các tùy chọn cấp phép của chúng tôi. Tìm hiểu thêm về các ứng dụng như AI trong chăm sóc sức khỏe và vision AI trong bán lẻ bằng cách truy cập các trang giải pháp của chúng tôi.








