在 Intel Core Ultra Series 3 (Panther Lake) 上使用 OpenVINO 加速 Ultralytics YOLO26
了解如何将 Ultralytics YOLO26 模型导出为 OpenVINO 格式,并在包括 CPU、GPU 和 NPU 在内的 Intel 硬件上加速推理。
过去几年,AI 和计算机视觉已从实验性技术发展为日常业务运营的重要组成部分。事实上,调查显示,约有88% 的组织已经在业务的至少一个环节中使用 AI。
然而,无论是在生产系统还是个人项目中,要将这种应用转化为实际价值,往往取决于模型部署后能否良好运行。在许多现实场景中,计算机视觉模型(如 Ultralytics YOLO26)会部署在边缘设备和各种硬件上,通常使用 CPU、集成 GPU 或 NPU,而不是高端 GPU。
这时性能可能开始出现差异,优化也因此变得至关重要。如果没有针对底层硬件进行适当优化,一个模型在某种环境中运行良好,在另一种环境中却可能表现不佳。
为简化这一流程,Ultralytics Python 包支持将 YOLO26 模型导出为 OpenVINO 等优化格式,使模型无需改变你的工作流,就能在 Intel 硬件上流畅运行。
例如,将 Ultralytics YOLO26 模型导出为 OpenVINO 格式后,模型便可在 Intel Core Ultra Series 3 处理器上更高效地运行,GPU 推理速度最高可提升三倍。
本文将介绍更新后的 Ultralytics 与 OpenVINO 集成如何让你更轻松地在 Intel Core Ultra Series 3 硬件上部署 YOLO26 模型。让我们开始吧!
Ultralytics 与 OpenVINO 集成概览#
Ultralytics Python 包提供统一接口,用于训练、运行推理和部署 Ultralytics YOLO 模型(如 YOLO26)。它支持多种集成,可协助完成视觉 AI 工作流的各个环节,从训练和实验到部署和优化。
其中一项面向部署的集成是与 OpenVINO 工具套件的集成,它支持将 Ultralytics YOLO26 模型导出为适用于 Intel 硬件的优化格式。此流程会将 YOLO 模型转换为可在 Intel CPU、GPU 和 NPU 上更高效运行的格式,其中包括搭载 Intel® Core™ Ultra™ 系列处理器的系统。
这样一来,你就能更便捷地在不同的 Intel 设备上运行模型,无需针对每种配置手动调整模型。无论你使用本地计算机、边缘设备还是规模更大的部署环境,都可以重复使用同一个导出模型。
这项集成尤其实用的一点是,它能无缝融入现有的 Ultralytics 工作流。你可以使用与训练和推理相同的接口导出模型,无需额外工具或复杂配置。
导出后,你可以根据所需的控制能力和灵活性,通过 Ultralytics Python 包或 OpenVINO Runtime 运行模型推理。
深入了解 OpenVINO 和用于 AI 推理的 Intel Panther Lake 硬件#
在了解导出的 Ultralytics YOLO26 模型如何在 Intel 硬件上高效运行之前,我们先退一步,看看 OpenVINO 与 Intel 硬件如何协同工作,从而实现高效推理。
OpenVINO 是一款开源工具套件,旨在优化 AI 推理,并支持在包括 CPU、集成 GPU 和 NPU 在内的 Intel 硬件上运行推理。它提供统一运行时,因此同一模型无需重写,就能在这些不同的计算单元上运行。
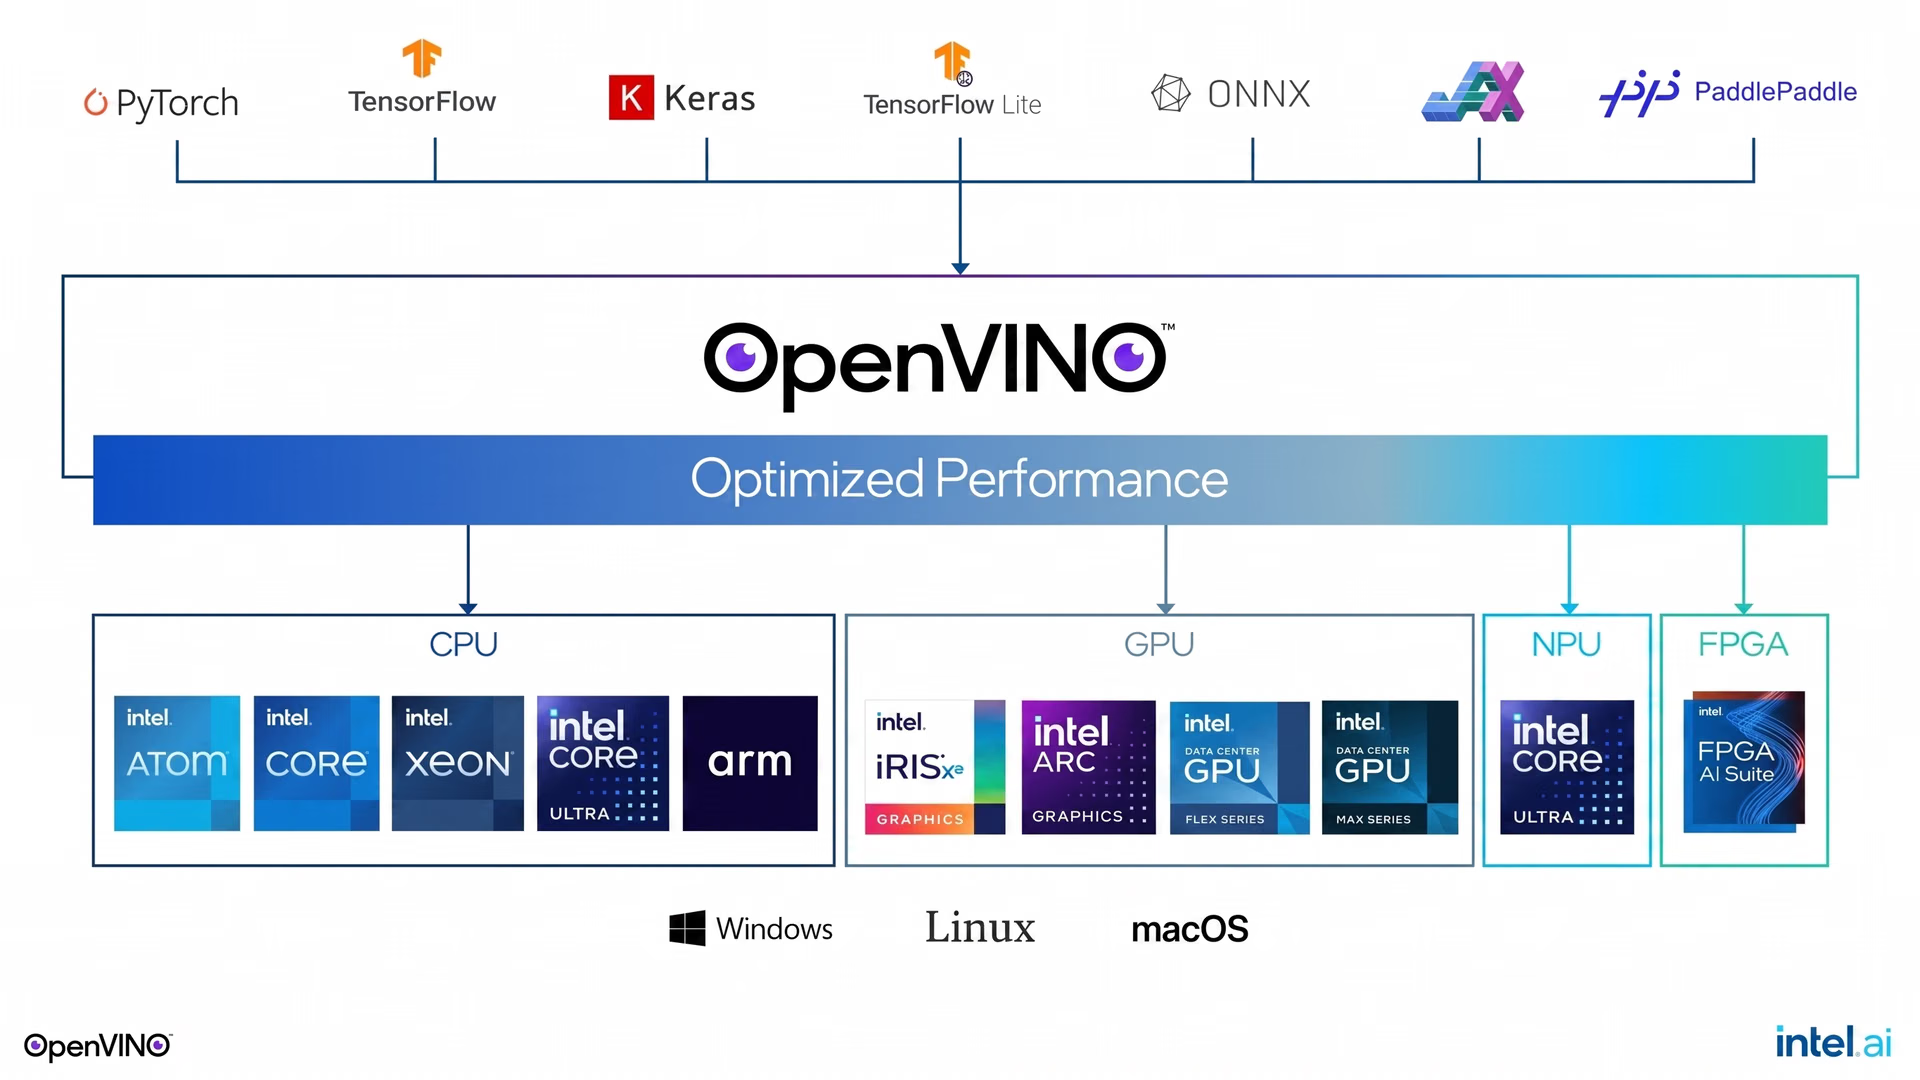
图 1. OpenVINO 让你轻松在多个硬件目标上部署模型。(来源)
在新款 Intel® Core™ Ultra™ Series 3 处理器(代号 Panther Lake)上,AI 工作负载会分布在同一处理器内的多个计算单元上。每颗芯片都集成了用于通用任务的 CPU 核心、用于并行处理的集成 GPU,以及专为 AI 推理设计的独立 NPU。
OpenVINO 提供统一 API,让你无需更改代码,就能将任务分配给 CPU、GPU 或 NPU 等任一计算单元。你只需在运行时指定用于推理的设备,即可根据性能和效率需求轻松地在三者之间切换。
在 Intel® Core™ Ultra™ 系列上对 Ultralytics YOLO26 进行基准测试#
了解 Ultralytics 与 OpenVINO 集成时,你可能会想:将 YOLO26 导出为 OpenVINO 格式后,模型性能能提升多少?
对比不同格式和精度级别下 YOLO26 模型的基准测试,推理速度差异一目了然。例如,在搭载 Panther Lake 处理器的 Intel Core Ultra X7 358H 上运行 YOLO26 nano 变体(YOLO26n)时,使用 PyTorch、FP32 精度处理每张图像需要 25.18 ms;而使用集成 NPU,以相同精度通过 OpenVINO 运行时,耗时仅为 2.64 ms。
这比原始的 PyTorch FP32 基准速度更快,对于延迟至关重要的实时应用和边缘应用而言,这种差异十分明显。在集成的 Intel Arc GPU 上运行同一模型时,优势更加突出。
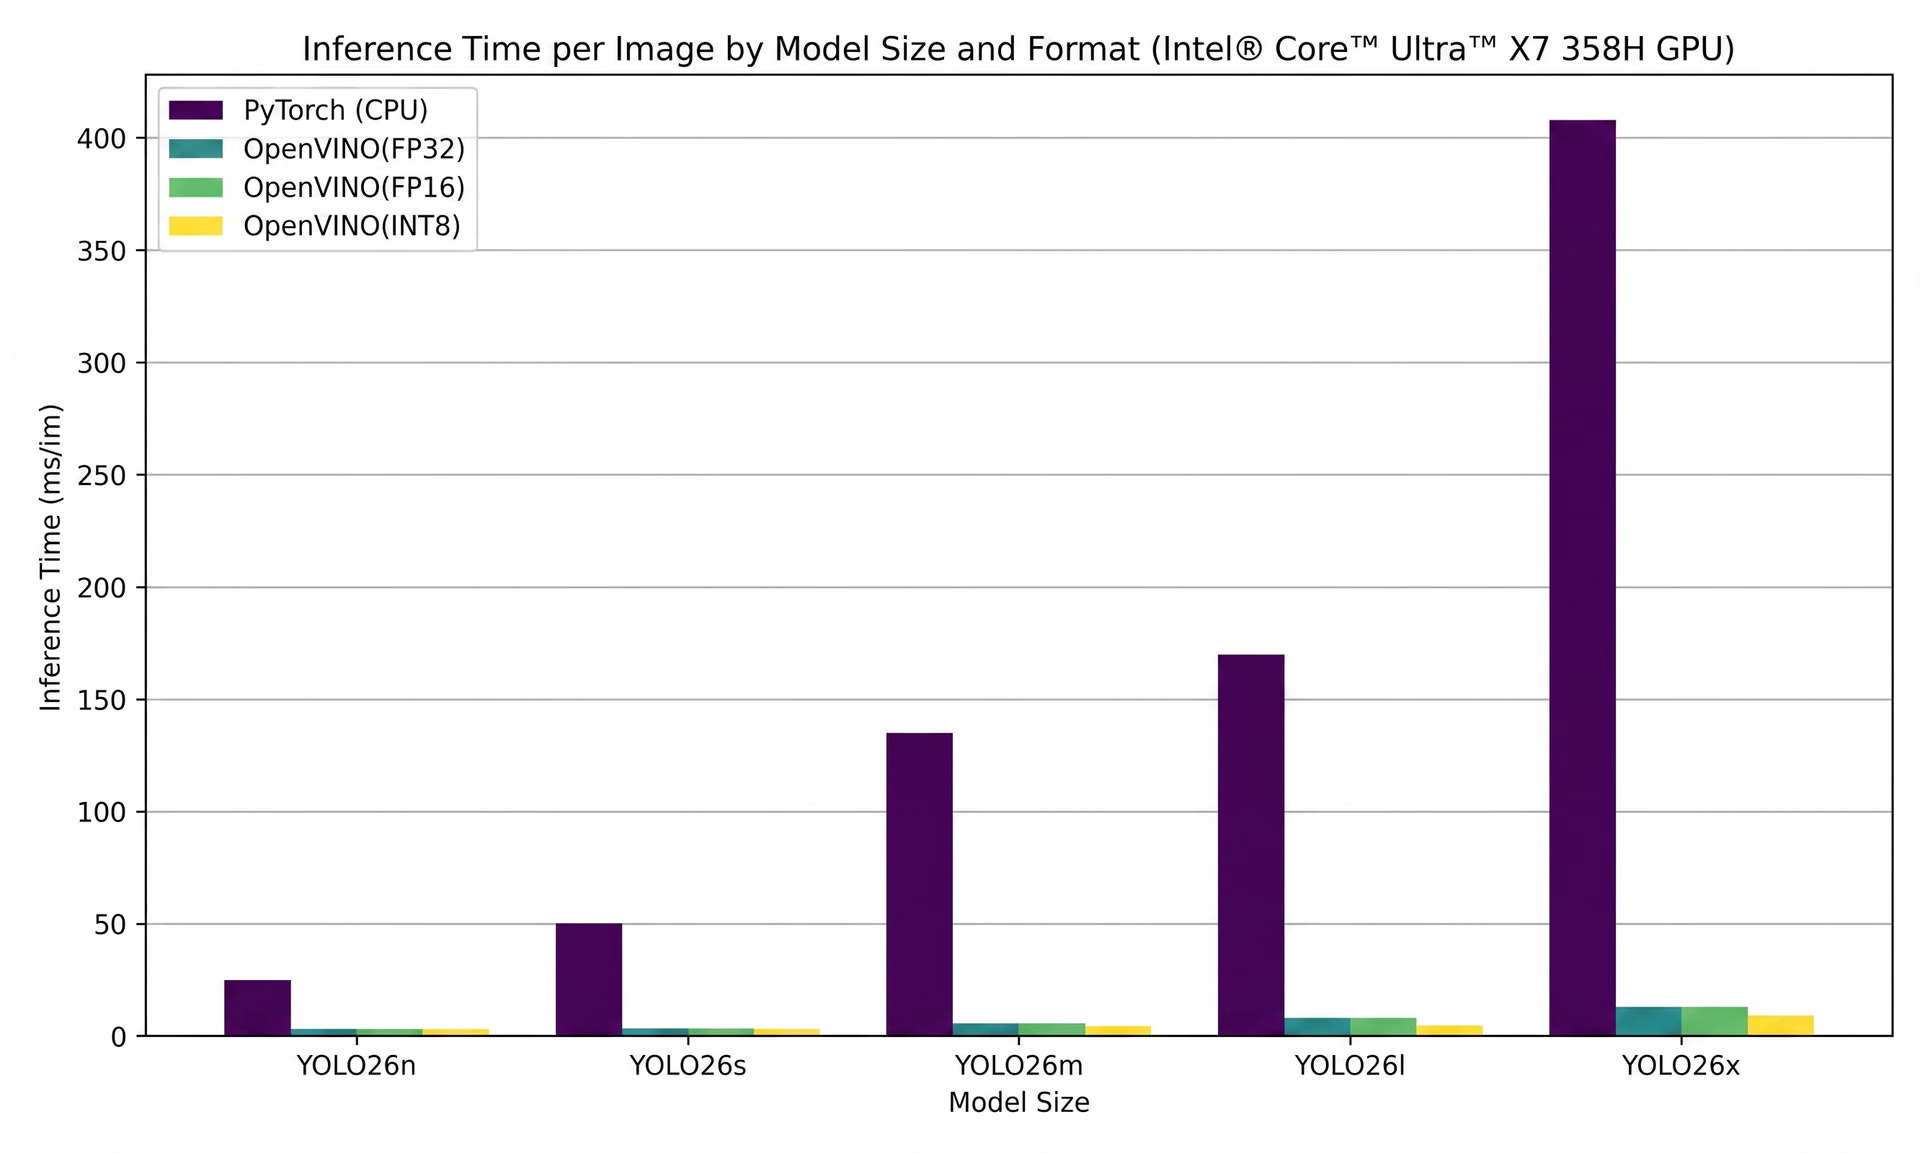
图 2. 使用 OpenVINO 在 Intel Panther Lake GPU 上对 Ultralytics YOLO26 推理进行基准测试(来源)
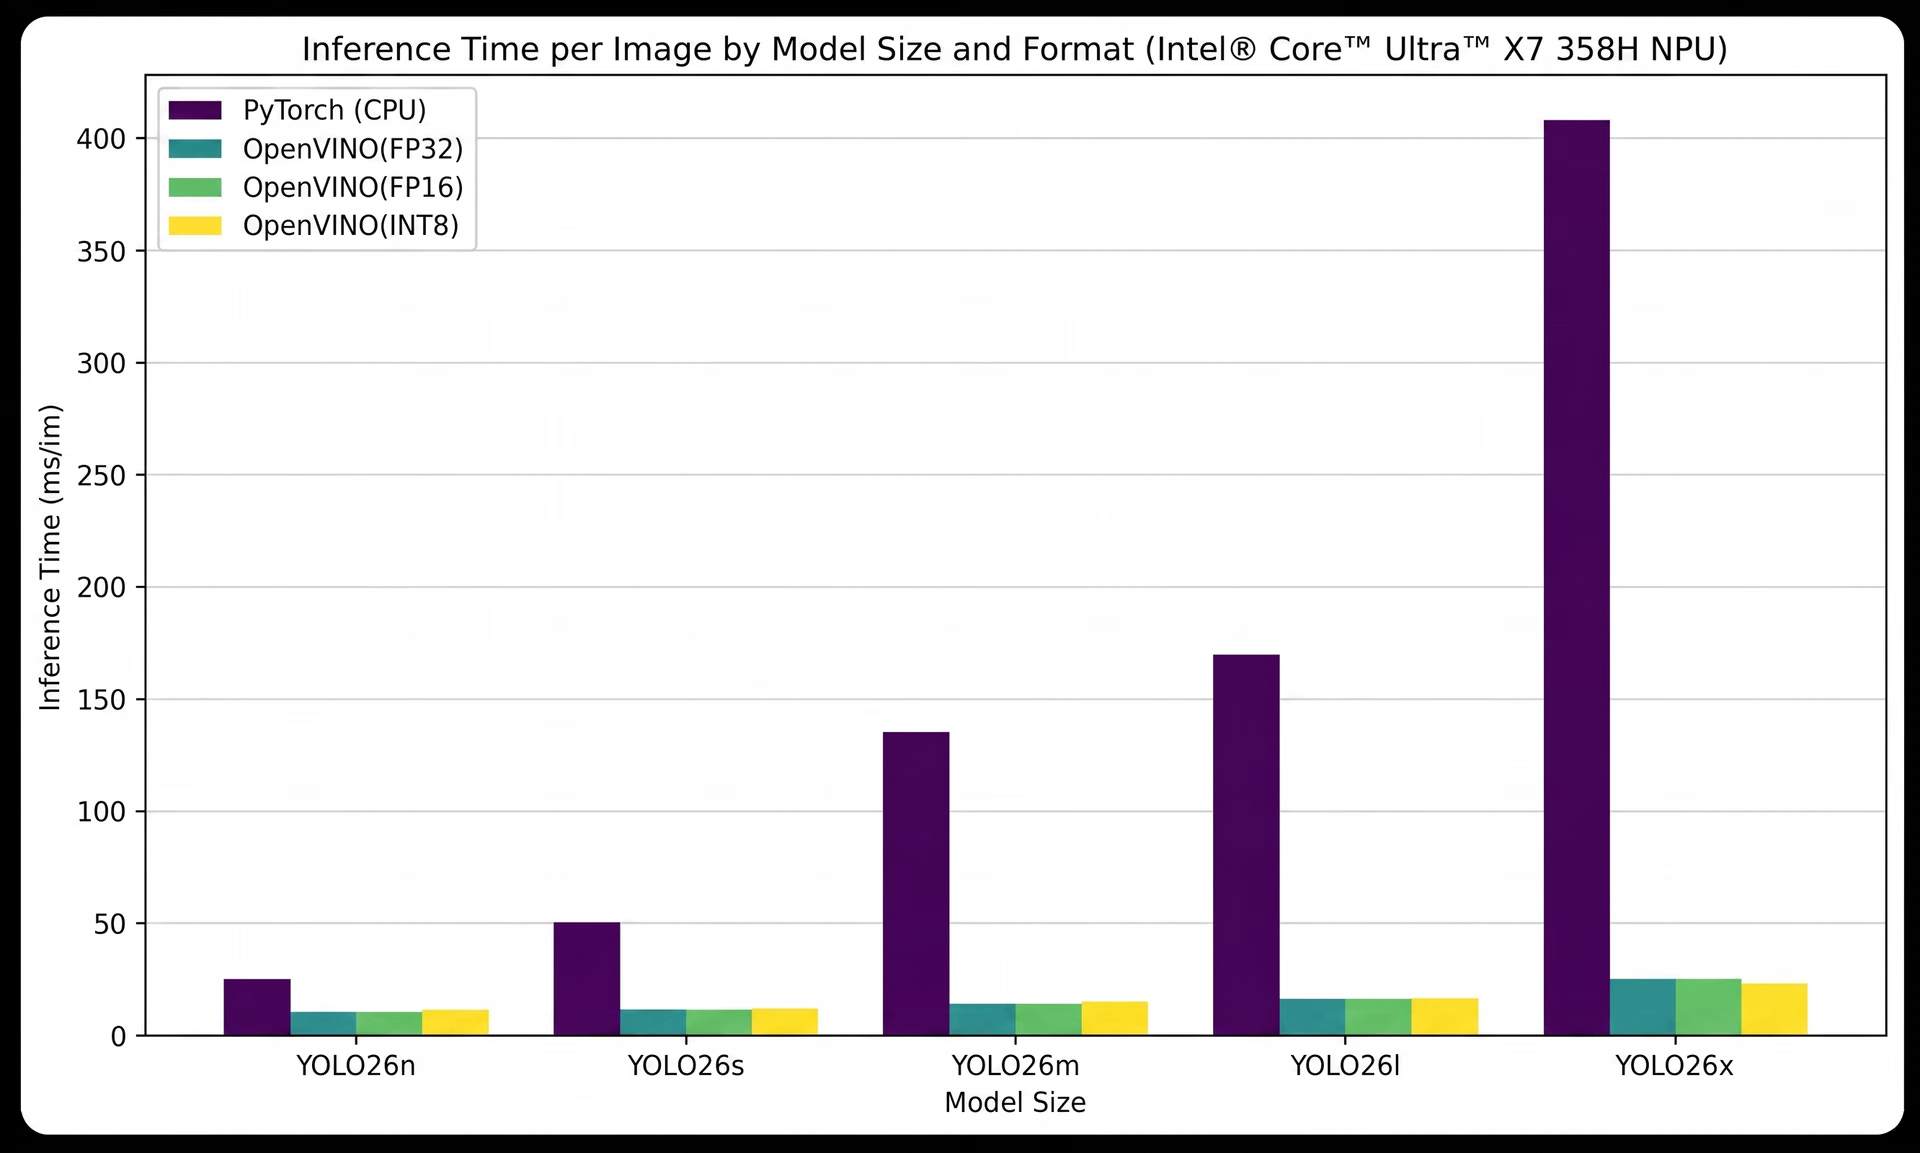
图 3. 使用 OpenVINO 在 Intel Panther Lake NPU 上对 Ultralytics YOLO26 推理进行基准测试(来源)
探索将 Ultralytics YOLO26 导出为 OpenVINO 格式的两种方法#
将 YOLO26 模型导出为 OpenVINO 格式主要有两种方法。你可以使用 Ultralytics Python 包,也可以直接通过 Ultralytics Platform 导出;它是一个端到端工作空间,可用于在同一处构建和管理计算机视觉工作流。下面我们将逐一介绍这两种方法。
使用 Ultralytics Python 包导出 YOLO26#
Ultralytics Python 包提供了一种简单直接的方式,让你在基于代码的工作流中将 YOLO26 模型导出为 OpenVINO 格式。由于训练和推理使用的是同一接口,导出模型可以自然融入现有流程,无需额外工具。
首先,你可以安装 Ultralytics 包。在终端或命令提示符中运行命令“pip install ultralytics”即可。如果你使用 Jupyter Notebook 或 Google Colab 等交互式环境,也可以在相同命令前加上感叹号来运行。
安装完成后,你可以加载训练好的 YOLO26 模型,并直接将其导出为 OpenVINO 格式。如下所示,先加载预训练的 YOLO26n 模型(yolo26n.pt),然后使用 export 方法将其转换为 OpenVINO 格式。
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

model.export(format="openvino")
运行代码后,转换后的模型会保存到一个新目录中,可供部署使用。
在 Ultralytics Platform 上导出 YOLO26#
如果你想采用更简单的免代码方式,可以直接通过 Ultralytics Platform 导出 YOLO26 模型。该平台将完整的计算机视觉工作流整合到一个工作空间中,让你无需额外配置即可轻松从训练过渡到部署。
模型准备就绪后,你可以在平台中打开模型并进入 Export 选项卡。在那里,你可以选择 OpenVINO 作为导出格式,还可以按需调整图像尺寸或精度等设置。
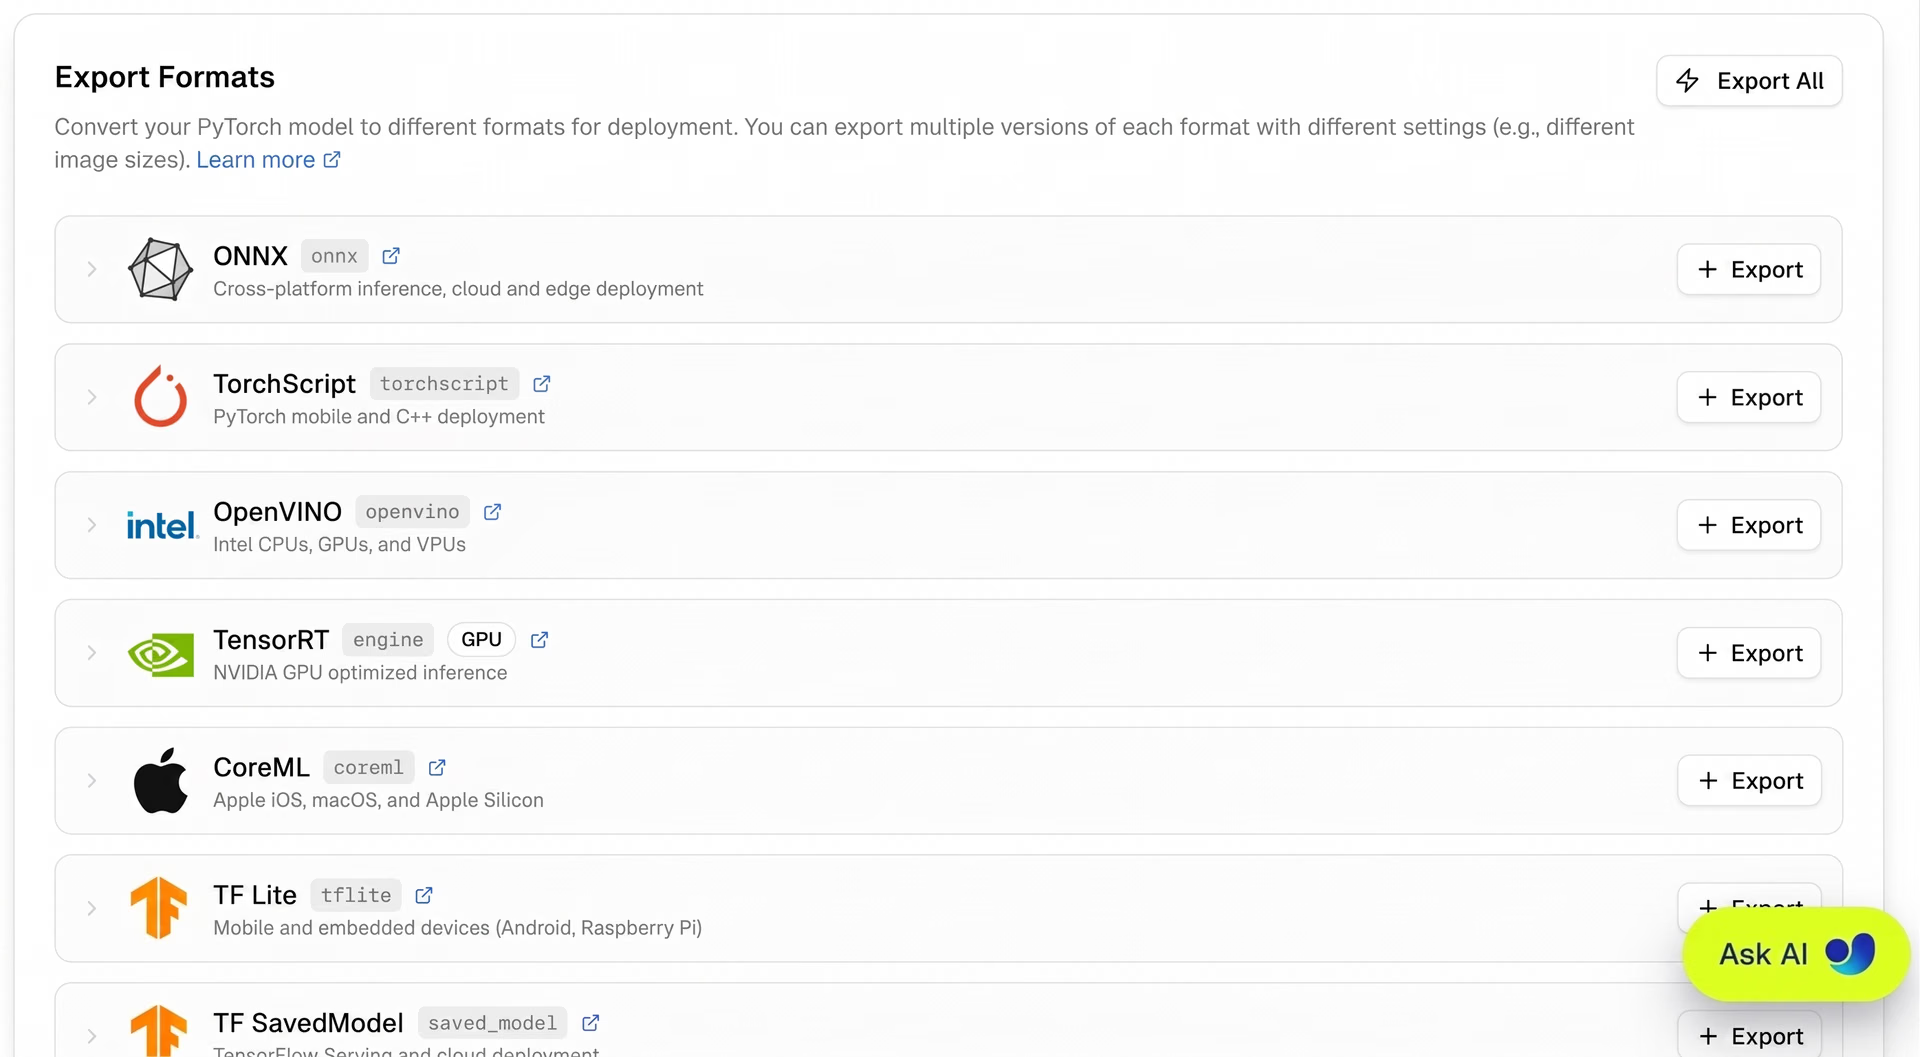
图 4. 在 Ultralytics Platform 中导出 YOLO26
平台会自动完成转换,因此你无需管理脚本、依赖项或环境配置。导出完成后,你可以下载优化后的模型,并将其部署到 Intel CPU、GPU 和 NPU 上。
Ultralytics 与 OpenVINO 集成带来的部署选项#
YOLO26 模型导出为 OpenVINO 格式后,你可以根据工作流和所需的控制能力,通过几种方式运行推理。你可以使用 Ultralytics Python 包,采用更简单的一体化方案;也可以使用原生 OpenVINO 运行时,获得更大的灵活性和控制能力。
使用 Ultralytics Python 包运行推理#
模型导出为 OpenVINO 格式后,你可以使用 Ultralytics Python 包运行推理。此方法非常适合快速测试和简化部署,因为它使用的接口与训练和导出相同。
使用此方法时,你可以从所在目录加载导出的 OpenVINO 模型,并对图像或视频等输入运行推理。你还可以根据系统可用的硬件,通过指定 "intel:cpu"、"intel:gpu" 或 "intel:npu" 等选项,选择要使用的设备。
下面的代码片段展示了如何加载导出的模型,并指定使用 GPU 对图像运行推理。推理完成后,输出图像会保存到“runs/detect/predict”目录中。
ov_model = YOLO("yolo26n_openvino_model/")

results = ov_model("https://ultralytics.com/images/bus.jpg", device="intel:gpu")
利用原生 OpenVINO 包进行推理#
如果你需要更精细地控制模型在生产环境中的运行方式,可以使用原生 OpenVINO 运行时进行推理。当你需要将模型集成到更大的应用程序中,或希望微调模型在特定硬件上的推理执行方式时,这种方法很有用。
OpenVINO 提供统一的方式,让模型能够在 Intel CPU、GPU 和 NPU 上运行,同时还支持异步执行和高效利用可用计算资源等功能。要进行设置,你可以直接使用导出的模型文件,包括定义模型结构的 .xml 文件和包含训练权重的 .bin 文件。
根据你的使用场景,你还可以调整输入尺寸或预处理步骤等设置。推理设置包括初始化 OpenVINO 运行时、加载模型并针对目标设备编译模型、准备输入数据,然后运行推理。
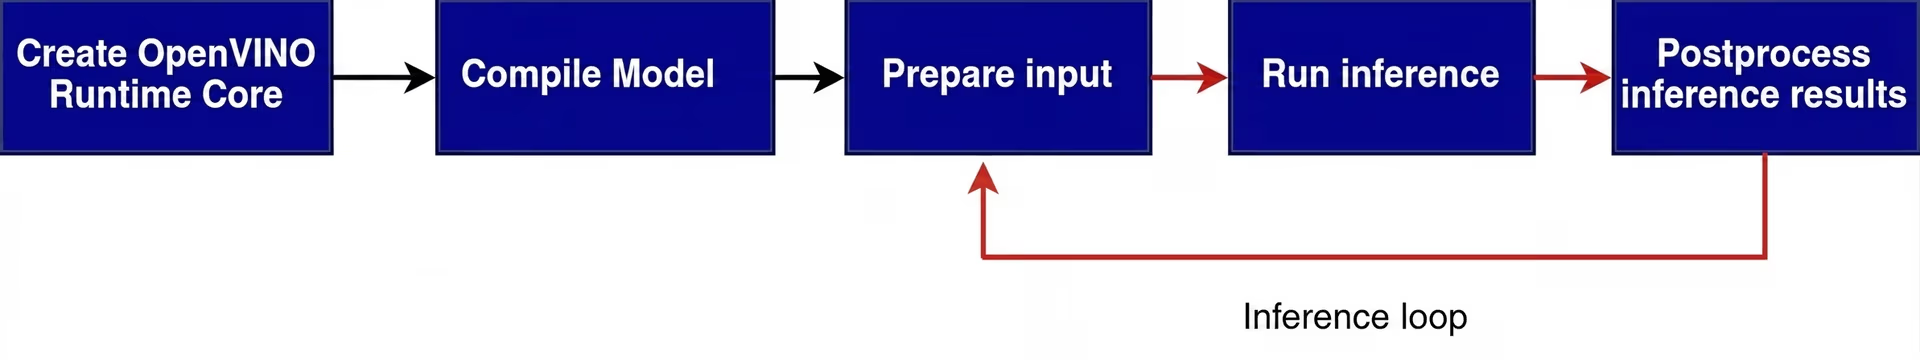
图 5. 典型 OpenVINO 推理流程示例(来源)
这样你就能控制模型的执行方式,以及模型如何融入整体部署方案。要进一步了解如何设置 OpenVINO 运行时并运行推理,可以查看 Ultralytics 的官方文档。
Ultralytics YOLO26 在 Intel 硬件上的实际应用#
Ultralytics 与 OpenVINO 集成的实际价值体现在生产环境中:可靠、低延迟的推理能够带来切实成效。下面介绍这项集成能发挥重要作用的一些关键行业:
-
制造业:将 Ultralytics YOLO26 导出为 OpenVINO 后,生产线系统便可在 Intel 硬件上自动检测零件缺失、错位或表面损伤等视觉缺陷,从而帮助提升产品质量并减少高昂的错误成本。
-
医疗健康:医学影像和患者监护系统可以在 Intel 硬件上本地运行导出的 Ultralytics YOLO26 模型,在保障可靠推理性能的同时满足严格的数据隐私要求。
-
智慧城市:借助部署在 Intel 边缘摄像头上的 Ultralytics YOLO26 导出模型,可以实现交通监控和人群分析,并实时获取车辆计数、行人跟踪和事件检测等信息。
-
汽车行业:在驾驶员监控和车内感知应用中,低延迟和高能效至关重要,因此搭载导出版 Ultralytics YOLO26 模型的 Intel 硬件非常适合嵌入式汽车系统。
想进一步了解这项集成?欢迎参加 Intel 的 OpenVINO DevCon 系列研讨会:“从标注到部署:使用 Geti、Ultralytics YOLO26 和 OpenVINO™ 构建目标检测流水线”。届时,我们的合作伙伴与生态系统经理 Francesco Mattioli 将与 Intel AI 软件布道师 Adrian Boguszewski 一起,现场演示并讲解如何为现实工业场景构建可用于生产的计算机视觉流水线。本次研讨会将展示完整的端到端目标检测工作流,涵盖数据集创建、模型训练、优化和边缘部署。
使用 OpenVINO 导出格式的优势#
以下是使用 OpenVINO 导出格式的一些主要优势:
-
易于使用和集成:OpenVINO 提供统一 API 和 80 多个教程笔记本,让你更轻松地从实验过渡到部署,无需引入过多复杂性。
-
同一模型可在不同硬件上运行:OpenVINO 让你可以在受支持的 Intel 硬件上使用同一个导出模型,并将其部署到 CPU、GPU 或 NPU 上,无需为每台设备重写或调整模型。
-
导出时内置优化:导出为 OpenVINO 格式时,模型会从 PyTorch 和 TensorFlow 等热门框架转换为可直接用于推理的优化格式,无需单独执行转换步骤。
-
更充分地利用硬件资源:OpenVINO 支持在 Intel 硬件上进行异步推理和负载均衡,有助于提升实际应用中的效率。
使用 ExecuTorch 和 OpenVINO 后端运行 Ultralytics YOLO26#
如果你要在要求更高的生产环境中部署 Ultralytics YOLO26,还有另一种方案可供选择,它将设备端效率与先进的模型压缩相结合。
ExecuTorch 是 PyTorch 的设备端推理框架,支持 OpenVINO 后端,让你可以通过不同的导出和运行时路径在 Intel 硬件上部署 Ultralytics YOLO26。
其工作方式是由 ExecuTorch 负责模型导出和运行时执行,而 OpenVINO 则作为底层硬件加速层,负责在 Intel CPU、GPU 或 NPU 上执行实际计算。二者协同工作,让你既能享受 ExecuTorch 带来的可移植性和设备端效率,也能利用 OpenVINO 提供的针对特定硬件的优化。
要进一步了解其工作原理,以及如何开始在 ExecuTorch 和 OpenVINO 后端上使用 Ultralytics YOLO26,请查看 Intel 博客,了解最新的 ExecuTorch 和 OpenVINO 更新。
要点#
通过 Ultralytics 与 OpenVINO 集成导出 YOLO26 模型,无需增加工作流复杂性,就能提升模型在 Intel 硬件上的性能。你可以从训练直接过渡到部署,无需重构流水线。总体而言,这为你提供了一种简单直接的方式,让模型能在实际应用中高效运行于 Intel CPU、GPU 和 NPU。
加入我们的社区,并探索我们的 GitHub 代码仓库,进一步了解视觉 AI。查看我们的许可选项,开始你的计算机视觉项目。对制造业中的 AI或汽车行业中的计算机视觉等创新应用感兴趣?访问我们的解决方案页面,了解更多信息。









