训练自定义图像分类器的最佳平台
图像分类器训练平台对比:无代码 AutoML、开发者平台和边缘工具,以及如何根据控制力、部署方式和成本进行选择。
 Miles Deans9 分钟阅读
AI 生成的示意检测场景。图块展示了四张正确分类的测试照片,这些照片从布料污渍数据集中选出,以便清晰展示。我们训练的 Ultralytics YOLO26s-cls 模型正确分类了 71 张测试图像中的 65 张,其中包括 11 张干净图像中的 7 张和 60 张有污渍图像中的 58 张。图块是测试照片的方形裁剪图。分数表示模型置信度,而非准确率。
训练自定义图像分类器的最佳平台取决于模型的运行位置以及你需要多少控制权。无代码云平台,例如 Amazon Rekognition Custom Labels、Gemini Enterprise Agent Platform 上的 AutoML(原 Vertex AI AutoML)、LandingLens 和 Ultralytics Platform,让你无需编写代码即可上传已标注图像并进行训练。开发者工作流,例如 Amazon SageMaker AI、Azure Machine Learning AutoML 和 Hugging Face Transformers,让你更好地控制模型和训练任务。面向边缘设备的工具,例如 Edge Impulse,适用于小型设备;Teachable Machine 则可免费用于在浏览器中制作原型。
选择时还要考虑服务状态。Microsoft 将于 2028 年 9 月 25 日停用 Azure Custom Vision,而 Hugging Face AutoTrain 已不再维护。Google 现在将 Vertex AI AutoML 称为Gemini Enterprise Agent Platform 上的 AutoML;本指南简称其为 Google Cloud AutoML。
本指南比较了用于在自己的已标注图像上训练分类器的工具,说明如何进行选择,并介绍如何在确定采用前测试分类器。要选择模型架构,请参阅图像分类模型对比。要部署已有模型,请参阅计算机视觉推理平台对比。Ultralytics 发布了这份比较,并提供其中一个平台。
比较要点#
图像分类会为整张图像分配一个或多个标签,例如为生产线上的零件标注“有缺陷”或“合格”。提供分类器训练的平台有五方面的差异,这些差异比功能列表更重要:
- 标签:单标签(每张图像一个类别)或多标签(每张图像多个类别)。并非所有平台都同时支持这两种方式。
- 控制权:AutoML 会替你选择模型和设置;开发者平台则允许你选择架构、图像尺寸和训练设置。
- 模型运行位置:有些平台只能在自己的云端提供模型服务,另一些则允许你导出模型,在自己的硬件上运行。
- 计费方式:训练时长、托管时长和按图像计费的预测费用会以不同方式累积。必须持续运行的模型,成本可能高于训练成本。
- 数据位置:图像的存储和处理位置;对于受监管的数据,这一点尤为重要。
图像分类器训练平台对比#
这些工具类型各不相同:托管式 AutoML 服务、开发者工作流和浏览器原型工具。先根据标签支持情况和模型必须运行的位置筛选候选项,再比较成本;同时先确认现有的预训练模型是否已经能满足需求。
平台按字母顺序排列。供应商文档核查日期为 2026 年 11 月 9 日;这份内容比较的是功能,并非实际操作基准测试。在小屏幕上,横向滚动表格即可查看所有列。
| 平台 | 方式 | 训练后模型的运行位置 | 计费方式 | 最适用场景 |
|---|---|---|---|---|
| Amazon Rekognition Custom Labels | AWS 控制台中的无代码 AutoML | 仅限 AWS,通过 Custom Labels API 使用 | 模型运行期间按训练时长和推理时长计费 | 已在 AWS 上开展业务、希望使用托管 API 的团队 |
| Amazon SageMaker AI | 开发者平台:使用内置图像分类算法或自己的训练代码 | SageMaker 端点,或部署导出模型的任意位置 | 按训练和托管实例付费 | 希望在 AWS 内获得完全控制权的机器学习团队 |
| Azure Custom Vision | 无代码门户 | Azure API;紧凑型领域模型也可以导出 | 训练计算时长、预测事务和图像存储费用 | 计划迁移的现有客户;该服务将于 2028 年 9 月 25 日停用 |
| Azure Machine Learning AutoML | 通过 Python SDK 或 CLI 进行 AutoML 图像训练;在工作室中查看结果 | Azure 端点或导出的模型 | 按计算资源付费 | Microsoft 推荐的 Custom Vision 后续迁移方案 |
| Edge Impulse | 在网页工作室中进行迁移学习(高通旗下公司) | 微控制器、嵌入式 Linux 和其他边缘设备 | 免费开发者计划可用于探索和原型开发;请确认生产用途的授权;企业版价格需询价 | 适用于小型低功耗设备的分类器 |
| Google Cloud AutoML(Gemini Enterprise Agent Platform 上的 AutoML,原 Vertex AI AutoML) | Google Cloud 中的无代码 AutoML | Google Cloud 端点,或供设备使用的 AutoML Edge 模型 | 按训练节点时长和托管费用付费 | 已在 Google Cloud 上开展业务的团队 |
| Hugging Face Transformers | 通过代码微调 ViT 等预训练图像分类器,并在 Hugging Face Hub 上分享模型 | 自己的基础设施或自行配置的托管服务 | 使用自己的计算资源,或付费使用训练和托管资源;请查看每个模型的许可证 | 希望自行选择检查点并控制训练流程的开发者。较早的无代码选项 AutoTrain 已不再维护 |
| LandingLens | 无代码平台,支持分类、检测和分割项目 | 云端或边缘设备,支持从 Windows 应用到 API 的多种方式 | 免费计划有使用限制,包括仅限非商业用途的一次模型下载;更高用量需使用付费计划 | 制造业检测团队 |
| Teachable Machine | Google Creative Lab 提供的免费浏览器工具 | 导出的 TensorFlow、TensorFlow.js 或 LiteRT(.tflite)模型 | 免费 | 学习和快速原型开发 |
| Ultralytics Platform | 上传、标注数据,并在云 GPU 上训练 YOLO26 分类模型 | 平台端点,或导出为 ONNX、TensorRT、CoreML 和 LiteRT 等格式 | 使用额度支付云 GPU 时长(每小时 0.24 美元起);注册后可获得额度 | 希望获得可导出分类器并在自有硬件上运行的团队 |
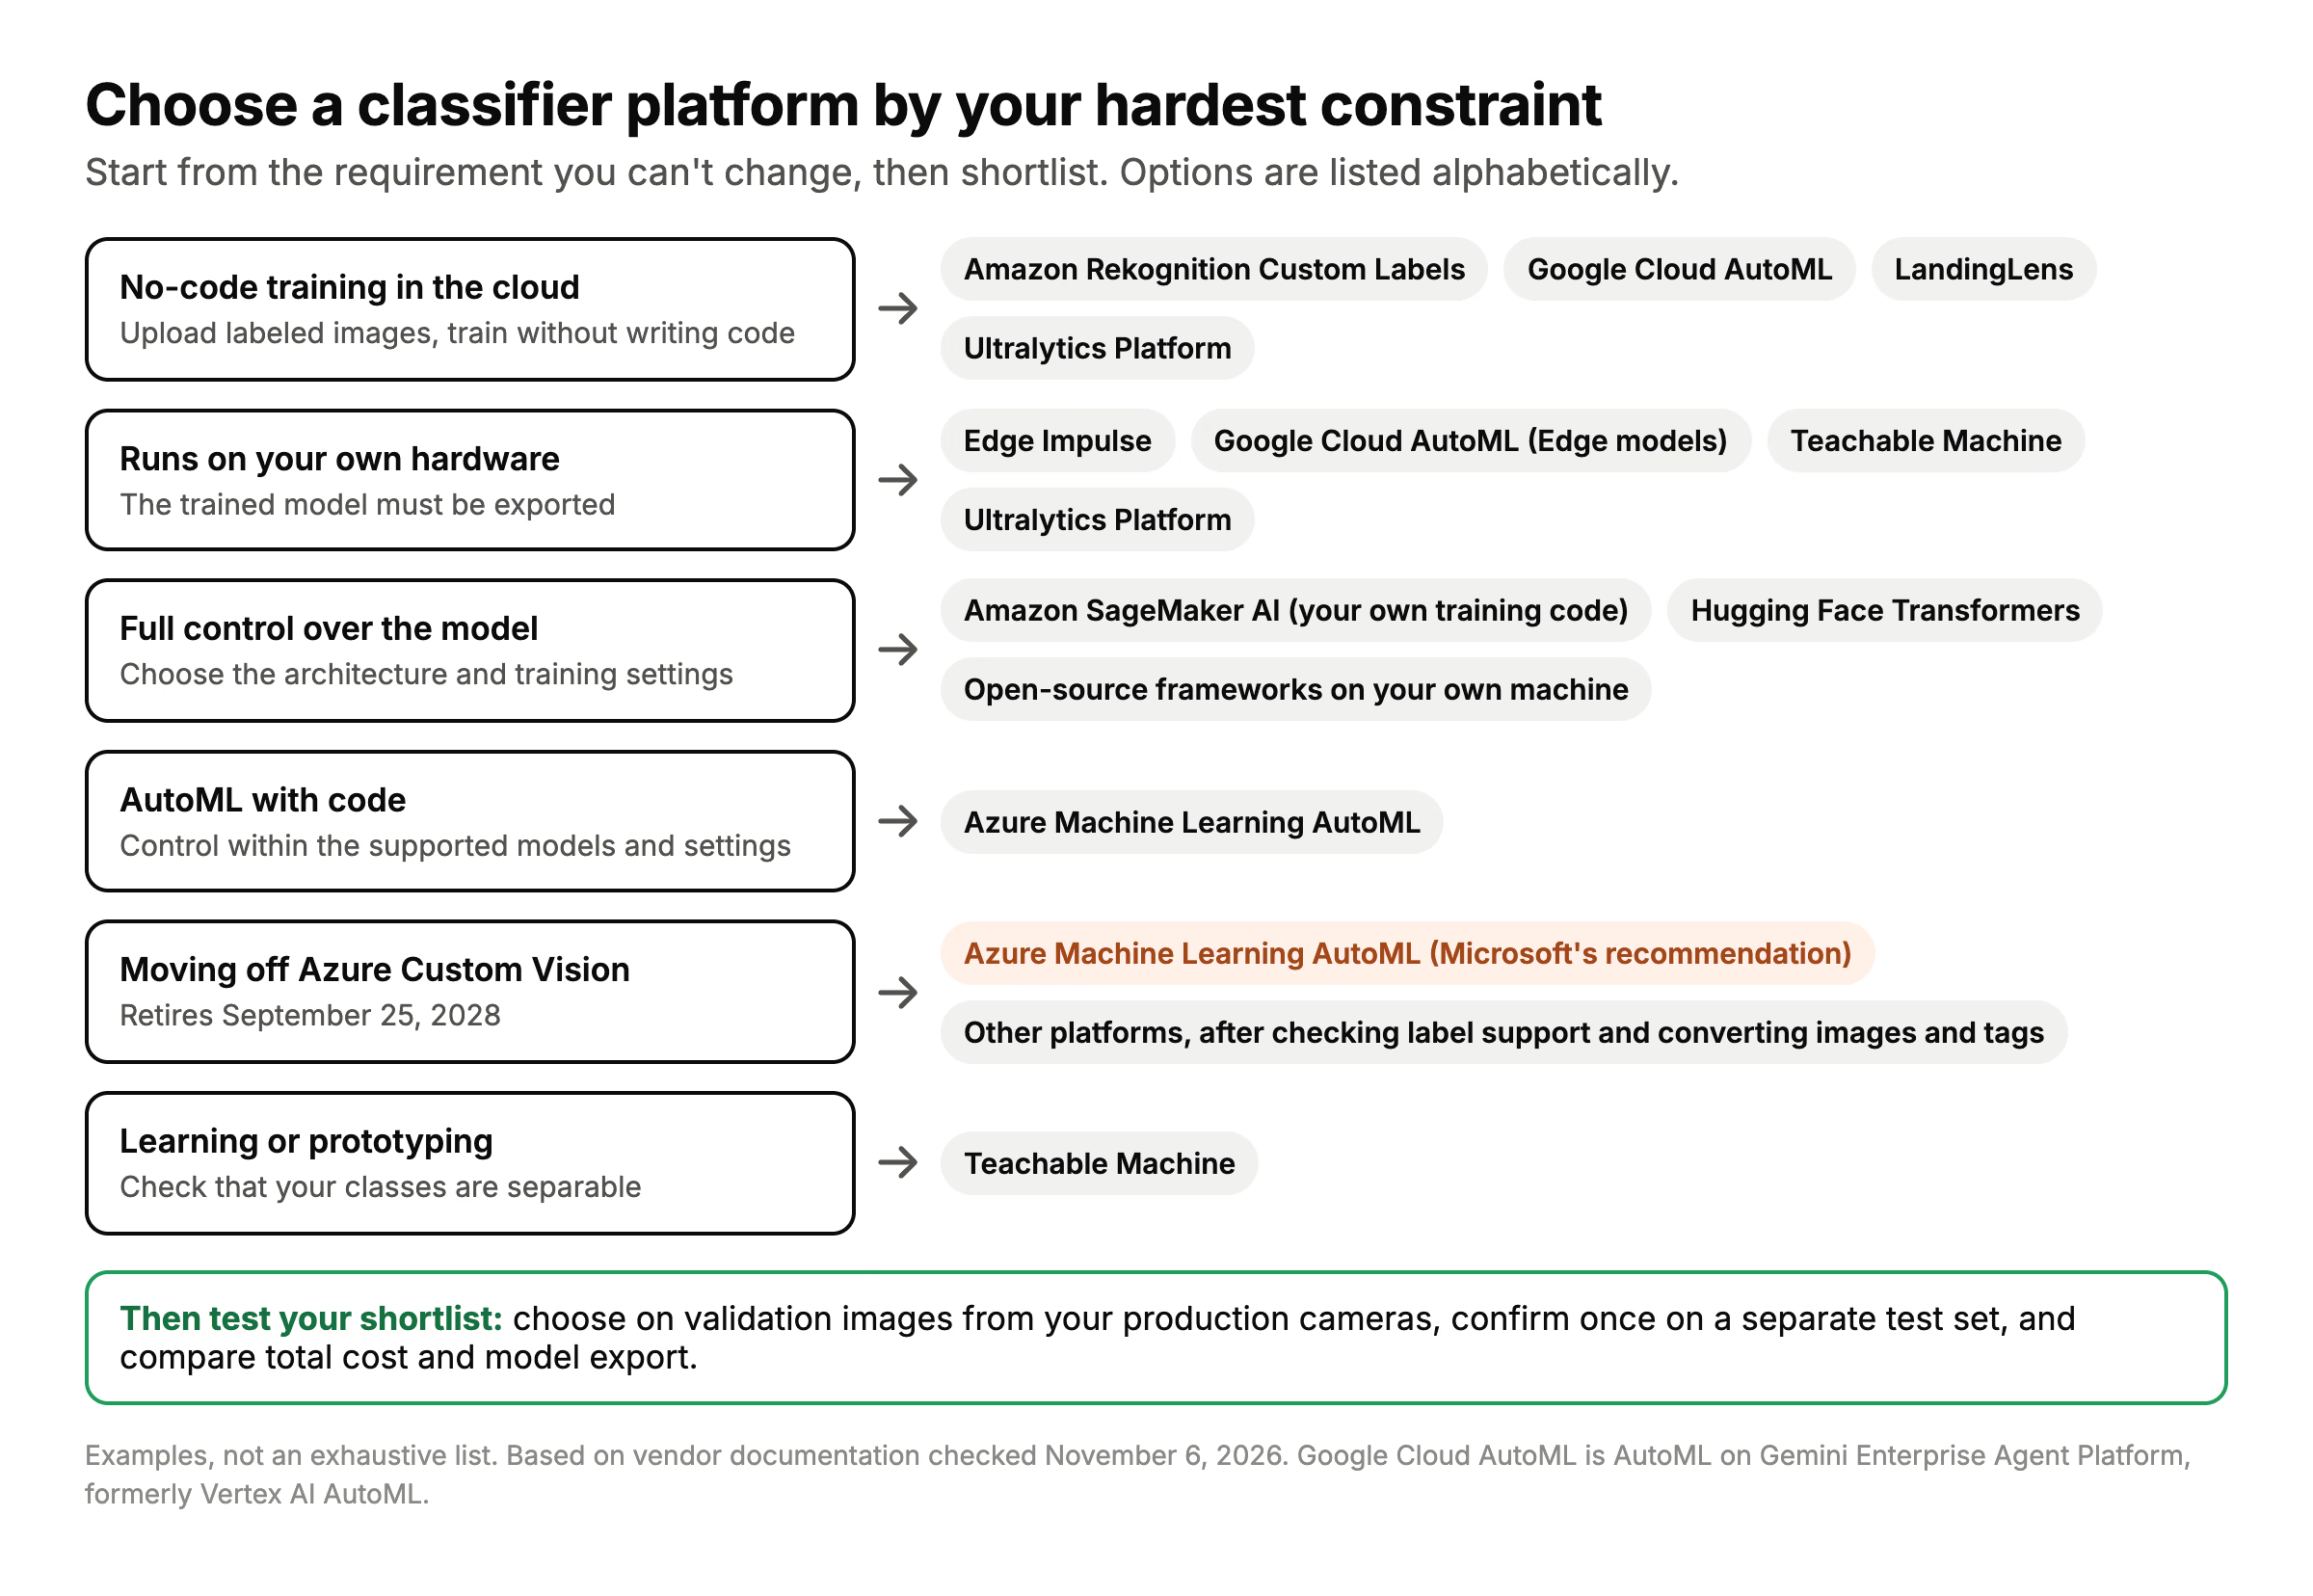
按需求划分的候选平台示例。这些分组彼此有所重叠;选择前请确认标签支持情况、部署权限和运行时兼容性。
Ultralytics Platform 训练单标签分类器,即每张图像对应一个类别。如果你需要多标签分类,可以考虑 Azure Machine Learning AutoML 或 Google Cloud AutoML。
如何选择#
从你最不能妥协的决策条件开始。
你不想编写代码,并且需要托管 API#
选择你已经在使用的云平台所提供的 AutoML 服务:AWS 上的 Amazon Rekognition Custom Labels,或 Google Cloud 上的 Google Cloud AutoML。两者都会替你处理模型和设置。请确认模型需要保持运行的时长,因为 Rekognition Custom Labels 在模型启动期间每小时都会计费,即使模型没有分析图像也一样。
你需要在自己的硬件上运行模型#
选择能够导出训练后模型的平台。Edge Impulse、Google Cloud AutoML(Edge 模型)、Teachable Machine 和 Ultralytics Platform 都支持模型导出;选择前请确认支持的运行时、计划限制和许可证条款。对于工厂电脑、摄像头和 GPU,导出的 YOLO26 分类模型可通过 ONNX、TensorRT 或 OpenVINO 运行。对于微控制器,Edge Impulse 专为这类设备而设计。
你希望完全控制模型#
若要控制架构和训练设置,可以使用 SageMaker 和自己的训练代码,或通过 PyTorch、TensorFlow、Keras、Hugging Face Transformers 或 Ultralytics YOLO 软件包构建工作流。请确认每个库支持哪些架构。Azure Machine Learning AutoML 等 AutoML 工具可让你在其支持的模型和设置范围内进行控制。无论选择哪种方式,都需要投入更多精力进行设置。
你正从 Azure Custom Vision 迁移#
Microsoft 将持续为现有客户提供完整支持,直到 2028 年 9 月 25 日,并推荐使用 Azure Machine Learning AutoML进行自定义分类。迁移时,请导出图像和标签分配;保留你曾使用的多个标签,并在重新训练前将数据转换为新平台的导入格式。
你正在学习或制作原型#
Teachable Machine 免费且可在浏览器中训练,因此适合用来测试各类别是否容易区分,再决定是否收集完整数据集。
如何在确定采用前检查分类器#
平台演示中的准确率几乎无法说明模型在你自己的图像上的表现。请在每个入围平台上进行相同的简短测试:
- 分别保留训练集、验证集和测试集。测试图像应来自模型在生产环境中会遇到的摄像头和拍摄条件,并将近似重复图像以及同一采集序列中的图像放在同一个数据集中。
- 训练一个基线模型,使用相同的训练图像和各平台的默认设置,并记录计算资源、训练预算或图像尺寸方面的限制。
- 使用验证集进行选择。比较每个类别的精确率、召回率和混淆矩阵,以及模型在你将使用的硬件上的速度,并在此阶段设置任何阈值。
- 只用未参与训练的测试集测试最终选择一次:单标签分类器看 top-1 准确率;多标签分类器则看每个标签的精确率、召回率和 F1。
- 核算全部成本:训练费用,加上按预期使用量计算的托管或预测费用。
- 检查退出选项:能否下载训练后的模型、以何种格式下载,以及适用什么许可证?
在每个平台上使用相同的图像、标签和数据集划分,并转换为对应平台的导入格式。下面是一个使用 Ultralytics YOLO 进行最终测试的可选示例:
from ultralytics import YOLO

model = YOLO("yolo26n-cls.pt")  # pretrained on ImageNet
model.train(data="path/to/dataset", epochs=50, imgsz=224)  # dataset/train/<class>/, dataset/val/<class>/

metrics = model.val(split="test")  # dataset/test/<class>/, never used in training (needs its own test folder)
print(f"top-1 accuracy: {metrics.top1:.3f}, top-5 accuracy: {metrics.top5:.3f}")查看分类数据集格式了解文件夹结构,查看分类文档了解分类示例,并查看训练设置了解所有训练选项。请分别保留 train、val 和 test 文件夹:如果缺少 test 文件夹,最终检查会改用验证图像。
Ultralytics 的适用范围#
Ultralytics 支持单标签分类器训练和导出。选择前,请在自己的数据上比较其结果。
- 在云端或本地训练。Ultralytics Platform 可让你在浏览器中通过云 GPU 训练 YOLO26 分类器;开源的
ultralyticsPython 软件包则可在自己的机器上训练相同的模型。 - 在一个工作流中准备数据并进行训练。使用Platform 数据集说明导入按类别文件夹组织的数据集,检查标签和数据集划分,然后在 Ultralytics Platform 中训练。
- 在需要的位置运行模型。将模型导出为 ONNX、TensorRT、CoreML、LiteRT 等格式,或部署到 Platform 端点。
- 了解限制。分类器仅支持单标签。Platform 端点运行在 CPU 上,因此高流量 GPU 服务最好在自己的硬件或其他云平台上运行。Ultralytics 提供 AGPL-3.0 和企业许可证:无法满足 AGPL-3.0 义务的专有部署需要企业许可证。
常见问题
Teachable Machine 免费且可在浏览器中运行,适合制作原型。Ultralytics YOLO 软件包可在你自己的硬件上运行,无需支付软件费用,但须遵守 AGPL-3.0;无法满足 AGPL-3.0 义务的专有部署需要获得企业许可证。Ultralytics 平台提供注册额度。
没有一个适用于所有情况的固定数量。先从生产环境中的摄像头和各种拍摄条件下采集多样化样本,再根据验证错误判断哪些类别需要更多样本,并保留单独的测试集进行最终检查。与从头开始训练相比,微调合适的预训练模型可以减少所需的标注数据量。
在某些平台上可以。Edge Impulse、Google Cloud AutoML(边缘模型)、Teachable Machine 和 Ultralytics 平台都支持导出模型;请确认支持的运行时、套餐限制和许可条款。Amazon Rekognition Custom Labels 模型只能通过 AWS API 运行。
Microsoft 推荐使用 Azure Machine Learning AutoML 构建自定义分类模型,并将继续为现有 Custom Vision 客户提供支持,直至 2028 年 9 月 25 日。若要迁移到其他平台,请导出图像和标签分配,并将其转换为该平台的导入格式。
可以。Google 现在将其称为 Gemini Enterprise Agent Platform 上的 AutoML,AutoML 图像分类仍采用相同的训练工作流。
如果只需为整张图像赋予一个标签(例如“合格”或“不合格”),就使用分类。如果你需要了解物体的位置或数量,就使用目标检测。
作者
评论
提出问题、分享你的结果,或帮助其他人。









