Raspberry Pi 目标检测:在 Pi 5 CPU 上运行 YOLO26,无需加速器
YOLO26n 在 Raspberry Pi 5 CPU 上使用 NCNN 时,每张图像耗时 67.03 毫秒;Arm 的开源运行时在其自己的测试中测得 36.60 毫秒。下面介绍如何运行这两种方案。
 Onuralp Sezer9 分钟阅读
Raspberry Pi 5 能否仅靠 CPU 运行目标检测,而不使用 AI HAT 或 USB 加速器?可以。在我们的基准测试中,Ultralytics YOLO26n 导出为 NCNN 后,在 Pi 5 的四个 Arm Cortex-A76 核心上每张图像推理耗时 67.03 毫秒,约为每秒 15 帧推理。Arm 还发布了一个专为该模型和开发板打造的开源运行时;Arm 在自己的测试中测得每张图像耗时 36.60 毫秒,约为每秒 27 帧推理。
本文将说明这两个数字各自对应的测试条件,以及每个数字反映的情况。接着,本文将逐步介绍如何在 Raspberry Pi 5 CPU 上运行 YOLO26n,从安装到实时摄像头检测;还会讲解如何在同一块开发板上运行 Arm 的运行时,以及何时仍值得添加加速器。
如果你刚接触目标检测本身,可以先了解什么是目标检测。本文介绍的是如何在 Pi 上运行目标检测。
Arm 的运行时在 Raspberry Pi 5 CPU 上运行 YOLO26n,每张图像耗时 36.60 毫秒#
Arm 的 Optimized-Runtimes 仓库汇集了针对特定模型和平台优化的 Arm 推理运行时。目前列出的运行时用于在 Raspberry Pi 5 上执行 YOLO26n 目标检测。每个运行时都有独立目录,其中包含构建、转换、示例、基准测试、测试和发布文档。
Arm 的学习指南在一项测试中比较了 Arm 运行时和 NCNN:Arm 运行时每张图像耗时 36.60 毫秒,NCNN 耗时 67.20 毫秒;两者均使用 YOLO26n,输入尺寸为 640 x 640,批次大小为 1,并在 Arm 的 coco-128-by-sa 数据集(共 128 张图像)上测试。两者的精度接近,Arm 运行时的 mAP50-95 为 0.4863,NCNN 为 0.4902。这些耗时分别约为每秒 27 帧和每秒 15 帧;在该测试中,Arm 运行时的吞吐量约高出 84%。Arm 指出,其 NCNN 模型使用 FP32 权重,并启用了 FP16 运算。
对于在成本和功耗受限的开发板上构建应用的团队来说,推理时间减半,意味着每帧可为采集、跟踪和应用的其他部分留出更多预算。这些数据仅代表推理时间;采集、预处理、绘制和显示都会增加每帧耗时,因此请在设备上测量完整的摄像头处理流程。这个运行时也延续了我们此前介绍的合作:Arm Create 2026 发布时,Ultralytics YOLO 作为预优化模型加入了 Arm AI Portal。
我们的 NCNN 基准测试显示,YOLO26n 在 Raspberry Pi 5 上每张图像耗时 67.03 毫秒#
Ultralytics 团队在 Raspberry Pi 5 上对 YOLO26 的八种导出格式进行了基准测试,相关内容见 Raspberry Pi 指南。测试条件如下:模型以 FP32 精度导出,默认输入尺寸为 640 像素,使用 Ultralytics 8.4.108,在 COCO128 上评估精度;计时仅涵盖推理,不包括预处理和后处理。我们的基准测试使用 FP32 导出模型。Arm 的另一项 NCNN 测试启用了 FP16 运算。67.03 毫秒和 67.20 毫秒这两个 NCNN 耗时不能直接比较。
NCNN 明显是速度最快的 Ultralytics 导出格式:
| YOLO26n 格式 | 推理时间(毫秒/图像) | mAP50-95(B),COCO128 |
|---|---|---|
| PyTorch | 299.09 | 0.4760 |
| ONNX | 125.99 | 0.4734 |
| LiteRT | 123.30 | 0.4730 |
| OpenVINO | 104.55 | 0.4734 |
| MNN | 91.87 | 0.4749 |
| NCNN | 67.03 | 0.4784 |
NCNN 的运行速度约为 PyTorch 权重的 4.5 倍(67.03 毫秒,而 PyTorch 为 299.09 毫秒),且在 COCO128 上的 mAP50-95 为 0.4784,高于 PyTorch 的 0.4760。更大的 YOLO26s 使用 NCNN 时耗时 172.88 毫秒;因此,如果你希望在 Pi CPU 上获得最高帧率,可以从 nano 模型开始。
YOLO26 在这块开发板上的表现也优于前代模型。在一项独立的 ONNX 基准测试中,输入尺寸为 640 像素时,YOLO26n 的速度为 7.79 FPS,而 YOLO11n 为 6.79 FPS,快约 15%;在 COCO 验证集上的 mAP50-95 分别为 40.1% 和 39.5%(Ultralytics 8.4.14)。导出时使用 nms=False,YOLO26 还可以在支持该功能的格式(例如 ONNX 和 OpenVINO)中不使用非极大值抑制;正如端到端检测指南所述,NCNN 会回退到使用 NMS 的标准检测头。
只有在条件一致时,才比较 Raspberry Pi 的性能数据#
Arm 的测试很有参考价值,因为它在不同运行时之间保持模型、输入尺寸、批次和数据集不变。你在网上看到的大多数 Pi 基准测试并非如此。影响结果最大的三个设置是:精度(FP32、FP16 或 INT8)、输入尺寸,以及计时范围——仅计算模型的前向传播,还是计算从图像到最终检测框的整个流程。
精度评估也需要同样谨慎。我们的 mAP 来自 COCO128(一个包含 128 张图像的样本集),因此在部署任何模型前,尤其是量化模型前,请使用你自己的验证图像检查精度。
五步在 Raspberry Pi 5 CPU 上运行 YOLO26n#
下面介绍通过 Ultralytics Python 包运行模型的最快受支持方案。该方案假设你使用的是装有 64 位 Raspberry Pi OS 的 Raspberry Pi 5;Raspberry Pi 指南介绍了如何刷写操作系统和设置 Docker。
- 在虚拟环境中安装 Ultralytics。当前版本的 Raspberry Pi OS 会阻止将
pip安装到系统 Python 中,因此请创建一个仍可使用系统摄像头库的环境:
sudo apt update
sudo apt install -y python3-venv python3-picamera2 rpicam-apps
python3 -m venv --system-site-packages ~/yolo
source ~/yolo/bin/activate
pip install ultralytics- 将 YOLO26n 导出为 NCNN 并进行测试。导出模式会生成一个
yolo26n_ncnn_model文件夹,你可以像加载其他模型一样加载它:
from ultralytics import YOLO

# 在 Pi 上导出一次;创建 'yolo26n_ncnn_model' 文件夹
model = YOLO("yolo26n.pt")
model.export(format="ncnn")

# 加载 NCNN 模型并在 CPU 上运行
ncnn_model = YOLO("yolo26n_ncnn_model")
results = ncnn_model("https://ultralytics.com/images/bus.jpg")
print(results[0].speed)  # 预处理、推理和后处理耗时,单位为毫秒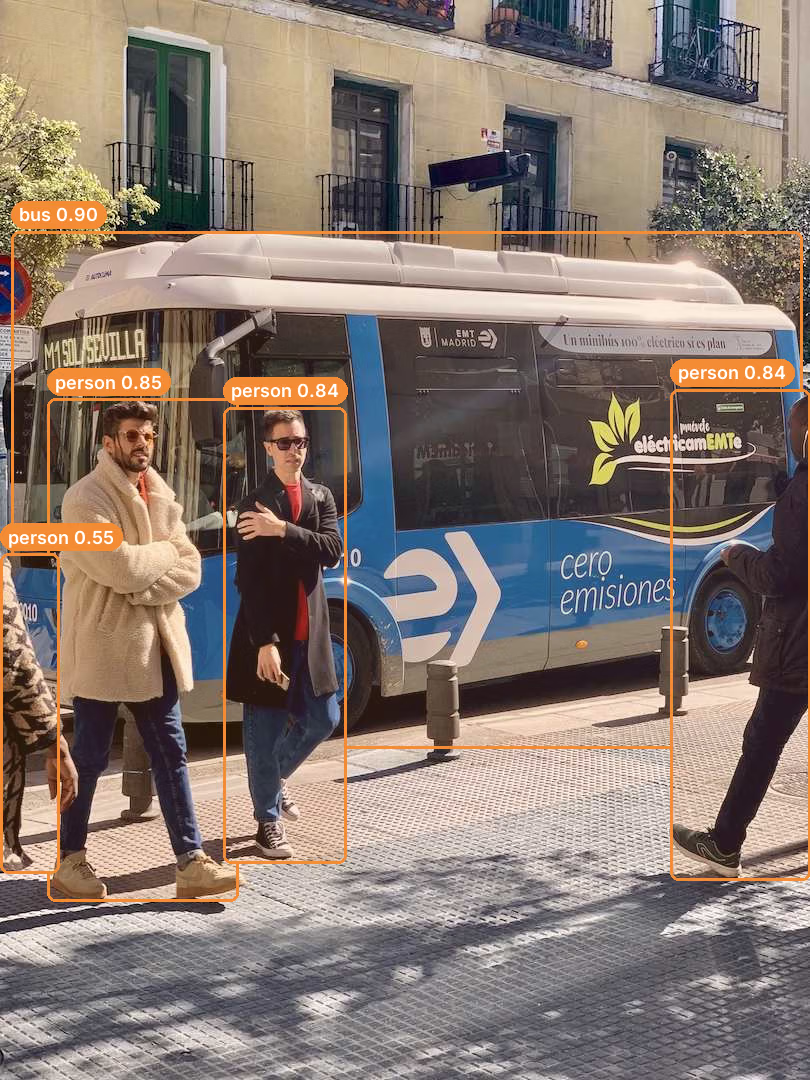
第 2 步中的 bus.jpg 测试图像经 YOLO26n 导出为 NCNN 后运行:检测到一辆公交车和四个人。结果在桌面 CPU 上记录;Pi 上的检测框和置信分数可能略有不同。
- 连接摄像头。使用
rpicam-hello检查画面。Pi 5 有两个 22 针摄像头/显示器接口,因此 15 针摄像头模块需要转接线。 - 运行实时检测。
picamera2会将帧直接交给模型。cv2.imshow窗口需要桌面会话;如果使用无头 Pi,请删除显示相关代码行,并在代码中使用检测结果:
import cv2
from picamera2 import Picamera2

from ultralytics import YOLO

picam2 = Picamera2()
picam2.preview_configuration.main.size = (1280, 720)
picam2.preview_configuration.main.format = "RGB888"
picam2.preview_configuration.align()
picam2.configure("preview")
picam2.start()

model = YOLO("yolo26n_ncnn_model")

while True:
    frame = picam2.capture_array()
    results = model(frame)
    cv2.imshow("Camera", results[0].plot())
    if cv2.waitKey(1) == ord("q"):
        break

cv2.destroyAllWindows()- 在你的开发板上进行基准测试。
yolo benchmark model=yolo26n.pt data=coco128.yaml imgsz=640会尝试在你自己的 Pi 上运行各种导出格式,让你了解散热、操作系统镜像和电源的实际表现。有些格式无法直接在 Pi 上导出:例如,LiteRT 只能在 Linux x86_64 或 macOS 上导出,因此请先在那里导出,再将文件复制到 Pi 并单独验证。若要获得更稳定的精度数据,请使用更大的验证集,例如data=coco.yaml。
在同一台 Pi 上同时运行 Arm 运行时和 NCNN#
Arm 的运行时是独立项目,并非 Ultralytics 导出格式;其设置步骤针对的是安装 Python 3.13 的 64 位 Raspberry Pi OS Trixie。若要试用并与 NCNN 比较:
- 克隆 arm/Optimized-Runtimes,进入
yolo26-raspberry-pi-5目录,按照其中的先决条件操作,并使用make runtime构建运行时。 - 运行
make example-video,查看示例视频中的检测结果。 - 运行
make ultralytics-benchmark,在你的开发板上对 Arm 运行时进行基准测试。 - 按照上文第 2 步将 YOLO26n 导出为 NCNN,然后在同一个生成的
coco-128-by-sa数据集上验证;使用 Arm 对比页面中的环境、检查点和命令,确保两种运行时使用相同输入尺寸处理相同图像。 - 对于你自己的模型,请按照运行时的模型卡说明,使用
make model CHECKPOINT=/path/to/checkpoint.pt转换兼容的微调 YOLO26n 检查点,并同时比较你自己的验证集精度和运行速度。
在 Arm 的对比测试中,对于 YOLO26n 目标检测,Arm 运行时是速度更快的 CPU 方案。Ultralytics NCNN 导出则涵盖其他场景:在NCNN 指南所列限制范围内,你可以通过同样两行代码运行其他尺寸和任务的 YOLO26,包括分割和姿态估计。
散热、超频和轻量级操作系统能提升帧率#
模型开始运行后,开发板的性能就决定了上限。Raspberry Pi 指南的最佳实践列出了以下优化方法:
- 为开发板散热。持续推理会使 CPU 发热,而热降频会降低基准测试时预期的时钟速度。散热片和风扇有助于保持帧耗时稳定。
- 确保散热后再超频。部分 Pi 5 开发板可将 CPU 从基础频率 2.4 GHz 超频至 3.0 GHz:在
/boot/firmware/config.txt中设置arm_freq=3000和force_turbo=1,然后重启。不同开发板的稳定性各不相同;如果系统变得不稳定,请将频率调低 100 MHz。 - 不使用桌面环境。Raspberry Pi OS Lite 可为视觉任务留出更多 RAM。
- 全天候运行时使用 SSD。持续写入会损耗 SD 卡;Pi 5 的 PCIe 接口可连接 NVMe 转接器。
- 目标较大时缩小输入尺寸。更小的
imgsz意味着每帧像素更少。请在自己的视频素材上测量速度和精度的变化,因为小目标或远处目标会最先受到影响。我们的计算机视觉中的 FPS 指南介绍了如何设定帧率预算。
单个 Pi CPU 性能不足时,添加加速器#
仅使用 CPU 的 Pi 5 适合单摄像头和中等帧率的场景。对于多个视频流、更大的模型,或需要为其他软件预留性能余量的场景,加速器可以让模型不再占用 CPU。以下是在 Raspberry Pi 5 上测得的 YOLO26n 推理时间(仅推理,COCO128),数据来自使用量化模型和不同 Ultralytics 版本的独立测试:
- AI HAT+ 上的 Hailo-8:耗时 21.7 毫秒,mAP50-95 为 0.455,使用 Ultralytics 8.4.174。
- DEEPX DX-M1 M.2 模块:耗时 34.6 毫秒,mAP50-95 为 0.4660,使用 Ultralytics 8.4.48。
- Coral Edge TPU:一种 USB 方案,拥有独立的导出流程;该指南中的耗时数据使用 YOLOv8 模型测得。
每种方案都需要额外硬件和电力,还需要执行模型编译步骤;加速模型以量化方式运行,因此请在导出后检查精度。若想了解更多方案,请参阅如何选择合适的边缘设备;如果 Pi 的算力不够,请参阅 NVIDIA Jetson 指南。
训练自定义检测器,然后以相同方式部署#
COCO 的 80 个类别只是起点。大多数 Pi 项目都需要识别自己的目标:生产线上的零件、货架上的商品、叶片上的害虫。Ultralytics Platform可端到端处理整个流程:上传并标注数据集,从 YOLO26n 检查点开始在云端训练,然后导出为 NCNN 并将文件夹复制到 Pi。
先从 nano 模型开始,然后使用摄像头拍摄的、有代表性的视频素材,通过自定义模型验证精度并测量速度。我们的模型训练技巧和 Academy 中关于选择部署目标的课程涵盖了其他相关内容。
哪些人适合在 Raspberry Pi 5 CPU 上运行 YOLO26#
如果你只有一个摄像头,能够接受在设备上测得的端到端帧率,并希望物料清单尽可能简单——只需 Raspberry Pi、摄像头、风扇和电源——那么可以在 Pi 5 CPU 上运行 YOLO26n。零售柜台、家用和野生动物摄像头、传送带计数以及机器人原型都适合这种方案。
如果你的全部工作负载只是 YOLO26n 目标检测,而且每毫秒都很重要,可以使用 Arm 的运行时。如果你需要处理多个摄像头、运行更大的模型,或为应用的其他部分留出 CPU 时间,则应添加加速器。
Ultralytics YOLO 根据 AGPL-3.0 或 Ultralytics 企业许可证提供。请查看 Ultralytics 许可选项,了解哪种许可适合你的部署需求。
常见问题
可以,适用于中等帧率的单摄像头任务。在 Ultralytics 基准测试中,YOLO26n 导出为 NCNN 后,在 Raspberry Pi 5 CPU 上每张图像推理耗时 67.03 毫秒(FP32 导出,输入尺寸为 640 像素),约为每秒 15 帧推理。另外,Arm 在其自己的对比测试中测得 YOLO26n 使用其开源运行时时耗时 36.60 毫秒;这是另一项测试,并不代表速度比我们测得的 67.03 毫秒提升了多少。摄像头采集和绘制会增加耗时,因此请测量完整处理流程。
在 Arm 的对比测试中,其 Optimized-Runtimes YOLO26n 运行时速度最快,每张图像耗时 36.60 毫秒,而 NCNN 耗时 67.20 毫秒。在我们对 Ultralytics 导出格式进行的另一项基准测试中,NCNN 以 67.03 毫秒的耗时位居第一,快于耗时 91.87 毫秒的 MNN 和耗时 104.55 毫秒的 OpenVINO。这些是两项独立的基准测试,使用了不同的数据集——COCO128 和 Arm 的 coco-128-by-sa,因此不能根据这些耗时推断两项测试之间的速度提升。
是的。在 Raspberry Pi 5 上进行的一项独立 ONNX 基准测试中,输入尺寸为 640 像素时,YOLO26n 的速度为 7.79 FPS,而 YOLO11n 为 6.79 FPS,快约 15%;在 COCO 验证集上的 mAP50-95 分别为 40.1% 和 39.5%。
中等帧率的单摄像头任务不需要。对于多路视频流或更大的模型,加速器会很有帮助:在我们的测试中,量化后的 YOLO26n 在 Hailo-8 AI HAT+ 上每张图像推理耗时 21.7 毫秒,而 CPU 上的 FP32 NCNN 导出模型耗时 67.03 毫秒。这些数据来自使用不同版本和精度的独立测试。
可以。你可以在 Python 中或 Ultralytics Platform 上训练模型,使用
format="ncnn"导出模型,将_ncnn_model文件夹复制到 Pi,然后使用YOLO("your_model_ncnn_model")加载模型。更新摄像头代码中的模型路径,并使用自己的数据集 YAML 和类别进行基准测试。Arm 的运行时也可以转换兼容的微调 YOLO26n 检查点。
作者
评论
提出问题、分享你的结果,或帮助其他人。









