密集场景中的 Ultralytics YOLO 分割:1,000 个掩码
在 Ultralytics 8.4.213 中,YOLO26n-seg 在 RTX PRO 6000 上用 56.4 毫秒预测并汇总合成 1080p 图像中的 1,000 个掩码,较之前的 821.2 毫秒大幅缩短。
 Glenn Jocher9 分钟阅读
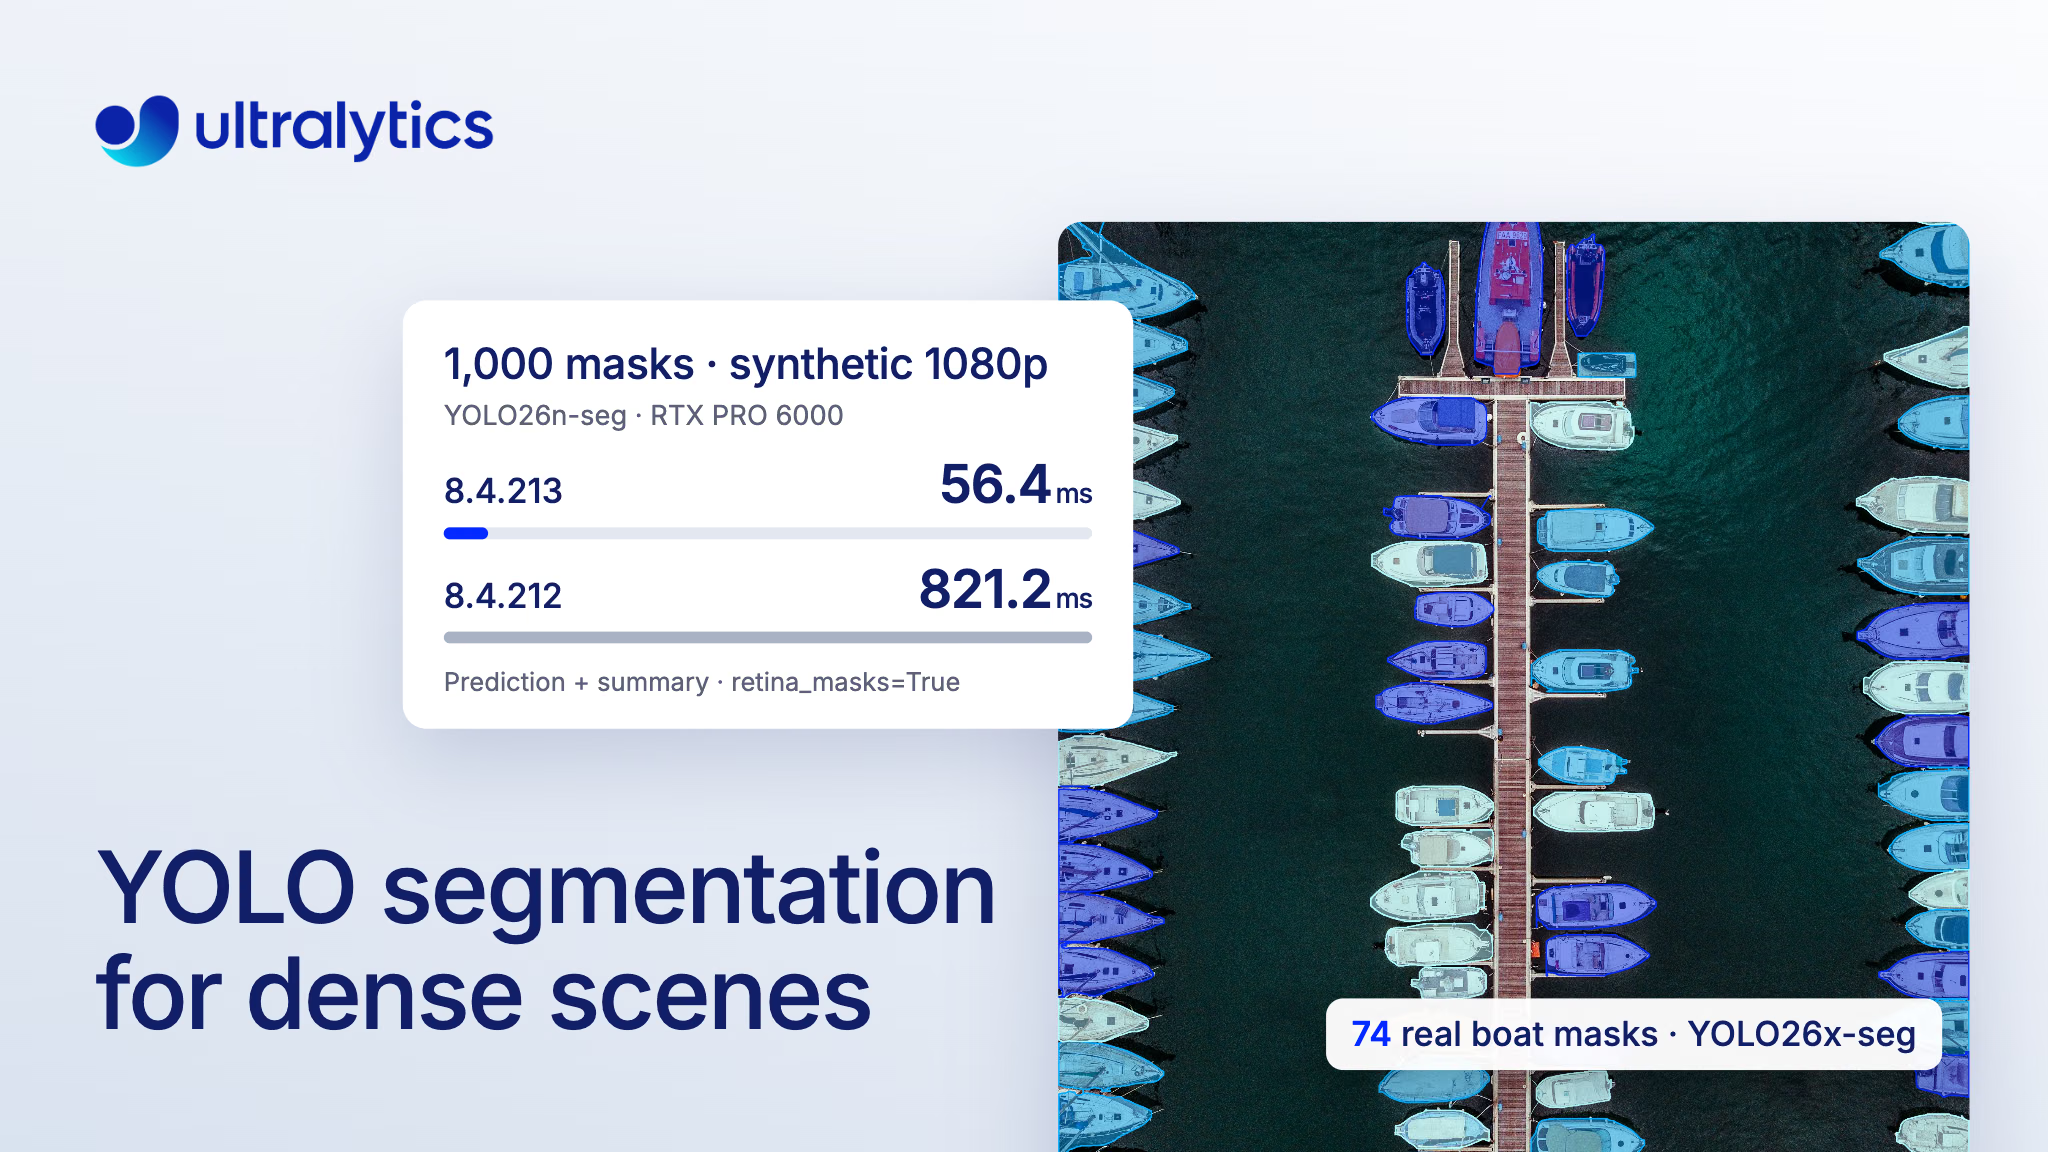
Ultralytics 8.4.213 于 2026 年 11 月 14 日发布,通过在每个检测框内解码大型掩码堆栈,加快了密集场景中的 YOLO 分割速度。如果你要分割货架、包裹、人群或航拍图像,很可能遇到过这种情况:分割模型找到了目标,但后续的掩码处理步骤却耗尽了时间或内存;这个版本大幅推迟了这种情况的出现。在我们对一张合成密集平铺 1080p 图像进行的基准测试中,YOLO26n-seg 在 RTX PRO 6000 上返回了 1,000 个全分辨率实例掩码(retina_masks=True),连同预测和结果摘要用时 56.4 毫秒,峰值 GPU 内存为 321 MiB;而在 8.4.212 中用时 821.2 毫秒,内存为 4,291 MiB。
模型本身没有变化。变化的是 YOLO segmentation 将模型输出转换为掩码的方式:现在,大型掩码堆栈会在每个目标的框内解码,而不是在整帧范围内解码。在 Ultralytics Platform 中,Predict 选项卡和 API 每张图像最多返回 1,000 个结果。本文将介绍密集场景为何计算开销大、8.4.213 做了哪些改进、实测结果,以及如何自行运行 1,000 个掩码的预测。
密集场景过去会为每个框外的像素付出计算代价#
实例分割会为每个目标生成独立掩码,这对于测量面积、抠出目标或区分相互接触的物体很有用。YOLO 分割模型会预测一小组共享原型掩码,以及每个检测目标的少量系数,后处理再将它们组合成每个目标对应的一个掩码。
直到现在,这一步都会在整帧尺寸上生成每个掩码:默认使用模型的推理尺寸,使用 retina_masks=True 或切片时则使用原始图像尺寸。对于 H x W 帧中的 N 个目标,系统会分配、裁剪、筛选并扫描一个 N x H x W 的堆栈,尽管每个掩码在其边界框之外都为零。在密集的 1080p 场景中,1,000 个框的面积总和(含重叠)约为整帧面积的两倍,但堆栈却达到整帧面积的 1,000 倍。开销随 max_det 和图像尺寸增长,而不是随图像中的框数量增长。
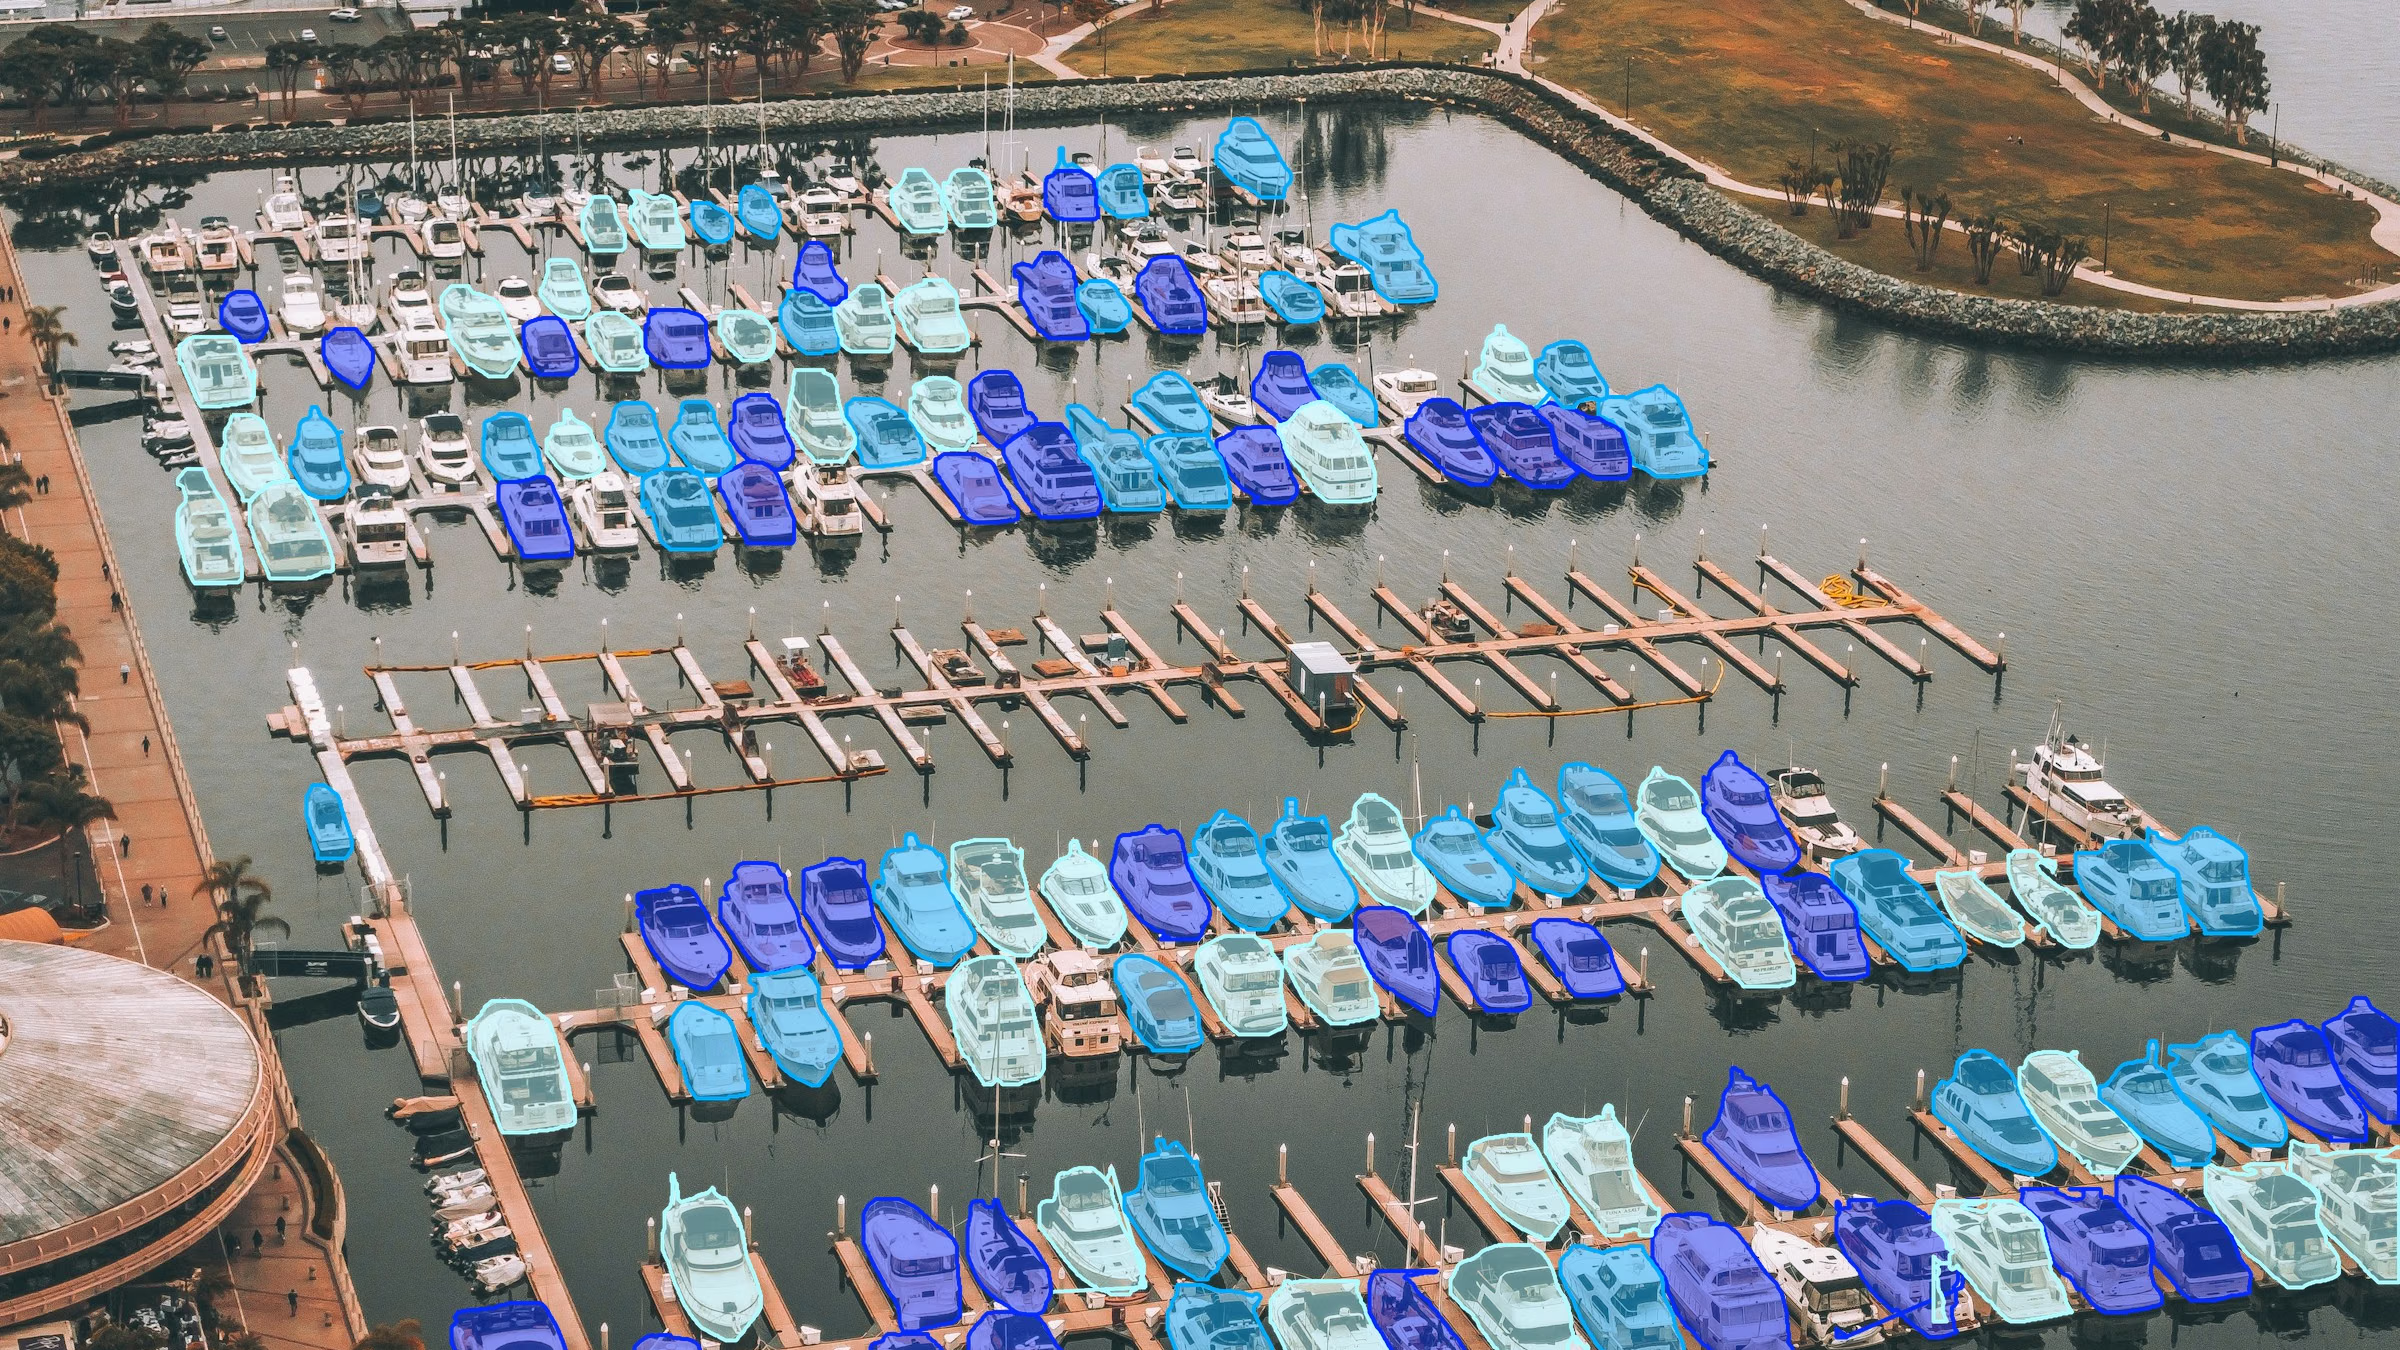
YOLO26x-seg 在这张码头照片中返回了 127 个船只掩码,显示为裁剪后的结果(imgsz=1920、conf=0.25、max_det=1000、retina_masks=True)。照片:Unsplash。
因此,将 max_det 提高到默认值 300 以上,对于分割任务来说并不实用;图像较大且实例较多时,还可能耗尽内存。像 SKU-110K 这样的密集零售货架、成堆包裹和航拍帧,正是你希望能处理超过 300 个目标的场景。
Ultralytics 8.4.213 在每个框内解码大型掩码堆栈#
来自 PR #27197 的新路径仅在每个框对应的像素位置插值原型 logits。它采用可分离双线性采样,与 PyTorch 插值使用的采样方式相同,并将尺寸相近的框分批处理。对于大型堆栈,解码开销现在取决于框的总面积。
实际使用中有三点值得注意:
- 当掩码堆栈超过固定大小时启用。当密集堆栈超过 CUDA 上的 33,554,432 个像素,或 CPU 及其他设备上的 4,194,304 个像素时,分割预测器会使用框内掩码。较小的堆栈仍使用现有的密集路径;对于少量掩码,这种方式的速度相当或更快。
- 在该路径上,轮廓直接由框内掩码生成。
masks.xy和masks.xyn会逐框追踪多边形,因此summary()、to_json()和save_txt不会构建完整堆栈。 - 输出格式不变。
masks.data仍会返回一个密集的 N x H x W 张量。在框内路径上,只有首次读取时才会构建该张量。
读取密集张量仍需承担其分配开销,但 PR 测得开销有所降低:在 GPU 上,以 retina_masks=True 读取 1080p 图像的 300 个掩码时,masks.data 的耗时从 14.1 ms 降至 9.1 ms,内存从 1,366 MiB 降至 795 MiB。
1080p 图像上的 1,000 个掩码,GPU 耗时从 821.2 ms 降至 56.4 ms#
PR 对 YOLO26n-seg 运行完整的 model.predict(...) 加 result.summary()(框和多边形)进行基准测试,每行启动一个进程,并报告预热运行的中位数。密集场景使用合成平铺图像,设置为 conf=0.01 和 imgsz=1280;典型场景使用默认设置下的标准 bus.jpg,包含 5 个掩码。“Before”表示 8.4.212。这些测量侧重后处理,包含预测和结果汇总,并非通用推理速度数据。
| 场景(GPU,RTX PRO 6000) | 掩码 | retina_masks | 8.4.212 | 8.4.213 |
|---|---|---|---|---|
典型场景(bus.jpg) | 5 | False | 4.3 ms,59 MiB | 4.4 ms,59 MiB |
| 1920 x 1080 | 300 | False | 118.5 ms,1,673 MiB | 16.3 ms,174 MiB |
| 1920 x 1080 | 300 | True | 248.7 ms,1,366 MiB | 18.0 ms,201 MiB |
| 1920 x 1080 | 1,000 | True | 821.2 ms,4,291 MiB | 56.4 ms,321 MiB |
| 4000 x 3000 | 300 | True | 1,352.1 ms,7,070 MiB | 26.5 ms,172 MiB |
| 4000 x 3000 | 1,000 | True | 4,323.1 ms,23,305 MiB | 130.7 ms,258 MiB |
耗时和 GPU 峰值内存,PyTorch 2.15.0,CUDA 13.2。来源:PR #27197。
正如预期,包含五个掩码的典型图像性能没有变化。改进体现在旧堆栈较大的场景中;对于此前开销最大的全分辨率掩码,提升最为显著。
大图像所需内存仅为原来的一小部分#
在 4000 x 3000 像素的图像上预测 1,000 个掩码时,旧路径的 GPU 内存峰值为 23,305 MiB。新路径的峰值为 258 MiB,耗时从 4,323.1 ms 降至 130.7 ms。使用 1,200 万像素的无人机、卫星和巡检帧时,内存占用的降低能为流水线的其他部分留出更多 GPU 内存。
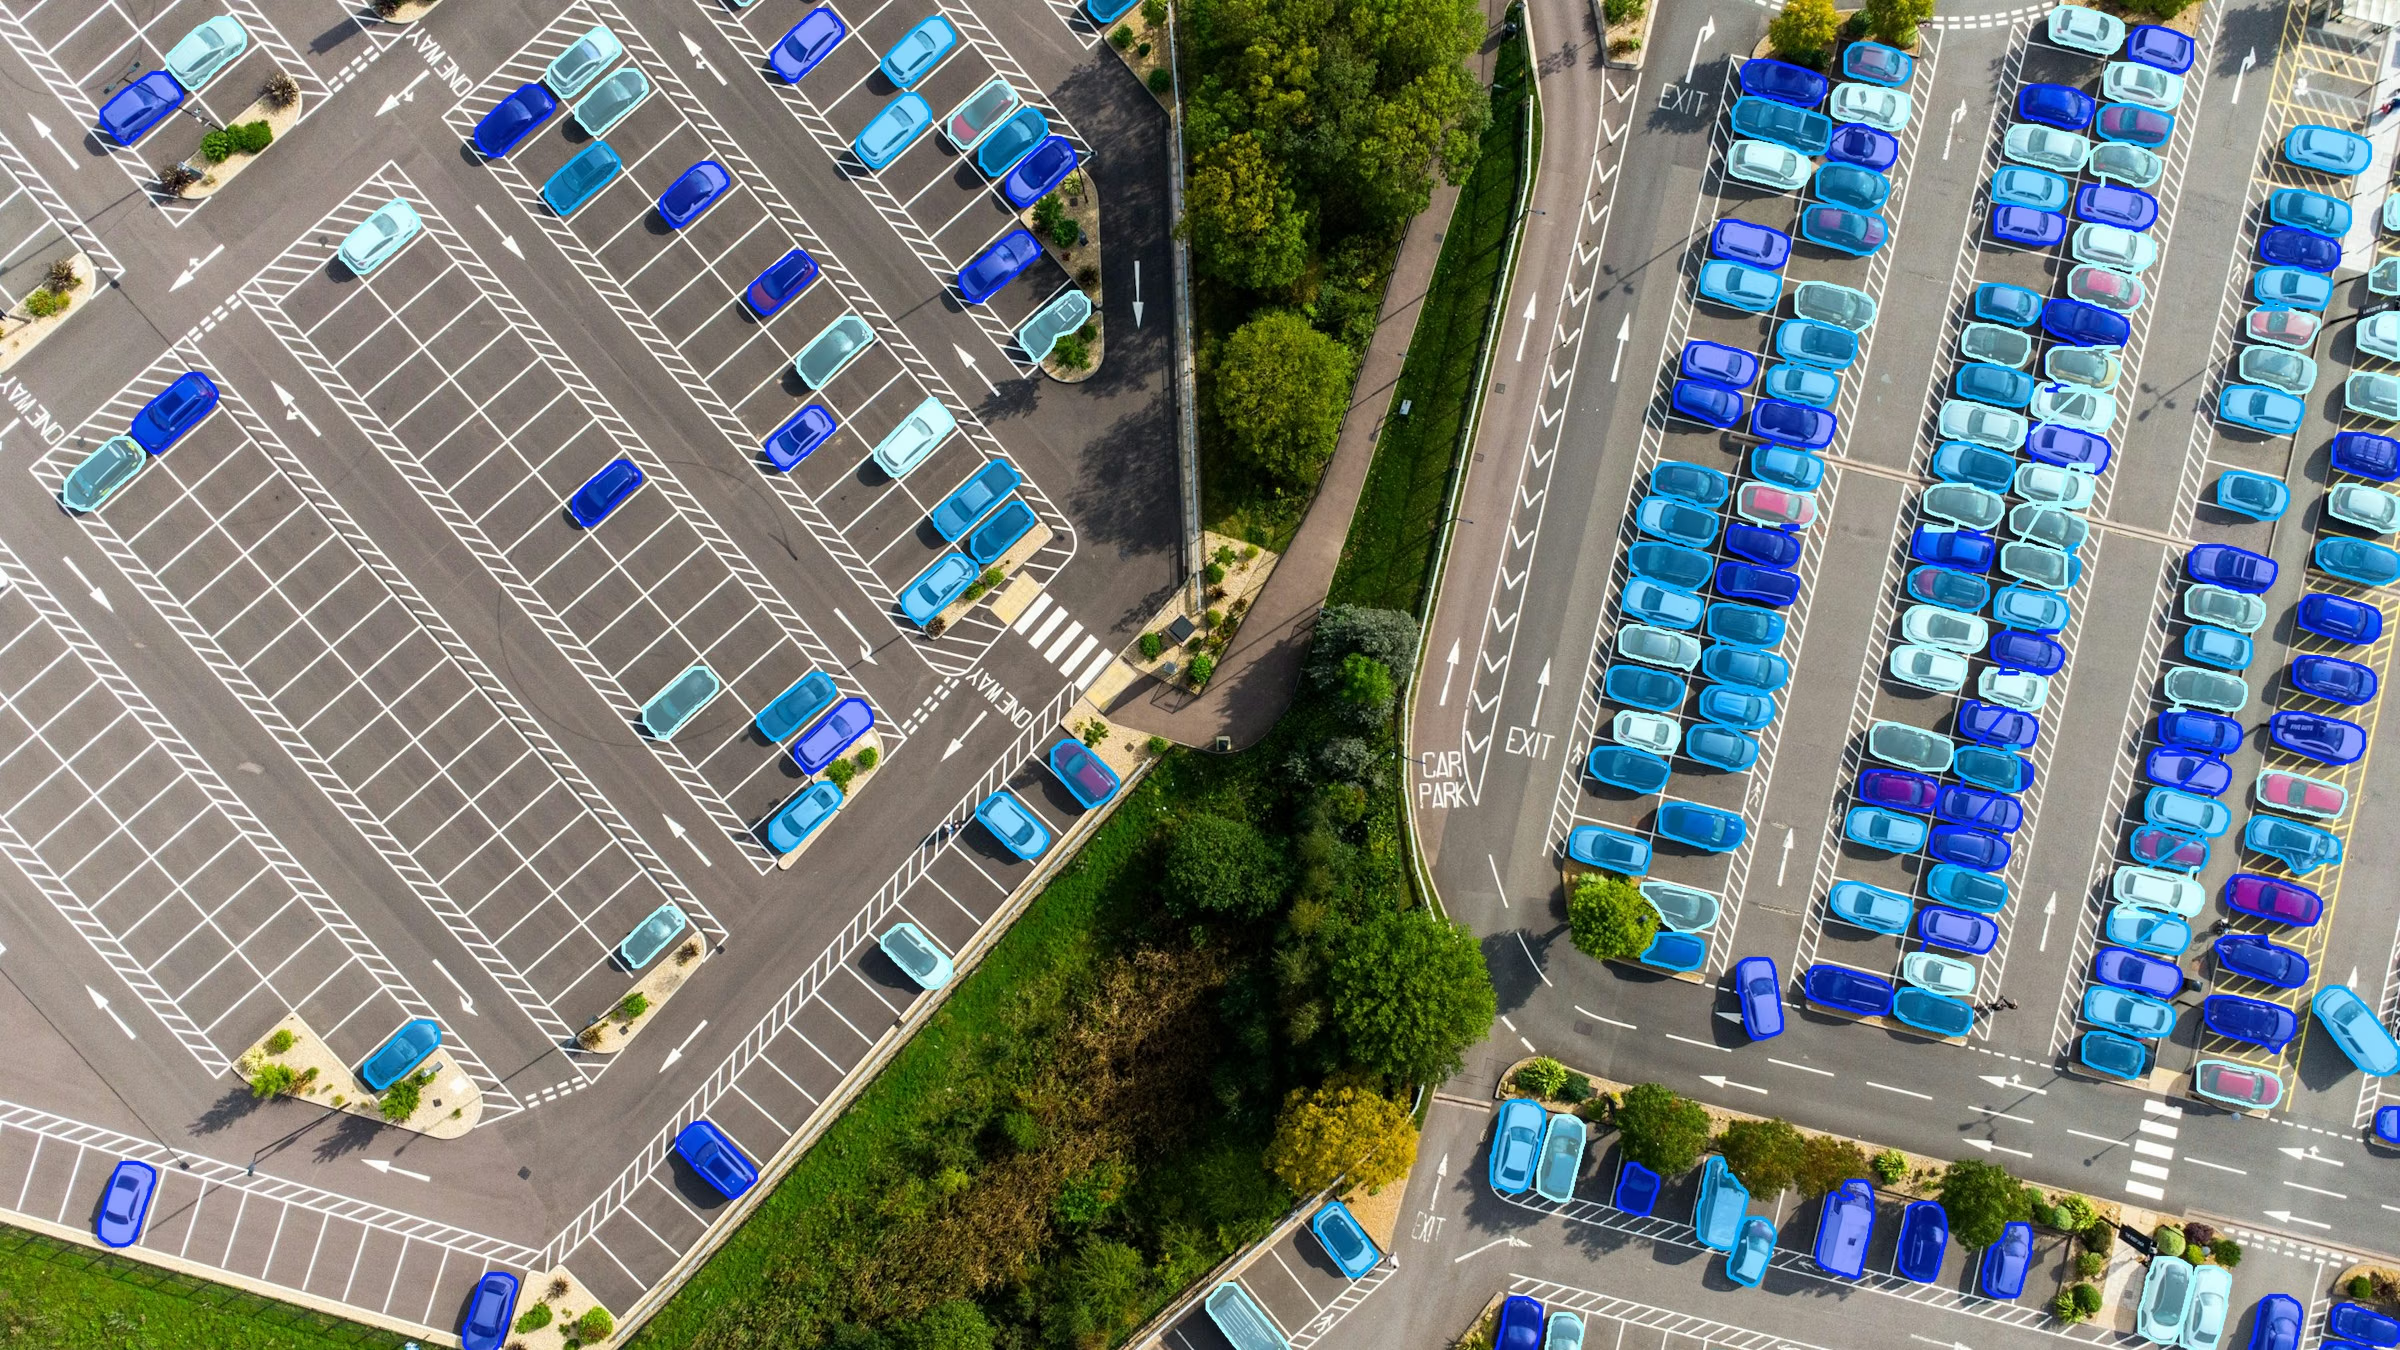
YOLO26x-seg 在这张航拍帧中返回了 222 个汽车掩码(imgsz=1920、conf=0.15、max_det=1000、retina_masks=True)。照片:Unsplash。
CPU 预测也大幅提速#
在配备 8 个线程的 Linux x86 CPU 上,尚未生成任何掩码时,进程的内存占用约为 840 MiB。对于 1080p 图像上的 1,000 个全分辨率掩码,进程内存峰值从 5,217 MiB 降至 1,072 MiB,耗时变化如下所示。
1920 x 1080 图像上的 300 和 1,000 个掩码,以及 4000 x 3000(12MP)图像上的 300 个掩码。YOLO26n-seg,预测加结果汇总;之前使用 8.4.212,之后使用 8.4.213。来源:PR #27197。
掩码与 8.4.212 的结果一致,一种模式下边缘略有差异#
只有结果相同,更快的路径才有意义。PR 使用 YOLO26n-seg 和 YOLO11n-seg,在两张图像的六种尺寸上,对 96 次预测比较了 8.4.213 和 8.4.212;conf 分别设为 0.25 和 0.01,覆盖两种掩码模式,并强制启用框内路径:
- 默认掩码(
retina_masks=False):框、掩码和多边形完全一致;760 万个掩码像素中没有差异。 - 全分辨率掩码(
retina_masks=True):在旧代码仅执行一次插值时,结果完全一致。对于其他图像尺寸,2,480 万个掩码像素中有 0.07% 存在差异(18,105 个),且全部位于掩码边缘;这是因为旧代码在这些位置执行了两次插值,而新代码会在精确坐标处对原型进行一次采样。 - Apple MPS:在包含 179 个掩码的密集 1080p 场景中,两种掩码模式下的掩码、框和多边形完全一致。
如何在 Python 中对每张图像分割 1,000 个目标#
使用 pip install -U ultralytics 升级到 8.4.213 或更高版本,然后将 max_det 提高到默认值 300 以上。其余代码无需更改。
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")  # COCO 类别;对于货架或包裹,请加载你自己训练的模型
results = model.predict("crowd.jpg", imgsz=1280, conf=0.25, max_det=1000, retina_masks=True)

r = results[0]
print(len(r.boxes), "objects")
if r.masks is not None:
    polygons = r.masks.xy  # 每个目标对应一个 (P, 2) 数组,坐标为原始图像像素
rows = r.summary()  # 框和多边形
max_det 是上限,不是目标值:实际返回的目标数量仍取决于模型、图像和置信度阈值。要充分利用这项改进:
- 尽可能读取轮廓。在大型堆栈路径上,
masks.xy(像素坐标)和masks.xyn(归一化坐标)都由框内掩码生成,to_json()和save_txt也一样。Results 参考文档列出了所有属性。 - 需要直接进行像素计算时,读取
masks.data。使用密集张量最容易计算面积和重叠;也可以通过masks.xy轮廓生成抠图。我们的 Academy 课程在代码中使用掩码介绍了何时使用每种视图,目标隔离指南则演示如何根据轮廓生成抠图。 - 需要源分辨率掩码时,使用
retina_masks=True。在 1080p GPU 基准测试中,处理 300 个掩码现在耗时 18.0 ms,而默认掩码耗时 16.3 ms。对于超大帧中的小目标,请参阅关于使用图像切片检测小目标的文章和高分辨率切片指南。切片预测会返回源尺寸的掩码,因此切片运行仍需与原始图像大小成正比的内存。 - 针对拥挤场景调整
conf和iou。提高max_det会保留更多已通过conf的检测结果;降低conf则会纳入置信度较低的目标。预测设置介绍了conf、iou和max_det;我们的 NMS IoU 阈值指南则说明了如何处理彼此接触的目标。
这项改动位于 Python 后处理中,因此既适用于 PyTorch 模型,也适用于通过 Ultralytics predict API 运行的导出模型。PR 测试了 YOLO26n-seg 和 YOLO11n-seg;所有 YOLO26 和 YOLO11 分割模型也都使用相同的后处理流程,涵盖拥有 2.7M 融合参数的 YOLO26n-seg 到拥有 62.8M 参数的 YOLO26x-seg。要在自己的密集数据上训练模型,请参阅我们的自定义训练 YOLO26 进行实例分割指南。
Ultralytics Platform 现在每张图像最多返回 1,000 个结果#
同一上限现在也适用于 Ultralytics Platform。模型的 Predict 选项卡每张图像最多返回 1,000 个结果,其背后的 REST API 也一样。RT-DETR 模型是例外,上限为 300,即其解码器中的查询数量。
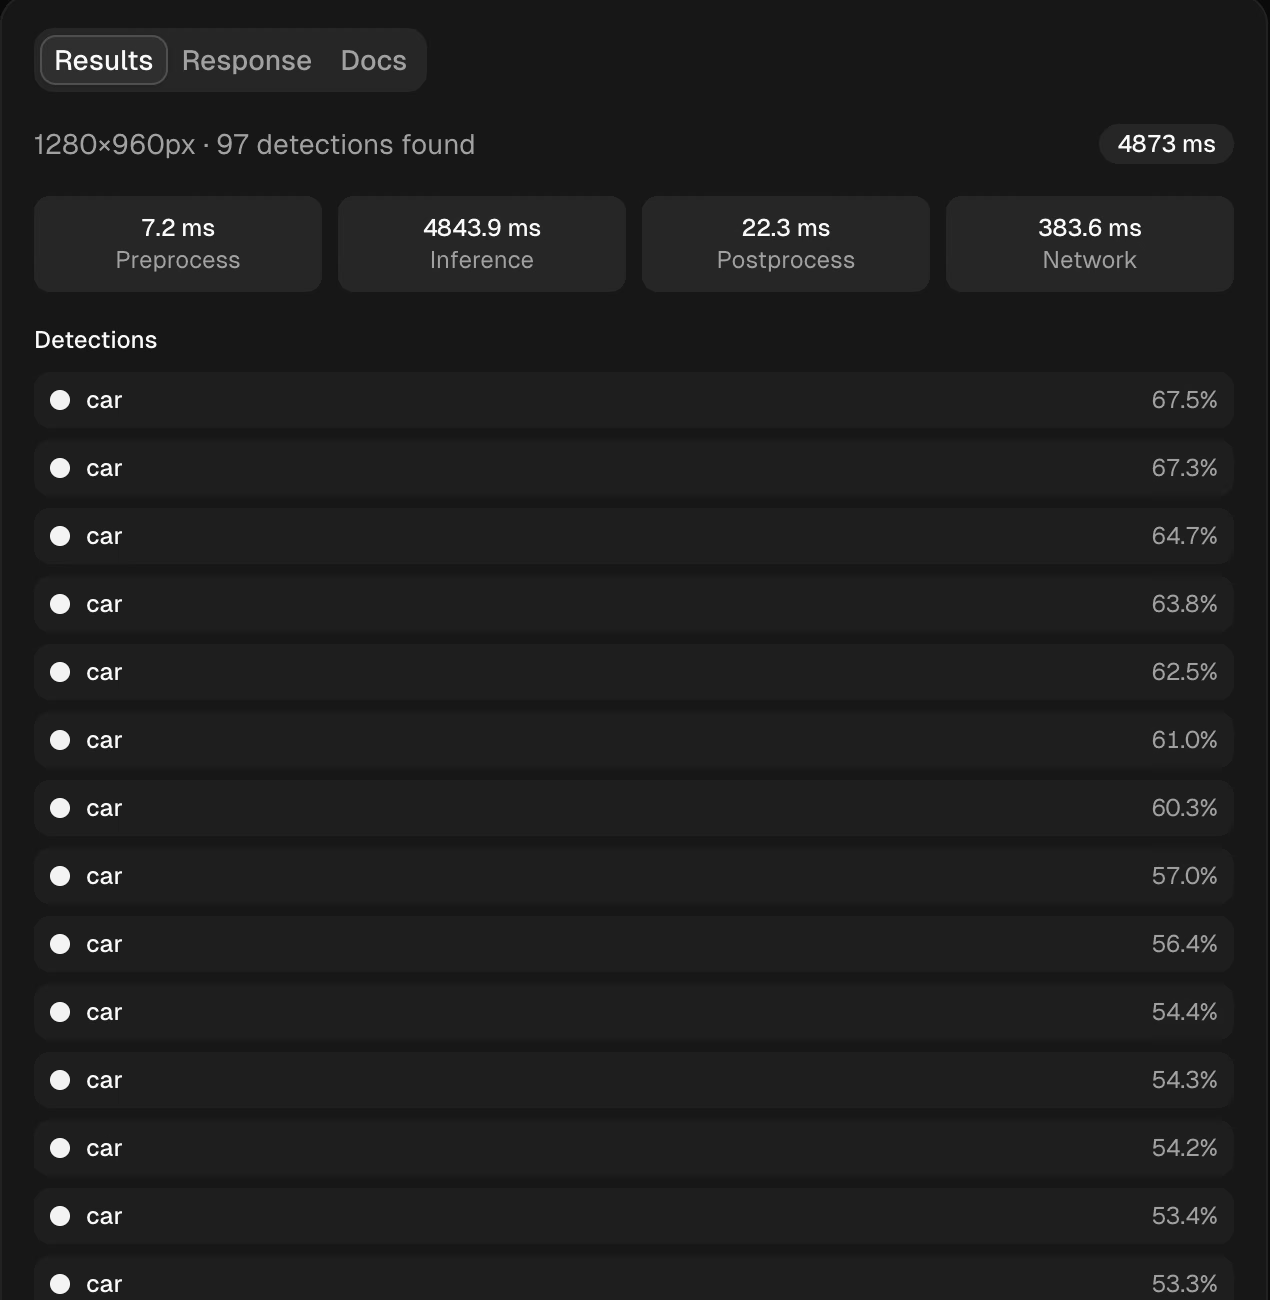
图像尺寸为 1280 时,YOLO26x-seg 的 Predict 选项卡在上方的航拍照片中列出 97 个汽车检测结果。Platform 推理文档详细介绍了该面板。
结果面板专为较长的列表设计。结果超过 10 个时,图像会显示不带标签的框,以免遮挡目标;列表会为每个结果命名,放大后的图像则会保留标签。将鼠标悬停在某一行上可高亮对应目标,悬停在目标上则可找到对应行。
要在自己的数据上试用,请从 Package-Seg 包裹分割数据集开始,在云端训练,然后在 Predict 选项卡中运行模型,或通过专用端点运行。
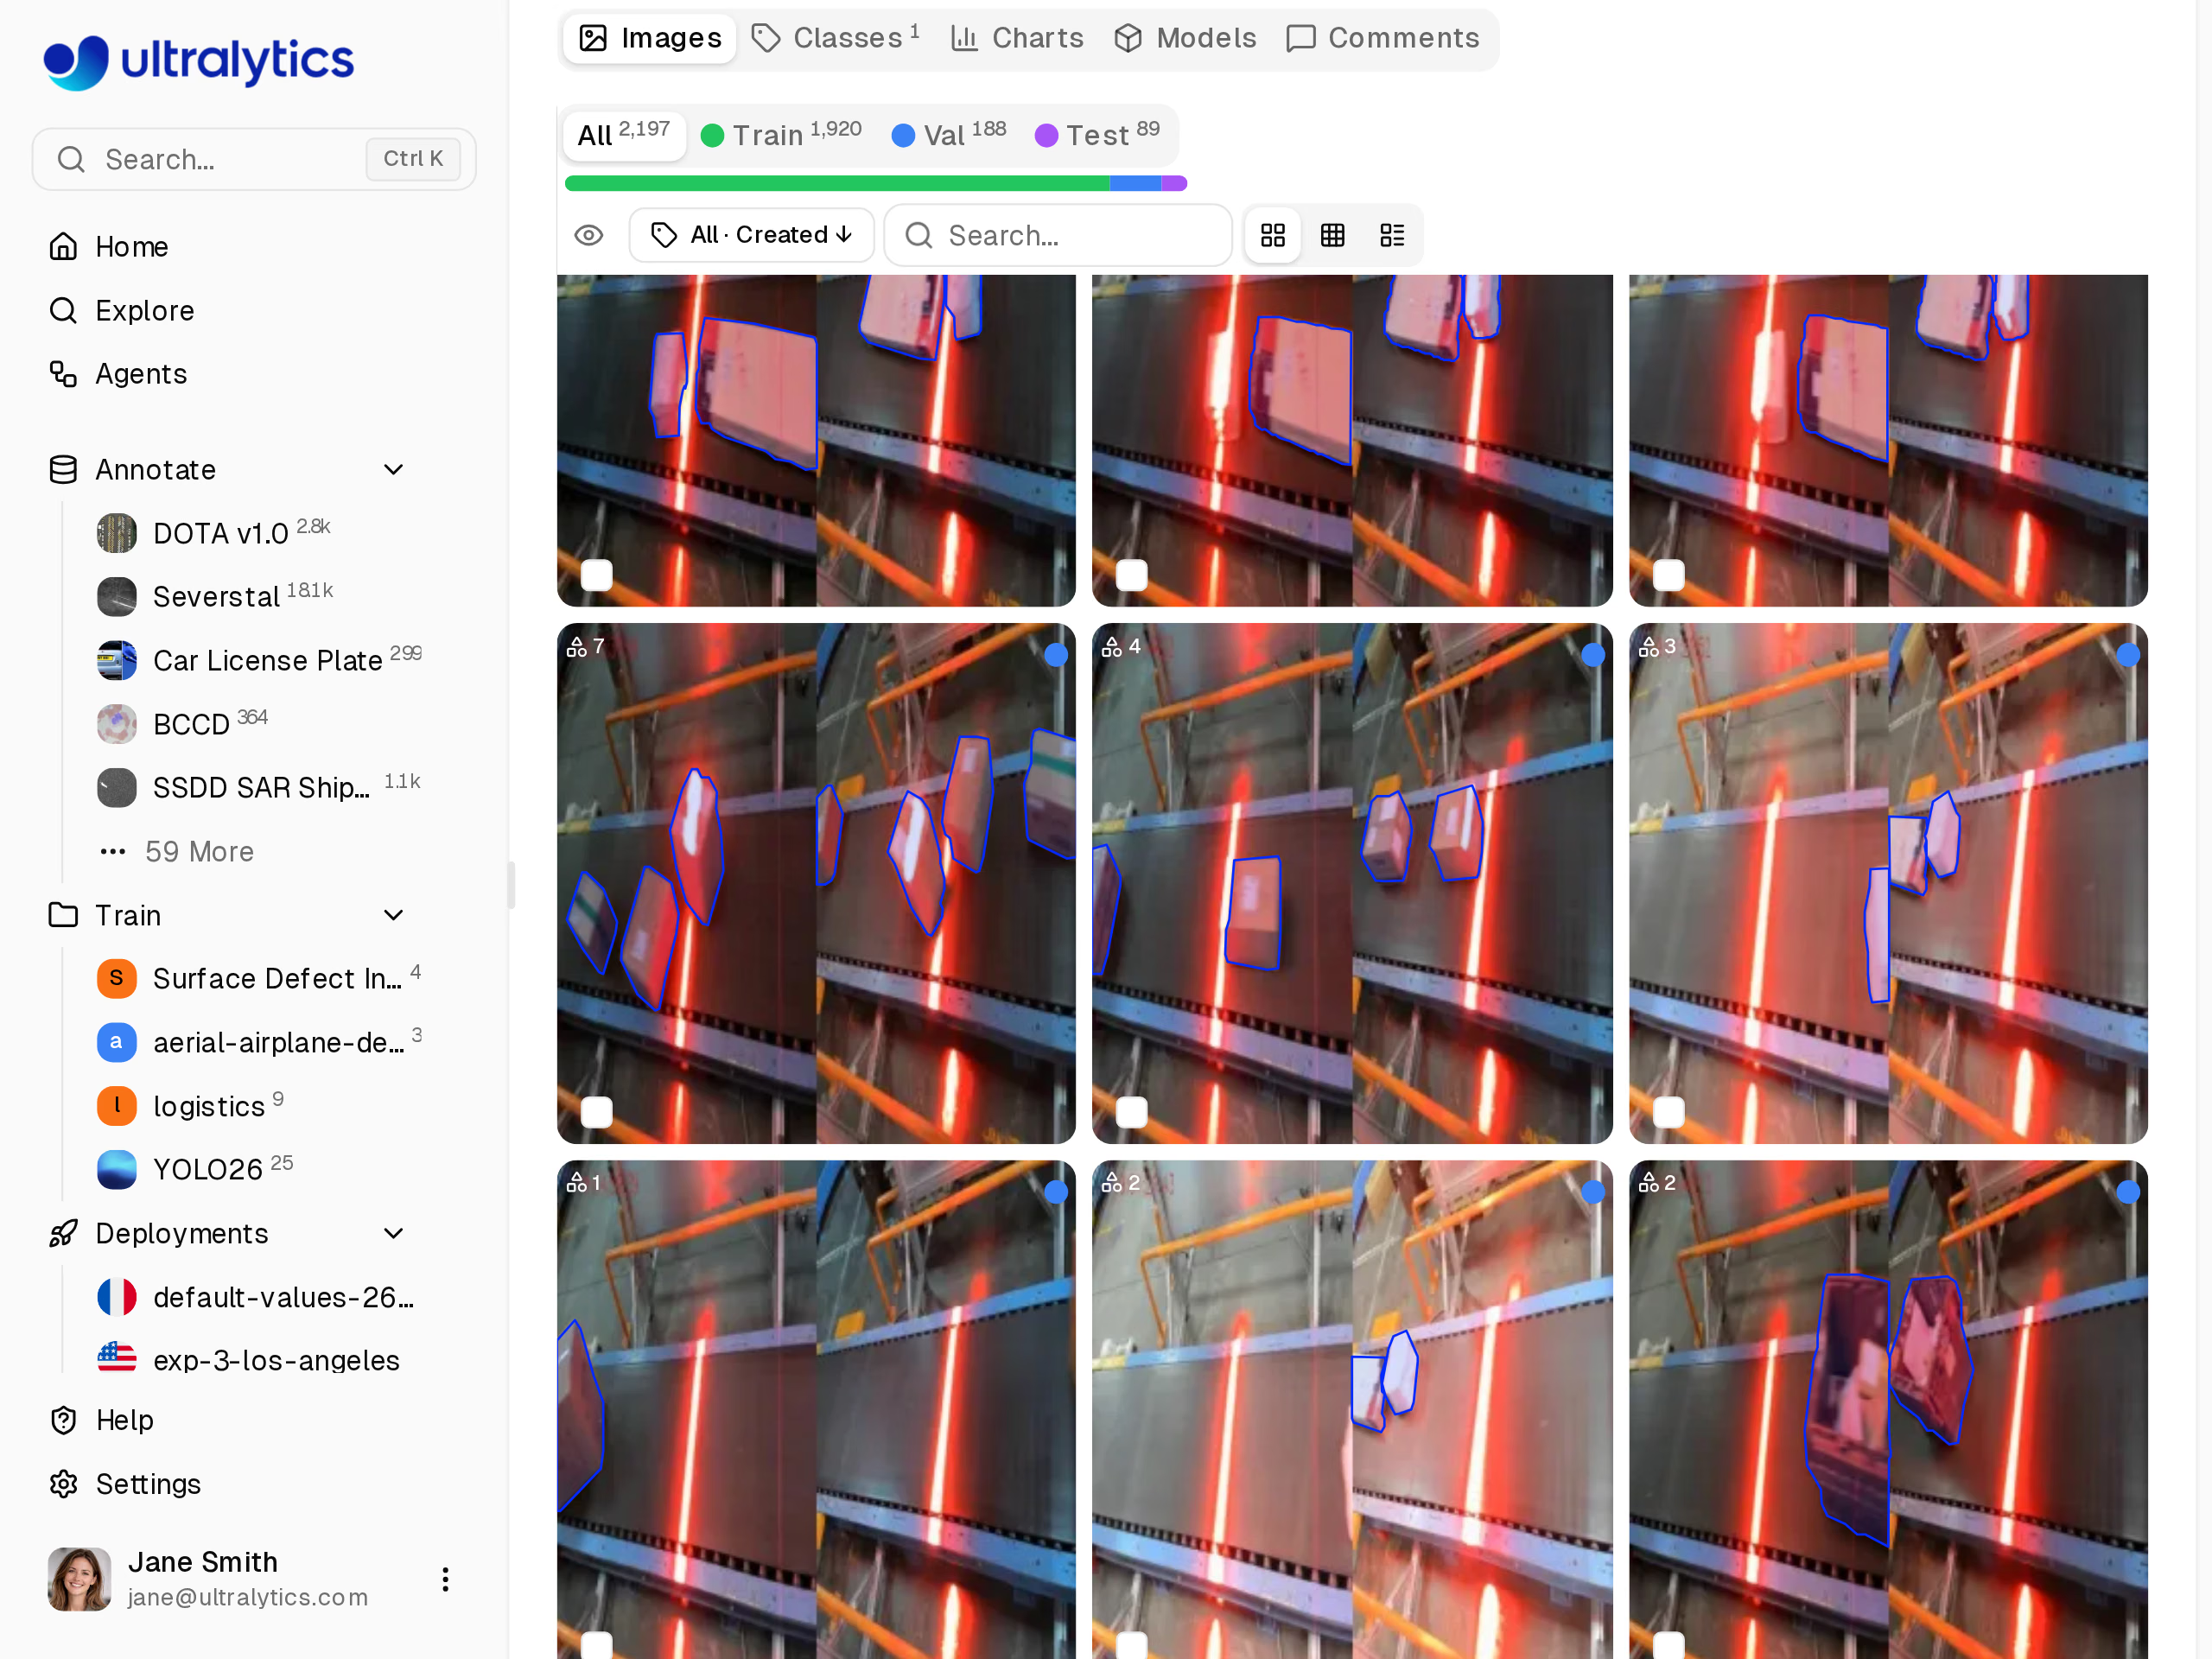
Ultralytics Platform 上的 Package-Seg 数据集,是物流分割任务的现成起点。
哪些团队适合升级#
如果你要分割拥挤场景或大图像,现在就升级:例如零售货架、包裹分拣、航拍和无人机测绘、细胞显微图像,或任何你为了控制内存而限制 max_det、缩小图像尺寸或降低 retina_masks 的场景。你可以重新评估这些变通方案。
如果你的掩码堆栈低于阈值,就仍会使用现有的密集路径;请注意,阈值按目标数量乘以图像尺寸计算,因此即使掩码数量不多,超大图像也可能超过阈值。如果你的流水线始终读取 masks.data,仍会构建密集张量;在 PR 的 1080p GPU 300 掩码测试中,这比以前耗时更少、内存占用也更低。要了解自己是否真的需要实例掩码,请参阅语义分割与实例分割。
常见问题
YOLO 分割是 Ultralytics YOLO 中的实例分割任务:模型会为每个目标返回一个类别、一个框、一个置信度分数和一个像素掩码。YOLO26 分割模型有五种尺寸,从 YOLO26n-seg 到 YOLO26x-seg,使用 COCO 的 80 个类别进行预训练,可直接在你自己的数据上微调。
max_det设定上限,默认为 300;实际返回的数量也取决于模型、图像和置信度阈值。自 8.4.213 起,对于基准测试这类工作负载,将上限设为 1,000 已经可行:在合成的 1080p 图像上,YOLO26n-seg 在 RTX PRO 6000 上以 56.4 ms 完成 1,000 个全分辨率掩码的预测和汇总,峰值内存为 321 MiB。Ultralytics Platform 每张图像最多返回 1,000 个结果。早期版本会按整帧尺寸生成每个掩码,因此内存会随目标数量乘以整帧面积增长。在 4000 x 3000 的合成基准测试中,使用 1,000 个全分辨率掩码时,GPU 内存峰值达到 23,305 MiB。8.4.213 会在每个框内解码大型堆栈,同一场景的内存峰值为 258 MiB。
升级到
ultralytics8.4.213 或更高版本即可;无需更改其他代码,因为大型掩码堆栈会自动启用框内路径。masks.data仍使用相同的密集格式,因此现有代码可以继续运行;改为读取masks.xy或调用summary(),则可避免在该路径上构建密集张量。retina_masks=True会以原始图像分辨率而非模型推理尺寸返回掩码,使密集掩码与原始图像对齐。在合成的 1080p 图像上使用 300 个掩码时,启用此设置后,YOLO26n-seg 在 RTX PRO 6000 上的预测加结果汇总耗时,从 8.4.212 的 248.7 ms 降至 8.4.213 的 18.0 ms。
作者
评论
提出问题、分享你的结果,或帮助其他人。









