Scaleout 在边缘设备上微调 Ultralytics YOLO 模型,让数据留在原处、支持离线运行,并能在数小时而非数周内交付新的检测模型。
机器学习模型训练通常假设你可以将所有数据汇集到一处、发送到云端,然后部署训练完成的模型。在许多实际场景中,这一假设并不成立。在国防、工业和受监管环境中,隐私法规、安全分类或高昂的带宽成本会限制数据离开其所在位置,而连接这些位置的网络也并非总是可信。
Scaleout专为应对这些情况构建基础设施。其 Scaleout Edge 平台采用联邦学习,将模型训练带到数据所在的位置,而不是将数据移到模型所在的位置。对于计算机视觉项目,Scaleout 会在部署于各个现场、由 GPU 加速的边缘站点 Vision Ground Nodes 上定制训练并微调Ultralytics YOLO 模型,因此检测能力可以在现场持续提升,同时敏感图像始终不会离开设备。
让机器学习走到数据所在之处#
Scaleout 于 2018 年由乌普萨拉大学研究大规模分布式系统的研究人员创立,致力于让机器学习能够应用于无法集中数据的场景。其关注的领域中,数据难以或根本无法汇集到一处,而联邦学习是实现这一目标的核心机制。
联邦学习将训练分散到多台设备上,再将各设备的模型更新汇集到中央控制平面,由其聚合并生成新的全局模型。每台设备都能利用对自身本地环境的了解,而整个设备群则受益于集体智能。数据留在应有的位置,只有模型学到的内容会传输。
Scaleout 的业务涵盖国防、工业、交通运输和其他受监管行业,包括参与北约 DIANA 加速器计划以及与 BAE Systems 合作等项目。这些领域面临的情况都相同:数据无法移动,但模型仍需要持续改进。
边缘机器学习的复杂挑战#
下面详细介绍 Scaleout 在现场训练模型时面临的限制:
- 硬件有限:现场部署没有数据中心服务器,只有无人机上的计算机等小型低功耗设备。在这些设备上运行训练好的模型可行,但重新训练则需要强大得多的算力。
- 数据锁定在设备上:重新训练所需的视频资料通常属于专有数据,无法发送到中央服务器,因此模型必须从不会离开边缘端的数据中学习。
- 现场没有专业人员:在现场采集数据的操作人员很少是机器学习工程师,因此重新训练不能依赖现场具备数据科学专业知识。
- 环境持续变化:现场环境变化迅速,因此模型必须持续更新,而不能依赖缓慢、定期的重新训练周期。
在边缘端微调 Ultralytics YOLO 模型#
为应对这些限制,Scaleout 构建了一套完全在现场运行的训练循环,并以 Ultralytics YOLO 模型为核心。
每个现场都部署一台 Vision Ground Node,也就是配有独立算力和存储的 GPU 加速边缘站点,与无人机群协同工作。无人机采集视频后,节点会筛选最有用的帧,由操作人员进行标注,然后在本地硬件上微调 YOLO 模型。
经过几个训练周期后,只有更新后的模型会被发送回控制平面,原始视频始终不会传出。Scaleout 通过其视觉模块提供这一循环。该模块是 Scaleout Edge 平台的扩展,将计算机视觉项目所需的工具整合为一个软件包。
该模块整合了帧筛选、标注、训练和部署,并由 Ultralytics YOLO 负责检测,让团队能够基于可用的基础方案开展工作,而不必自行拼装这些组件。
Scaleout 最初在北约 DIANA 加速器计划中采用这一方法,使用 YOLOv8 在现场采集的数据上微调检测模型。由于专有原因,这些数据无法通过现场网络传输或集中存储,因此团队将微调过程分散到各处,让模型在本地从新样本中学习。
这一训练循环也面向操作人员而非数据科学家设计。系统会引导非专业人员审查并标注重要帧,让现场人员能够自行持续改进模型。
配套工具也体现了这一设计理念,包括用于标注的开源版 Label Studio、用于接入无人机视频流的流媒体服务器,以及用于微调的 Ultralytics Python 软件包。根据部署需求,整套方案可运行在从 NVIDIA Jetson 模块到坚固耐用的现场设备或笔记本电脑等各种硬件上。
为什么选择 Ultralytics YOLO 模型?#
对 Scaleout 来说,Ultralytics YOLO 最大的优势是模型足够轻量,因此即使网络连接质量不佳,联邦训练也切实可行。Scaleout 不传输原始数据,只传输模型更新。它最常用的模型Ultralytics YOLOv8 nano约为 10.7 MB,因此即使带宽有限,完整更新包也很小,易于发送。
Ultralytics Python 软件包还为 Scaleout 工程师提供了跨不同硬件训练和部署的灵活性。精简的 YOLOv8 nano 模型可以在资源受限的边缘设备上稳定运行,而软件包的导出选项则支持在 Scaleout 所服务的不同环境中部署。由于模型易于微调,团队可以随着现场条件变化快速迭代。
Ultralytics YOLO 帮助 Scaleout 更快更新模型#
使用 Ultralytics YOLO 时,最繁重的工作都留在设备上。训练使用数百 GB 的现场视频素材,但实际传输的模型只有约 10 MB。这大幅减少了需要传输的数据量,因此可以在这些部署所依赖的有限网络上实现联邦训练。
这种方法还改变了改进后的模型重新投入现场使用的速度。原本可能需要数周或数月的流程——收集数据、运送到中央位置、重新训练并重新部署——在边缘端运行训练循环后,缩短为数天甚至数小时。
这一点在 Scaleout 的无人机项目中体现得最为明显。在国防侦察任务中,无人机沿搜索路线飞行,并使用机载 Ultralytics YOLO 模型实时检测、识别和定位目标物体,所有处理都由无人机自身的计算机完成,而非发送到外部进行分析。
无人机采集新视频后,数据会传入 Vision Ground Node,由 YOLO 在新帧上进行微调,然后将更新后的模型推送回现场,整个过程中视频始终不会离开现场。检测模型必须跟上快速变化的环境,同时应对无法移动的数据;在本地重新训练的模型能在实际现场持续发挥作用,而集中训练后固定不变的模型则可能逐渐落后。
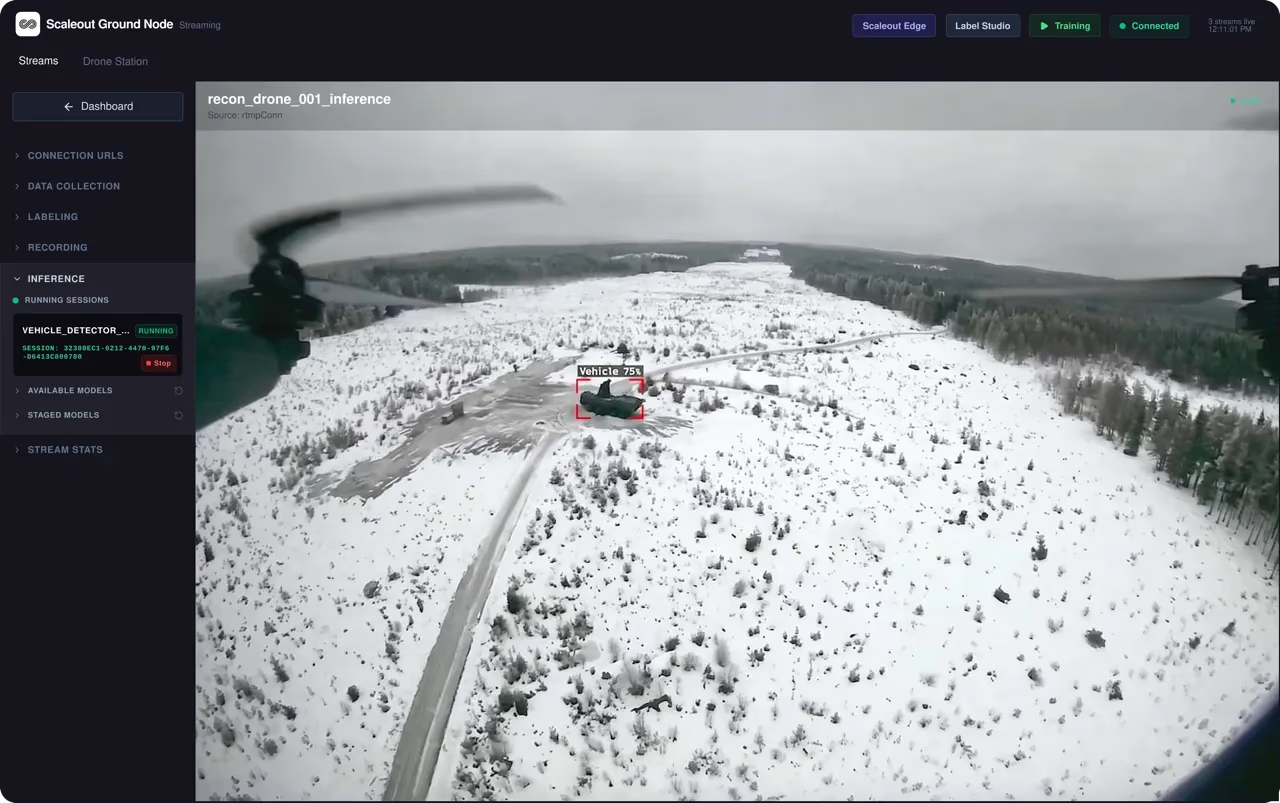
图 1. Scaleout 与 Ultralytics YOLO 如何为 AI 无人机提供支持的示例(来源)。
同样的模式远不止适用于无人机。在能源站点和远程设施等工业场景中,每个地点的数据都很敏感;该平台可以在不让任何原始数据越过设施边界的情况下,改进多个站点的检测模型。无论数据存储在无人机还是固定设备上,Scaleout 都让视频留在原处,只传输模型学到的内容。
为数据无法移动的环境构建自适应 AI#
随着 Scaleout 不断发展,公司持续将基于联邦学习和边缘计算的计算机视觉扩展到更多场景和硬件。其预构建模块旨在将数月的集成工作压缩到数天,让客户能够使用自有硬件,并采用自适应学习循环,而无需重建底层机器学习代码。
凭借作为检测流水线核心的 Ultralytics YOLO,Scaleout 正在让 AI 能够在传统方法力有不逮的环境中训练和改进:让数据留在原处,在网络故障时继续运行,并将边缘设备群转变为能够整体持续学习的系统。
准备好探索视觉 AI 能为你做什么了吗?前往我们的 GitHub 代码仓库,了解 YOLO 模型如何改变制造业 AI和机器人计算机视觉等领域。查看我们的许可选项,开启智能自动化之旅。










