Data Curation
数据整理是一项持续进行的工作,包括组织、验证、记录和维护可靠的数据集,以用于机器学习和评估。
数据整理是一个持续进行的过程,包括筛选、组织、检查、记录和维护数据,使其始终适用于特定用途。在机器学习中,数据整理决定模型学习的样本,以及用于评估模型的证据。经过整理的数据集包含相关样本、用于监督任务的一致标签、上下文信息以及可追溯的版本。
数据整理、清洗与预处理#
数据整理贯穿数据集的整个生命周期。数据清洗用于纠正错误并删除不可用记录;数据预处理则通过调整尺寸或归一化等操作转换输入。数据标注也称为数据标签,为监督学习添加目标。数据整理会统筹这些活动,同时确定哪些样本应纳入数据集、如何定义类别,以及数据集如何随时间变化。一致的类别定义和标注规则有助于模型学习图像与目标之间可靠的关系。
因此,数据整理是以数据为中心的 AI的重要组成部分;这种方法通过改进数据来提升系统。
数据整理的工作方式#
流程从数据集规范开始,其中包括预测任务、目标类别、运行条件和纳入标准。对于目标检测,规范还包括边界框和部分可见物体的标注规则。检查类别频率和采集条件,可以发现数据集偏差,包括代表性不足的类别或环境。
质量检查结合自动检测与人工审核。文件检查可找出无法读取的图像;标注检查可识别无效坐标和不一致的类别。精确文件哈希可检测完全相同的副本,而嵌入——即图像内容的数值表示——有助于找出视觉上相似的样本。审核时应区分可修复的错误与不可用记录,并保留能够代表任务的有效难例。
文件哈希审计可以为每个唯一文件保留一个路径。以下示例检查 ultralytics 包中附带的图像;该包通过 pip install ultralytics 安装:
from hashlib import sha256

from ultralytics.utils import ASSETS

paths = sorted(ASSETS.glob("*.jpg"))
unique = {}

# Keep the first image path for each file digest.
for path in paths:
    digest = sha256(path.read_bytes()).hexdigest()
    unique.setdefault(digest, path)

curated = list(unique.values())
print(f"Before: {len(paths)}, after deduplication: {len(curated)}")
这些计数显示精确去重后剩余的文件数量;如果计数相同,就表示所有抽样文件的哈希值都不相同。
划分数据集有助于确保训练数据、验证数据和测试数据彼此独立。相邻的视频帧包含相同的场景内容,因此将它们分配到不同的数据子集中会造成数据泄漏,并抬高评估得分。按录制会话、摄像头或地点分组,能让评估结果反映预期的泛化任务。固定的数据集版本会连同标签一起保留这些分配。
Ultralytics Platform 提供类别分布图表和图像聚类功能,帮助发现覆盖缺口、重复项和离群点,从而支持数据整理。借助其数据集管理工具,团队可以检查这些分组,并更新图像、标签和数据子集分配。
数据整理人员的职责#
数据整理人员负责维护数据集的含义和可用性。职责包括记录数据来源、协调标注指南、解决标注分歧以及记录变更。元数据——即描述样本的信息——会记录采集时间、传感器、位置和标注状态。维护可复用数据还包括保留数据说明和配套文档。
数据溯源会记录样本的来源及其转换过程。将数据集版本与实验跟踪关联起来,可以复现模型比较结果。部署后,主动学习会优先挑选信息量大的样本进行审核;监控则会检测数据漂移,并可能促使团队采集新数据。
计算机视觉中的示例#
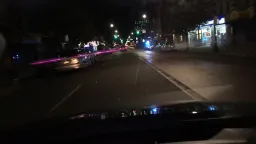
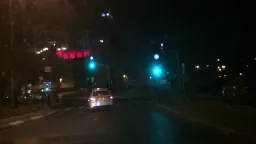
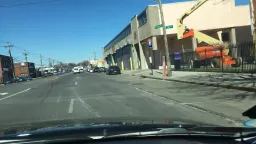
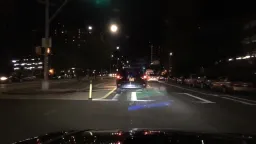
在汽车感知领域,原始 BDD100K 数据集包含 100,000 段驾驶视频,覆盖美国各地、多种天气状况以及白天和夜间环境。其环境属性支持按采集条件进行评估。Platform 版本包含 99,996 张用于检测任务的关键帧图像。
 BDD100K 预览 1
 BDD100K 预览 2
 BDD100K 预览 3
 BDD100K 预览 4
Dashcam frames from crowdsourced US drives across cities, weather, and times of day, from UC Berkeley's BDD100K driving benchmark. Keyframes come from 40-second videos recorded largely in New York and the San Francisco Bay Area through Nexar, including night, rain, snow, and fog. Source: Yu, Chen, Wang, et al., "BDD100K: A Diverse Driving Dataset for Heterogeneous Multitask Learning," CVPR 2020; bdd100k.com. Free for educational, research, and non-profit use; commercial use requires UC Berkeley permission.
对于图像分类,ciFAIR 修正版本替换了 CIFAR-10 和 CIFAR-100 原始测试集中与其他图像近乎重复的样本。分别有 3.25% 和 10% 的原始测试集样本与训练图像或其他测试图像匹配。在训练集不变的情况下,ResNeXt-29 (8x64d) 在 CIFAR-10 上的分类错误率从 3.56% 升至 ciFAIR-10 上的 3.95%。









