Florence-2: Microsofts neuestes Vision-Language-Modell
Lerne Florence-2 kennen, Microsofts Vision-Language-Modell für Objekterkennung, Segmentierung, Bildbeschriftung und Grounding mit starker Zero-Shot-Leistung.
 Abirami Vina7 Min. Lesezeit
Im Juni 2024 stellte Microsoft Florence-2 vor, ein multimodales Vision-Sprach-Modell (VLM), das eine Vielzahl von Aufgaben bewältigen soll, darunter Objekterkennung, Segmentierung, Bildbeschriftung und Grounding. Florence-2 setzt neue Maßstäbe bei der Zero-Shot-Leistung. Das bedeutet, dass das Modell Aufgaben ohne vorheriges spezielles Training ausführen kann. Außerdem ist es kleiner als andere Vision-Sprach-Modelle auf dem neuesten Stand der Technik.
Florence-2 ist mehr als nur ein weiteres Modell. Seine Vielseitigkeit und verbesserte Leistung können verschiedene Branchen erheblich beeinflussen, indem sie die Genauigkeit erhöhen und den Bedarf an umfangreichem Training verringern. In diesem Artikel betrachten wir die wichtigsten Funktionen von Florence-2, vergleichen seine Leistung mit anderen VLMs und besprechen mögliche Anwendungsbereiche.
Was ist Florence-2?#
Florence-2 kann innerhalb eines einheitlichen Rahmens eine Vielzahl von Aufgaben bewältigen. Die Fähigkeiten des Modells beruhen zum Teil auf seinem umfangreichen Trainingsdatensatz FLD-5B. FLD-5B umfasst 5,4 Milliarden Annotationen zu 126 Millionen Bildern. Dieser umfassende Datensatz wurde eigens erstellt, um Florence-2 die nötigen Fähigkeiten für eine Vielzahl von Vision-Aufgaben mit hoher Genauigkeit und Effizienz zu vermitteln.
Hier findest du einen genaueren Überblick über die Aufgaben, die Florence-2 unterstützt:
- Objekterkennung: Das Modell kann Objekte in Bildern mit hoher Präzision erkennen und lokalisieren.
- Segmentierung: Bei dieser Aufgabe wird ein Bild in aussagekräftige Bereiche unterteilt, damit es einfacher analysiert und interpretiert werden kann.
- Bildbeschriftung: Florence-2 kann aussagekräftige Bildbeschreibungen mit Kontext und Details erstellen.
- Visuelles Grounding: Das Modell kann bestimmte Ausdrücke oder Wörter in einer Bildbeschreibung den entsprechenden Bildbereichen zuordnen.
- Zero-Shot-Leistung: Das Modell kann Aufgaben ohne spezifisches Training ausführen.
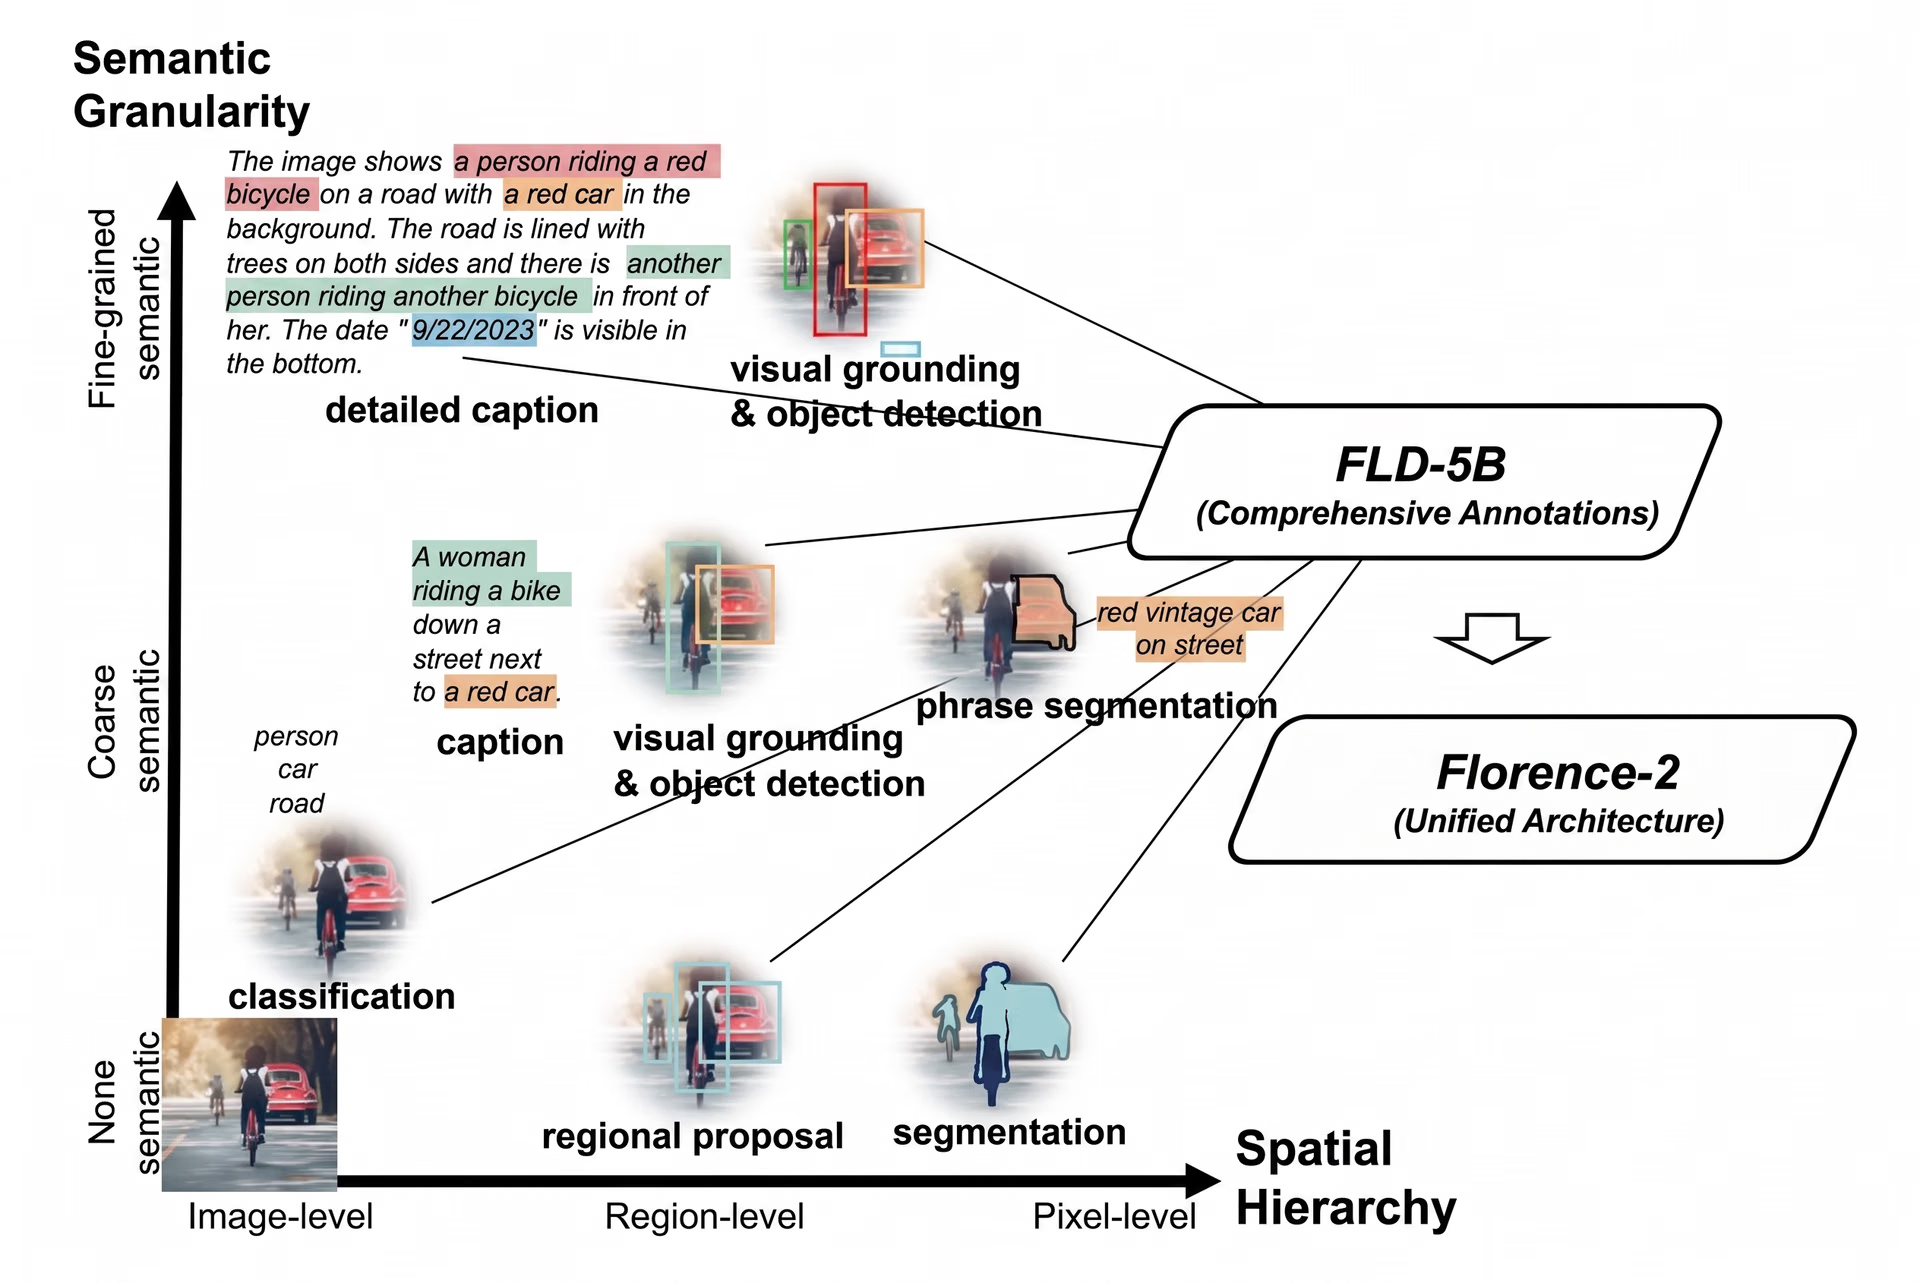
Abb. 1 So wurde Florence-2 trainiert.
Das Modell unterstützt sowohl textbasierte als auch regionsbasierte Aufgaben. Für Aufgaben zu bestimmten Bildbereichen werden dem Vokabular des Modells spezielle Positionstokens hinzugefügt. Diese Tokens helfen dem Modell, verschiedene Formen zu verstehen, etwa Rechtecke um Objekte (Box-Darstellung), Vierecke (Vierecksdarstellung) und Vielecke (Polygon-Darstellung). Das Modell wird mit einer standardmäßigen Kreuzentropie-Verlustfunktion trainiert. Dabei lernt es, indem es seine Vorhersagen mit den richtigen Antworten vergleicht und seine internen Parameter entsprechend anpasst.
Erstellung des FLD-5B-Datensatzes#
Der Datensatz FLD-5B umfasst verschiedene Arten von Annotationen: Textbeschreibungen, Paare aus Regionen und Text sowie Kombinationen aus Text, Ausdrücken und Regionen. Er wurde in einem zweistufigen Prozess aus Datenerfassung und Annotation erstellt. Die Bilder stammen aus bekannten Datensätzen wie ImageNet-22k, Objects365, Open Images, Conceptual Captions und LAION. Die Annotationen im Datensatz FLD-5B sind größtenteils synthetisch, das heißt, sie wurden automatisch und nicht manuell erstellt.
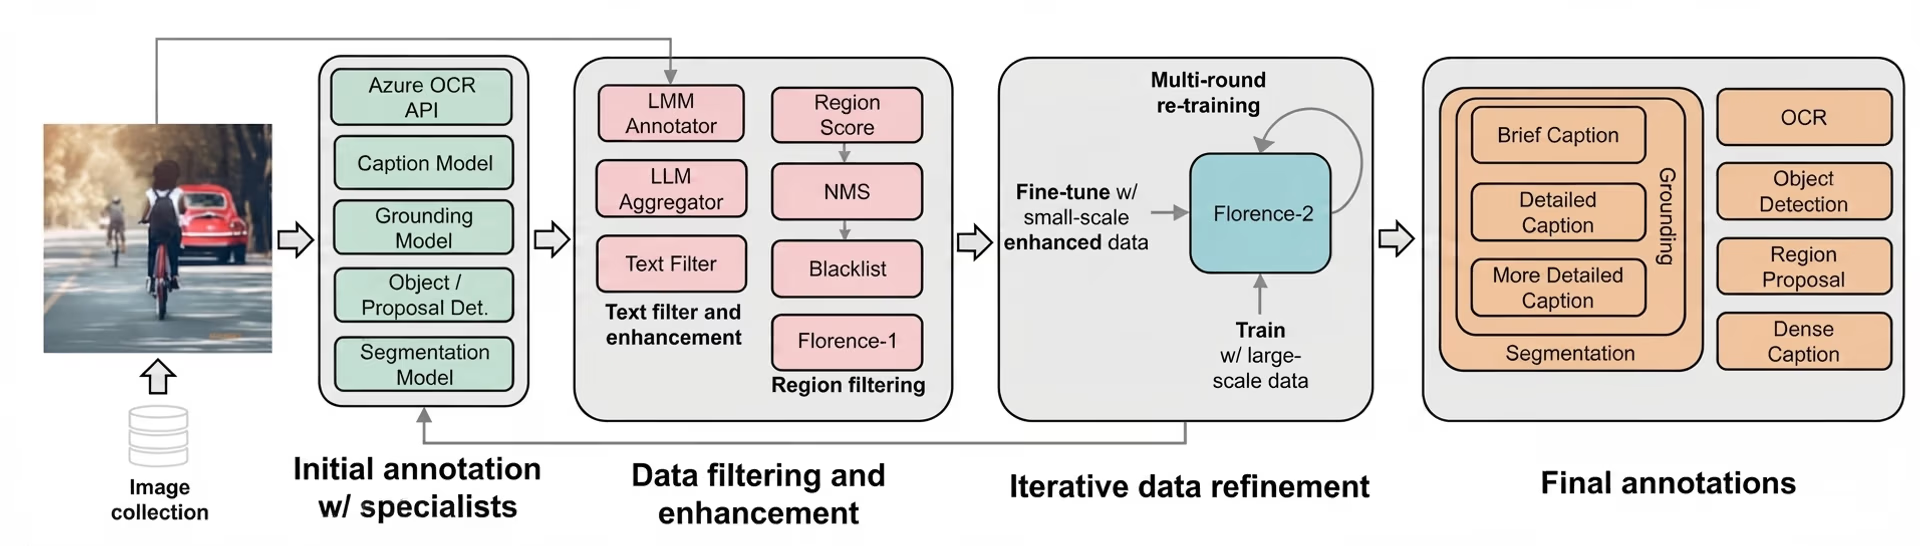
Abb. 2 Erstellung des Datensatzes FLD-5B.
Zunächst erstellten spezialisierte Modelle, die Aufgaben wie Objekterkennung oder Segmentierung besonders gut beherrschen, diese Annotationen. Anschließend sorgte ein Filterungs- und Verbesserungsverfahren dafür, dass die Annotationen detailliert und genau waren. Nachdem Störfaktoren entfernt worden waren, wurde der Datensatz iterativ verfeinert. Dabei nutzte man die Ausgaben von Florence-2, um die Annotationen fortlaufend zu aktualisieren und zu verbessern.
Die Modellarchitektur von Florence-2 verstehen#
Die Modellarchitektur von Florence-2 basiert auf einem Sequenz-zu-Sequenz-Lernverfahren. Das bedeutet, dass das Modell eine Eingabesequenz – etwa ein Bild mit einer Textanweisung – verarbeitet und schrittweise eine Ausgabesequenz – etwa eine Beschreibung oder ein Label – erzeugt. In diesem Rahmen wird jede Aufgabe als Übersetzungsproblem behandelt: Das Modell erhält ein Eingabebild und eine aufgabenspezifische Anweisung und erzeugt die entsprechende Ausgabe.
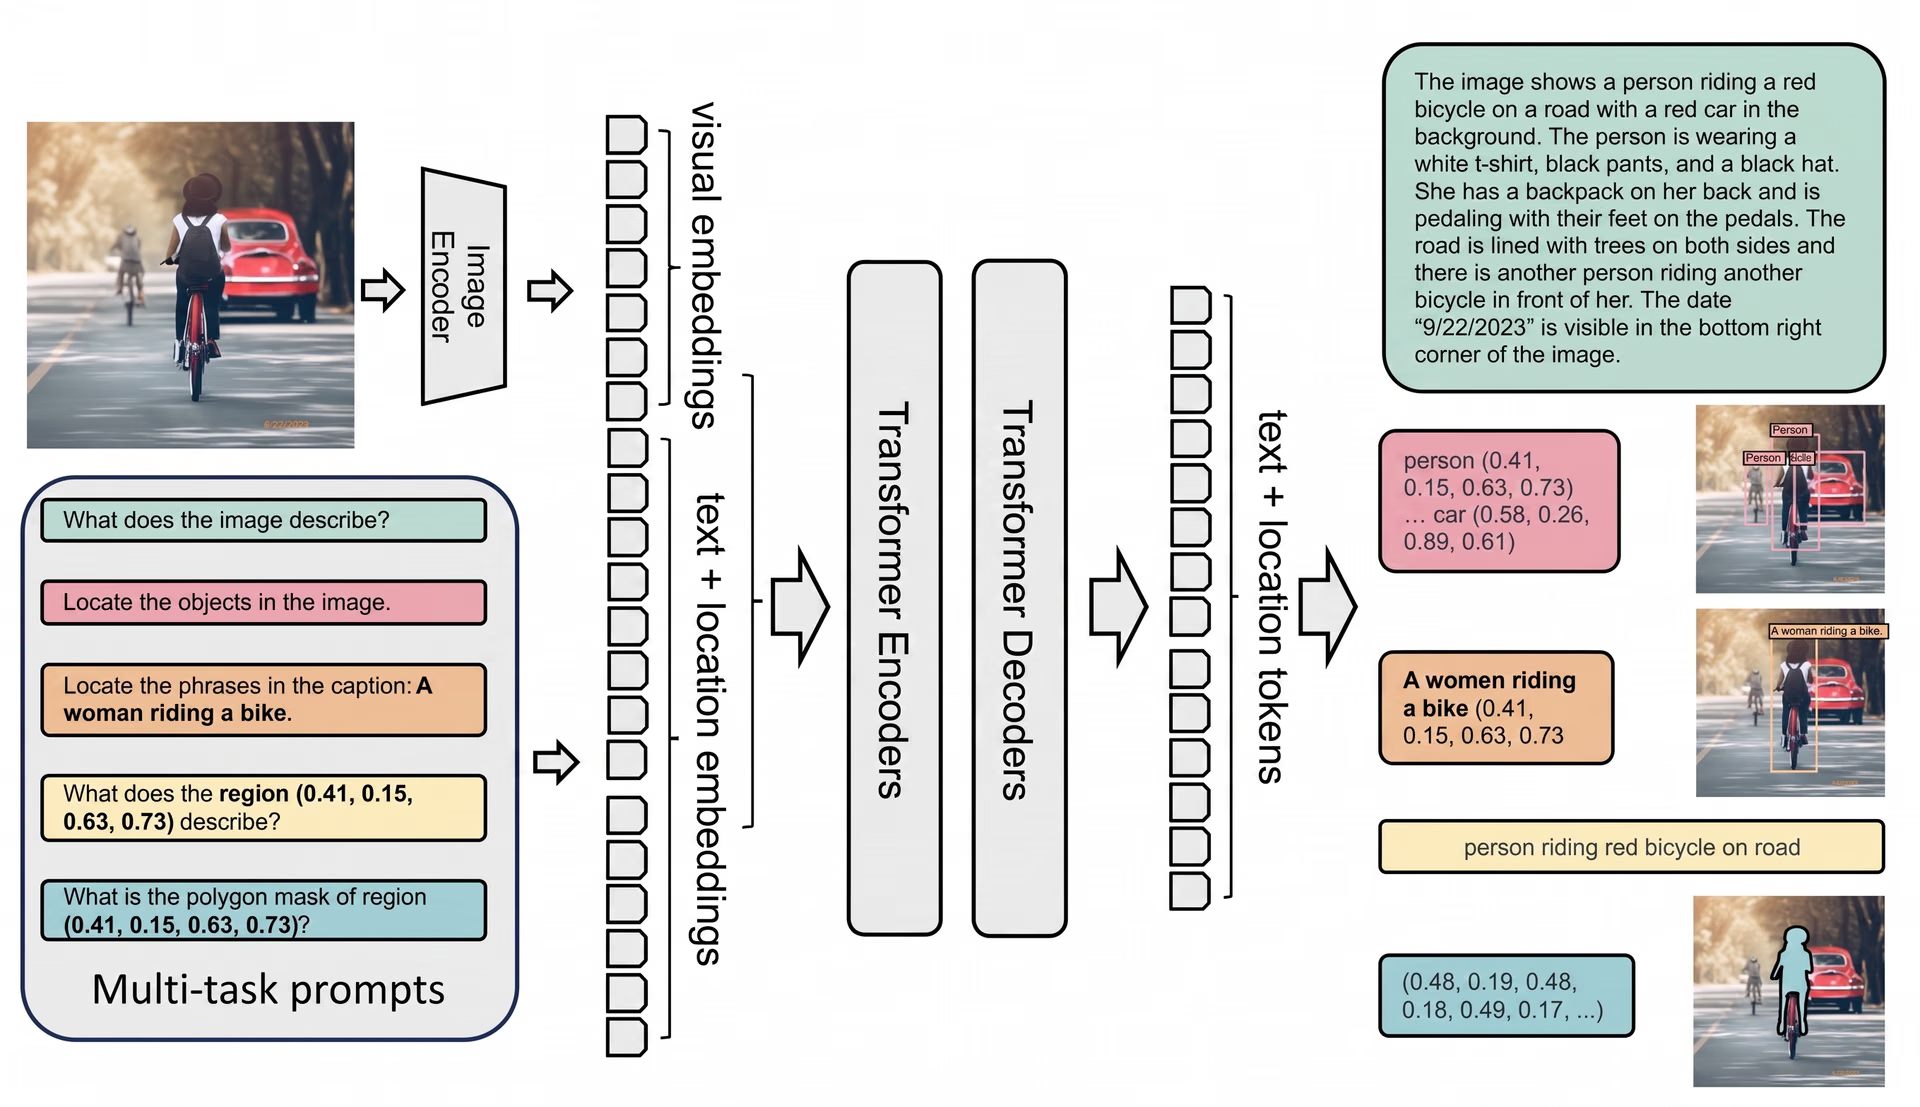
Abb. 3 Die Architektur des Vision-Sprach-Modells Florence-2.
Im Zentrum der Modellarchitektur steht ein multimodaler Encoder-Decoder-Transformer, der einen Bild-Encoder und einen multimodalen Encoder-Decoder kombiniert. Der Bild-Encoder namens DaViT (Dual Attention Vision Transformer) verarbeitet Eingabebilder, indem er sie in visuelle Token-Embeddings umwandelt – kompakte Bildrepräsentationen, die sowohl räumliche Informationen (wo sich Dinge befinden) als auch semantische Informationen (was Dinge sind) erfassen. Diese visuellen Token werden anschließend mit Text-Embeddings (Textrepräsentationen) kombiniert, sodass das Modell Text- und Bilddaten zusammenführen kann.
Florence-2 im Vergleich zu anderen VLMs#
Florence-2 hebt sich dank seiner starken Zero-Shot-Fähigkeiten von anderen Vision-Sprach-Modellen ab. Anders als Modelle wie PaliGemma, die umfangreiches Feinabstimmen benötigen, um sich an verschiedene Aufgaben anzupassen, funktioniert Florence-2 direkt nach der Installation gut. Außerdem kann Florence-2 mit größeren Modellen wie GPT-4V und Flamingo mithalten. Diese haben oft deutlich mehr Parameter, erreichen aber nicht immer die Leistung von Florence-2. So erzielt Florence-2 beispielsweise bessere Zero-Shot-Ergebnisse als Kosmos-2, obwohl Kosmos-2 mehr als doppelt so viele Parameter hat.
In Benchmark-Tests zeigte Florence-2 starke Leistungen bei Aufgaben wie COCO-Bildbeschriftung und dem Verständnis referenzieller Ausdrücke. Bei Objekterkennungs- und Segmentierungsaufgaben auf dem COCO-Datensatz übertraf das Modell PolyFormer und UNINEXT. Es ist eine äußerst wettbewerbsfähige Option für reale Anwendungen, bei denen sowohl Leistung als auch Ressourceneffizienz entscheidend sind. Auf der Ultralytics Platform kannst du Erkennungsdatensätze mit Florence-2 automatisch annotieren und das Modell im VLM-Leaderboard mit anderen Vision-Sprach-Modellen vergleichen.
Anwendungsbereiche von Florence-2#
Florence-2 lässt sich in vielen verschiedenen Branchen einsetzen, etwa in der Unterhaltungsbranche, bei der Barrierefreiheit, in der Bildung und weiteren Bereichen. Sehen wir uns einige Beispiele an, um das besser zu verstehen.
Anwendungsbereiche der Bildbeschriftung#
Wenn du auf einer Streamingplattform überlegst, was du ansehen möchtest, liest du vielleicht eine Zusammenfassung des Films, um dich zu entscheiden. Was wäre, wenn die Plattform auch eine ausführliche Beschreibung des Filmplakats anbieten könnte? Florence-2 macht das mit Bildbeschriftung möglich: Dabei wird beschreibender Text zu Bildern erzeugt. Florence-2 kann detaillierte Beschreibungen von Filmplakaten erstellen und Streamingplattformen dadurch für Menschen mit Sehbehinderung zugänglicher machen. Das Modell analysiert die visuellen Elemente eines Plakats, etwa Figuren, Landschaften und Text, und kann daraus eine ausführliche Beschreibung des Inhalts und der Stimmung erstellen. Das folgende Bild zeigt, wie detailliert die Beschreibung von Florence-2 sein kann.
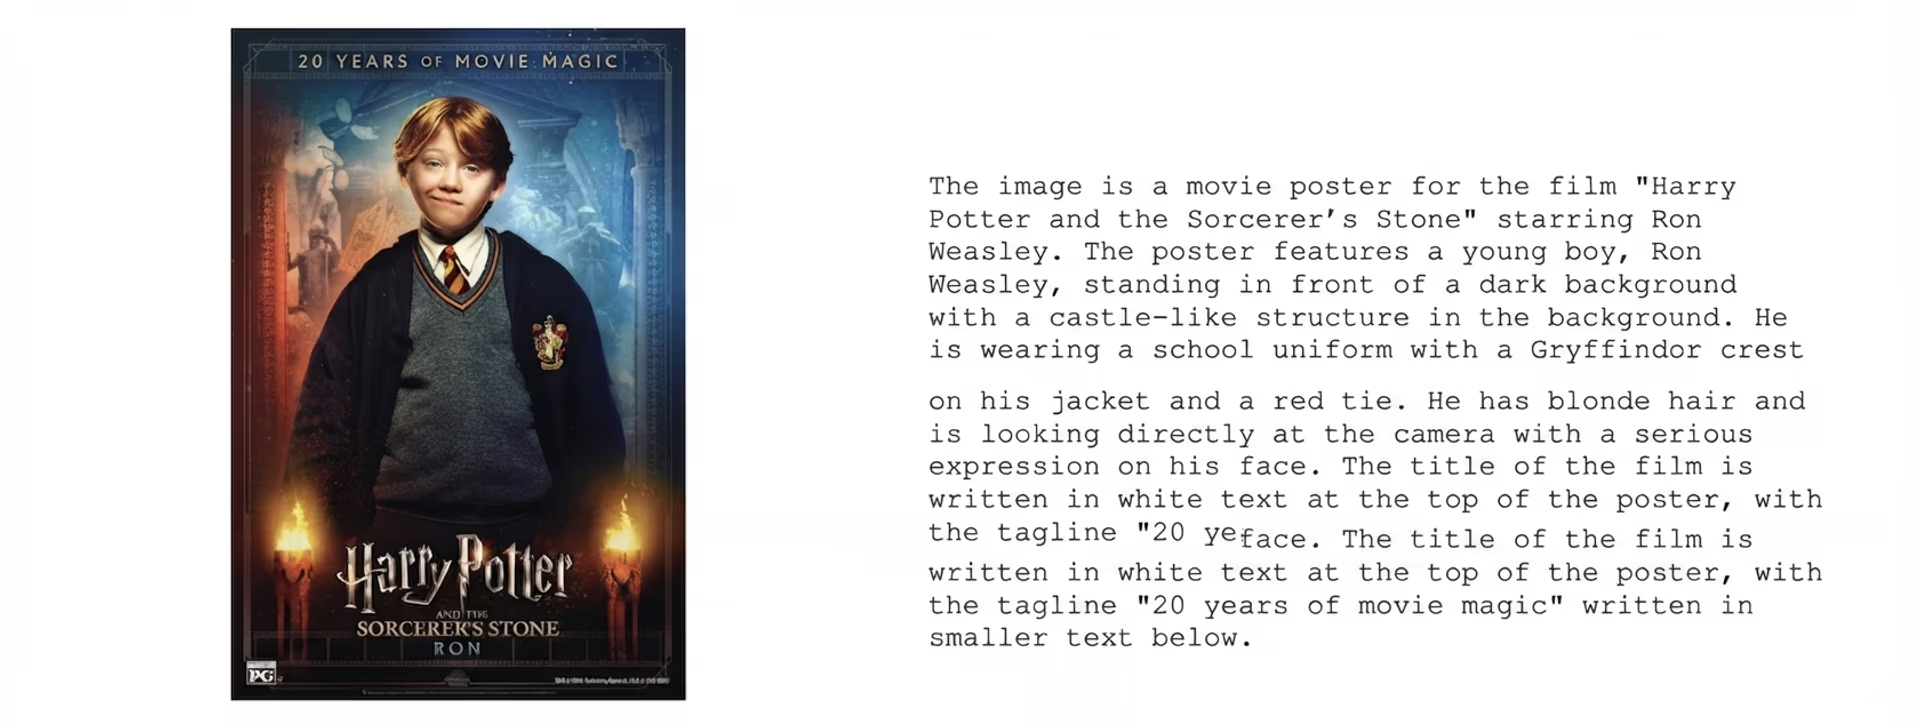
Abb. 4 Beispiel für eine von Florence-2 erzeugte Bildbeschriftung.
Hier sind weitere Beispiele dafür, wann Bildbeschriftungen hilfreich sein können:
- E-Commerce: Bildbeschriftungen können detaillierte Beschreibungen von Produktbildern liefern und Kundinnen und Kunden dabei helfen, die Merkmale und Einzelheiten der Produkte besser zu verstehen.
- Reisen und Tourismus: Bildbeschriftungen können ausführliche Beschreibungen von Sehenswürdigkeiten und Attraktionen in Reiseführern und Apps bereitstellen.
- Bildung: Bildbeschriftungen können Lehrbilder und Diagramme kennzeichnen und beschreiben und so das Lehren und Lernen unterstützen.
- Immobilien: Bildbeschriftungen können ausführliche Beschreibungen von Immobilienbildern liefern und Merkmale sowie Ausstattung hervorheben, die für potenzielle Käufer interessant sind.
Visuelles Grounding beim Kochen einsetzen#
Florence-2 kann auch kulinarische Erlebnisse bereichern. Ein digitales Kochbuch könnte Florence-2 zum Beispiel nutzen, um Bereiche in der Abbildung eines komplexen Rezepts visuell zuzuordnen und zu kennzeichnen. Visuelles Grounding ordnet bestimmte Bildbereiche den entsprechenden beschreibenden Texten zu. So lassen sich alle Zutaten und Arbeitsschritte genau kennzeichnen und erläutern. Das erleichtert Hobbyköchen das Nachkochen und hilft ihnen, die Rolle der einzelnen Zutaten im Gericht zu verstehen.
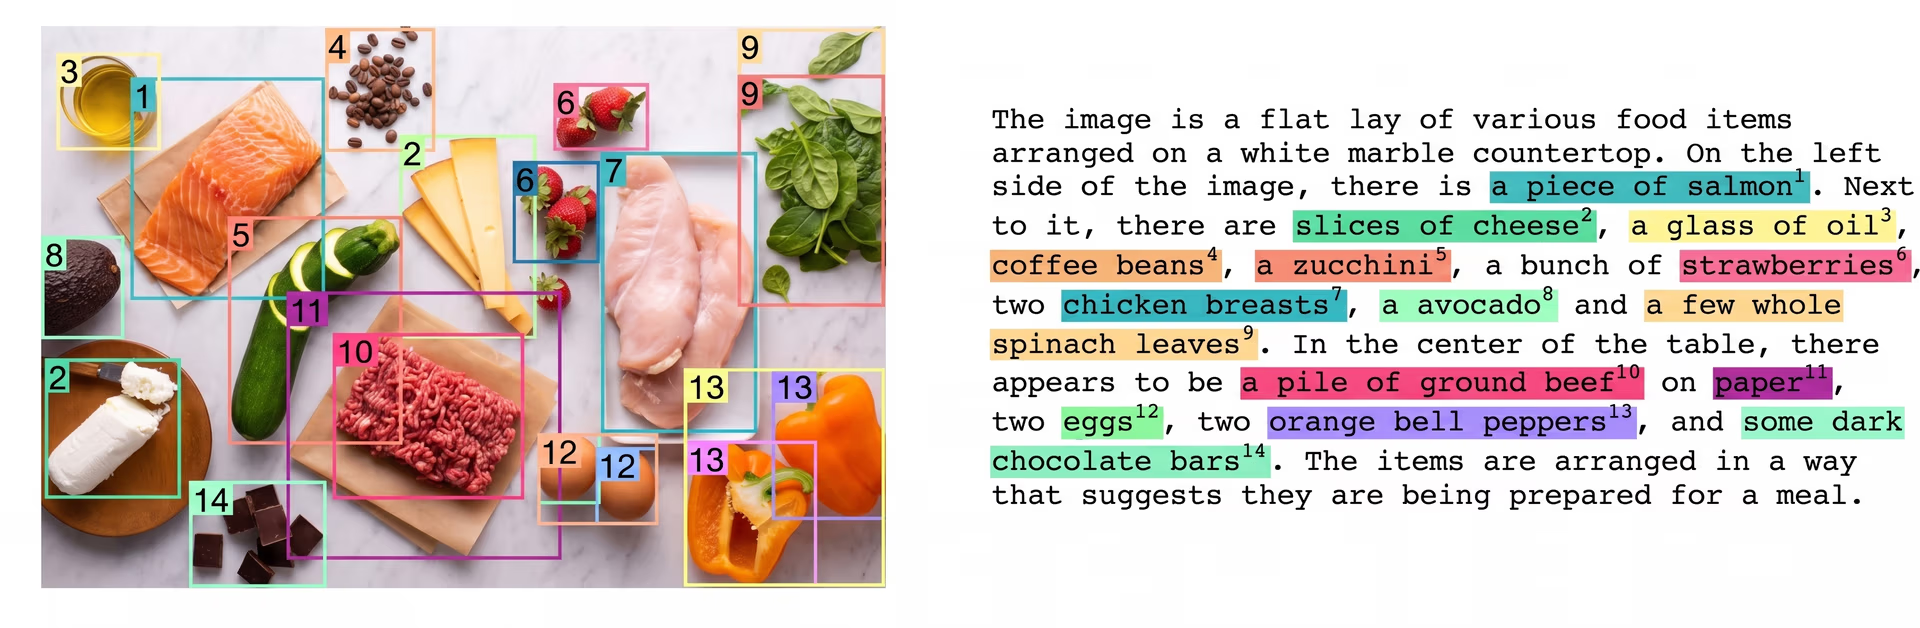
Abb. 5 Beispiel für visuelles Grounding mit Florence-2.
OCR für Finanzdokumente auf Basis von Bildbereichen#
OCR mit Verarbeitung bestimmter Bildbereiche, bei der Text aus festgelegten Dokumentbereichen extrahiert wird, kann beispielsweise in der Buchhaltung nützlich sein. Festgelegte Bereiche von Finanzdokumenten lassen sich analysieren, um wichtige Angaben wie Transaktionsdetails, Kontonummern und Fälligkeitstermine automatisch zu extrahieren. Das verringert den Bedarf an manueller Dateneingabe, reduziert Fehler und beschleunigt die Verarbeitung. Finanzinstitute können das Verfahren nutzen, um Aufgaben wie die Rechnungsverarbeitung, den Abgleich von Belegen und die Scheckverrechnung zu vereinfachen. Das führt zu schnelleren Transaktionen und besserem Kundenservice.
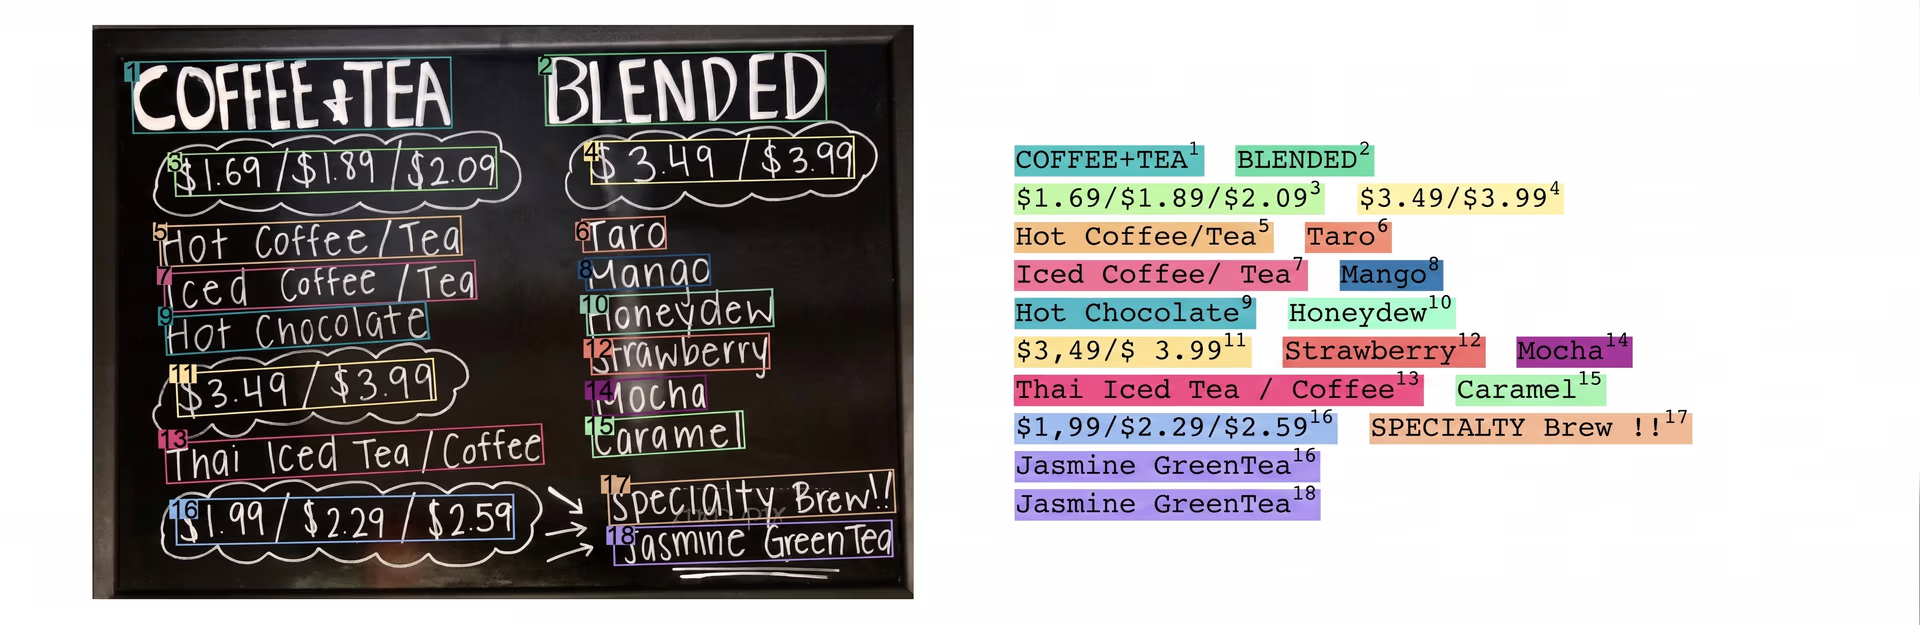
Abb. 6 Beispiel für OCR-Textextraktion aus einem Bildbereich mit Florence-2.
Segmentierung von Bildbereichen in industriellen Anwendungen#
Bei der Segmentierung von Bildbereichen wird ein Bild in aussagekräftige Teile untergliedert, die sich gezielt analysieren und eingehend untersuchen lassen. Sie kann industrielle Anwendungen unterstützen, die die Präzision und Effizienz verschiedener Prozesse verbessern. Indem sich die Technologie auf bestimmte Bildbereiche konzentriert, ermöglicht sie eine genaue Prüfung und Analyse von Bauteilen und Produkten. Bei der Qualitätskontrolle kann sie Materialfehler oder Unregelmäßigkeiten wie Risse und Ausrichtungsfehler erkennen und so sicherstellen, dass nur hochwertige Produkte auf den Markt gelangen.
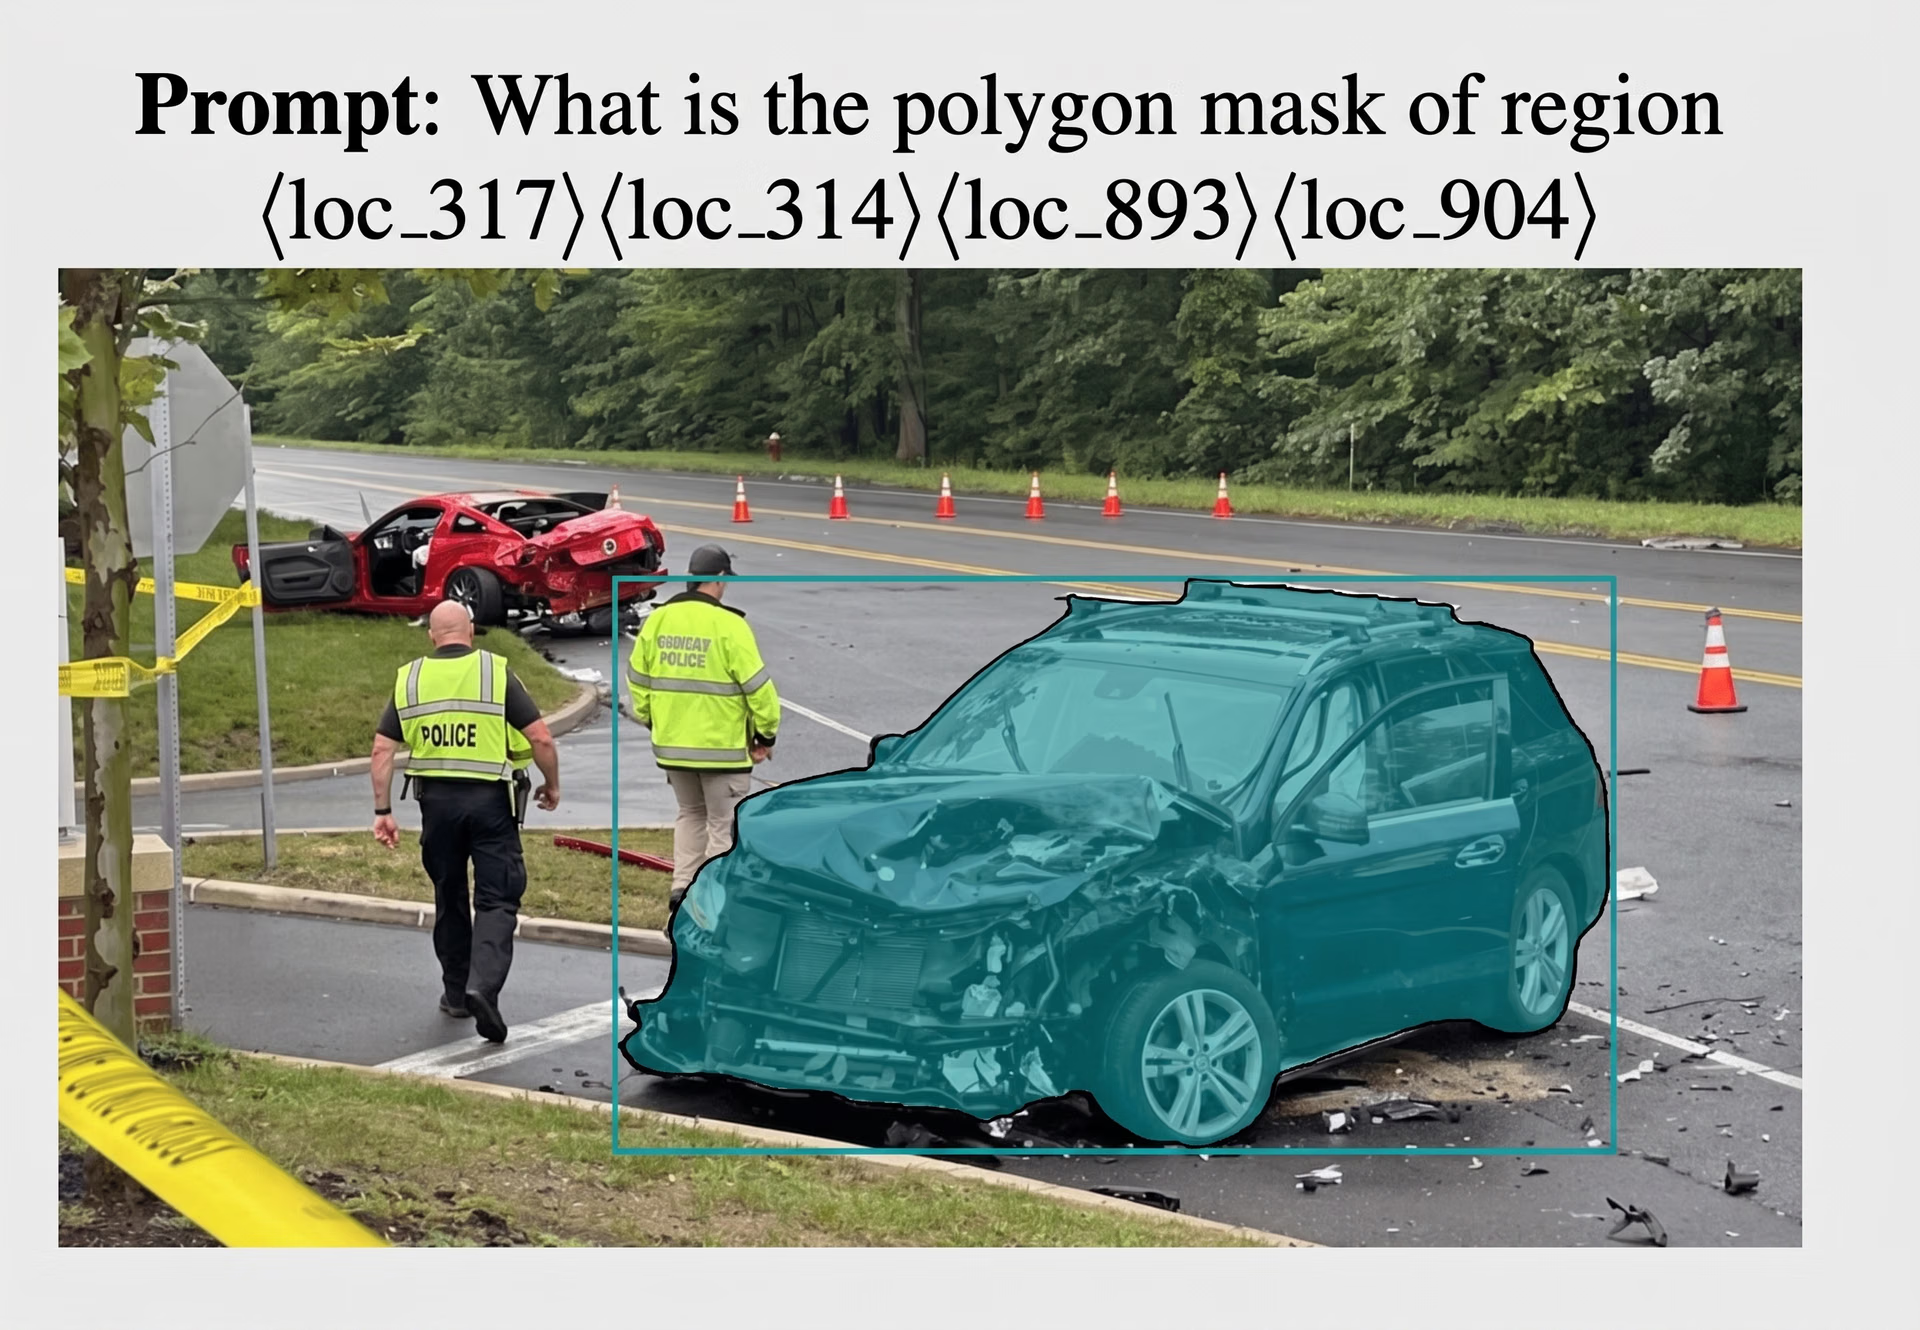
Abb. 7 Beispiel für die Segmentierung von Bildbereichen mit Florence-2.
Die Technologie verbessert außerdem automatisierte Montagelinien, indem sie Roboter arme zu bestimmten Bauteilen führt und die Positionierung sowie Montage der Bauteile optimiert. Auch in der Lagerverwaltung hilft sie dabei, den Zustand und Standort von Waren zu verfolgen und zu überwachen. Das ermöglicht eine effizientere Logistik und weniger Ausfallzeiten. Insgesamt verbessert die Segmentierung von Bildbereichen in der Industrie Genauigkeit und Produktivität. Das spart Kosten und erhöht die Produktqualität.
Die wichtigsten Erkenntnisse#
Wir beobachten zunehmend, dass KI-Modelle leichter werden und zugleich eine hohe Leistung beibehalten. Florence-2 ist ein wichtiger Fortschritt für Vision-Sprach-Modelle. Das Modell kann Aufgaben wie Objekterkennung, Segmentierung, Bildbeschriftung und Grounding mit beeindruckender Zero-Shot-Leistung bewältigen. Trotz seiner geringeren Größe ist Florence-2 effizient und vielseitig und eignet sich dadurch für Anwendungen in unterschiedlichen Branchen. Modelle wie Florence-2 eröffnen neue Möglichkeiten und erweitern das Potenzial für KI-Innovationen.
Erfahre mehr über KI in unserem GitHub-Repository und werde Teil unserer Community. Auf unseren Lösungsseiten findest du weitere Informationen zu KI-Anwendungen in der Fertigung und der Landwirtschaft.
Verfasst von
Content Creator · Ultralytics
Kommentare
Stelle eine Frage, teile deine Ergebnisse oder hilf anderen.









