So vereinfacht die Ultralytics Platform die Bereitstellung von Computer-Vision-Modellen
Sieh dir an, wie die Ultralytics Platform alle wichtigen Funktionen für die Bereitstellung von Computer-Vision-Modellen vereint – vom Testen bis hin zu produktionsreifen APIs.
 Abirami Vina11 Min. Lesezeit
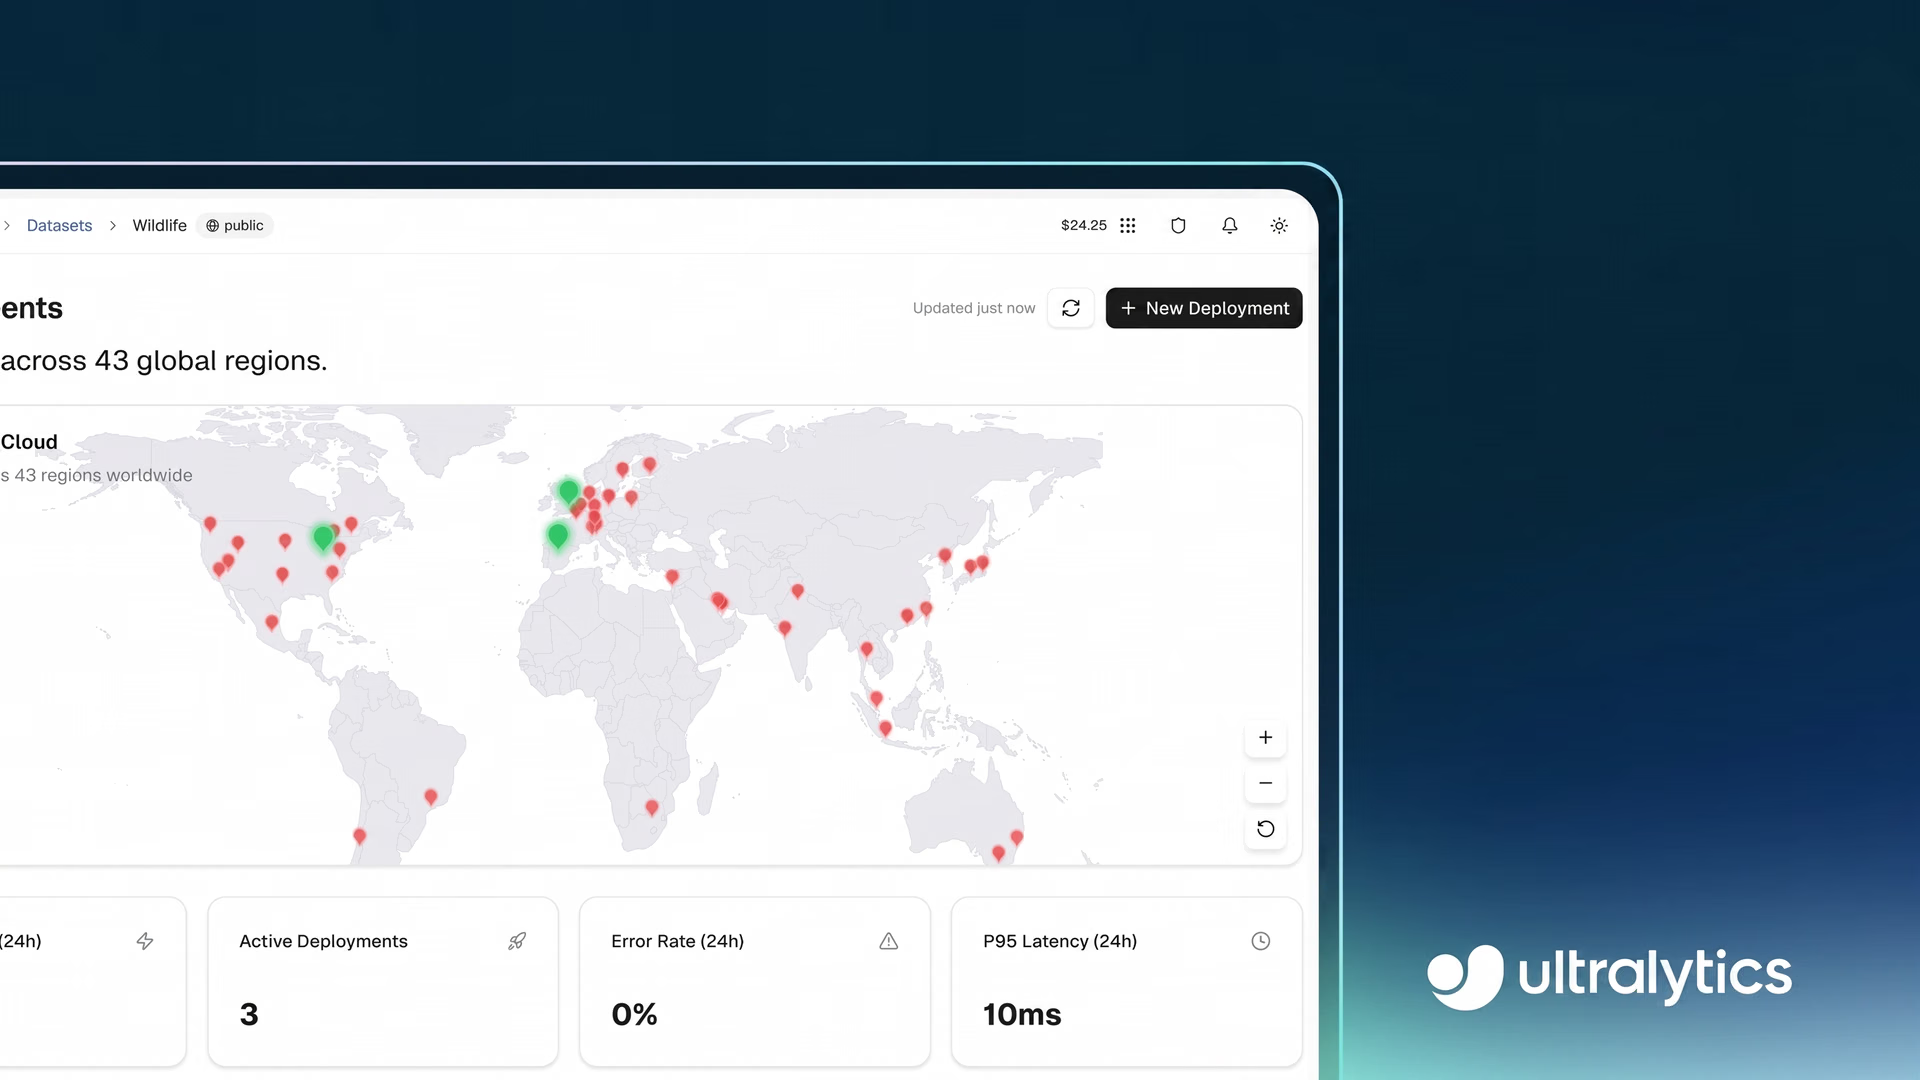
Ultralytics arbeitet seit Jahren mit der Computer-Vision-Community zusammen und entwickelt Modelle und Werkzeuge, die visuelle KI für alle zugänglicher machen. Mit der Ultralytics Platform gehen wir noch einen Schritt weiter: Wir führen den gesamten Entwicklungsablauf für Computer Vision in einer einheitlichen Umgebung zusammen – von der Verwaltung und Annotation von Datensätzen bis hin zu Modelltraining, Validierung und Bereitstellung.
Insbesondere freuen wir uns darauf, die Bereitstellung von Computer-Vision-Modellen einfacher zu machen. Computer Vision findet zunehmend Eingang in reale Anwendungen, doch die Analyse von Bildern und Videos außerhalb kontrollierter Umgebungen ist nach wie vor komplex.
Anders als bei Testaufbauten mit vorhersehbaren Bedingungen sind reale Szenarien von wechselnden Lichtverhältnissen, sich ändernden Eingaben und unvorhersehbarer Auslastung geprägt. Dadurch wird die Bereitstellung zu einer der größten Herausforderungen im Computer-Vision-Workflow.
Bei der Bereitstellung geht es um mehr, als ein Modell einfach nur verfügbar zu machen. Es müssen Prozesse eingerichtet werden, die reale Daten verarbeiten können, und es muss sichergestellt sein, dass alles reibungslos läuft, wenn die Nutzung zunimmt und Projekte wachsen.
Teams müssen außerdem die Leistung nachverfolgen und die Zuverlässigkeit langfristig aufrechterhalten. Dafür ist häufig ein Wechsel zwischen verschiedenen KI-Tools für Tests, Integration, Bereitstellung und Überwachung nötig. Das kann die Modellentwicklung verlangsamen und unnötige Komplexität verursachen.
So entstehen fragmentierte Workflows. Die Ultralytics Platform führt diesen Prozess zusammen und vereinfacht ihn.
Sie bietet integrierte Unterstützung für das Bereitstellen, Testen und Überwachen von Modellen in einer einzigen Umgebung. Teams können Modelle mit browserbasierter Inferenz überprüfen, sie über gemeinsame Inferenzdienste in Anwendungen integrieren und auf dedizierten Endpunkten mit Leistungsüberwachung bereitstellen.
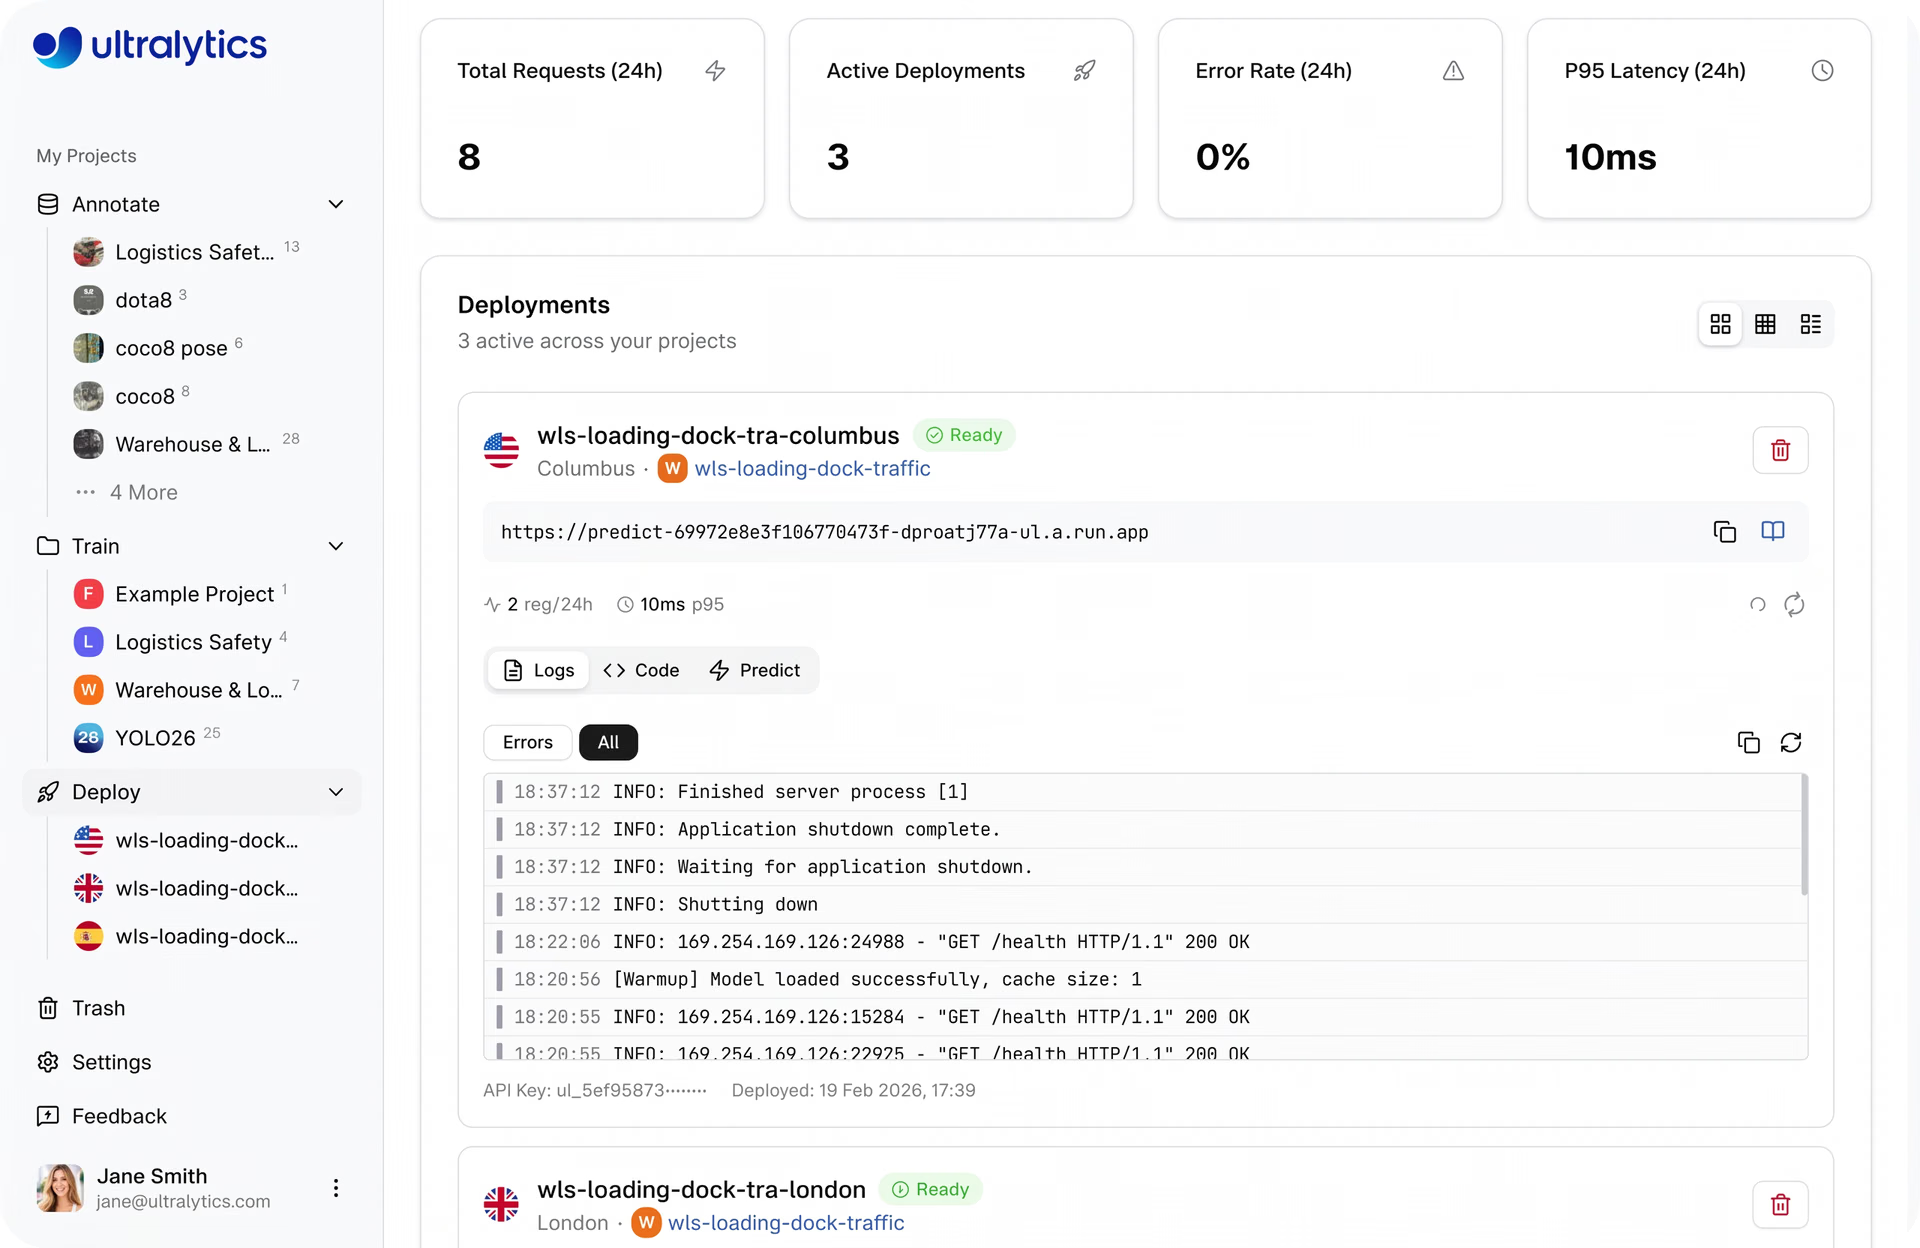
Abb. 1: Ein Blick auf die Bereitstellungsseite in der Ultralytics Platform (Quelle)
In diesem Artikel zeigen wir, wie Ultralytics Platform die Bereitstellung von Modellen für Computer Vision vereinfacht – vom Testen und der Integration bis hin zum produktiven Einsatz und der Überwachung. Los geht’s!
Überblick über die Modellbereitstellung für Computer Vision#
Im Lebenszyklus des maschinellen Lernens ist die Modellbereitstellung die Phase, in der ein Modell aus der Experimentierphase in den praktischen Einsatz übergeht. Bei Computer-Vision-Modellen, die mit Deep Learning und konvolutionalen neuronalen Netzen erstellt wurden, bedeutet das in der Regel, sie für die Echtzeitverarbeitung von Bildern und Videos verfügbar zu machen.
Nach der Bereitstellung verarbeiten diese Modelle neue Daten, die in der Regel zunächst vorverarbeitet werden, etwa durch Größenanpassung, Normalisierung oder Formatierung. Anschließend werden die verarbeiteten Daten an das Modell übergeben, das die während des Trainings erlernten Muster anwendet, um hochpräzise Vorhersagen zu erstellen.
Je nach Anwendungsfall kann das unterschiedliche Computer-Vision-Aufgaben umfassen. Ultralytics-YOLO-Modelle wie Ultralytics YOLO26 unterstützen beispielsweise zahlreiche Aufgaben im Bereich Computer Vision, darunter Objekterkennung, Instanzsegmentierung, Bildklassifizierung, Posenschätzung und die Erkennung orientierter Begrenzungsrahmen (OBB).
Damit sich das in realen Anwendungen praktisch umsetzen lässt, müssen Modelle häufig in Systeme integriert werden, die sowohl die Vorverarbeitung als auch die Inferenz effizient bewältigen. Hier wird eine Infrastruktur für die Bereitstellung unverzichtbar.
In Produktivumgebungen greift man typischerweise über REST APIs oder Modellbereitstellungssysteme auf Modelle zu. Über diese Schnittstellen können Anwendungen programmgesteuert Daten senden und Vorhersagen empfangen. So lassen sie sich leichter in externe Anwendungen, IoT-Geräte oder Robotersysteme integrieren, die auf visuelles Verständnis in Echtzeit angewiesen sind.
Einschränkungen herkömmlicher Tools zur Bereitstellung von Computer-Vision-Modellen#
Die Bereitstellung von Computer-Vision-Modellen klingt vielleicht unkompliziert, doch bisher sah sie in der Praxis ganz anders aus. Ein typischer Ablauf: Zunächst werden Daten von Kameras oder Sensoren erfasst und zur Inferenz an ein Modell gesendet. Anschließend werden die Vorhersagen an eine Anwendung zurückgegeben.
In der Praxis wird jeder dieser Schritte häufig von eigenen Tools und Diensten übernommen. Ein System erfasst möglicherweise die Daten, ein anderes verwaltet die Modellbereitstellung, und zusätzliche Tools dienen der Skalierung, Überwachung und Protokollierung. Diese Komponenten miteinander zu verbinden und zuverlässig am Laufen zu halten, kann schnell komplex werden.
Mit zunehmender Nutzung wächst auch diese Komplexität. Die Infrastruktur zu verwalten, Abhängigkeiten zu handhaben und eine gleichbleibende Leistung über die gesamte Verarbeitungskette hinweg aufrechtzuerhalten, kann die Entwicklung verlangsamen und die Bereitstellung von Computer-Vision-Modellen in realen Anwendungen erschweren.
Die Ultralytics Platform führt diese Komponenten in einer einheitlichen Umgebung zusammen. So lässt sich der gesamte Bereitstellungsworkflow nahtloser verwalten und zugleich die Leistung und Zuverlässigkeit bei wachsender Nutzung sicherstellen.
Bereitstellungsoptionen für Modelle in der Ultralytics Platform#
Die Ultralytics Platform vereint nicht nur den Prozess der Modellbereitstellung, sondern bietet auch Flexibilität bei der Bereitstellung und Nutzung von Modellen.
Für die verschiedenen Phasen der Bereitstellung von Computer-Vision-Modellen bietet die Plattform vier Optionen: browserbasiertes Testen mit sofortiger Inferenz, gemeinsame Inferenz über APIs für die Entwicklung, dedizierte Endpunkte für skalierbare Produktivbereitstellungen in verschiedenen Regionen weltweit sowie den Modellexport, um Modelle auf externer Infrastruktur oder Edge-Geräten auszuführen.
Schauen wir uns genauer an, wie die einzelnen Optionen funktionieren.
Modelle schnell mit dem Tab „Predict“ überprüfen#
Bevor du ein Modell in den Produktivbetrieb überführst, solltest du wissen, wie es mit neuen, bisher unbekannten Daten umgeht. Die Ultralytics Platform bietet einen integrierten Tab „Predict“, mit dem du ohne Einrichtung, Infrastruktur oder Abhängigkeiten direkt im Browser Inferenz ausführen kannst.
Mit dem Tab „Predict“ lässt sich die Modellvalidierung schnell und interaktiv durchführen. Du kannst Bilder hochladen, vorinstallierte Beispiele verwenden oder Eingaben mit einer Webcam erfassen. Sobald Daten bereitgestellt werden, startet die Inferenz automatisch.
Die Ergebnisse werden sofort mit visuellen Überlagerungen, Konfidenzwerten und detaillierten Ausgaben angezeigt. So siehst du klar, wie sich das Modell verhält.
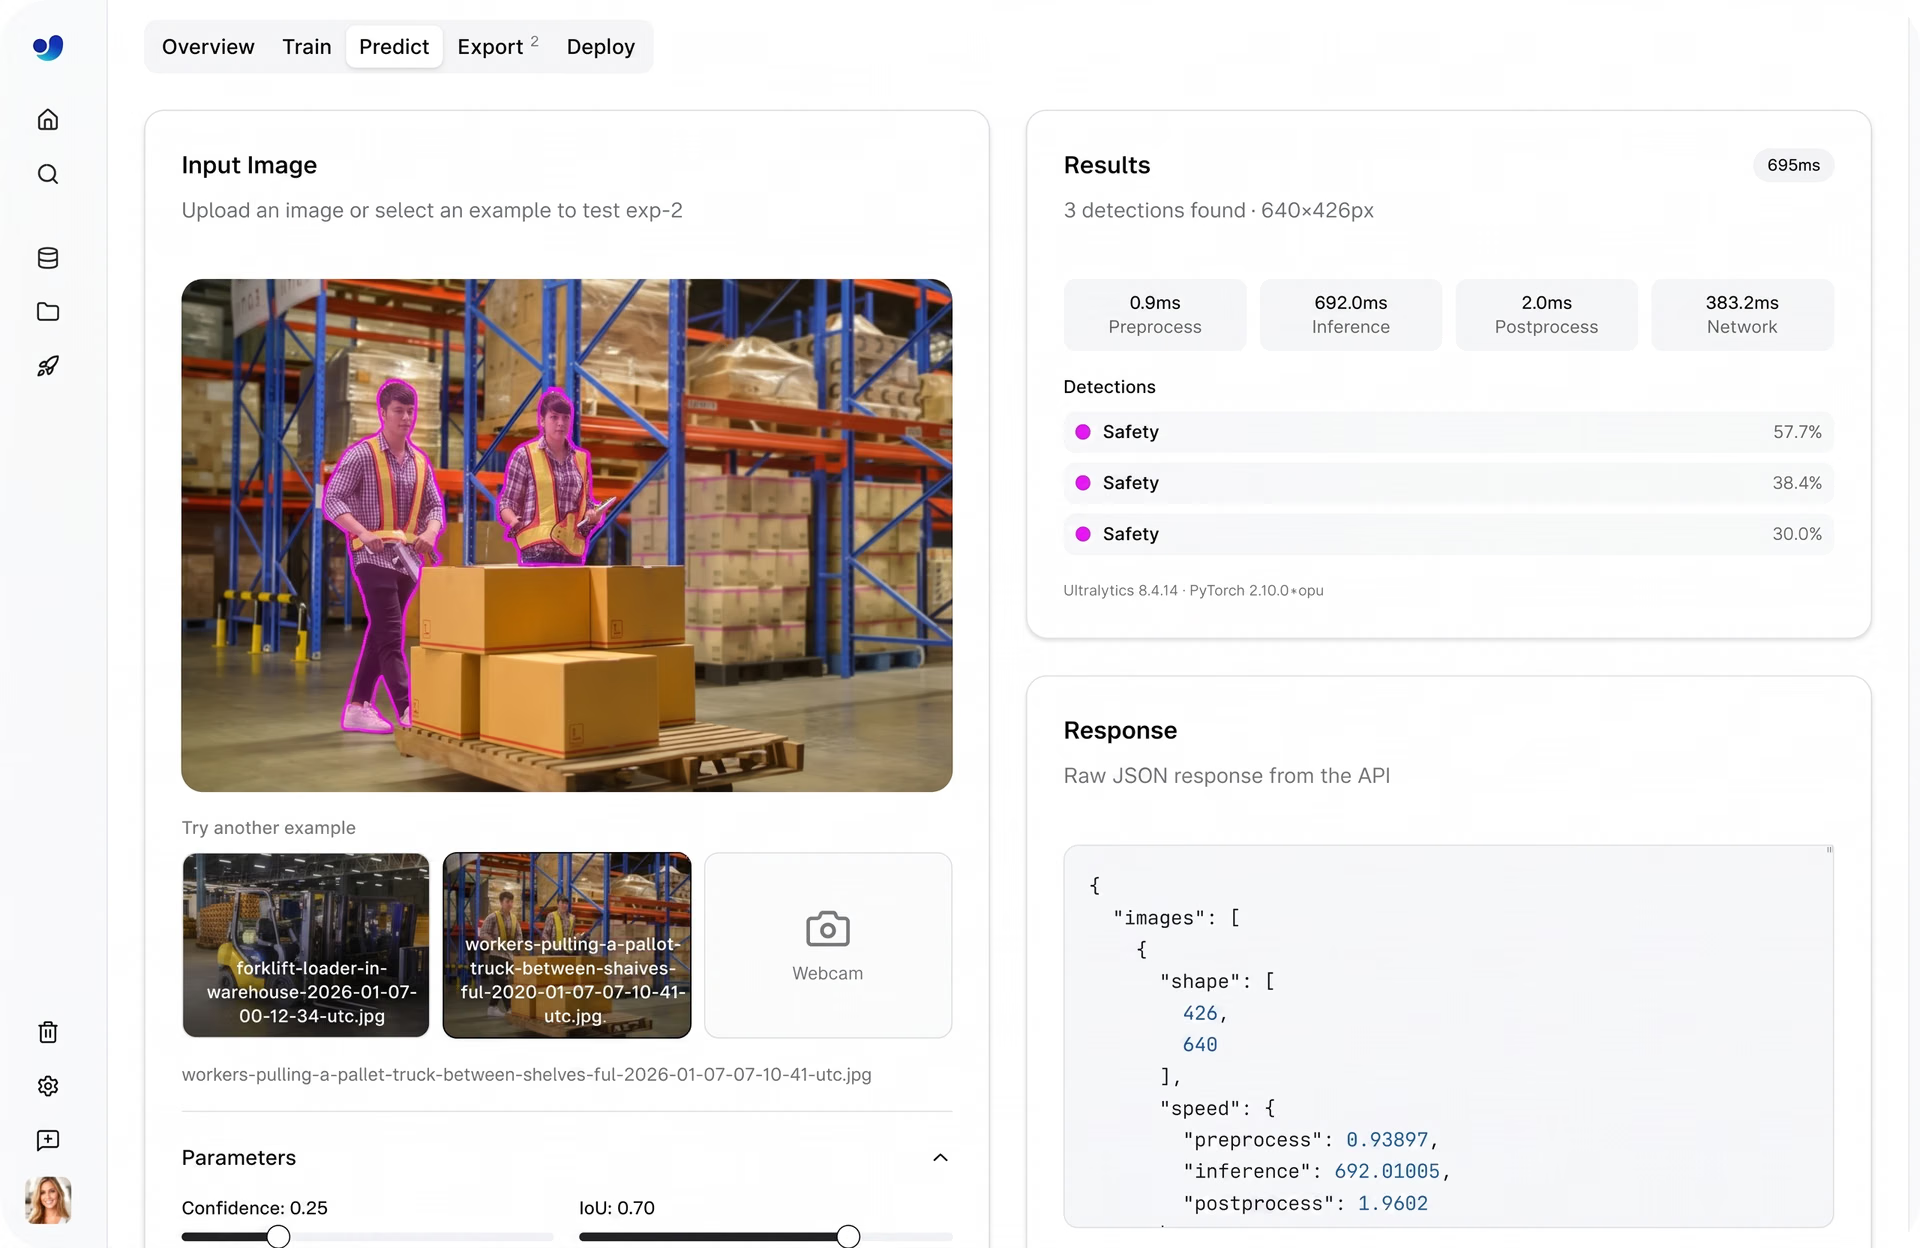
Abb. 2: Beispiel für die Überprüfung eines Modells mit dem Tab „Predict“ (Quelle)
Mit wenigen Klicks kannst du also verschiedene Eingaben testen, Parameter anpassen und die Leistung in einer einzigen Oberfläche bewerten, bevor du mit der Bereitstellung beginnst.
Gemeinsame Inferenz für Tests oder geringe Auslastung nutzen#
Angenommen, du hast ein Modell trainiert und mit dem Tab „Predict“ überprüft. Als Nächstes integrierst du es häufig in eine Anwendung oder einen Workflow.
Statt eine Infrastruktur einzurichten oder Server zu verwalten, kannst du mit den gemeinsamen Inferenzdiensten der Ultralytics Platform Daten an dein Modell senden und über einfache REST APIs Vorhersagen empfangen.
Im Hintergrund läuft die gemeinsame Inferenz auf einem mandantenfähigen System in einigen zentralen Regionen. Anfragen werden automatisch an den nächstgelegenen verfügbaren Dienst weitergeleitet. So bleibt die Leistung reaktionsschnell und Nutzende an verschiedenen Standorten können konsistent auf Modelle zugreifen.
Du kannst Eingaben über standardisierte HTTP-Anfragen senden und strukturierte Ergebnisse zurückerhalten. So lassen sich Modelle problemlos mit Anwendungen, Skripten oder automatisierten Arbeitsabläufen verbinden. Diese Lösung eignet sich besonders für Entwicklung, Tests, Integrationen und kleinere Anwendungsfälle, bevor du zu einer besser skalierbaren Bereitstellung im Produktivbetrieb wechselst.
Modelle weltweit über dedizierte Endpunkte bereitstellen#
Sobald ein Modell für den Produktionseinsatz bereit ist, muss es den Datenverkehr in der realen Welt zuverlässig und in großem Umfang bewältigen. Die Ultralytics Platform unterstützt dich dabei mit dedizierten Endpunkten, auf denen Modelle als Dienste für einzelne Kunden in 42 Regionen weltweit laufen. Werden sie näher an den Endnutzenden bereitgestellt, sinkt die Latenz und die Leistung bleibt an verschiedenen Standorten konstant.
Jeder Endpunkt verfügt über eigene zugewiesene Rechenressourcen und eine eindeutige URL für Inferenzanfragen. Dank dieser Kontrolle lassen sich Bereitstellungen leicht an die Leistungsanforderungen anpassen – von einfachen Anwendungsfällen bis hin zu anspruchsvolleren Anwendungen mit hohem Durchsatz, die mehr Rechenleistung benötigen.
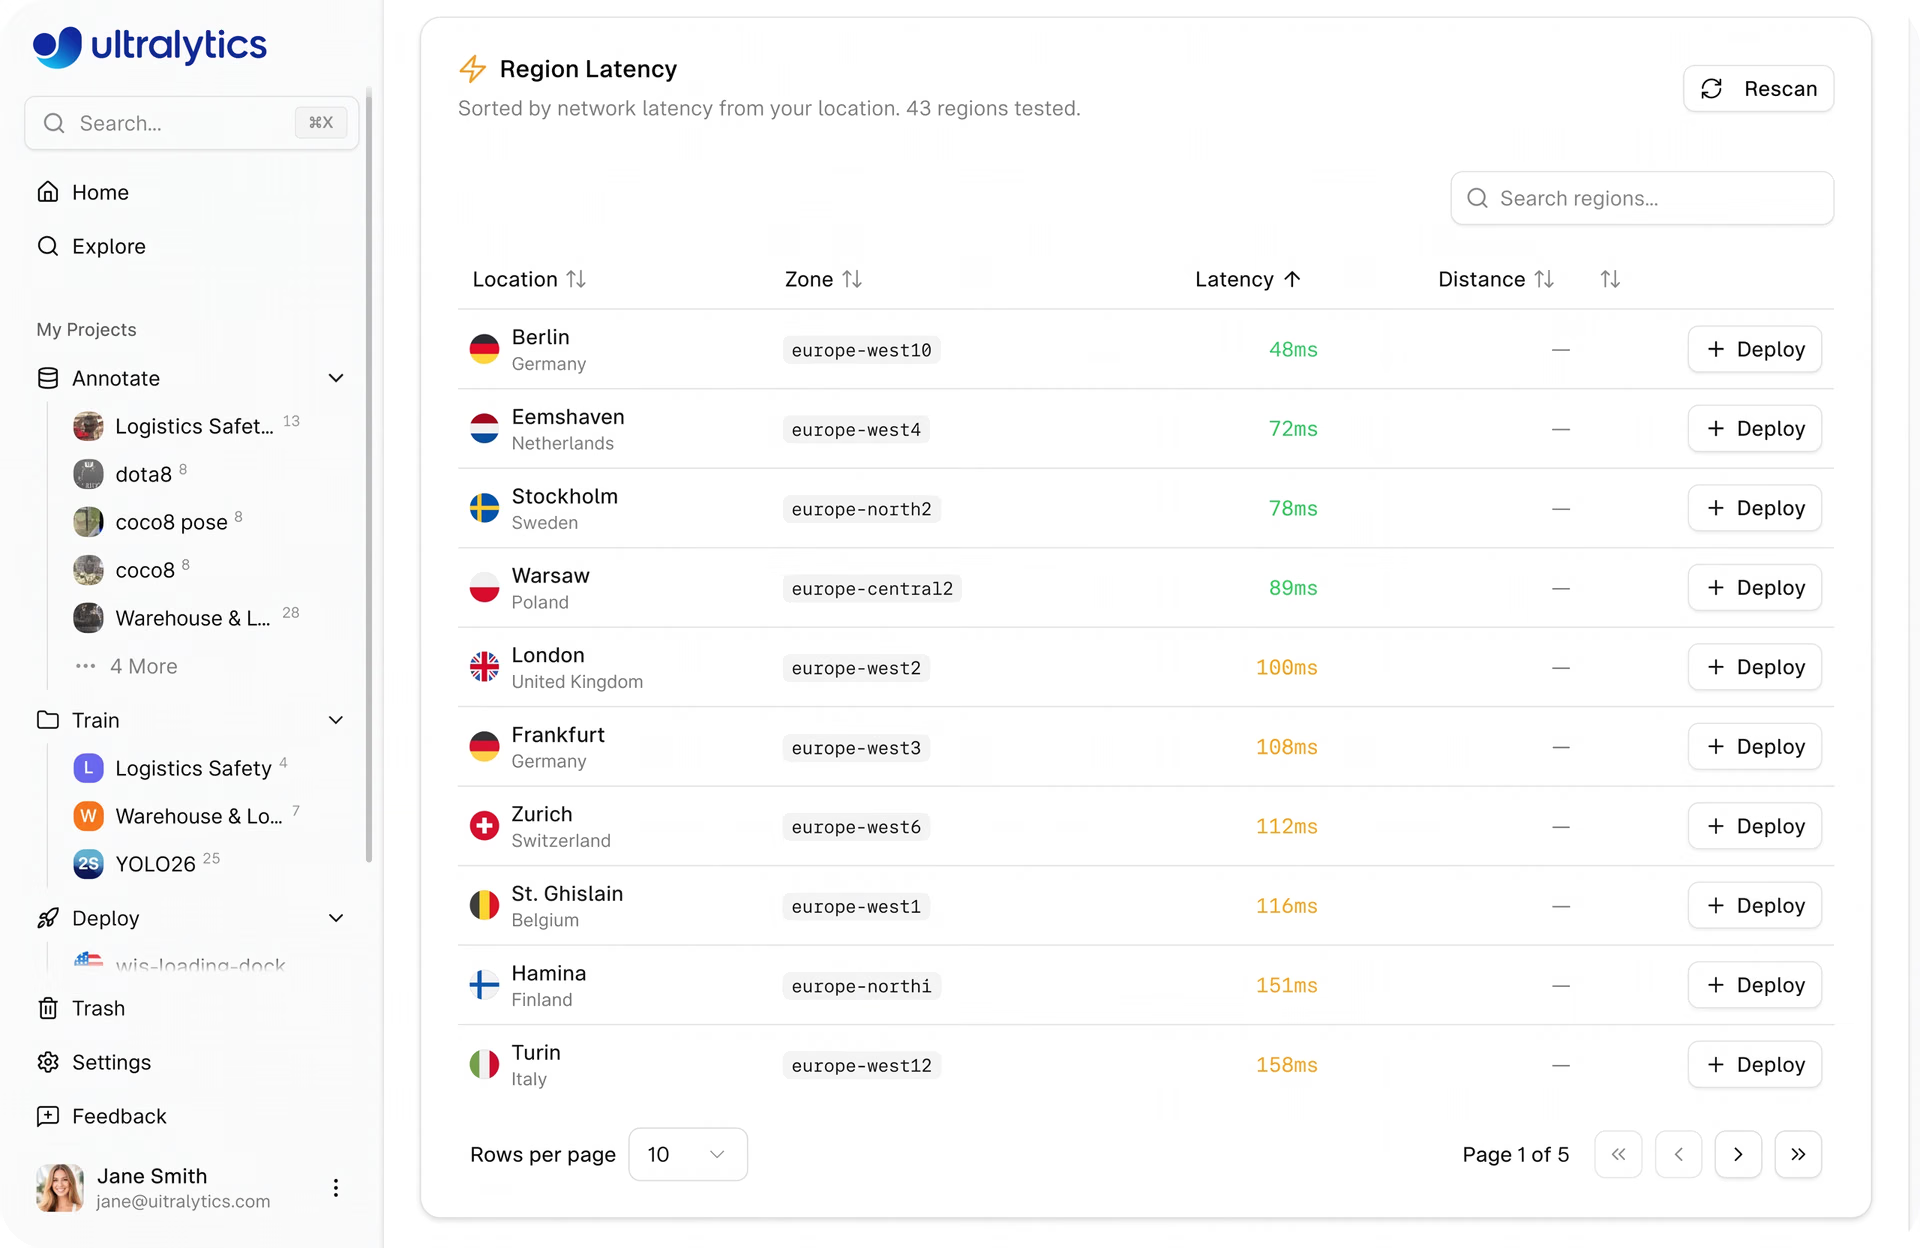
Abb. 3. Mit der Ultralytics Platform kannst du Modelle in 42 Regionen weltweit bereitstellen (Quelle)
Bei den Standardressourcen werden ungenutzte dedizierte Endpunkte auf null herunterskaliert und bei neuen Anfragen wieder gestartet. So lässt sich die Ressourcennutzung ohne manuelles Eingreifen optimieren. Benutzerdefiniert dimensionierte Endpunkte halten stattdessen eine Instanz betriebsbereit.
Modelle einfach mit der Ultralytics Platform exportieren#
Edge-KI wird immer wichtiger, da immer mehr Anwendungen auf Modellen basieren, die direkt auf Geräten wie Smartphones, Kameras und eingebetteten Systemen laufen. Die lokale Ausführung kann auch dabei helfen, Datenschutzanforderungen zu erfüllen: Sensible Daten wie Bilder oder Videostreams lassen sich direkt auf dem Gerät verarbeiten, ohne sie an externe Server zu senden.
In solchen Fällen müssen Modelle außerhalb von Ultralytics Platform ausgeführt werden, weshalb der Modellexport ein entscheidender Teil der Bereitstellung ist. Ultralytics-YOLO-Modelle werden häufig mit Python und PyTorch trainiert und können anschließend in mehr als 17 Formate exportiert werden, darunter ONNX, TensorRT, CoreML und OpenVINO.
Diese große Auswahl an Formaten gewährleistet die Kompatibilität mit unterschiedlichster Hardware – von leistungsstarken Grafikprozessoren (GPUs) bis hin zu Mobil- und Embedded-Geräten. Außerdem ermöglicht der Export eine gezielte Leistungsoptimierung für bestimmte Umgebungen.
Je nach Format können Modelle eine höhere Inferenzgeschwindigkeit erreichen, etwa durch bessere GPU-Leistung mit TensorRT oder eine optimierte CPU-Ausführung mit ONNX und OpenVINO. Optionen wie FP16- und INT8-Quantisierung können außerdem die Modellgröße verringern und den Durchsatz steigern. Das ist besonders bei Edge-Bereitstellungen nützlich.
In Ultralytics Platform ist der Export direkt in den Arbeitsablauf integriert. So lassen sich optimierte Modelle mit nur wenigen Klicks erstellen. Teams können vom Training dazu übergehen, Modelle auf externen Systemen auszuführen, ohne zusätzlichen Aufwand zu verursachen.
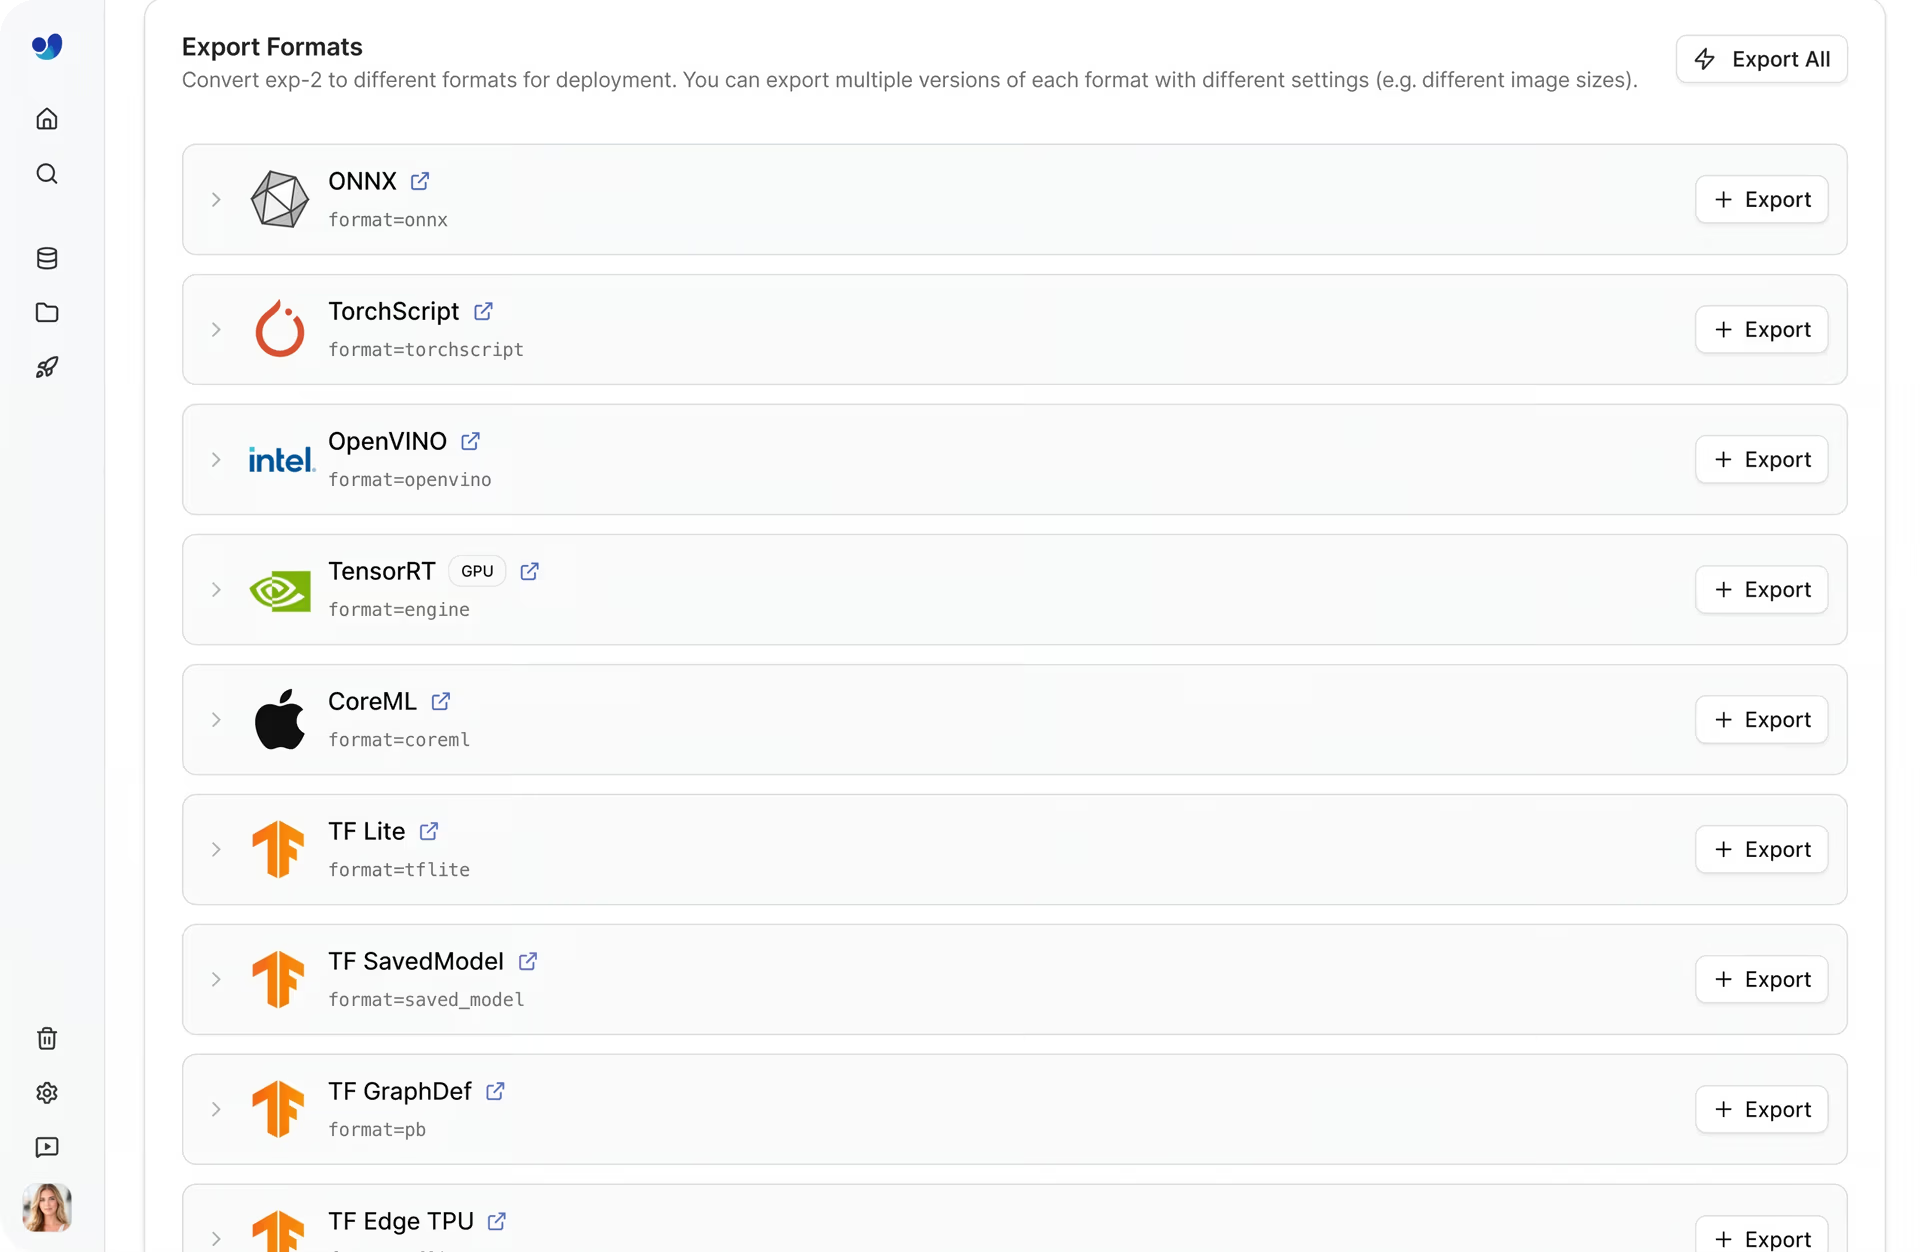
Abb. 4: Eine Auswahl an Exportformaten in der Ultralytics Platform.
Die passende Option für die Modellbereitstellung auswählen#
Jede Bereitstellungsoption der Ultralytics Platform unterstützt eine andere Phase des Workflows – von den ersten Tests bis zum Produktiveinsatz. Hier erfährst du, wann sich die jeweilige Option eignet:
- Tab „Predict“: Diese Option wird üblicherweise direkt nach dem Training oder der Feinabstimmung verwendet, um die Leistung eines Modells mit neuen Daten mithilfe browserbasierter Inferenz zu überprüfen.
- Gemeinsame Inferenz: In dieser Phase lassen sich Modelle über APIs in Anwendungen integrieren. So können reale Interaktionen während der Entwicklung getestet werden.
- Dedizierte Endpunkte: Sie eignen sich für Produktivbereitstellungen, bei denen Modelle eine konstante Leistung, dedizierte Ressourcen und die Möglichkeit zur Skalierung über Regionen weltweit benötigen.
- Modellexport: Wenn Modelle außerhalb der Plattform ausgeführt werden sollen, ermöglicht der Export die Bereitstellung auf Edge-Geräten, in mobilen Apps oder auf eigener Infrastruktur.
Teams durchlaufen diese Optionen oft Schritt für Schritt: von der Validierung über die Integration bis hin zur Bereitstellung im Produktivbetrieb – alles innerhalb der Plattform.
Bereitgestellte Modelle mit der Ultralytics Platform überwachen#
Die Bereitstellung ist zwar entscheidend, doch die Computer-Vision-Pipeline endet damit nicht. Sobald ein Modell im Produktivbetrieb läuft, ist kontinuierliche Überwachung wichtig, damit es langfristig zuverlässig funktioniert.
Die Ultralytics Platform bietet integrierte Überwachungstools, mit denen Teams nachvollziehen können, wie sich ihre KI-Modelle für Computer Vision im Laufe der Zeit verhalten. Das unterstützt einen strukturierteren Workflow für den Betrieb maschinellen Lernens (MLOps).
Die Seite „Deploy“ enthält ein Dashboard, das wichtige Kennzahlen wie die Gesamtzahl der Anfragen, aktive Bereitstellungen, Antwortlatenz und Fehlerraten erfasst. Diese Einblicke helfen Teams, Nutzungsmuster zu verstehen, die Reaktionsfähigkeit des Systems zu bewerten und bei unterschiedlichen Auslastungen eine geringe Latenz sicherzustellen.
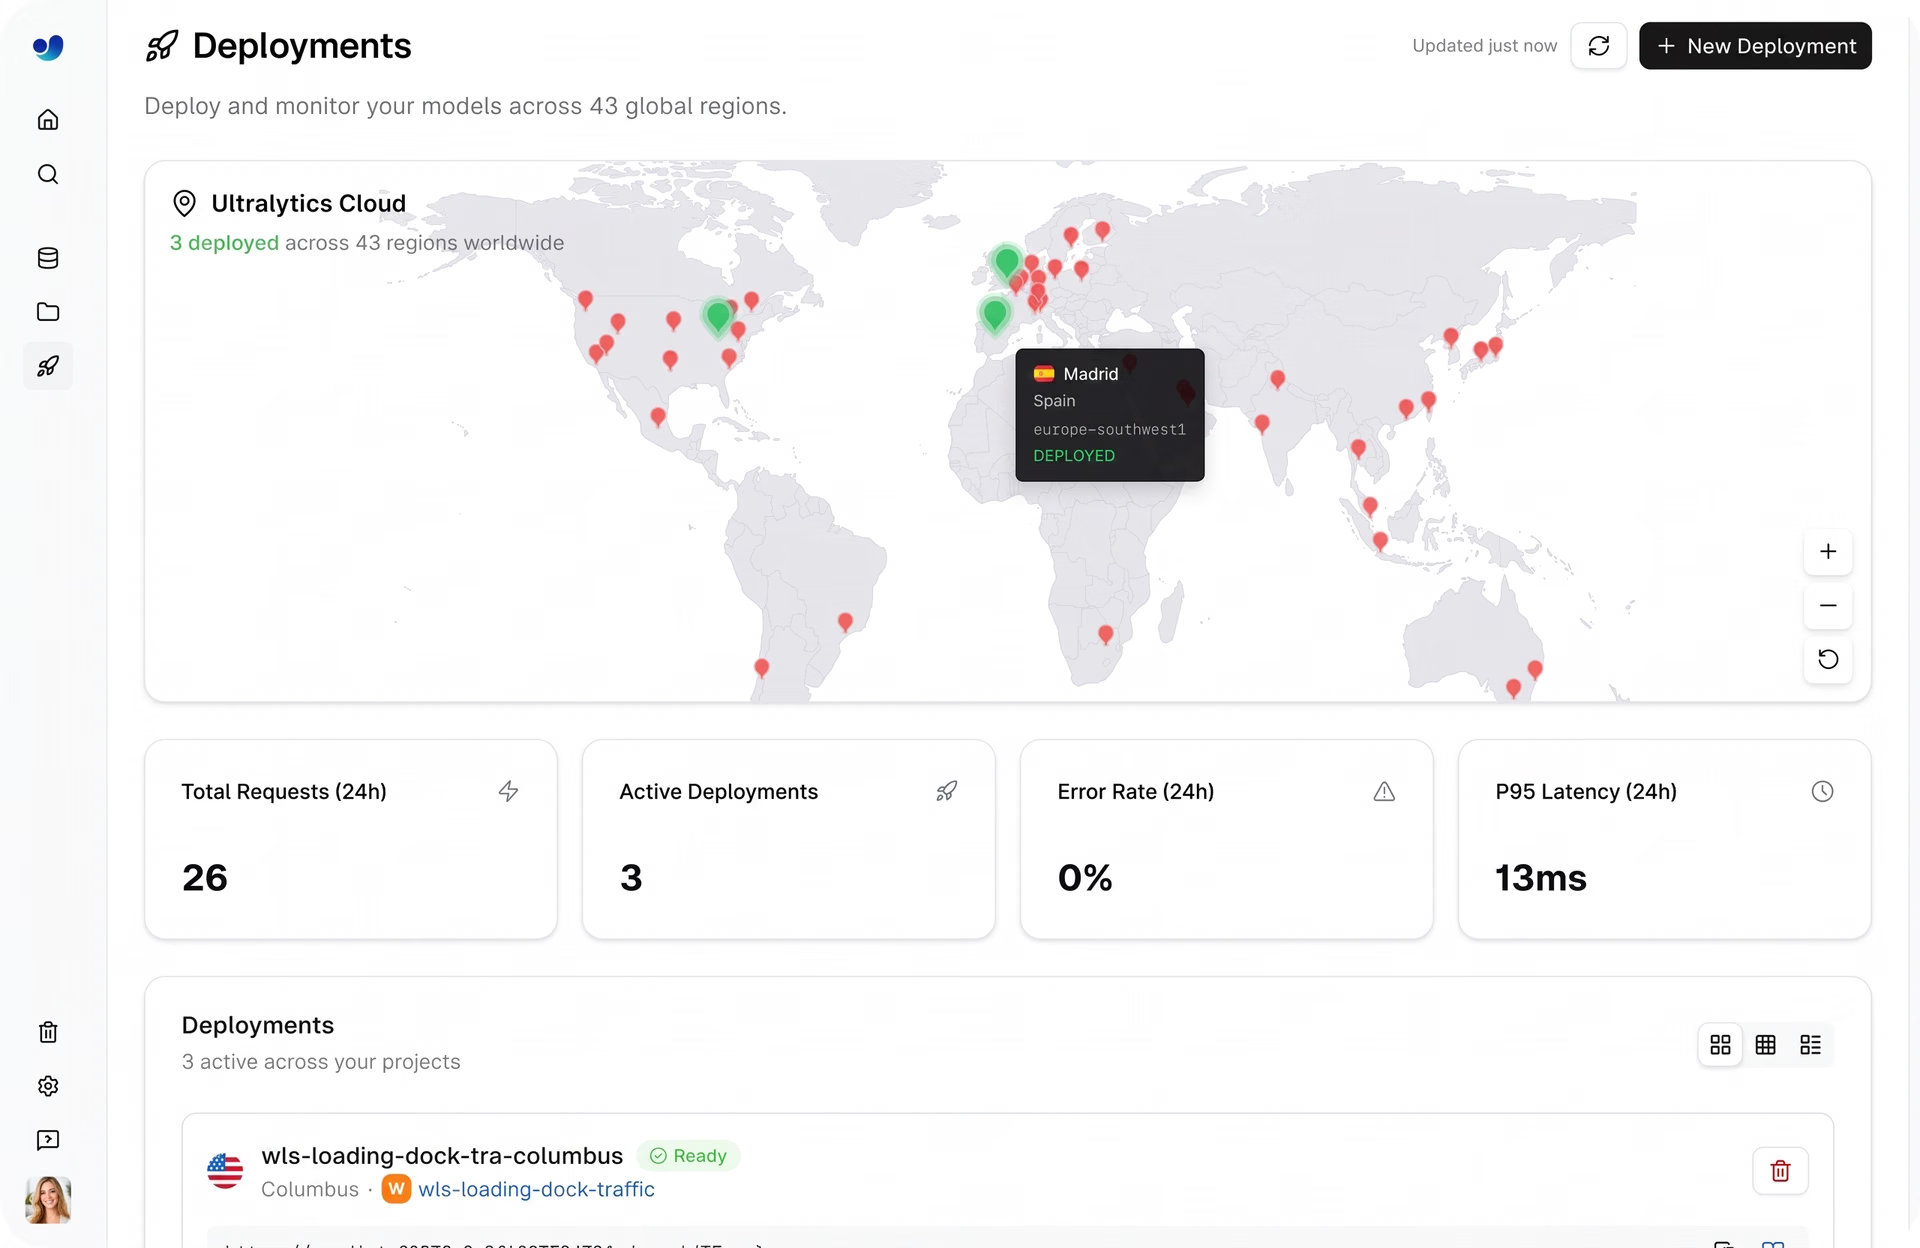
Abb. 5: Mit der Ultralytics Platform lassen sich bereitgestellte Modelle einfach überwachen. (Quelle)
Jeder dedizierte Endpunkt bietet außerdem detaillierte Einblicke in die Beobachtbarkeit über individuelle Ansichten der Bereitstellung. Dazu gehören der Zugriff auf Protokolle, der Zustand des Modells und Leistungsdaten in Echtzeit. Protokolle helfen dabei, Probleme zu beheben, fehlgeschlagene Anfragen zurückzuverfolgen und potenzielle Schwierigkeiten mit Abhängigkeiten oder der Infrastruktur zu erkennen.
Mit der Weiterentwicklung von Produktivumgebungen können sich verändernde Eingabedaten, Skalierungsanforderungen oder wechselnde Nutzungsmuster die Genauigkeit und Robustheit eines Modells beeinträchtigen. Durch die kontinuierliche Überwachung von Leistungskennzahlen können Teams Anomalien und Engpässe erkennen und Korrekturmaßnahmen ergreifen, etwa das Modell optimieren oder Ressourcen anpassen. So bleibt die Modellbereitstellung konstant und zuverlässig.
Skalierbarkeit bei der Bereitstellung von Computer-Vision-Modellen einplanen#
Die Skalierung von Computer-Vision-Systemen bedeutete traditionell, Workflows und Frameworks miteinander zu verbinden, die nie für ein Zusammenspiel ausgelegt waren. Datenpipelines, Trainingsschleifen, Bereitstellungsinfrastruktur und Überwachungssysteme sind oft voneinander getrennt. Das sorgt in jeder Phase für Reibungsverluste.
Die eigentliche Herausforderung besteht nicht nur darin, Modelle zu entwickeln, sondern auch darin, sie voranzubringen: von den Daten bis zum Produktivbetrieb, durch die Anpassung an neue Eingaben, den Umgang mit steigender Nachfrage und kontinuierliche Verbesserungen, ohne den Ablauf zu verlangsamen.
Das Besondere an der Ultralytics Platform ist, dass diese Bewegung bereits integriert ist. Statt jede Phase als separaten Schritt zu behandeln, verbindet sie die Phasen zu einem kontinuierlichen Kreislauf, in dem Modelle in derselben Umgebung entwickelt, bereitgestellt, beobachtet und aktualisiert werden können.
Das verändert die Art und Weise, wie Teams skalieren. Es geht nicht mehr darum, Tools oder Infrastruktur zu orchestrieren, sondern darum, den Schwung bei wachsenden Systemen aufrechtzuerhalten.
Die wichtigsten Erkenntnisse#
Damit Modelle für maschinelles Lernen wie Computer-Vision-Modelle in realen Anwendungen eingesetzt werden können, müssen sie zuverlässig, skalierbar und einfach zu verwalten sein. Die Ultralytics Platform vereinfacht diesen Prozess, indem sie verschiedene Funktionen wie Modellbereitstellung, Deployment und Überwachung in einer einheitlichen Umgebung vereint. Mit flexiblen Bereitstellungsoptionen und integrierten Tools können Teams schneller und mit weniger Komplexität vom Experimentieren zum Produktivbetrieb wechseln.
Besuche unsere Community und sieh dir unser GitHub-Repository an, um mehr zu erfahren. Auf unseren Lösungsseiten findest du verschiedene Anwendungsbereiche, etwa KI im Gesundheitswesen und Computer Vision in der Logistik. Entdecke unsere Lizenzoptionen und leg noch heute mit der Entwicklung los!
Verfasst von
Content Creator · Ultralytics
Kommentare
Stelle eine Frage, teile deine Ergebnisse oder hilf anderen.









