Análisis de la ficha del modelo Claude 3: qué implica para la IA visual
Descubre la ficha del modelo Claude 3 de Anthropic: cómo rinden Opus, Sonnet y Haiku en los benchmarks de visión y en qué aspectos se quedan cortos para las tareas de visión artificial.
 Mostafa Ibrahim8 min de lectura
En los últimos años, la IA visual ha avanzado considerablemente y ha transformado sectores que van desde la sanidad hasta el comercio minorista. Comprender los modelos subyacentes y su documentación es fundamental para aprovechar estos avances de forma eficaz. Una herramienta esencial para los desarrolladores de IA es la ficha del modelo, que ofrece una descripción completa de las características y el rendimiento de un modelo de IA.
En este artículo analizaremos la ficha del modelo Claude 3, desarrollado por Anthropic, y sus implicaciones para el desarrollo de IA visual. Claude 3 es una nueva familia de modelos multimodales de gran tamaño que consta de tres variantes: Claude 3 Opus, el modelo más capaz; Claude 3 Sonnet, que equilibra rendimiento y velocidad; y Claude 3 Haiku, la opción más rápida y rentable. Todos los modelos incorporan nuevas capacidades visuales que les permiten procesar y analizar datos de imágenes.
Descripción general de la ficha del modelo Claude 3#
¿Qué es exactamente una ficha del modelo? Es un documento detallado que ofrece información sobre el desarrollo, el entrenamiento y la evaluación de un modelo de aprendizaje automático. Su objetivo es fomentar la transparencia, la responsabilidad y el uso ético de la IA mediante información clara sobre la funcionalidad del modelo, los casos de uso previstos y sus posibles limitaciones. Para ello, proporciona datos detallados sobre el modelo, como los resultados de su evaluación y su comparación con modelos anteriores y con los de la competencia.
Métricas de evaluación#
Las métricas de evaluación son fundamentales para valorar el rendimiento de un modelo. La ficha del modelo Claude 3 presenta puntuaciones en pruebas de referencia estándar del sector, que ofrecen una visión clara de sus puntos fuertes y de los aspectos que puede mejorar. Estas puntuaciones se comparan con las de otros modelos destacados y muestran el rendimiento competitivo de Claude 3.
Además, Claude 3 se basa en los puntos fuertes de sus predecesores e incorpora avances en arquitectura y técnicas de entrenamiento. La ficha del modelo compara Claude 3 con versiones anteriores y destaca mejoras en exactitud, eficiencia y aplicabilidad a nuevos casos de uso.
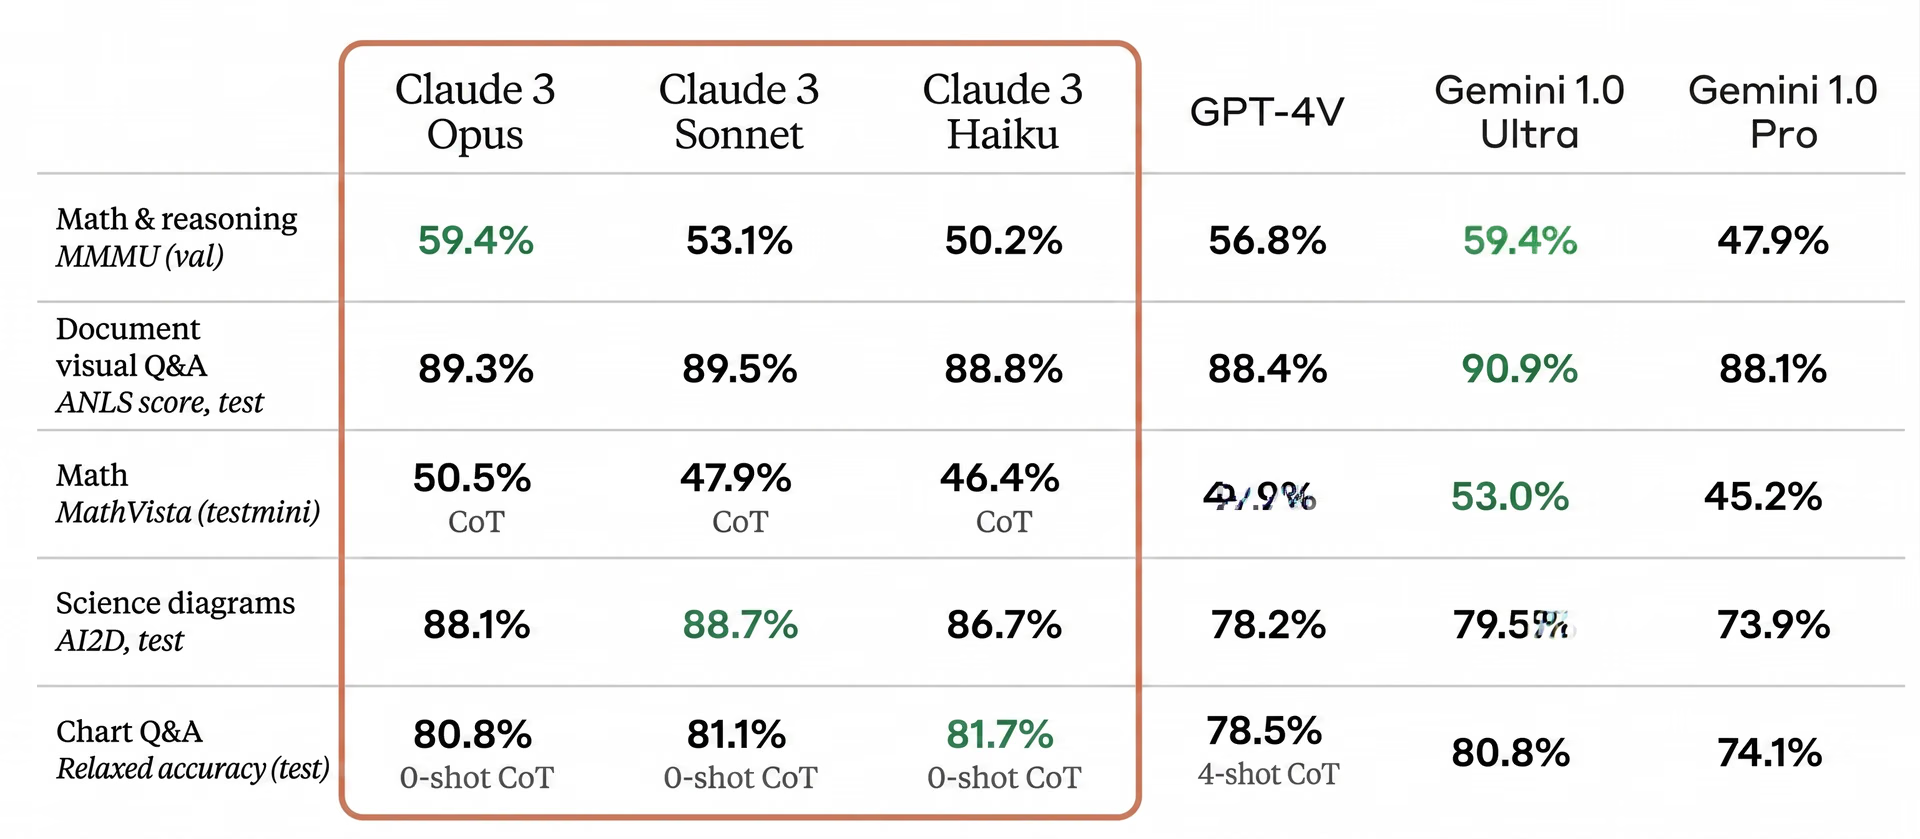
Fig. 1. Tabla que compara los modelos Claude 3 con otros modelos en diversas tareas.
¿Cómo influye Claude 3 en el desarrollo de la IA visual?#
La arquitectura y el proceso de entrenamiento de Claude 3 permiten obtener un rendimiento fiable en diversas tareas de procesamiento del lenguaje natural (NLP) y tareas visuales. El modelo logra resultados sólidos de forma constante en las pruebas de referencia, lo que demuestra su capacidad para realizar análisis lingüísticos complejos con eficacia.
El entrenamiento de Claude 3 con diversos conjuntos de datos garantiza su solidez y su capacidad para generalizar en distintos escenarios. Esto hace que el modelo sea versátil y eficaz en una amplia variedad de aplicaciones.
Aunque sus resultados son notables, Claude 3 es, en esencia, un modelo de lenguaje grande (LLM). Aunque los LLM como Claude 3 pueden realizar diversas tareas de visión artificial, no se diseñaron específicamente para tareas como la detección de objetos, la creación de cuadros delimitadores y la segmentación de imágenes. Por ello, su precisión en estos ámbitos puede no estar a la altura de la de modelos creados específicamente para la visión artificial, como Ultralytics YOLOv8. No obstante, los LLM destacan en otros ámbitos, especialmente en el procesamiento del lenguaje natural (NLP), donde Claude 3 demuestra una gran capacidad al combinar tareas visuales sencillas con el razonamiento humano.
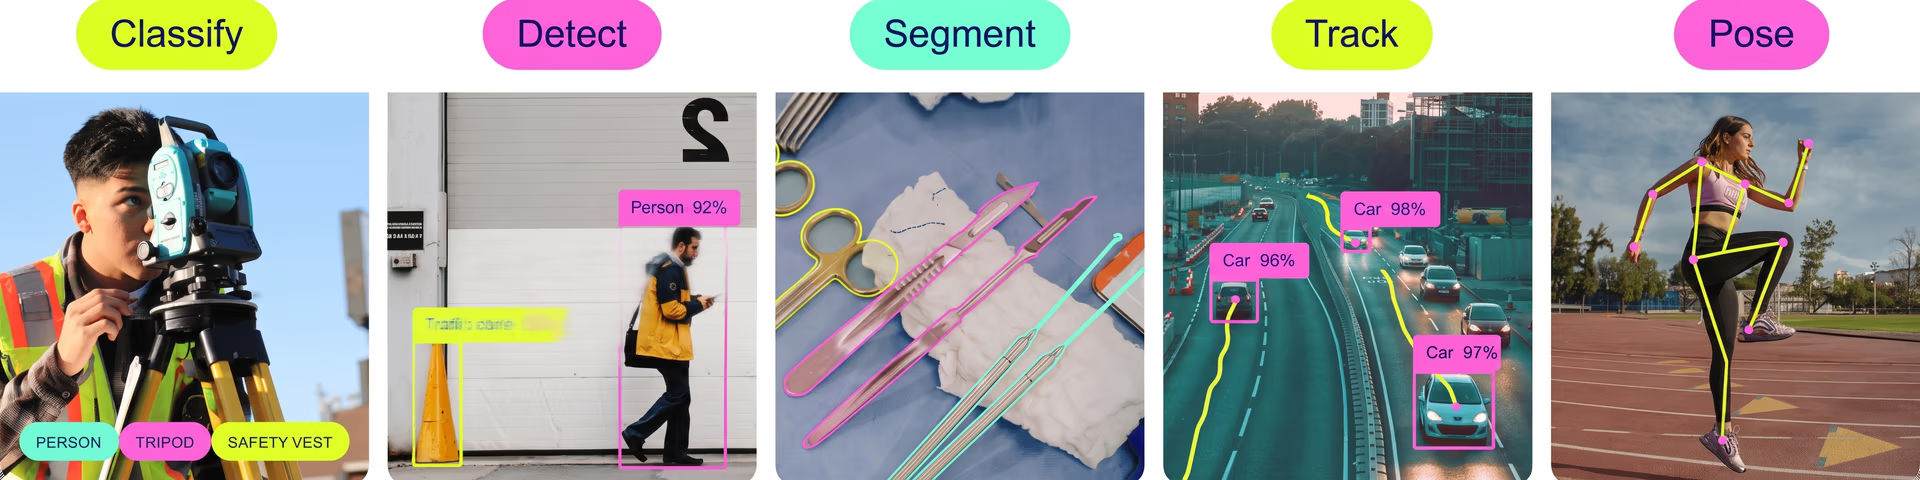
Fig. 2. Descripción general de la clasificación, detección, segmentación y seguimiento de objetos, y de la estimación de poses con Ultralytics YOLOv8.
Las capacidades de NLP se refieren a la capacidad de un modelo de IA para comprender el lenguaje humano y responder a él. Claude 3 aprovecha ampliamente esta capacidad en sus aplicaciones del ámbito visual, lo que le permite ofrecer descripciones ricas en contexto, interpretar datos visuales complejos y mejorar el rendimiento general en tareas de IA visual.
Conversión de imágenes a texto#
Una de las impresionantes capacidades de Claude 3, especialmente en tareas de IA visual, es procesar imágenes de baja calidad con escritura difícil de leer y convertirlas en texto. Esta función demuestra la avanzada potencia de procesamiento y las capacidades de razonamiento multimodal del modelo. En esta sección veremos cómo realiza Claude 3 esta tarea y analizaremos los mecanismos subyacentes y sus implicaciones para el desarrollo de la IA visual.
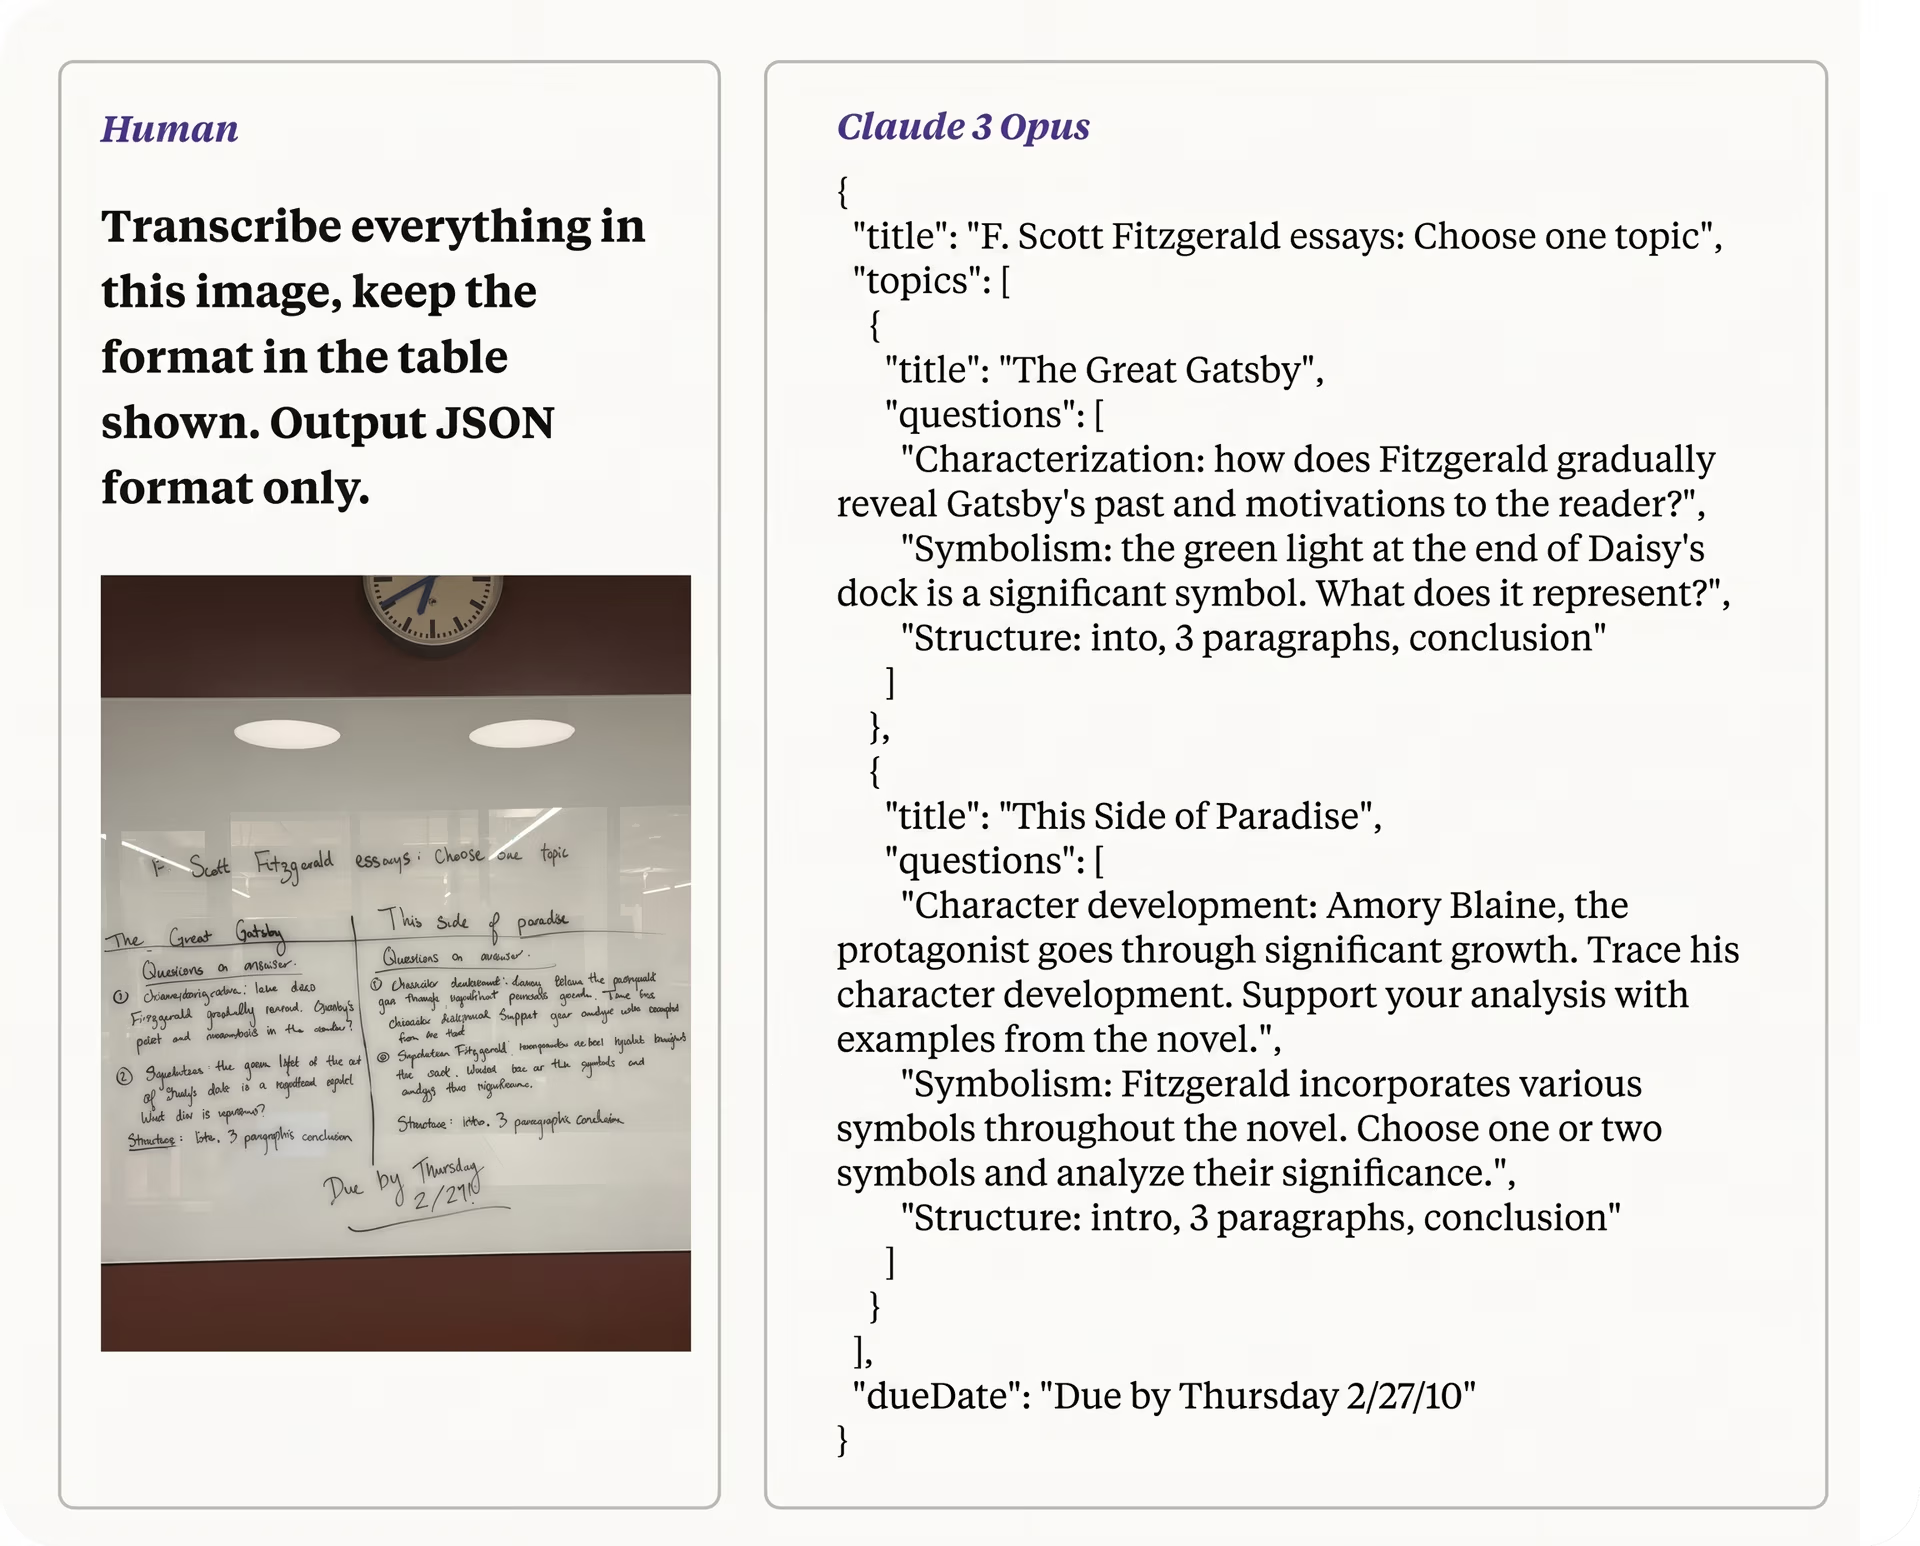
Fig. 3. Claude 3 Opus convierte en texto una foto de baja calidad con escritura difícil de leer.
Entender el desafío#
Convertir en texto una foto de baja calidad con escritura difícil de leer es una tarea compleja que presenta varios desafíos:
- Calidad de imagen: una resolución baja, el ruido y una iluminación deficiente pueden ocultar detalles de la imagen.
- Variabilidad de la escritura: los estilos de escritura varían mucho de una persona a otra, lo que dificulta que los modelos reconozcan e interpreten el texto.
- Comprensión del contexto: convertir correctamente la escritura en texto requiere entender el contexto para resolver las ambigüedades.
Como se ha mencionado, los modelos Claude 3 abordan estos desafíos combinando técnicas avanzadas de visión artificial y procesamiento del lenguaje natural (NLP).
Razonamiento visual (multimodal)#
La arquitectura de Claude 3 le permite realizar tareas de razonamiento complejas a partir de entradas visuales. Por ejemplo, como se muestra en la Fig. 4, el modelo puede interpretar gráficos y diagramas, por ejemplo, identificar los países del G7 en un gráfico sobre el uso de Internet, extraer datos relevantes y realizar cálculos para analizar tendencias. Este razonamiento en varios pasos, como calcular las diferencias estadísticas en el uso de Internet entre grupos de edad, mejora la precisión y la utilidad del modelo en aplicaciones del mundo real.
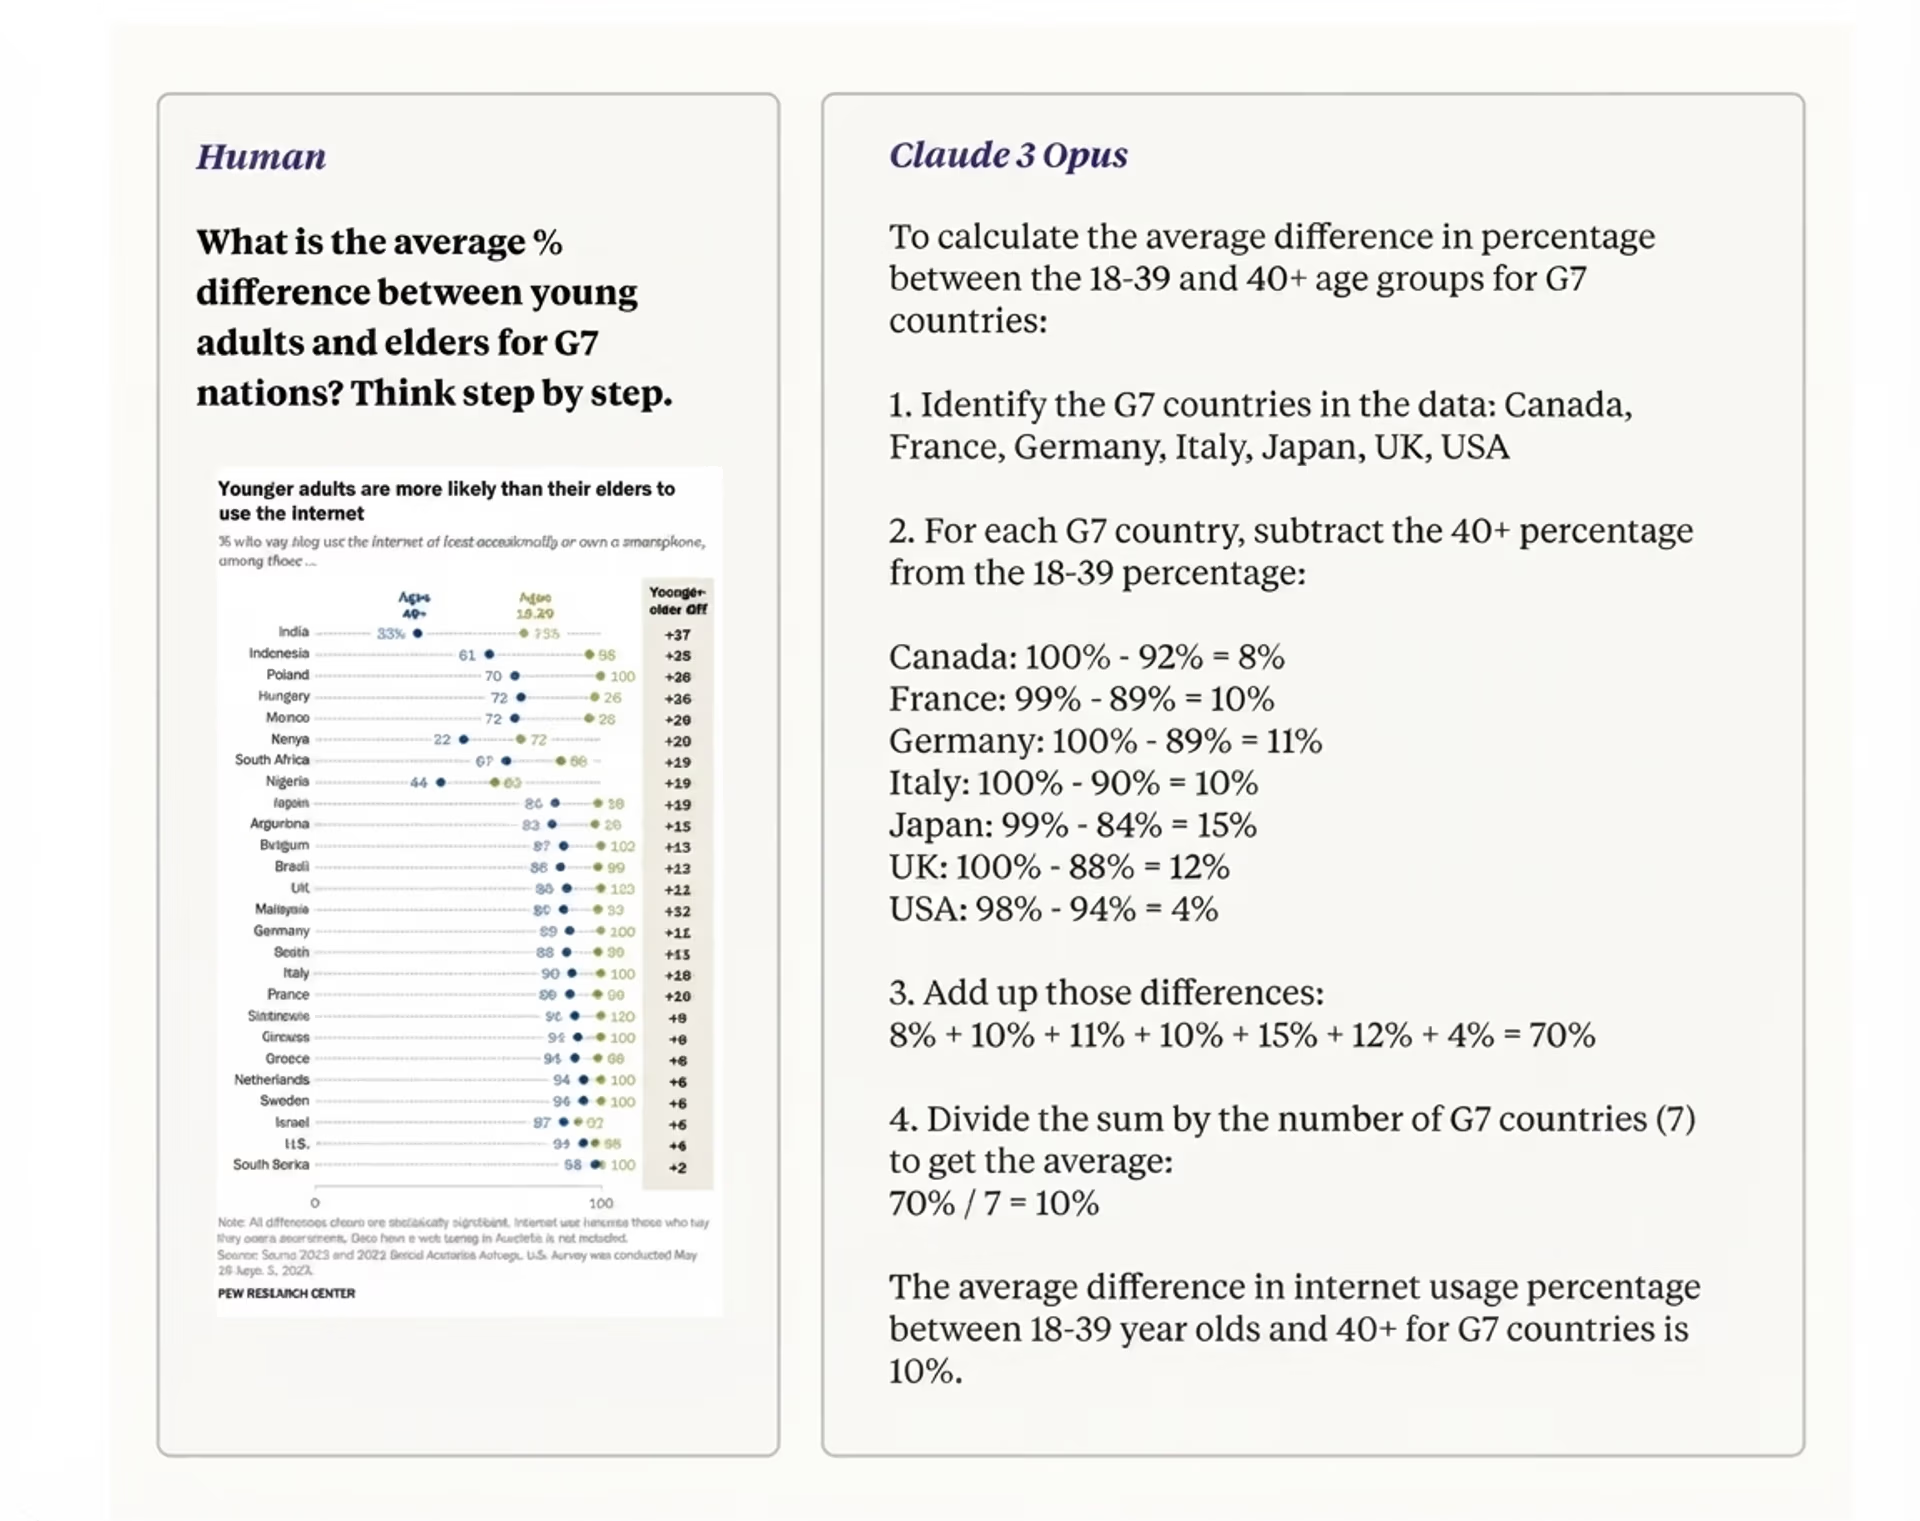
Fig. 4. Claude 3 Opus realiza tareas de razonamiento múltiple sobre un gráfico visual.
Describir imágenes#
Claude 3 destaca por transformar imágenes en descripciones detalladas, lo que demuestra sus potentes capacidades tanto en visión artificial como en procesamiento del lenguaje natural. Puede generar descripciones precisas y ricas en contexto, ya que no solo identifica objetos, sino que también comprende sus interacciones y su importancia dentro de la escena.
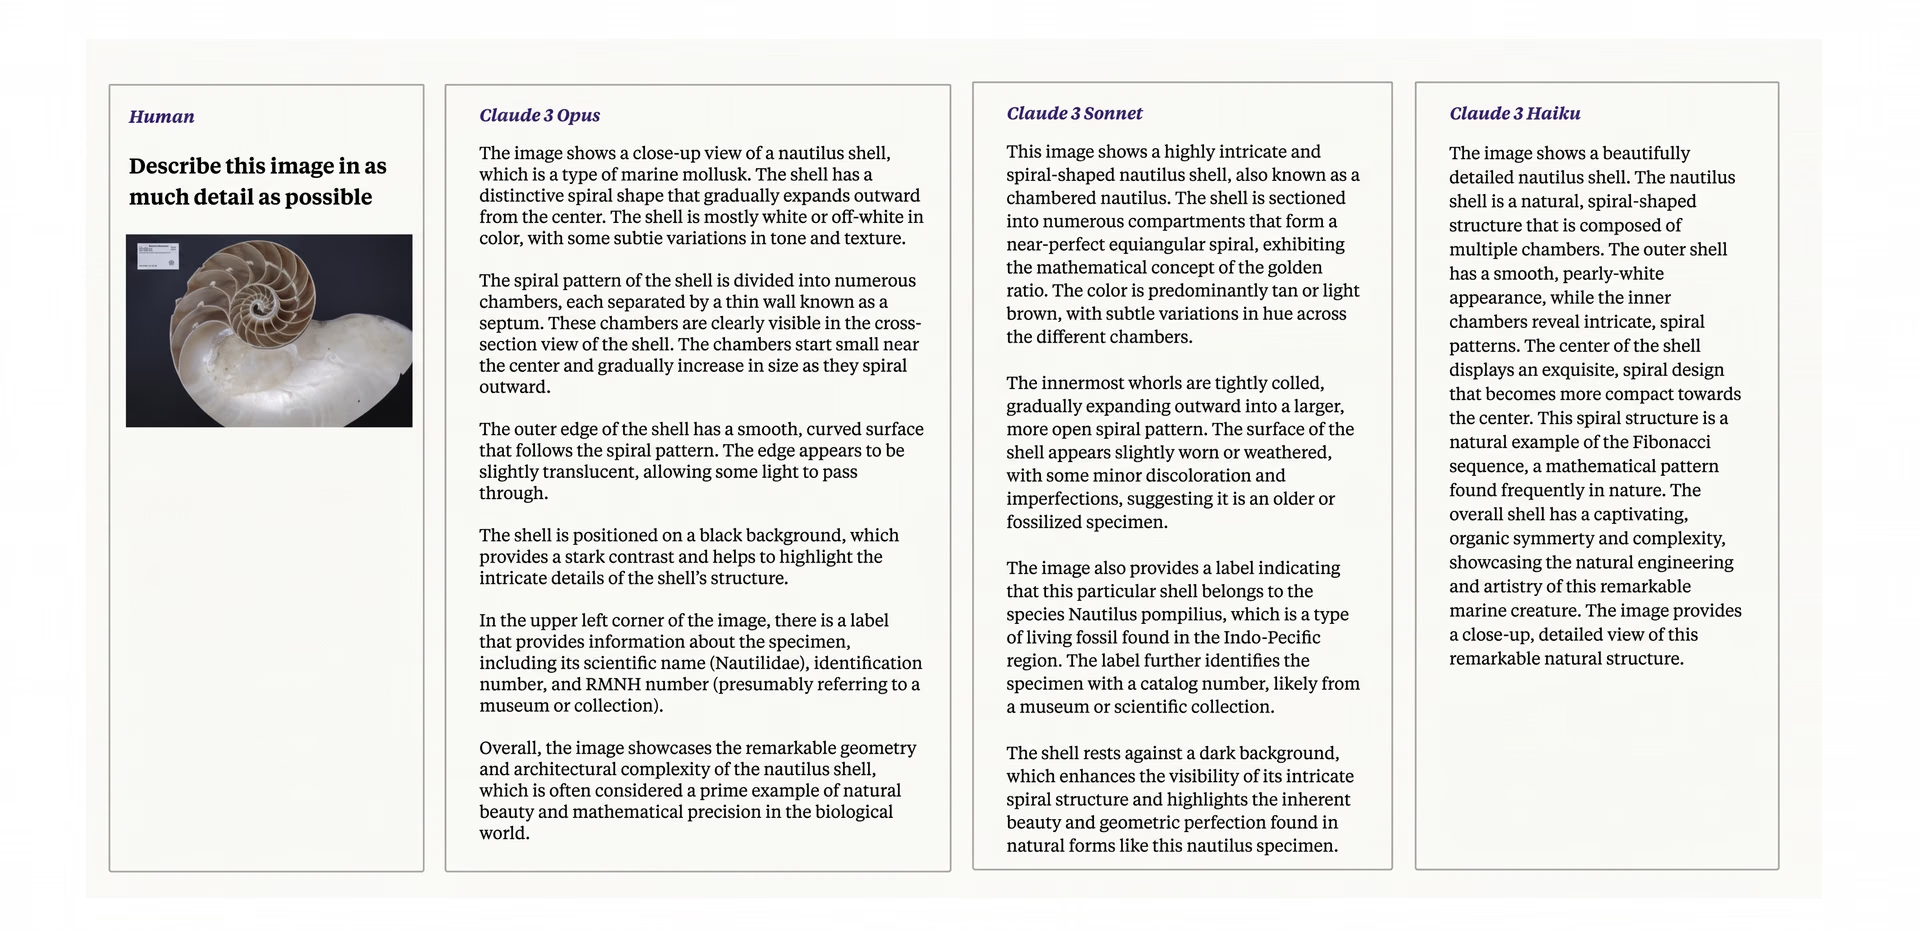
Fig. 5. Los modelos Claude 3 comprenden los objetos visuales de una imagen y los describen en un lenguaje comprensible para las personas.
Desafíos y limitaciones de los modelos Claude 3 en visión artificial#
No está orientado a la visión artificial#
Los modelos de lenguaje grandes (LLM), como Claude 3, destacan en el procesamiento del lenguaje natural, no en la visión artificial. Aunque pueden describir imágenes, las tareas de detección de objetos y segmentación de imágenes se resuelven mejor con modelos orientados a la visión, como Ultralytics YOLOv8. Estos modelos especializados están optimizados para tareas visuales y ofrecen un mejor rendimiento al analizar imágenes. Además, Claude 3 no puede realizar tareas como crear cuadros delimitadores.
Complejidad de la integración#
Combinar Claude 3 con sistemas de visión artificial puede ser complejo y requerir pasos de procesamiento adicionales para cerrar la brecha entre los datos textuales y los visuales.
Limitaciones de los datos de entrenamiento#
Claude 3 se entrena principalmente con grandes cantidades de datos textuales, lo que significa que carece de los extensos conjuntos de datos visuales necesarios para alcanzar un alto rendimiento en tareas de visión artificial. Por ello, aunque Claude 3 destaca en la comprensión y generación de texto, no puede procesar ni analizar imágenes con la misma eficacia que los modelos diseñados específicamente para datos visuales. Esta limitación reduce su eficacia en aplicaciones que requieren interpretar o generar contenido visual.
El potencial futuro de Claude 3 en la IA visual#
Al igual que otros modelos de lenguaje grandes, Claude 3 seguirá mejorando. Es probable que las mejoras futuras se centren en tareas visuales más avanzadas, como la detección de imágenes y el reconocimiento de objetos, así como en avances en tareas de procesamiento del lenguaje natural. Esto permitirá generar descripciones más precisas y detalladas de objetos y escenas, entre otras tareas similares. Los modelos Claude más recientes, como Claude Opus 5.5 y Claude Haiku 5.5, pueden detectar objetos con cajas delimitadoras, y los resultados de las pruebas de referencia de VLM muestran cómo se comparan con otros modelos de lenguaje y visión.
Por último, la investigación continua sobre Claude 3 dará prioridad a mejorar la interpretabilidad, reducir los sesgos y mejorar la generalización en diversos conjuntos de datos. Estos esfuerzos garantizarán el sólido rendimiento del modelo en distintas aplicaciones y fomentarán la confianza y la fiabilidad de sus resultados.
Reflexiones finales#
La ficha del modelo Claude 3 es un recurso valioso para desarrolladores y partes interesadas en la IA visual, ya que ofrece información detallada sobre la arquitectura, el rendimiento y las consideraciones éticas del modelo. Al promover la transparencia y la rendición de cuentas, contribuye a garantizar un uso responsable y eficaz de las tecnologías de IA. A medida que la IA visual siga evolucionando, las fichas de modelos como la de Claude 3 serán fundamentales para orientar el desarrollo y fomentar la confianza en los sistemas de IA.
En Ultralytics nos apasiona impulsar la tecnología de IA. Para descubrir nuestras soluciones de IA y estar al día de las últimas innovaciones, visita nuestro repositorio de GitHub. Únete a nuestra comunidad en Discord y descubre cómo estamos transformando sectores como la conducción autónoma y la fabricación.
Escrito por
Ingeniero de software y redactor técnico · Por cuenta propia
Comentarios
Haz una pregunta, comparte tus resultados o ayuda a otra persona.









