Florence-2: l’ultimo modello visivo-linguistico di Microsoft
Scopri Florence-2, il modello di visione e linguaggio di Microsoft per il rilevamento degli oggetti, la segmentazione, la generazione di didascalie e il grounding, con ottime prestazioni zero-shot.
 Abirami Vina9 min di lettura
Nel giugno 2024, Microsoft ha presentato Florence-2, un modello visione-linguaggio multimodale (VLM) progettato per gestire un’ampia gamma di attività, tra cui il rilevamento di oggetti, la segmentazione, la generazione di didascalie per immagini e il grounding. Florence-2 stabilisce un nuovo punto di riferimento per le prestazioni zero-shot: può cioè svolgere attività senza un addestramento specifico precedente e ha dimensioni inferiori rispetto ad altri modelli visione-linguaggio all’avanguardia.
Florence-2 è molto più di un semplice modello. La sua versatilità e le sue prestazioni migliorate potrebbero avere un impatto significativo su vari settori, aumentando la precisione e riducendo la necessità di un addestramento esteso. In questo articolo esamineremo le funzionalità principali di Florence-2, ne confronteremo le prestazioni con quelle di altri VLM e parleremo delle sue potenziali applicazioni.
Che cos'è Florence-2?#
Florence-2 può gestire diverse attività all’interno di un unico framework unificato. Le capacità del modello sono dovute in parte al suo ampio dataset di addestramento, chiamato FLD-5B. FLD-5B comprende 5,4 miliardi di annotazioni distribuite su 126 milioni di immagini. Questo dataset completo è stato creato appositamente per fornire a Florence-2 le capacità necessarie a gestire un’ampia gamma di attività di visione con elevata precisione ed efficienza.
Ecco più da vicino le attività supportate da Florence-2:
- Rilevamento degli oggetti: può identificare e localizzare gli oggetti nelle immagini con elevata precisione.
- Segmentazione: questa attività consiste nel suddividere un'immagine in segmenti significativi per facilitarne l'analisi e l'interpretazione.
- Generazione di didascalie per immagini: Florence-2 è in grado di generare didascalie descrittive per le immagini, fornendo contesto e dettagli.
- Grounding visivo: il modello può associare frasi o parole specifiche di una didascalia alle aree corrispondenti dell'immagine.
- Prestazioni zero-shot: può svolgere attività senza un addestramento specifico.
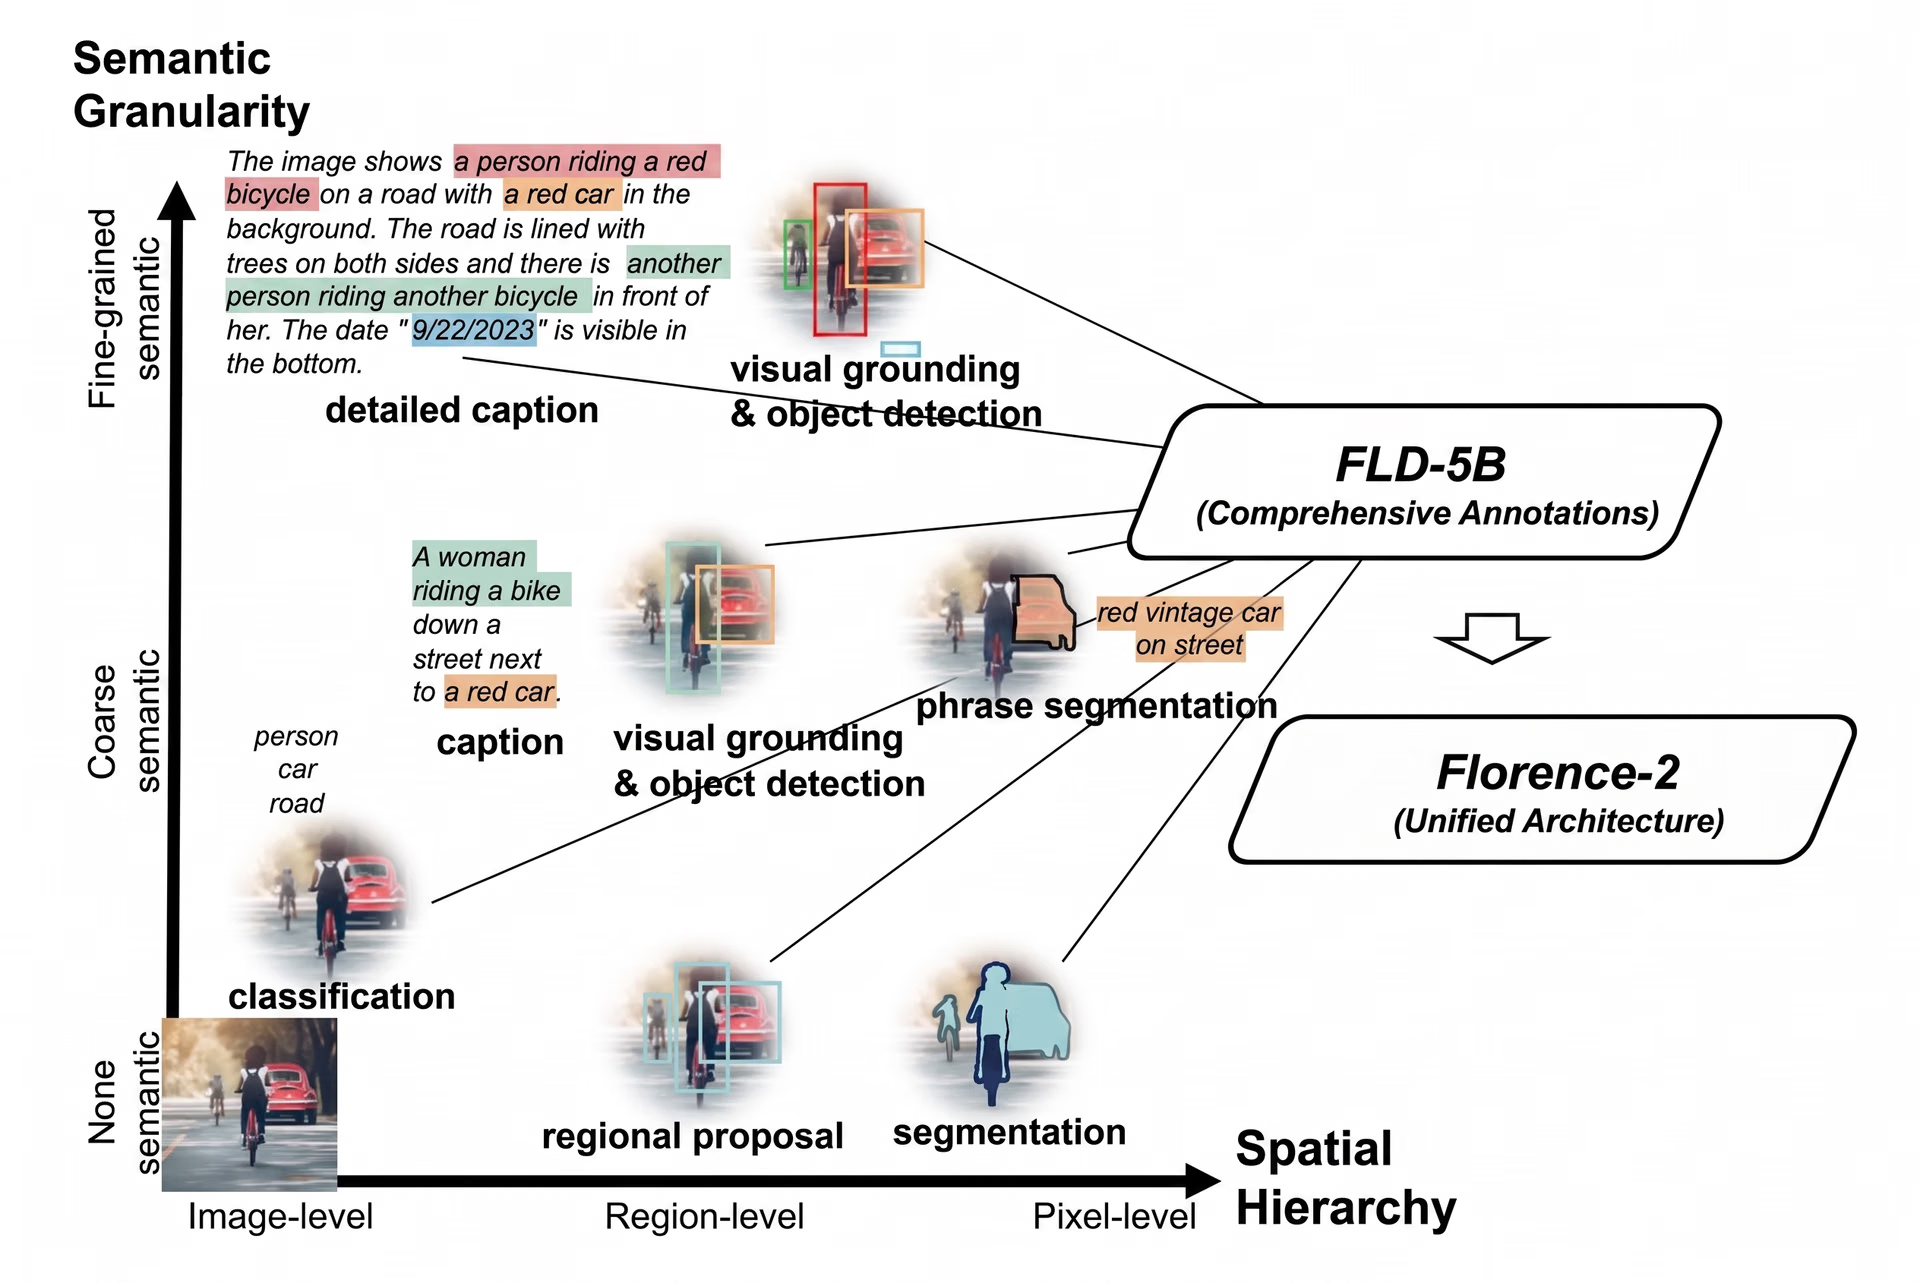
Fig. 1 Capire come è stato addestrato Florence-2.
Il modello supporta attività basate sia sul testo sia sulle regioni. Per le attività che riguardano regioni specifiche di un’immagine, al vocabolario del modello vengono aggiunti token di localizzazione speciali. Questi token aiutano il modello a comprendere forme diverse, come rettangoli intorno agli oggetti (rappresentazione con riquadri), forme a quattro lati (rappresentazione con riquadri quadrilateri) e forme con molti lati (rappresentazione con poligoni). Il modello viene addestrato con una funzione di perdita standard di entropia incrociata, che lo aiuta a imparare confrontando le predizioni con le risposte corrette e regolando di conseguenza i propri parametri interni.
Creazione del dataset FLD-5B#
Il dataset FLD-5B comprende diversi tipi di annotazioni: descrizioni testuali, coppie di regioni e testo e combinazioni di testo, frasi e regioni. È stato creato attraverso un processo in due fasi che comprendeva la raccolta e l’annotazione dei dati. Le immagini provengono da dataset popolari come ImageNet-22k, Objects365, Open Images, Conceptual Captions e LAION. Le annotazioni del dataset FLD-5B sono per lo più sintetiche, ovvero generate automaticamente e non etichettate manualmente.
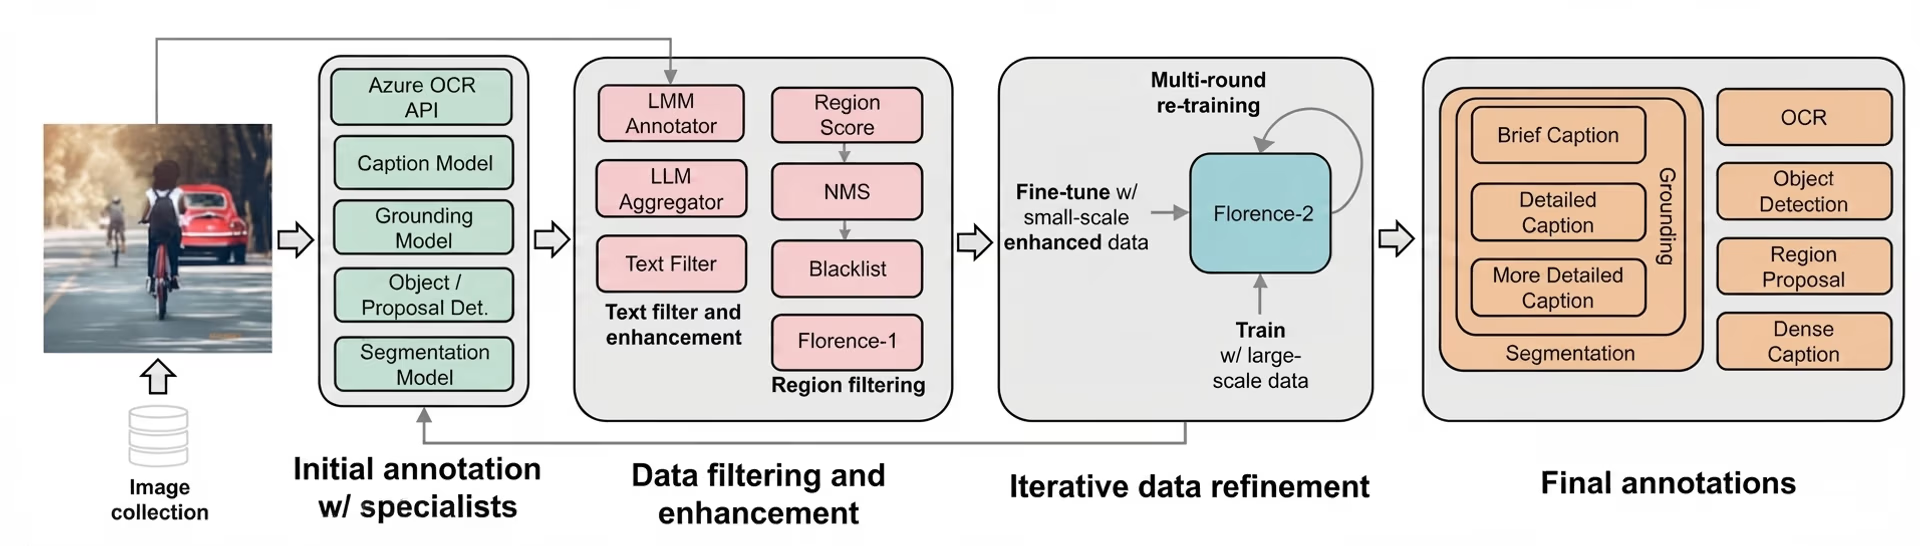
Fig. 2 Creazione del dataset FLD-5B.
Inizialmente, modelli specializzati in attività specifiche, come il rilevamento degli oggetti o la segmentazione, hanno creato queste annotazioni. In seguito, è stato utilizzato un processo di filtraggio e perfezionamento per assicurarsi che fossero dettagliate e accurate. Dopo aver rimosso eventuali dati rumorosi, il dataset è stato sottoposto a un perfezionamento iterativo, durante il quale gli output di Florence-2 sono stati usati per aggiornare e migliorare continuamente le annotazioni.
Comprendere l'architettura del modello Florence-2#
L'architettura del modello Florence-2 si basa su un approccio di apprendimento sequenza-sequenza. Ciò significa che il modello elabora una sequenza di input, come un'immagine accompagnata da un prompt testuale, e genera una sequenza di output, come una descrizione o un'etichetta, passo dopo passo. Nel framework sequenza-sequenza, ogni attività viene trattata come un problema di traduzione: il modello riceve un'immagine di input e un prompt specifico per l'attività e genera l'output corrispondente.
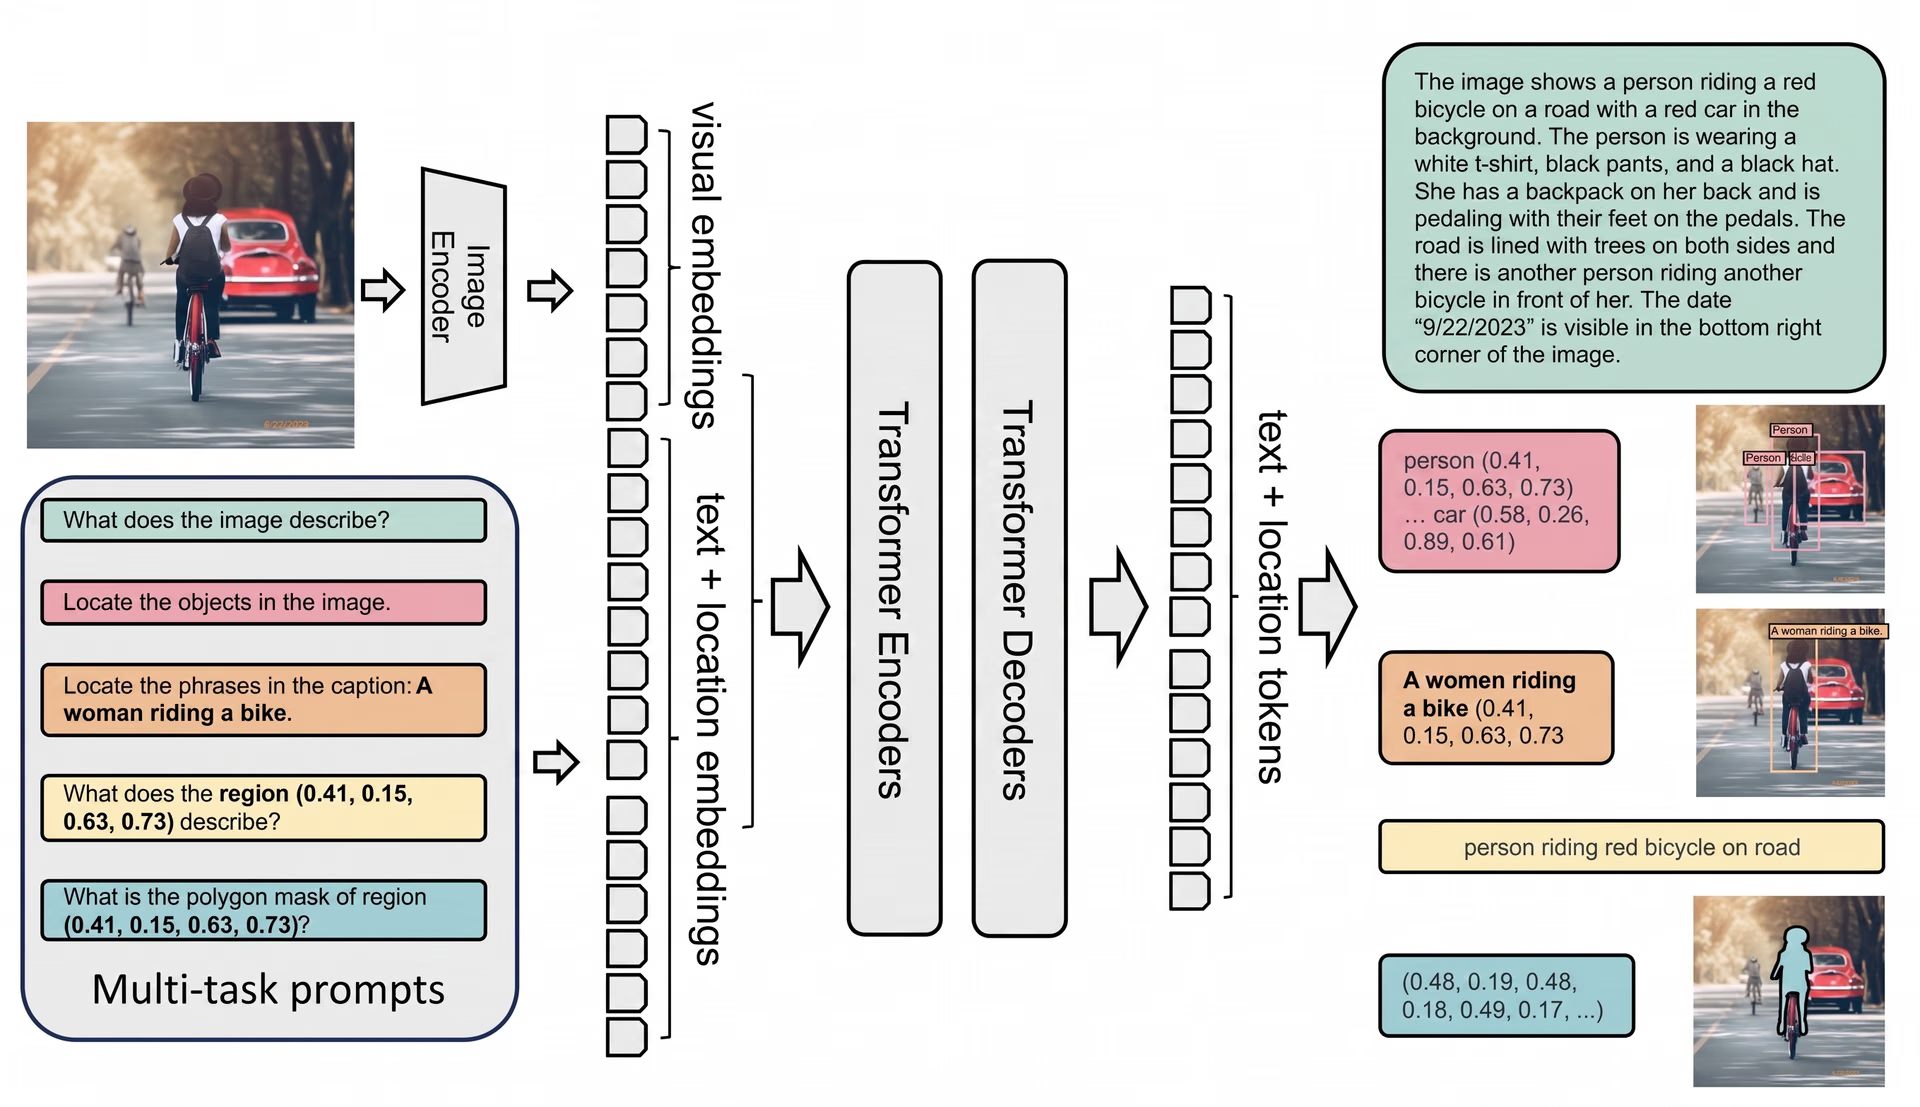
Fig. 3 Architettura del modello visione-linguaggio Florence-2.
Al centro dell'architettura del modello c'è un Transformer encoder-decoder multimodale, che combina un encoder di immagini e un encoder-decoder multimodale. L'encoder di immagini, chiamato DaViT (Dual Attention Vision Transformer), elabora le immagini di input convertendole in embedding di token visivi, rappresentazioni compatte dell'immagine che ne acquisiscono sia le informazioni spaziali (dove si trovano gli elementi) sia quelle semantiche (quali sono gli elementi). Questi token visivi vengono poi combinati con gli embedding di testo (rappresentazioni del testo), consentendo al modello di unire i dati testuali e visivi.
Confronto tra Florence-2 e altri VLM#
Florence-2 si distingue dagli altri modelli visione-linguaggio per le sue solide capacità zero-shot. A differenza di modelli come PaliGemma, che dipendono da un fine-tuning esteso per adattarsi a varie attività, Florence-2 funziona bene fin da subito. Inoltre, Florence-2 riesce a competere con modelli più grandi come GPT-4V e Flamingo, che spesso hanno molti più parametri ma non sempre eguagliano le prestazioni di Florence-2. Per esempio, Florence-2 ottiene risultati zero-shot migliori di Kosmos-2, pur avendo Kosmos-2 oltre il doppio dei parametri.
Nei test di benchmark, Florence-2 ha mostrato ottime prestazioni in attività come la generazione di didascalie sul dataset COCO e la comprensione delle espressioni di riferimento. Ha superato modelli come PolyFormer e UNINEXT nelle attività di rilevamento e segmentazione di oggetti sul dataset COCO. È una scelta molto competitiva per le applicazioni reali in cui prestazioni ed efficienza delle risorse sono entrambe fondamentali. Su Ultralytics Platform puoi annotare automaticamente i dataset di rilevamento con Florence-2 e confrontarlo con altri modelli visione-linguaggio nella classifica VLM.
Applicazioni di Florence-2#
Florence-2 può essere usato in molti settori diversi, come l'intrattenimento, l'accessibilità, l'istruzione e così via. Vediamo alcuni esempi per capirlo meglio.
Applicazioni della generazione di didascalie per immagini#
Quando ti trovi su una piattaforma di streaming e cerchi di decidere cosa guardare, potresti leggere la sinossi di un film per scegliere. E se la piattaforma potesse anche fornire una descrizione dettagliata della locandina? Florence-2 può renderlo possibile generando didascalie descrittive per le immagini. Florence-2 può generare descrizioni dettagliate delle locandine dei film, rendendo le piattaforme di streaming più inclusive per le persone con disabilità visive. Analizzando gli elementi visivi di una locandina, come personaggi, scenari e testo, Florence-2 può creare descrizioni dettagliate che ne comunicano il contenuto e l'atmosfera. L'immagine qui sotto mostra il livello di dettaglio che Florence-2 può fornire nella descrizione.
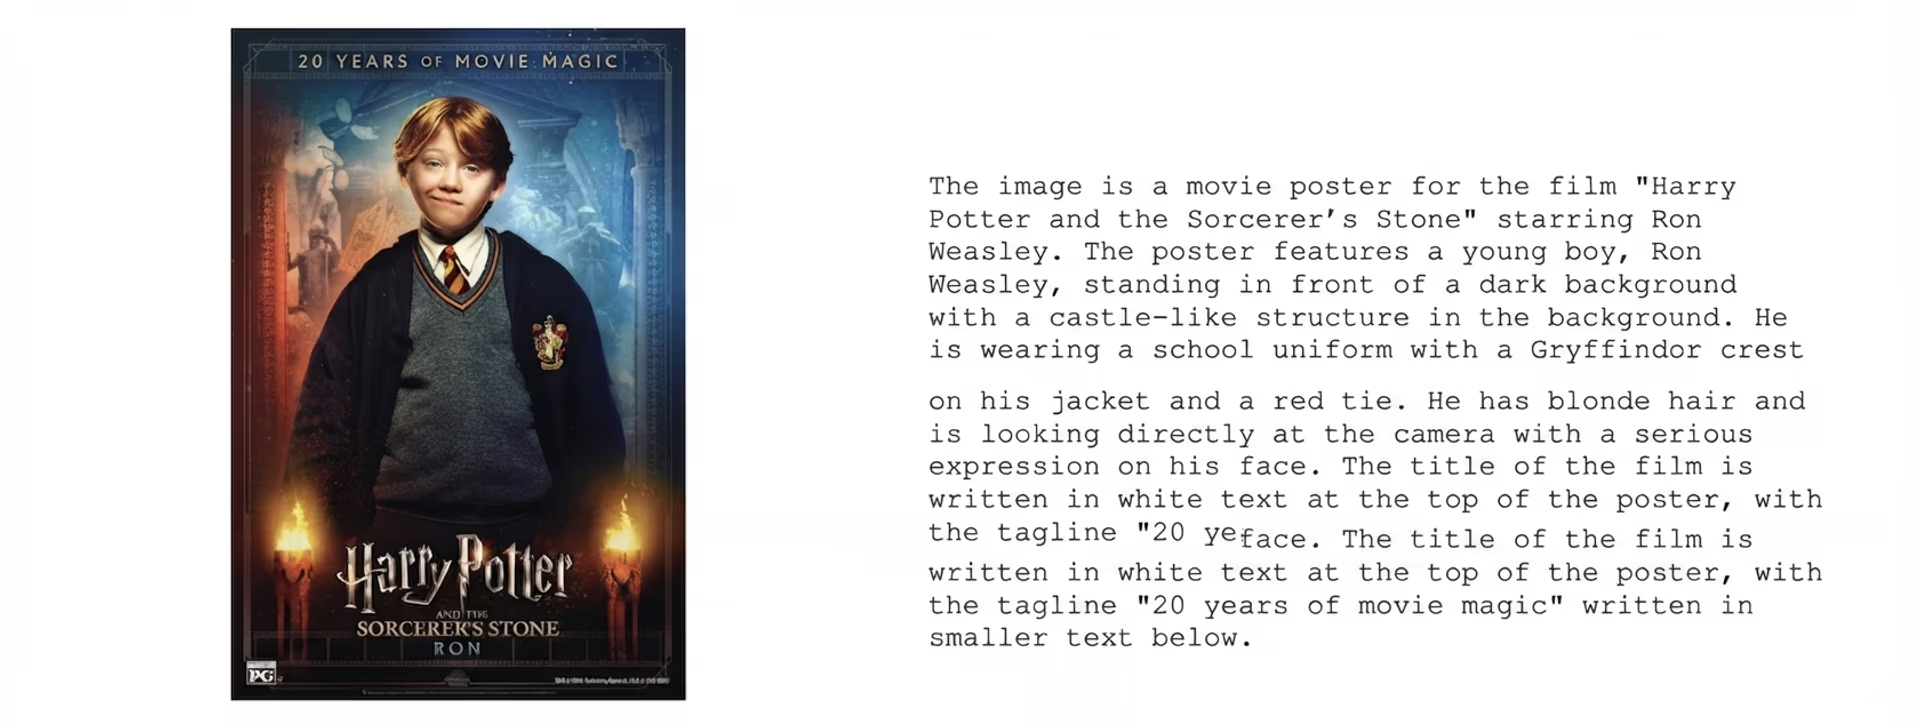
Fig. 4 Esempio di didascalia per un'immagine generata da Florence-2.
Ecco altri esempi di situazioni in cui le didascalie per immagini possono essere utili:
- E-commerce: la generazione di didascalie per immagini può fornire descrizioni dettagliate dei prodotti, aiutando i clienti a comprenderne meglio caratteristiche e dettagli.
- Viaggi e turismo: possono fornire descrizioni dettagliate di monumenti e attrazioni nelle guide e nelle app di viaggio.
- Istruzione: le didascalie per immagini possono etichettare e descrivere immagini e diagrammi didattici, facilitando l'insegnamento e l'apprendimento.
- Immobiliare: possono fornire descrizioni dettagliate delle immagini degli immobili, mettendone in risalto le caratteristiche e i servizi per i potenziali acquirenti.
Usare il grounding visivo mentre si cucina#
Florence-2 può essere utilizzato anche per arricchire le esperienze culinarie. Per esempio, un ricettario online potrebbe usare Florence-2 per applicare il grounding visivo e assegnare etichette alle parti di un'immagine complessa di una ricetta. Il grounding visivo è utile perché collega parti specifiche dell'immagine al testo descrittivo corrispondente. Ogni ingrediente e ogni passaggio possono essere etichettati e spiegati con precisione, rendendo più facile per chi cucina a casa seguire la ricetta e comprendere il ruolo di ciascun elemento nel piatto.
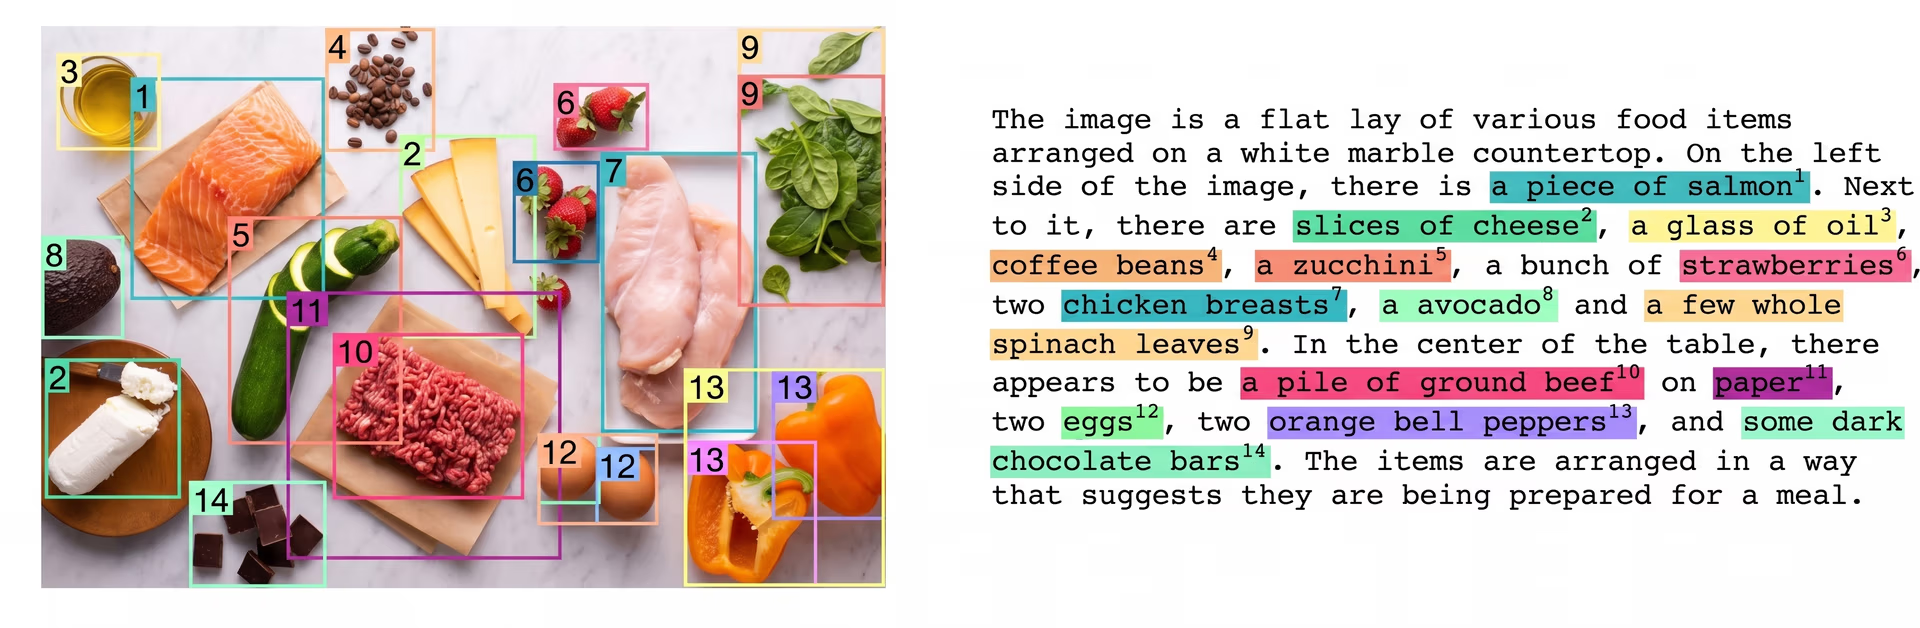
Fig. 5 Esempio di grounding visivo con Florence-2.
OCR basato su regioni per i documenti finanziari#
L'OCR con elaborazione basata su regioni, che si concentra sull'estrazione di testo da aree specifiche di un documento, può essere utile in ambiti come la contabilità. Le aree designate dei documenti finanziari possono essere analizzate per estrarre automaticamente informazioni importanti, come i dettagli delle transazioni, i numeri di conto e le scadenze. Riducendo la necessità di inserire i dati manualmente, si minimizzano gli errori e si velocizzano i tempi di elaborazione. Gli istituti finanziari possono usarlo per semplificare attività come l'elaborazione delle fatture, la riconciliazione delle ricevute e la compensazione degli assegni, velocizzando le transazioni e migliorando il servizio clienti.
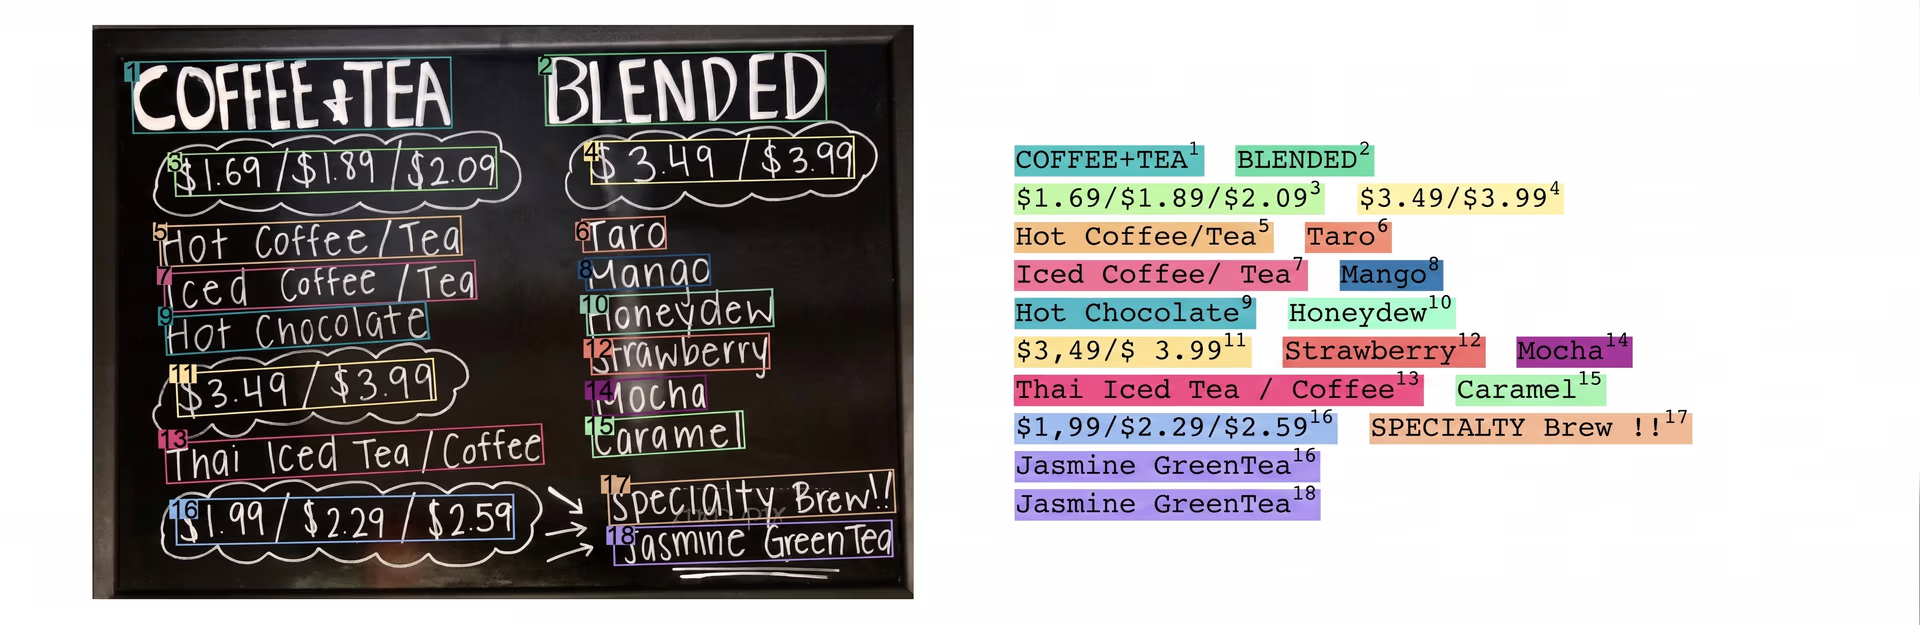
Fig. 6 Esempio di estrazione OCR basata su regioni con Florence-2.
Segmentazione basata su regioni nelle applicazioni industriali#
La segmentazione basata su regioni, che consiste nel suddividere un'immagine in parti significative per consentire un'analisi mirata e un'ispezione dettagliata, può alimentare le applicazioni industriali che migliorano la precisione e l'efficienza di vari processi. Concentrandosi su aree specifiche di un'immagine, questa tecnologia consente di ispezionare e analizzare in dettaglio componenti e prodotti. Nel controllo qualità, può identificare difetti o irregolarità nei materiali, come crepe o disallineamenti, assicurando che sul mercato arrivino solo prodotti di alta qualità.
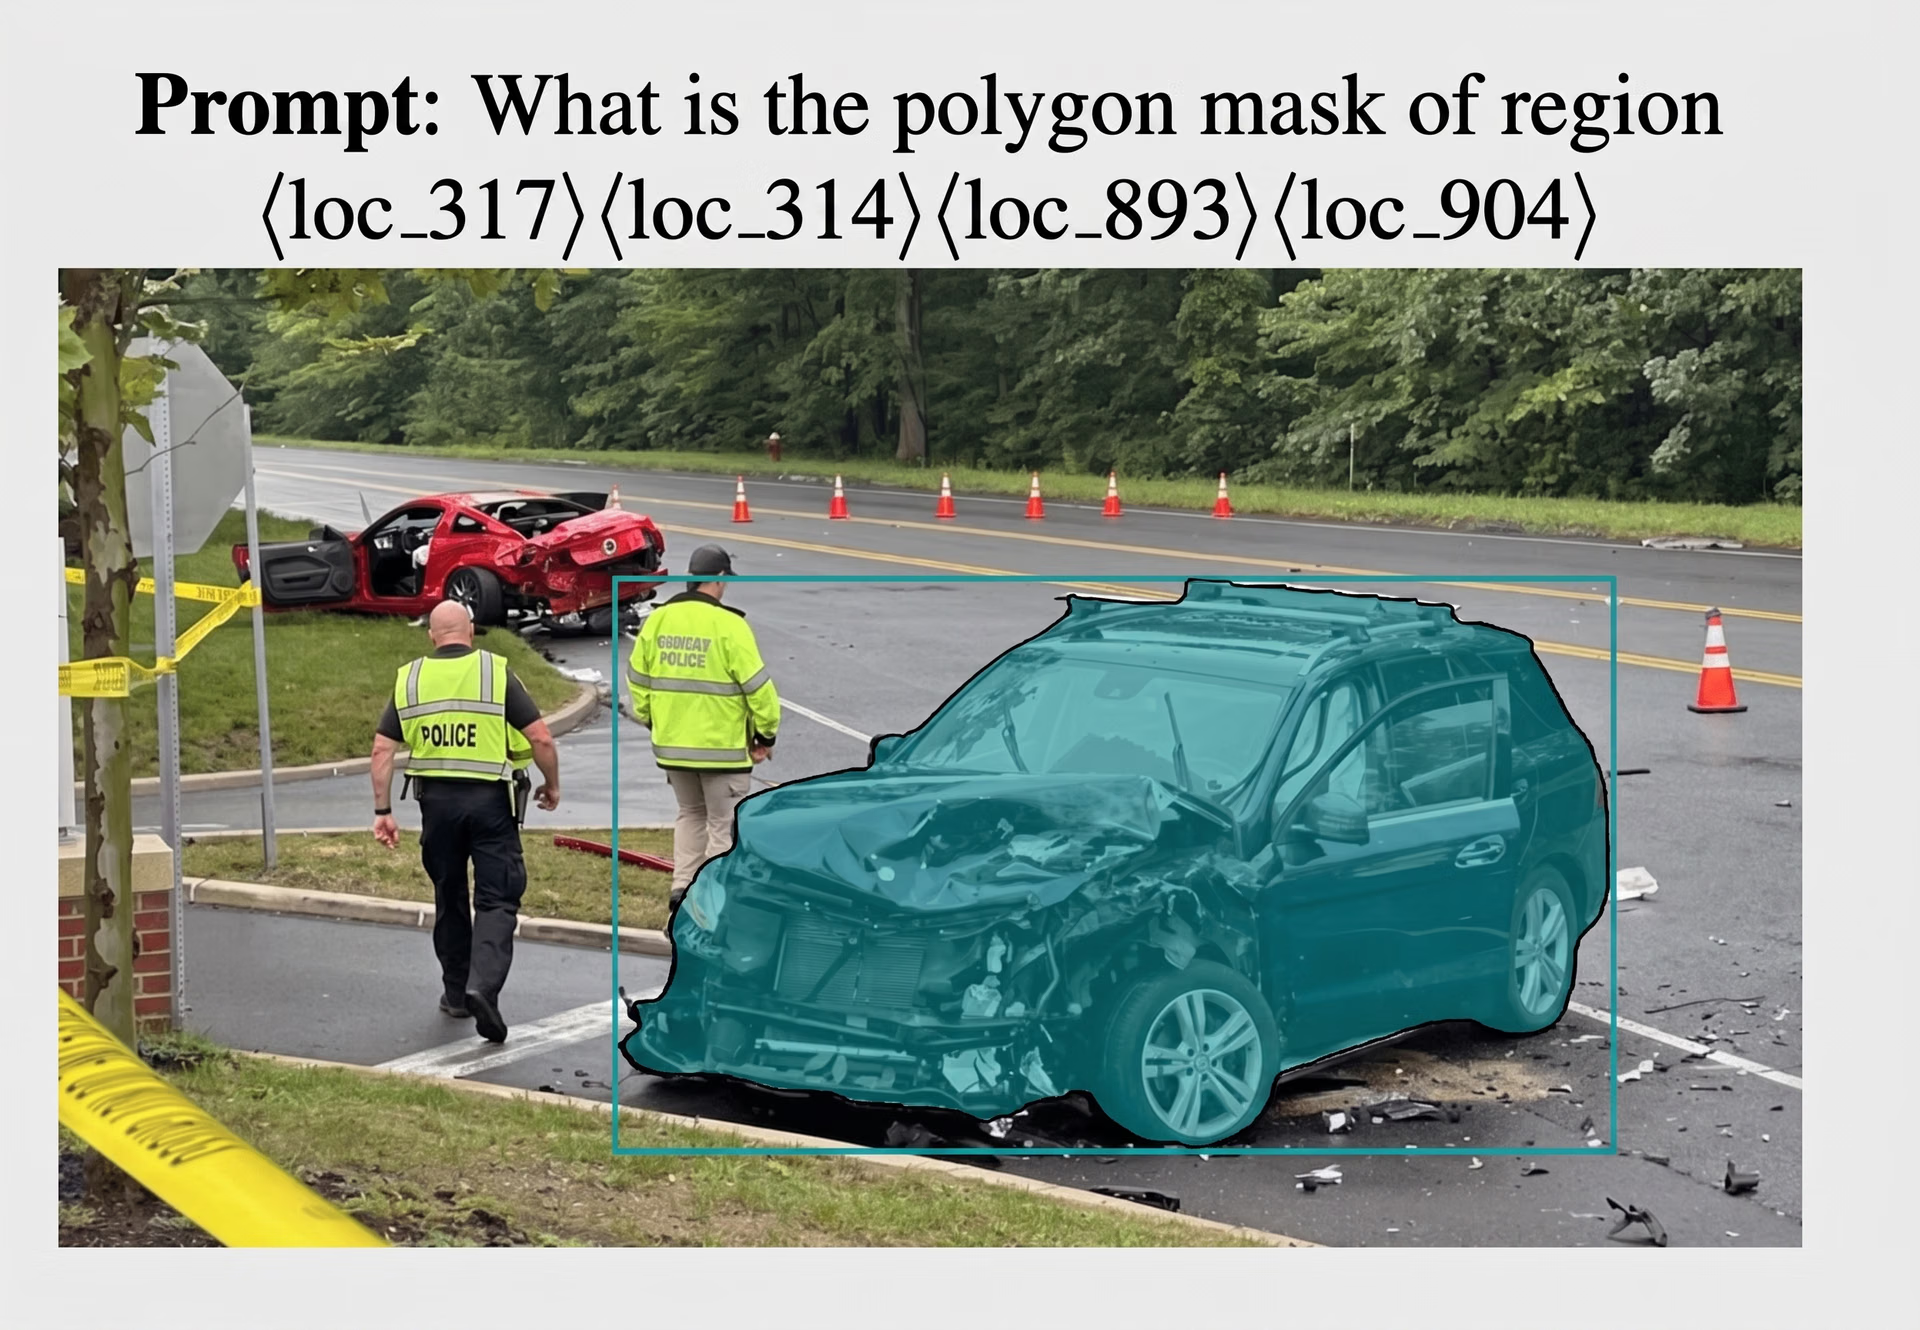
Fig. 7 Esempio di segmentazione basata su regioni con Florence-2.
Migliora anche le linee di assemblaggio automatizzate, guidando i bracci robotici verso parti specifiche e ottimizzando il posizionamento e l'assemblaggio dei componenti. Analogamente, nella gestione dell'inventario, aiuta a monitorare le condizioni e la posizione delle merci, rendendo la logistica più efficiente e riducendo i tempi di inattività. Nel complesso, la segmentazione basata su regioni aumenta la precisione e la produttività, consentendo di risparmiare sui costi e migliorare la qualità dei prodotti nei contesti industriali.
Punti chiave#
Stiamo assistendo a una tendenza: i modelli di AI diventano più leggeri pur mantenendo prestazioni elevate. Florence-2 rappresenta un importante passo avanti per i modelli visione-linguaggio. Può gestire diverse attività, come il rilevamento di oggetti, la segmentazione, la generazione di didascalie per immagini e il grounding, con prestazioni zero-shot notevoli. Nonostante le dimensioni ridotte, Florence-2 è efficiente e multifunzionale, il che lo rende utile per applicazioni in diversi settori. Modelli come Florence-2 aprono nuove possibilità e ampliano il potenziale delle innovazioni nell’AI.
Scopri altre novità sull’AI visitando il nostro repository GitHub e unendoti alla nostra community. Consulta le pagine delle nostre soluzioni per leggere delle applicazioni dell’AI nella manifattura e nell’agricoltura.
Scritto da
Creatore di contenuti · Ultralytics
Commenti
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.









