Come migliorare la mAP del modello sugli oggetti piccoli: guida rapida
Scopri come migliorare la mAP del modello sugli oggetti piccoli con consigli pratici sulla qualità dei dati, l’augmentation, le strategie di training, la valutazione e il deployment.
Con la continua crescita dell’adozione dell’intelligenza artificiale (AI), del machine learning e della visione artificiale, i sistemi di rilevamento degli oggetti vengono usati ovunque, dalle telecamere intelligenti per il traffico ai droni e agli strumenti di analisi per il commercio al dettaglio. Spesso ci si aspetta che questi sistemi rilevino oggetti di qualsiasi dimensione, che si tratti di un grande camion vicino alla fotocamera o di un pedone minuscolo in lontananza.
In genere, individuare oggetti grandi e ben visibili è più semplice. Al contrario, rilevare oggetti piccoli è più difficile.
Quando un oggetto occupa solo una piccolissima porzione dell’immagine, le informazioni visive disponibili sono davvero poche. Un pedone lontano ripreso da una telecamera del traffico o un piccolo veicolo catturato da una vista aerea possono occupare solo pochi pixel, eppure quei pixel possono contenere informazioni cruciali.
I modelli di visione artificiale, come i modelli Ultralytics YOLO, si basano su schemi visivi per riconoscere gli oggetti e, quando questi schemi sono limitati o poco chiari, le prestazioni ne risentono. Durante l’elaborazione si possono perdere dettagli importanti, rendendo le previsioni più sensibili agli errori di localizzazione. Anche un leggero spostamento di un riquadro di delimitazione può trasformare un rilevamento corretto in un mancato rilevamento.
Questa differenza emerge chiaramente osservando le prestazioni dei modelli. La maggior parte dei modelli di rilevamento e segmentazione gestisce bene gli oggetti medi e grandi, ma quelli piccoli spesso riducono la precisione complessiva.
Le prestazioni del deep learning si misurano in genere con la precisione media, o mAP. Questa metrica riflette sia la precisione dei rilevamenti sia il grado di sovrapposizione tra i riquadri previsti e gli oggetti reali.
Combina la precisione, che indica quanti oggetti previsti sono corretti, e il richiamo, che indica quanti oggetti reali vengono rilevati correttamente, considerando diversi livelli di confidenza e soglie di intersezione sull’unione, o IoU (una metrica che misura quanto il riquadro di delimitazione previsto si sovrappone al riquadro di riferimento).
In precedenza abbiamo approfondito il rilevamento di piccoli oggetti e spiegato perché sia un problema così complesso per i modelli di visione artificiale. In questo articolo ripartiremo da quelle basi e ci concentreremo su come migliorare la mAP quando sono coinvolti piccoli oggetti. Cominciamo!
Perché è più difficile rilevare gli oggetti piccoli?#
Nelle applicazioni che impiegano rilevatori di oggetti, un oggetto è definito piccolo in base allo spazio che occupa nell’immagine, non necessariamente a quanto appare piccolo all’occhio umano. Se occupa solo una piccolissima porzione dell’immagine, contiene pochissime informazioni visive e diventa più difficile per un algoritmo di visione artificiale rilevarlo con precisione.
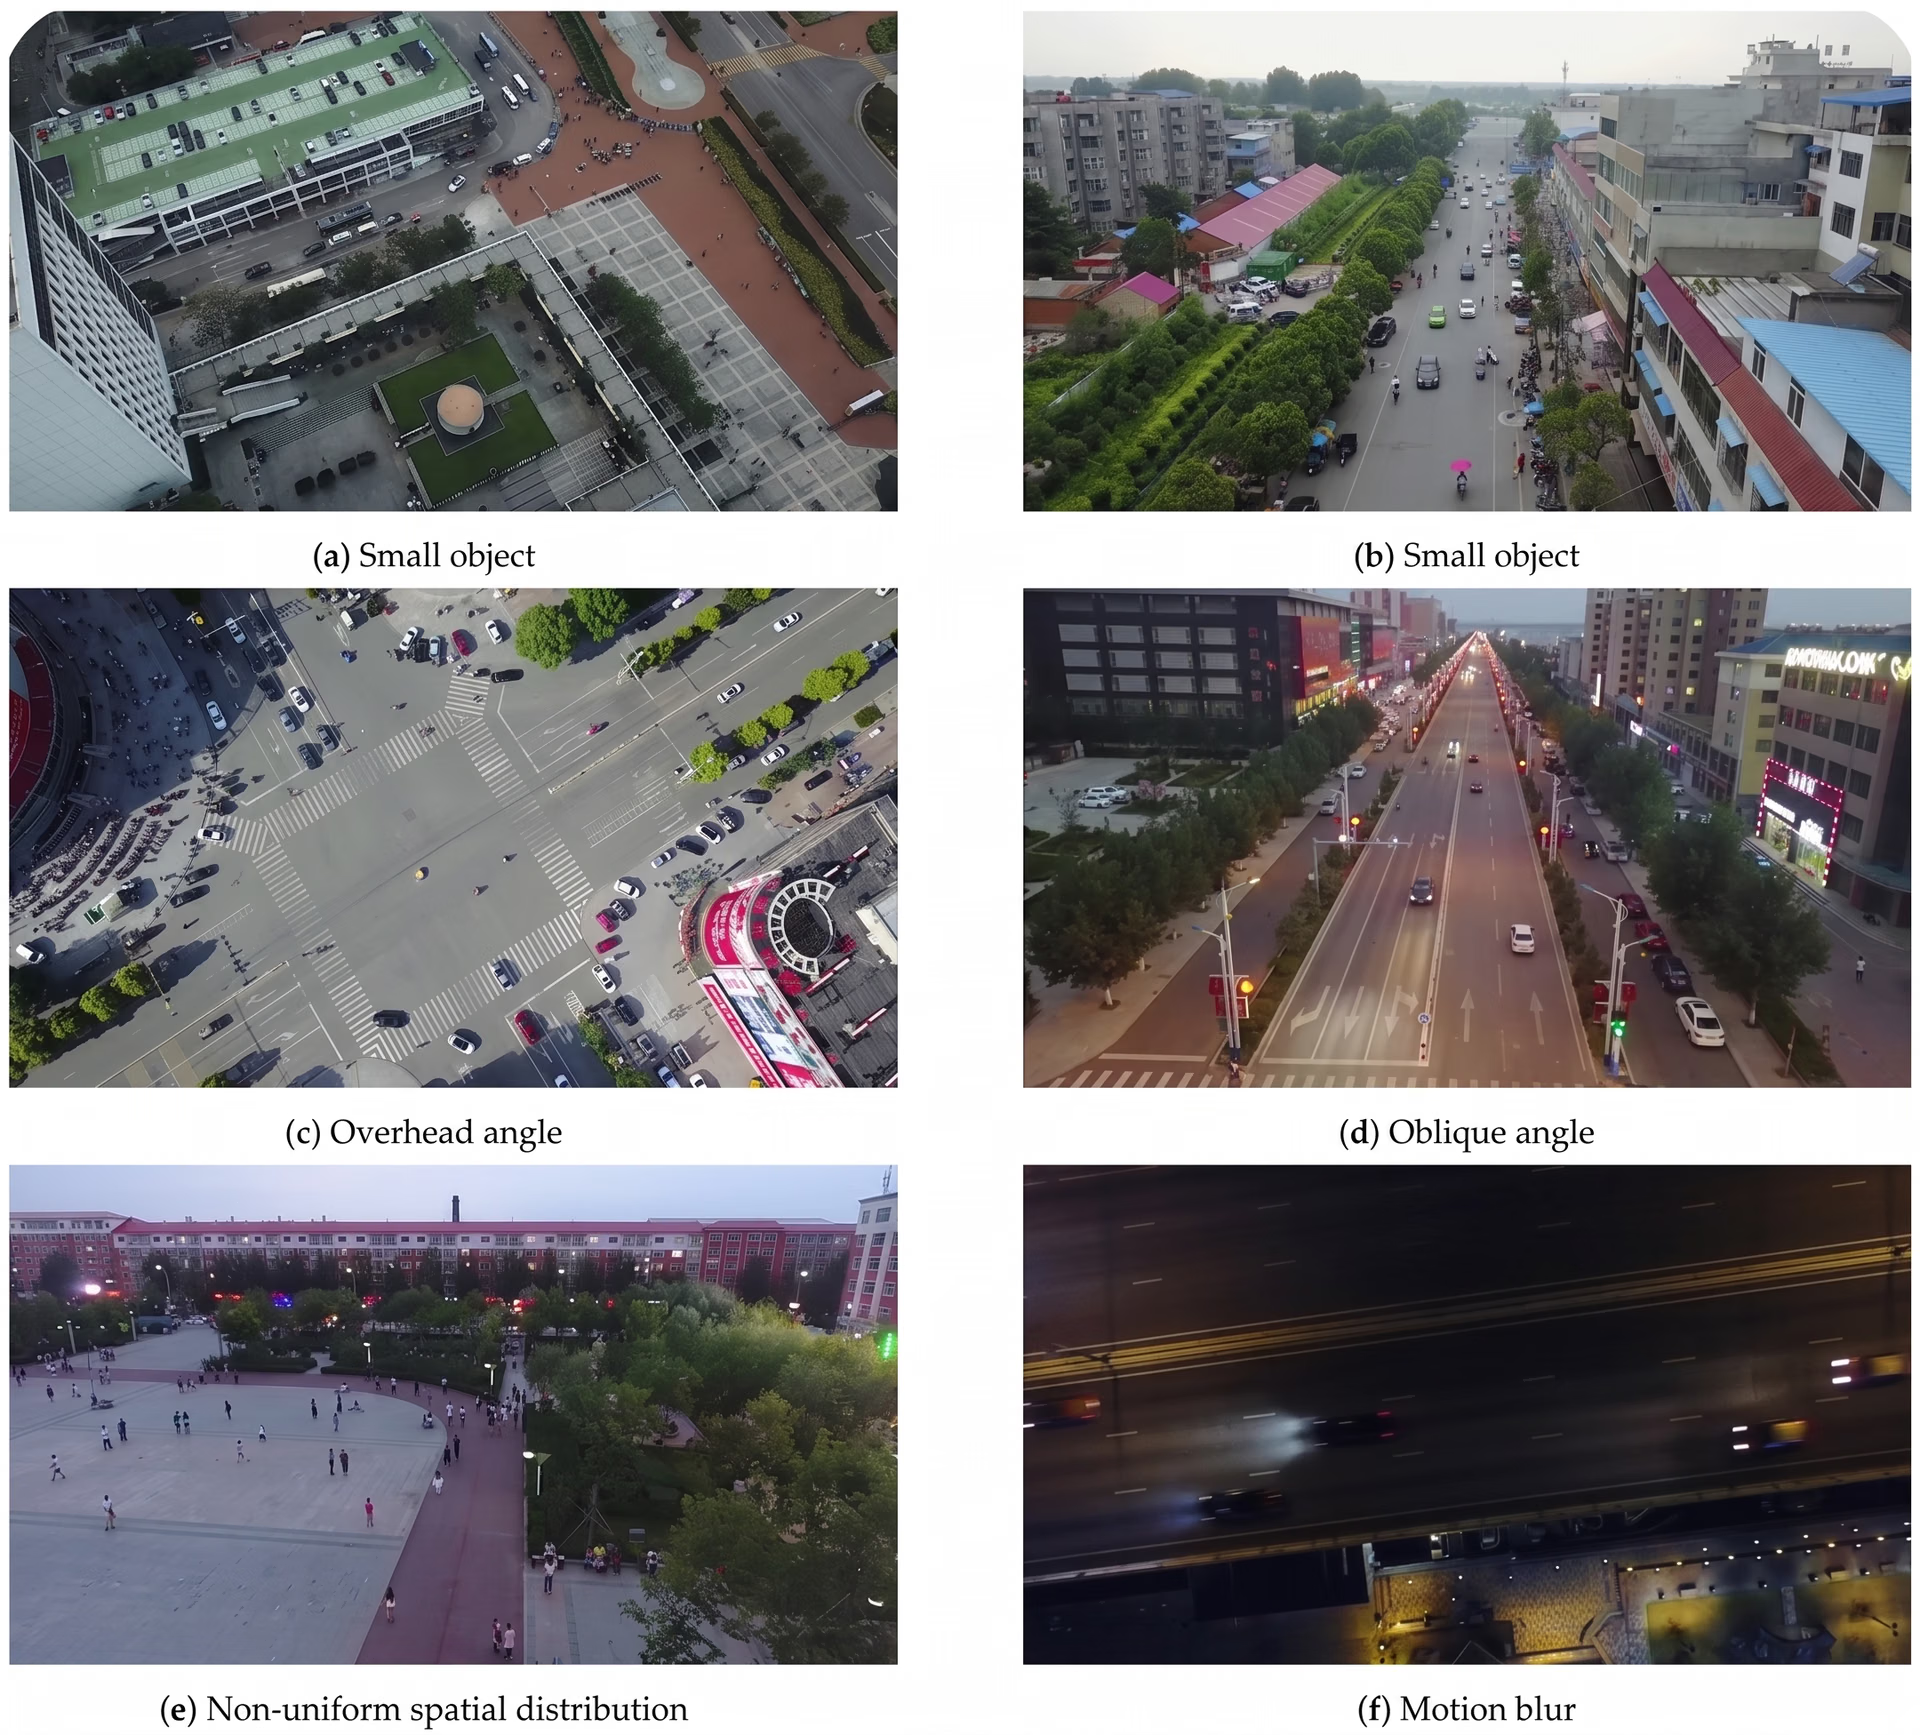
Fig. 1. Immagini di esempio che mostrano piccoli oggetti distribuiti su aree di pixel limitate (Fonte)
Con meno pixel a disposizione, dettagli importanti come bordi, forme e trame possono risultare poco chiari o andare facilmente persi. Durante l’elaborazione dell’immagine, il modello la ridimensiona e semplifica per mettere in evidenza gli schemi utili.
Questo aiuta il modello a comprendere la scena nel suo insieme, ma può anche ridurre ulteriormente i dettagli più fini. Per gli oggetti piccoli, questi dettagli sono spesso essenziali per un rilevamento corretto.
Queste difficoltà diventano ancora più evidenti quando si osservano le metriche di valutazione. Gli oggetti piccoli sono particolarmente sensibili agli errori di localizzazione. Anche un riquadro di delimitazione leggermente disallineato può non raggiungere la soglia richiesta di intersezione sull’unione, o IoU.
In tal caso, una previsione che sembra ragionevole può essere conteggiata come errata. Questo riduce sia la precisione sia il richiamo e, di conseguenza, la precisione media, o mAP.
Poiché questi fattori sono strettamente collegati, per migliorare le prestazioni spesso è necessario considerare l’intero sistema. Ciò significa bilanciare attentamente la risoluzione delle immagini, l’estrazione delle caratteristiche, la progettazione del modello e le impostazioni di valutazione, in modo da preservare e interpretare meglio i piccoli dettagli visivi.
L’importanza della qualità del dataset e delle annotazioni#
Nel rilevamento di piccoli oggetti, la qualità del dataset spesso fa la differenza maggiore in termini di prestazioni. Gli oggetti piccoli occupano solo una piccolissima porzione dell’immagine, quindi le informazioni visive disponibili per l’apprendimento del modello sono davvero poche. Per questo, i dati di addestramento diventano particolarmente importanti. Se il dataset non include un numero sufficiente di esempi chiari e rappresentativi, il modello di rilevamento degli oggetti farà fatica a riconoscere schemi coerenti.
I dataset più adatti al rilevamento di piccoli oggetti contengono in genere immagini ad alta risoluzione, frequenti apparizioni di piccoli bersagli e condizioni visive coerenti. Sebbene i dataset generici come il dataset COCO siano un utile punto di partenza, spesso non rispecchiano la scala, la densità o il contesto di specifici casi d’uso reali. In questi casi, raccogliere dati di addestramento specifici per il dominio diventa necessario per migliorare le prestazioni del modello.
Anche la qualità delle annotazioni svolge un ruolo cruciale. Le annotazioni definiscono i riferimenti corretti, specificando le etichette degli oggetti e le posizioni dei riquadri di delimitazione che il modello impara a prevedere.
Per gli oggetti piccoli, i riquadri di delimitazione devono essere tracciati con cura e coerenza. Anche lievi differenze nella posizione del riquadro possono influire sensibilmente sulla precisione della localizzazione, perché gli oggetti piccoli sono molto sensibili agli spostamenti a livello di pixel.
Annotazioni scadenti o incoerenti possono ridurre notevolmente la mAP. Se gli oggetti sono etichettati in modo errato, il modello apprende schemi sbagliati, con un possibile aumento dei falsi positivi.
Se nell’immagine sono presenti oggetti che mancano nei riferimenti corretti, durante la valutazione i rilevamenti corretti possono essere conteggiati come falsi positivi. Entrambe le situazioni riducono le prestazioni complessive.
È interessante notare che ricerche recenti indicano che la precisione media per gli oggetti piccoli rimane spesso tra il 20% e il 40% nei benchmark standard, un valore decisamente inferiore a quello degli oggetti più grandi. Questa differenza evidenzia l’importanza della progettazione del dataset e della coerenza delle annotazioni per la precisione complessiva del rilevamento.
L’aumento dei dati può svolgere un ruolo chiave nel migliorare la precisione#
Ora che abbiamo compreso l’importanza della qualità del dataset e della coerenza delle annotazioni, vediamo come un modello di rilevamento degli oggetti può apprendere in modo più efficace dai dati esistenti. Anche quando raccogliere altre immagini è difficile o costoso, ci sono comunque modi per migliorare le prestazioni sfruttando meglio i dati già disponibili.
Uno degli approcci più pratici è l’aumento dei dati. È particolarmente importante nel rilevamento di piccoli oggetti, perché questi forniscono meno indizi visivi da cui il modello possa apprendere. Introducendo variazioni controllate durante l’addestramento, l’aumento dei dati aiuta il modello a generalizzare meglio senza dover raccogliere nuovi dati.
Un aumento dei dati efficace punta a mantenere ben visibili gli oggetti piccoli. Tecniche come il ridimensionamento controllato, il ritaglio leggero e la suddivisione dell’immagine in riquadri possono far risaltare maggiormente gli oggetti piccoli, preservandone forma e aspetto. L’obiettivo è aiutare il modello a vedere più spesso gli oggetti piccoli e in condizioni leggermente diverse, senza modificarne l’aspetto nelle situazioni reali.
Tuttavia, l’aumento dei dati va applicato con attenzione. Alcune trasformazioni possono ridurre la visibilità degli oggetti piccoli o modificarne l’aspetto in modi improbabili nei dati reali. In questi casi, il modello potrebbe avere difficoltà ad apprendere confini precisi degli oggetti.
Aumento dei dati più intelligente con l’IA generativa#
Un’altra forma interessante di aumento dei dati, sempre più diffusa, consiste nell’usare l’IA generativa per creare dati sintetici di addestramento. Invece di affidarsi a immagini raccolte e annotate manualmente, i team possono generare scene realistiche che simulano ambienti specifici, dimensioni degli oggetti, condizioni di illuminazione e variazioni dello sfondo.
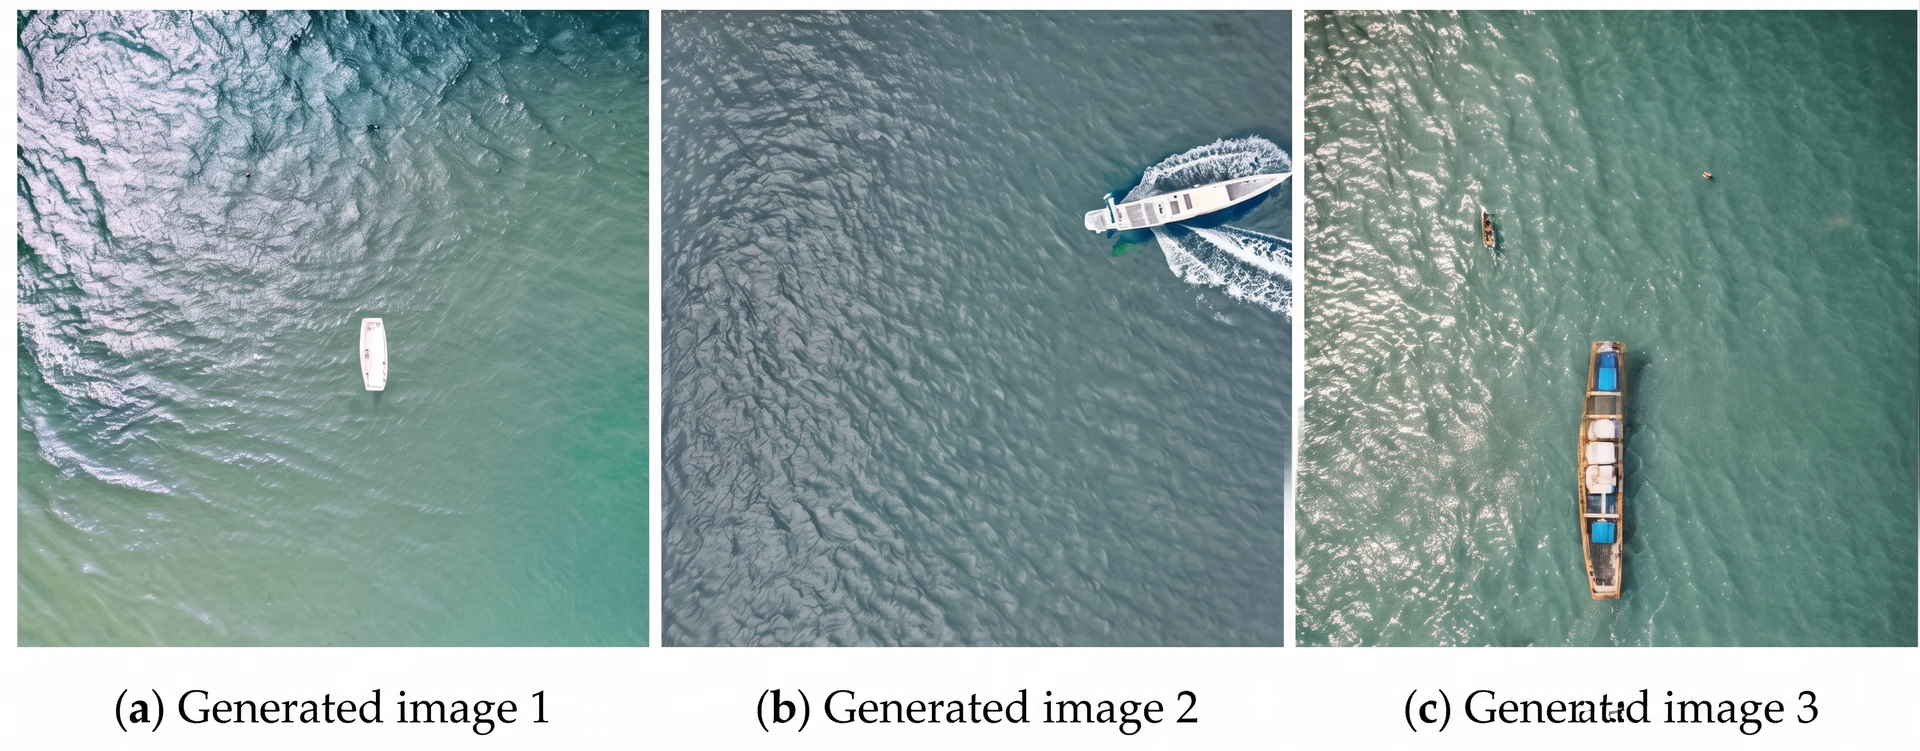
Fig. 2. Uno sguardo alle immagini aeree sintetiche utilizzate per l’aumento dei dati (Fonte)
Questo approccio è particolarmente utile per il rilevamento di piccoli oggetti, per i quali può essere difficile acquisire esempi reali in modo coerente. Controllando l’aspetto degli oggetti piccoli nelle immagini sintetiche, ad esempio regolando scala, densità e posizione, è possibile esporre i modelli a una gamma più ampia di scenari di addestramento.
Se combinato con attenzione ai dati reali, l’aumento sintetico può migliorare la robustezza del modello, ridurre i costi di raccolta dei dati e favorire miglioramenti delle prestazioni più mirati.
Scelte di addestramento del modello che possono influire sulla mAP degli oggetti piccoli#
Oltre alla qualità del dataset e alla coerenza delle annotazioni, anche le scelte di addestramento del modello incidono notevolmente sulle prestazioni nel rilevamento di piccoli oggetti.
Ecco alcune delle principali strategie di addestramento da considerare:
- Inizia con modelli preaddestrati: un modello preaddestrato, come Ultralytics YOLO26, ha già appreso schemi visivi generali da ampi dataset di immagini. Questo offre un punto di partenza solido rispetto all’addestramento da zero ed è particolarmente utile quando si rilevano oggetti piccoli con dati limitati.
- Usa il transfer learning in modo strategico: il transfer learning consiste nell’adattare un modello preaddestrato al tuo dataset specifico. Aiuta il modello a concentrarsi sui tuoi oggetti piccoli e riduce l’overfitting (ovvero la memorizzazione dei dati di addestramento anziché l’apprendimento di schemi generali).
- Affronta lo sbilanciamento delle classi: se gli oggetti piccoli compaiono meno spesso di quelli grandi, il modello potrebbe dare priorità all’apprendimento degli oggetti grandi. Tecniche come la ponderazione delle classi o le strategie di campionamento aiutano a evitare che gli oggetti piccoli vengano ignorati.
- Regola le soglie di confidenza e IoU: gli oggetti piccoli sono sensibili anche a lievi errori di localizzazione. Affinare queste soglie aiuta a valutare e interpretare meglio le prestazioni sugli oggetti piccoli durante la convalida e l’inferenza.
Considerazioni sull’architettura del modello per il rilevamento di piccoli oggetti#
Per le attività di rilevamento di piccoli oggetti puoi usare un modello di rilevamento generico, ma esistono anche architetture progettate appositamente per migliorare questo tipo di rilevamento. Per esempio, esistono varianti P2 del modello Ultralytics YOLOv8, ottimizzate per preservare i dettagli spaziali più fini.
Ultralytics YOLOv8 elabora le immagini a più scale, riducendole gradualmente man mano che avanzano nella rete. Questo aiuta il modello a comprendere la scena nel suo insieme, ma riduce anche i dettagli più fini.
Quando un oggetto è già molto piccolo, durante questo processo possono scomparire informazioni visive importanti. La variante P2 di Ultralytics YOLOv8 affronta questo problema utilizzando uno stride di 2 nella sua piramide di caratteristiche.
Una piramide di caratteristiche è la parte del modello che analizza l’immagine a più risoluzioni interne, così da poter rilevare oggetti di dimensioni diverse. Con uno stride di 2, in questa fase l’immagine viene ridotta più gradualmente, preservando una maggiore quantità di dettagli originali a livello di pixel.
Poiché viene preservata una maggiore quantità di dettagli spaziali, gli oggetti piccoli mantengono più struttura visibile all’interno della rete. Questo facilita la localizzazione e il rilevamento degli oggetti che occupano solo pochi pixel e può contribuire a migliorare la mAP per gli oggetti piccoli.
Valutazione basata sulle dimensioni per il rilevamento di piccoli oggetti#
Sebbene la precisione media riassuma le prestazioni complessive del modello, non sempre mostra quanto bene il modello gestisca oggetti di dimensioni diverse. Per gli oggetti piccoli, le prestazioni sono spesso limitate dalla precisione della localizzazione più che dalla sola classificazione; ciò significa che lievi spostamenti del riquadro di delimitazione possono influire sensibilmente sui risultati.
In altre parole, il modello può identificare correttamente la classe dell’oggetto, ma se il riquadro di delimitazione previsto è leggermente disallineato, il rilevamento può comunque essere considerato errato. Poiché gli oggetti piccoli coprono solo pochi pixel, anche un lieve spostamento del riquadro può ridurre sensibilmente la sovrapposizione tra il riquadro previsto e il riferimento. Di conseguenza, i punteggi di valutazione possono diminuire anche quando l’oggetto è stato identificato correttamente.
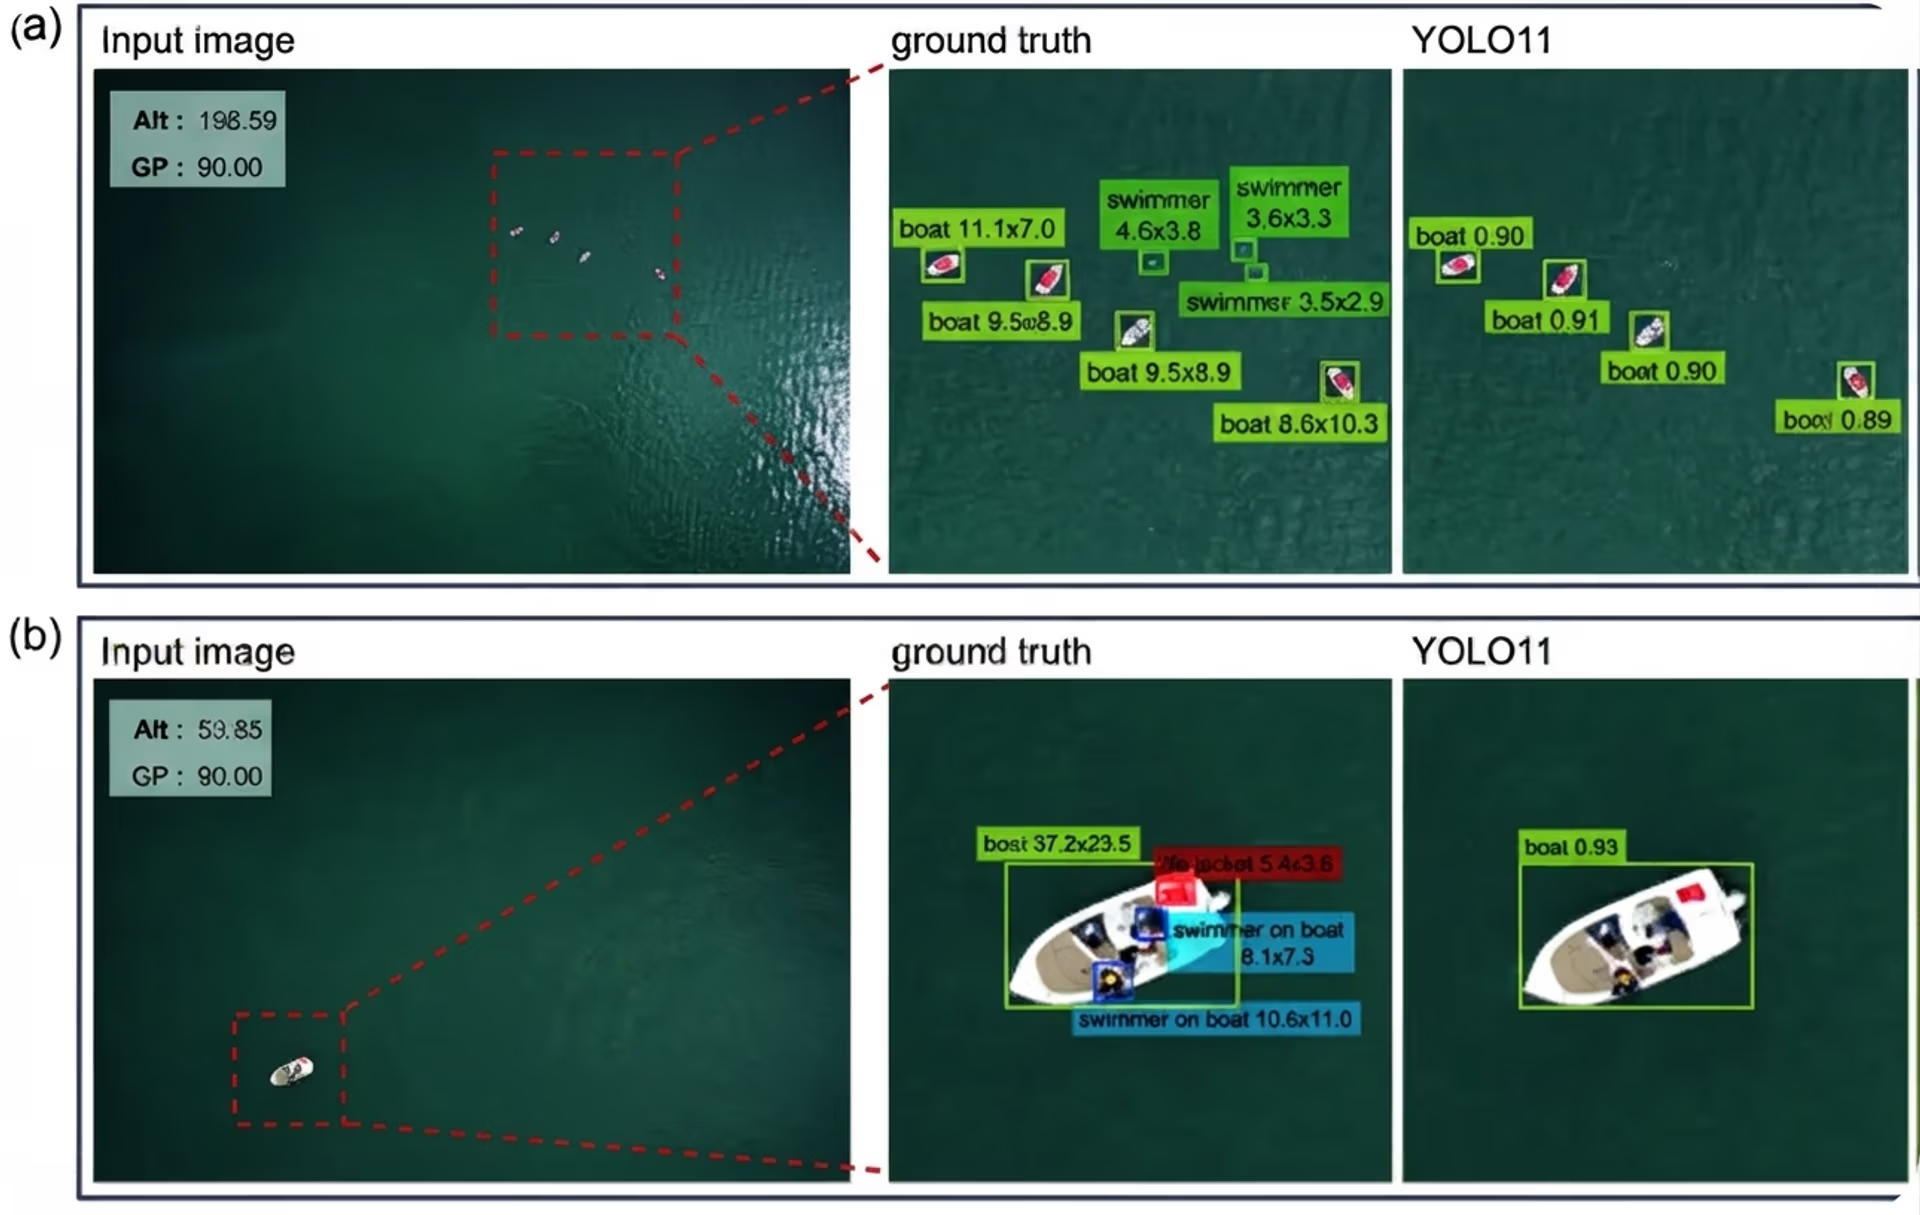
Fig. 3. Valutare il rilevamento di piccoli oggetti può essere complicato (Fonte)
Un approccio più informativo consiste nel valutare le prestazioni in base alle dimensioni degli oggetti. La maggior parte dei benchmark più utilizzati riporta la precisione media separatamente per gli oggetti piccoli, medi e grandi.
Questa suddivisione per dimensione offre un quadro più chiaro dei punti di forza e delle difficoltà del modello. In pratica, l’AP per gli oggetti piccoli è spesso inferiore alla mAP complessiva e mette in evidenza difficoltà di localizzazione che potrebbero non emergere dalle metriche aggregate.
Considera i vincoli di distribuzione e i compromessi nel mondo reale#
Le prestazioni del modello cambiano spesso quando si passa da ambienti di test controllati alla distribuzione nel mondo reale. Fattori come la risoluzione delle immagini, la velocità di elaborazione e l’hardware disponibile introducono compromessi che influiscono direttamente sul rilevamento di piccoli oggetti.
Per esempio, aumentare la risoluzione in ingresso può migliorare la mAP per gli oggetti piccoli, perché i piccoli bersagli occupano più pixel e conservano più dettagli. Tuttavia, una risoluzione maggiore aumenta anche l’uso di memoria e i tempi di elaborazione. Questo può rallentare l’inferenza e aumentare i costi operativi.
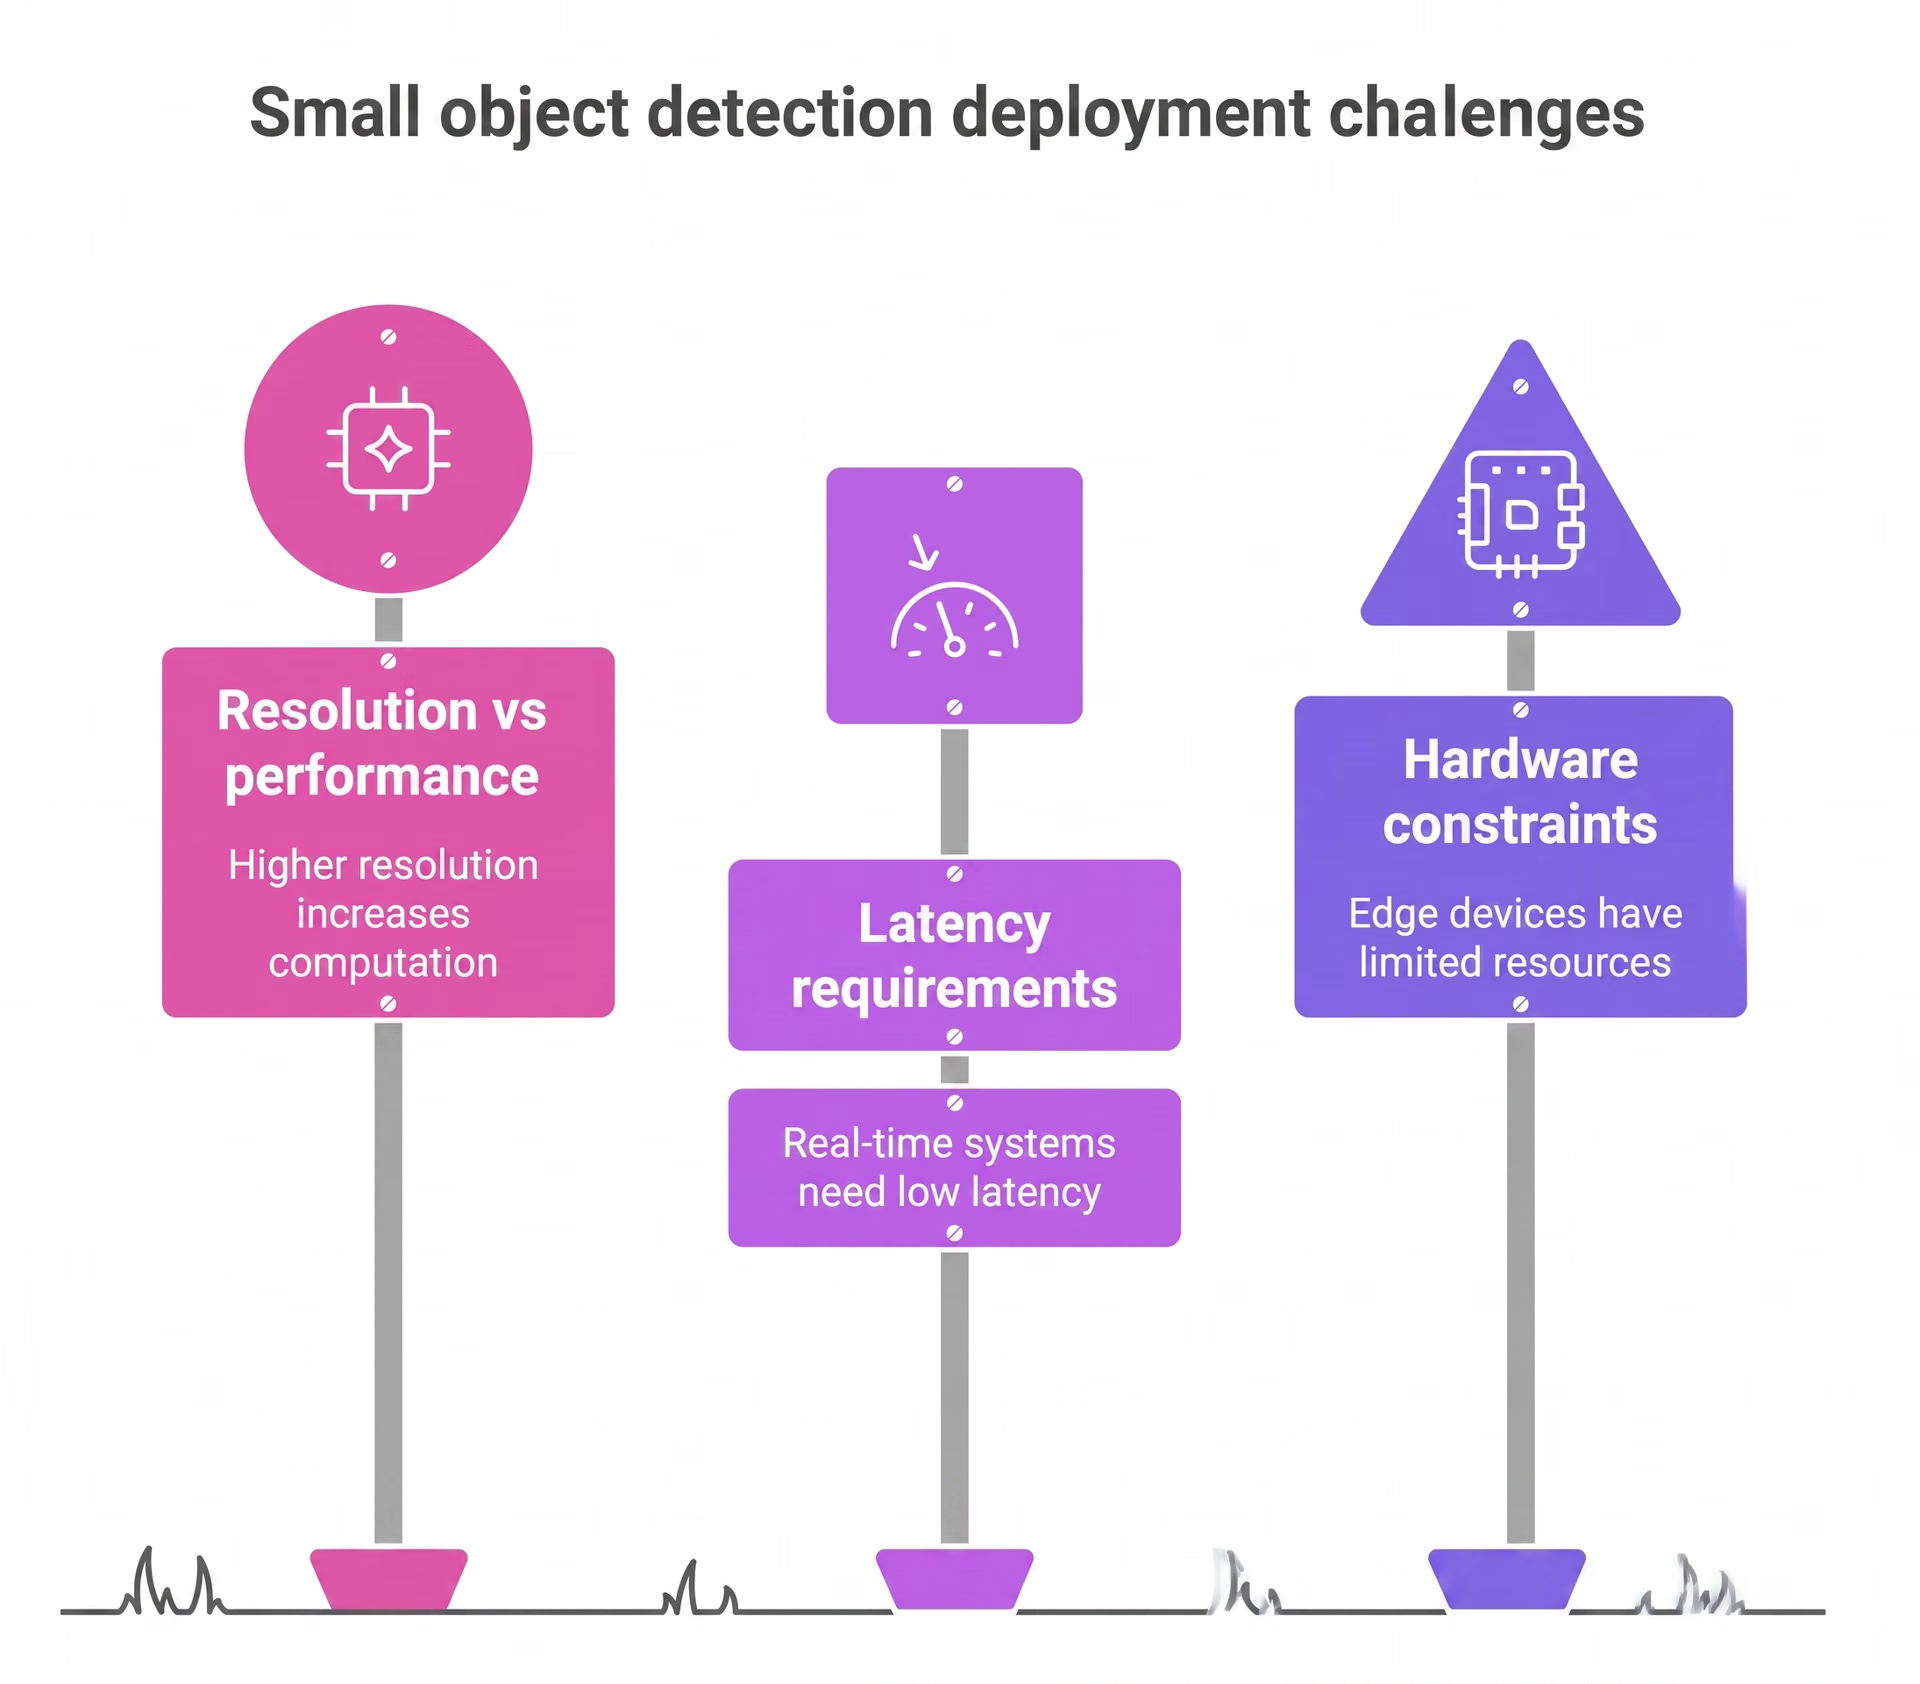
Fig. 4. Sfide della distribuzione per il rilevamento di piccoli oggetti. Immagine dell’autore.
La scelta dell’hardware è fondamentale per gestire questi compromessi. GPU più potenti consentono di usare modelli più grandi e velocizzare l’elaborazione, ma gli ambienti di distribuzione, soprattutto i dispositivi edge, spesso dispongono di risorse di calcolo e memoria limitate.
Le applicazioni in tempo reale introducono un ulteriore vincolo: mantenere una latenza bassa può richiedere di ridurre le dimensioni del modello o la risoluzione in ingresso, con possibili effetti negativi sul richiamo degli oggetti piccoli. In definitiva, le decisioni di distribuzione richiedono un equilibrio tra prestazioni di rilevamento, limiti dell’hardware, requisiti di velocità e costi complessivi.
Ricapitolando: migliorare la mAP del modello sugli oggetti piccoli#
Migliorare il rilevamento di piccoli oggetti richiede un approccio pratico e strutturato, soprattutto in ambienti reali. Ecco una panoramica dei passaggi principali da tenere a mente:
- Verifica la qualità del tuo dataset: assicurati che il tuo dataset includa un numero sufficiente di esempi di oggetti piccoli, utilizzi immagini ad alta risoluzione quando possibile e rispecchi le condizioni dell’ambiente in cui verrà distribuito il modello.
- Verifica la coerenza delle annotazioni: assicurati che i riquadri di delimitazione siano precisi, completi e contrassegnati con etichette coerenti. Le annotazioni incoerenti possono limitare direttamente le prestazioni di localizzazione.
- Regola intenzionalmente le impostazioni di addestramento: modifica con attenzione la dimensione del batch, il numero di epoche e le impostazioni di ottimizzazione, in modo che gli oggetti piccoli siano rappresentati adeguatamente durante l’addestramento.
- Procedi per iterazioni: apporta modifiche controllate, misurane l’impatto e perfeziona il tuo approccio. Iterazioni costanti e basate sui dati portano a miglioramenti progressivi nel tempo.
Punti chiave#
Migliorare la mAP per gli oggetti piccoli richiede un approccio strutturato e basato sui dati, non modifiche casuali. I miglioramenti reali derivano dalla combinazione di dati di qualità, annotazioni coerenti, addestramento attento e metodi di valutazione adeguati. Nei progetti reali, test regolari e modifiche contenute e misurabili sono ciò che permette di ottenere nel tempo un rilevamento di piccoli oggetti migliore e più affidabile.
Unisciti alla nostra community in crescita ed esplora il nostro repository GitHub per trovare risorse pratiche sull’AI. Per iniziare oggi a sviluppare soluzioni di vision AI, scopri le nostre opzioni di licenza. Scopri come l’AI in agricoltura sta trasformando il settore agricolo e come la vision AI nella robotica sta plasmando il futuro visitando le pagine dedicate alle nostre soluzioni.








