ラベリング作業を減らす方法:自動ラベリングとアクティブラーニングツールの比較
CVAT、Encord、Labelbox、Lightly、Roboflow、SuperAnnotate、Ultralytics、V7、Voxel51 FiftyOneを含む、自動ラベリングとアクティブラーニングの10ツールを比較します。
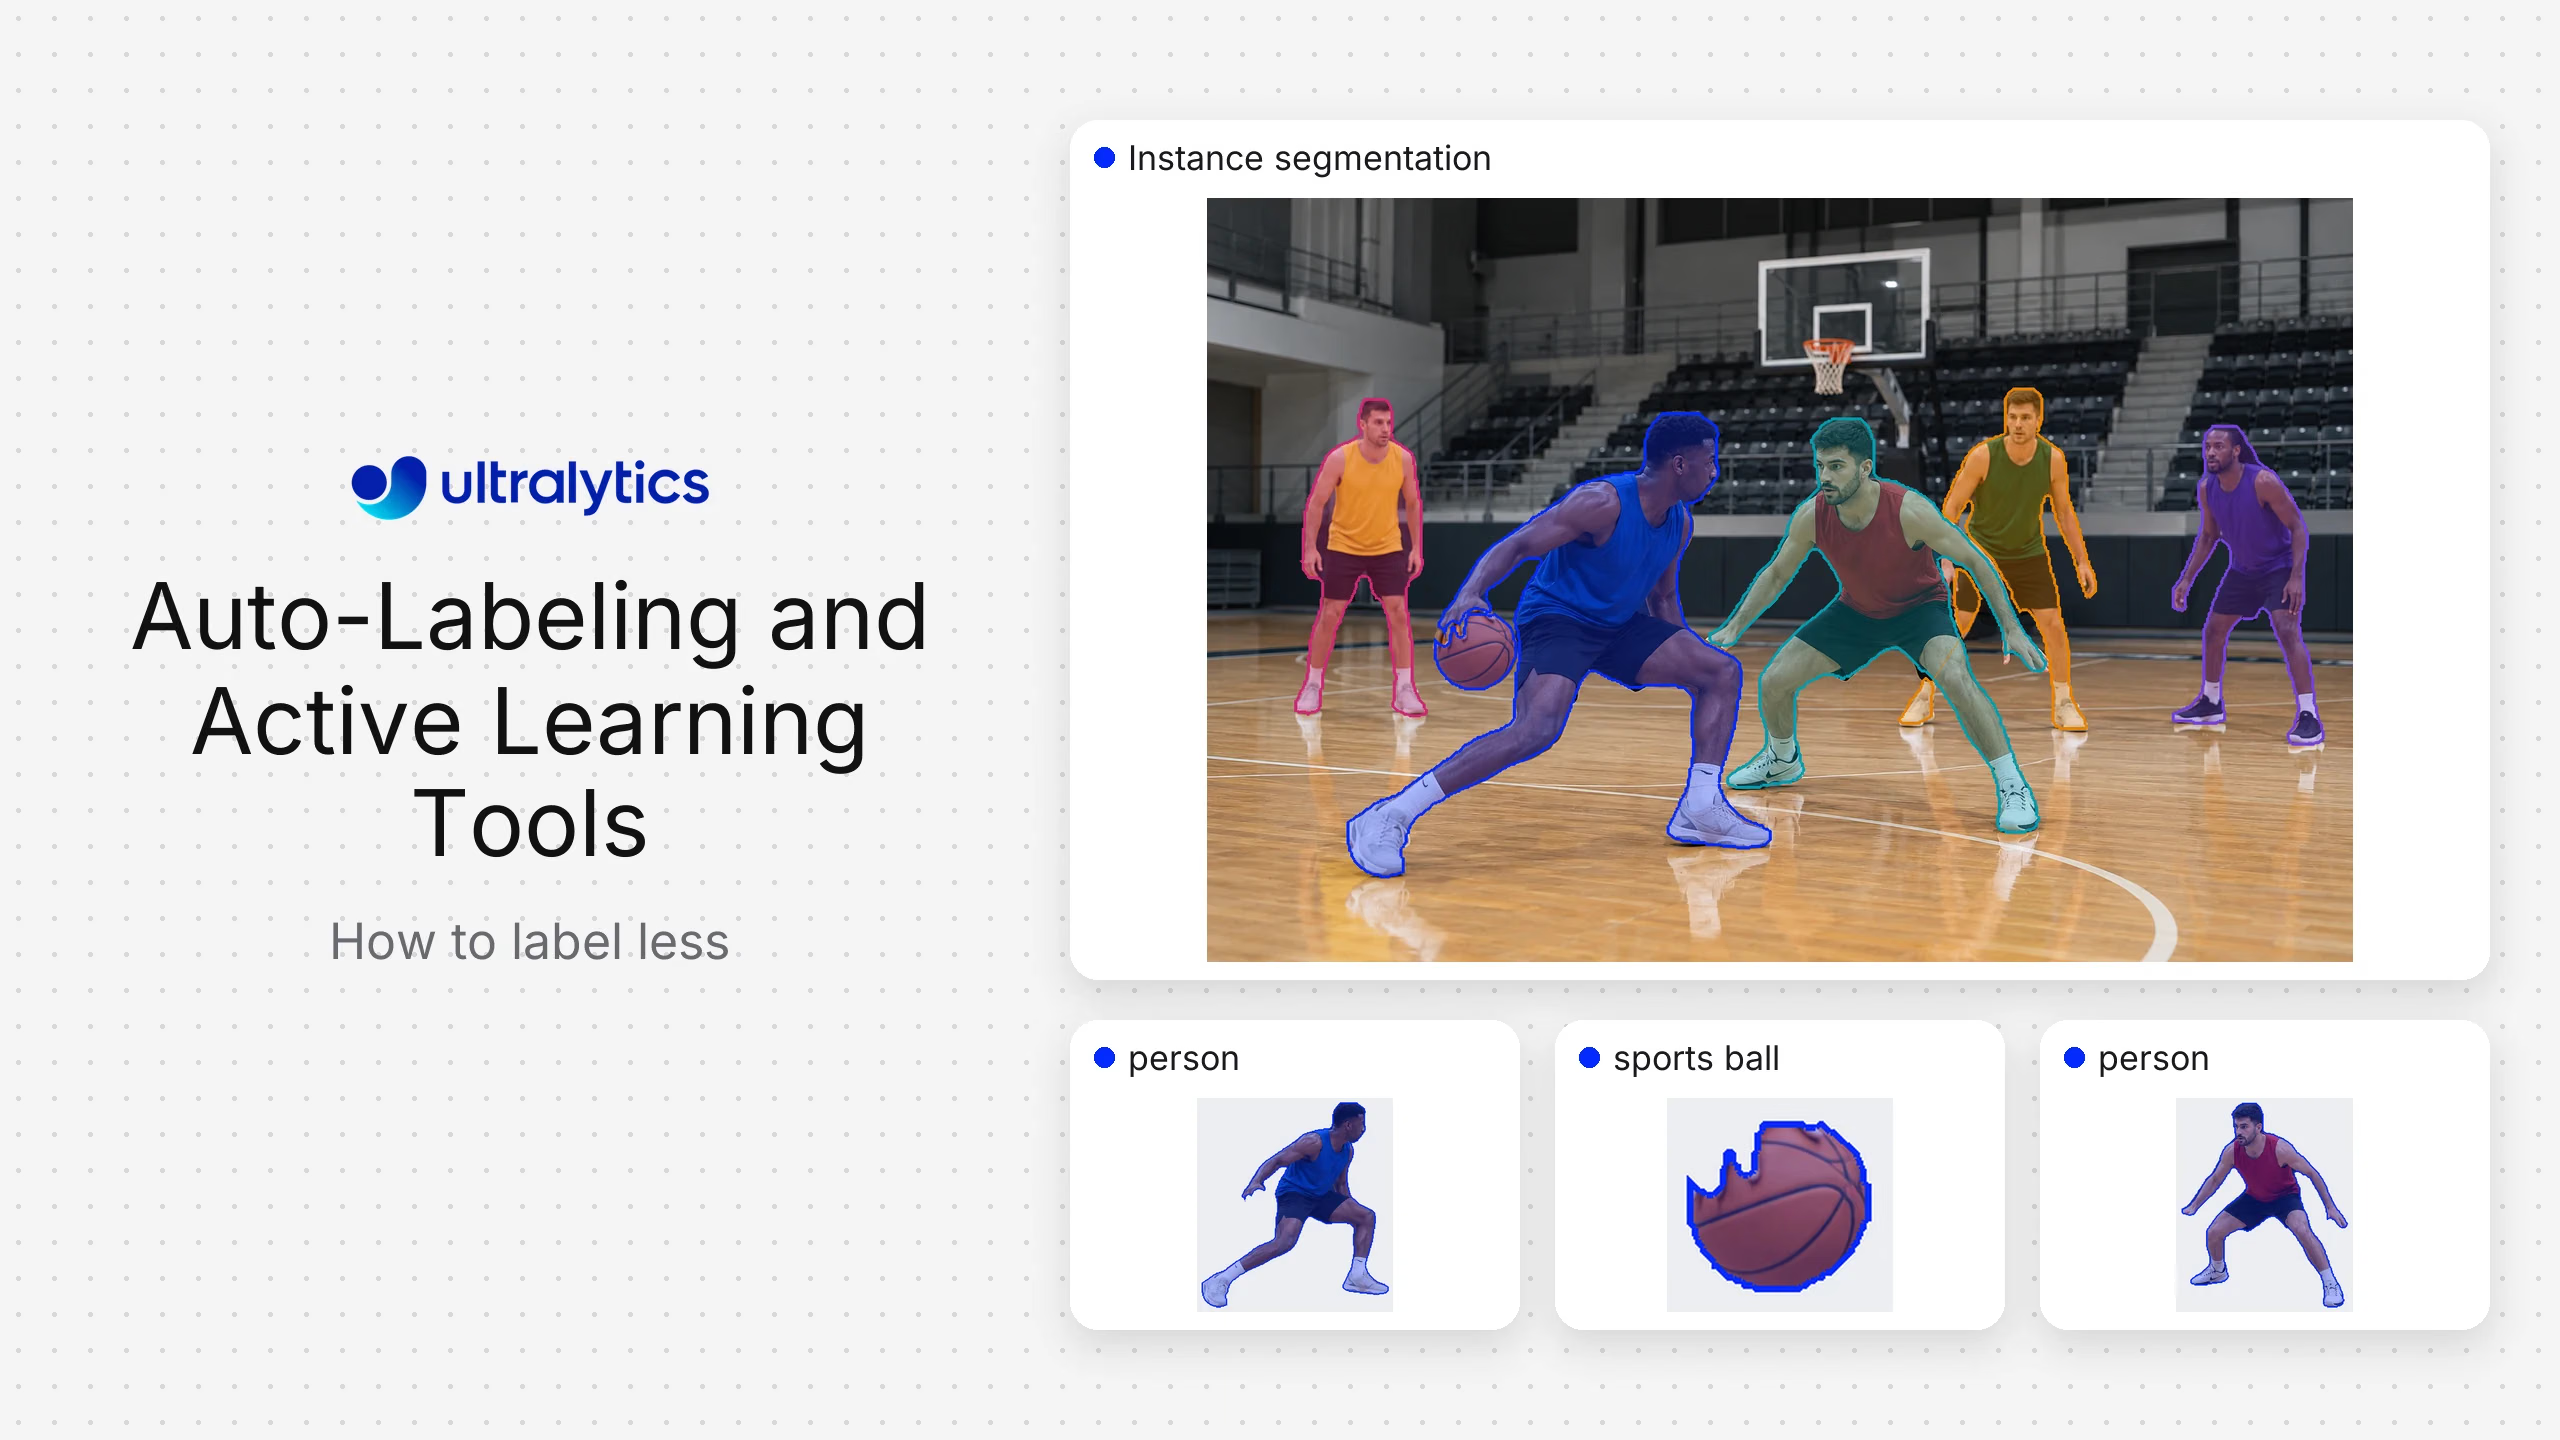
ほとんどのコンピュータービジョンチームが抱えているのは、アノテーションの問題ではありません。アノテーション量の問題です。フレームが多すぎる一方で、レビューに使える時間は少なく、モデルの改善に必要なのはその一部だけです。自動化ツールは2つの方向からこの問題に対処するため、その違いによって実際に必要なツールが決まります。Ultralytics Platformは、自動ラベリングの方向を担い、SAMベースのSmart AnnotationとUltralytics YOLOのトレーニングを1つのワークフローにまとめています。
自動ラベリングでは、モデルを人間の前に置きます。モデルがボックス、マスク、キーポイントを提案し、レビュー担当者が修正することで、ラベル1件あたりのコストを下げます。アクティブラーニングでは、モデルをデータセットの前に置きます。ラベルのないデータをスコアリングし、レビュー担当者が確認する価値のあるフレームを選ぶことで、必要なラベルの数を減らします。後者が必要なのに前者を購入するのは、この分野で最もよくある無駄な購入です。
Smart Annotationは、検出、セグメンテーション、Oriented Boxタスク向けにマスクとボックスを提案します。ポーズと分類のデータセットは引き続き手作業でアノテーションするため、タスク構成に照らして確認する必要があります。万能の解決策ではありません。LightlyとVoxel51 FiftyOneはデータ選択に特化しており、CVATはセルフホスト型のオープンソースワークフローに適しています。また、Labelbox、Encord、SuperAnnotateは、小規模なビジョンチームには使い切れないほど充実したエンタープライズ向けレビュー機能を備えています。
自動ラベリングとアクティブラーニングのツール比較#
| ツール | 自動化のアプローチ | 最適な用途 | 提供形態 | 主なトレードオフ |
|---|---|---|---|---|
| CVAT | SAMを含む、サービングされたモデルによる自動アノテーション | オープンソースの制御性とセルフホスティングを求めるチーム | オープンソースとホステッド | モデルのサービングとインフラは自社で運用します |
| Encord | 画像、動画、医療用フォーマットに対応した自動アノテーション | 複雑な動画、DICOM、長時間シーケンスのワークフロー | マネージドプラットフォーム | 小規模なチームにとっては、必要以上に高機能な場合があります |
| Label Studio | 自社でホストするプラグイン式MLバックエンドを通じた事前アノテーション | 複数のモダリティを横断する柔軟なラベリングレイヤーを必要とするチーム | オープンソースとエンタープライズ | 自動化にはバックエンドの構築と運用が必要です |
| Labelbox | データセットに対してモデルを実行する、モデル支援型ラベリング | 複数のデータタイプを1つのレビュープロセスでラベリングする企業 | マネージドプラットフォーム | ビジョン専業チームには機能が広範すぎます |
| Lightly | 埋め込みベースで、ラベルのないデータからラベル付けする対象を選択 | レビュー担当者の時間が制約となる、大量の未ラベルデータ | マネージド型とセルフホスト型 | データを選択しますが、アノテーション用インターフェースではありません |
| Roboflow | 基盤モデルまたは独自のトレーニング済みモデルを使用するモデル支援型ラベリング | すでに同社のデータセットツールを使用している、開発者主導のビジョンチーム | マネージドプラットフォーム | ワークフローをより多く採用することで、最大の価値が得られます |
| SuperAnnotate | マネージドなラベリングサービスと組み合わせた自動化機能 | ソフトウェアとラベリングの処理能力をまとめて購入するチーム | プラットフォームとサービス | ソフトウェアとサービスの範囲は分けて価格を設定する必要があります |
| Ultralytics Platform | SAMベースのSmart Annotationを使用し、その結果でUltralytics YOLOモデルをトレーニング | ラベリングとトレーニングを1つのループで行いたいビジョンチーム | マネージドプラットフォーム | テキストや音声のラベリングではなく、ビジョンタスクに特化 |
| V7 Darwin | 画像と動画の詳細な作業を対象とした自動アノテーション | 医用画像と高密度な動画のアノテーション | マネージドプラットフォーム | V7自体の注力分野はドキュメントAIに移行しており、アノテーションは現在V7 Darwinの下で提供されています |
| Voxel51 FiftyOne | データセットのキュレーション、エラーの検出、モデル主導の探索 | データセットとモデルの品質を共同でデバッグするチーム | オープンソースとエンタープライズ | ラベリング人員やUIではなく、キュレーションレイヤーです |
このページでは、ベンダーをランキングせず、全体を通してアルファベット順に掲載しています。Ultralyticsはこの比較を公開し、掲載もされているため、順序は意図的に中立とし、各項目に明記されたトレードオフを記載しています。
2つの用途は異なる製品選定となるため、ここに唯一の最適なツールはありません。アノテーション、トレーニング、デプロイを一つのループ内で完結させたい場合は、Ultralytics Platformを選んでください。利便性よりオープンソースの制御性を重視する場合は、CVATまたはLabel Studioを選んでください。何にラベルを付けるべきかを判断することが実際の制約である場合は、LightlyまたはFiftyOneを選んでください。大規模チーム全体のレビューガバナンスが実際の課題である場合は、マネージド型のエンタープライズプラットフォームを選んでください。
自動ラベリングとアクティブラーニング#
この2つはセットで販売されることがありますが、解決するボトルネックは異なります。まず自社の課題を明確にすれば、調達サイクルを短縮できます。
自動ラベリングは、ラベル作成のコストを削減します。モデルが画像を処理してアノテーション候補を提案し、人間が承認、編集、または却下します。効果は確かにありますが、限界もあります。すべてのフレームに人手をかける必要があり、モデルの誤りがレビュアーの作業になります。モデルがすでに得意としているクラスなら、修正はすぐに終わります。一方、曖昧なケース、遮蔽されたケース、まれなケース(実際にモデルを改善するケース)では、提案の精度が最も低く、修正に最も時間がかかります。
アクティブラーニングは、必要なラベルの数を減らします。システムはラベルのないデータプールを埋め込み、またはスコア付けし、モデルにとって学習価値の高いフレームを順位付けします。たとえば、不確実性が高いもの、既存データとの類似度が低いもの、モデルのバージョン間で予測が食い違うものが対象です。データプールの一部だけにラベルを付けることで、精度の大部分を得られます。
実務上の見分け方:
- レビュアーが全フレームにアノテーションする必要があり、作業に追われているなら、自動ラベリングが必要です。
- ラベル付けできる量をはるかに超える映像があり、選定するための合理的な方法がないなら、アクティブラーニングが必要です。
- 両方の課題があるなら両方が必要ですが、通常は別々の製品になります。
有効な手順は、まずアクティブラーニングでデータを選定し、選ばれたデータだけを自動ラベリングすることです。データプール全体に自動化を実行すると、モデルの改善につながらないフレームに計算リソースとレビュー時間を費やすことになります。
CVAT#
概要。 画像、動画、3Dデータに対応した成熟したオープンソースのアノテーションツールで、セルフホストまたはホスト型で利用できます。
最適な用途。 アノテーションの実行場所とコストを完全に制御する必要があるチーム。
自動化の仕組み。 自動アノテーションでは、インタラクティブなセグメンテーションに使うSAMを含む、CVATと連携して提供されるモデルを呼び出し、レビュアーがタスクを開く前に事前アノテーションします。
強み。 ライセンス費用のかからない高機能なアノテーションインターフェース、補間を含む充実した動画サポート、データを保持するベンダーがいないことです。
トレードオフ。 デプロイ、モデルの提供、レビューワークフローの設計は自社で担う必要があります。自動化の品質は、バックエンドに用意するモデルの性能に左右されます。
Encord#
概要。 動画、DICOM、点群などの複雑な視覚データを対象とする、アノテーションおよびデータ管理プラットフォームです。
最適な用途。 フレーム単位の作業が困難な長時間の動画や医用画像を扱うチーム。
自動化の仕組み。 自動アノテーションとオブジェクトトラッキングにより、フレーム間でアノテーションを引き継ぎ、生成されたラベルをレビューする段階も設けられています。
強み。 動画と医療フォーマットへの対応が非常に優れており、処理量を数えるだけでなく、ラベルの問題を検出する品質管理ツールも備えています。
トレードオフ。 小規模な物体検出プロジェクトには、プラットフォームの規模もオンボーディングの負担も過剰です。
Label Studio#
概要。 ビジョン、テキスト、音声など、さまざまなデータタイプに対応するオープンソースのラベリングフレームワークで、エンタープライズ版もあります。
最適な用途。 複数のモダリティにわたり、単一のラベリングレイヤーを標準化するチーム。
自動化の仕組み。 自社で作成・ホストするMLバックエンドが事前アノテーションを返すため、ラベリングに使うモデルを完全に自由に選べます。
強み。 インターフェースと自動化を最大限に柔軟に制御でき、事前アノテーションに使うモデルにも制約がありません。
トレードオフ。 自動化は機能ではなくフレームワークです。バックエンドの構築、提供、保守を誰かが担う必要があります。
Labelbox#
概要。 複数のデータタイプに対応し、充実したレビューおよび品質管理レイヤーを備えるエンタープライズ向けデータラベリングプラットフォームです。
最適な用途。 画像と他のモダリティを、単一のガバナンスプロセスの下でラベリングする組織。
自動化の仕組み。 モデル支援型ラベリングでは、予測結果を編集可能な事前アノテーションとしてインポートできます。また、モデルの実行結果を使って、同じデータセット上で予測と正解データを比較できます。
強み。 成熟したレビューワークフロー、きめ細かな品質管理、アノテーターごとのパフォーマンスの可視化です。
トレードオフ。 マルチモーダルのエンタープライズプログラムに適した幅広い機能には、ビジョンのみを扱うチームには不要な設定作業も伴います。
Lightly#
概要。 埋め込みを使って、ラベルのないデータのうち、ラベルを付ける価値があるものを選定するデータ選択プラットフォームです。
最適な用途。 アノテーション可能な量をはるかに超える映像を抱えているチーム。特に、常時録画カメラや車両群からデータを収集しているチームに適しています。
自動化の仕組み。 データを埋め込みに変換し、多様性、不確実性、または関心のあるケースとの類似度に基づいて選定します。選ばれたサブセットは、利用中のアノテーションツールに送られます。
強み。 動画データの冗長性の問題に直接対処できます。ほとんど同じフレームが何千枚あっても、コストが増えるだけで新たな情報は得られません。
トレードオフ。 主な用途はアノテーションではなくデータ選定のため、通常はラベリングツールと組み合わせて使います。ただし、現行のApache-2.0リリースであるLightlyStudioはラベリングにも対応するようになりました。選定専用だと決めつけず、現在の機能範囲を確認してください。
Roboflow#
概要。 データセット管理、アノテーション、トレーニング、デプロイに対応するコンピュータービジョンプラットフォームで、開発者主導のチームに広く利用されています。
最適な用途。 ホスト型のビジョンワークフローを求め、同プラットフォームのデータセット規約を取り入れることに抵抗がないチーム。
自動化の仕組み。 モデル支援型ラベリングでは、基盤モデルまたはプロジェクトですでにトレーニングしたモデルがアノテーションを提案するため、モデルの改善に応じて提案の質も向上します。
強み。 ドキュメントが充実したアノテーションインターフェース、優れたデータセットのバージョン管理、クラスリストをすばやく作成できる大規模な公開データセットのエコシステムです。
トレードオフ。 プラットフォームの利用範囲が広いほど価値が高まるため、ラベリングレイヤーだけを求めるチームにとっては、必要以上の機能を購入することになる可能性があります。
SuperAnnotate#
概要。 マネージド型ラベリングサービスを利用できる、アノテーションプラットフォームです。
最適な用途。 ラベリングソフトウェアと同じくらい、ラベリングの作業能力も制約となっているチーム。
自動化の仕組み。 自動化機能により、プロジェクト内でラベルを事前に付与し、引き継げます。また、人手による作業には、マネージド型のレビュアーを利用できます。
強み。 ツールと人員を一つのベンダーから調達でき、両方を対象としたエンタープライズ向けプロジェクト管理も利用できます。
トレードオフ。 ソフトウェアとサービスの要件は分けて検討する必要があります。そうしないと、活用方法を決められない作業能力まで購入することになります。
Ultralytics Platform:SAM Smart AnnotationからUltralytics YOLOのトレーニングまで#
概要。 Ultralytics Platformは、データセットのアノテーションをモデルのトレーニングおよびデプロイにつなぎます。生画像または既存のラベルを取り込み、Smart Annotationがアノテーションを提案し、レビュアーが修正します。その後、別のトレーニングシステムに移すことなく、データセットを使ってUltralytics YOLOモデルをトレーニングできます。
最適な用途。 Ultralytics YOLOを使って、物体検出、セグメンテーション、分類、姿勢推定、または回転ボックスのモデルを構築しており、ラベル付け、トレーニング、検査のループを一か所に保ちたいチーム。
自動化の仕組み。 Smart AnnotationはMetaのSegment AnythingモデルであるSAMを使い、クリックと数回の調整ポイントからマスク、バウンディングボックス、回転ボックスを生成します。その結果をレビュアーが手動で編集します。デフォルトはSAM 3で、マスクの精度よりインタラクティブな速度を優先する場合は、軽量なSAM 2.1のバリアントを選択できます。物体検出、セグメンテーション、セマンティックセグメンテーション、回転ボックスに対応しています。姿勢推定と分類のデータセットは手動でアノテーションしますが、姿勢推定では人、手、犬、顔、ボックス用のスケルトンテンプレートを使って手作業を効率化できます。
事前学習済みYOLOモデルを使った事前アノテーションにも対応しており、こちらの仕組みは特に有用です。トレーニングが同じプラットフォーム内で完結するため、自社でファインチューニングしたモデルを次のラウンドの事前アノテーションに使えます。エクスポートの手順を挟まずにループを完結できます。手元のデータでトレーニングし、モデルが間違えた箇所を確認して、アノテーションに回します。これはこのガイドの後半で説明する、効果が積み重なる仕組みであり、自分で連携を構築せずに利用できます。
強み。 クローズドループが最大の特長です。ラベリングとトレーニングの間にエクスポート、変換、インポートの手順がなく、手動アノテーションはUltralyticsモデルがサポートする6つのビジョンタスクに対応し、各実行で使ったデータセットとのつながりも維持されます。
トレードオフ。 コンピュータービジョン向けに構築されているため、画像とともにテキストや音声もラベリングするチームには別のツールが必要です。マネージド型の人手によるラベリングサービスは提供せず、非常に大規模なラベルなしデータプール向けの埋め込みベースの選定エンジンでもありません。また、統合による利点には、留意すべき裏面もあります。ワークフローを一つのプラットフォームに集約するほど、その多くを一つのベンダーに委ねることになります。これは上記でRoboflowに関して述べた、同じベンダーへの依存コストです。また、この比較の中では最も新しい選択肢です。Ultralytics Platformは2026年3月にリリースされた一方、CVAT、Labelbox、Roboflowには長年の本番運用実績があります。調達要件として実績の長さが重視される場合、この違いは現実的なものであり、考慮する必要があります。
V7#
概要。 詳細な画像および動画の作業に特化したアノテーションプラットフォームで、医用画像と科学画像に最も強みがあります。
最適な用途。 レビュアーの作業性がコストを大きく左右する、密度の高い高精度なアノテーションを作成するチーム。
自動化の仕組み。 自動アノテーションにより、わずかな入力から詳細なインスタンスアノテーションを生成し、動画フレーム間のトラッキングも行います。
強み。 精度を重視したツールと、難易度の高いセグメンテーション作業に定評のあるインターフェースです。
トレードオフ。 難しい画像に特化した機能は、単純な物体検出には不要な負担となります。
Voxel51 FiftyOne#
概要。 ビジョンデータセットとモデル予測の探索、キュレーション、デバッグに使うオープンソースのツールキットで、エンタープライズ版もあります。
最適な用途。 精度の問題がデータに起因しているものの、その原因をまだ特定できていないチーム。
自動化の仕組み。 予測と正解データを同じ画面に読み込むことで、損失による並べ替え、ラベルエラーや重複の検出、ラベルを付け直す対象データのエクスポートができます。
強み。 追加のラベリングでは解決できないデータセットの問題(誤ラベル、重複、クラス不均衡)の検出に、特に優れています。
トレードオフ。 キュレーションと分析のレイヤーです。アノテーションUIでもラベリングサービスでもありません。
自動ラベリングを支えるモデル#
ベンダーは自動化を機能としてアピールしますが、得られる品質は基盤となるモデルによって決まります。また、このトピックに関する検索結果を各エンジンが表示する際も、それらのモデルが直接取り上げられています。
Segment Anything(SAM)。 Metaのプロンプト対応セグメンテーションモデルは、点またはボックスのプロンプトからマスクを生成します。Ultralytics Platformの機能を含むスマートアノテーション機能を支える中核的なモデルで、オブジェクトの境界検出に優れています。ただし、クラス名は認識しません。セグメンテーションは実行しますが、セグメントが何であるかを判断するには別の仕組みが必要です。
オープンボキャブラリ検出器。 Grounding DINOファミリーのモデルは、テキストプロンプトからオブジェクトを検出できます。そのため、モデルが一度も学習していないクラスも事前アノテーションできます。新しいクラスリストの初期作成には便利ですが、語彙が公開ウェブ上のものと合わない、ドメイン固有の部品や欠陥では信頼性が下がります。
自社でファインチューニングしたモデル。 最初のモデルができた後は、自社のカメラ、照明、クラスを学習しているため、通常はそのモデルが自社データの事前アノテーションに最適です。これがループの効果を積み重ねる仕組みです。ラベリングを重ねるたびに、次のラウンドで使う事前アノテーションモデルが改善します。
実務上、自動化の効果はプロジェクトの進行とともに高まります。汎用モデルが最初の100枚をどの程度うまく事前アノテーションできるかだけでツールを評価すると、1万枚目での性能を過小評価することになります。
データセットの劣化を防ぎながらワークフローを運用する#
自動化はリスクを取り除くのではなく、リスクの所在を移します。レビュアーが確認せずに承認した事前アノテーション済みフレームは、注意深く確認したフレームと見分けがつきません。また、すでにボックスが描かれていると、確証バイアスが強く働きます。
自動化を拡大する前に導入しておきたい対策:
- 事前アノテーションを確認し、ただ承認するのは避けてください。 レビュアーには下書きを修正することが役割だと伝え、承認率が不自然に高い場合は監査してください。
- 手作業でラベル付けした評価セットを別に確保してください。 評価対象と同じモデルファミリーでテストセットを自動ラベリングすると、精度ではなく予測の一致度を測ることになります。
- サンプリングして再確認してください。 各ラウンドで、自動ラベリングを承認したデータからランダムに一部を抽出し、独立してゼロからラベルを付けます。不一致率が実際の品質を示す指標です。
- 自動化の精度が最も低いクラスに注意してください。 小さなオブジェクト、強い遮蔽、まれなクラスでは提案が失敗しやすく、見えにくいエラーも集中します。
- オントロジーを安定させるか、バージョン管理してください。 自動化は古いクラス定義を忠実に、しかも迅速に引き継ぎます。
- データの来歴を記録してください。 どのラベルがモデルの提案で、どのラベルが手作業で付けられたかを把握していれば、後から品質を調査しやすくなります。
自動化の費用対効果が下がるとき#
自動化の効果が最も高いのは、量が多く、視覚的に一貫していて、クラスが明確なデータです。早めに認識しておきたい、効果が最も低い状況は3つあります。
1つ目は、本当に新しいクラスです。部品、欠陥、イベントを概念として認識できるモデルがなければ、事前アノテーションでノイズが生まれ、レビュアーは本来の作業に取りかかる前にノイズを除去しなければなりません。まず数百件を手作業でラベル付けしてモデルをトレーニングし、その後、自社モデルで事前アノテーションしてください。
2つ目は、専門家の判断が必要なケースです。何かを欠陥とみなすべきかどうかの判断が難しい場合、ボトルネックは描画ではなく判断です。自動化しても、有資格の検査員2人の見解の相違を解消する時間は短縮できません。
3つ目は、データセットがすでに十分大きいケースです。一定の規模を超えると、同じシーンのラベルを増やしても精度は向上しなくなり、制約はデータの多様性に移ります。これはデータ選定の問題です。そこに自動ラベリングの処理能力を追加しても、冗長なラベルをより速く生成するだけです。
よくある質問
どちらの課題を抱えているかによって異なります。Ultralytics YOLOモデルをトレーニングするチームには、Ultralytics PlatformがSAMベースのSmart Annotationとトレーニングを同じループ内にまとめます。開発者主導のワークフローにはRoboflow、セルフホスト型ワークフローにはCVATがそれぞれ有力です。一方、エンタープライズ向けのレビュ―ガバナンスや、難しい動画・医用画像を重視する場合は、Labelbox、Encord、SuperAnnotate、V7が有力です。
専用設計の選択肢はLightlyとVoxel51 FiftyOneです。Lightlyは大規模なラベルなしデータプールから埋め込みベースでデータを選定する用途、FiftyOneはキュレーションとエラー検出に適しています。複数のアノテーションプラットフォームも、プロジェクト内で不確実性ベースまたはモデル主導の優先順位付けを提供します。これは便利ですが、専用の選定レイヤーより対象範囲は限られます。
通常、セグメンテーション形式の提案にはSAM、テキストプロンプトから新しいクラスの初期ラベルを作成するにはGrounding DINOファミリーなどのオープンボキャブラリ検出器、モデルができた後は自社でファインチューニングしたモデルを使います。通常、3つ目の選択肢が自社データの事前アノテーションに最適です。
いいえ。レビュアーの作業が、描画から修正に変わります。人によるレビューを完全になくすと、モデルの誤りが検証されないままトレーニングセットに入り、次のラウンドでさらに強化されます。
低下する可能性があります。もっとも具体的な失敗は、レビュアーが妥当に見える提案を確認せずに承認することです。対策は、自動化を一度も通していない手作業ラベル付き評価セットを用意することと、定期的にランダムサンプルを独立して再ラベリングし、実際の不一致を測定することです。
多くの場合は可能ですが、運用できることが条件です。SAMモデルを配信するCVATと、カスタムMLバックエンドを備えたLabel Studioは、どちらも十分な事前アノテーション機能を提供します。ライセンス費用を抑える代わりに、モデルサービングの運用とレビューのワークフロー設計が必要になります。
まず選択し、その後にアノテーションします。アクティブラーニングでラベル付けする価値のあるフレームを選び、その対象に自動ラベリングを適用します。ラベルのないデータ全体に自動化を実行すると、モデルに影響しなかったフレームに対しても、計算リソースとレビュアーの時間を費やすことになります。









