Ultralytics YOLO26が単眼深度推定に対応しました
Ultralytics YOLO26の新しい深度推定タスクでは、ステレオカメラやLiDARを使わず、単一のRGB画像からピクセル単位のメートルスケール深度を推定できます。
これまでは、YOLOパイプラインに深度情報を追加するには、自分で組み立てる必要がありました。一般的な方法は、YOLOで物体検出を行い、MiDaSやDepth Anythingなど、別のプロジェクトの深度モデルと組み合わせることでした。そのため、依存関係とフレームワークがもう一つ増え、2種類の入出力形式を調整する必要がありました。
単眼深度推定が、Ultralytics YOLO26のネイティブタスクになりました。単一のRGB画像から、物体検出、セグメンテーション、ポーズと同じパッケージ、ワークフロー、エクスポートパスを使って、すべてのピクセルの距離値を取得できます。
深度推定とは何ですか?#
深度推定は、2台目のカメラや追加センサーを使わず、単一のRGB画像からピクセル単位の深度マップを予測します。出力の各ピクセルには、カメラからその表面上の点までの推定距離を表す、メートル単位の深度値が含まれます。
出力は、入力画像に位置合わせされた(H, W)形状の高密度な浮動小数点マップです。すべてのピクセルにメートル単位の絶対距離が格納されており、近いものと遠いものの相対的な順序ではなく、カメラからの距離を示します。
深度推定は専用のチェックポイントを持つ独立したタスクで、出力は深度マップのみです。バウンディングボックスやセグメンテーションマスクは返しません。そのため、物体検出と深度推定を組み合わせるには、2つのモデルを実行し、2回のフォワードパスを行う必要があります。従来の方法と異なるのは、両方が1つのパッケージに含まれ、1回のインストール、1つのトレーニング・推論インターフェース、1つのエクスポートパス、1つのバージョン管理を共有できる点です。1つ目のフレームワークに加えて2つ目のフレームワークを保守する必要はありません。
ピクセル単位の出力により、深度情報は障害物やフリースペースの検出、クリアランスの確認、シーンのレイアウト把握、物体の前後関係の理解に役立ちます。
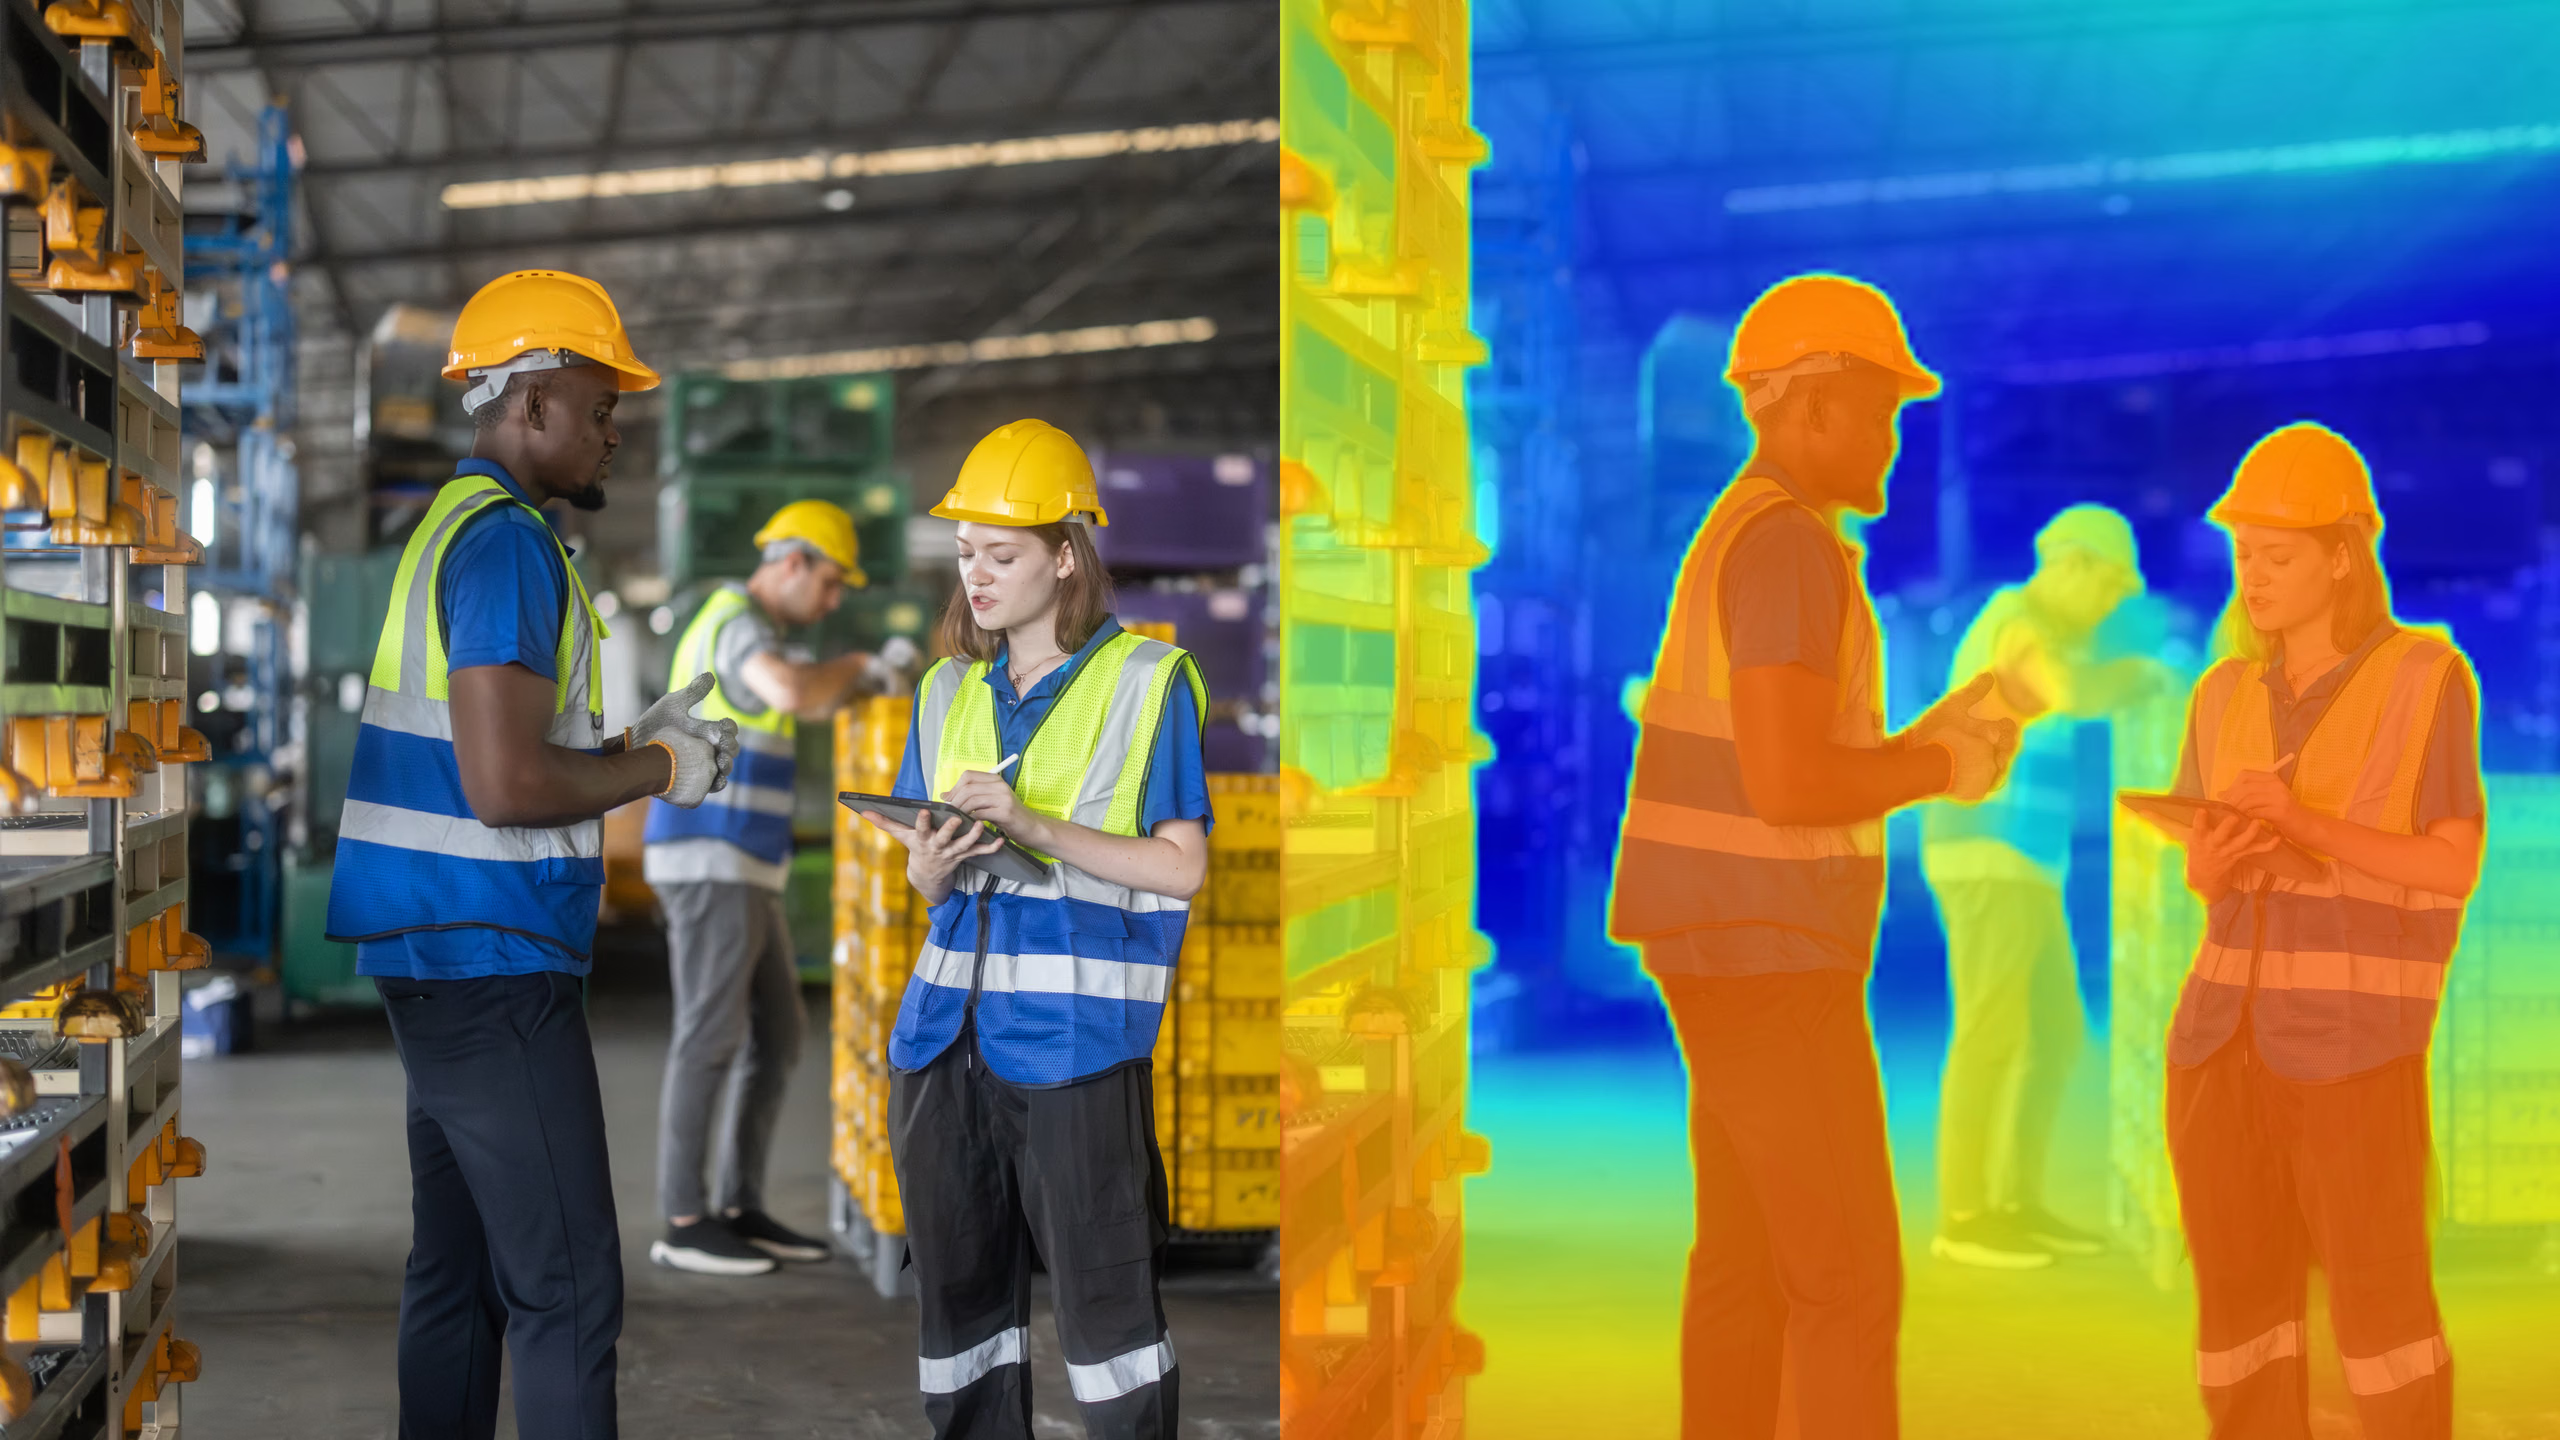 図1. 安全およびコンプライアンスの監視に向けたUltralytics YOLO26の深度推定。
Ultralytics YOLO26には、yolo26n-depthからyolo26x-depthまで、5種類の学習済み深度モデルが用意されています。約219万枚の屋内外画像にわたる、複数のデータセットを幅広く組み合わせて学習しています。NYU Depth V2データセットでは、nanoモデルのδ1精度0.882からextra-largeモデルの0.933までの性能を示すため、デプロイ先に適した速度と精度のトレードオフを選べます。
設計段階から上限のない深度推定#
多くの深度モデルは、予測範囲を0~10メートルなどの固定範囲に制限しています。これは屋内シーンでは問題ありませんが、屋外ではうまく機能しません。Ultralyticsは、固定の上限を設けず、開放型の対数スケールで深度を予測します。
この違いはテスト結果に表れます。屋内外のデータを混合して学習した上限付きモデルは、ほぼすぐに性能が頭打ちになり、物体が80メートル先にある場合もあるKITTIのような長距離データセットでは性能が大きく低下します。Ultralytics YOLO26の方式にはそのような上限がないため、データを増やすほど性能が向上し、数センチメートルから数百メートルまで対応できます。KITTIでは、距離範囲80 mでδ1が0.942に達します。つまり、1つのモデルファミリーで卓上シーンにも高速道路のシーンにも同じように対応できます。
Ultralytics YOLO26の深度推定とDepth Anything V2の比較#
現在、YOLOと併せてDepth Anythingを実行している場合、違いは速度と、それに伴う計算コストです。Ultralytics YOLO26の深度推定は、nanoモデルで1,000万未満のパラメーター数というはるかに小さなモデルでありながら、Depth Anything V2 Baseより最大20.3倍、Depth Anything V2 Smallより最大7.7倍高速に動作します。Depth Anything V2の小さい方のチェックポイントは約2,400万パラメーターです。
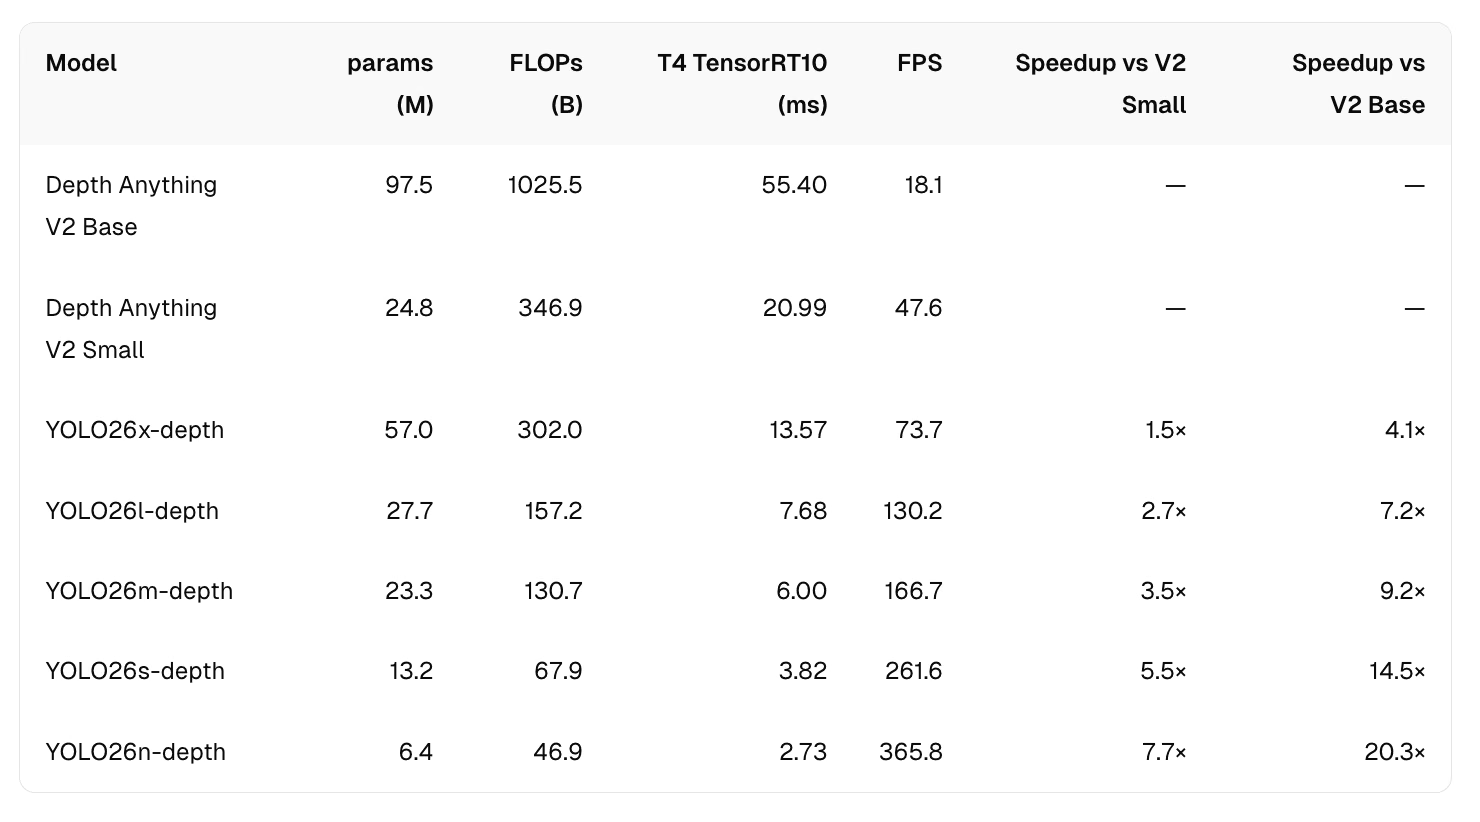 図2. Ultralytics YOLO26の深度推定とDepth Anything V2の速度ベンチマーク。
この差こそが設計の狙いです。Depth Anything V2のモデルは大幅に大きくなっています。一方、Ultralytics YOLO26-Depthは、1フレームあたりの計算コストを抑えたサイズと速度で高い深度推定性能を実現し、Depth Anything V2のモデルでは対応できないハードウェアにもデプロイできるよう設計されています。NYU Depth V2とKITTIにおけるモデルごとの精度はドキュメントで公開しているため、実際の要件と照らし合わせて確認できます。
動作環境#
このサイズの違いによって、深度推定を実際にどこで利用できるかが決まります。深度推定を検討している多くのチームは、アイデアが足りないのではなく、計算リソースが不足しています。低消費電力のドローン、四足歩行ロボット、ウェアラブル端末、ドライブレコーダー、会議用ハードウェア、産業用PCでは、精度の限界に達する前に電力とコストの上限に達してしまいます。
深度推定には5種類の学習済みモデルが用意されているため、ベンチマークで最も優れたサイズではなく、デプロイ先に適したサイズを選べます。深度推定はUltralytics YOLO26のネイティブタスクであるため、検出、セグメンテーション、姿勢推定と同じエクスポート手順で、次の形式に対応します: ONNX、TensorRT、CoreML、NCNN、LiteRT。
Ultralytics YOLO26の深度推定を始める#
Ultralytics Pythonパッケージは、深度推定を含むYOLO26のすべてのタスクにわたって、学習、検証、推論を実行するための統一インターフェースを提供します。学習済み深度モデルは、次の1つのコマンドで実行できます:
from ultralytics import YOLO
from ultralytics import YOLO

# モデルを読み込む
model = YOLO("yolo26n-depth.pt")  # 公式モデルを読み込む
model = YOLO("path/to/best.pt")  # カスタムモデルを読み込む

# モデルで予測する
results = model("https://ultralytics.com/images/bus.jpg")  # 画像を入力して予測する

# 結果にアクセスする
for result in results:
    depth_map = result.depth.data.cpu().numpy()  # torch.Tensor → NumPy float32、形状 (H, W)、単位はメートル
またはCLIから:
yolo depth predict model=yolo26n-depth.pt source='https://ultralytics.com/images/bus.jpg'  # predict with official model
yolo depth predict model=path/to/best.pt source='https://ultralytics.com/images/bus.jpg'   # predict with custom model
絶対距離はカメラとシーンによって異なります。深度マップの形状は正しいもののスケールが合わない場合、model.calibrate()はラベル付きフレーム約100枚を使って、モデルの深度ヘッドにある2つの変数(スケールとオフセット)だけを数秒で調整します。追加学習は不要で、ネットワークの他の部分にも変更を加えません。
独自データでのファインチューニング#
学習済み深度モデルを独自のカメラやドメインに適応させるには、学習済み重みから開始し、AdamWを使用して、スクラッチ学習時のデフォルトより学習率を大幅に下げます。これにより、モデルを上書きするのではなく、微調整できます:
from ultralytics import YOLO
from ultralytics import YOLO
model = YOLO("yolo26s-depth.pt")  # 学習済み重みから開始
model.train(
    data="path/to/your_dataset.yaml",
    epochs=20,
    imgsz=640,
    optimizer="AdamW",
    lr0=1e-4,  # スクラッチ学習時のデフォルトの約100分の1
    warmup_bias_lr=1e-4,  # ウォームアップも緩やかにする
)デフォルトの対数ヘッドには上限がないため、データセットが近距離でも長距離でも、max_depthの調整なしですぐに利用できます。特定のカメラで絶対スケールだけが合わない場合は、model.calibrate()を使うと、少量のラベル付きデータで軽量な閉形式の補正を数秒で行えます。ネットワークの重みは変更しません。
データセットでは、各RGB画像に対応する.npy深度ファイルを、同じフォルダー構造で配置します。UltralyticsにはNYU Depth V2、KITTI、Hypersim、SUN RGB-D、ARKitScenes向けの設定が組み込まれているため、多くのチームは標準ベンチマークで直ちに検証を始められます。
深度推定の主なユースケース#
この新機能は一般的なカメラ1台で利用できるため、単眼深度推定は、ステレオカメラやLiDARの導入に伴うコスト、消費電力、キャリブレーションの負担を正当化できない製品や業界にも、多くの機会をもたらします。この機能を活用できる主な業界とユースケースを見ていきましょう:
- ロボティクスと自律ナビゲーション。移動ロボットやドローンは、搭載カメラ1台で障害物までの距離と空きスペースを推定できるため、専用の深度センサーを使わずにリアルタイムの経路計画を支援できます。
- 産業および物流の状況把握。固定カメラ1台で、クリアランス確認、空きスペース検出、棚や通路の状況把握を実現できます。2台目のセンサーを追加するのが現実的でない場所にも適しています。
- 安全およびコンプライアンスの監視。フォークリフトや倉庫の安全区域、鉄道事故の検出、既存のCCTVを使った転倒者や置き去り物の検出など、すでに設置されているカメラ映像に距離情報を追加できます。既存の安全認証済みセンサーに取って代わるのではなく、それらと併用します。
- インフラおよび設備の点検。架空線のクリアランス分析、ドローンによる設備や腐食の点検、航空測量など、近距離の細部から長距離のシーンまで同じモデルファミリーで扱う必要がある用途に適しています。
- 運転支援と自動車向け認識。上限のない長距離深度出力により、近距離の屋内シーンに対応する同じモデルファミリーを、80 m以上の運転シーンにも汎化できます。
- ARと空間コンテンツ。仮想オブジェクトを現実のシーンに自然に配置したり、深度を考慮したエフェクトを適用したりするには、各ピクセルがカメラから実際にどれだけ離れているかを把握する必要があります。
あらゆるUltralytics YOLO26のデプロイ先に深度推定を導入#
深度推定がUltralytics YOLO26のネイティブタスクになったことで、チームは業界を問わず、あらゆるRGBカメラからピクセル単位の距離情報を活用できます。検出、セグメンテーション、姿勢推定でおなじみの学習、検証、予測、エクスポートのワークフローをそのまま利用でき、保守が必要なサードパーティ依存関係も1つ減ります。
Ultralytics YOLO26の深度推定を使ったデプロイを検討する際に、押さえておきたいポイントをいくつか見ていきましょう:
- Ultralytics YOLO DepthはRGBカメラ向けに構築されています。ウェブカメラ、スマートフォン、産業用カメラ、ドローンなど、一般的なカメラであれば利用できます。一方、LiDARの点群、レーダー、ソナー、熱画像やマルチスペクトルバンド、メッシュやIFCデータなどのモダリティは、モデルの入力形式の対象外です。
- 知覚に基づく判断に使える距離情報。出力はメートル単位の実距離であり、ナビゲーション、クリアランス、監視に適しています。ただし、認証済みの許容誤差が必要な用途では、専用の計測機器が引き続き適切な手段です。
- 画像ごとの推論。深度推定は他のUltralytics YOLO26タスクと同様、各フレームを個別に処理するため、既存のフレーム単位のパイプラインに変更なしで組み込めます。シーケンス全体にわたる推論は、アプリケーション層で処理します。
- Ultralytics YOLO26-Depthは、テクスチャがあり不透明な表面で特に高い性能を発揮します。ガラス、鏡、水たまり、磨かれた金属、開けた空は、単眼方式では本質的に曖昧さが生じるため、実際の環境を代表するシーンで検証することをお勧めします。
ビジョンAIに関心がありますか?ライセンスオプションを確認して、コンピュータービジョンをプロジェクトに導入しましょう。GitHubリポジトリでは、Ultralyticsの幅広いタスクとインテグレーションを確認できます。また、Ultralytics Platformで、エンドツーエンドのビジョンAIワークフローの構築を始めましょう。









