Bilgisayarlı görü modellerinin üretimde başarısız olmasının 5 nedeni
Veri uyumsuzluğundan gecikmeye kadar bilgisayarlı görü modellerinin üretimde neden başarısız olduğunu ve ekiplerin gerçek dünya görüntü yapay zekâ sistemlerinde model performansını nasıl artırabileceğini öğren.
 Abirami Vina8 dakikalık okuma
Bilgisayarlı görü, makinelerin çeşitli görevler için görsel verileri yorumlamasını ve analiz etmesini sağlayan, artık çoğu sektörde benimsenen temel bir yapay zekâ teknolojisidir. Bu sistemler tıbbi görüntüleme ve robotikten üretim ve perakende otomasyonuna kadar birçok gerçek dünya uygulamasını destekler.
Ancak bilgisayarlı görü sistemi geliştirmek her zaman kolay değildir. Genellikle nesne algılama ve izleme gibi görevleri desteklemek üzere görüntülerdeki ve videolardaki örüntüleri belirlemek için eğitilen bir görsel yapay zekâ modeli geliştirmeyi gerektirir.
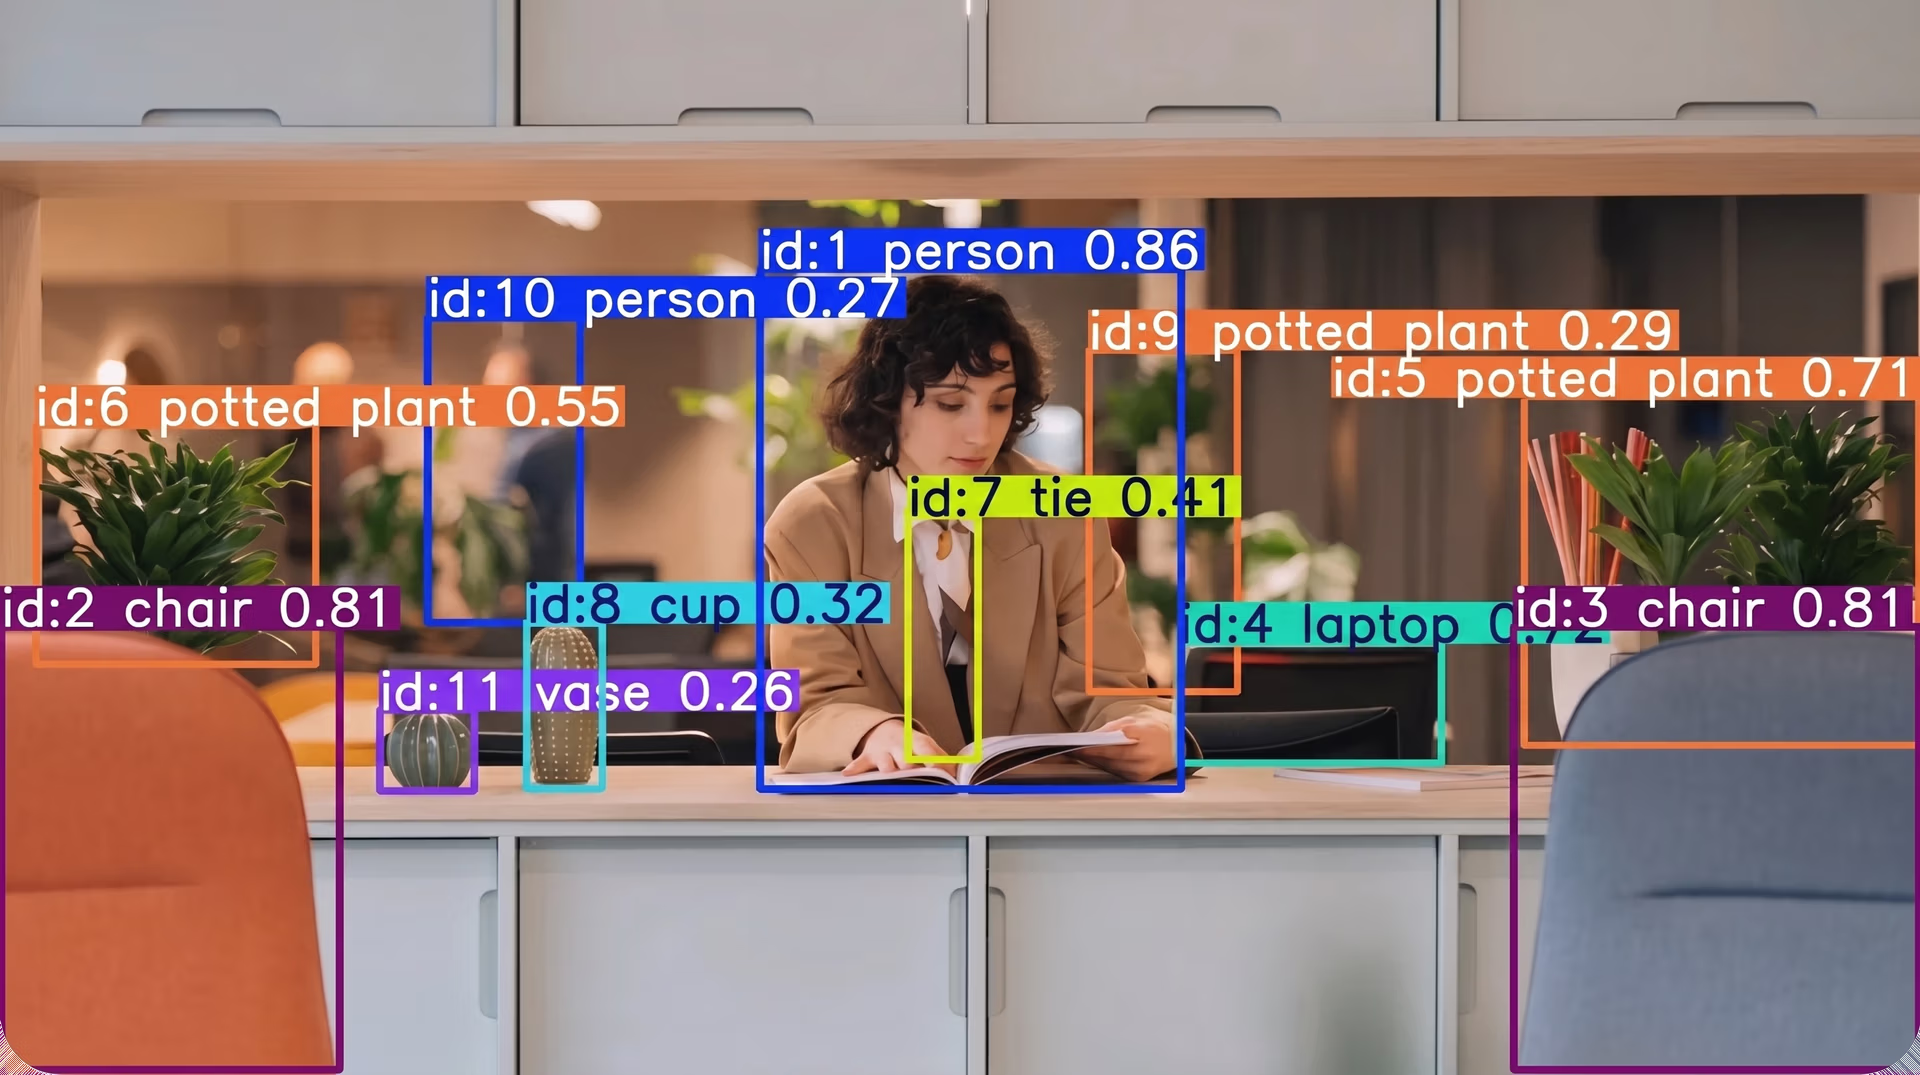
Şekil 1. Nesne algılama ve izleme örneği (Kaynak)
Yıllar içinde daha gelişmiş hâle gelmelerine rağmen bilgisayarlı görü modelleri, geliştirme sırasında gerçek dünya ortamlarında dağıtıldıktan sonra gösterdiklerinden farklı davranabilir. Bunun nedeni, modellerin kontrollü geliştirme ortamlarının dışında dağıtılmasının yeni ve çoğu zaman beklenmedik zorluklar ortaya çıkarmasıdır.
Veri kümelerindeki çeşitlilik eksikliği, yetersiz model izleme ve altyapı kısıtları gibi etkenler, aynı modelin dağıtım sonrasında gerçek dünyada farklı davranmasına neden olabilir.
Bu makalede, bilgisayarlı görü modellerinin üretim ortamında başarısız olmasının beş yaygın nedenini inceleyeceğiz.
Model eğitimi ile üretim arasındaki boşluk#
Model eğitimi genellikle kontrollü bir ortamda gerçekleştirilir. Bu aşamada yapay zekâ geliştiricileri, özenle hazırlanmış eğitim veri kümeleriyle çalışır.
Bu geniş görsel veri koleksiyonları, her görüntünün içeriğini açıklayan iyi yapılandırılmış açıklamalar veya etiketler içerir. Eğitim ayrıca tutarlı koşullarda gerçekleştirilir; böylece görsel yapay zekâ modelleri görsel örüntüleri etkili bir şekilde öğrenebilir.
Bu örüntülerin doğru öğrenildiğinden emin olmak için modeller, geliştirme sırasında standart değerlendirme metrikleri ve kıyaslama veri kümeleri kullanılarak sistematik biçimde değerlendirilebilir. Eğitim veri kümeleri gibi bu kıyaslama veri kümeleri de özenle hazırlanır.
Ancak gerçek dünyadaki bilgisayarlı görü sistemlerinin karşılaştığı veriler, eğitim ve değerlendirme sırasında kullanılan verilerden çok farklı olabilir. Dağıtıldıktan sonra bu modeller nadiren kontrollü koşullarda çalışır.
Modeller; ışığın sürekli değiştiği, kamera açılarının kaydığı ve arka planların zaman içinde farklılaştığı, öngörülemeyen ortamlardaki görüntü ve videoları işlemek zorunda kalabilir. Örneğin, öncelikle gündüz çekilmiş görüntülerle eğitilip değerlendirilen trafik algılama amaçlı bir görsel yapay zekâ modeli, geceleri araçları algılamakta zorlanabilir.
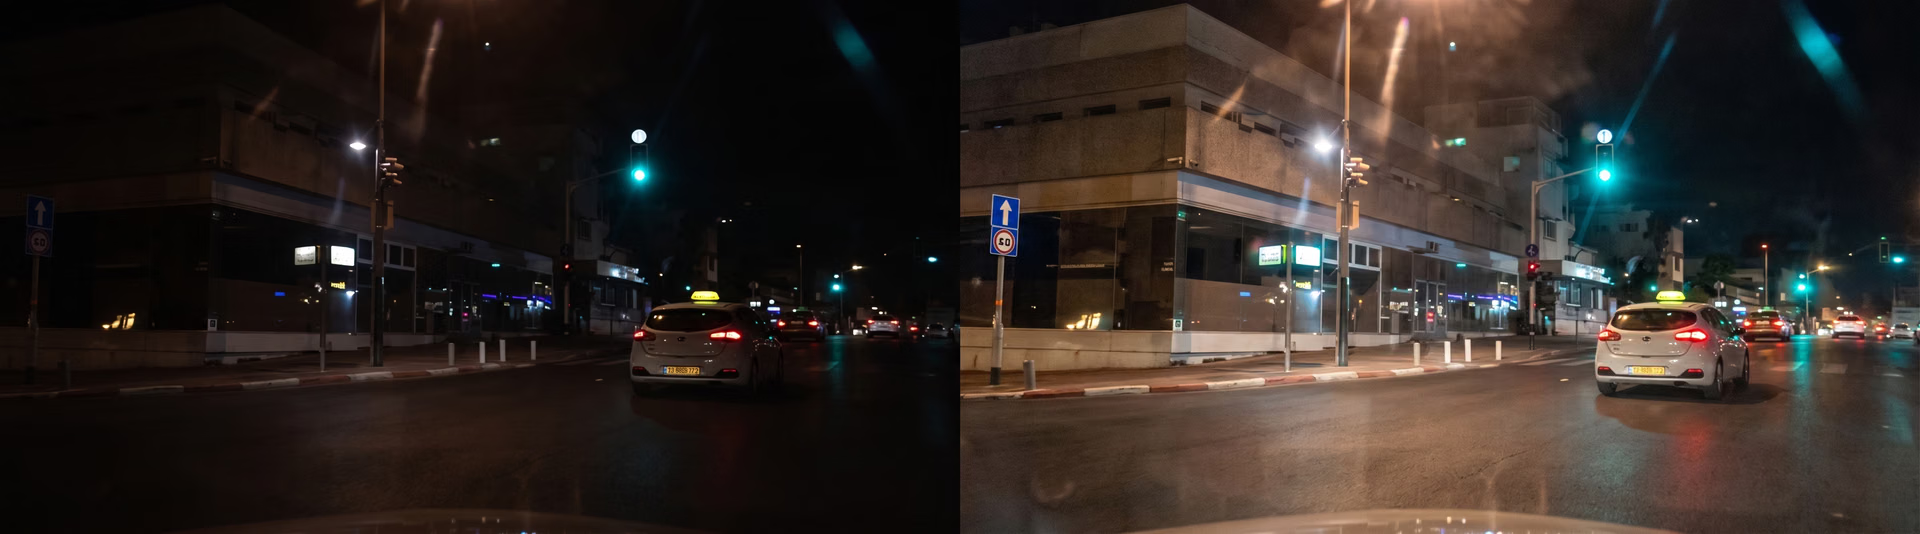
Şekil 2. İyileştirme uygulandıktan sonra bile gece görüntülerini yorumlamak, gündüz görüntüleriyle eğitilen modeller için zordur. (Kaynak)
Geliştirme ile gerçek dünyadaki dağıtım arasındaki bu farka eğitim-üretim boşluğu denir. Bu boşluk nedeniyle model hataları çoğu zaman ancak dağıtımdan sonra görünür hâle gelir; bu da daha güvenilir ve sağlam bilgisayarlı görü sistemleri geliştirmek için laboratuvardan üretime geçiş yolunu erkenden anlamayı önemli kılar.
Bilgisayarlı görü modellerinin üretimde başarısız olmasının 5 yaygın nedeni#
Şimdi, bilgisayarlı görü modellerinin üretimde başarısız olmasının beş yaygın nedenine daha yakından bakalım.
1. Düşük kaliteli eğitim veri kümeleri#
Veri kümeleri, bilgisayarlı görü modellerinin eğitiminde merkezi bir rol oynar; çünkü modelin eğitim sırasında ne öğrendiğini ve dağıtım sonrasında gerçek dünyadan gelen girdilere nasıl tepki verdiğini belirler. Bu, özellikle her görüntünün neyi temsil ettiğini gösteren etiketli örneklerden öğrenen denetimli öğrenme için önemlidir.
Evrişimli sinir ağları (CNNs) dahil birçok derin öğrenme modeli, görsel verilerdeki örüntüleri tanımak için bu etiketli örneklere dayanır. Ancak eğitim veri kümesi gerçek dünya koşullarını yansıtmadığında model, nesnelerin eğitim verileri dışında nasıl göründüğünü tam olarak temsil etmeyen örüntüler öğrenebilir.
Örneğin, büyük çatlak kusurlarından oluşan bir veri kümesiyle eğitilen bir model, gerçek dünya üretim iş akışlarında nadir görülen küçük bir çatlak türünü algılayamayabilir. Benzer şekilde, açıklama kalitesi de model davranışını etkileyebilir. Etiketli verilerdeki tutarsız etiketler veya eksik ayrıntılar, modelin eğitim sırasında yanlış bilgiler öğrenmesine neden olabilir.
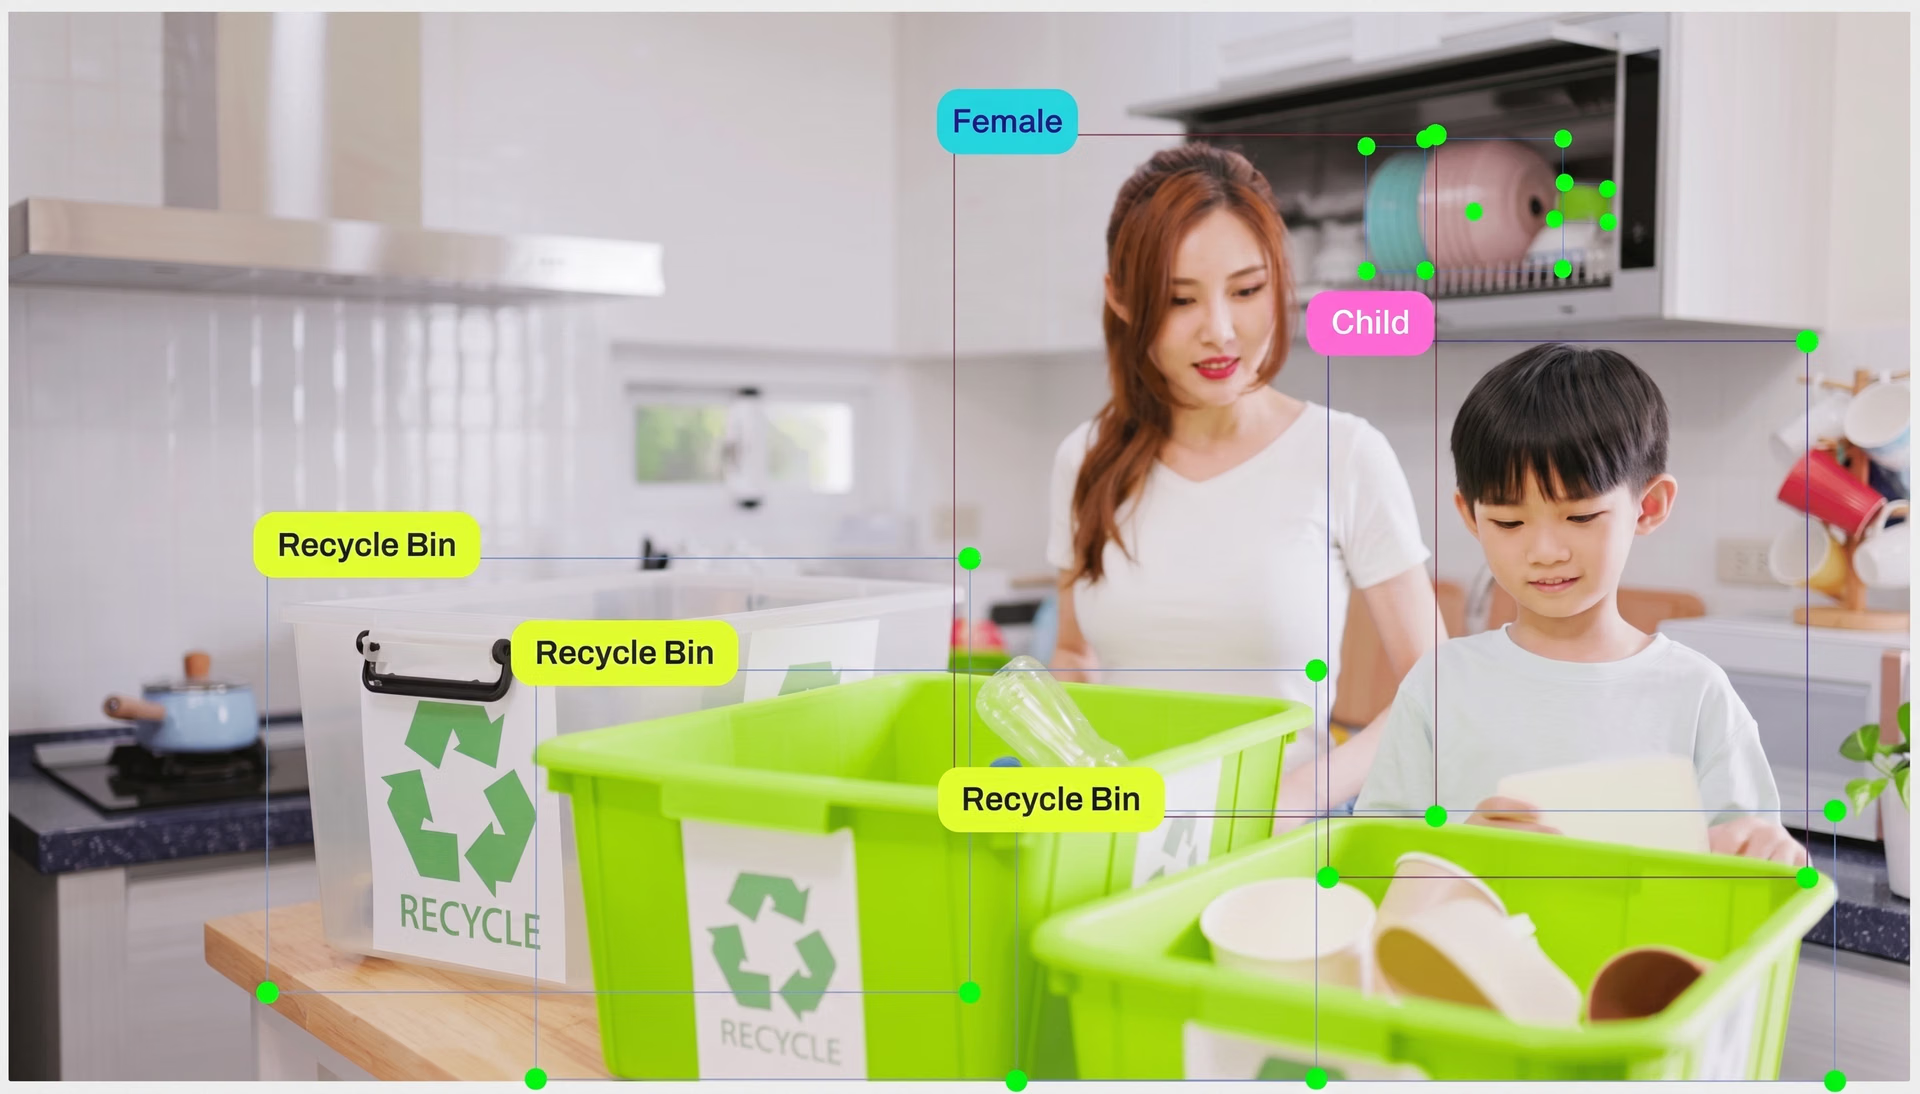
Şekil 3. Görüntü açıklamalarına bir bakış (Kaynak)
Genel olarak, eğitim verilerinin kalitesi ve çeşitliliği kritik öneme sahiptir ve bir modelin gerçek dünya uygulamalarındaki performansını belirleyebilir. Veri kümeleri temsil edici ve doğru etiketlenmiş olduğunda model, dağıtım sonrasında genellikle daha güvenilir performans gösterir.
2. Aşırı öğrenme ve genelleme#
Görsel modeller gibi makine öğrenimi modelleri, eğitim veri kümelerinden örüntüler öğrenir. Ancak bazen bir model birkaç örüntüye gereğinden fazla dayanabilir.
Daha genel görsel ilişkileri öğrenmek yerine, eğitim verilerindeki sınırlı örüntüleri ezberleyebilir. Bu davranış aşırı öğrenme olarak bilinir.
Aşırı öğrenme genellikle eğitim veri kümeleri küçük olduğunda veya yeterli veri çeşitliliği içermediğinde ortaya çıkar. Böyle durumlarda model, daha önce gördüğü görüntüleri tanımakta başarılı olur ancak yeni verileri veya alışılmadık girdileri yorumlamakta zorlanır.
Sonuç olarak bir model, test verileri eğitim verilerine benzediği için bu verilerde iyi performans gösterebilir ancak dağıtımdan sonra yeni koşullarda farklı davranabilir. Genelleme kavramının önemli olmasının nedeni budur. Basitçe ifade etmek gerekirse genelleme, modellerin eğitim sırasında öğrendiklerini yeni senaryolara ne kadar iyi uygulayabildiğini gösterir.
Aşırı öğrenmeyi azaltmak için uygulayıcılar çoğunlukla modelleri daha çeşitli veri kümelerinde eğitir ve verilerde daha fazla çeşitlilik oluşturmak amacıyla eğitim görüntülerini hafifçe değiştiren bir yöntem olan veri artırmayı uygular. Bu noktalar göz önünde bulundurulmazsa sistem gerçek dünya ortamlarında çalışmaya başladığında model performansı hızla düşebilir.
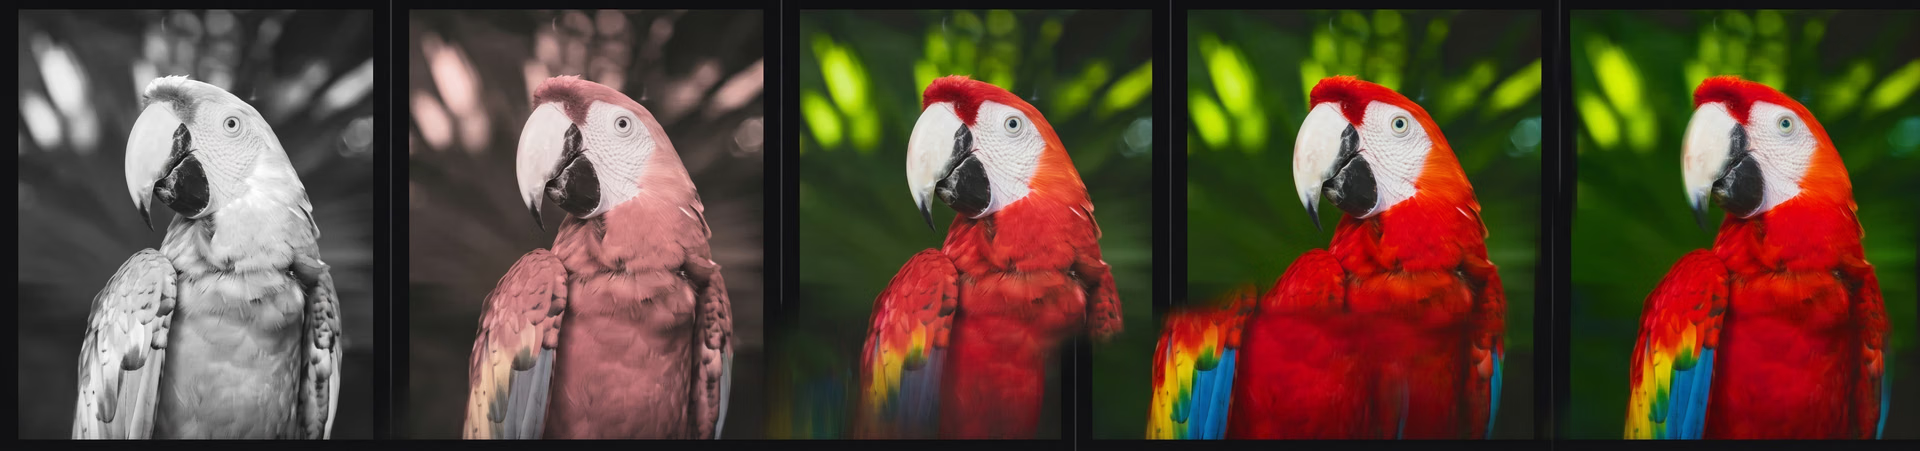
Şekil 4. Veri artırma, bir veri kümesinde aynı görüntünün farklı biçimlerini oluşturmaya yardımcı olabilir. (Kaynak)
3. Gerçek dünya ortamlarındaki gizli uç durumlar#
Bilgisayarlı görü modelleri yeni verilere iyi genelleme yapsa bile gerçek dünya ortamlarında beklenmedik uç durumlarla karşılaşılabilir. Bunlar, modelin eğitim sırasında öğrendiği tipik örüntülerden farklı, sıra dışı durumlardır.
Bu senaryoların çoğunu geliştirme sırasında yakalamak zordur; çünkü nadiren ortaya çıkar, yeniden oluşturulmaları güçtür veya eğitim verisi olarak toplanmaları pahalı olabilir. Örneğin nesneler alışılmadık şekillerde görünebilir, öngörülemeyen biçimde hareket edebilir veya başka nesnelerin arkasında kısmen gizlenebilir.
Işık, kamera açıları veya arka plan koşullarındaki değişiklikler de tanımayı zorlaştıran durumlara yol açabilir. Bu uç durumlar genellikle ancak sistem gerçek dünya uygulamalarında dağıtıldıktan sonra fark edilir.
Örneğin robotik ve üretim otomasyonunda öğeler beklenenden farklı yerleştirilebilir veya konumlandırılabilir; bu da modelin ele alması için tasarlanmadığı durumlar yaratır. Sonuçta test sırasında güvenilir görünen tahminler, sistem gerçek dünya ortamlarında çalışmaya başladığında daha tutarsız hâle gelebilir.
4. Dağıtım sonrası izleme ve hata ayıklama eksikliği#
Görsel yapay zekâ modeli geliştirmenin yanı sıra model performansını izlemek ve iyileştirmek de önemlidir. Ancak sistem çalışmaya başladıktan sonra odak, zaman içindeki performansını yakından takip etmek yerine çoğu zaman sistemi yalnızca çalışır durumda tutmaya kayar. Bunun sonucunda model davranışındaki değişiklikler fark edilmeyebilir.
Aynı zamanda gelen verilerdeki değişiklikler, kamera düzenleri veya çalışma ortamları gibi etkenler modelin nesneleri ne kadar doğru tespit ettiğini ya da sınıflandırdığını zamanla etkileyebilir. Bu değişiklikler her zaman belirgin değildir ve günlük operasyonlar sırasında fark edilmeyebilir.
Model çıktılarının ve genel sistem davranışının izlenmesi, ekiplerin bu sorunları daha erken belirlemesine yardımcı olabilir. Düzenli kontroller, doğrulama rutinleri ve hata ayıklama iş akışları, ekiplerin olağan dışı sonuçları incelemesini ve bunlara neyin yol açmış olabileceğini anlamasını sağlar.
Üretim gibi alanlarda, kamera yapılandırmasındaki bir değişikliğin ardından model montaj hattındaki nesneleri aniden yanlış tanımlayabilir. Dağıtılmış bir görsel yapay zekâ sisteminin davranışını takip etmek, bu değişikliklere daha kolay yanıt vermeyi ve gerçek dünya ortamlarında istikrarlı performansı korumayı sağlar.
5. Altyapı kısıtları ve gecikme#
Birçok bilgisayarlı görü sisteminin gerçek zamanlı çalışması gerekir; bu da donanım, ağlar ve işleme hatları üzerinde ciddi baskı oluşturabilir. Kaynaklar kısıtlı olduğunda hesaplama gecikmeleri veya ağ gecikmesi yaşanabilir; bu da tahminlerin çok geç ulaşmasına ve genel sistem performansının etkilenmesine neden olur.
Bazı durumlarda gelişmiş derin öğrenme modelleri de altyapı sorunları yaratabilir. Örneğin Transformer tabanlı mimariler, büyük miktarda görsel veriyi işlemek ve görüntüler içindeki karmaşık ilişkileri öğrenmek üzere tasarlanmıştır; ancak çoğu zaman önemli ölçüde hesaplama kaynağı gerektirir. Bu modelleri çalıştırmak daha güçlü veya daha pahalı donanımlar gerektirebilir.
Uygun optimizasyon yapılmadığında, test sırasında hızlı çalışan modeller bile dağıtımdan sonra yavaşlayabilir veya tutarsız davranabilir. Ekipler bu sorunu çözmek için genellikle işlem hatlarını optimize eder, mümkün olduğunda model karmaşıklığını azaltır ve doğruluk ile hız arasında denge kurar.
Bunun için büyük modelleri daha hafif sürümlere sıkıştırmak, daha verimli mimariler kullanmak veya sistemin mevcut donanımda sorunsuz çalışması için görüntüleri daha düşük çözünürlükte işlemek gerekebilir. Çoğu durumda ekipler dağıtım kısıtlarını karşılamaya yardımcı olması için Ultralytics YOLO26 gibi hafif ve hızlı modelleri de tercih eder.
Bilgisayarlı görü modeli hatalarını önlemeye yönelik en iyi uygulamalar#
Bilgisayarlı görü modellerini üretime dağıtırken hataları azaltmaya yardımcı olabilecek bazı en iyi uygulamalar şunlardır:
- Aşamalı dağıtım stratejileri kullan: Ekiplerin model davranışını gözlemleyip gerektiğinde ayarlamalar yapabilmesi için modelleri üretime kademeli olarak dahil et.
- Geri bildirim döngüleri oluştur: Modelleri güncellenmiş veri kümeleriyle yeniden eğitmek ve zaman içinde performansı iyileştirmek için yeni görüntüler topla ve hatalı tahminleri incele.
- Model sınırlamalarını belgele: Dağıtım sırasında olası sorunları öngörebilmeleri için modelin zorlanabileceği durumları ekiplerin açıkça kaydetmesini sağla.
- Gerçek dünyadaki değişkenlik için tasarla: Aydınlatma, kamera açıları, nesne yerleşimi veya arka plan koşullarındaki farklılıkları önceden planlamak, modellerin farklı çalışma senaryolarında kararlı kalmasına yardımcı olabilir.
Önemli çıkarımlar#
Bilgisayarlı görü modelleri, algoritmaların kendisi zayıf olduğu için nadiren başarısız olur. Çoğu durumda asıl zorluk, bu sistemlerin çalıştığı ortamlardan kaynaklanır. Eğitim sırasında iyi performans gösteren modeller, davranışlarını etkileyebilecek öngörülemeyen gerçek dünya koşullarıyla sıklıkla karşılaşır.
Bu nedenle güvenilir görsel yapay zekâ sistemleri geliştirmek, yalnızca bir modeli eğitmekten fazlasını gerektirir. Ayrıca veri kümelerini özenle hazırlamayı, dağıtım sonrasında model performansını izlemeyi ve sistemleri gerçek dünya koşullarına sürekli uyarlamayı da içerir.
Görsel yapay zekâyı daha yakından keşfetmek ister misin? Topluluğumuza katıl ve otomotivde yapay zekâ ile lojistikte bilgisayarlı görü gibi uygulamalar hakkında bilgi edin. Bilgisayarlı görü projelerine başlamak için lisans seçeneklerimize göz at. Daha fazla bilgi için GitHub depomuzu ziyaret et.
Yazan
İçerik Üreticisi · Ultralytics
Yorumlar
Soru sor, sonuçlarını paylaş veya başka birine yardım et.









