Florence-2: Model thị giác-ngôn ngữ mới nhất của Microsoft
Tìm hiểu Florence-2, model thị giác-ngôn ngữ của Microsoft dùng cho phát hiện đối tượng, phân đoạn, tạo chú thích và định vị đối tượng, với hiệu năng zero-shot mạnh mẽ.
 Abirami Vina11 phút đọc
Vào tháng 6 năm 2024, Microsoft giới thiệu Florence-2, một model thị giác-ngôn ngữ đa phương thức (VLM) được thiết kế để xử lý nhiều tác vụ, bao gồm phát hiện vật thể, phân đoạn, tạo chú thích hình ảnh và định vị theo mô tả. Florence-2 thiết lập chuẩn mới về hiệu năng zero-shot, nghĩa là model có thể thực hiện tác vụ mà không cần huấn luyện trước cho tác vụ cụ thể, đồng thời có kích thước nhỏ hơn các model thị giác-ngôn ngữ tiên tiến khác.
Florence-2 không chỉ là một model nữa. Tính linh hoạt và hiệu năng được cải thiện của model có tiềm năng tạo tác động đáng kể đến nhiều ngành bằng cách nâng cao độ chính xác và giảm nhu cầu huấn luyện chuyên sâu. Trong bài viết này, chúng ta sẽ tìm hiểu các tính năng chính của Florence-2, so sánh hiệu năng với những VLM khác và thảo luận về các ứng dụng tiềm năng.
Florence-2 là gì?#
Florence-2 có thể xử lý nhiều tác vụ trong một framework thống nhất. Các khả năng của model một phần đến từ dataset huấn luyện lớn có tên FLD-5B. FLD-5B gồm 5,4 tỷ nhãn trên 126 triệu hình ảnh. Dataset toàn diện này được tạo riêng để trang bị cho Florence-2 những năng lực cần thiết nhằm xử lý nhiều tác vụ thị giác với độ chính xác và hiệu quả cao.
Dưới đây là cái nhìn chi tiết hơn về các tác vụ Florence-2 hỗ trợ:
- Phát hiện đối tượng: Model có thể xác định và định vị các đối tượng trong ảnh với độ chính xác cao.
- Phân đoạn: Tác vụ này chia ảnh thành các phân vùng có ý nghĩa để phân tích và diễn giải dễ dàng hơn.
- Tạo chú thích ảnh: Florence-2 có thể tạo chú thích mô tả cho ảnh, cung cấp ngữ cảnh và thông tin chi tiết.
- Grounding thị giác: Model có thể liên kết các cụm từ hoặc từ ngữ cụ thể trong chú thích với những vùng tương ứng trong ảnh.
- Hiệu năng zero-shot: Model có thể thực hiện tác vụ mà không cần huấn luyện chuyên biệt.
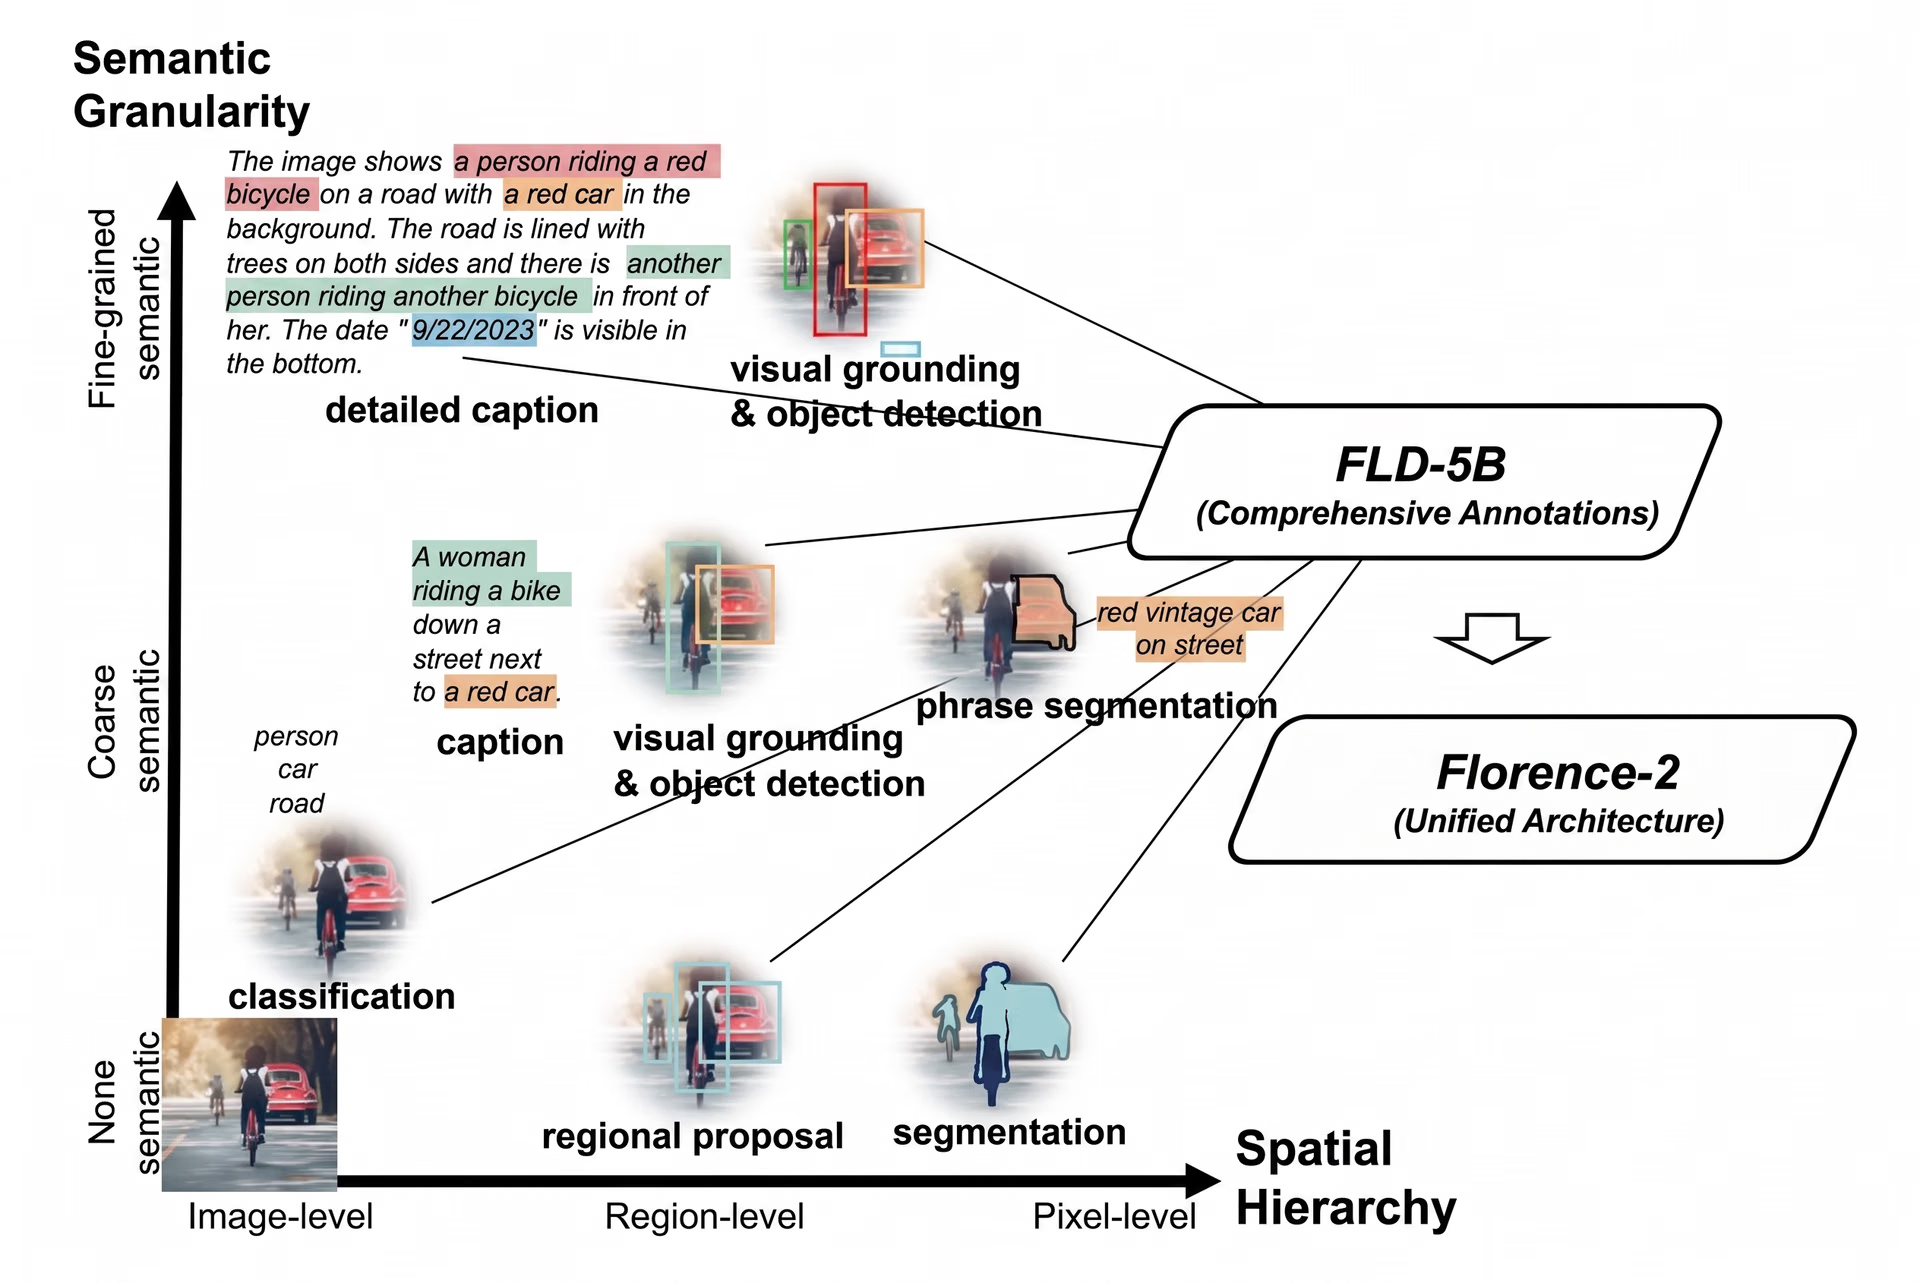
Hình 1. Tìm hiểu cách Florence-2 được huấn luyện.
Model hỗ trợ cả tác vụ dựa trên văn bản lẫn tác vụ dựa trên vùng. Các token vị trí đặc biệt được thêm vào bộ từ vựng của model cho những tác vụ liên quan đến vùng cụ thể trong ảnh. Các token này giúp model hiểu nhiều hình dạng khác nhau, chẳng hạn như hình chữ nhật quanh vật thể (biểu diễn dạng hộp), hình bốn cạnh (biểu diễn dạng hộp tứ giác) và hình nhiều cạnh (biểu diễn dạng đa giác). Model được huấn luyện bằng hàm mất mát entropy chéo tiêu chuẩn, giúp model học bằng cách so sánh dự đoán với đáp án chính xác rồi điều chỉnh các tham số nội bộ tương ứng.
Tạo bộ dữ liệu FLD-5B#
Dataset FLD-5B bao gồm nhiều loại nhãn: mô tả bằng văn bản, cặp vùng và văn bản, cùng tổ hợp văn bản, cụm từ và vùng. Dataset được tạo qua quy trình hai bước gồm thu thập và gán nhãn dữ liệu. Hình ảnh được lấy từ các dataset phổ biến như ImageNet-22k, Objects365, Open Images, Conceptual Captions và LAION. Nhãn trong dataset FLD-5B chủ yếu là dữ liệu tổng hợp, tức được tạo tự động thay vì gán nhãn thủ công.
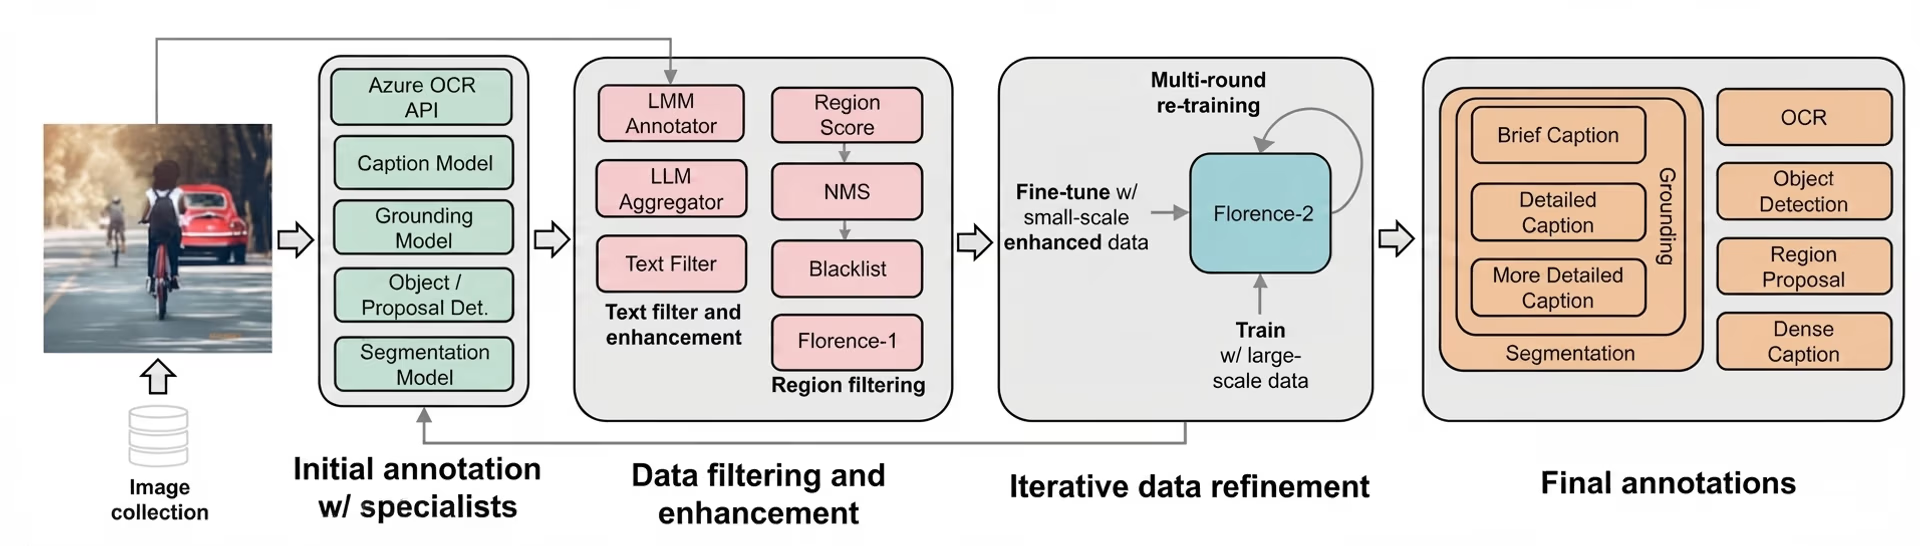
Hình 2. Tạo dataset FLD-5B.
Ban đầu, các model chuyên biệt có thế mạnh ở những tác vụ cụ thể, như phát hiện đối tượng hoặc phân đoạn, tạo ra các annotation này. Sau đó, quy trình lọc và cải thiện được áp dụng để đảm bảo annotation chi tiết và chính xác. Sau khi loại bỏ nhiễu, bộ dữ liệu được tinh chỉnh lặp lại, trong đó đầu ra của Florence-2 được dùng để liên tục cập nhật và cải thiện annotation.
Tìm hiểu kiến trúc model Florence-2#
Kiến trúc model của Florence-2 tuân theo phương pháp học sequence-to-sequence. Điều này có nghĩa là model xử lý một chuỗi đầu vào (chẳng hạn ảnh kèm prompt văn bản) và tạo ra chuỗi đầu ra (chẳng hạn mô tả hoặc nhãn) theo từng bước. Trong framework sequence-to-sequence, mỗi tác vụ được xem như một bài toán dịch: model nhận ảnh đầu vào và prompt dành riêng cho tác vụ, rồi tạo ra đầu ra tương ứng.
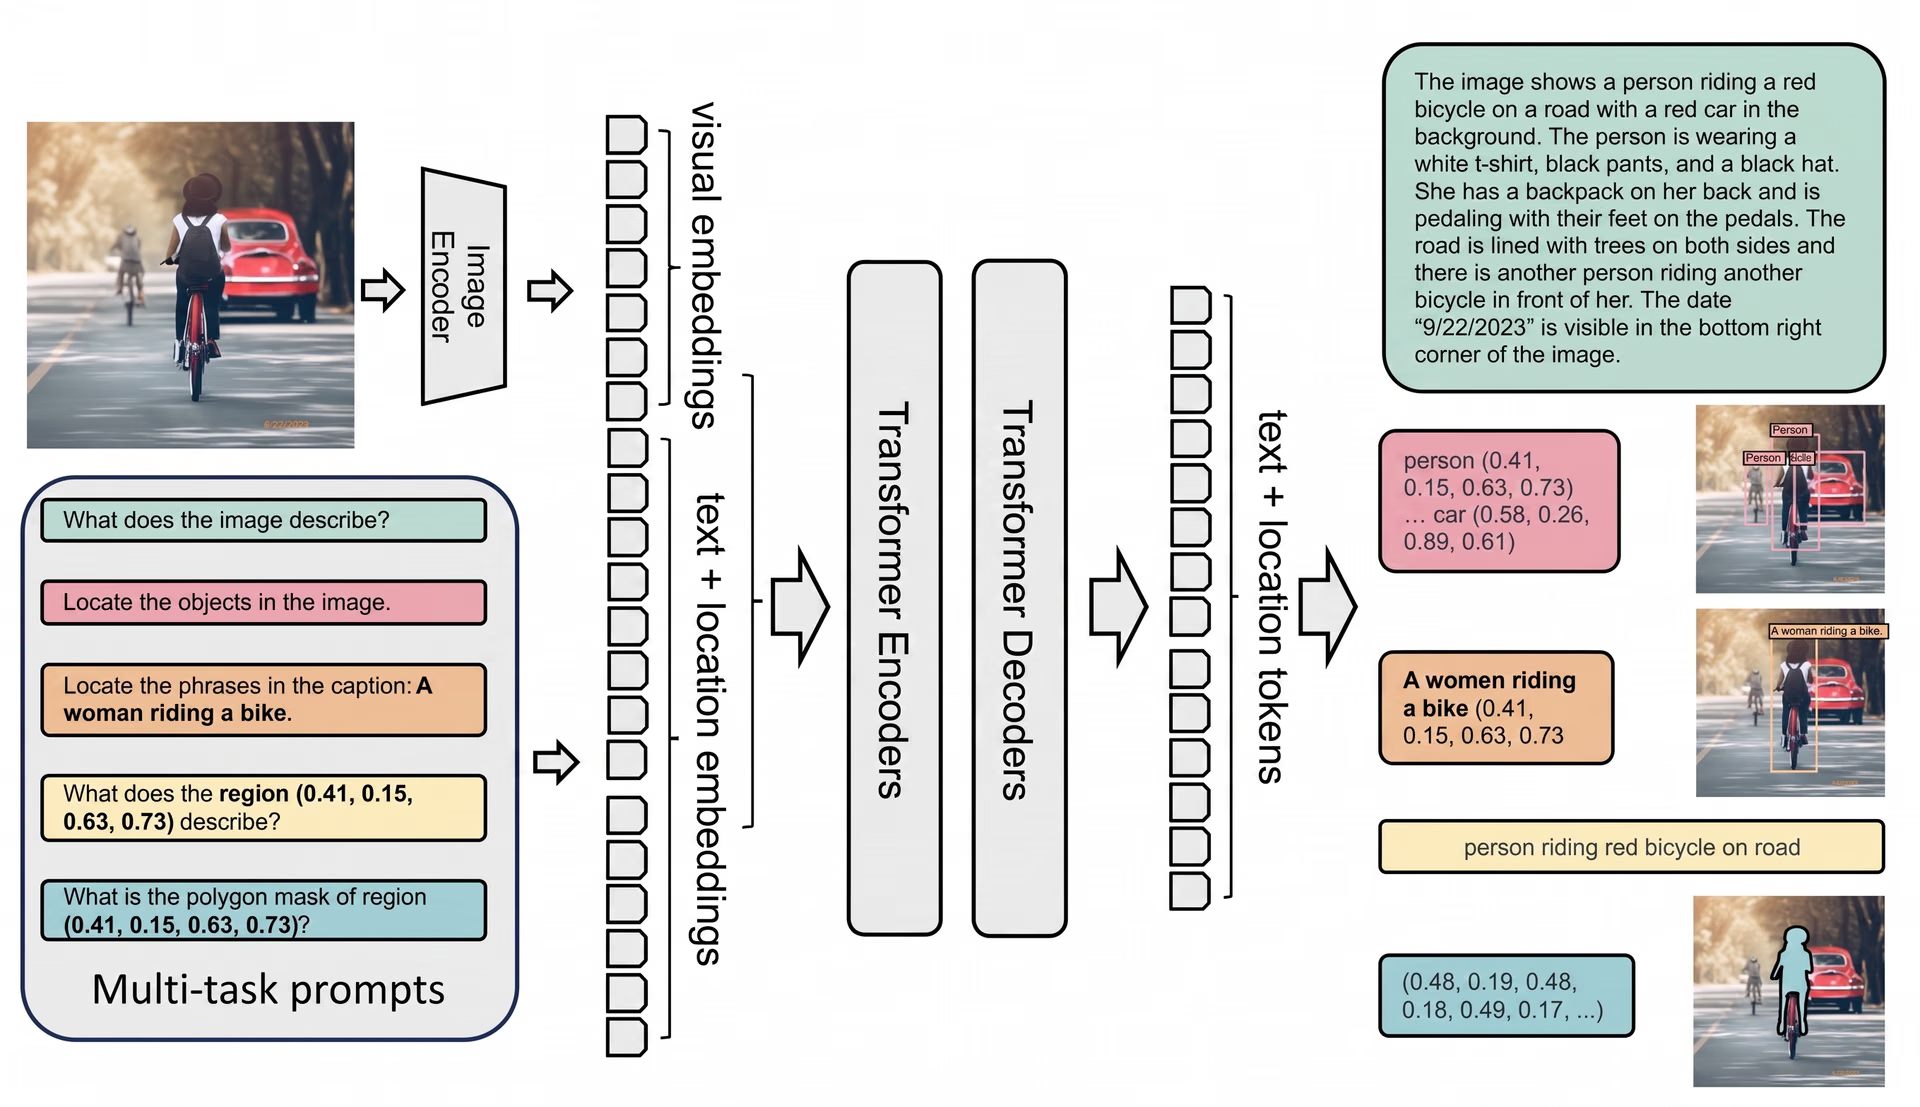
Hình 3. Kiến trúc model thị giác-ngôn ngữ Florence-2.
Cốt lõi của kiến trúc model là một Transformer encoder-decoder đa phương thức, kết hợp bộ mã hóa ảnh với bộ mã hóa-giải mã đa phương thức. Bộ mã hóa ảnh có tên DaViT (Transformer Thị giác Chú ý Kép) xử lý ảnh đầu vào bằng cách chuyển chúng thành các embedding token thị giác — những biểu diễn gọn của ảnh, nắm bắt cả thông tin không gian (vị trí của sự vật) lẫn ngữ nghĩa (sự vật là gì). Sau đó, các token thị giác này được kết hợp với embedding văn bản (các biểu diễn của văn bản), cho phép model hợp nhất dữ liệu văn bản và hình ảnh.
So sánh Florence-2 với các VLM khác#
Florence-2 nổi bật so với các model thị giác-ngôn ngữ khác nhờ năng lực zero-shot mạnh mẽ. Không giống các model như PaliGemma, vốn cần tinh chỉnh chuyên sâu để thích ứng với nhiều tác vụ, Florence-2 hoạt động hiệu quả ngay khi sử dụng. Florence-2 cũng có thể cạnh tranh với các model lớn hơn như GPT-4V và Flamingo, vốn thường có nhiều tham số hơn nhưng không phải lúc nào cũng đạt hiệu năng ngang Florence-2. Ví dụ: Florence-2 đạt kết quả zero-shot tốt hơn Kosmos-2 dù Kosmos-2 có số tham số nhiều hơn gấp đôi.
Trong các thử nghiệm benchmark, Florence-2 cho thấy hiệu năng mạnh mẽ ở các tác vụ như tạo chú thích cho COCO và hiểu biểu thức tham chiếu. Model vượt trội hơn các model như PolyFormer và UNINEXT trong các tác vụ phát hiện vật thể và phân đoạn trên dataset COCO. Đây là lựa chọn có tính cạnh tranh cao cho các ứng dụng thực tế, nơi hiệu năng và hiệu quả sử dụng tài nguyên đều rất quan trọng. Bạn có thể tự động gán nhãn dataset phát hiện bằng Florence-2 trên Ultralytics Platform và xem model này so sánh với các model ngôn ngữ thị giác khác ra sao trên bảng xếp hạng VLM.
Các ứng dụng của Florence-2#
Florence-2 có thể được sử dụng trong nhiều ngành khác nhau, chẳng hạn như giải trí, khả năng tiếp cận, giáo dục, v.v. Hãy cùng xem qua một vài ví dụ để hiểu rõ hơn.
Ứng dụng tạo chú thích ảnh#
Khi sử dụng nền tảng streaming và đang phân vân không biết nên xem gì, bạn có thể đọc tóm tắt phim để đưa ra lựa chọn. Sẽ thế nào nếu nền tảng còn có thể cung cấp mô tả chi tiết về poster phim? Florence-2 có thể thực hiện điều đó thông qua tính năng tạo chú thích ảnh, giúp tạo văn bản mô tả cho ảnh. Florence-2 có thể tạo mô tả chi tiết về poster phim, giúp các nền tảng streaming trở nên toàn diện hơn với người dùng khiếm thị. Bằng cách phân tích các yếu tố hình ảnh trên poster, chẳng hạn nhân vật, bối cảnh và văn bản, Florence-2 có thể tạo mô tả chi tiết truyền tải nội dung và sắc thái của poster. Hình bên dưới cho thấy mức độ chi tiết mà Florence-2 có thể cung cấp trong phần mô tả.
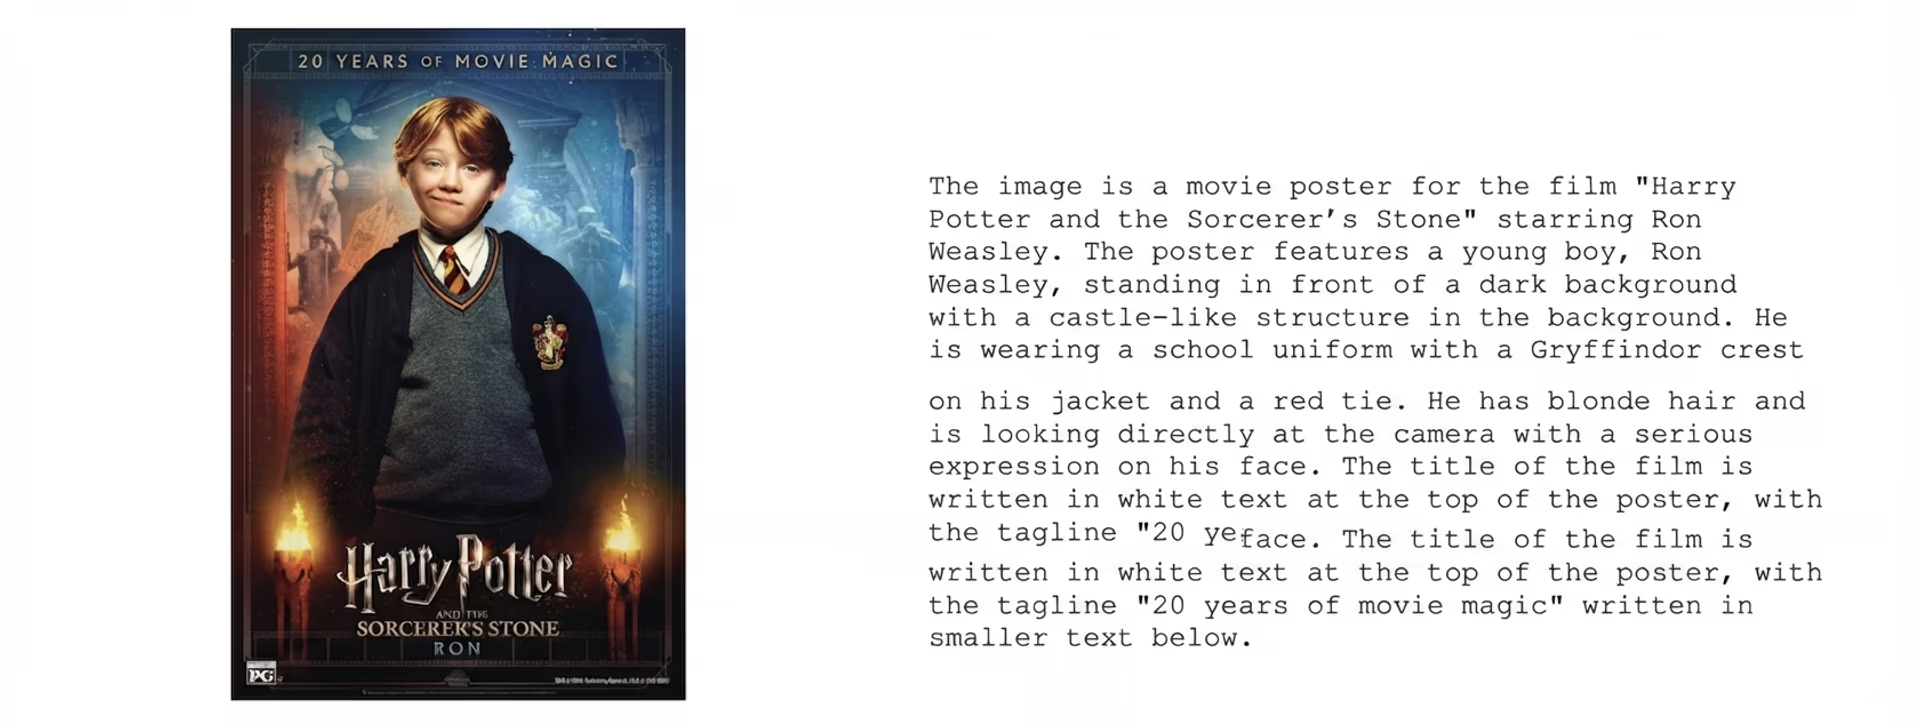
Hình 4. Ví dụ về chú thích ảnh do Florence-2 tạo.
Dưới đây là một số ví dụ khác về những trường hợp tạo chú thích ảnh hữu ích:
- Thương mại điện tử: Tạo chú thích hình ảnh có thể cung cấp mô tả chi tiết về hình ảnh sản phẩm, giúp khách hàng hiểu rõ hơn các tính năng và thông tin sản phẩm.
- Du lịch và lữ hành: Tính năng này có thể cung cấp mô tả chi tiết về địa danh và điểm tham quan trong cẩm nang và ứng dụng du lịch.
- Giáo dục: Tính năng tạo chú thích ảnh có thể gán nhãn và mô tả hình ảnh, sơ đồ giáo dục, hỗ trợ việc dạy và học.
- Bất động sản: Tính năng này có thể cung cấp mô tả chi tiết về ảnh bất động sản, làm nổi bật đặc điểm và tiện ích để người mua tiềm năng tham khảo.
Sử dụng grounding thị giác khi nấu ăn#
Florence-2 cũng có thể được dùng để làm phong phú trải nghiệm ẩm thực. Chẳng hạn, một sách nấu ăn trực tuyến có thể dùng Florence-2 để grounding thị giác và gán nhãn các phần trong ảnh công thức phức tạp. Grounding thị giác hữu ích trong trường hợp này vì liên kết các phần cụ thể của ảnh với văn bản mô tả tương ứng. Mỗi nguyên liệu và bước thực hiện có thể được gán nhãn và giải thích chính xác, giúp người nấu ăn tại nhà dễ làm theo công thức và hiểu vai trò của từng thành phần trong món ăn.
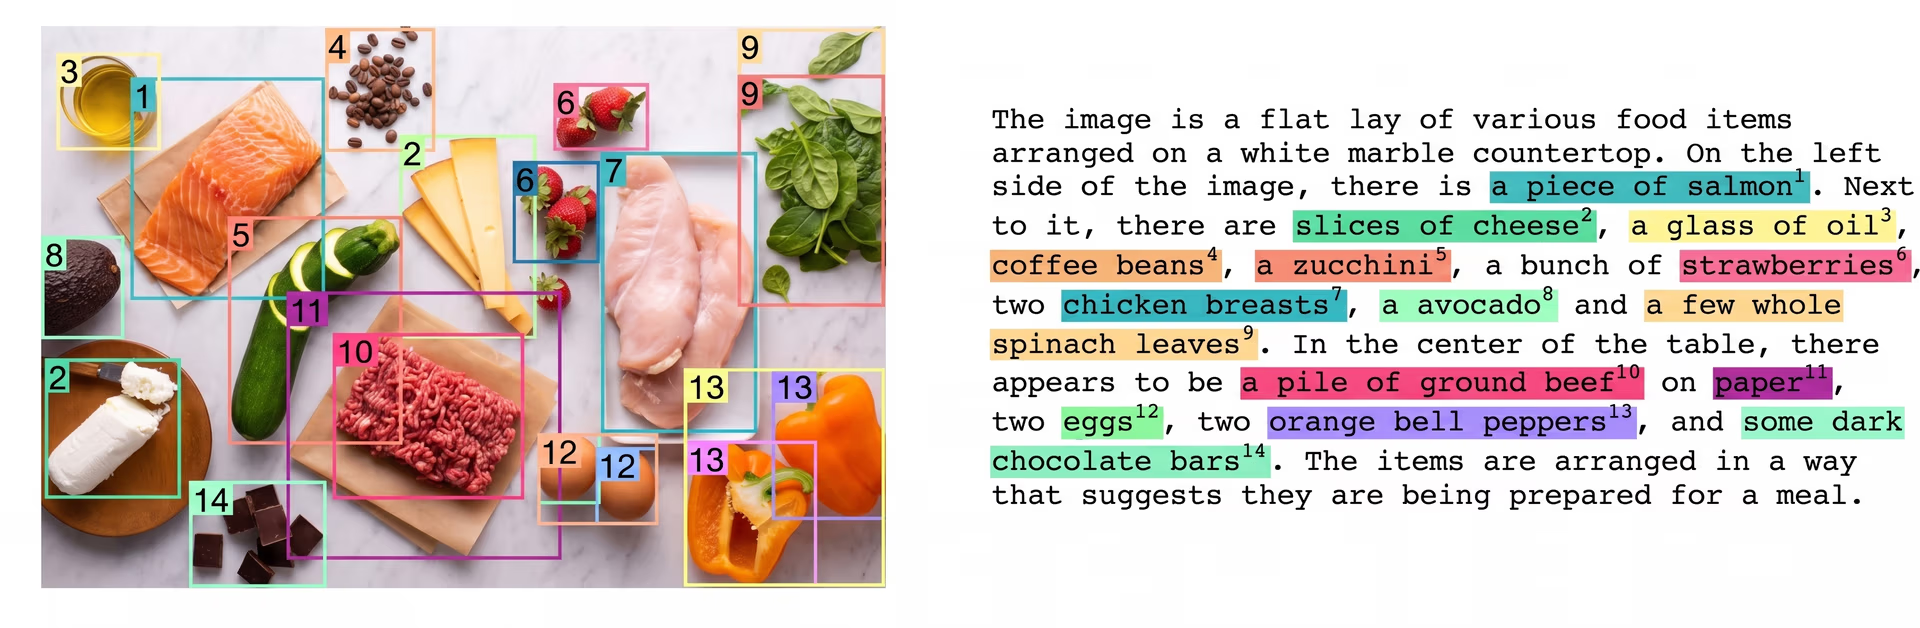
Hình 5. Ví dụ về grounding thị giác bằng Florence-2.
OCR dựa trên vùng cho tài liệu tài chính#
OCR với phương pháp xử lý dựa trên vùng, tập trung trích xuất văn bản từ các khu vực cụ thể trong tài liệu, có thể hữu ích trong các lĩnh vực như kế toán. Có thể phân tích những vùng được chỉ định trong tài liệu tài chính để tự động trích xuất thông tin quan trọng như chi tiết giao dịch, số tài khoản và ngày đến hạn. Giảm nhu cầu nhập dữ liệu thủ công giúp hạn chế lỗi và rút ngắn thời gian xử lý. Các tổ chức tài chính có thể dùng công nghệ này để tinh gọn những tác vụ như xử lý hóa đơn, đối soát biên lai và thanh toán séc, từ đó giao dịch nhanh hơn và nâng cao dịch vụ khách hàng.
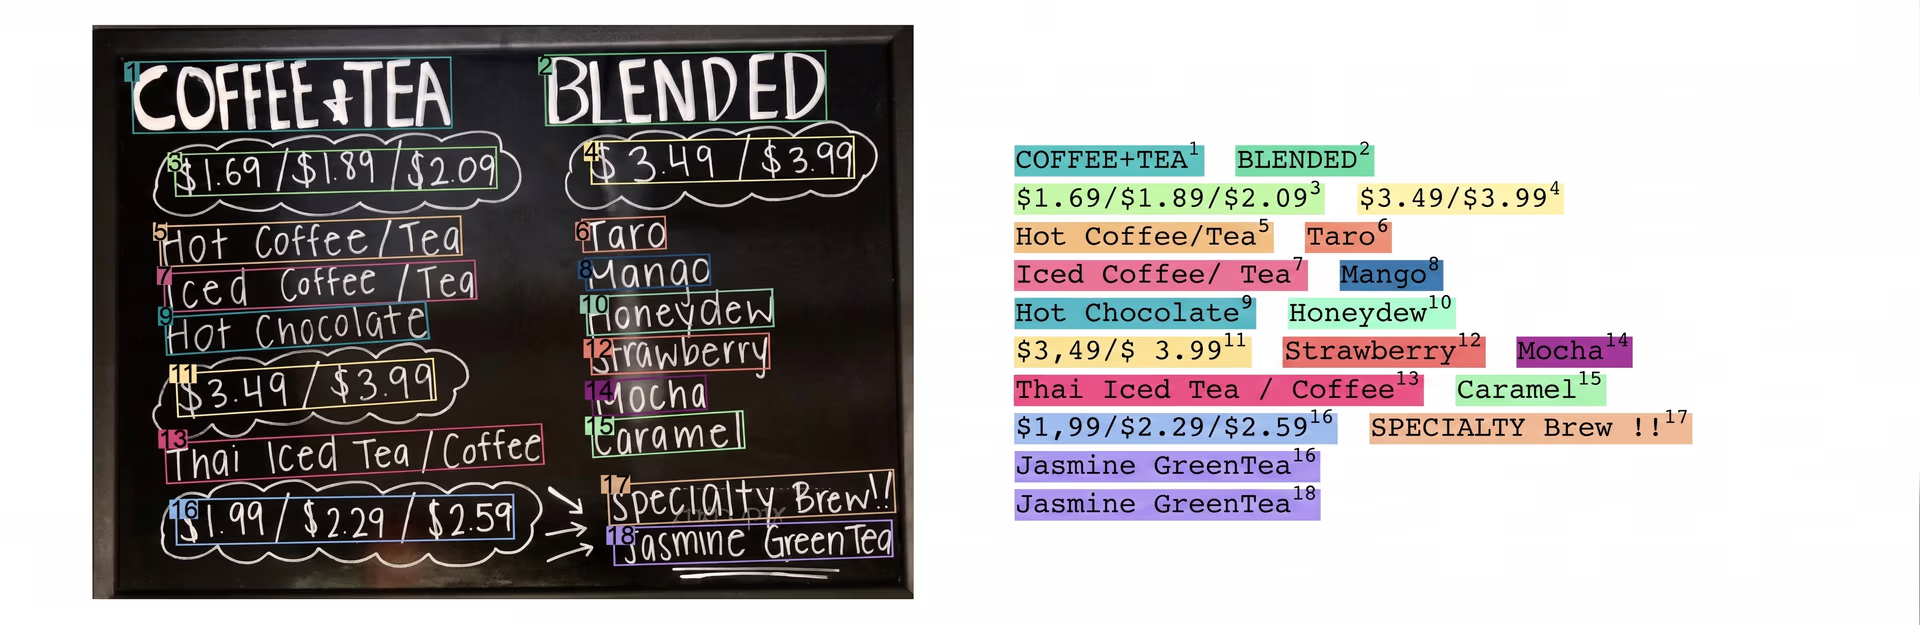
Hình 6. Ví dụ về trích xuất OCR theo vùng bằng Florence-2.
Phân đoạn dựa trên vùng trong các ứng dụng công nghiệp#
Phân đoạn dựa trên vùng, tức chia ảnh thành các phần có ý nghĩa để phân tích tập trung và kiểm tra chi tiết, có thể thúc đẩy các ứng dụng công nghiệp, giúp cải thiện độ chính xác và hiệu quả trong nhiều quy trình. Bằng cách tập trung vào những khu vực cụ thể trong ảnh, công nghệ này cho phép kiểm tra và phân tích chi tiết các linh kiện và sản phẩm. Trong kiểm soát chất lượng, công nghệ có thể xác định lỗi hoặc điểm không nhất quán trong vật liệu, chẳng hạn như vết nứt hoặc lệch vị trí, đảm bảo chỉ những sản phẩm chất lượng cao nhất mới được đưa ra thị trường.
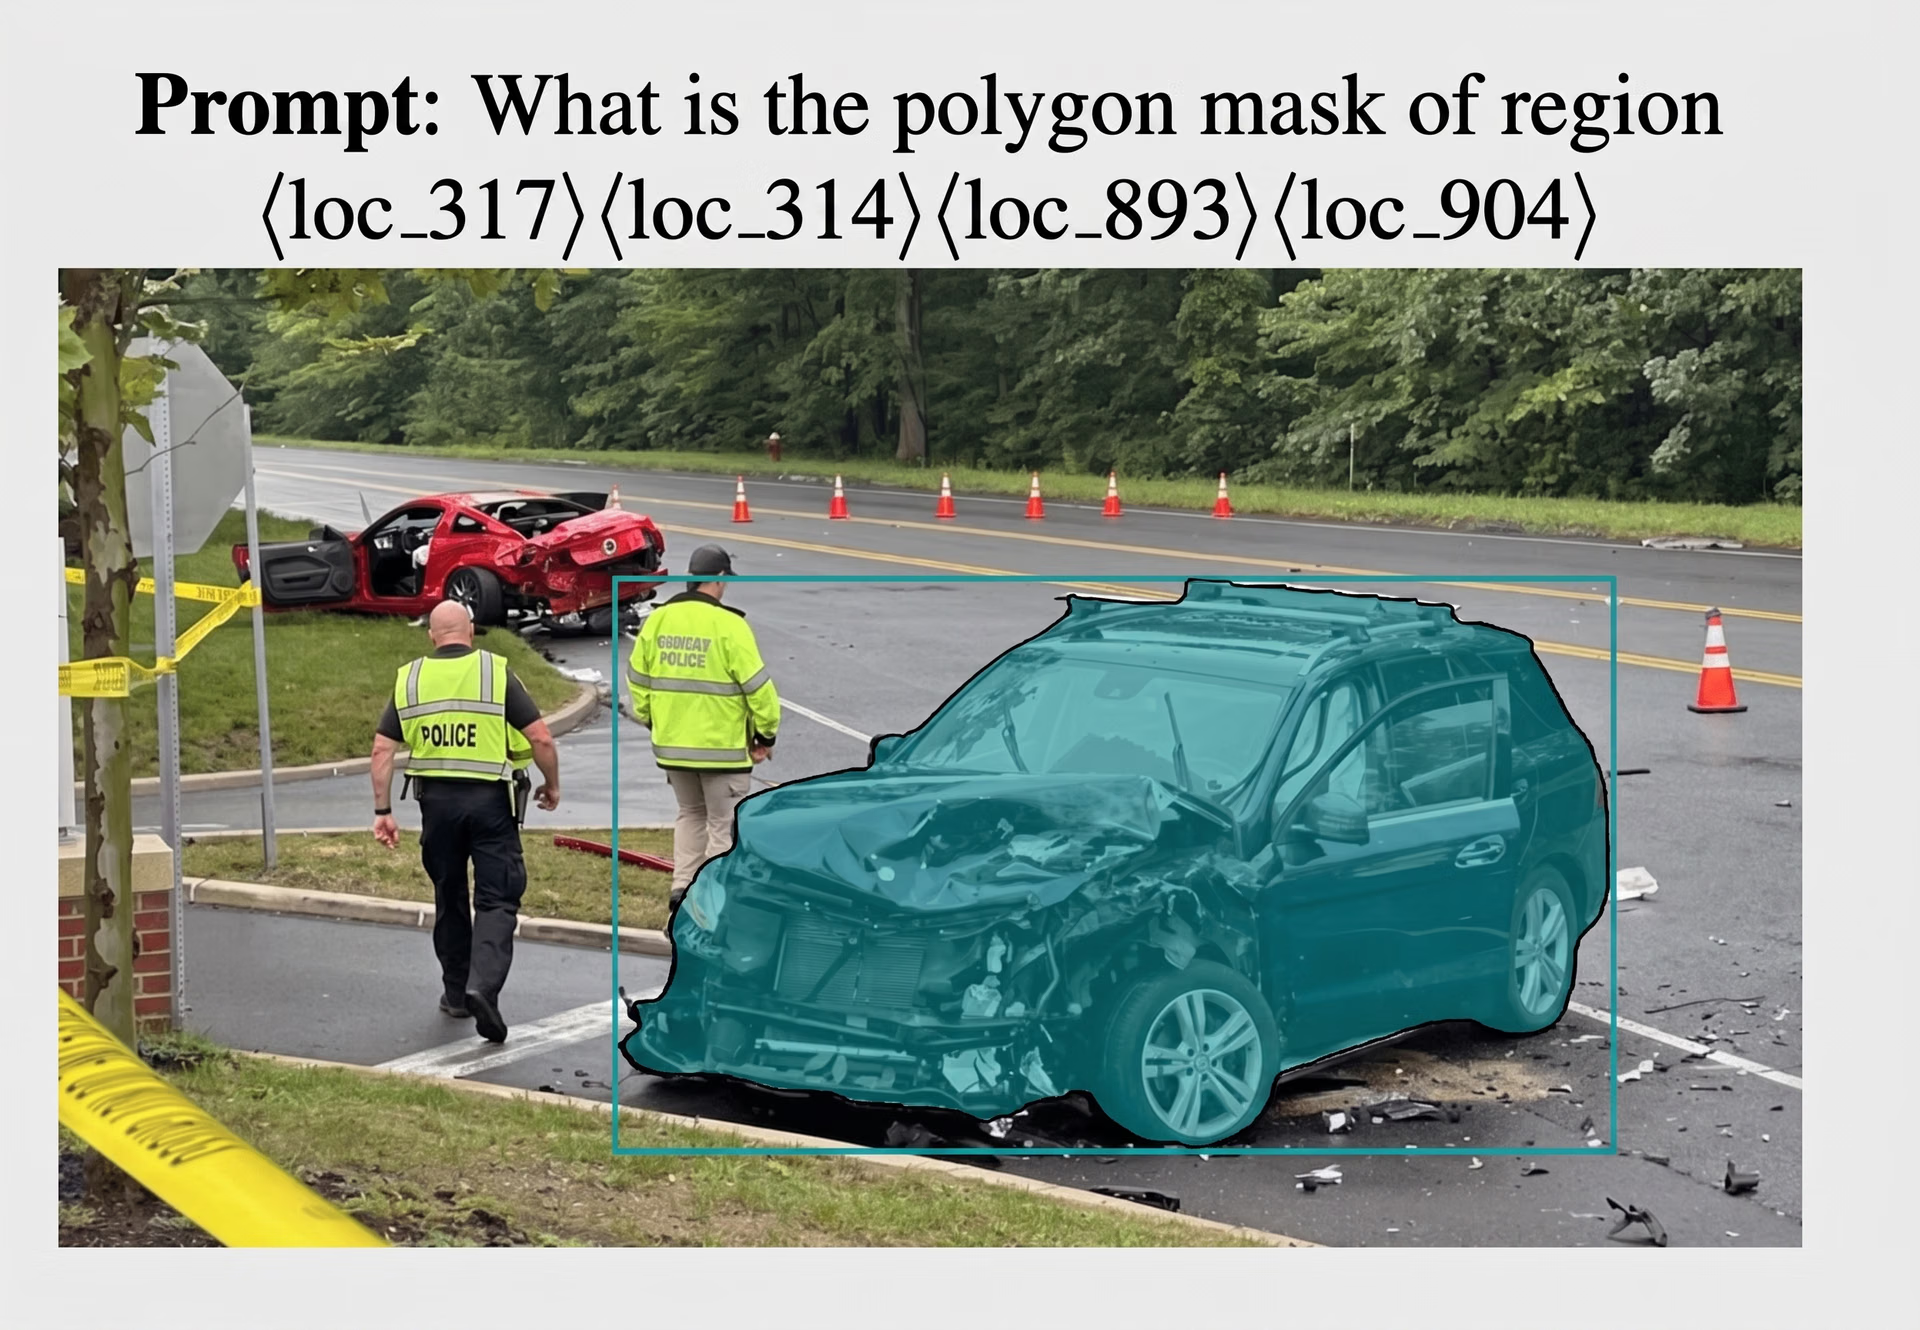
Hình 7. Ví dụ về phân đoạn theo vùng bằng Florence-2.
Công nghệ này cũng cải thiện dây chuyền lắp ráp tự động bằng cách hướng dẫn các cánh tay robotic đến những bộ phận cụ thể, đồng thời tối ưu hóa việc định vị và lắp ráp linh kiện. Tương tự, trong quản lý hàng tồn kho, công nghệ giúp theo dõi và giám sát tình trạng cũng như vị trí hàng hóa, từ đó nâng cao hiệu quả logistics và giảm thời gian ngừng hoạt động. Nhìn chung, phân đoạn dựa trên vùng giúp tăng độ chính xác và năng suất, tiết kiệm chi phí và nâng cao chất lượng sản phẩm trong môi trường công nghiệp.
Điểm chính cần ghi nhớ#
Chúng ta đang chứng kiến xu hướng các model AI ngày càng gọn nhẹ nhưng vẫn duy trì hiệu năng cao. Florence-2 đánh dấu bước tiến lớn cho các model thị giác-ngôn ngữ. Model có thể xử lý nhiều tác vụ như phát hiện vật thể, phân đoạn, tạo chú thích hình ảnh và định vị theo mô tả với hiệu năng zero-shot ấn tượng. Dù có kích thước nhỏ hơn, Florence-2 vẫn hiệu quả và đa chức năng, nhờ đó hữu ích trong các ứng dụng thuộc nhiều ngành khác nhau. Những model như Florence-2 đang mở ra nhiều khả năng hơn, mở rộng tiềm năng đổi mới AI.
Tìm hiểu thêm về AI bằng cách truy cập kho GitHub và tham gia cộng đồng của chúng tôi. Xem các trang giải pháp của chúng tôi để đọc về ứng dụng AI trong sản xuất và nông nghiệp.
Được viết bởi
Nhà sáng tạo nội dung · Ultralytics
Bình luận
Đặt câu hỏi, chia sẻ kết quả hoặc giúp đỡ người khác.









