Tận dụng học tăng cường trong các dự án thị giác máy tính
Tìm hiểu cách học tăng cường hoạt động và kết hợp với thị giác máy tính trong robot kho hàng, xe tự hành và robot phẫu thuật, cùng những đánh đổi của phương pháp này.
 Abirami Vina12 phút đọc
Có thể giải thích đơn giản về trí tuệ nhân tạo (AI) như sau: đây là lĩnh vực tập trung vào việc tái tạo cách con người suy nghĩ và học hỏi. Từ đó hình thành khái niệm các kỹ thuật học tập trong AI, tức những phương pháp khác nhau giúp máy móc cải thiện hiệu suất theo thời gian, giống như con người.
Trước đây, chúng ta đã tìm hiểu các kỹ thuật học tập trong AI quan trọng, bao gồm học có giám sát, học không giám sát, học tăng cường và học chuyển giao, cũng như vai trò của từng kỹ thuật trong việc giúp model AI xử lý thông tin và đưa ra quyết định.
Hôm nay, chúng ta sẽ tìm hiểu kỹ hơn về học tăng cường, một kỹ thuật giúp hệ thống AI học hỏi qua trải nghiệm bằng cách tương tác với môi trường và cải thiện dựa trên phản hồi. Cụ thể, chúng ta sẽ khám phá cách áp dụng học tăng cường vào các ứng dụng thị giác máy tính, tức các hệ thống cho phép máy diễn giải và hiểu thông tin hình ảnh từ thế giới xung quanh.
Việc kết hợp các khái niệm như học tăng cường và thị giác máy tính đang mở ra những khả năng mới đầy hứa hẹn và là một lĩnh vực nghiên cứu tích cực. Cách tiếp cận này cho phép các hệ thống AI nhận biết những gì chúng nhìn thấy và đưa ra quyết định sáng suốt dựa trên thông tin trực quan đó.
Học tăng cường là gì?#
Học tăng cường là một nhánh của học máy, trong đó một tác nhân AI học bằng cách thực hiện hành động và nhận phản hồi dưới dạng phần thưởng hoặc hình phạt. Mục tiêu là xác định những hành động nào sẽ dẫn đến kết quả tốt nhất theo thời gian.
Có thể hình dung học tăng cường giống như việc huấn luyện một chú chó. Khi chó ngồi theo lệnh, bạn thưởng cho nó một món ăn. Sau một thời gian, chó học được rằng ngồi xuống sẽ nhận được phần thưởng. Trong học tăng cường, tác nhân AI hoặc model giống như chú chó; môi trường là thế giới xung quanh, còn phần thưởng giúp nó hiểu liệu mình đã hành động đúng hay chưa.
Điều này khác với học có giám sát, trong đó model AI được cung cấp nhiều ví dụ về đáp án đúng. Chẳng hạn, model có thể được cho xem ảnh một con chó và được hướng dẫn: "Đây là một con chó."
Ngược lại, học tăng cường không dựa vào dữ liệu đã gán nhãn. Thay vào đó, phương pháp này học bằng cách thử các hành động khác nhau và rút kinh nghiệm từ kết quả, giống như chơi một trò chơi và tìm hiểu nước đi nào giúp bạn chiến thắng.
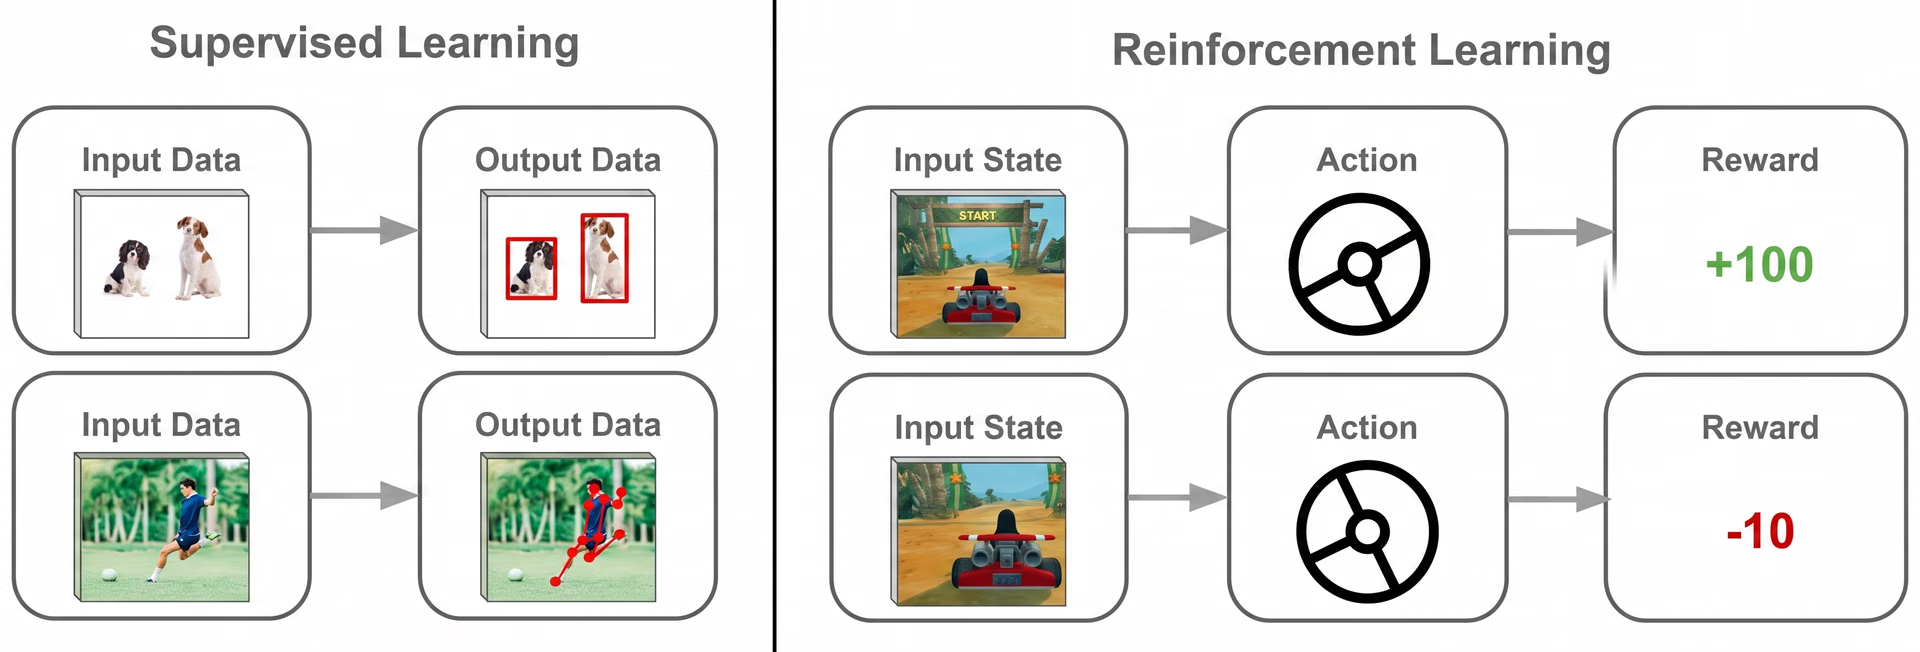
Hình 1. Học tăng cường so với học có giám sát.
Học tăng cường rất quan trọng đối với những tác vụ đòi hỏi đưa ra quyết định từng bước, trong đó mỗi lựa chọn sẽ ảnh hưởng đến diễn biến tiếp theo. Kiểu học này được sử dụng trong các trò chơi điện tử chiến thuật để khiến lối chơi thử thách và hấp dẫn hơn đối với người chơi.
Cách học tăng cường hoạt động trong các giải pháp AI#
Hãy nghĩ đến việc học đi xe đạp. Ban đầu, có thể bạn sẽ ngã. Nhưng qua luyện tập, bạn dần hiểu được cách giữ thăng bằng. Càng đạp xe nhiều, bạn càng tiến bộ. Bạn học bằng cách thực hành chứ không chỉ bằng cách được hướng dẫn phải làm gì.
Học tăng cường hoạt động tương tự đối với AI. AI học qua trải nghiệm: thử các hành động khác nhau, quan sát kết quả và dần cải thiện khả năng đưa ra lựa chọn đúng theo thời gian.
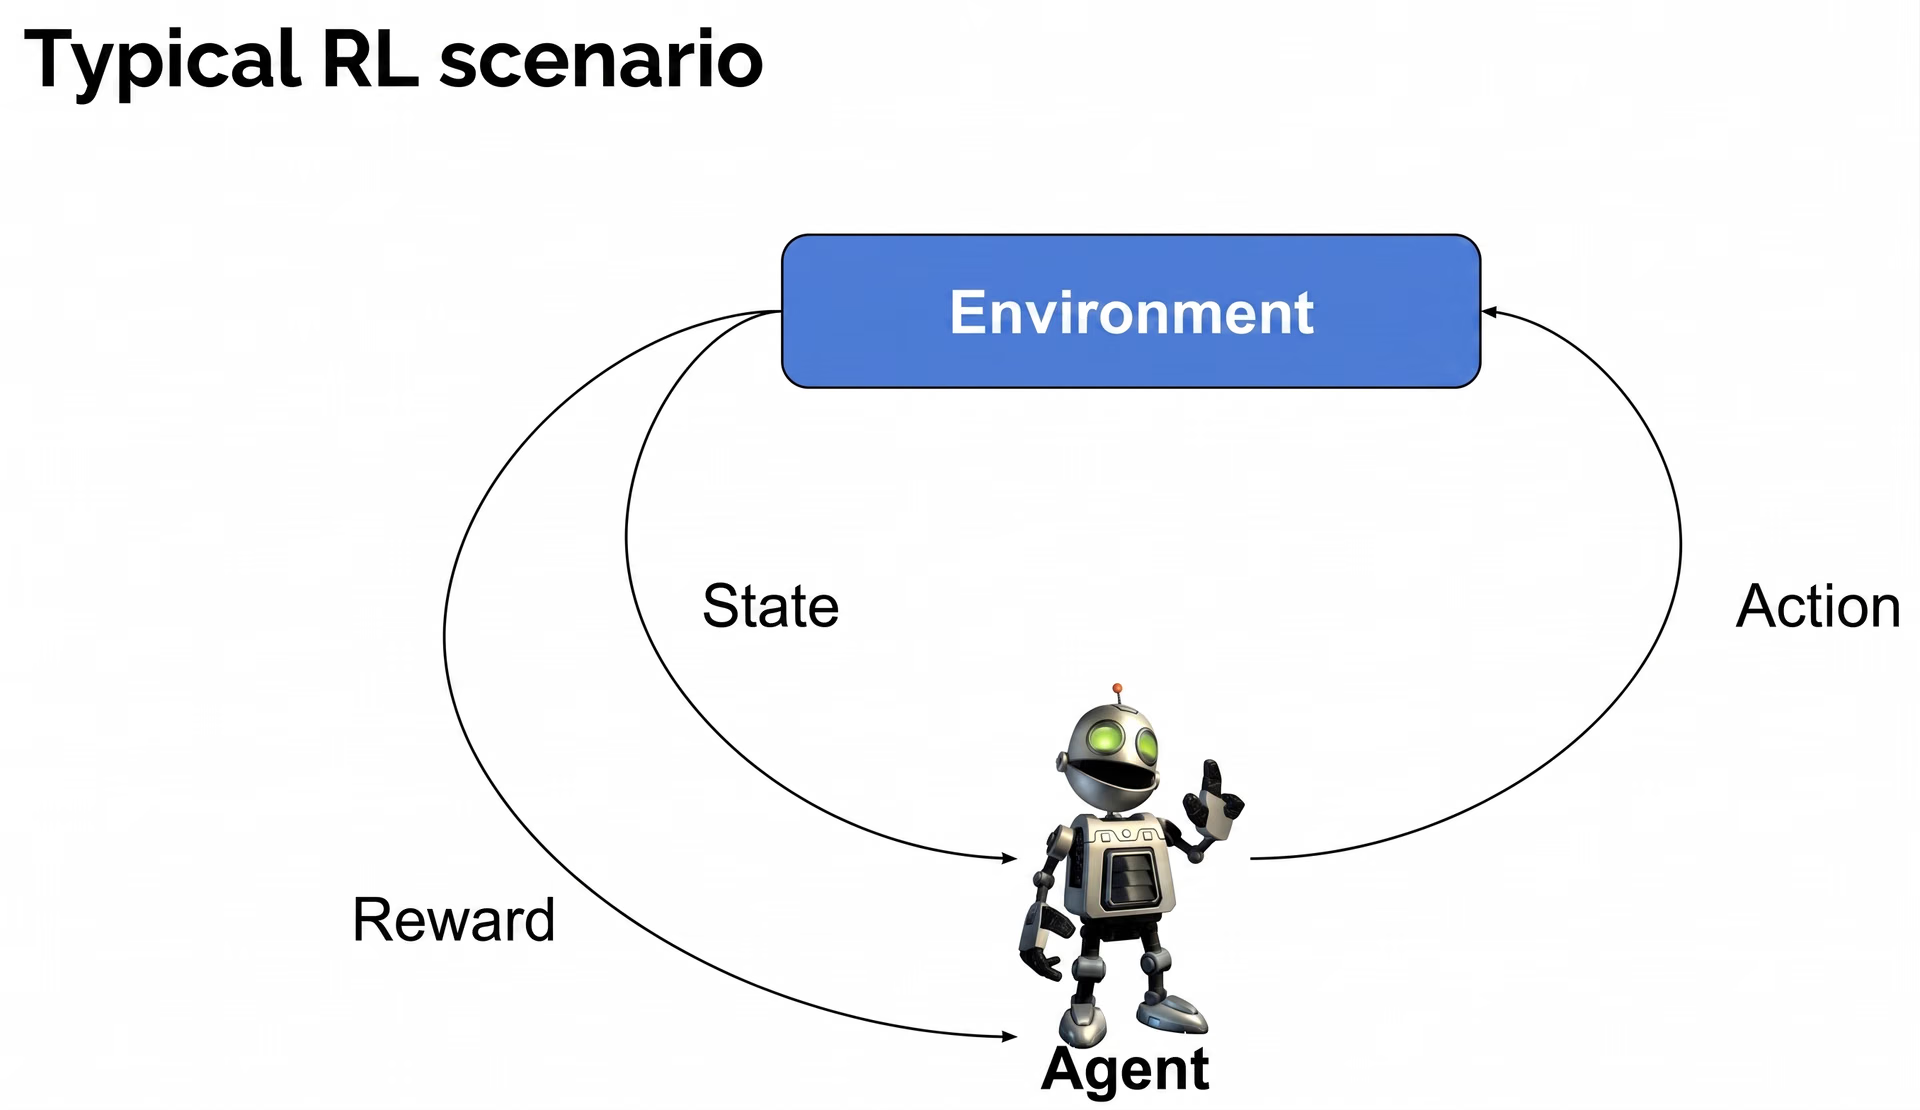
Hình 2. Tìm hiểu cách học tăng cường hoạt động.
Sau đây là một số thành phần chính của học tăng cường:
- Agent: Agent là tác nhân học hoặc đưa ra quyết định. Agent tương tác với môi trường bằng cách thực hiện hành động và hướng đến một mục tiêu cụ thể.
- Môi trường: Môi trường bao gồm mọi thứ mà agent tương tác. Môi trường thay đổi để đáp lại các hành động của agent và đưa ra phản hồi dựa trên kết quả.
- Trạng thái: Trạng thái thể hiện một ảnh chụp nhanh tình huống hiện tại trong môi trường. Agent quan sát trạng thái để hiểu bối cảnh xung quanh và xác định hành động tiếp theo.
- Hành động: Hành động là một bước đi hoặc quyết định do agent thực hiện, có ảnh hưởng đến môi trường. Mỗi hành động dẫn đến một trạng thái mới và có thể tác động đến phần thưởng trong tương lai.
- Phần thưởng: Phần thưởng đơn giản là phản hồi từ môi trường, cho agent biết hành động của mình có mang lại lợi ích hay không. Phần thưởng tích cực khuyến khích agent lặp lại những hành động tốt, còn phần thưởng tiêu cực ngăn agent thực hiện những hành động kém hiệu quả.
- Policy: Policy là chiến lược mà agent sử dụng để chọn hành động dựa trên trạng thái hiện tại. Theo thời gian, agent tinh chỉnh policy để tối đa hóa tổng phần thưởng có thể nhận được.
Kết hợp các thành phần này giúp học tăng cường cho phép hệ thống AI học những hành vi hiệu quả thông qua quá trình thử và sai liên tục. Qua mỗi lần thử, tác tử ngày càng chọn tốt hơn những hành động mang lại phần thưởng cao hơn và kết quả tốt hơn.
Những đổi mới về học tăng cường trong thị giác máy tính#
Thị giác máy tính được ứng dụng trong các tác vụ như phát hiện đối tượng trong ảnh, phân loại nội dung của ảnh và phân đoạn ảnh thành các phần khác nhau. Các model thị giác máy tính như Ultralytics YOLO11 hỗ trợ những tác vụ này và có thể được dùng để xây dựng các ứng dụng tạo ra những thông tin chuyên sâu về hình ảnh hữu ích.
Tuy nhiên, khi kết hợp các tác vụ AI thị giác này với học tăng cường, ta có được một giải pháp AI không chỉ nhìn nhận mà còn học cách hành động dựa trên thông tin hình ảnh và ngày càng cải thiện theo thời gian.
Một ví dụ thú vị về học tăng cường trong các ứng dụng thị giác máy tính là sử dụng robot trong kho hàng. Robot được trang bị camera và hệ thống thị giác máy tính có thể phân tích môi trường xung quanh, phát hiện vị trí của từng mặt hàng, xác định hình dạng và kích thước, đồng thời hiểu được cách mặt hàng được đặt trên kệ.
Mỗi lần robot cố gắng nhặt một mặt hàng, robot sẽ nhận phản hồi: thành công nếu nhặt đúng hoặc thất bại nếu làm rơi. Theo thời gian, robot học được hành động nào hiệu quả nhất với từng loại mặt hàng. Thay vì làm theo một tập hướng dẫn cố định, robot liên tục cải thiện thông qua trải nghiệm.
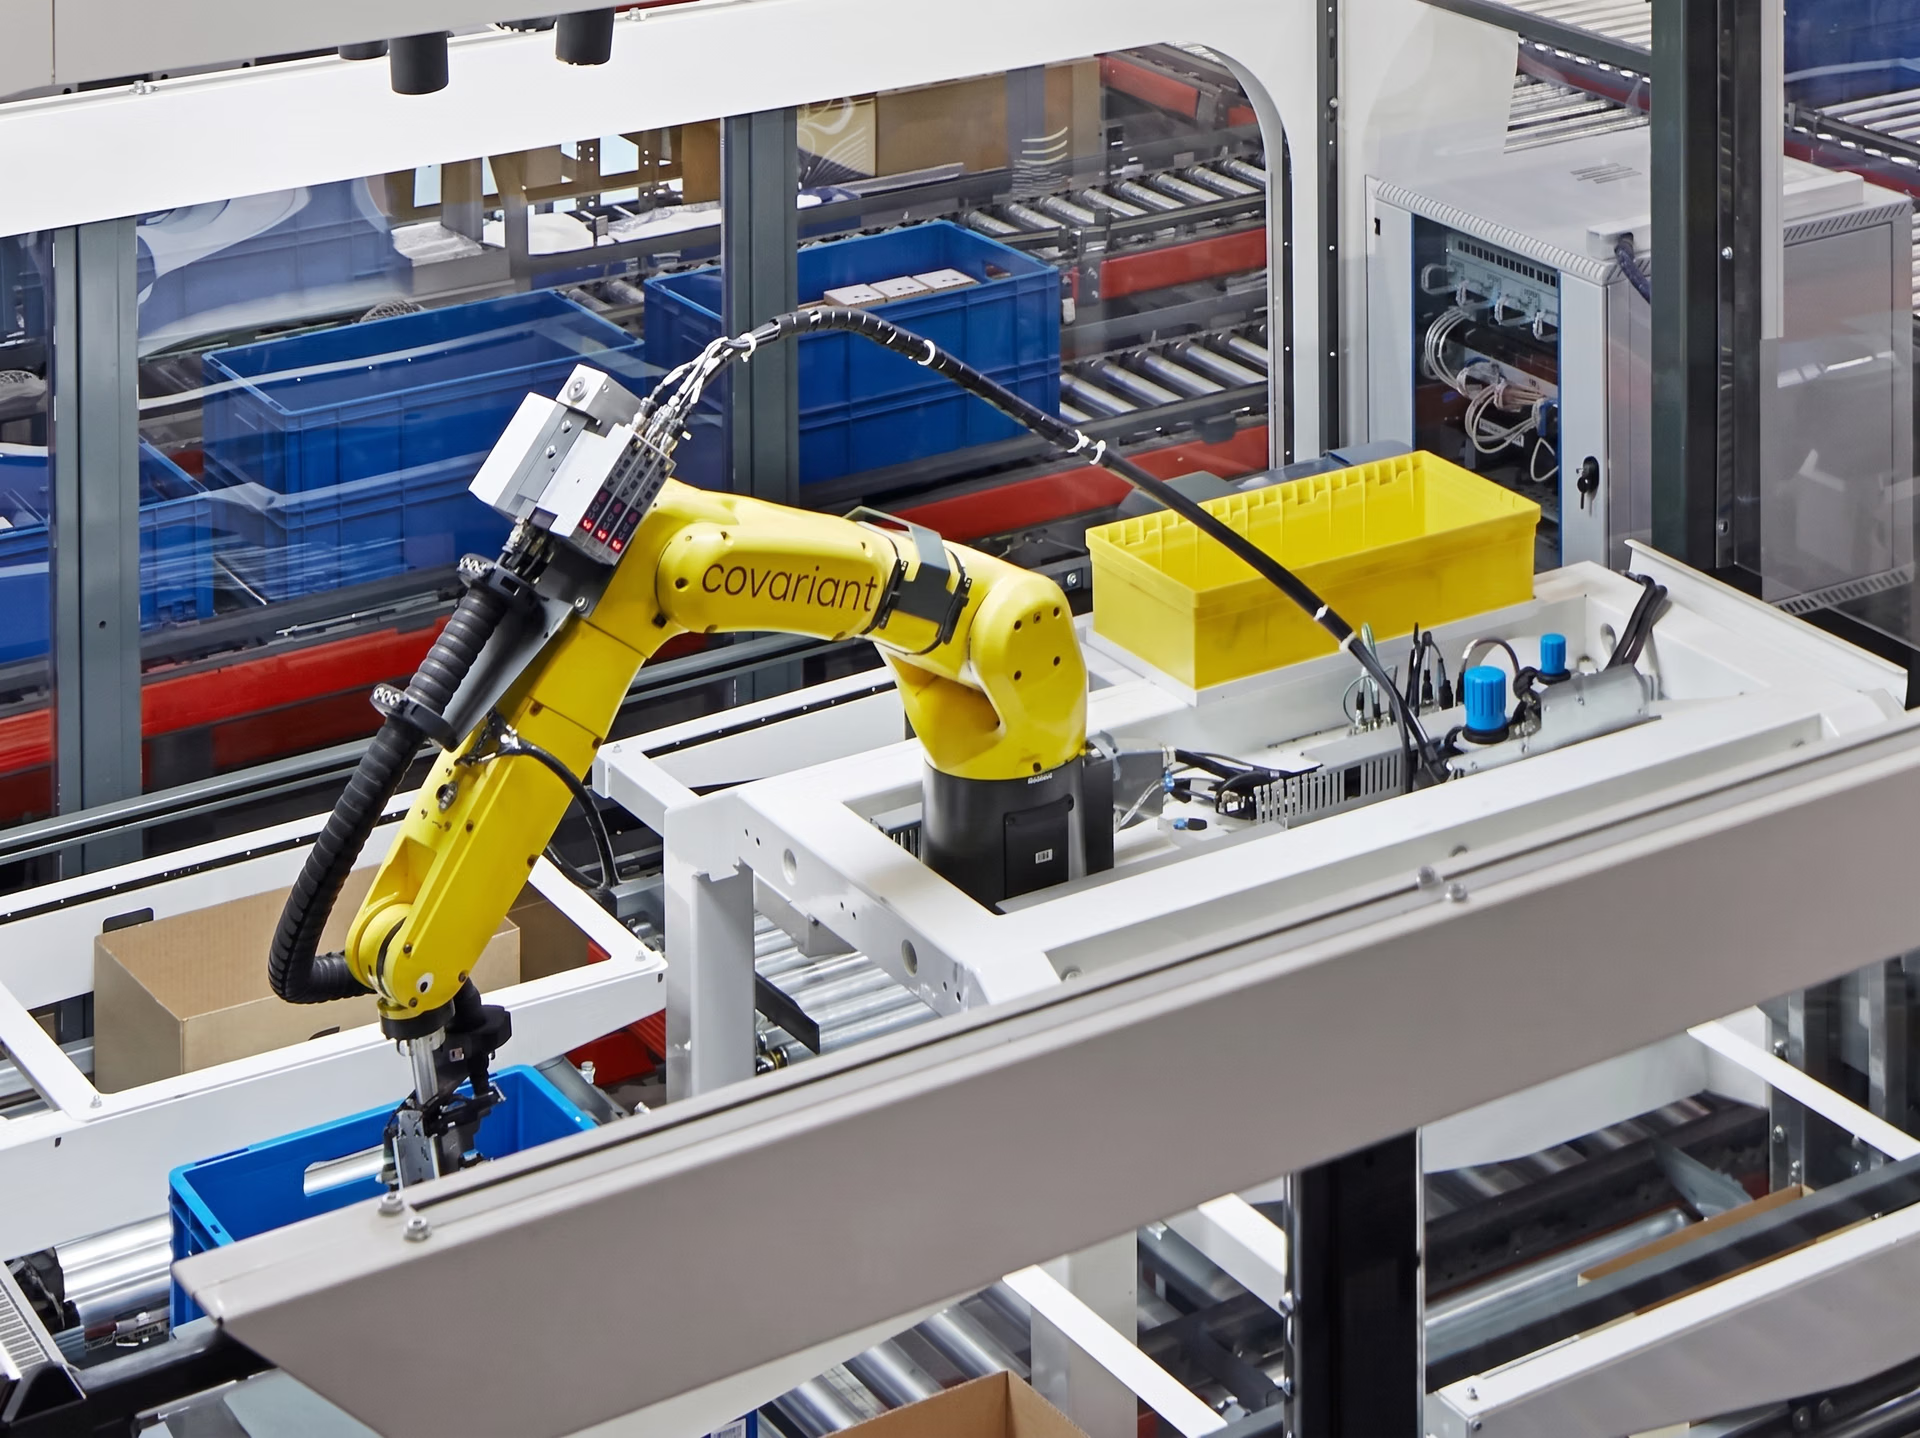
Hình 3. Cánh tay robot sử dụng Vision AI và học tăng cường để nhặt đồ vật.
Ứng dụng của học tăng cường trong thị giác máy tính#
Giờ đây, khi đã hiểu rõ hơn học tăng cường là gì và có vai trò như thế nào trong thị giác máy tính, hãy cùng xem xét kỹ hơn một số ví dụ về việc ứng dụng kết hợp học tăng cường và thị giác máy tính.
Tích hợp Vision AI và học tăng cường để tạo ra phương tiện thông minh hơn#
Xe tự hành có thể dựa vào cả AI thị giác để hiểu môi trường xung quanh lẫn học tăng cường để đưa ra quyết định dựa trên những gì xe quan sát được. AWS DeepRacer là một ví dụ điển hình về ứng dụng này.
AWS DeepRacer là một xe đua tự hành hoàn toàn, có tỷ lệ 1/18, học cách lái xe bằng camera và học tăng cường. Thay vì được chỉ dẫn phải làm gì, xe tự tìm cách xử lý bằng cách thử nghiệm, mắc lỗi và rút kinh nghiệm.
Camera của chiếc xe nhỏ này hoạt động như một đôi mắt, ghi lại đường đua phía trước. Dựa trên những gì nhìn thấy, xe học cách đánh lái và điều chỉnh tốc độ. Sau mỗi vòng đua, xe lại tiến bộ hơn. Ví dụ, xe có thể học cách vào cua rộng hơn hoặc giảm tốc trước những khúc cua gắt dựa trên các lần thử trước đó.
Quá trình huấn luyện DeepRacer bắt đầu trong môi trường ảo, nơi model luyện tập và hoàn thiện kỹ năng lái xe. Khi đạt đến một mức hiệu suất nhất định, những kỹ năng đó được chuyển sang đường đua ngoài đời thực với xe thật.
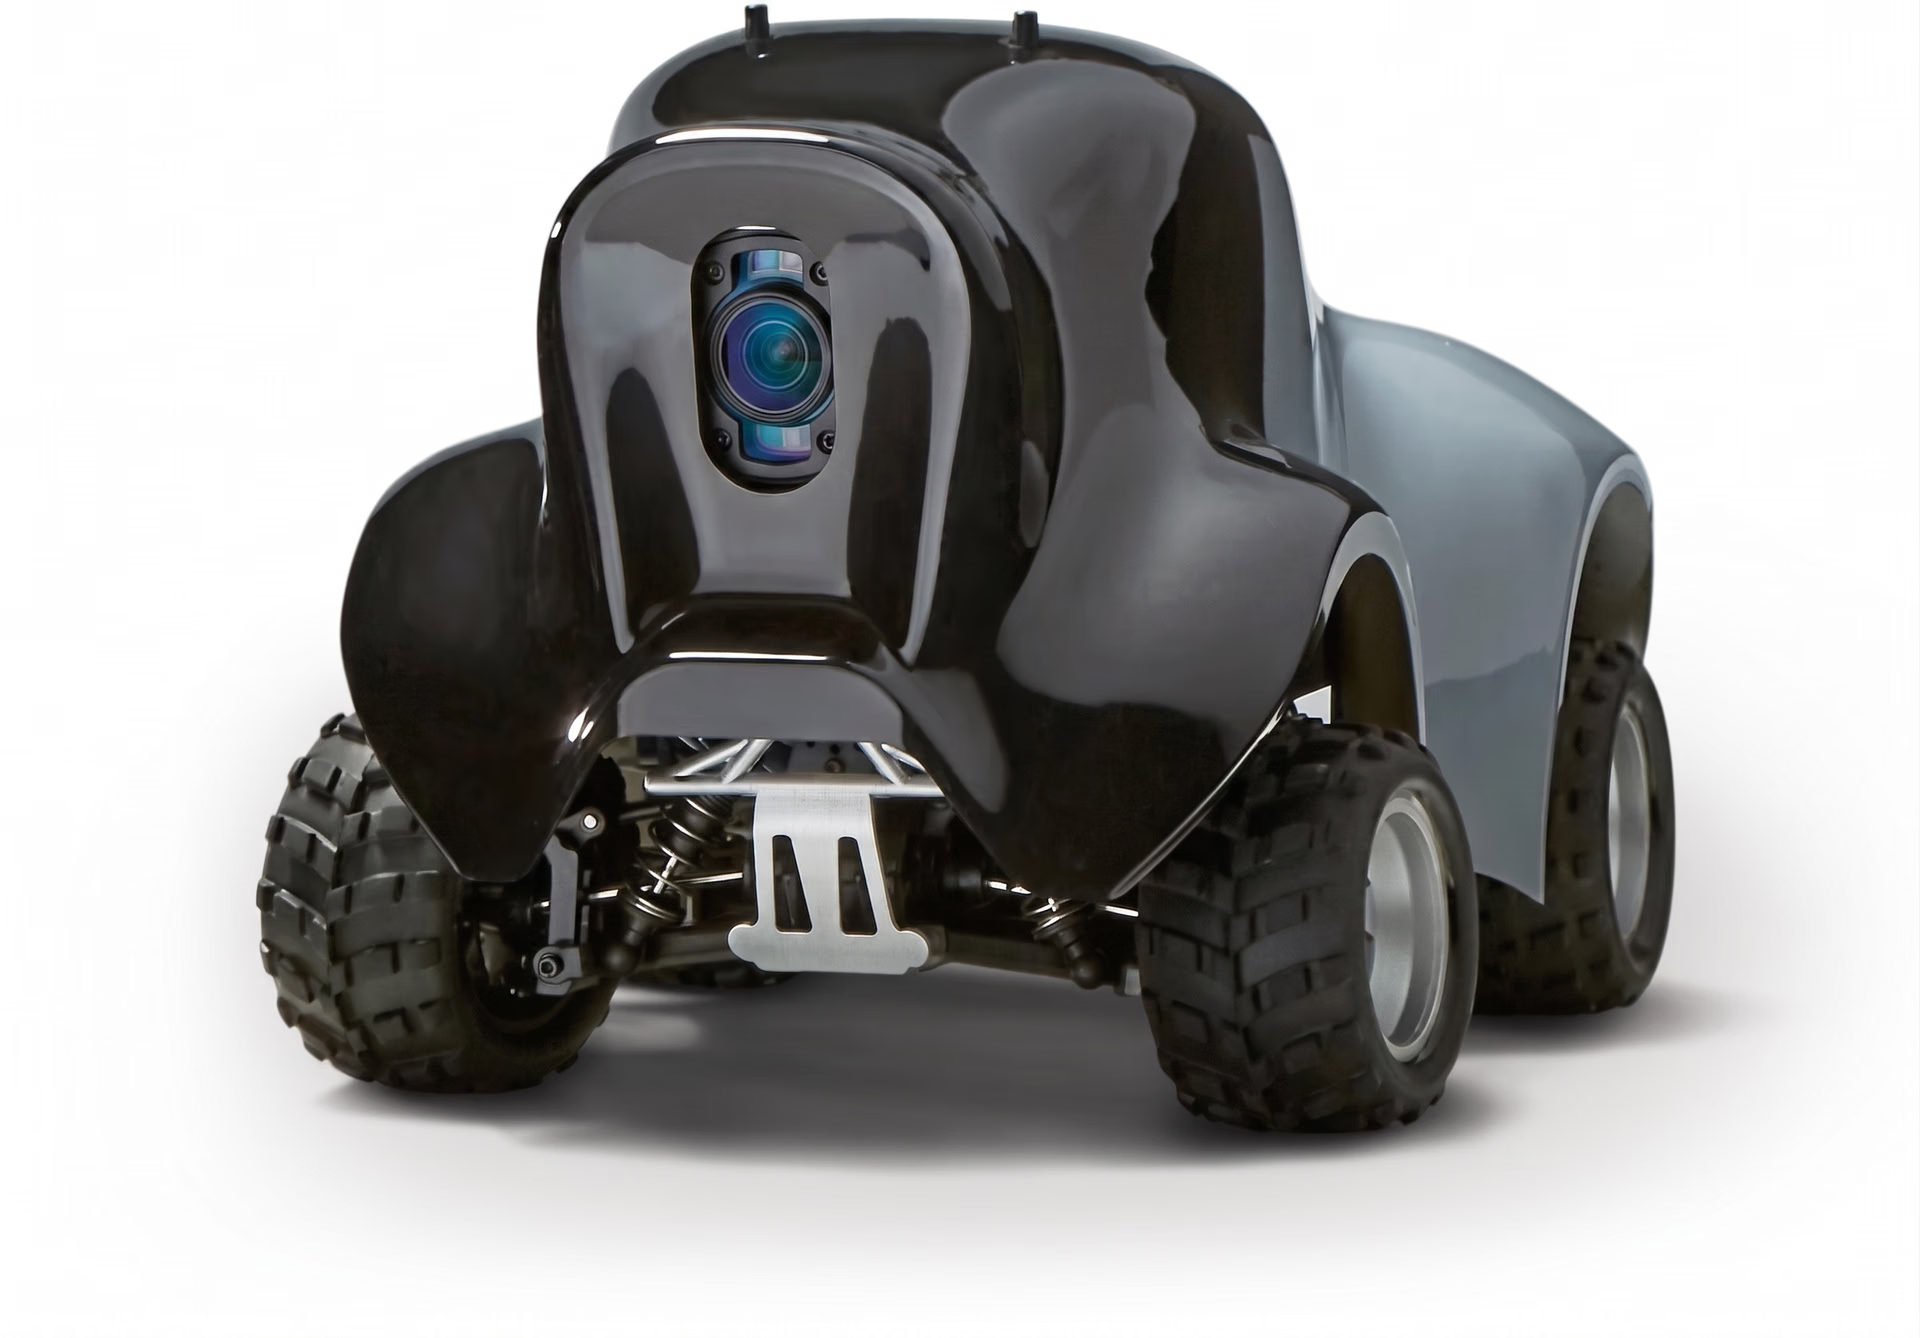
Hình 4. AWS DeepRacer sử dụng thị giác và học tăng cường để tự lái. Nguồn ảnh: Amazon.
Hướng tới robot phẫu thuật tự hành#
Một lĩnh vực nghiên cứu đầy triển vọng đang thu hút sự chú ý là tích hợp AI thị giác và học tăng cường trong phẫu thuật robot. Hiện tại, ứng dụng này vẫn chủ yếu mang tính lý thuyết. Các nhà nghiên cứu đang chạy mô phỏng trong môi trường ảo.
Tuy nhiên, những thử nghiệm ban đầu cho thấy kết quả đầy hứa hẹn, gợi mở khả năng robot phẫu thuật sẽ thực hiện được các thủ thuật phức tạp, tinh vi với độ chính xác và khả năng thích ứng cao hơn, đồng thời cần ít sự can thiệp của con người hơn.
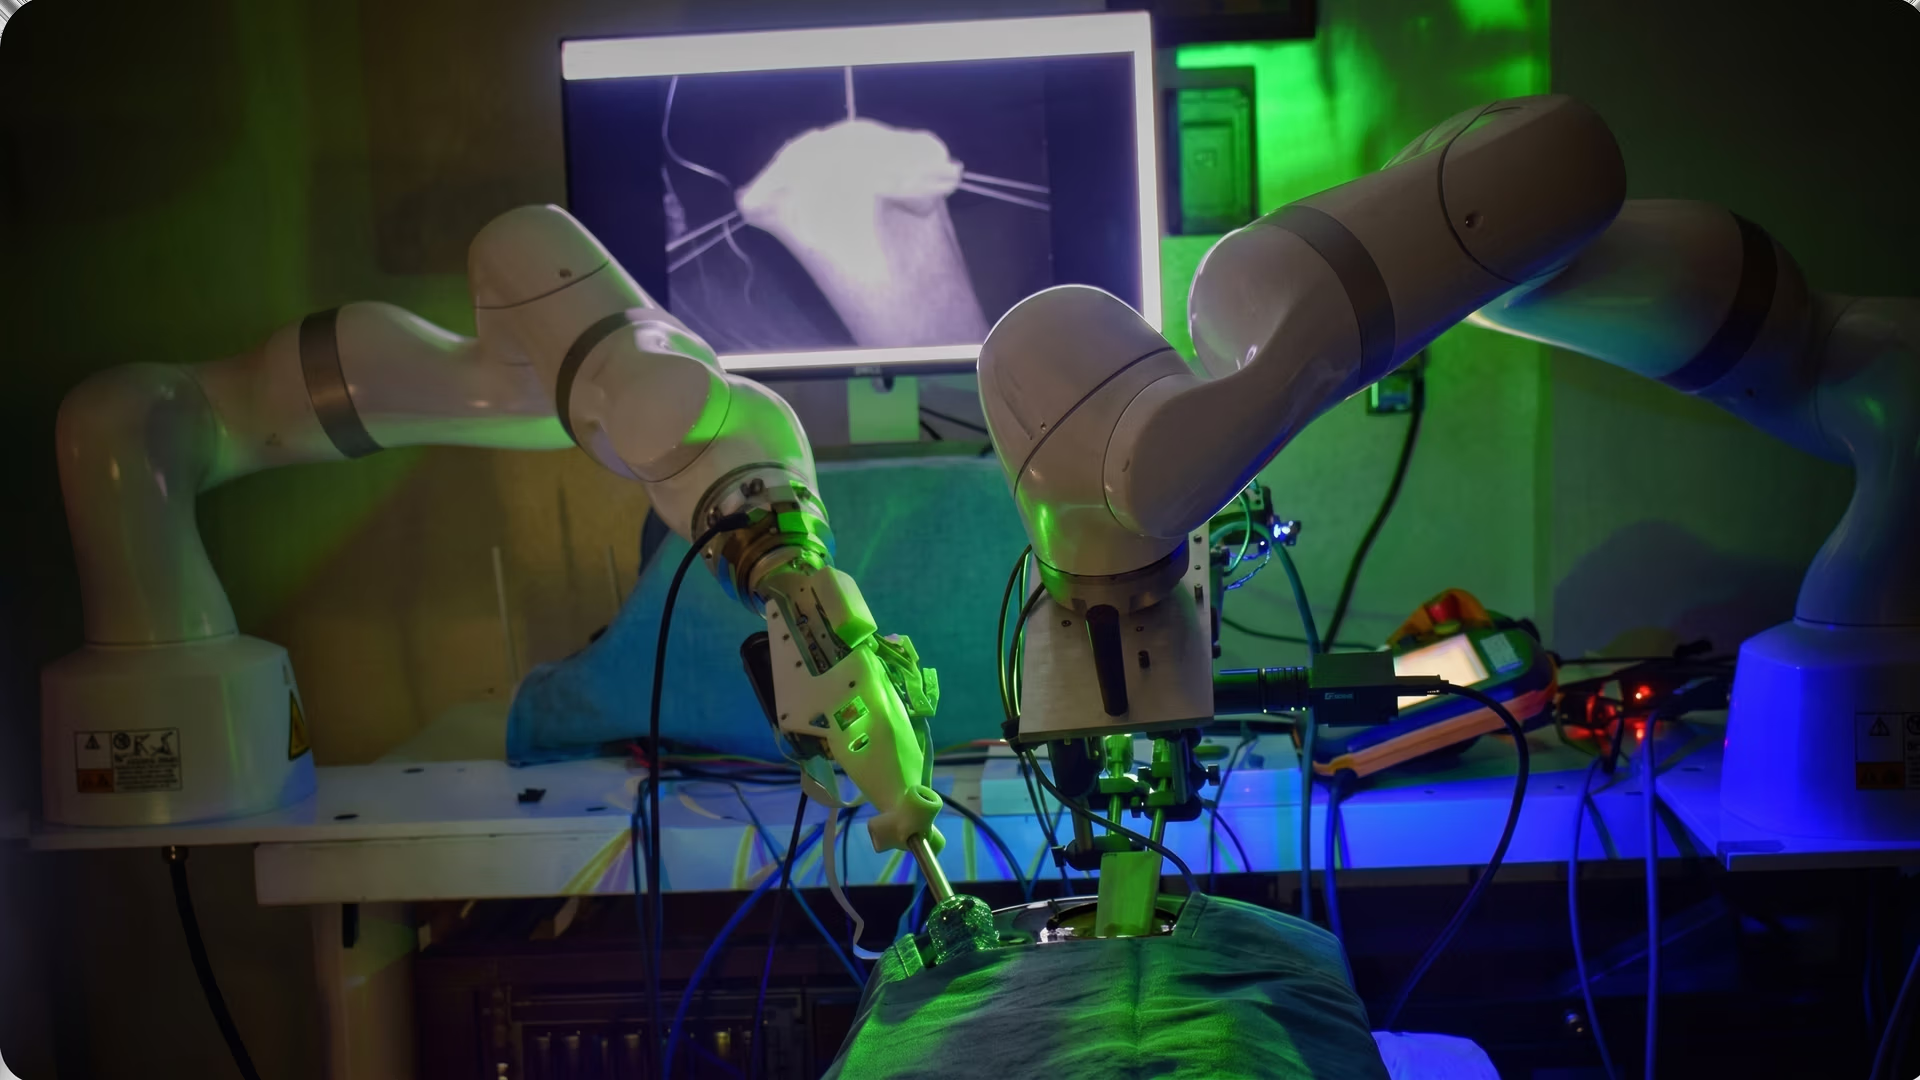
Hình 5. Robot phẫu thuật ngày càng tiên tiến.
Ví dụ, hãy hình dung tình huống cần nhẹ nhàng nhấc một miếng gạc khỏi vị trí phẫu thuật. Robot được trang bị AI thị giác trước tiên sẽ phân tích khung cảnh, sử dụng phân đoạn để xác định miếng gạc và các mô xung quanh.
Sau đó, học tăng cường sẽ giúp robot phẫu thuật quyết định cách tiếp cận nhiệm vụ, xác định góc tốt nhất để gắp miếng gạc, lực cần tác động và cách nhấc miếng gạc mà không làm ảnh hưởng đến các vùng nhạy cảm lân cận. Theo thời gian, thông qua việc thực hành nhiều lần trong môi trường mô phỏng, robot có thể học cách thực hiện những chuyển động tinh vi nhưng quan trọng này ngày càng thành thạo và tự tin hơn.
Ưu và nhược điểm của học tăng cường trong Vision AI#
Học tăng cường cho phép các hệ thống AI thị giác vượt ra khỏi khả năng nhận diện đơn thuần và bắt đầu đưa ra quyết định dựa trên những gì chúng quan sát được. Điều này mở ra những khả năng mới trong các lĩnh vực như robot, tự động hóa và tương tác theo thời gian thực.
Dưới đây là một số lợi ích chính của việc tích hợp học tăng cường vào quy trình AI thị giác:
- Ít phụ thuộc vào dữ liệu gán nhãn: Các hệ thống này có thể học thông qua tương tác, vì vậy không cần đến những dataset gán nhãn khổng lồ để bắt đầu.
- Xử lý tốt hơn sự không chắc chắn: Học tăng cường có thể xử lý thông tin hình ảnh không đầy đủ hoặc nhiễu bằng cách điều chỉnh hành động dựa trên phản hồi, thay vì chỉ dựa vào dữ liệu hoàn hảo.
- Hỗ trợ học tập dài hạn: Học tăng cường giúp model cải thiện theo thời gian bằng cách học từ chuỗi hành động, chứ không chỉ từ các quyết định đơn lẻ.
Mặt khác, sau đây là một số hạn chế của học tăng cường cần cân nhắc:
- Bài toán quy kết công lao: Agent có thể khó xác định hành động cụ thể nào góp phần tạo nên kết quả cuối cùng, đặc biệt trong các chuỗi quyết định dài.
- Nguy cơ khám phá không an toàn: Trong quá trình huấn luyện, agent có thể thử những hành động không an toàn hoặc không mong muốn, vốn không thể chấp nhận được trong các ứng dụng thực tế như chăm sóc sức khỏe hoặc lái xe tự hành.
- Hội tụ chậm: Model có thể mất nhiều thời gian mới đạt được hiệu suất tốt, đặc biệt với các tác vụ phức tạp.
Điểm chính cần ghi nhớ#
Học tăng cường trong các dự án thị giác máy tính giúp hệ thống AI hiểu môi trường xung quanh và học cách hành động thông qua trải nghiệm. Với các model như Ultralytics YOLO11 cung cấp khả năng phát hiện đối tượng theo thời gian thực, hệ thống có thể đưa ra quyết định sáng suốt dựa trên những gì quan sát được.
Cách tiếp cận này vượt qua các phương pháp truyền thống khi cho phép AI cải thiện thông qua thử nghiệm và phản hồi, thay vì chỉ dựa vào dữ liệu được gán nhãn. Cách này hỗ trợ học tập liên tục và giúp xây dựng các hệ thống AI thị giác linh hoạt, thích ứng và thông minh hơn, ngày càng cải thiện theo thời gian.
Tham gia cộng đồng đang phát triển của chúng tôi. Truy cập kho lưu trữ GitHub để tìm hiểu sâu hơn về AI. Bạn muốn bắt đầu dự án thị giác máy tính của riêng mình? Khám phá các lựa chọn cấp phép của chúng tôi. Tìm hiểu thêm về AI trong sản xuất và AI thị giác trong ngành ô tô trên các trang giải pháp của chúng tôi.
Được viết bởi
Nhà sáng tạo nội dung · Ultralytics
Bình luận
Đặt câu hỏi, chia sẻ kết quả hoặc giúp đỡ người khác.









