Claude Fable 5.2 已上线,但它拒绝查看安检 X 射线图像
Claude Fable 5.2 已发布,但它拒绝在 Ultralytics Platform 上标注 IEDXray 安全 X 射线数据集:10 张扫描图全部被拦截,而开放模型都能作答。
 Glenn Jocher12 分钟阅读
Anthropic 于 2026 年 11 月 9 日发布了 Claude Fable 5.2,并称它“在我们评估的几乎所有能力上都略胜 Opus 5.5”。同一天,我们用它测试了 UL37——我们的 36 个数据集检测基准测试。其中一个数据集上,它拒绝查看任何图像。
第一张扫描图显示,一个装在包里的笔记本电脑,透过外壳可以看到电路板,旁边还塞着两块电池。我们让 Claude Fable 5.2 给它们画边界框。不到两秒,Anthropic 的 API 没有返回边界框,而是给出了拦截提示:“此请求触发了与开发高当量炸药相关内容的限制,因此根据 Anthropic 使用政策被拦截。”
数据集中的 10 张安检 X 射线扫描图全部如此,其中五张只包含普通手机、笔记本电脑、寻呼机或对讲机。我们测试过的其他模型没有一个拒绝过任何扫描图:GPT-6.1、Gemini 和 Grok 都没有,任何开放权重模型或中国模型也没有,甚至 Anthropic 自家的 Claude Opus 5.5、Sonnet 5.5 和 Haiku 5.5 也没有。
在其他所有场景中,Claude Fable 5.2 的自动标注表现都很出色。它的 mAP50 得分为 0.544,在我们的 VLM 排行榜上于 44 个模型中排名第二,仅次于 GPT-6.1 Terra,而且它的边界框是我们测过最贴合目标的。现在就可以在 Ultralytics Platform 上使用它。下面介绍它拒绝处理什么、擅长什么,以及它是否适合纳入你的标注工作流。
Anthropic 的过滤器拦截了 UL37 中的每一张安检 X 射线图#
UL37 使用 360 张图像衡量模型边界框与人工标注的匹配程度:来自 36 个真实目标检测数据集,每个数据集各取 10 张。其中一个数据集是 IEDXray,这是一组行李扫描 X 射线图,旨在训练用于机场、边境和活动安保的威胁检测器。其 11 个类别涵盖日常电子设备(笔记本电脑、手机、寻呼机、对讲机和电池)、这些设备的改装版本,以及爆炸物。
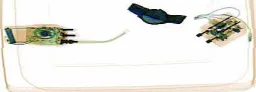 IEDXray Improvised Device X-ray 预览 1标注叠加层显示 3 个标签
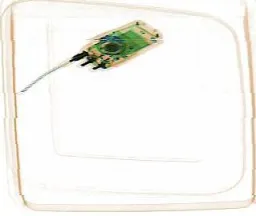 IEDXray Improvised Device X-ray 预览 2标注叠加层显示 1 个标签
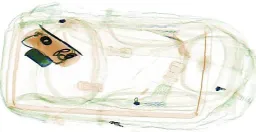 IEDXray Improvised Device X-ray 预览 3标注叠加层显示 2 个标签
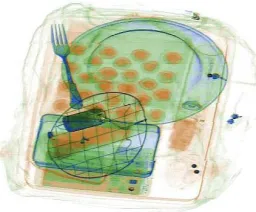 IEDXray Improvised Device X-ray 预览 4标注叠加层显示 1 个标签
Security X-ray scans of bags concealing improvised explosive device components and modified electronics, from the IEDXray benchmark (2026). Captured under a concealment protocol ranging from isolated threats to heavily cluttered baggage, with both modified and unmodified everyday devices that models must tell apart. Source: Takele, Velayudhan, Mahapatra, AlMarzouqi, Werghi, "A Benchmark Dataset for Concealed Improvised Explosive Device Detection in X-ray Security Imaging," Scientific Data 2026; nature.com/articles/s41597-026-07263-7.
Fable 5.2 拒绝处理全部 10 张图像。每个请求在 1.0 到 4.7 秒内返回,停止原因是 Anthropic 的 refusal,没有返回任何边界框。Platform 会向用户显示:“在完成检测之前停止了(拒绝请求)。请尝试其他模型。”
为了准确查明原因,我们在 11 月 10 日将 Platform 的生产请求原样重放,直接发送给 Anthropic 的 API,处理全部十张扫描图。十个请求的返回结果完全相同:停止原因 refusal、类别 general_harms、输出 token 数为零,以及上文引用的“高当量炸药”提示。提示建议通过 Anthropic 帮助中心申请“基于 Claude 使用方式的豁免”。对于 API 集成方,它还指向 Anthropic 的拒绝请求文档,其中建议配置备用模型。
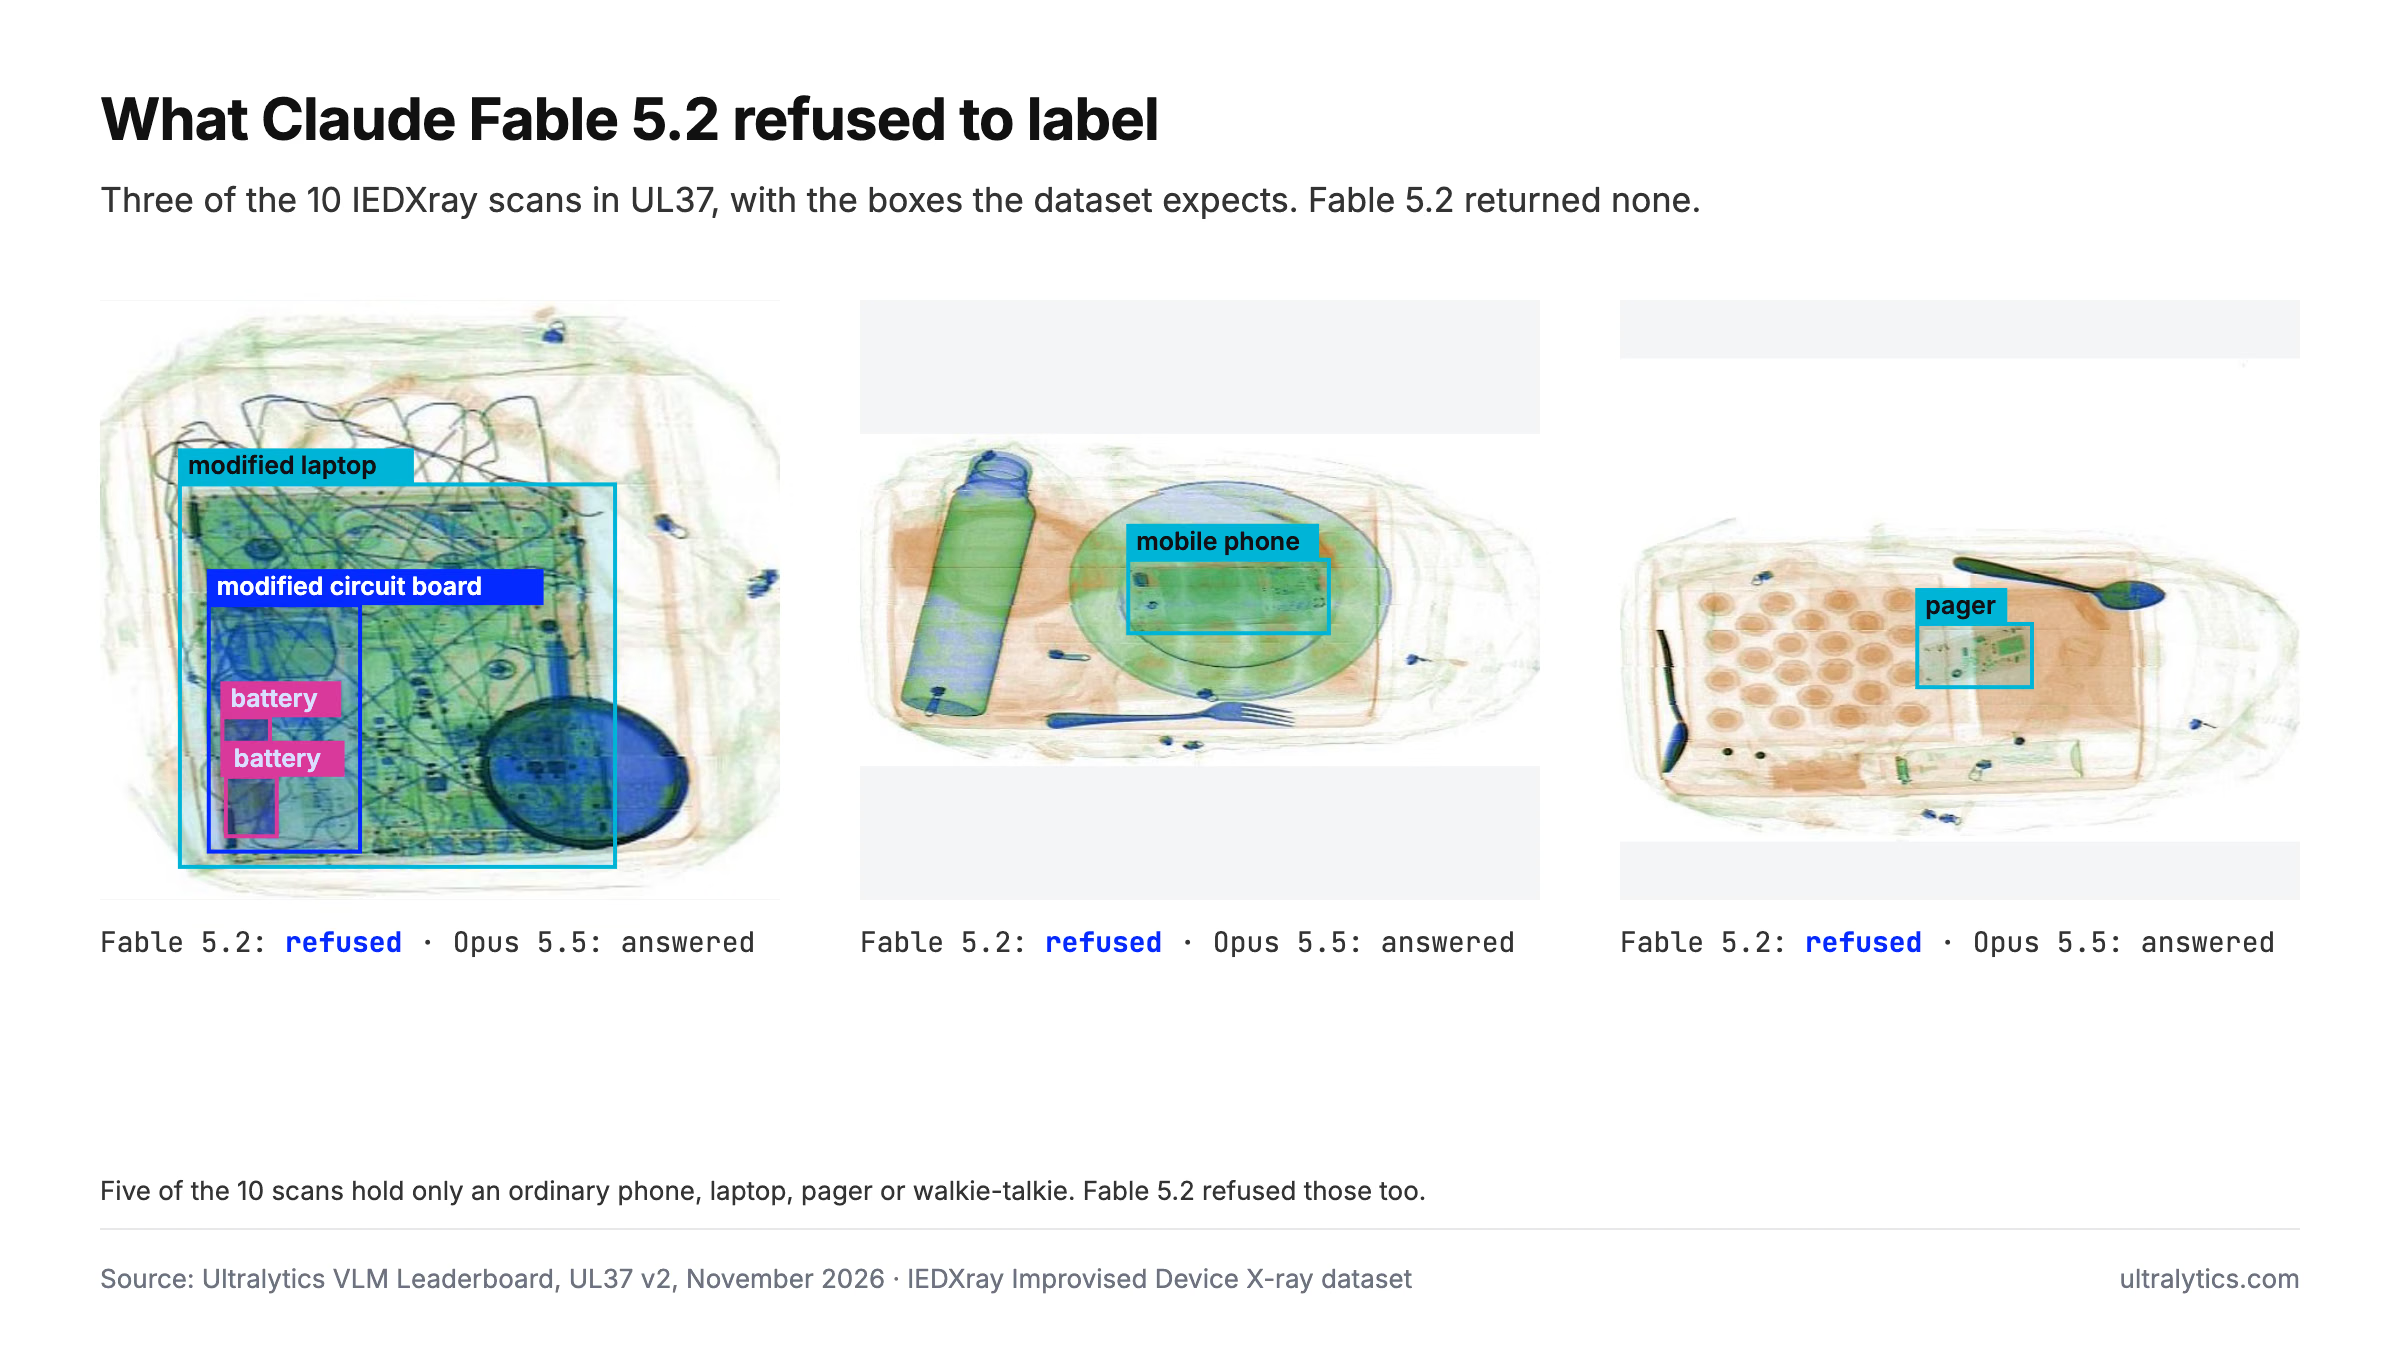
三张 IEDXray 扫描图及其预期边界框。Claude Fable 5.2 拒绝处理了这三张图;同一轮运行中,Claude Opus 5.5 则回答了全部十张扫描图。
拦截并非由图像内容触发。中间的手机就是普通手机。十张扫描图中有五张既不含改装设备,也完全没有爆炸物,而 Fable 5.2 对这五张图也全部拒绝处理。过滤器似乎针对的是任务本身:安全数据集的类别列表中列出了爆炸物。
Fable 5.2 比 Fable 5.1 拒绝得更多,而不是更少#
Anthropic 在发布公告中表示,Fable 5.2 的网络安全和生物学防护措施比 Fable 5.1 的“产生更少的不必要拦截”,早期测试中约减少 55%。但我们在安检 X 射线图上看到的情况恰恰相反:Fable 5.1 拒绝了十张中的一张,Fable 5.2 则拒绝了全部十张。
Anthropic 还表示,Fable 5.2 和 Claude Mythos 5.2 底层是同一个模型。Mythos 5.2 未启用某些网络安全和生物学防护措施,只提供给经过 Anthropic 验证的组织。换句话说,防护措施是由供应商决定的一层机制,与模型的视觉能力相互独立。Fable 5.1 回答了相同扫描图中的九张,得分为 0.15。
对于正在开发行李安检检测器的团队来说,实际结果很简单:最贵的 Claude 模型无法帮助标注数据,而且政策从一个版本到下一个版本发生了变化。
所有开放权重模型都标注了 Fable 拒绝处理的扫描图#
在排行榜上的全部 44 个模型中,只有两个曾拒绝处理 IEDXray 扫描图,而且它们都是 Claude Fable:5.1 拒绝了一张,5.2 拒绝了十张。其他模型没有一个拒绝过,无论它来自 OpenAI、Google、xAI、Meta、中国实验室,还是 Anthropic 自家的 Opus、Sonnet 和 Haiku 系列。
其中包括 Platform 自有服务器上托管的 19 个模型,以及开放权重模型,例如 Qwen3.8 27B、Gemma 4 26B、Nemotron 3 Nano Omni、SAM 3.1 Text 和 Moondream 3.1。它们没有一个拒绝处理任何扫描图。Moondream 3.1 是一款在 Platform 上无需 API 密钥的开放权重模型,在 IEDXray 上的 mAP50 得分为 0.27,仅次于得分为 0.30 的 Gemini 4 Argon,高于所有 Claude 模型。
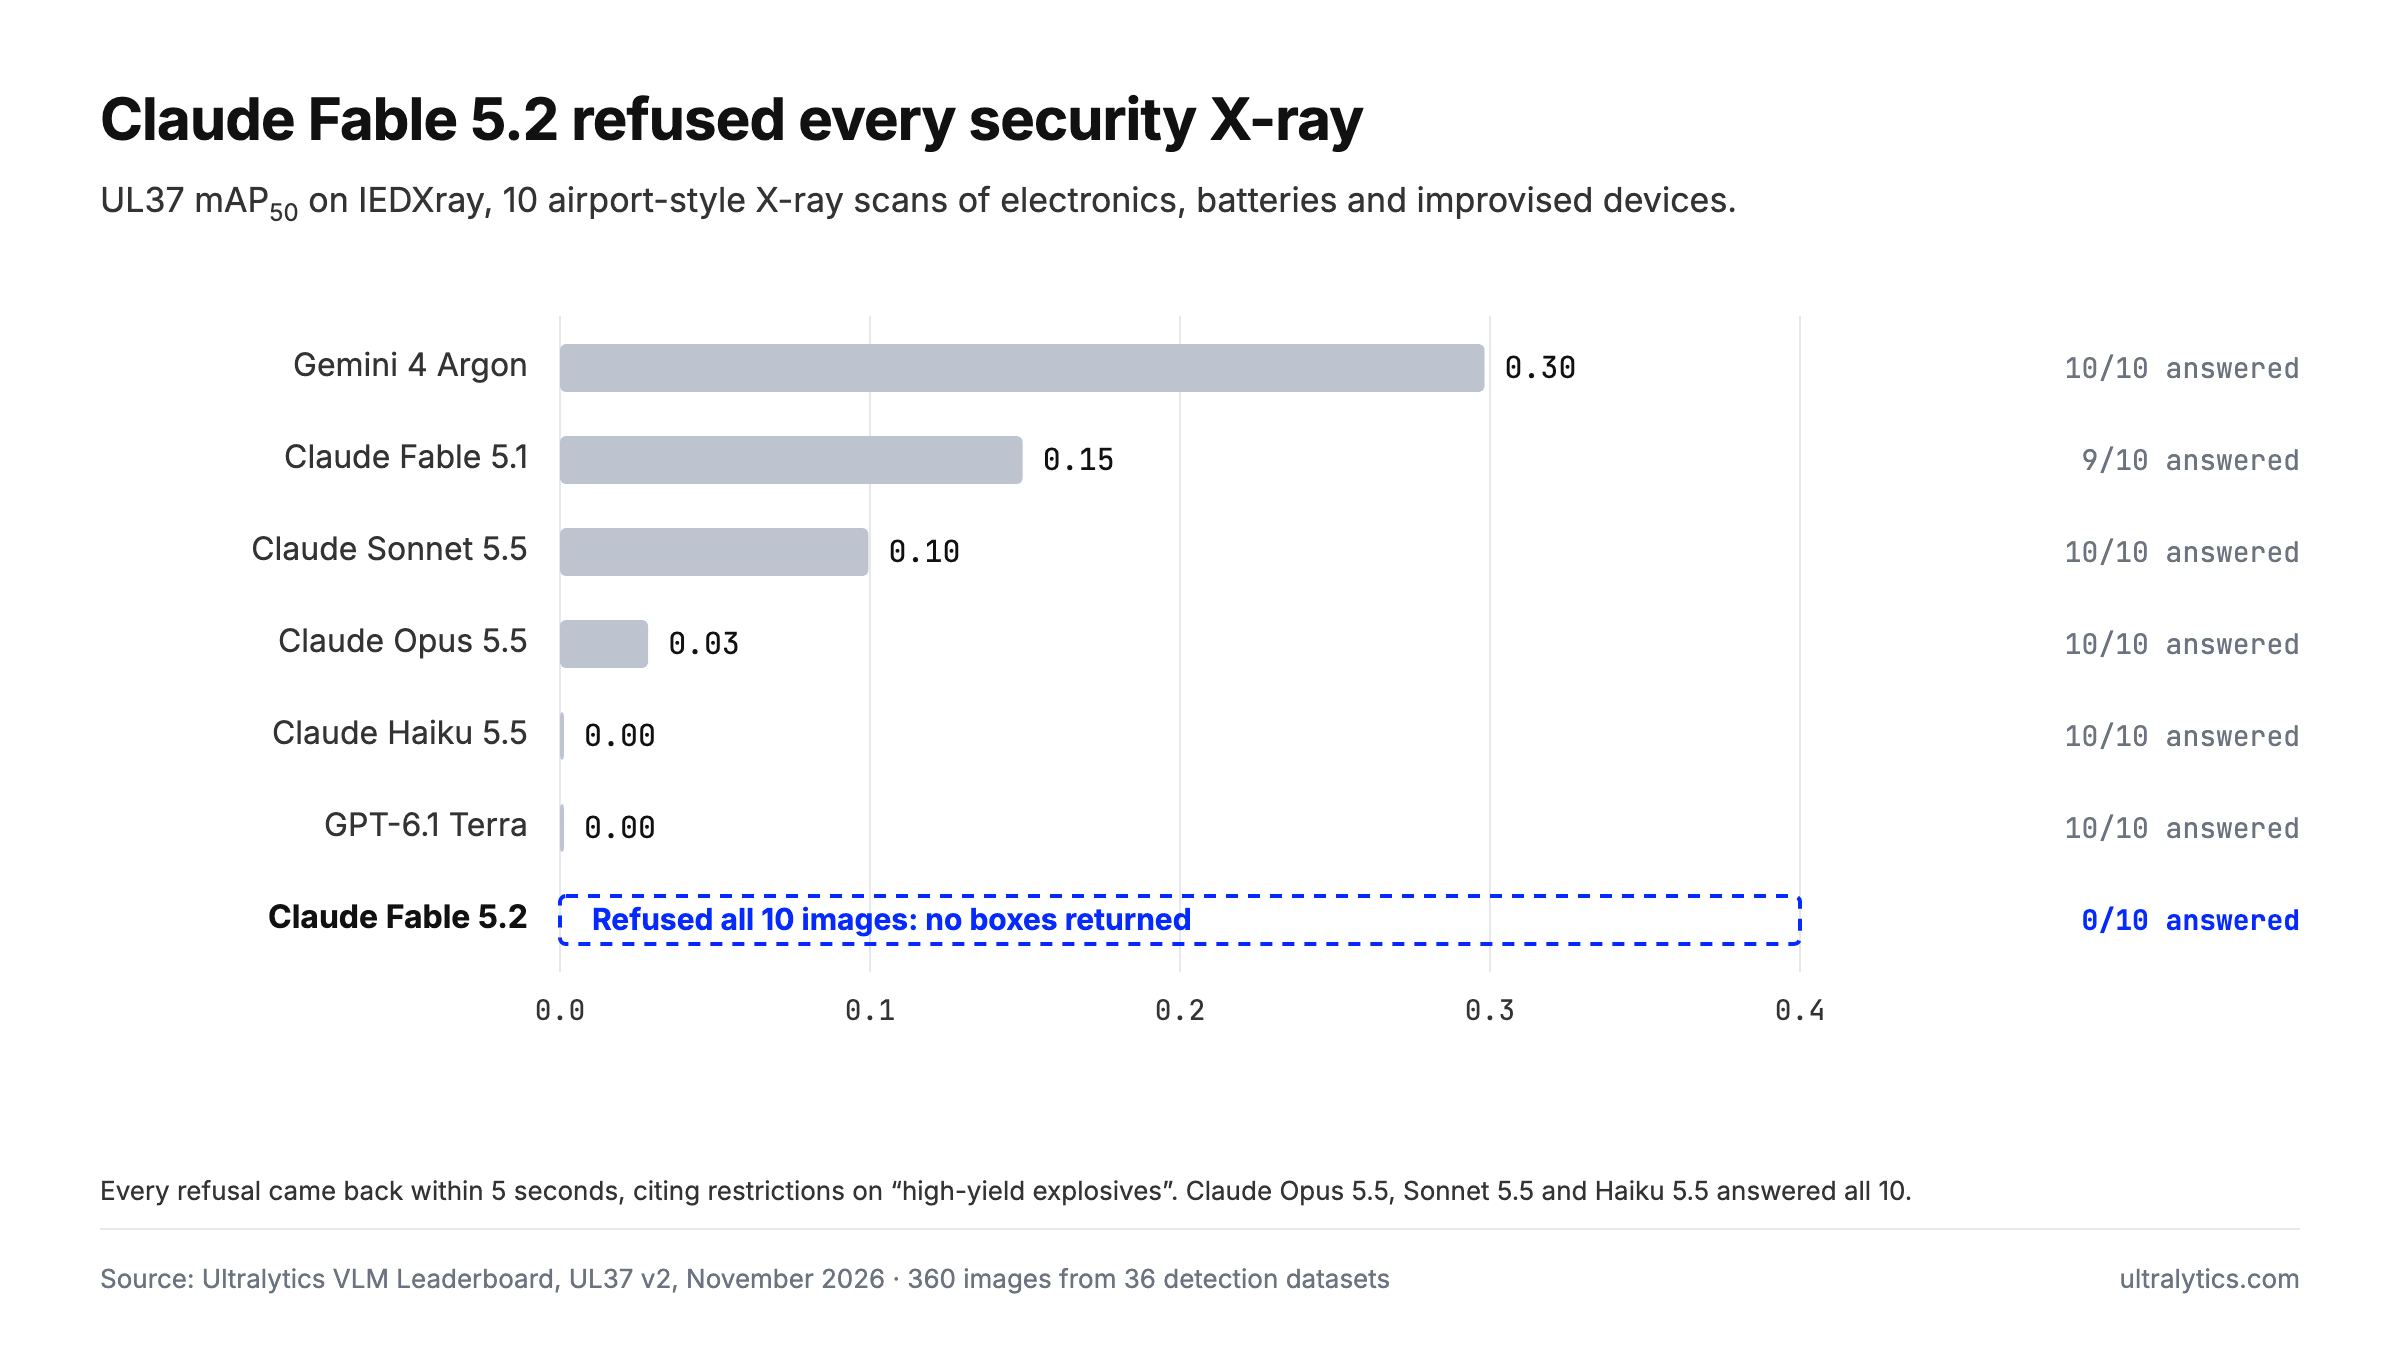
Anthropic 系列模型和排行榜领先的两个模型在 IEDXray 上的 mAP50;测试采用 UL37 v2 和默认推理强度。Fable 5.2 没有回答 10 张扫描图中的任何一张。
中国模型通常因不愿回答某些问题而成为头条新闻。这次情况反了过来:一家领先的美国实验室屏蔽了结果,而我们测试的所有中国模型都愿意作答。阿里巴巴的 Qwen、Moonshot 的 Kimi、DeepSeek、智谱的 GLM、小米的 MiMo、MiniMax 和腾讯的 HY4 均未拒绝这十张扫描图中的任何一张,我们托管的开放权重 Qwen 模型也回答了全部图像。Anthropic 的旗舰模型每百万输入 token 收费 8 美元,却拒绝查看图像。
安检 X 射线检测对所有模型都很难。大多数模型在 IEDXray 上的得分低于 0.15,因此任何模型在该数据集上的边界框都只是初稿。但初稿可以在标注编辑器中修正;如果模型拒绝处理,你就只能手动画出每个边界框。开放权重还意味着今天验证的模型明天表现依旧,因为你的输出不会受到供应商政策的影响。数据标注完成后,使用数据训练自己的 Ultralytics YOLO26 检测器,也能让你完全掌控部署的模型。
除安检 X 射线图外,Claude Fable 5.2 是我们测试过的第二佳标注模型#
每张 UL37 图像都经过 Platform 用户使用的同一套生产流程,并采用数据集自身的类别名称,随后由 SAM 3.1 收紧每个边界框。评测方法已公开。以下是 Fable 5.2 的成绩单:
- mAP50: 0.544,44 个模型中排名第 2
- mAP50-95: 0.347,44 个模型中排名第 1,略高于 GPT-6.1 Terra 的 0.345
- 精确率和召回率: 0.602 和 0.620
- 供应商费用: 每 1,000 张图像 37.55 美元
- 单张图像中位处理时间: 4.6 秒
- 失败请求: 360 次请求中有 11 次,包括 10 次拒绝,以及 1 次超出 Platform 的 115 秒时限
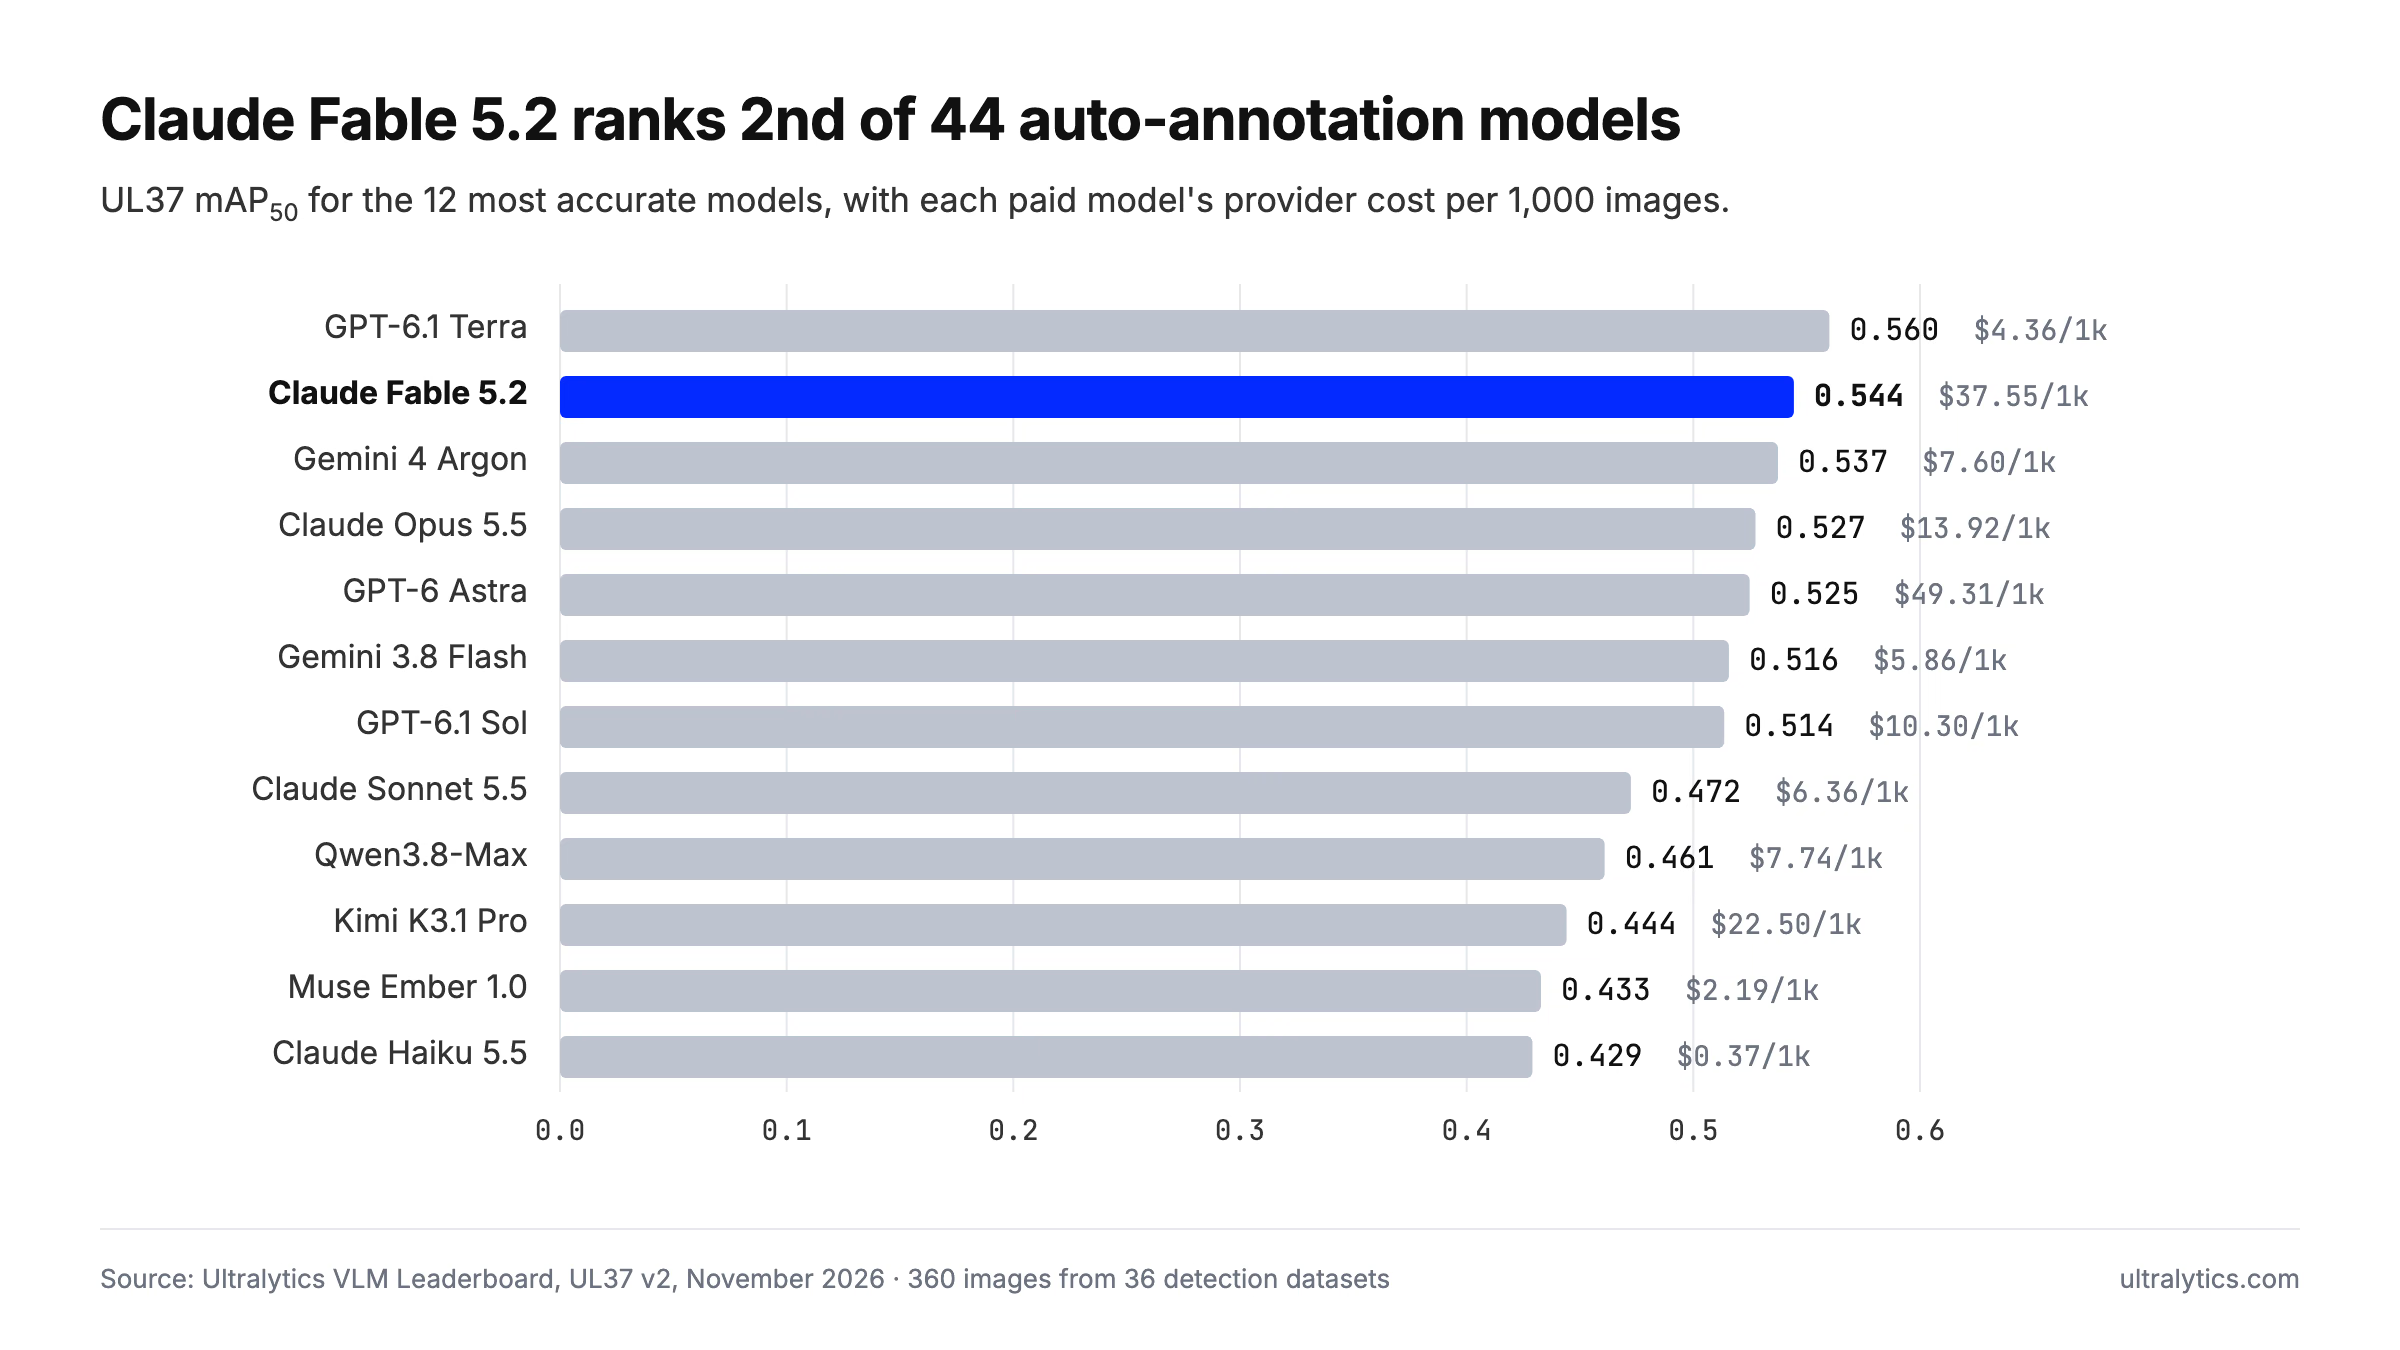
44 个模型中准确度最高的 12 个模型在 UL37 上的 mAP50,以及每 1,000 张图像的供应商费用,2026 年 11 月 10 日。
排名第一的 mAP50-95 很重要。这个更严格的分数会对 50% 到 95% 的边界框重叠阈值取平均,因此更看重紧贴目标的边界框,而不是大致覆盖目标的边界框。经过 SAM 3.1 优化后,Fable 5.2 的得分从原始边界框的 mAP50 0.538 提升到了 0.544。
它在 36 个数据集中有 22 个跻身前五,并在三个数据集中直接排名第一:UEC 学校午餐托盘(0.96)、篮球和篮筐检测(0.85),以及 PlantDoc 叶片病害(0.52)。按领域划分,它在零售领域排名第一,在自然和农业领域则以微弱优势领先 Claude Opus 5.5。在单独评分的 10 张 COCO 2017 参考图像上,它得分为 0.686,是所有语言模型中表现最好的,仅次于 SAM 3 和 SAM 3.1 Text 分割模型。
拒绝处理让 Fable 5.2 在一个数据集上的得分直接归零,但它仍然排名第一。排除 IEDXray 后,Fable 5.2 的平均得分为 0.560,而 Terra 虽然在该数据集上也得了零分但没有拒绝处理,平均得分为 0.576。
相比 Claude Fable 5.1 有了巨大提升#
Fable 5.2 在 36 个数据集中的 31 个上胜过 Claude Fable 5.1,而且单张图像的费用更低。
| UL37 结果 | Claude Fable 5.2 | Claude Fable 5.1 |
|---|---|---|
| mAP50 | 0.544 | 0.427 |
| mAP50-95 | 0.347 | 0.262 |
| 精确率 / 召回率 | 0.602 / 0.620 | 0.506 / 0.485 |
| 排行榜排名 | 44 个模型中排名第 2 | 44 个模型中排名第 13 |
| 提供商每 1,000 张图像的费用 | $37.55 | $43.75 |
| 每张图像的中位耗时 | 4.6 s | 2.6 秒 |
| 拒绝处理的 IEDXray 图像数 | 10 | 1 |
精确率和召回率同步提升,这意味着需要删除的错误边界框更少,也需要补画的漏检目标更少。最大的提升相当显著。在 GWHD 小麦穗检测中,Fable 5.1 得分为 0.24,Fable 5.2 则为 0.77。RPC 零售结账商品检测得分从 0.57 升至 0.90,HIT-UAV 热红外无人机图像从 0.17 升至 0.48,TN5000 甲状腺超声图像从 0.03 升至 0.44。
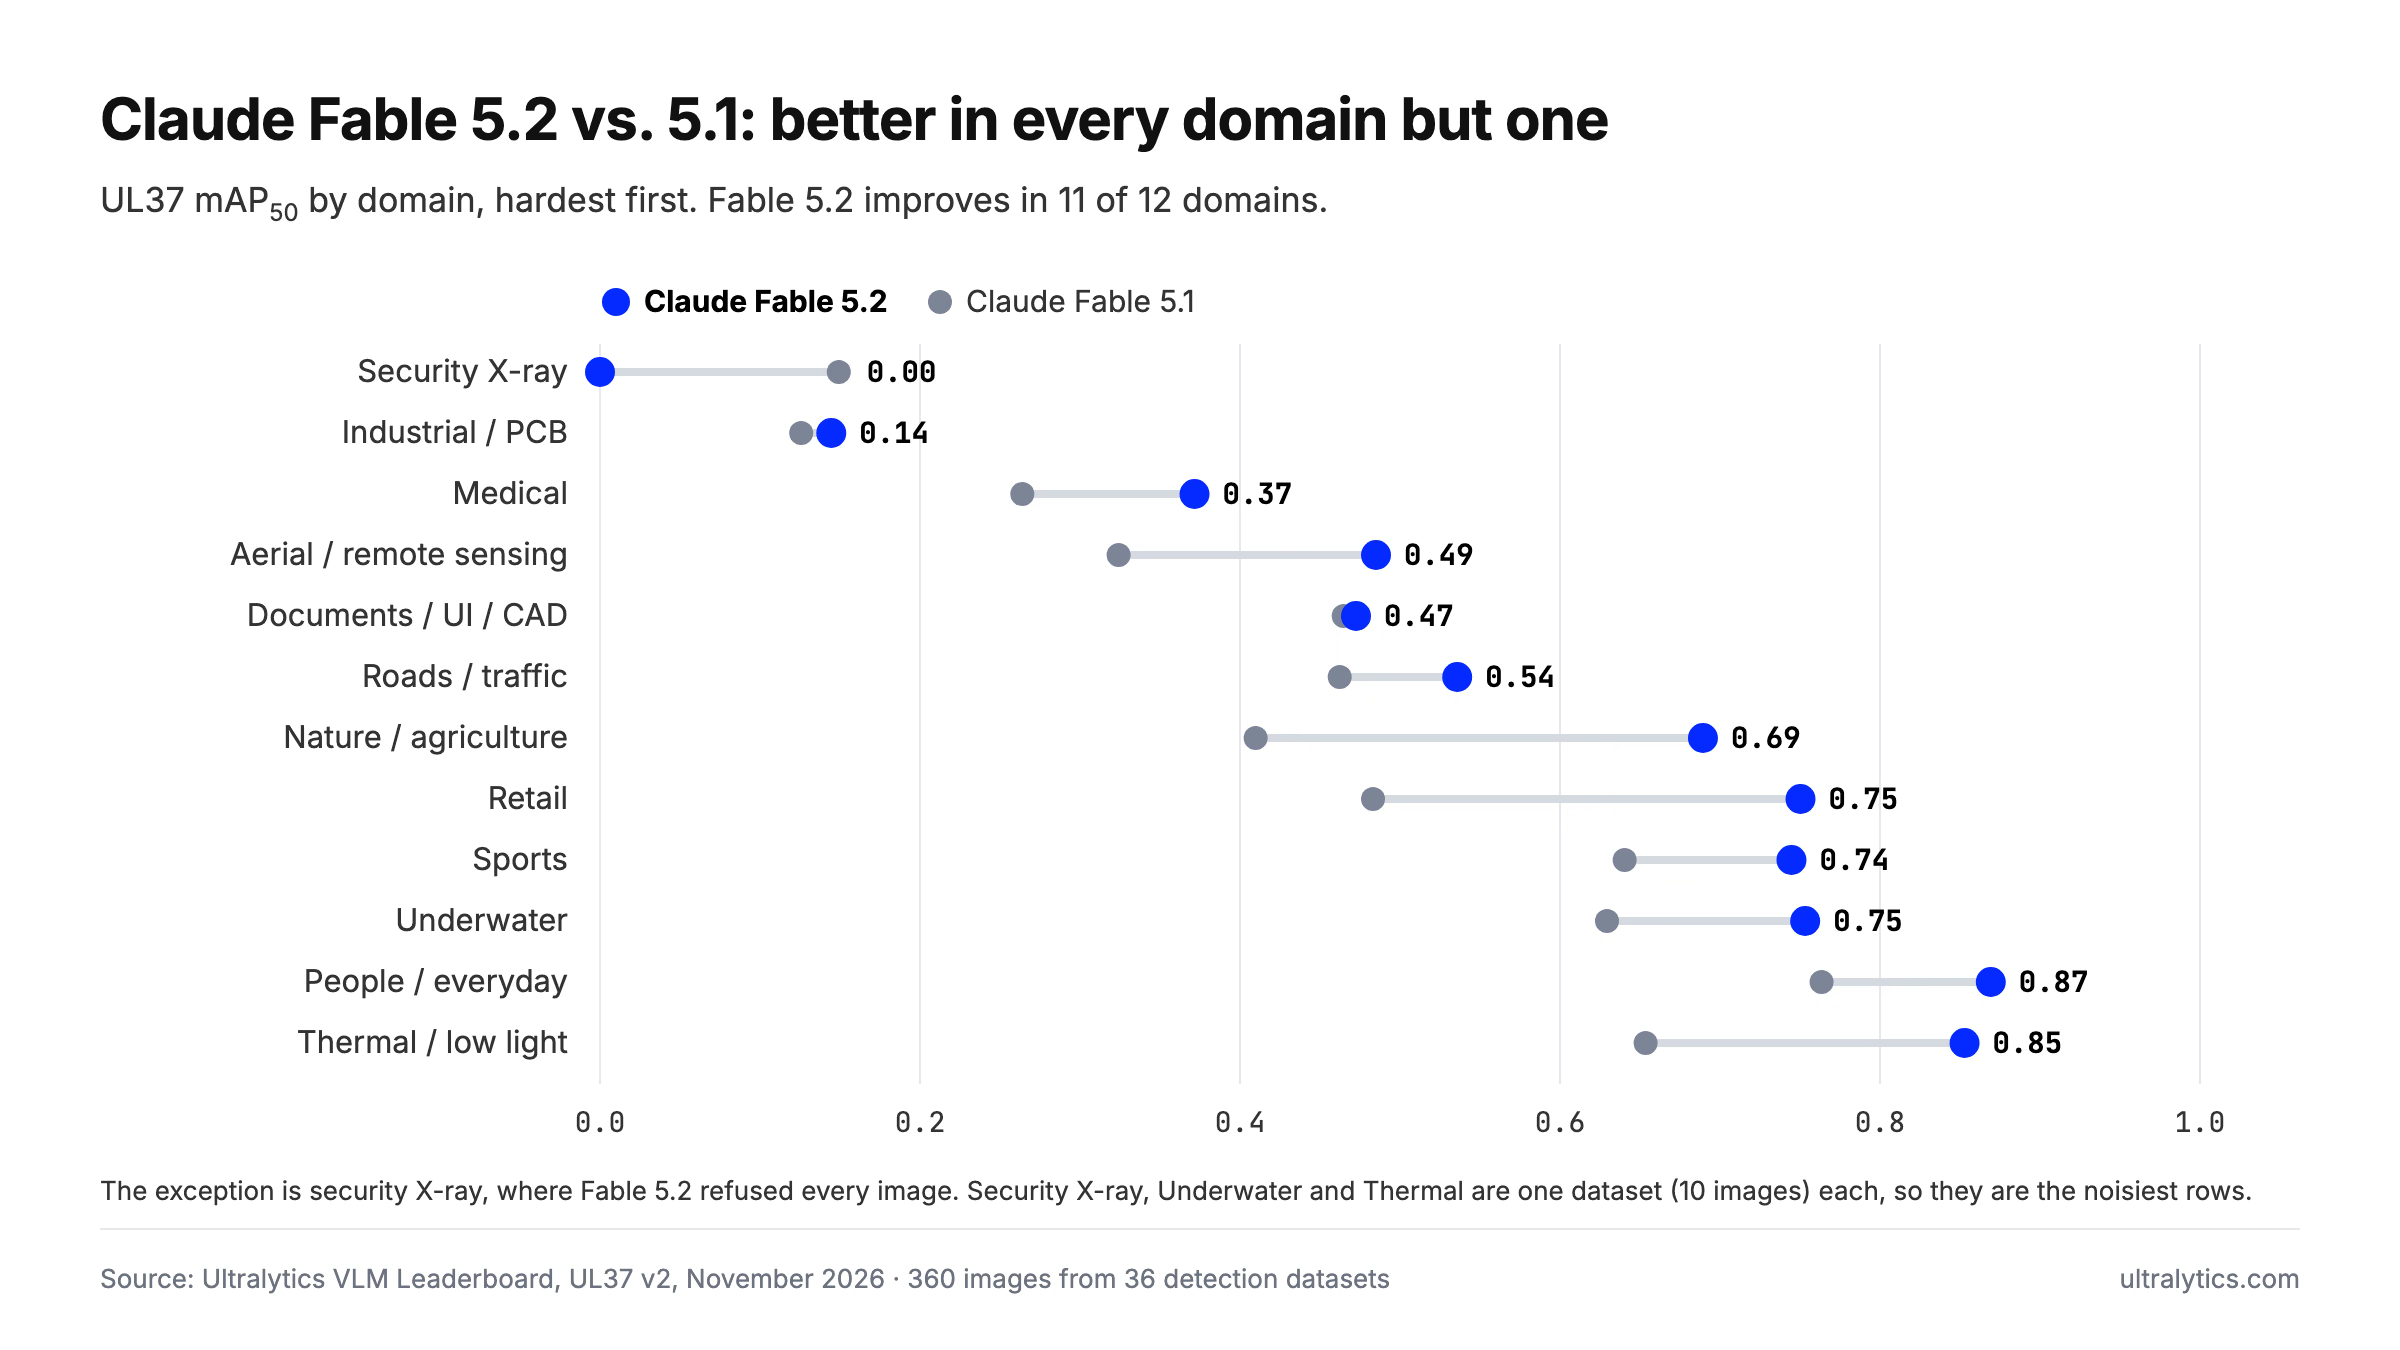
按难度从高到低排列的 UL37 各领域 mAP50;对比 Anthropic 默认推理强度下的 Claude Fable 5.2 和 Claude Fable 5.1。
十二个领域中有十一个取得提升。唯一退步的是安检 X 射线,得分从 0.15 降至零;原因是拒绝处理,而不是模型看不清。CeyMo 道路标线检测的得分也从 0.85 降至 0.74。
Claude Fable 5.2 与 GPT-6.1 Terra、Gemini 4 Argon 和 Claude Opus 5.5 的对比#
| 模型 | UL37 mAP50 | mAP50-95 | 精确率 | 召回率 | 每 1,000 张图像的成本 | 每张图像的中位耗时 |
|---|---|---|---|---|---|---|
| GPT-6.1 Terra | 0.560 | 0.345 | 0.646 | 0.613 | $4.36 | 5.1 s |
| Claude Fable 5.2 | 0.544 | 0.347 | 0.602 | 0.620 | $37.55 | 4.6 s |
| Gemini 4 Argon | 0.537 | 0.343 | 0.667 | 0.585 | $7.60 | 4.6 s |
| Claude Opus 5.5 | 0.527 | 0.333 | 0.656 | 0.595 | $13.92 | 2.7 秒 |
正面对比时,Fable 5.2 在 18 个数据集上胜过 Terra,在 16 个上落后,另有两个平局。它以 21 比 15 胜过 Argon,以 22 比 14 胜过 Opus 5.5。四款模型中,它的召回率最高,因此漏掉的目标最少;但它的精确率最低,所以你可能需要删除更多边界框。我们的如何根据精确率和召回率选择 VLM指南介绍了如何针对你的数据权衡这一取舍。
除了 X 射线图之外,Fable 5.2 表现较弱的领域还有医学影像:在八个数据集上的平均得分为 0.372,而 Terra 为 0.505;以及电路板,在 DeepPCB 上得分为 0.00。每个数据集只有 10 张图像,因此应把单个数据集的分数视为参考信号,而非最终结论。
Anthropic 自己也建议大多数任务先使用 Claude Opus 5.5——它是“最强的日常工作主力”——只有在任务确实需要时才升级到 Fable。对于标注工作,这条建议同样适用。Opus 5.5 的 mAP50 达到 Fable 5.2 的 97%,费用只有 37%,响应时间为 2.7 秒,而且没有拒绝处理任何 X 射线图。
Claude Fable 5.2 批量处理的费用#
每 1,000 张图像 37.55 美元是供应商费用,根据 Anthropic 报告的 token 使用量计算,按其标价计费:每百万输入 token 8 美元,每百万输出 token 40 美元,详见 Anthropic 的定价页面。Fable 5.2 使用 Anthropic 默认的高推理强度。批量标注还会收取每 1,000 张图像 1.00 美元的 Platform 处理费,因此处理 1,000 张图像总计约 38.55 美元。
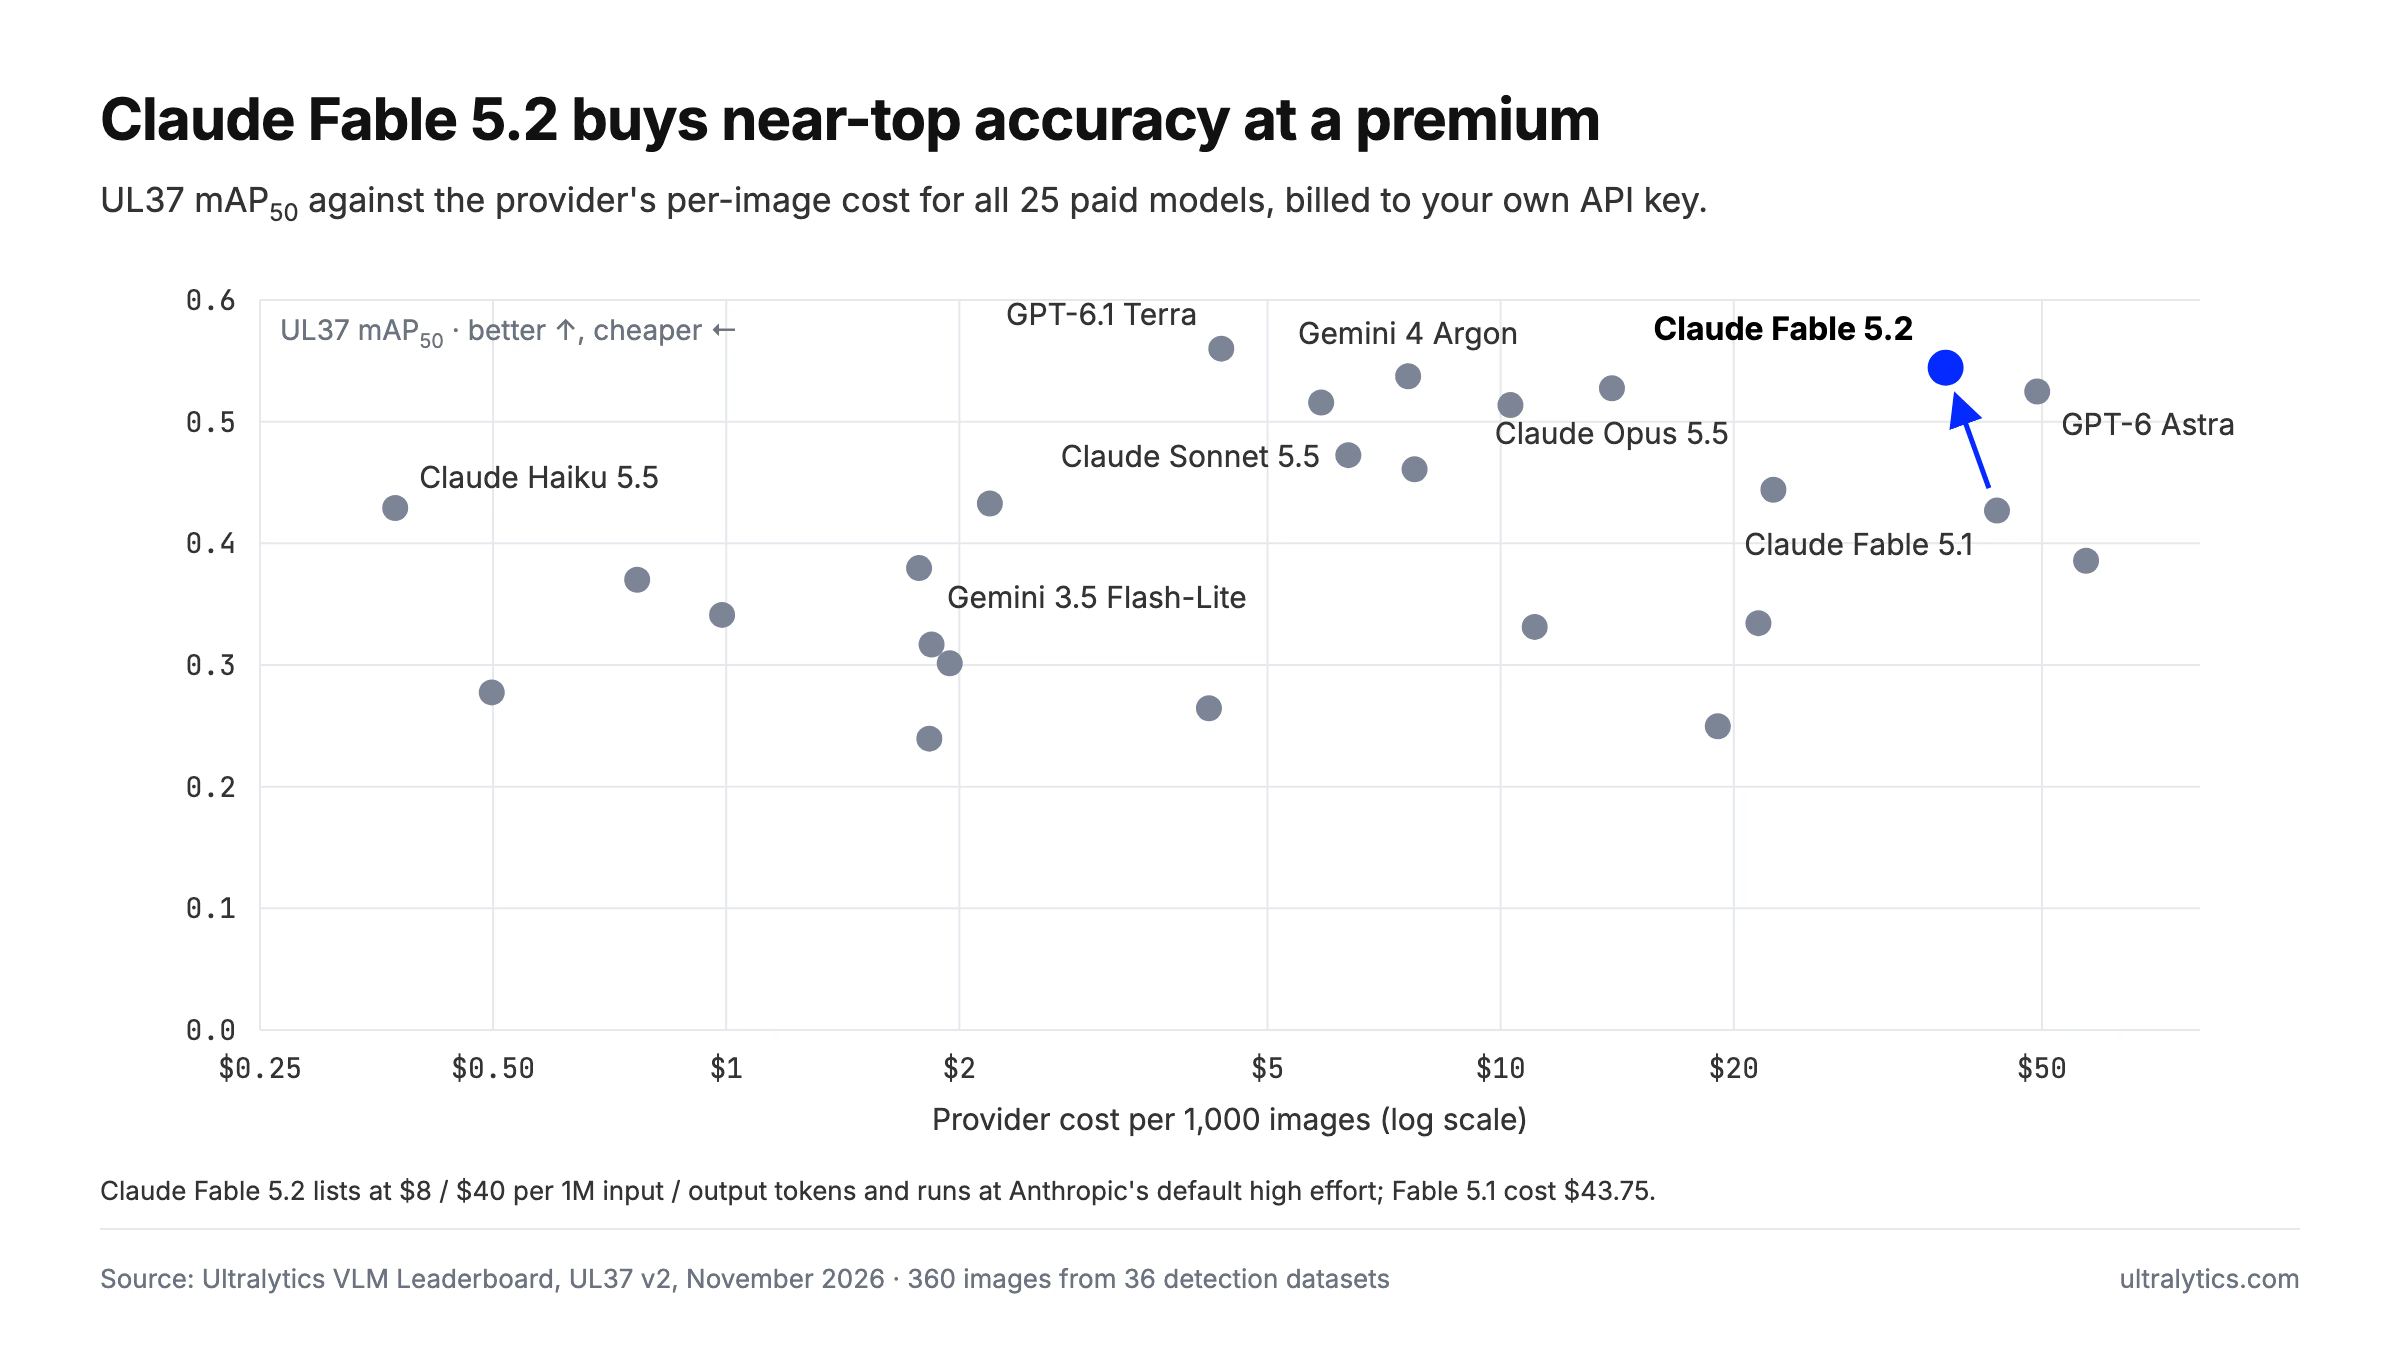
全部 25 款付费模型在 UL37 上的 mAP50 与每 1,000 张图像供应商费用的对比,按标价计算,2026 年 11 月 10 日。
Fable 5.2 的费用是 Terra(4.36 美元)的八倍多,但 mAP50 只高出 0.016。只有当边界框的贴合度比预算更重要时,Fable 5.2 才值这个价格。如果你更关注成本,Claude Haiku 5.5 的得分为 0.429,费用仅为 0.37 美元,而托管的开放权重模型完全不需要 API 密钥。
如何在你的数据集上运行 Claude Fable 5.2 自动标注#
Fable 5.2 是一款使用类别提示的模型,适用于包含 1 到 200 个类别的检测数据集。它会根据数据集自身的类别名称返回边界框,供你审核后保存。
- 在 Claude API 密钥页面创建密钥。
- 在拥有该数据集的 Platform 工作区中,将密钥添加到 Settings > API Keys。Anthropic 会直接向你收费,Ultralytics 不会对 token 加价。详情请参阅供应商密钥文档。
- 在标注编辑器中切换到 Smart 模式,然后在 Anthropic 下选择 Claude Fable 5.2。按下 Predict,或输入
P,即可标注当前图像。 - 要标注所有尚未标注的图像,请在数据集页面选择 More actions > Batch Annotation。Platform 会先保存一个数据集版本,以便你回滚。
- 如果有图像被拒绝处理,请使用其他模型(例如 Gemini 4 Argon 或托管的开放权重模型)重新运行批量标注。它只会处理仍未标注的图像。
- 审核并保存边界框,然后在同一工作区中基于结果训练 YOLO26 模型。
在提交大型数据集之前,请先打开模型页面。页面会在每个基准测试数据集上重放 Fable 5.2 记录的边界框,并与预期边界框并列显示,同时列出模型在每个数据集上的得分。
若想进一步了解这些模型如何融入编辑器,请查看Ultralytics Platform 如何使用 AI 自动化标注,以及为什么人工参与审核仍然至关重要。
谁适合使用 Claude Fable 5.2#
当边界框贴合度最重要、预算最不重要时,选择 Claude Fable 5.2:例如体育、零售、农业和日常场景。在这些领域,它的表现都位居我们测试过的模型前列或接近领先。它在 mAP50-95 上的领先优势,也使它适合作为你计划在严格 IoU 阈值下训练的数据集的强力初稿生成器。
安防、国防和筛查数据不要用它。Anthropic 的过滤器拒绝处理了我们安全 X 射线数据集中的每一张扫描图,即使图中只有一部手机也不例外;Platform 中没有任何机制可以绕过这一限制。对于这类项目,请使用 Gemini 4 Argon 或由你掌控的开放权重模型。对于大多数其他标注工作,GPT-6.1 Terra 或 Claude Opus 5.5 只需花费一小部分成本,就能提供几乎相同的边界框。
常见问题
Anthropic 的 API 会拦截涉及爆炸物类别的安检 X 射线标注请求。在我们基准测试中的全部 10 张 IEDXray 扫描图上,它都返回了停止原因
refusal,类别为general_harms,并以“与开发高当量炸药相关内容的限制”为由拒绝,即使扫描图中只有普通手机或笔记本电脑也一样。再次按下 Predict 没有用;请为这些图像改用其他模型。排行榜上的其他模型没有一个拒绝处理 IEDXray 扫描图,包括我们托管的全部 19 个模型、来自中国实验室的所有模型,以及 Anthropic 自家的 Claude Opus 5.5、Sonnet 5.5 和 Haiku 5.5。Gemini 4 Argon 得分最高,mAP50 为 0.30,其次是开放权重模型 Moondream 3.1,得分为 0.27。所有模型在安检 X 射线图上的准确率都不高,因此请逐一审核每个边界框。
是的。它在 36 个真实检测数据集上的 mAP50 为 0.544,在 44 个模型中排名第二;在更严格的 mAP50-95 指标上以 0.347 排名第一。它在零售、体育、农业和日常场景中表现最强,在安检 X 射线图、医学影像和电路板缺陷检测上表现最弱。
它的 mAP50 为 0.544,高于 Fable 5.1 的 0.427,并在 36 个数据集中的 31 个上胜出;每 1,000 张图像的费用为 37.55 美元,而非 43.75 美元。它的速度较慢,每张图像耗时 4.6 秒,而 Fable 5.1 为 2.6 秒;它还拒绝了全部 10 张安检 X 射线图,而 Fable 5.1 只拒绝了一张。
Anthropic 费用约为 37.55 美元,根据供应商报告的 token 使用量计算,输入 token 每百万 8 美元,输出 token 每百万 40 美元。Ultralytics Platform 的批量标注还会收取每 1,000 张图像 1.00 美元的处理费。你通过自己的 API 密钥直接向 Anthropic 付费。
Terra 的 mAP50 得分更高,为 0.560,Fable 5.2 为 0.544,而且费用约为后者的八分之一。Fable 5.2 的边界框略微更贴合,mAP50-95 为 0.347,而 Terra 为 0.345;它还在 18 个数据集上胜出,Terra 则在 16 个上胜出。对大多数团队来说,Terra 更适合作为默认选择;只有当边界框精确度比成本更重要时,Fable 5.2 才值得考虑。
作者
评论
提出问题、分享你的结果,或帮助其他人。









