Jetson Orin Nano Super 与 Raspberry Pi 5:YOLO26 目标检测对比
YOLO26n 推理:Jetson Orin Nano Super 上为 4.57 ms(TensorRT FP16),Pi 5 CPU 上为 67.03 ms,数据来自两次独立测试。请根据模型、FPS 和摄像头数量进行选择。
 Onuralp Sezer12 分钟阅读
你应该在 Raspberry Pi 5 还是 NVIDIA Jetson Orin Nano 上运行目标检测?如果只有一个摄像头、目标帧率较低且模型较小,Pi 5 CPU 可能就够用:在我们发布的基准测试中,Ultralytics YOLO26n 导出为 NCNN 后,在其四个 Arm 核心上每张图像的推理耗时为 67.03 ms,约为每秒 15 帧推理。当你需要更多摄像头、更大的模型,或需要 Pi 无法提供的更高帧率余量时,Jetson 就能派上用场:在 Jetson Orin Nano Super Developer Kit 上,同一模型作为 TensorRT FP16 引擎时耗时为 4.57 ms。
Ultralytics 发布这项对比并开发可在两块板卡上运行的 YOLO26;我们不制造这两块板卡。Jetson 数据来自 Orin Nano Super Developer Kit(NVIDIA 入门级 Orin 开发套件),Pi 数据来自 Raspberry Pi 5,二者分别测试。许多人仍在搜索“Jetson Nano”,也就是 2019 年推出的原版板卡。它可通过 JetPack 4 运行 YOLO26,但我们的 Jetson 指南没有提供它的 YOLO26 基准测试,因此本文仅列出其规格。
下文将介绍:这些板卡如何按模型大小、目标帧率和摄像头流数量进行比较;增加摄像头后 FPS 为何会下降;如何自行测量两块板卡;以及哪块板卡适合你的项目。设置步骤请参阅 NVIDIA Jetson 指南和 Raspberry Pi 指南;我们的 在 Raspberry Pi 5 CPU 上进行目标检测实操指南则深入介绍 Pi 端的内容。
Pi 5 使用 CPU 运行 YOLO;Orin Nano Super 则配备 GPU#
这两块板卡通过不同的芯片解决同一问题。Raspberry Pi 5 是一台通用计算机,配备四个 Arm Cortex-A76 核心,没有专用 AI 加速器,因此我们的 Pi 基准测试是在 CPU 上运行 YOLO。Jetson Orin Nano Super Developer Kit 将基于 Ampere GPU 架构的 Orin Nano 模组与载板搭配使用,而 NVIDIA 的 TensorRT 运行时会为该 GPU 编译模型。它是专为此类工作负载设计的边缘 AI平台。
| Jetson Nano 4GB(2019) | Jetson Orin Nano Super | Raspberry Pi 5 | |
|---|---|---|---|
| YOLO 计算能力 | 128 核 Maxwell GPU | 1024 核 Ampere GPU,32 个 Tensor Core | 4 核 Arm Cortex-A76 CPU |
| CPU | 4 核 Cortex-A57,1.43 GHz | 6 核 Cortex-A78AE,最高 1.7 GHz | 4 核 Cortex-A76,最高 2.4 GHz |
| 内存 | 4 GB LPDDR4,25.6 GB/s | 8 GB LPDDR5,102 GB/s | 因型号而异 |
| AI 性能(NVIDIA 峰值数据) | 472 GFLOPS | 67 稀疏 INT8 TOPS | — |
| JetPack / 操作系统 | 仅 JetPack 4 | JetPack 5 至 7 | Raspberry Pi OS |
| Ultralytics 部署路径 | TensorRT,包括 DeepStream | TensorRT(在我们的基准测试中速度最快) | NCNN(在我们的基准测试中速度最快) |
规格而非测量数据,核对日期为 2026 年 11 月 19 日。NVIDIA 的峰值数据采用不同的数值格式,因此无法直接比较。Orin Nano Super 的 67 TOPS 是稀疏 INT8 数据;NVIDIA 列出的密集计算性能为 33 TOPS。Jetson 数据行取自 NVIDIA Jetson 指南中的对比表和 JetPack 表,以及 DeepStream 指南;Pi 5 数据行取自 Raspberry Pi 文档。
功耗也是选择时需要考虑的因素。NVIDIA 列出的 Orin Nano Super Developer Kit 功耗为 7 W 至 25 W。如果板卡刷入启用了 Super 模式的配置,Orin Nano 8GB 将提供 15 W、25 W 和 MAXN SUPER 功耗模式;使用默认配置时则保留原有的 7 W 和 15 W 模式。无论选择哪块板卡,都要在连接摄像头后测量整个系统的功耗,因为电源和外壳都必须满足这一需求。
核算整套设备的成本,而不仅是板卡:存储、电源、散热和摄像头都会增加两种方案的成本。随着内存成本上涨,Raspberry Pi 在 2026 年不止一次上调 Pi 5 价格。截至 2026 年 11 月,2GB Pi 5 标价为 $77.50,16GB 板卡标价为 $385。Jetson 的当前价格和供货情况,请查看 NVIDIA 开发套件页面;此外还要计入 Pi 所需加速器的成本,例如 Raspberry Pi AI HAT+。对于生产部署,NVIDIA 销售可搭配自有载板使用的 Jetson 模组;我们用于基准测试的开发套件适合开发和原型制作。
Pi 5 CPU 适合低 FPS 的 YOLO26n 工作负载#
如果所需帧率不高,Pi 5 无需额外硬件就能处理单摄像头检测。在 Ultralytics 基准测试中(FP32 导出、640 像素输入、COCO128、Ultralytics 8.4.108,仅统计推理时间),NCNN 是速度最快的导出格式:YOLO26n 每张图像耗时 67.03 ms,mAP50-95 为 0.4784。推理速度约为 15 FPS,适用于计数站、货架摄像头或不需要快速运动检测的机器人原型。请验证完整的摄像头处理流程,而不只是推理。Arm 也发布了一个适用于 Pi 5 上 YOLO26n 的开源运行时,并在其自有测试中测得该运行时比 NCNN 更快;我们的 Raspberry Pi 5 实操指南对比了二者。
模型尺寸是 Pi 的短板。更大的 YOLO26s 在 Pi 5 上使用 NCNN 时耗时 172.88 ms,推理速度不到 6 FPS。Raspberry Pi 指南中的多格式对比(Ultralytics 8.4.108)仅涵盖 n 和 s。较早的 ONNX 对比(Ultralytics 8.4.14)还报告了 m、l 和 x,其中 YOLO26m 耗时 993.78 ms。如果小目标或难以区分的类别让你需要更大的模型或更高的输入尺寸,请在确定方案前先在板卡上测试该模型。
为 Pi 5 添加 AI HAT+#
还有第三种配置值得考虑:Pi 5 搭配 Raspberry Pi 的 AI HAT+,可添加 13 TOPS 或 26 TOPS 版本的 Hailo 加速器。在 Ultralytics 的 Hailo 集成基准测试中(Ultralytics 8.4.174、COCO128),为 26 TOPS Hailo-8 版本导出的 YOLO26n 每张图像耗时 21.7 ms,mAP50-95 为 0.455;同一台 Pi 上未导出的 PyTorch 模型耗时 364.6 ms。该测试未注明输入尺寸,且使用 INT8,因此应将其视为独立基准测试,而非下方对比表中的一项。Hailo 模型需要经过编译,因此导出后请使用你自己的图像检查精度。
在 Orin Nano Super 上,YOLO26n 到 YOLO26l 的推理耗时均低于 18 ms#
在 Jetson 上,更大的模型也能实用。Ultralytics 在 Orin Nano Super Developer Kit 上进行的基准测试(640 像素输入、COCO128、Ultralytics 8.4.33,仅统计推理时间)显示,n 到 l 的所有尺寸在作为 TensorRT FP16 引擎运行时,每张图像的推理耗时都低于 18 ms:
| YOLO26 模型 | Raspberry Pi 5 CPU(ms/图像) | Orin Nano Super,TensorRT FP16(ms/图像) | Orin Nano Super mAP50-95,FP16 |
|---|---|---|---|
| YOLO26n | 67.03(NCNN FP32,8.4.108) | 4.57 | 0.4800 |
| YOLO26s | 172.88(NCNN FP32,8.4.108) | 7.17 | 0.5649 |
| YOLO26m | 993.78(较早的 ONNX 测试,8.4.14) | 13.59 | 0.6225 |
| YOLO26l | 1259.46(较早的 ONNX 测试,8.4.14) | 17.42 | 0.6225 |
分别测试的已发布结果。Orin Nano Super:Ultralytics 8.4.33。所有数据均使用 640 像素输入,仅统计推理时间,不包括预处理和后处理。
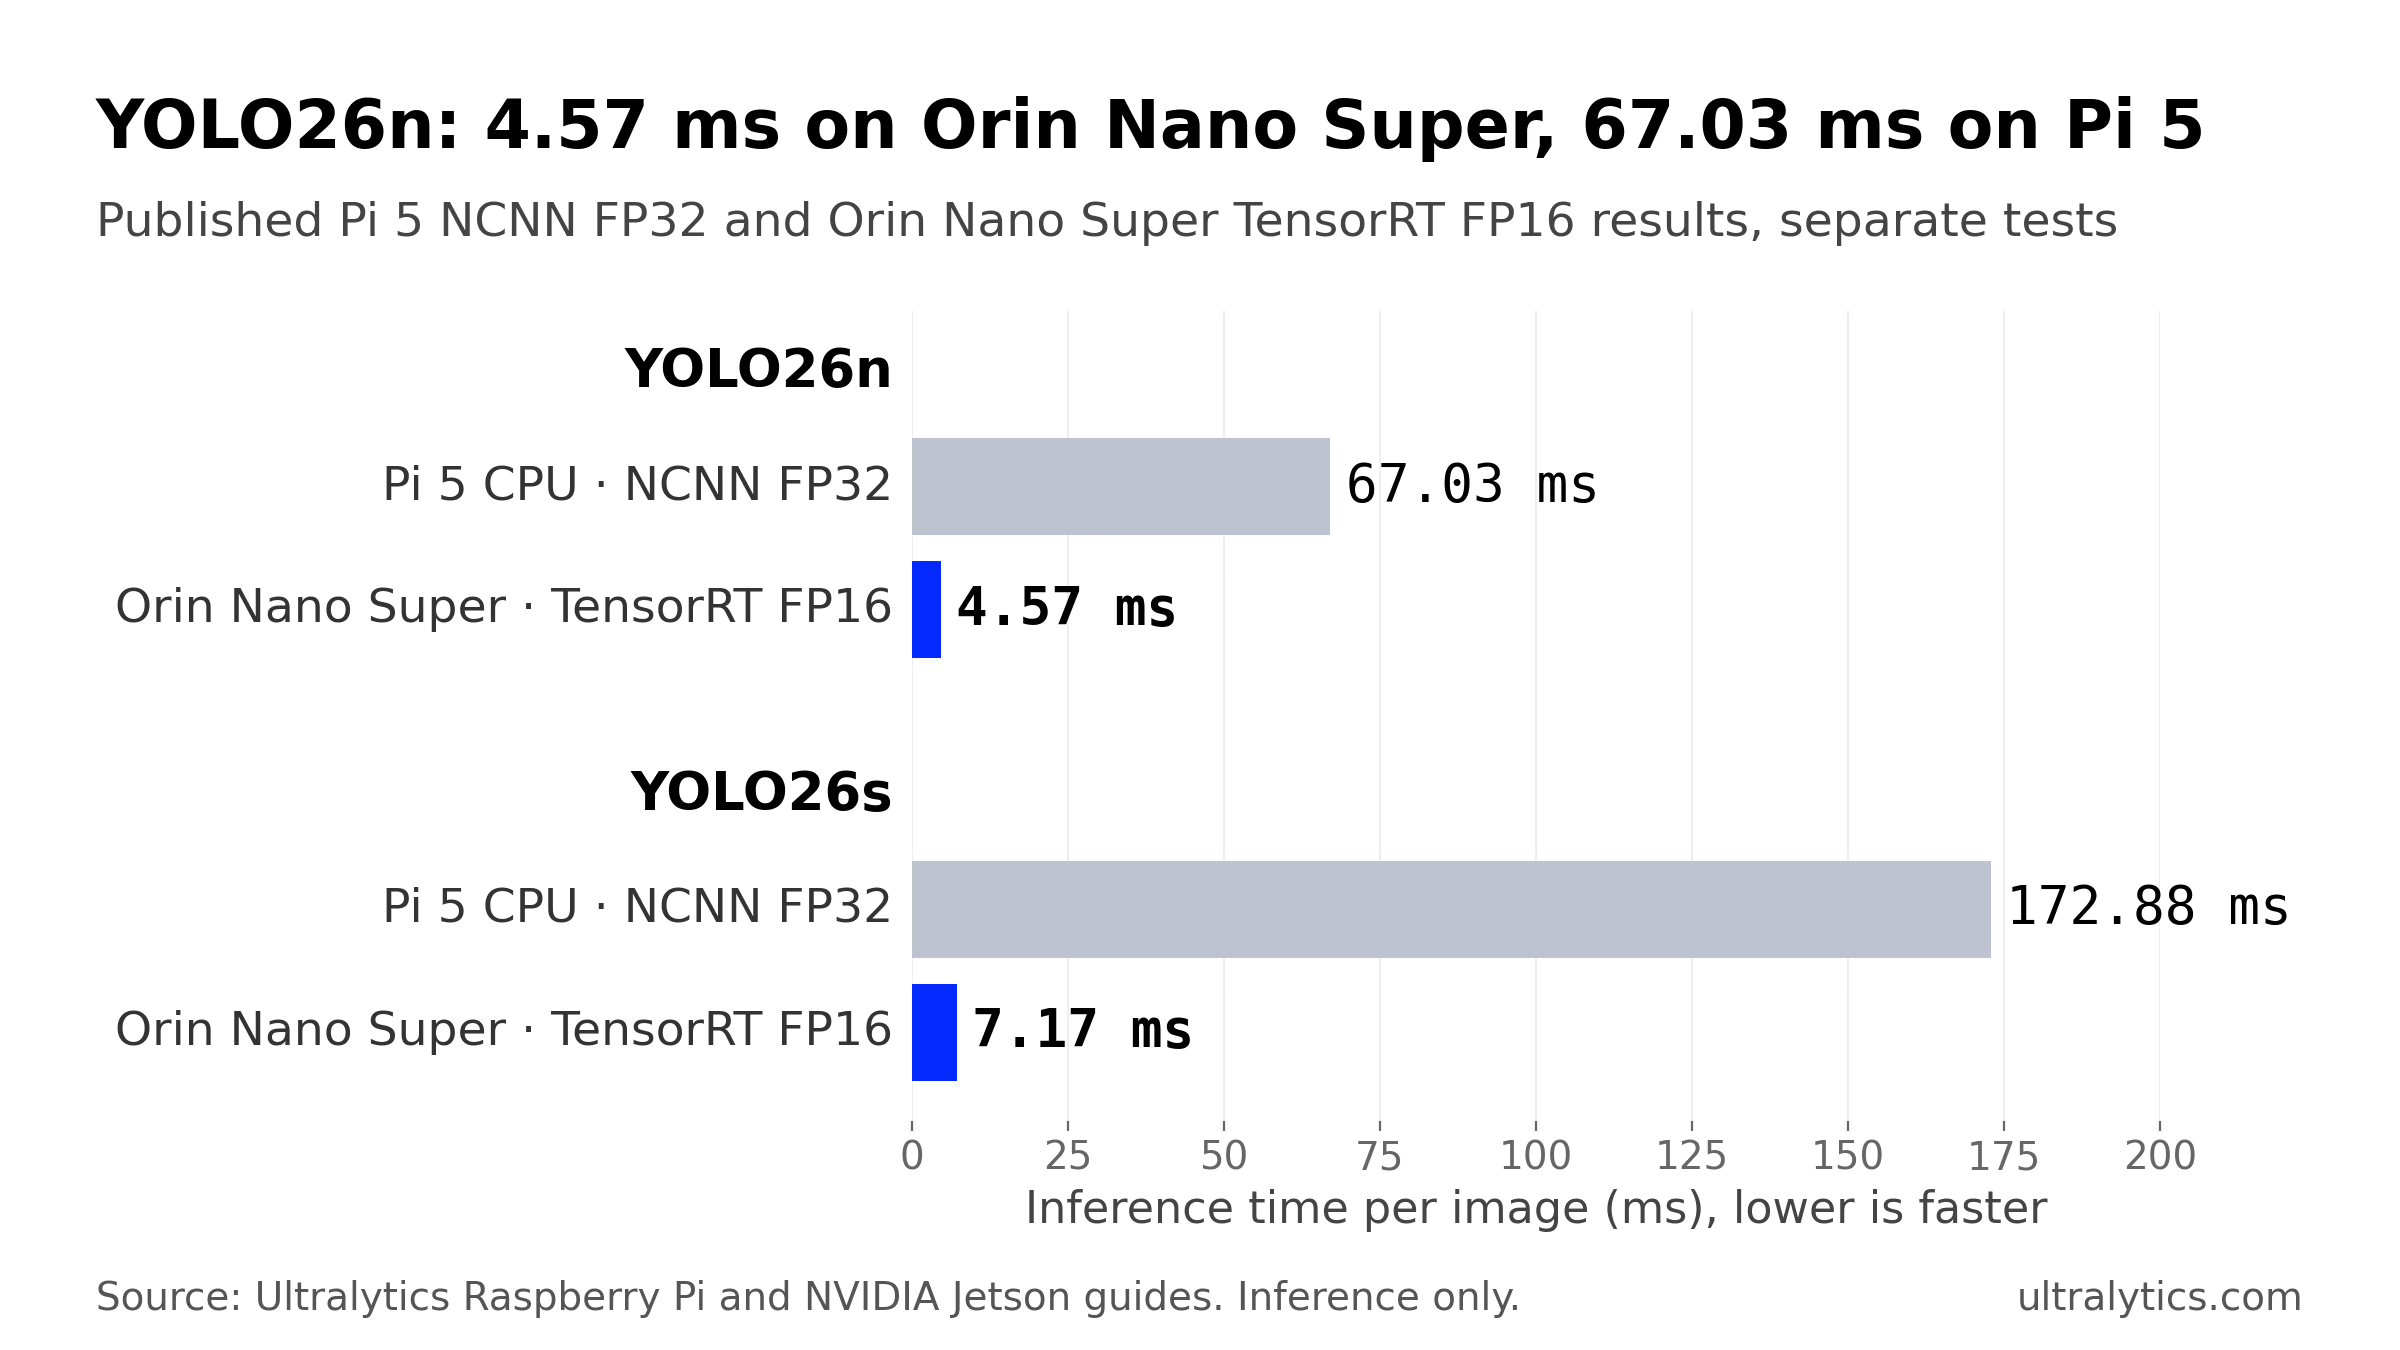
NCNN FP32 和 TensorRT FP16 的已发布结果来自分别进行的测试:Raspberry Pi 5 使用 Ultralytics 8.4.108,Orin Nano Super Developer Kit 使用 Ultralytics 8.4.33。仅统计推理时间,不包括预处理和后处理。来源:Ultralytics Raspberry Pi 和 NVIDIA Jetson 指南。
对于 YOLO26n,与 Pi 5 CPU 相比,推理时间减少约 93%。部分差距来自精度设置,因此也可以对比 FP32 导出结果:Orin Nano Super 的 FP32 TensorRT 引擎耗时 7.53 ms,仍比 Pi 的 FP32 NCNN 导出快近九倍,不过两者的运行时和测试版本不同。更显著的是 YOLO26m:mAP50-95 为 0.6225,耗时 13.59 ms;较早的 ONNX 测试中,Pi 5 CPU 运行该模型的速度约为每秒一帧。
INT8 还能进一步缩短一点耗时。YOLO26n 作为 INT8 引擎时耗时降至 3.80 ms,但在 COCO128 上,其 mAP50-95 从 0.4800 降至 0.4490。因此建议先使用 FP16;只有当 FP16 无法满足你的预算,且你能使用自己摄像头拍摄的图像进行校准时,再尝试 INT8 量化。我们的 Academy 使用 TensorRT 进行优化课程会详细讲解如何做出这一选择。
增加摄像头后 FPS 会下降,因为所有视频流共用同一份算力预算#
扩展规模时常见的情况是:一个摄像头运行流畅,但增加到第三或第四个摄像头后,处理帧率就会下降。每一帧都需要解码、预处理、推理和后处理,每个摄像头都要消耗同一份算力。在 Pi 5 上,同样的四个 CPU 核心既要解码视频,也要运行模型,因此每增加一路视频流,两项任务都要分走一部分时间。
Ultralytics 会处理这些管线细节。在 .streams 文件中每行列出一个来源,并传入 Predict 模式:每路视频流都会获得独立的读取线程,加载器会将每个摄像头的最新帧组成一个批次,因此任何一路较慢或丢帧的来源都可能拖慢整个批次。支持批处理的后端会通过一次前向传递处理整个批次;NCNN 则逐帧处理,而固定形状的 TensorRT 引擎会拆分批次或填充数据,使其符合导出时的尺寸。默认情况下(stream_buffer=False),模型运行较慢时会跳过过时帧,而不是将帧排队,这能缩短应用内部的积压;不过摄像头、解码器或网络中的缓冲仍可能增加延迟。
单图像延迟只能作为起点,不能用来确定摄像头数量。批处理会改变吞吐量,解码、跟踪和绘制也会增加各自的开销。Ultralytics Academy 的多路视频流推理课程提供了估算规则:每台设备可处理的视频流数量大致等于实际批次大小下的持续吞吐量除以每路视频流所需的 FPS,并为峰值预留 20% 到 30% 的余量。如下方实操部分所示,请在连接摄像头的板卡上测量该吞吐量。对于 Jetson 上的多摄像头管线,DeepStream 可以在一个平铺应用中通过单个 TensorRT 引擎处理多个来源。
根据每个摄像头的实测 FPS、模型尺寸和精度进行选择#
先从可能满足需求的最低成本板卡开始,使用自己的摄像头进行测量,只有在性能不足时才升级:
| 如果测量结果显示…… | 从这里开始 |
|---|---|
| YOLO26n 达到你的精度目标和每个摄像头的 FPS 要求 | 使用 NCNN 的 Pi 5 CPU。低 FPS 的任务可能可以处理多个摄像头。 |
| Pi 的帧率不够,但你想继续使用 Pi | Pi 5 搭配加速器,例如 Hailo-8 AI HAT+或 DEEPX DX-M1。二者都能运行量化模型,但需要经过编译步骤,因此导出后请检查精度。 |
| 你需要在较高 FPS 下运行更大的模型、处理比 Pi 可持续支持数量更多的视频流,或为其他软件腾出 CPU 时间 | 选择搭载 TensorRT 的 Jetson Orin Nano Super;如果实测吞吐量仍不够,再升级到 Orin NX 或 AGX Orin。 |
在成为基准测试数字之前,帧率首先是一项业务需求。我们的计算机视觉中的 FPS 指南会说明如何根据观察对象的移动速度设定 FPS,如何选择合适的边缘设备则介绍这两款板卡之外的选择。
使用自己的摄像头测量两块板卡#
上面的数据是在固定条件下测得的;散热、功耗模式、操作系统镜像、软件版本和你自己的模型都会造成差异。Ultralytics 包在两块板卡上使用相同的 API,因此你可以在两块板卡上运行同一项测量。以下命令已使用 Ultralytics 8.4.215 验证。
第 1 步:在每块板卡上测试各种导出格式#
在板卡上运行 yolo benchmark model=yolo26n.pt data=coco128.yaml imgsz=640。Benchmark 模式会报告板卡支持的每种导出格式的模型大小、mAP50-95 和推理时间;如果某种格式支持 FP16 或 INT8,可添加 quantize=16 或 quantize=8 进行测量。对于刷入启用了 Super 模式配置的 Orin Nano Super Developer Kit,先选择 MAXN SUPER 功耗模式;在 NVIDIA 面向 JetPack 6.2 和 Orin Nano 发布的超级模式说明中,对应的设置为 sudo nvpmodel -m 2。然后运行 sudo jetson_clocks。长时间运行时请监控温度。
第 2 步:在每块板卡上导出速度最快的格式#
在 Raspberry Pi 5 上,按照我们的 Raspberry Pi 5 实操指南导出为 NCNN。在 Jetson 上,请直接在设备上构建引擎,因为 TensorRT 引擎与构建它的 GPU 和 TensorRT 版本绑定。未使用 dynamic 导出的引擎具有固定输入形状。一种做法是将 batch 设为摄像头数量;如果需要更快速度,则用较小的 imgsz 重新导出:
from ultralytics import YOLO

# 仅适用于 Jetson:需要 NVIDIA GPU。FP16 TensorRT 引擎,640 像素,批次大小为四个摄像头
YOLO("yolo26n.pt").export(format="engine", quantize=16, imgsz=640, batch=4)  # 写入 yolo26n.engine
第 3 步:测量每个摄像头的处理 FPS#
在 cams.streams 中每行填写一个 RTSP URL,在板卡上运行模型约一分钟,并将每个摄像头的处理 FPS 与其发送帧率进行比较。计时器会在首个完整批次之后启动,此时视频流已连接且模型已预热;计时会在一个完整批次处理完毕时停止:
import time
from collections import Counter

from ultralytics import YOLO

model = YOLO("yolo26n.engine")  # on the Pi 5: YOLO("yolo26n_ncnn_model")
cameras = open("cams.streams").read().split()
n_streams = len(cameras)

frames, start = Counter(), None
for i, result in enumerate(model("cams.streams", stream=True)):
    if i < n_streams:  # first batch: connection and warm-up
        if i == n_streams - 1:
            start = time.perf_counter()
        continue
    frames[i % n_streams] += 1  # results arrive in stream order within each batch
    if (i + 1) % n_streams == 0 and time.perf_counter() - start > 60:
        break

elapsed = time.perf_counter() - start
for slot, count in sorted(frames.items()):
    print(f"{cameras[slot]}: {count / elapsed:.1f} processed FPS")
此测量反映该管线的处理结果吞吐量。如果增加视频流后某个摄像头的处理 FPS 远低于其帧率,说明板卡跟不上需求。请使用 Academy 多路视频流课程中的生产者—消费者示例,通过明确的逐路丢帧计数器确认这一点;添加应用所需的跟踪或绘制步骤,然后使用较小的 imgsz 重新导出、改用更小的模型或更快的导出格式,或者升级硬件,并重新运行测试。
如果你不想搭建构建环境,Ultralytics Platform 的 Export 选项卡可以为 Jetson 目标设备构建 TensorRT 引擎,其中包括 Orin Nano 8GB Super。Orin 型号的引擎是在 AGX Orin 上构建的,目前仍待在 Orin Nano 本机上验证,因此请检查设备上的 TensorRT 和 CUDA 运行时是否与引擎兼容,并在实际部署设备上验证每个引擎。有关 NVIDIA GPU 上 ONNX Runtime 与 TensorRT 的比较,请参阅 ONNX 与 TensorRT。
选择哪块板卡#
如果 YOLO26n 达到你的精度目标,而且你在板卡上测得的处理 FPS 能满足所需的全部摄像头,就选择 Raspberry Pi 5。推理速度约为 15 FPS,适合零售柜台、传送带计数、野生动物和家庭摄像头,以及早期机器人原型。若需要处理更多帧但仍想使用 Pi,可以添加加速器。
如果你需要在可用帧率下运行大于 nano 的模型、处理比 Pi 可持续支持数量更多的视频流,或为跟踪、导航和应用其余部分留出 CPU 时间,就选择 Jetson Orin Nano Super。在该设备上,YOLO26s 到 YOLO26l 的每张图像推理耗时均低于 18 ms;增加摄像头时,这部分性能余量就能派上用场。请测量完整应用以确认性能。
Ultralytics 的适用范围#
Ultralytics 不制造这两块板卡;我们开发能在两者上运行的模型和工具。同一组 YOLO26 权重可以导出为适用于 Pi 5 的 NCNN、适用于搭配 AI HAT+ 的 Pi 的 Hailo,以及适用于 Jetson 的 TensorRT,因此你可以先在 Pi 上制作原型,工作负载增长时再迁移到 Jetson,无需重新训练;每次导出后都要验证精度。Ultralytics Platform 可以处理部署前的各个步骤:标注数据集;当项目所需的训练算力超过本地可用算力时,在云端训练;并为任一板卡导出模型。
注意事项:我们发布的基准测试仅测量推理性能,且是在指定测试设备上进行,并非在你的摄像头、外壳或生产模组上测得;我们的 Jetson 指南也未提供原版 Jetson Nano 的 YOLO26 结果。Ultralytics YOLO 采用 AGPL-3.0 或 Ultralytics Enterprise License 授权;请查看 Ultralytics 许可,了解你的部署需要哪种许可。
常见问题
它的单图像处理速度快得多。在我们分别进行并发布的基准测试中,Jetson Orin Nano Super Developer Kit 上的 YOLO26n 作为 TensorRT FP16 引擎时耗时 4.57 ms,而 Raspberry Pi 5 CPU 上使用 NCNN 时耗时 67.03 ms(640 像素输入,仅统计推理时间);Jetson 上的 YOLO26m 耗时 13.59 ms。你是否需要这种性能优势,取决于模型、摄像头数量和 FPS 目标:如果 Pi 5 通过你自己的测量已能满足需求,它就是更简单的方案。
不是。原版 Jetson Nano 于 2019 年推出,配备 128 核 Maxwell GPU 和 4 GB 内存,仅支持 JetPack 4。Jetson Orin Nano 是更新的模组,配备 1024 核 Ampere GPU;我们用于基准测试的 Orin Nano Super Developer Kit 配备 8 GB 内存,支持 JetPack 5 至 7。本文的性能对比针对 Orin Nano Super,而非原版 Nano。
可以。2019 年推出的 Jetson Nano 支持 JetPack 4,Ultralytics 提供 JetPack 4 Docker 镜像;我们的 YOLO26 TensorRT DeepStream 指南也在搭载 JetPack 4.6.4 的 Jetson Nano 4GB 上进行了测试。我们的 Jetson 指南没有提供该设备的 YOLO26 基准测试,而且它的硬件性能远低于 Orin Nano Super。
所有视频流共用板卡的算力:每增加一个摄像头,都需要单独进行解码、预处理、推理和后处理。使用
.streams文件时,Ultralytics 会将所有摄像头的帧组成批次,并在模型处理不过来时跳过过时帧,因此共享管线一旦成为瓶颈,每个摄像头的处理 FPS 都可能下降。使用更快的导出格式、更小的模型或imgsz,或者升级到性能更强的硬件,都能提高 FPS。可以。只需训练一次,然后使用
format="ncnn"为 Pi 5 导出同一组权重,使用format="engine"为 Jetson 导出,并在目标设备上或针对目标设备构建 TensorRT 引擎。每次导出后,请使用自己的数据验证精度。
作者
评论
提出问题、分享你的结果,或帮助其他人。









