Bestärkendes Lernen in Computer-Vision-Projekten nutzen
Entdecke, wie bestärkendes Lernen in Computer-Vision-Anwendungen Systemen hilft, zu sehen, Entscheidungen zu treffen und sich in realen Anwendungen verschiedener Branchen zu verbessern.
Eine einfache Möglichkeit, künstliche Intelligenz (AI) zu erklären, besteht darin, sie als ein Fachgebiet zu betrachten, das sich darauf konzentriert, die Denk- und Lernweise des Menschen nachzubilden. Daher kommt die Idee von Lernverfahren in der AI: Es handelt sich um verschiedene Methoden, mit denen Maschinen ihre Leistung im Laufe der Zeit verbessern können, genau wie Menschen.
Zuvor haben wir wichtige Lernverfahren der AI untersucht, darunter überwachtes, unüberwachtes, verstärkendes und Transferlernen, und erläutert, welche wichtige Rolle jedes dieser Verfahren dabei spielt, AI-Modelle beim Verarbeiten von Informationen und Treffen von Entscheidungen zu unterstützen.
Heute sehen wir uns verstärkendes Lernen genauer an – eine Methode, bei der AI-Systeme durch die Interaktion mit einer Umgebung aus Erfahrungen lernen und sich anhand von Rückmeldungen verbessern. Konkret untersuchen wir, wie verstärkendes Lernen auf Anwendungen der Computer Vision angewendet werden kann – also auf Systeme, die Maschinen dabei unterstützen, visuelle Informationen aus der Welt zu interpretieren und zu verstehen.
Die Verbindung von Konzepten wie verstärkendem Lernen und Computer Vision eröffnet neue, spannende Möglichkeiten und ist ein aktives Forschungsgebiet. Sie ermöglicht es AI-Systemen, das Gesehene zu erkennen und auf Grundlage dieser visuellen Informationen fundierte Entscheidungen zu treffen.
Was ist verstärkendes Lernen?#
Verstärkendes Lernen ist ein Teilgebiet des maschinellen Lernens, bei dem ein AI-Agent durch das Ausführen von Aktionen und das Erhalten von Rückmeldungen in Form von Belohnungen oder Bestrafungen lernt. Ziel ist es, herauszufinden, welche Aktionen im Laufe der Zeit zu den besten Ergebnissen führen.
Du kannst dir verstärkendes Lernen wie das Training eines Hundes vorstellen. Wenn ein Hund sich auf Kommando hinsetzt, gibst du ihm ein Leckerli. Nach einiger Zeit lernt der Hund, dass Hinsetzen zu einer Belohnung führt. Beim verstärkenden Lernen entspricht der AI-Agent oder das Modell dem Hund, die Umgebung ist die Welt um ihn herum, und die Belohnung hilft ihm zu verstehen, ob er die richtige Entscheidung getroffen hat.
Das unterscheidet sich vom überwachten Lernen, bei dem dem AI-Modell viele Beispiele mit den richtigen Antworten gezeigt werden. Beispielsweise könnte dem Modell ein Bild eines Hundes gezeigt und gesagt werden: „Das ist ein Hund.“
Verstärkendes Lernen hingegen ist nicht auf annotierte Daten angewiesen. Stattdessen lernt das System, indem es verschiedene Aktionen ausprobiert und aus den Ergebnissen lernt – ähnlich wie beim Spielen, wenn du herausfindest, welche Züge dir zum Sieg verhelfen.
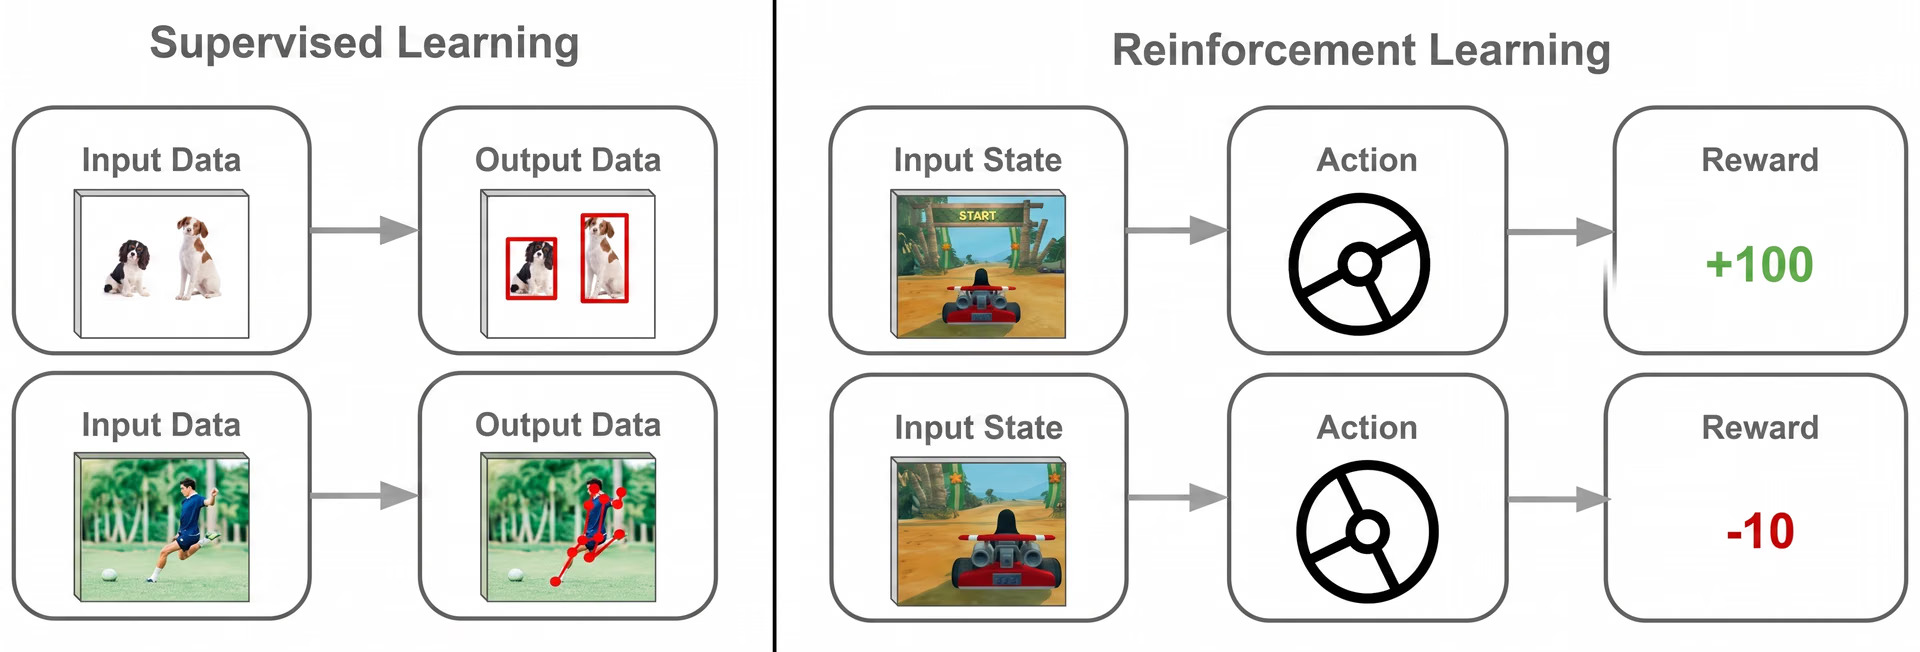
Abb. 1 Verstärkendes Lernen im Vergleich zum überwachten Lernen.
Verstärkendes Lernen ist für Aufgaben entscheidend, bei denen Entscheidungen Schritt für Schritt getroffen werden und jede Wahl beeinflusst, was als Nächstes geschieht. Diese Art des Lernens wird in Strategie-Videospielen eingesetzt, um das Spiel anspruchsvoller und fesselnder für die Spielenden zu gestalten.
So funktioniert verstärkendes Lernen in AI-Lösungen#
Überlege, wie du Fahrradfahren lernst. Am Anfang fällst du vielleicht hin. Mit etwas Übung findest du jedoch heraus, was dir hilft, das Gleichgewicht zu halten. Je mehr du fährst, desto besser wirst du. Du lernst durch Ausprobieren und nicht nur dadurch, dass man dir sagt, was du tun sollst.
Verstärkendes Lernen funktioniert für AI auf ähnliche Weise. Das System lernt durch Erfahrungen – indem es verschiedene Aktionen ausprobiert, beobachtet, was geschieht, und seine Fähigkeit, im Laufe der Zeit die richtigen Entscheidungen zu treffen, schrittweise verbessert.
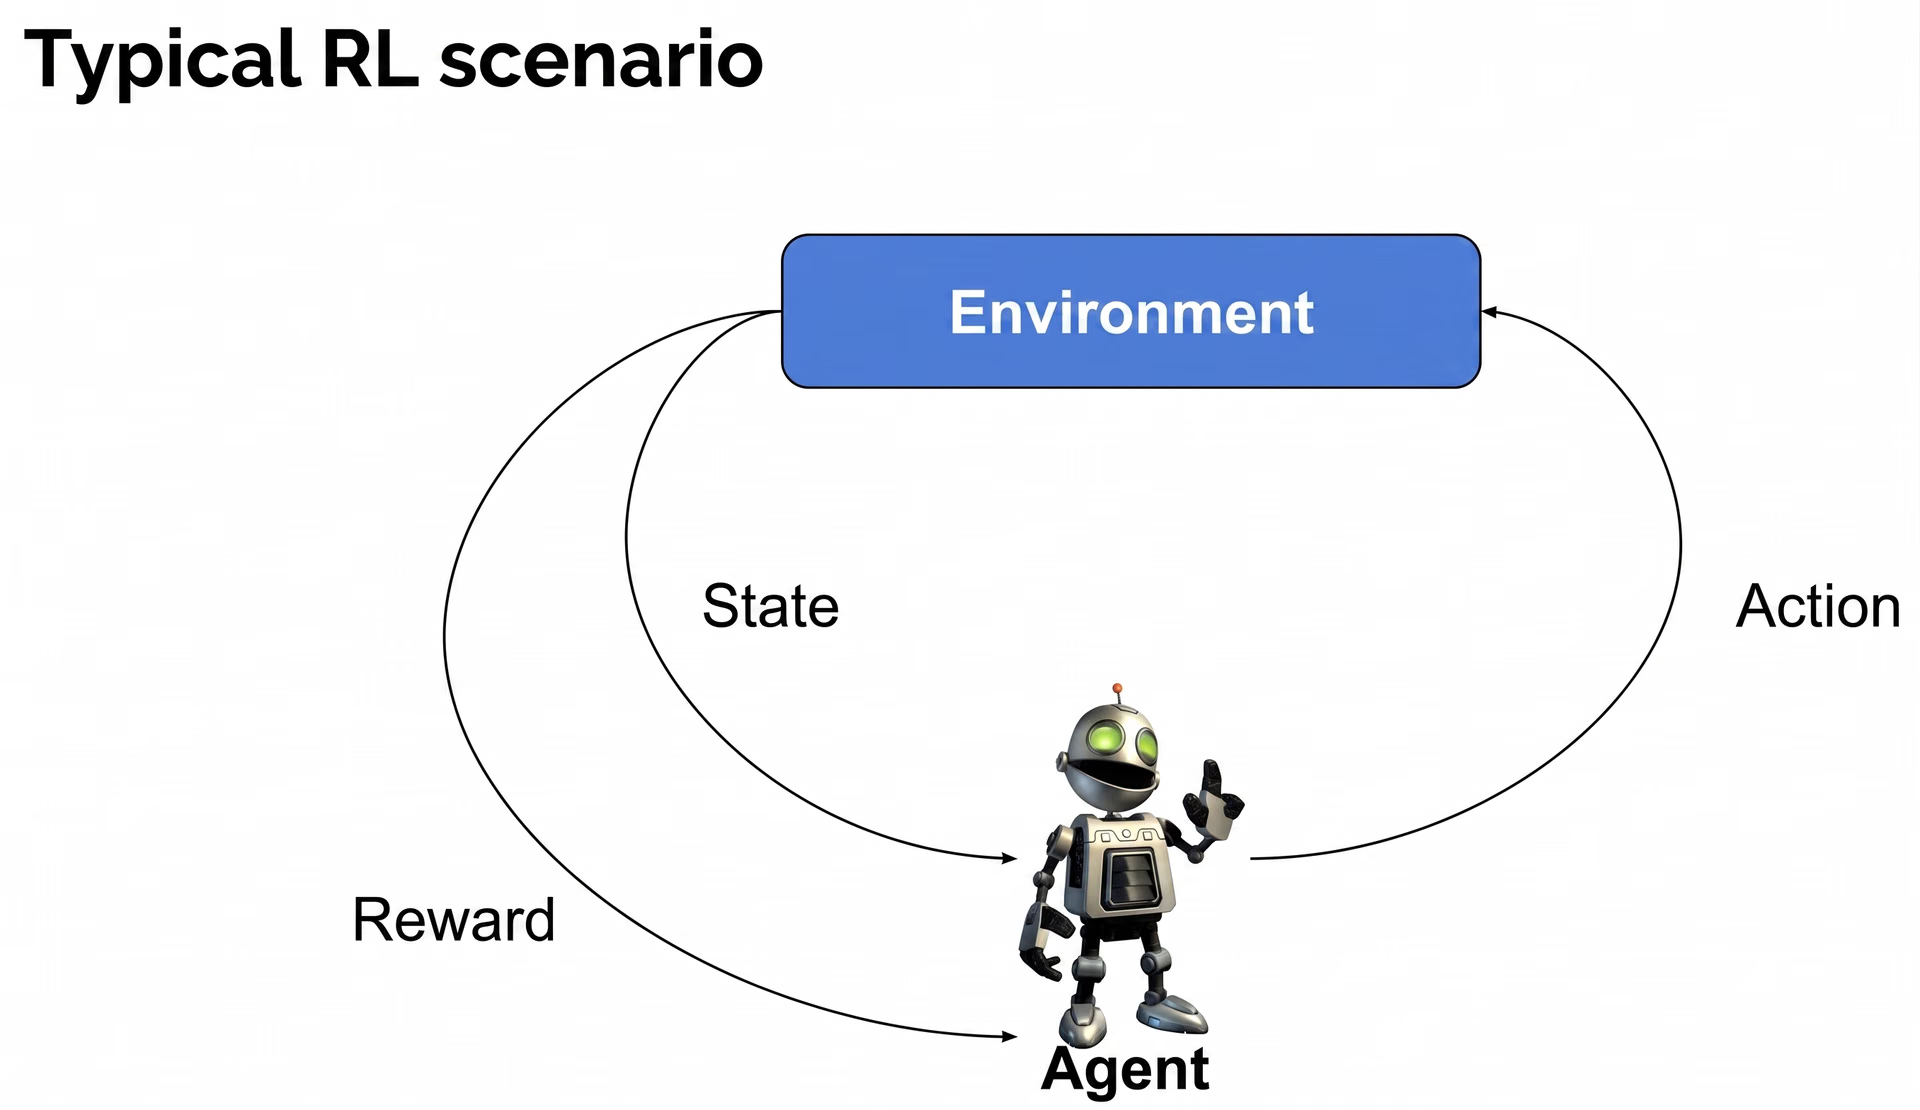
Abb. 2 So funktioniert verstärkendes Lernen.
Hier siehst du einige der wichtigsten Komponenten des verstärkenden Lernens:
- Agent: Der Agent ist der Lernende oder Entscheidungsträger. Er interagiert mit der Umgebung, indem er Aktionen ausführt, und verfolgt ein bestimmtes Ziel.
- Umgebung: Die Umgebung umfasst alles, womit der Agent interagiert. Sie verändert sich als Reaktion auf die Aktionen des Agenten und liefert anhand der Ergebnisse Rückmeldungen.
- Zustand: Ein Zustand stellt eine Momentaufnahme der aktuellen Situation in der Umgebung dar. Der Agent beobachtet den Zustand, um seine Umgebung zu verstehen und zu bestimmen, welche Aktion als Nächstes auszuführen ist.
- Aktion: Eine Aktion ist eine Bewegung oder Entscheidung des Agenten, die sich auf die Umgebung auswirkt. Jede Aktion führt zu einem neuen Zustand und kann zukünftige Belohnungen beeinflussen.
- Belohnung: Eine Belohnung ist einfach eine Rückmeldung der Umgebung, die dem Agenten mitteilt, ob seine Aktion nützlich war oder nicht. Positive Belohnungen ermutigen den Agenten, gute Aktionen zu wiederholen, während negative Belohnungen von ungünstigen Aktionen abhalten.
- Richtlinie: Eine Richtlinie ist die Strategie des Agenten, anhand des aktuellen Zustands Aktionen auszuwählen. Im Laufe der Zeit verfeinert der Agent seine Richtlinie, um die Summe der erzielbaren Belohnungen zu maximieren.
Durch die gemeinsame Nutzung dieser Komponenten ermöglicht verstärkendes Lernen AI-Systemen, durch kontinuierliches Ausprobieren und Lernen aus Fehlern wirksame Verhaltensweisen zu erlernen. Mit jedem Versuch wird der Agent besser darin, Aktionen auszuwählen, die zu höheren Belohnungen und besseren Ergebnissen führen.
Innovationen durch verstärkendes Lernen in der Computer Vision#
Computer Vision wird für Aufgaben wie das Erkennen von Objekten in Bildern, das Klassifizieren des Bildinhalts und das Segmentieren eines Bildes in verschiedene Bereiche eingesetzt. Computer-Vision-Modelle wie Ultralytics YOLO11 unterstützen solche Aufgaben und können zum Aufbau wirkungsvoller Anwendungen verwendet werden, die visuelle Erkenntnisse gewinnen.
Wenn diese Vision-AI-Aufgaben jedoch mit verstärkendem Lernen kombiniert werden, entsteht eine AI-Lösung, die nicht nur sieht, sondern auch lernt, auf Grundlage visueller Erkenntnisse zu handeln, und sich mit der Zeit verbessert.
Ein interessantes Beispiel für verstärkendes Lernen in Computer-Vision-Anwendungen ist der Einsatz von Robotern in Lagern. Roboter mit Kameras und Computer-Vision-Systemen können ihre Umgebung analysieren, die Position jedes Artikels erkennen, seine Form und Größe bestimmen und verstehen, wie er im Regal angeordnet ist.
Jedes Mal, wenn der Roboter versucht, einen Artikel aufzunehmen, erhält er eine Rückmeldung – Erfolg, wenn der Artikel korrekt aufgenommen wurde, oder Misserfolg, wenn er herunterfällt. Mit der Zeit lernt der Roboter, welche Aktionen für verschiedene Artikel am besten funktionieren. Anstatt eine festgelegte Abfolge von Anweisungen zu befolgen, verbessert er sich kontinuierlich durch Erfahrungen.
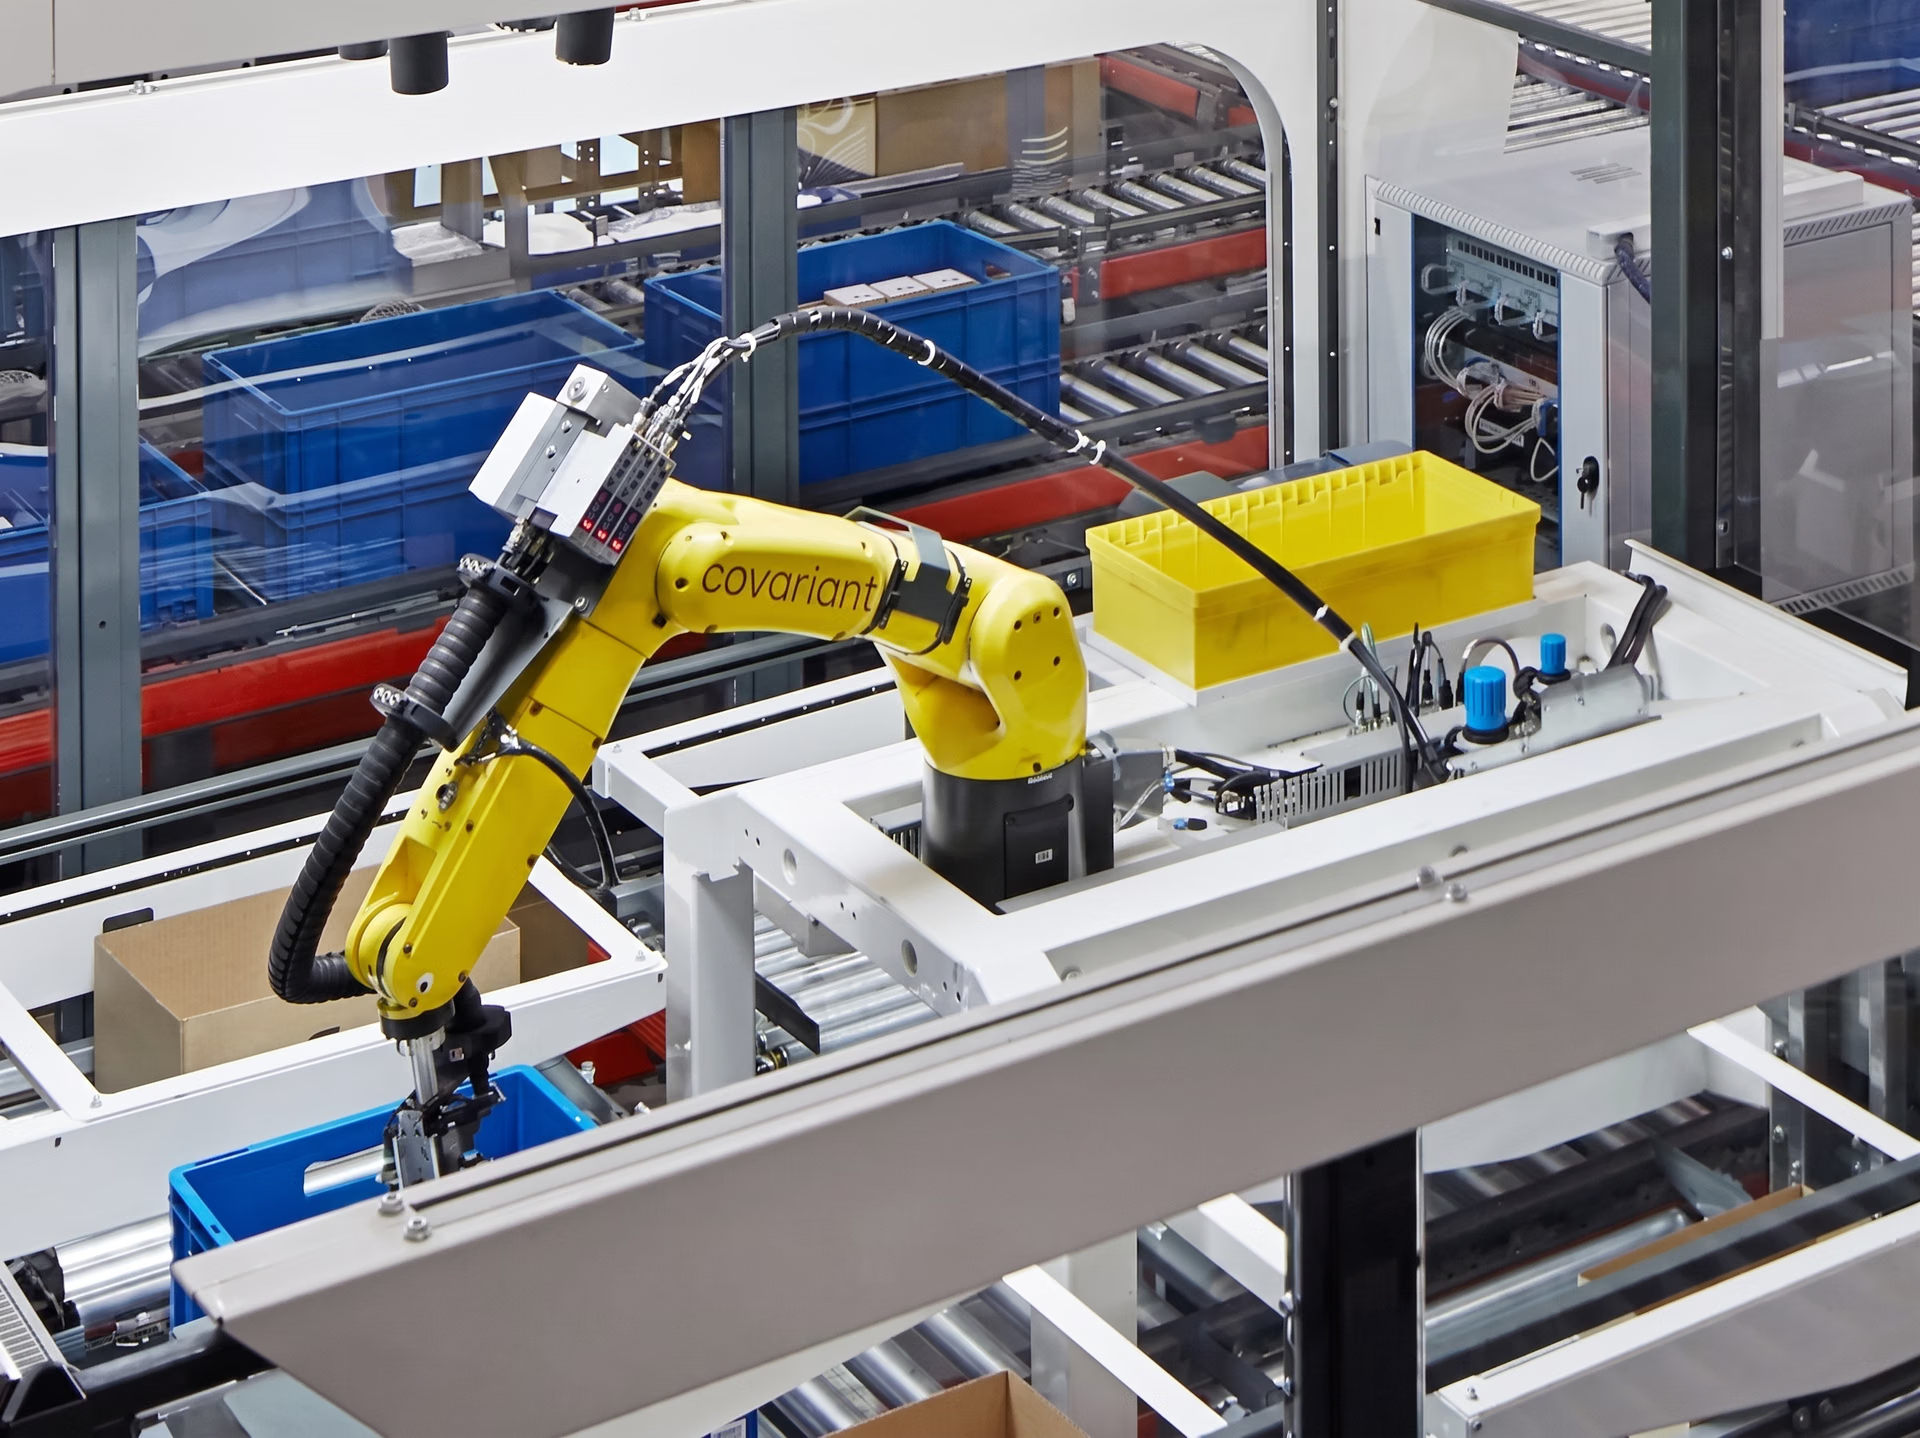
Abb. 3 Ein Roboterarm nutzt Vision AI und verstärkendes Lernen, um Objekte aufzunehmen.
Anwendungen des verstärkenden Lernens in der Computer Vision#
Nachdem wir nun besser verstanden haben, was verstärkendes Lernen ist und welche Rolle es in der Computer Vision spielt, sehen wir uns einige Beispiele dafür an, wie verstärkendes Lernen und Computer Vision gemeinsam eingesetzt werden.
Vision AI und verstärkendes Lernen für intelligentere Fahrzeuge kombinieren#
Autonome Fahrzeuge können sowohl Vision AI nutzen, um ihre Umgebung zu verstehen, als auch verstärkendes Lernen, um auf Grundlage des Gesehenen Entscheidungen zu treffen. Ein hervorragendes Beispiel dafür ist der AWS DeepRacer.
Der AWS DeepRacer ist ein vollständig autonomes Rennfahrzeug im Maßstab 1:18, das mithilfe einer Kamera und verstärkenden Lernens das Fahren lernt. Anstatt Anweisungen zu erhalten, findet es durch Ausprobieren, Fehler und Lernen aus diesen Fehlern selbstständig heraus, was zu tun ist.
Die Kamera dieses kleinen Fahrzeugs funktioniert wie ein Augenpaar und erfasst die vor ihm liegende Strecke. Anhand des Gesehenen lernt das Fahrzeug, wie es lenken und wie schnell es fahren soll. Mit jeder Runde wird es besser. So könnte es beispielsweise lernen, Kurven weiter auszufahren oder vor engen Kurven abzubremsen, indem es aus früheren Versuchen lernt.
Das Training für den DeepRacer beginnt in einer virtuellen Umgebung, in der das Modell seine Fahrfähigkeiten trainiert und verfeinert. Sobald es ein bestimmtes Leistungsniveau erreicht, werden diese Fähigkeiten auf reale Strecken mit echten Fahrzeugen übertragen.
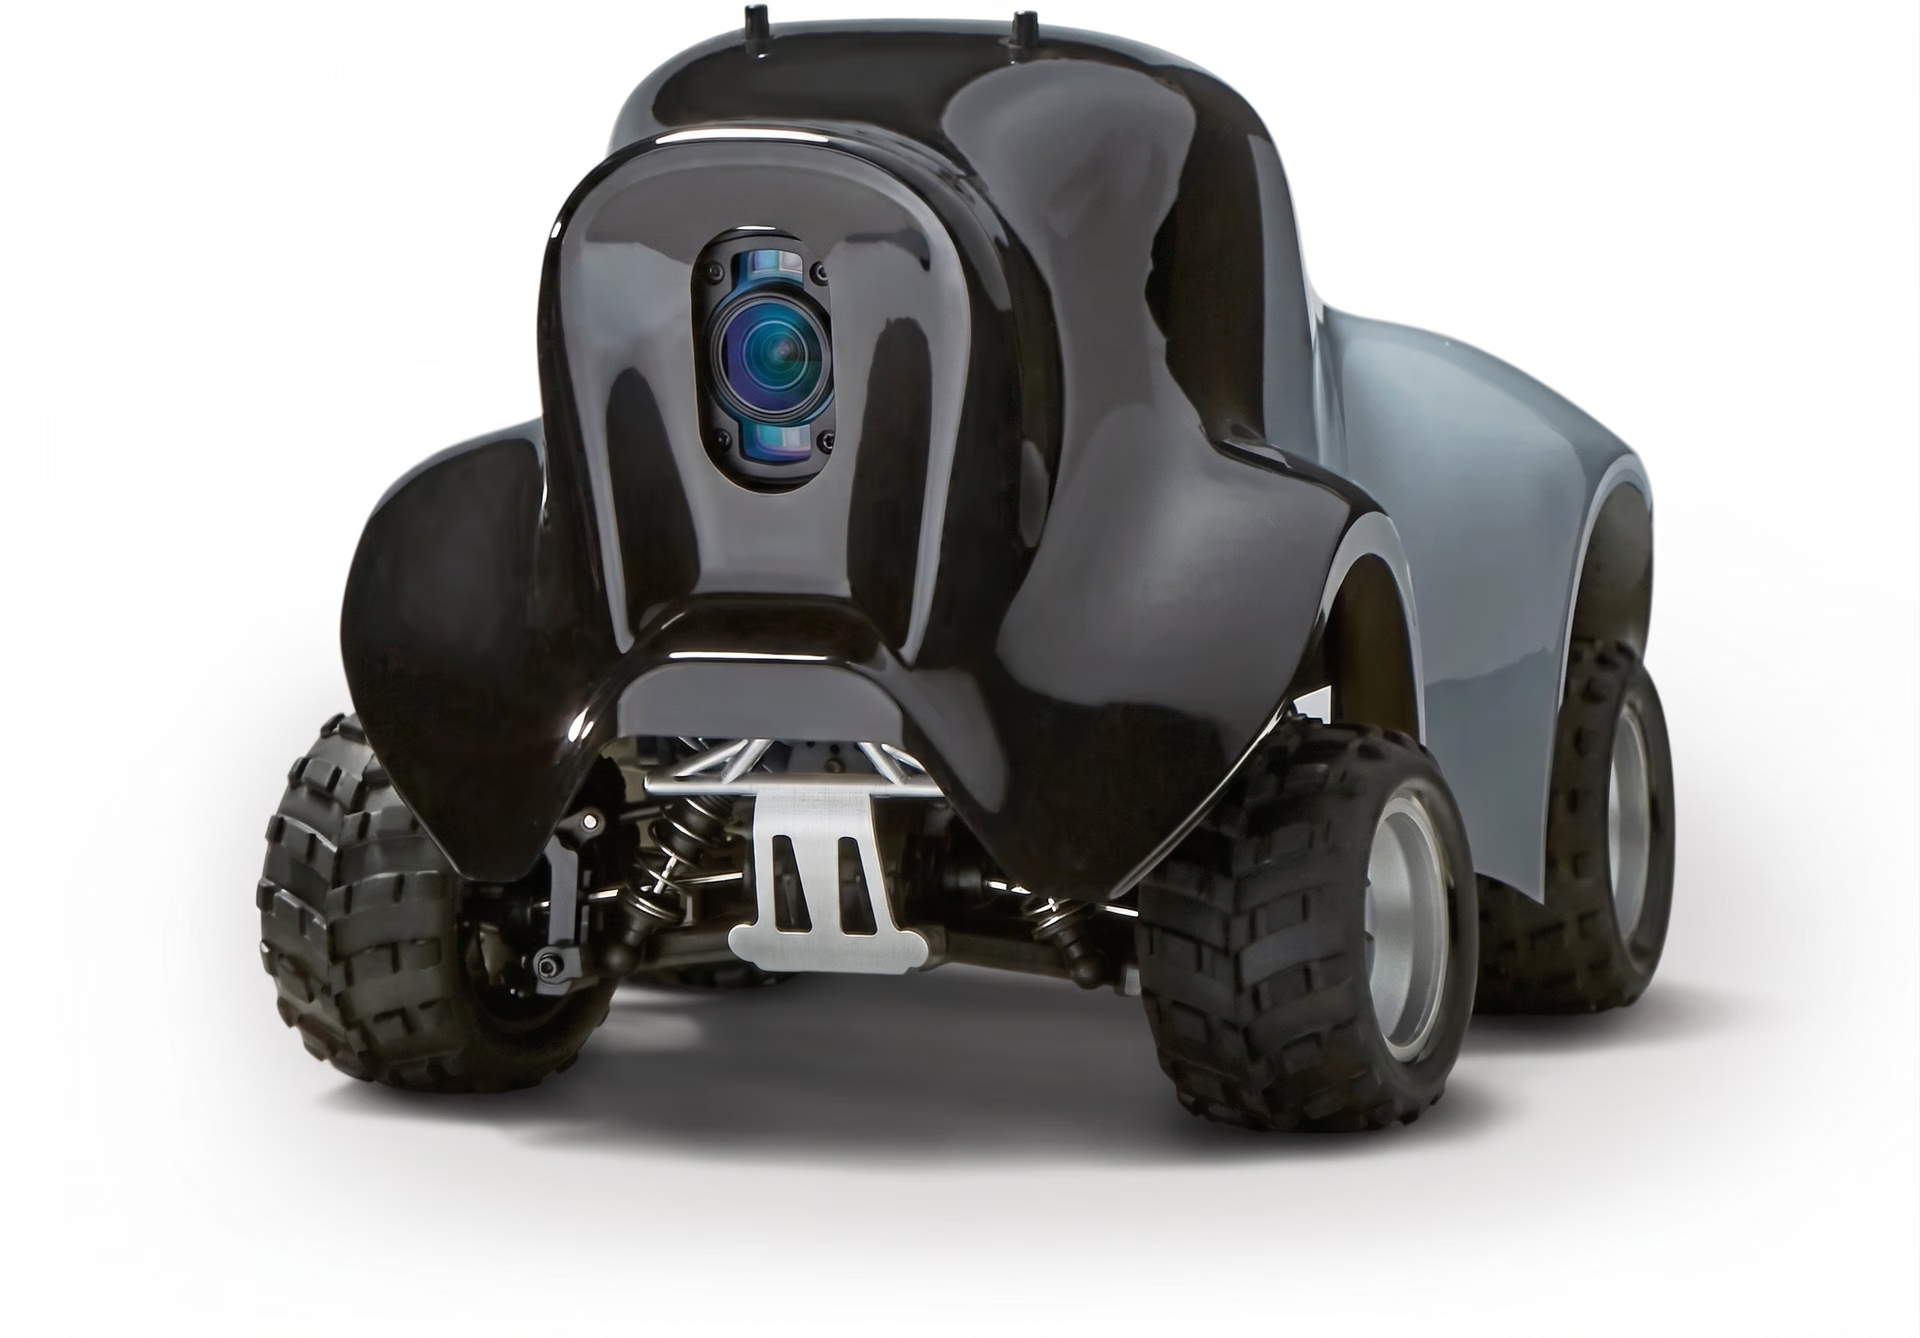
Abb. 4 Der AWS DeepRacer nutzt Vision und verstärkendes Lernen für autonomes Fahren. Bildquelle: Amazon.
Auf dem Weg zu autonomen Operationsrobotern#
Ein spannendes und zunehmend beachtetes Forschungsgebiet ist die Verbindung von Vision AI und verstärkendem Lernen in der robotergestützten Chirurgie. Derzeit ist diese Anwendung noch weitgehend theoretischer Natur. Forschende führen Simulationen in virtuellen Umgebungen durch.
Frühe Experimente zeigen jedoch vielversprechende Ergebnisse. Sie deuten darauf hin, dass Operationsroboter künftig komplexe, anspruchsvolle Eingriffe mit höherer Präzision, Anpassungsfähigkeit und minimalem menschlichem Eingreifen durchführen könnten.
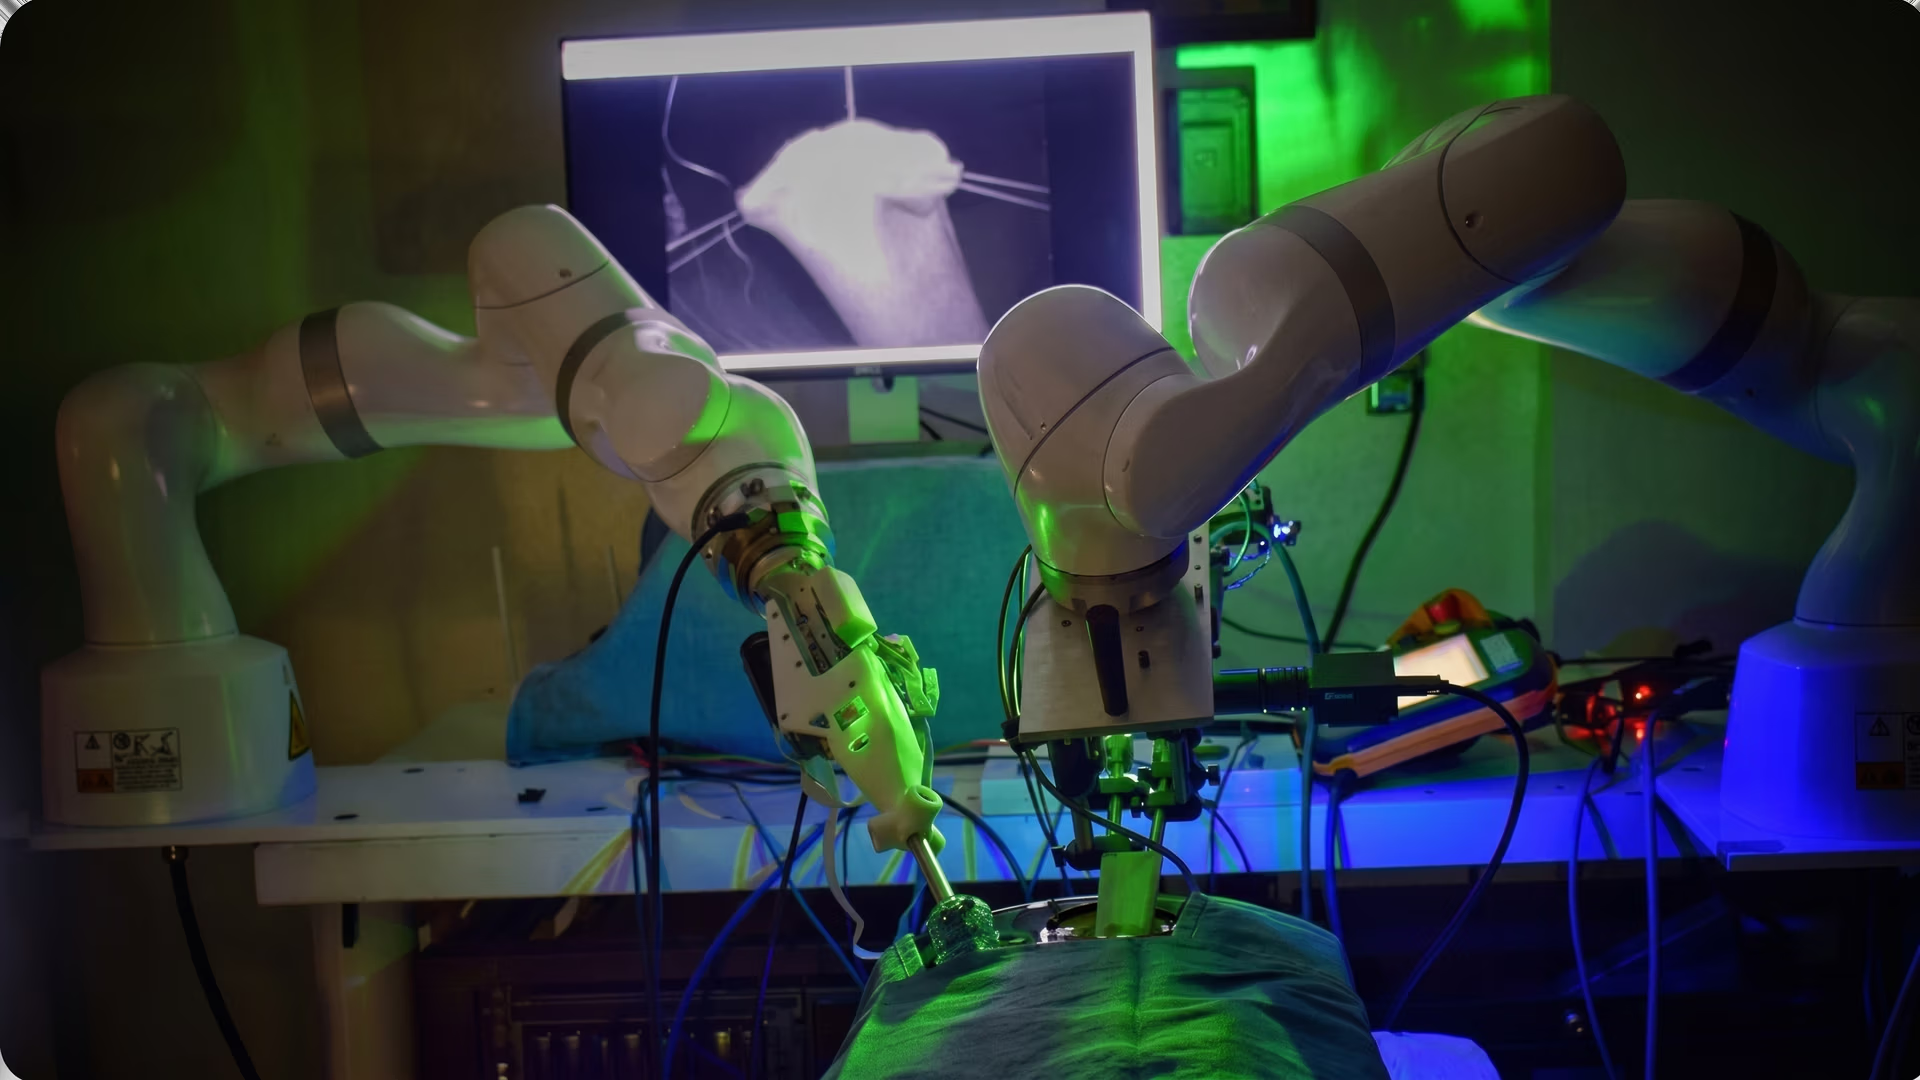
Abb. 5 Operationsroboter werden immer fortschrittlicher.
Stell dir beispielsweise eine Situation vor, in der ein Stück Mull vorsichtig von einem Operationsbereich angehoben werden muss. Ein mit Vision AI ausgestatteter Roboter würde zunächst die Szene analysieren und mithilfe der Segmentierung die Mullkompresse und das umliegende Gewebe identifizieren.
Verstärkendes Lernen würde dem Operationsroboter anschließend helfen, zu entscheiden, wie er die Aufgabe angeht: welcher Winkel zum Greifen der Mullkompresse am besten geeignet ist, wie viel Druck angewendet werden soll und wie sie angehoben werden kann, ohne empfindliche Bereiche in der Nähe zu beeinträchtigen. Mit der Zeit und durch wiederholtes Training in simulierten Umgebungen könnte der Roboter lernen, diese subtilen, kritischen Bewegungen zunehmend sicher und geschickt auszuführen.
Vor- und Nachteile des verstärkenden Lernens in der Vision AI#
Verstärkendes Lernen ermöglicht es Vision-AI-Systemen, über die einfache Erkennung hinauszugehen und auf Grundlage des Gesehenen Entscheidungen zu treffen. Das eröffnet neue Möglichkeiten in Bereichen wie Robotik, Automatisierung und Interaktion in Echtzeit.
Hier sind einige der wichtigsten Vorteile der Integration von verstärkendem Lernen in Vision-AI-Arbeitsabläufe:
- Weniger Abhängigkeit von annotierten Daten: Diese Systeme können aus Interaktionen lernen und benötigen daher keine riesigen annotierten Datensätze, um zu starten.
- Besserer Umgang mit Unsicherheit: Verstärkendes Lernen kann unvollständige oder verrauschte visuelle Informationen verarbeiten, indem es Aktionen anhand von Rückmeldungen anpasst, statt sich ausschließlich auf perfekte Daten zu verlassen.
- Unterstützt langfristiges Lernen: Es hilft Modellen, sich im Laufe der Zeit zu verbessern, indem sie aus Folgen von Aktionen und nicht nur aus Entscheidungen in einzelnen Schritten lernen.
Andererseits gibt es einige Einschränkungen des verstärkenden Lernens, die du berücksichtigen solltest:
- Problem der Zuordnung von Ergebnissen zu Aktionen: Für den Agenten kann es schwierig sein, herauszufinden, welche konkreten Aktionen zu einem Endergebnis beigetragen haben, insbesondere bei langen Entscheidungsfolgen.
- Risiko unsicherer Erkundung: Während des Trainings kann der Agent unsichere oder unerwünschte Aktionen ausprobieren, die in realen Anwendungen wie dem Gesundheitswesen oder dem autonomen Fahren nicht akzeptabel wären.
- Langsame Konvergenz: Es kann lange dauern, bis das Modell tatsächlich eine gute Leistung erreicht, insbesondere bei komplexen Aufgaben.
Wichtige Erkenntnisse#
Verstärkendes Lernen in Computer-Vision-Projekten ermöglicht es AI-Systemen, ihre Umgebung zu verstehen und durch Erfahrungen zu lernen, wie sie handeln sollen. Mit Modellen wie Ultralytics YOLO11 für die Objekterkennung in Echtzeit kann das System auf Grundlage des Gesehenen fundierte Entscheidungen treffen.
Dieser Ansatz geht über traditionelle Methoden hinaus, da sich AI durch Ausprobieren und Rückmeldungen verbessern kann, anstatt sich ausschließlich auf annotierte Daten zu stützen. Er unterstützt kontinuierliches Lernen und hilft dabei, flexiblere, anpassungsfähigere und intelligentere Vision-AI-Systeme zu entwickeln, die mit der Zeit besser werden.
Werde Teil unserer wachsenden Community. Besuche unser GitHub-Repository, um tiefer in die Welt der AI einzutauchen. Möchtest du deine eigenen Computer-Vision-Projekte starten? Entdecke unsere Lizenzoptionen. Erfahre auf unseren Lösungsseiten mehr über AI in der Fertigung und Vision AI in der Automobilindustrie.








