Intelligente Datensatzverwaltung für Computer Vision mit der Ultralytics Platform
Entdecke, wie du mit der Ultralytics Platform die Verwaltung von Datensätzen in deinen Computer-Vision-Projekten verbesserst. Verfolge, vergleiche und optimiere deine Datensätze ganz einfach.
 Abirami Vina15 Min. Lesezeit
Visuelle KI oder Computer Vision hat sich seit ihren Anfängen stark weiterentwickelt: Aus experimenteller Forschung wurde eine Schlüsseltechnologie für praktische Anwendungen. Heute können KI-Begeisterte mithilfe leicht zugänglicher Tools und Frameworks leistungsstarke Modelle für Aufgaben wie Objekterkennung und Instanzsegmentierung entwickeln.
Wenn diese Anwendungen jedoch aus der Experimentierphase in den Produktivbetrieb übergehen, bleibt die Verwaltung von Datensätzen eine kritische und oft übersehene Herausforderung. Mit zunehmender Größe und Komplexität von Computer-Vision-Datensätzen fällt es Teams oft schwer, einheitliche Annotationen sicherzustellen, Änderungen zwischen Versionen nachzuverfolgen und die allgemeine Datenqualität zu gewährleisten.
Selbst fortschrittliche Modelle können in realen Umgebungen hinter den Erwartungen zurückbleiben, wenn die Trainingsdaten unvollständig oder unausgewogen sind oder schlecht verwaltet werden. Diese wachsende Lücke zwischen der Leistung während der Entwicklung und der Zuverlässigkeit im Praxiseinsatz macht einen strukturierteren Ansatz für die Verwaltung von Datensätzen erforderlich.
Eine weitere häufige Einschränkung besteht darin, dass Datenerfassung, Annotation und Training oft mit separaten Tools durchgeführt werden. Ein fragmentierter Arbeitsablauf erschwert die effiziente Verwaltung von Datensätzen, erhöht das Risiko von Inkonsistenzen und verlangsamt die Iteration.
Um Engpässe bei visueller KI wie die Datensatzverwaltung und fragmentierte Arbeitsabläufe zu beheben, haben wir kürzlich die Ultralytics Platform eingeführt. Sie ist eine durchgängige Arbeitsumgebung, die Datensatzverwaltung, Annotation, Training, Bereitstellung und Überwachung in einem einheitlichen Arbeitsablauf zusammenführt.
Wenn jede Phase des Computer-Vision-Lebenszyklus miteinander verknüpft ist, lassen sich Datensatzänderungen leichter nachverfolgen, Leistungen zwischen Versionen vergleichen und Daten kontinuierlich verbessern, um bessere Ergebnisse zu erzielen.
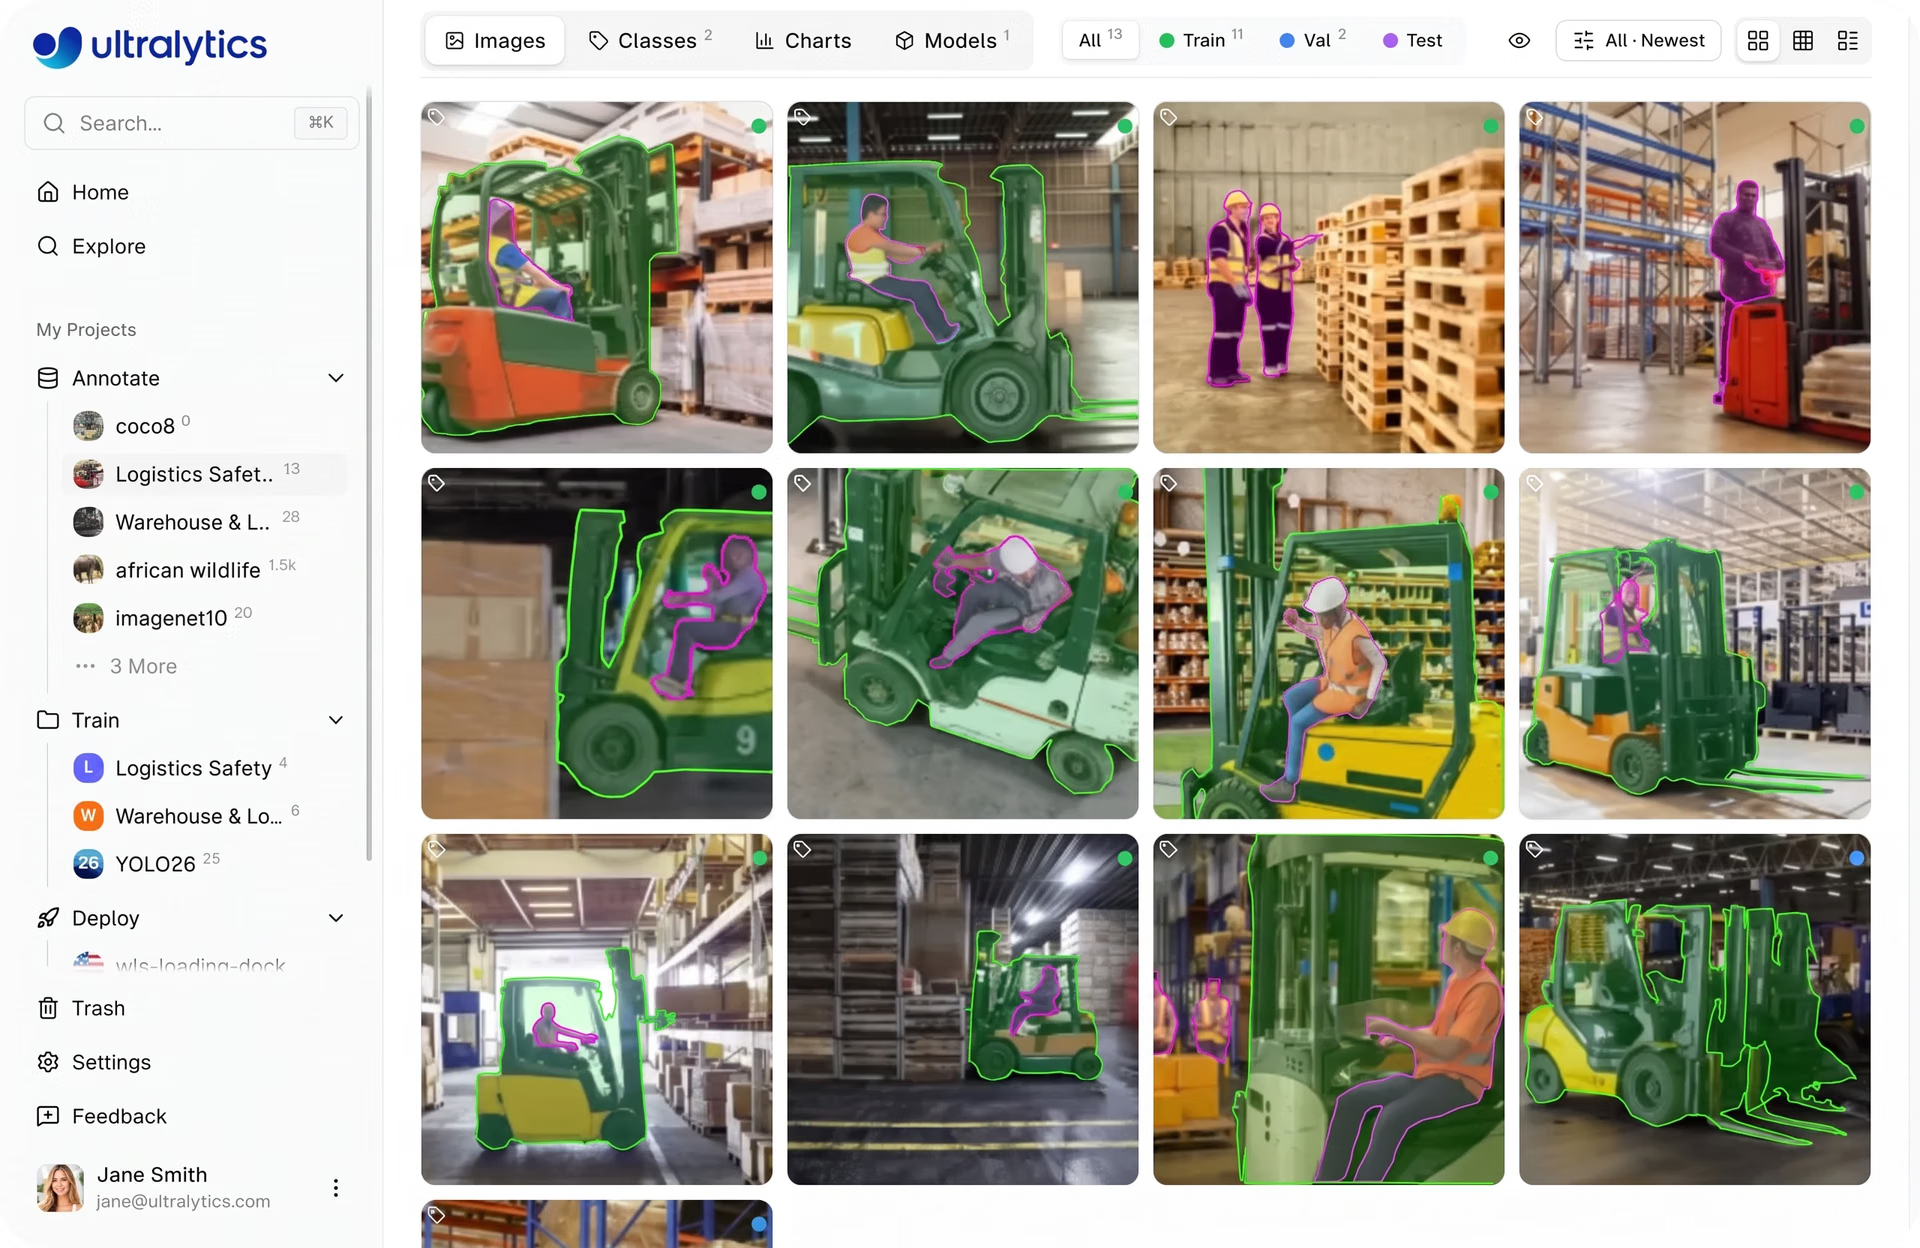
Abb. 1. Beispiel für die Anzeige deiner Datensatzbilder in der Ultralytics Platform (Quelle)
In diesem Artikel gehen wir genauer darauf ein, wie dir die Ultralytics Platform dabei hilft, deine Datensätze nachzuverfolgen, zu vergleichen und zu verbessern, um zuverlässigere Computer-Vision-Modelle zu entwickeln.
Die Bedeutung der Datensatzverwaltung für Computer Vision#
Die Leistung eines Computer-Vision-Modells hängt eng mit den Daten zusammen, mit denen es trainiert wird. Die Modellgenauigkeit, also wie oft Vorhersagen korrekt sind, hängt nicht nur vom Algorithmus ab, sondern auch davon, wie gut der Datensatz die Bedingungen der realen Welt abbildet.
Einfach ausgedrückt lernt ein Modell Muster direkt aus den Daten. Daher können Lücken, Verzerrungen oder Inkonsistenzen im Datensatz seine Vorhersagen beeinflussen. Anders gesagt: Daten von schlechter Qualität, fehlerhafte Annotationen oder eine unzureichende Abdeckung realer Bildvariationen – etwa unterschiedlicher Lichtverhältnisse, Objektwinkel, Hintergründe oder Verdeckungsgrade – können die Genauigkeit erheblich verringern, selbst wenn die Modellarchitektur leistungsfähig ist.
Das gilt auch für die Feinabstimmung eines Modells: Dabei wird ein vortrainiertes Modell mit neuen oder aktualisierten Daten weitertrainiert, damit es sich besser an einen bestimmten Anwendungsfall oder eine bestimmte Umgebung anpasst. Da die Modellgenauigkeit so stark von den Daten abhängt, ist deren ordnungsgemäße Verwaltung unerlässlich.
Zur Datensatzverwaltung gehören das Organisieren, Beschriften und kontinuierliche Aktualisieren von Daten, damit sie korrekt und relevant bleiben. So lässt sich die Leistung im Laufe der Zeit leichter verbessern, insbesondere wenn Modelle mit neuen Daten neu trainiert oder feinabgestimmt werden.
Wie sich die Datensatzqualität auf die Zuverlässigkeit in der Praxis auswirkt#
Anwendungsfälle für Computer Vision, etwa Sicherheitsüberwachungssysteme, zeigen sehr gut, warum eine ordnungsgemäße Datenverwaltung so wichtig ist. Diese Systeme müssen unter verschiedenen realen Bedingungen zuverlässig funktionieren, darunter unterschiedliche Lichtverhältnisse, Kamerawinkel, Menschenansammlungen und teilweise Verdeckungen.
Decken die Trainingsdaten diese Variationen nicht ab oder fehlt es an Vielfalt bei der Darstellung von Objekten in unterschiedlichen Szenen und unter verschiedenen Bedingungen, kann das Modell Objekte möglicherweise nur schwer zuverlässig erkennen. Ein Modell, das beispielsweise hauptsächlich mit gut beleuchteten, übersichtlichen Szenen trainiert wurde, kann bei schlechten Lichtverhältnissen oder in überfüllten Umgebungen schlecht abschneiden. In Sicherheitssystemen kann dies dazu führen, dass Ereignisse übersehen oder Fehlalarme ausgelöst werden.
Um das zu verhindern, ist es wichtig, Datensätze zu pflegen, die nicht nur sauber und korrekt beschriftet, sondern auch ausgewogen und stets aktuell sind. Dazu gehört, Lücken in den Daten zu erkennen, bei veränderten Bedingungen neue Beispiele hinzuzufügen und sicherzustellen, dass verschiedene Klassen und Umgebungen gleichmäßig vertreten sind.
Mit einem vollständigeren und strukturierteren Datensatz können Modelle besser mit Variationen in der realen Welt umgehen und zuverlässigere Vorhersagen treffen.
Wichtige Aspekte der Datensatzverwaltung#
Wie sieht Datensatzverwaltung also konkret aus? Dabei werden Daten organisiert, beschriftet und gepflegt, damit sie während des gesamten Modellentwicklungsprozesses effektiv genutzt werden können.
Zur Datenorganisation gehört beispielsweise, den Datensatz zu strukturieren und in Trainings-, Validierungs- und Testdaten aufzuteilen. Mit dem Trainingsdatensatz wird das Modell trainiert, der Validierungsdatensatz dient dazu, die Leistung zu überwachen und Anpassungen während der Entwicklung zu steuern, und mit dem Testdatensatz wird bewertet, wie gut das fertige Modell mit völlig unbekannten Daten zurechtkommt.
Bei der Beschriftung werden Bilder mit Angaben wie Klassenbezeichnungen, Begrenzungsrahmen oder Segmentierungsmasken annotiert. Da das Modell anhand dieser Annotationen lernt, sind Genauigkeit und Einheitlichkeit entscheidend, damit es aussagekräftige Muster lernt und zuverlässige Vorhersagen trifft.
Zur Pflege des Datensatzes gehört außerdem, die Daten im Laufe der Zeit zu überprüfen und zu aktualisieren. Dazu können das Beheben von Annotationsfehlern, das Entfernen minderwertiger oder doppelter Daten sowie das Hinzufügen neuer Beispiele gehören, um fehlende Fälle oder veränderte Bedingungen abzudecken.
Grundsätzlich ist die Datensatzverwaltung ein fortlaufender Prozess. Während Modelle ausgewertet und neue Daten erfasst werden, müssen Datensätze aktualisiert werden, damit sie reale Bedingungen und Grenzfälle abbilden. Wenn Teams diese Aktualisierungen nachverfolgen und verschiedene Versionen vergleichen, können sie erkennen, wodurch sich die Leistung verbessert und wo weitere Änderungen nötig sind.
Datensätze mit der Ultralytics Platform verwalten#
Die Ultralytics Platform bietet einen strukturierten Arbeitsablauf zur Verwaltung von Datensätzen in einer einzigen Umgebung – von der Datenvorbereitung bis zum Export. Sie ist sowohl für einzelne Entwicklerinnen und Entwickler als auch für Teams konzipiert und erleichtert die einheitliche Verwaltung von Datensätzen, ganz gleich, ob du allein oder gemeinsam an Projekten arbeitest.
Jede Phase ist darauf ausgelegt, die Organisation, Verarbeitung und Nutzung von Datensätzen während des gesamten Modellentwicklungszyklus zu vereinfachen. Wenn diese Schritte an einem Ort zusammengeführt werden, verringert die Plattform die Fragmentierung und erleichtert es, Arbeitsabläufe konsistent zu halten.
Sehen wir uns nun die wichtigsten Schritte und die Unterstützung der Plattform in jeder Phase an.
Datensätze in die Ultralytics Platform hochladen#
Der Einstieg in die Arbeit mit Datensätzen auf der Plattform ist flexibel und bietet mehrere Möglichkeiten, Daten hinzuzufügen oder wiederzuverwenden. Du kannst eigene Daten hochladen oder mithilfe öffentlicher Datensätze auf der Plattform schneller loslegen. Außerdem kannst du vorhandene, von der Community freigegebene Datensätze klonen und darauf aufbauen.
Mit den Community-Funktionen der Plattform lassen sich vorhandene Arbeiten leicht erkunden und wiederverwenden. Du kannst auf Datensätze anderer Nutzerinnen und Nutzer zugreifen, darunter Millionen von Bildern und Annotationen, und so schnell loslegen, ohne alles selbst erfassen und beschriften zu müssen. Beim Klonen eines Datensatzes wird eine Kopie in deinem Arbeitsbereich erstellt, die du bearbeiten und erweitern kannst, während das Original erhalten bleibt.
Für Uploads unterstützt die Plattform einzelne Bilder, Videos und Datensatzarchive wie ZIP-, TAR- oder GZ-Dateien. Außerdem werden gängige Datensatzformate wie YOLO und COCO unterstützt. So lassen sich bestehende Datensätze und Annotationen ganz einfach ohne zusätzliche Konvertierung importieren. Darüber hinaus kannst du Datensätze mithilfe einer von der Plattform exportierten NDJSON-Datei hochladen und so Datensätze einfach in verschiedenen Projekten wiederherstellen oder wiederverwenden.
Nach dem Hochladen verarbeitet die Plattform die Daten in einer strukturierten Pipeline. Dazu gehören die Validierung von Dateiformaten und -größen, das Anpassen der Bildgröße bei Bedarf, das Auslesen von Annotationen und das Erstellen von Datensatzstatistiken.
Videos werden beispielsweise in Einzelbilder umgewandelt, damit sie für das Training verwendet werden können. Bilder werden optimiert und für eine einfachere Durchsicht und Analyse vorbereitet. Nach der Verarbeitung können Datensätze auf der Plattform annotiert, analysiert und zum Trainieren von Modellen verwendet werden.
Datenannotation in der Ultralytics Platform#
Nach dem Hochladen können Datensätze direkt auf der Plattform überprüft und annotiert werden. Die Plattform umfasst integrierte Tools zur Bildannotation für eine Reihe von Computer-Vision-Aufgaben, darunter Objekterkennung, Instanzsegmentierung, semantische Segmentierung, Bildklassifizierung, Posenschätzung und die Erkennung orientierter Begrenzungsrahmen (OBB).
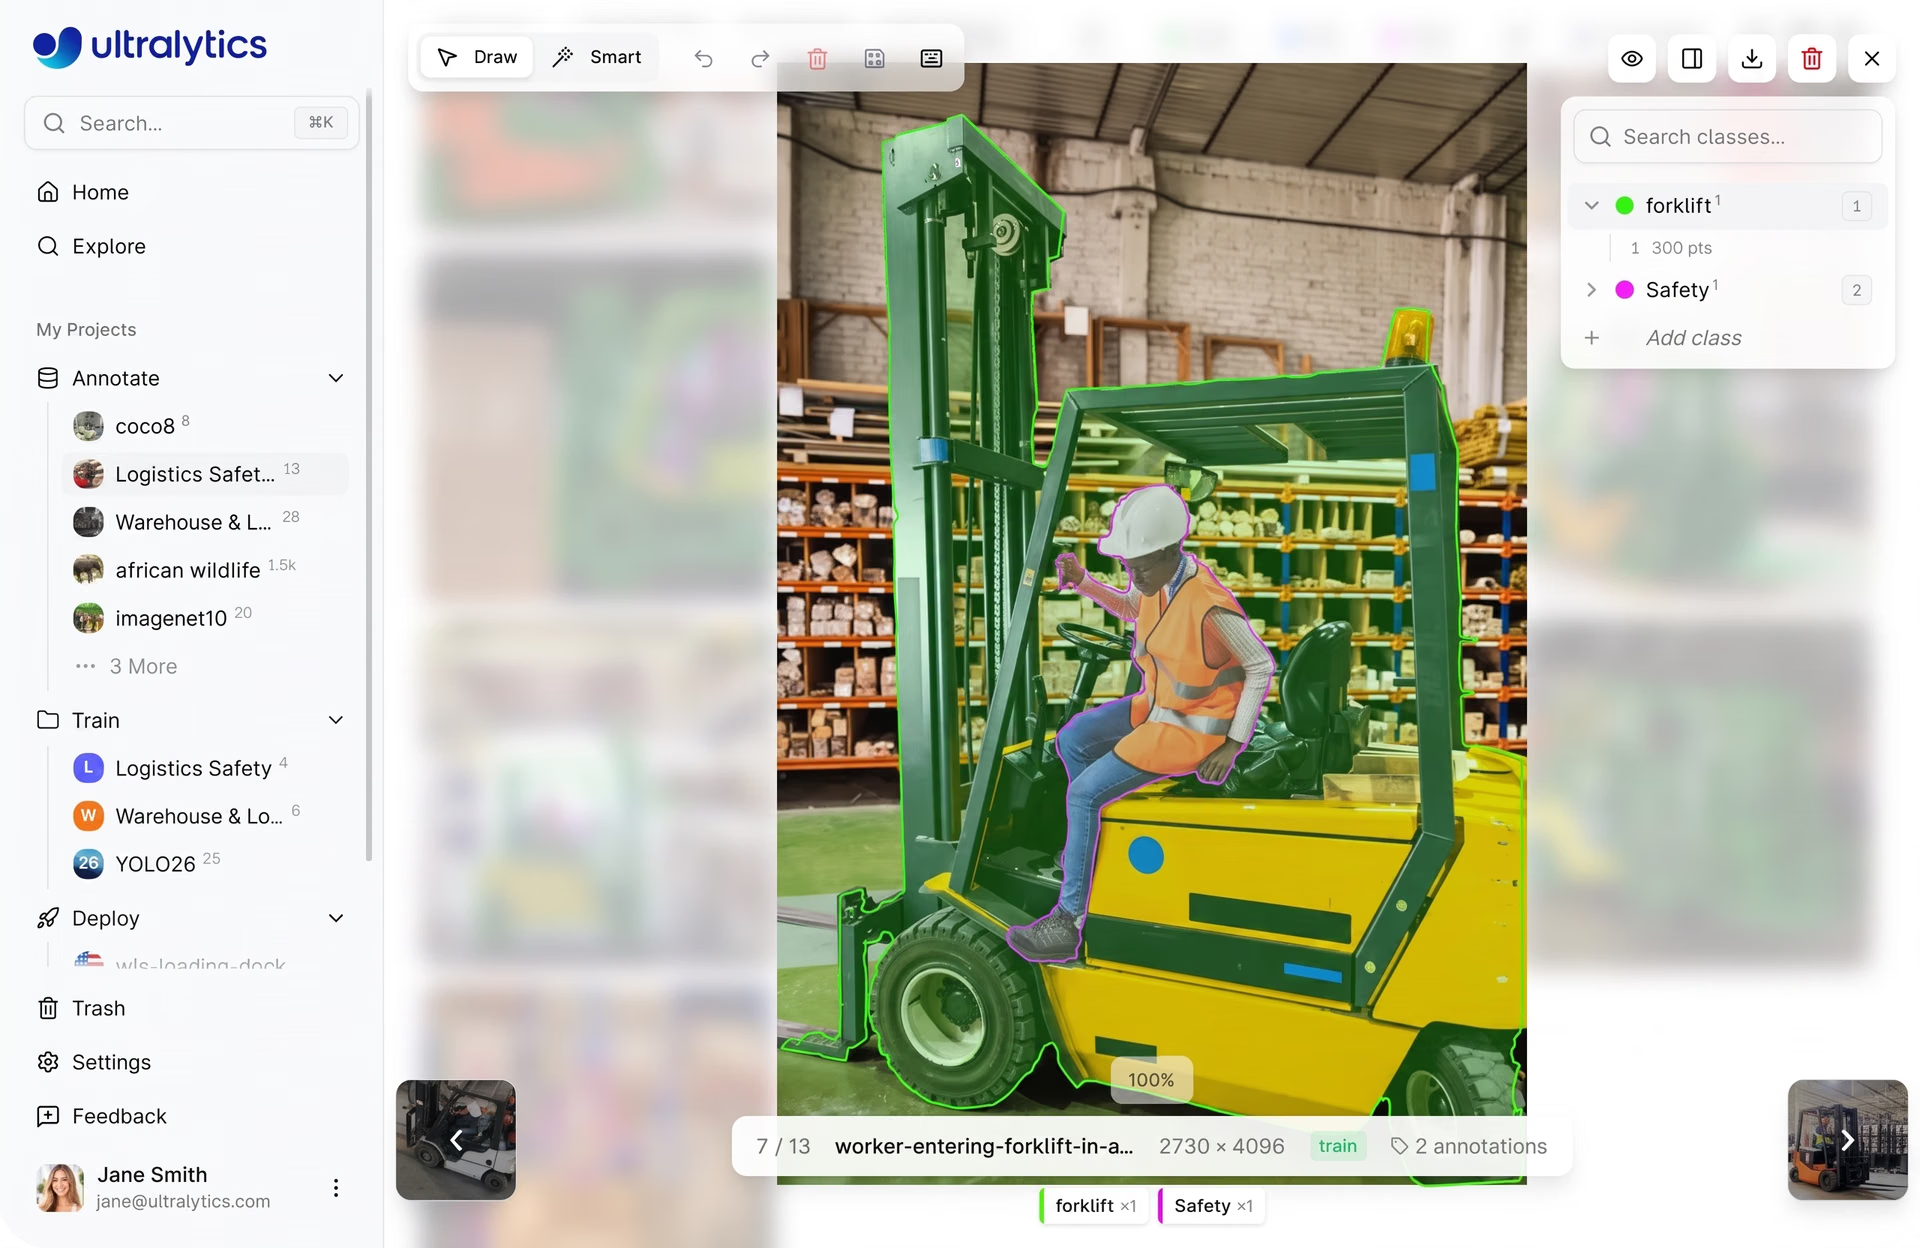
Abb. 2. Datenbeschriftung mit der Ultralytics Platform (Quelle)
Annotationen lassen sich manuell mit diesen Tools erstellen oder mithilfe KI-gestützter Funktionen wie der intelligenten SAM-gestützten Annotation schneller anfertigen. Mit SAM kannst du Masken, Begrenzungsrahmen oder gedrehte Begrenzungsrahmen erstellen, indem du direkt mit dem Bild interagierst. Das beschleunigt die Beschriftung und gewährleistet zugleich Genauigkeit.
Datensatzqualität mit der Ultralytics Platform analysieren#
Neben der Vorbereitung und Annotation von Daten ist es für zuverlässige Computer-Vision-Modelle entscheidend, die Datensatzqualität zu verstehen. Ohne einen klaren Überblick über Faktoren wie die Klassenverteilung, die Qualität der Annotationen, die Aufteilung des Datensatzes und die Repräsentation der Daten unter verschiedenen Bedingungen lassen sich Probleme, die die Modellleistung beeinträchtigen, nur schwer erkennen.
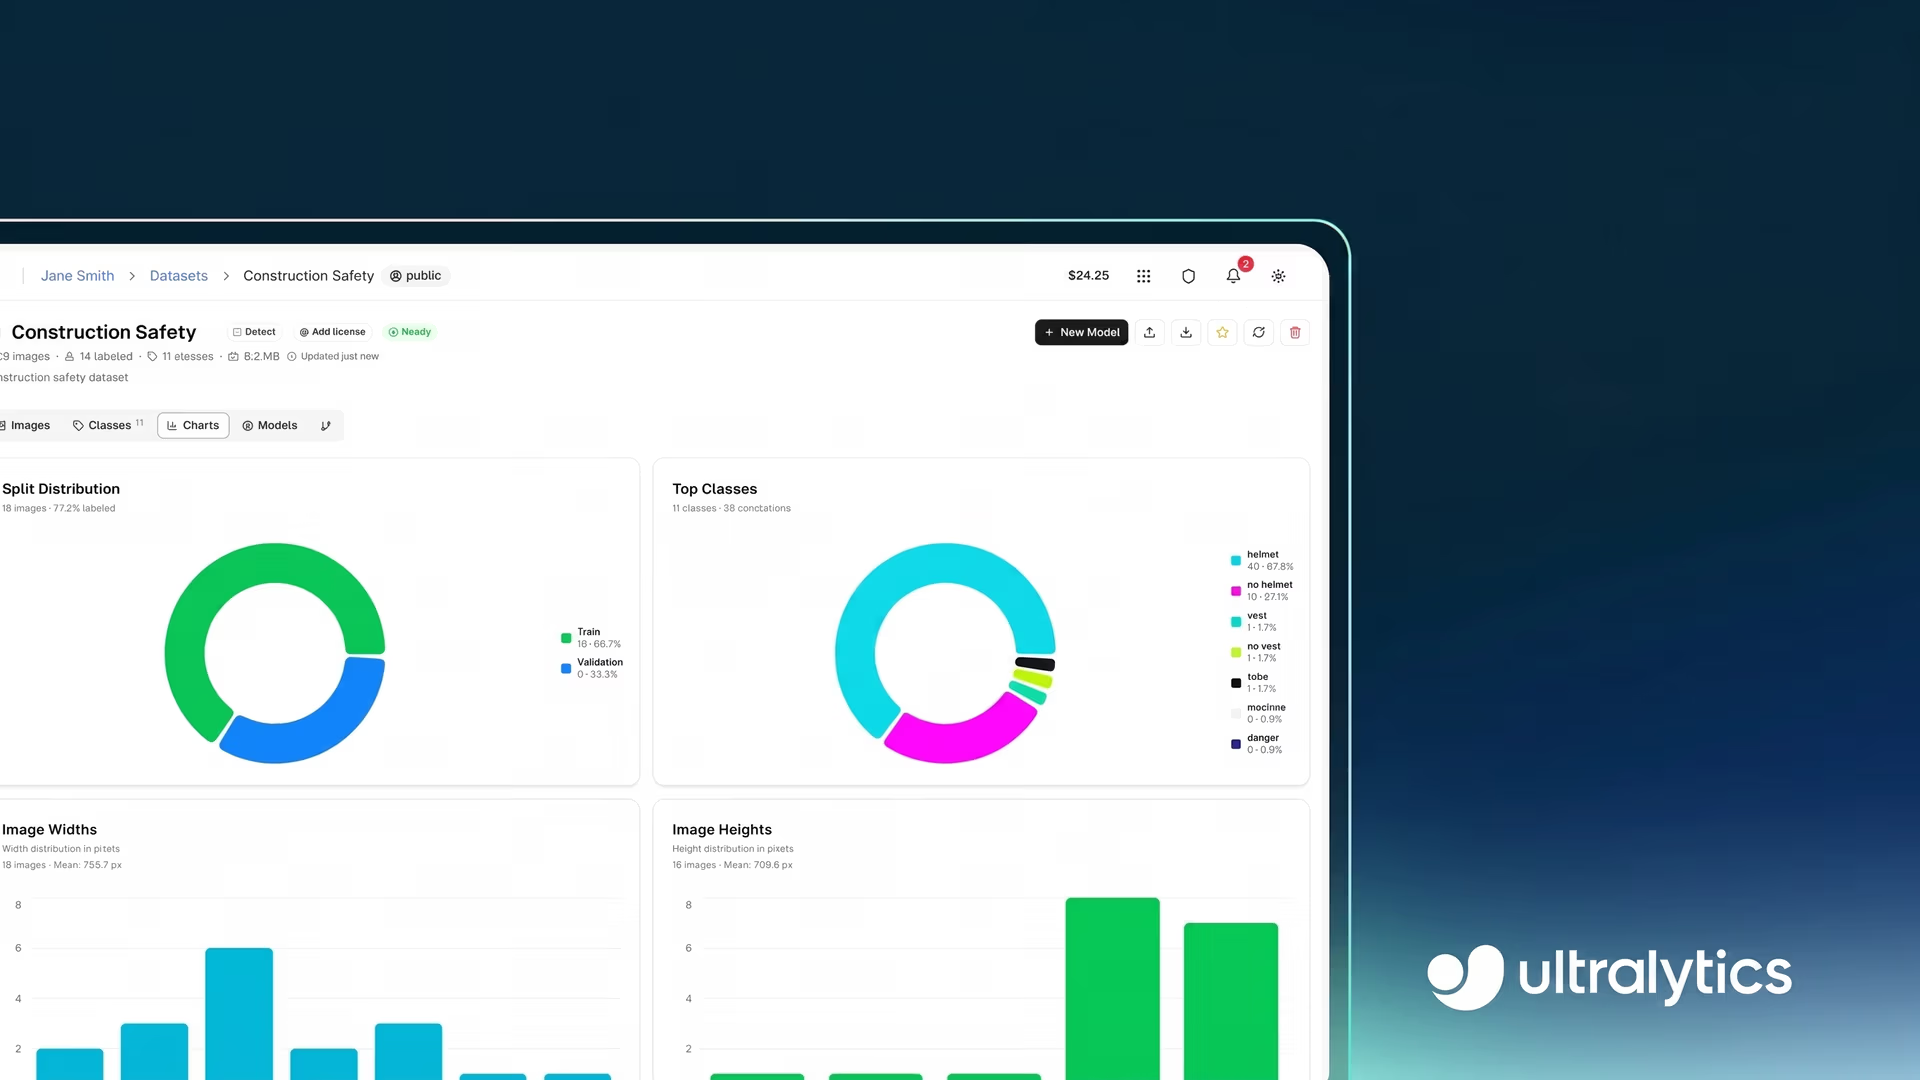
Die Ultralytics Platform bietet integrierte Funktionen, mit denen du Datensätze effektiver analysieren kannst. Diese Einblicke sind direkt in der Datensatzoberfläche über Registerkarten wie „Bilder“, „Klassen“ und „Diagramme“ verfügbar.
Auf der Registerkarte „Diagramme“ kannst du Statistiken zum gesamten Datensatz anzeigen, etwa die Aufteilung in Trainings-, Validierungs- und Testdaten, die Klassenhäufigkeit und Annotations-Heatmaps, die zeigen, wo Objekte in Bildern vorkommen.
Die Registerkarte „Klassen“ zeigt die Anzahl der Annotationen pro Klasse und erleichtert so das Erkennen von Klassenungleichgewichten. Auf der Registerkarte „Bilder“ findest du Einzelheiten zu den Bildern, etwa Abmessungen, die Anzahl der Annotationen und die Verteilung der Bezeichnungen auf einzelne Bilder.
Mit diesen Einblicken lassen sich Probleme wie Klassenungleichgewichte, fehlende Szenarien oder eine ungleichmäßige Datenverteilung leichter erkennen. Du könntest beispielsweise feststellen, dass bestimmte Klassen nur sehr wenige Beispiele enthalten oder dass sich die meisten Annotationen auf bestimmte Bildbereiche konzentrieren.
Neben der Datenanalyse unterstützt die Plattform die Kuratierung und Erweiterung von Datensätzen. Dabei werden Datensätze durch das Korrigieren oder Entfernen problematischer Daten verfeinert und Variationen vorhandener Daten erstellt, um die Modellleistung zu verbessern. Diese Anpassungen kannst du direkt auf der Plattform vornehmen, indem du Annotationen aktualisierst, neue Daten hinzufügst oder die Aufteilung des Datensatzes anhand der Analyseergebnisse neu organisierst.
Datensätze aus der Ultralytics Platform exportieren#
Sobald ein Datensatz vorbereitet und validiert wurde, kannst du ihn für den Einsatz in verschiedenen Umgebungen exportieren. So kannst du deine Computer-Vision-Daten flexibel dort verwenden, wo es für dich am besten passt – beim Training lokal, in der Cloud oder mit anderen Tools und Arbeitsabläufen.
Die Ultralytics Platform exportiert Datensätze als Ultralytics-NDJSON-Dateien. Das Ultralytics Python-Paket kann direkt mit diesem Format trainieren, und die Dateien lassen sich wieder in die Plattform importieren. So können Datensätze problemlos in verschiedene Trainingsabläufe und Tools integriert werden.
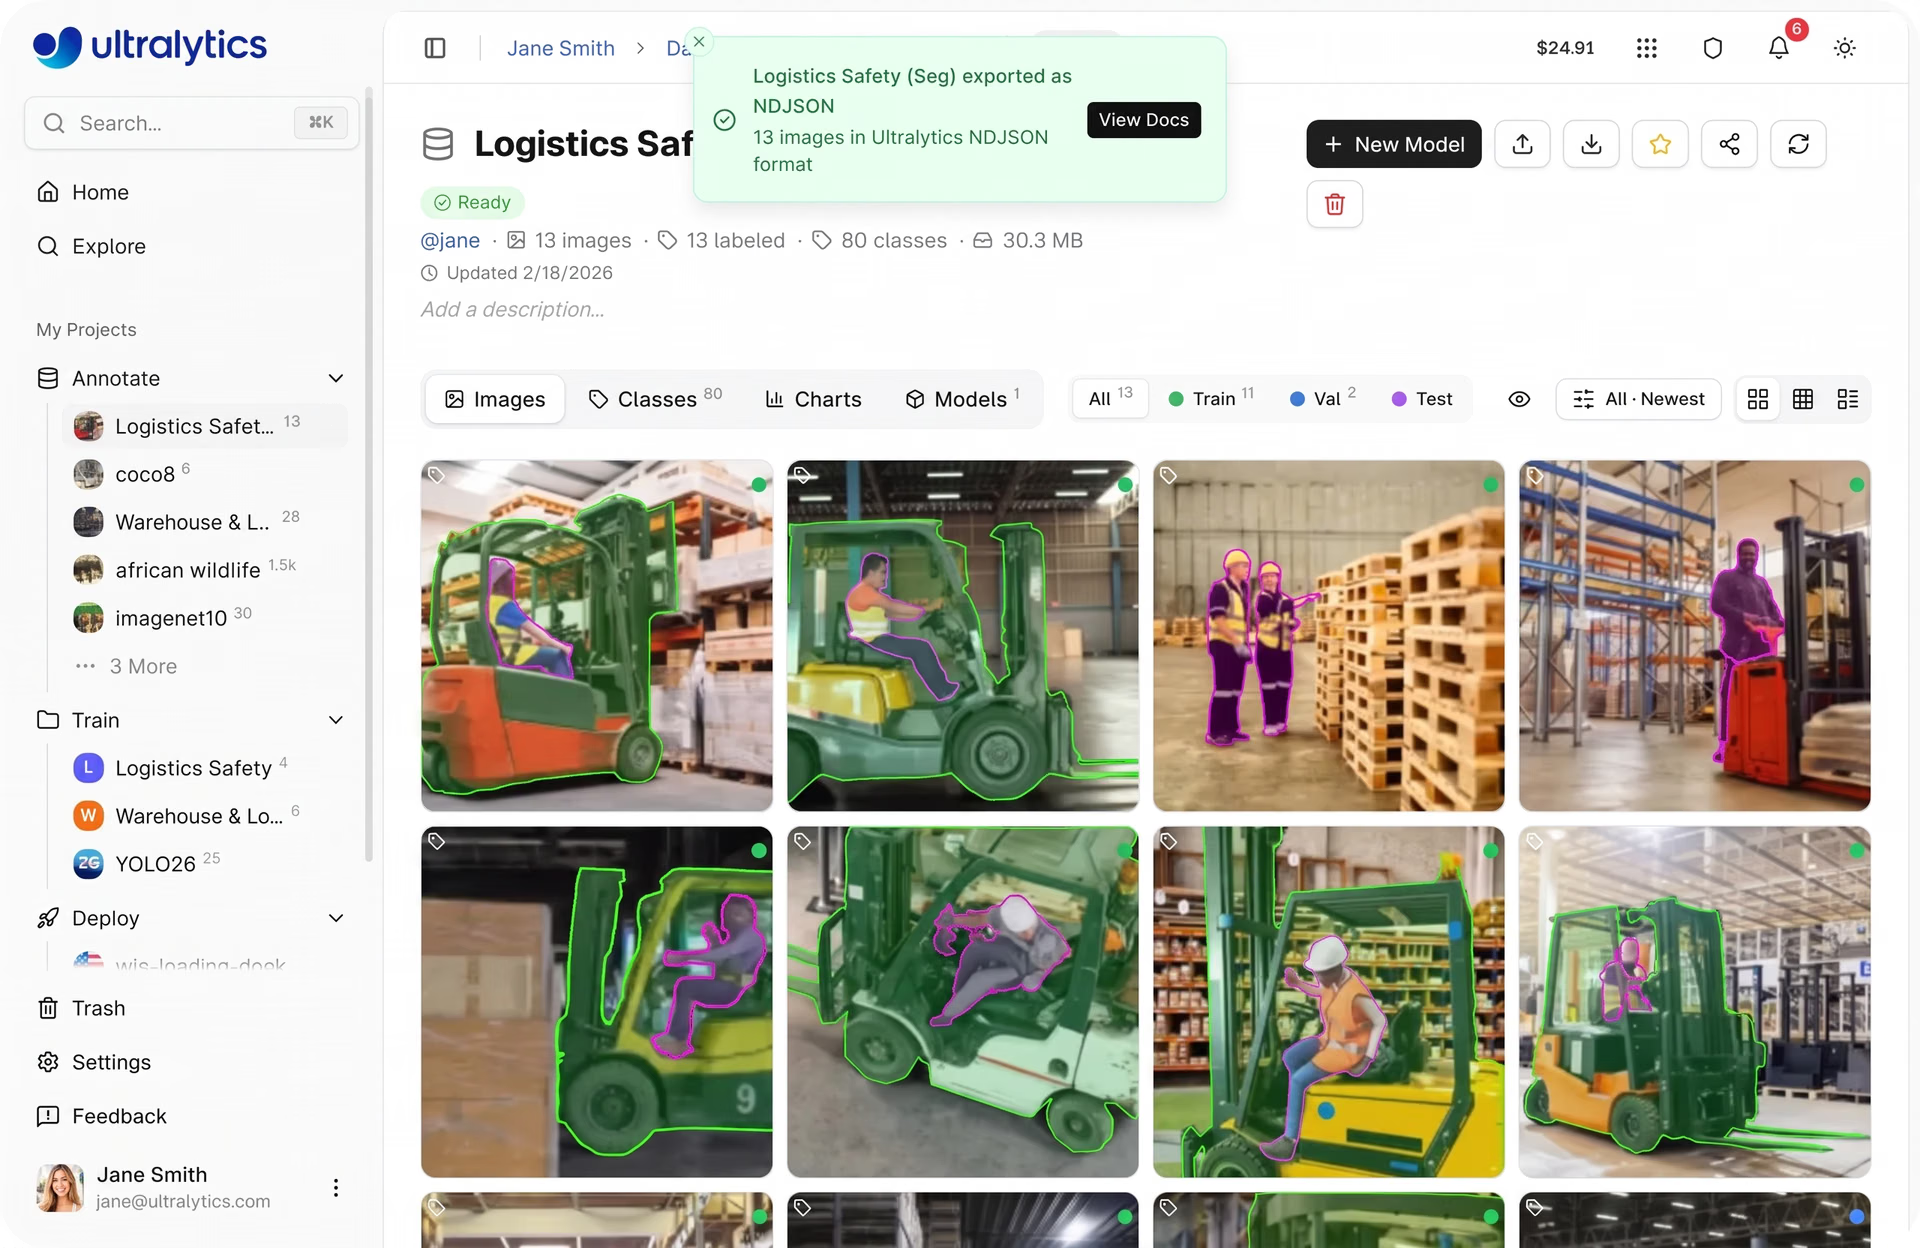
Abb. 3. Export eines Datensatzes aus der Ultralytics Platform (Quelle)
Beim Exportieren eines Datensatzes wird eine unveränderliche Momentaufnahme der Daten zu einem bestimmten Zeitpunkt erstellt, einschließlich der Bilder, Annotationen und Struktur. Das ist hilfreich, weil sich Datensätze häufig ändern, wenn neue Daten hinzugefügt, Annotationen aktualisiert oder Aufteilungen angepasst werden. Durch den Export einer Momentaufnahme kannst du genau die Version des Datensatzes bewahren, die für einen bestimmten Trainingslauf verwendet wurde.
So lassen sich Ergebnisse später leichter reproduzieren, da du ein Modell erneut mit derselben Datenkonfiguration trainieren und die Leistung verschiedener Datensatzversionen vergleichen kannst. Du kannst beispielsweise prüfen, ob neue Bilder oder korrigierte Annotationen die Modellgenauigkeit tatsächlich verbessern, anstatt zu raten, was sich geändert hat.
Exportierte Datensätze können heruntergeladen und in lokalen, Cloud- oder Offline-Trainingsumgebungen verwendet werden.
Datensatzqualität durch Iterationen mit der Ultralytics Platform verbessern#
In Arbeitsabläufen für maschinelles Lernen und Deep Learning wird die Datensatzverwaltung auch nach der Bereitstellung fortgesetzt, weil sich reale Daten häufig von den für das Training verwendeten Daten unterscheiden.
Wenn Modelle neue Eingaben verarbeiten, werden Lücken im Datensatz – etwa fehlende Bedingungen wie schlechte Lichtverhältnisse, unterschiedliche Kamerawinkel, Verdeckungen oder überfüllte Szenen – ebenso wie Annotationsfehler deutlicher. Daher müssen die Daten im Laufe der Zeit verfeinert werden.
Es gibt mehrere Möglichkeiten, einen Datensatz zu verbessern. Du kannst neue Bilder oder Videos hinzufügen, um fehlende Bedingungen wie schlechte Lichtverhältnisse, unterschiedliche Kamerawinkel, Verdeckungen oder überfüllte Szenen abzudecken und so blinde Flecken in den Daten zu verringern.
Gleichzeitig hilft es dem Modell, zuverlässigere Muster zu lernen, wenn Annotationen genau und einheitlich sind, beispielsweise durch korrekt beschriftete Objekte und präzise Begrenzungsrahmen oder Masken.
Typischerweise folgt darauf ein einfacher Kreislauf: Modell trainieren, Ergebnisse auswerten, Fehler erkennen, den Datensatz verbessern und erneut trainieren. Jeder Schritt hilft dabei, Probleme wie fehlerhafte Annotationen, fehlende Daten oder unzureichend vertretene Fälle aufzudecken.
Angenommen, du arbeitest an einem System zur Überwachung von Verkaufsregalen in Echtzeit, das Produkte in Geschäften erkennen soll. In frühen Versionen des Datensatzes fehlen möglicherweise bestimmte Produkttypen, Lichtverhältnisse oder dicht bestückte Regale. Bei der Auswertung stellst du vielleicht fest, dass das Modell Objekte in solchen Situationen nur schwer erkennt.
Um die Leistung zu verbessern, kannst du neue Bilder erfassen, die diese fehlenden Szenarien abdecken, und bei Bedarf die Annotationen aktualisieren. Durch wiederholtes Anwenden dieses Verfahrens wird das Modell mit der Zeit genauer und zuverlässiger in realen Bedingungen.
Die Ultralytics Platform unterstützt diesen Arbeitsablauf, indem sie Datensatzaktualisierungen mit Training und Auswertung verknüpft. Dank integrierter Versuchsverfolgung und Leistungskennzahlen lässt sich der Fortschritt leichter überwachen und die Datensätze lassen sich kontinuierlich verbessern.
Änderungen an Datensätzen mit der Ultralytics Platform nachverfolgen#
Wir haben kurz angesprochen, wie sich Datensätze im Laufe der Modellentwicklung verändern. Wenn neue Daten hinzukommen, Annotationen verfeinert und Klassen aktualisiert werden, ist es entscheidend, diese Änderungen nachzuverfolgen, um die Datenqualität zu erhalten und eine gleichbleibende Modellleistung sicherzustellen.
Hier sind einige wichtige Funktionen der Ultralytics Platform zur Nachverfolgung von Datensätzen und zur Versionsverwaltung:
- Datensatzversionierung: Du kannst unveränderliche Datensatzversionen als NDJSON-Momentaufnahmen erstellen. Jede Version erfasst zu einem bestimmten Zeitpunkt wichtige Angaben wie die Anzahl der Bilder, Klassen und Annotationen sowie die Datensatzgröße. Diese Versionen werden gespeichert und können später heruntergeladen werden. So lassen sich Experimente leichter reproduzieren und Ergebnisse verschiedener Datensatzstände vergleichen.
- Registerkarte „Versionen“: Alle Datensatzversionen sind auf der Registerkarte „Versionen“ geordnet. Dort kannst du den Versionsverlauf einsehen, Änderungen beschreiben und nachverfolgen, wie sich der Datensatz im Laufe der Zeit entwickelt.
- Modelle verknüpfen: Die Registerkarte „Modelle“ zeigt alle Modelle, die mit einem Datensatz trainiert wurden, einschließlich Kennzahlen wie mAP und Trainingsdetails. Datensatzversionen sind mit Trainingsläufen verknüpft, sodass du nachvollziehen kannst, wie sich Datenänderungen auf die Modellleistung auswirken.
- Registerkarte „Fehler“: Auf der Registerkarte „Fehler“ werden Dateien hervorgehoben, bei deren Verarbeitung Probleme aufgetreten sind. Außerdem werden Fehlerdetails und Lösungsvorschläge angezeigt. So kannst du beispielsweise beschädigte Dateien oder nicht unterstützte Formate erkennen und vor dem Training beheben.
- Datensatzoberfläche (Registerkarten „Bilder“ und „Klassen“): In diesen Ansichten kannst du Bilder durchsuchen, Annotationen überprüfen, Klassenbezeichnungen verwalten und die Klassenverteilung analysieren. Funktionen wie Filtern, Sortieren und das Erkennen nicht annotierter Bilder erleichtern es, die Datensatzqualität im Laufe der Zeit zu überwachen.
- Statistiken und Diagramme: Integrierte Datenvisualisierungen wie die Verteilung der Datensatzaufteilung, die Klassenhäufigkeit und Annotations-Heatmaps helfen dabei, Änderungen in der Datenverteilung nachzuverfolgen und Ungleichgewichte im Zuge der Weiterentwicklung des Datensatzes zu erkennen.
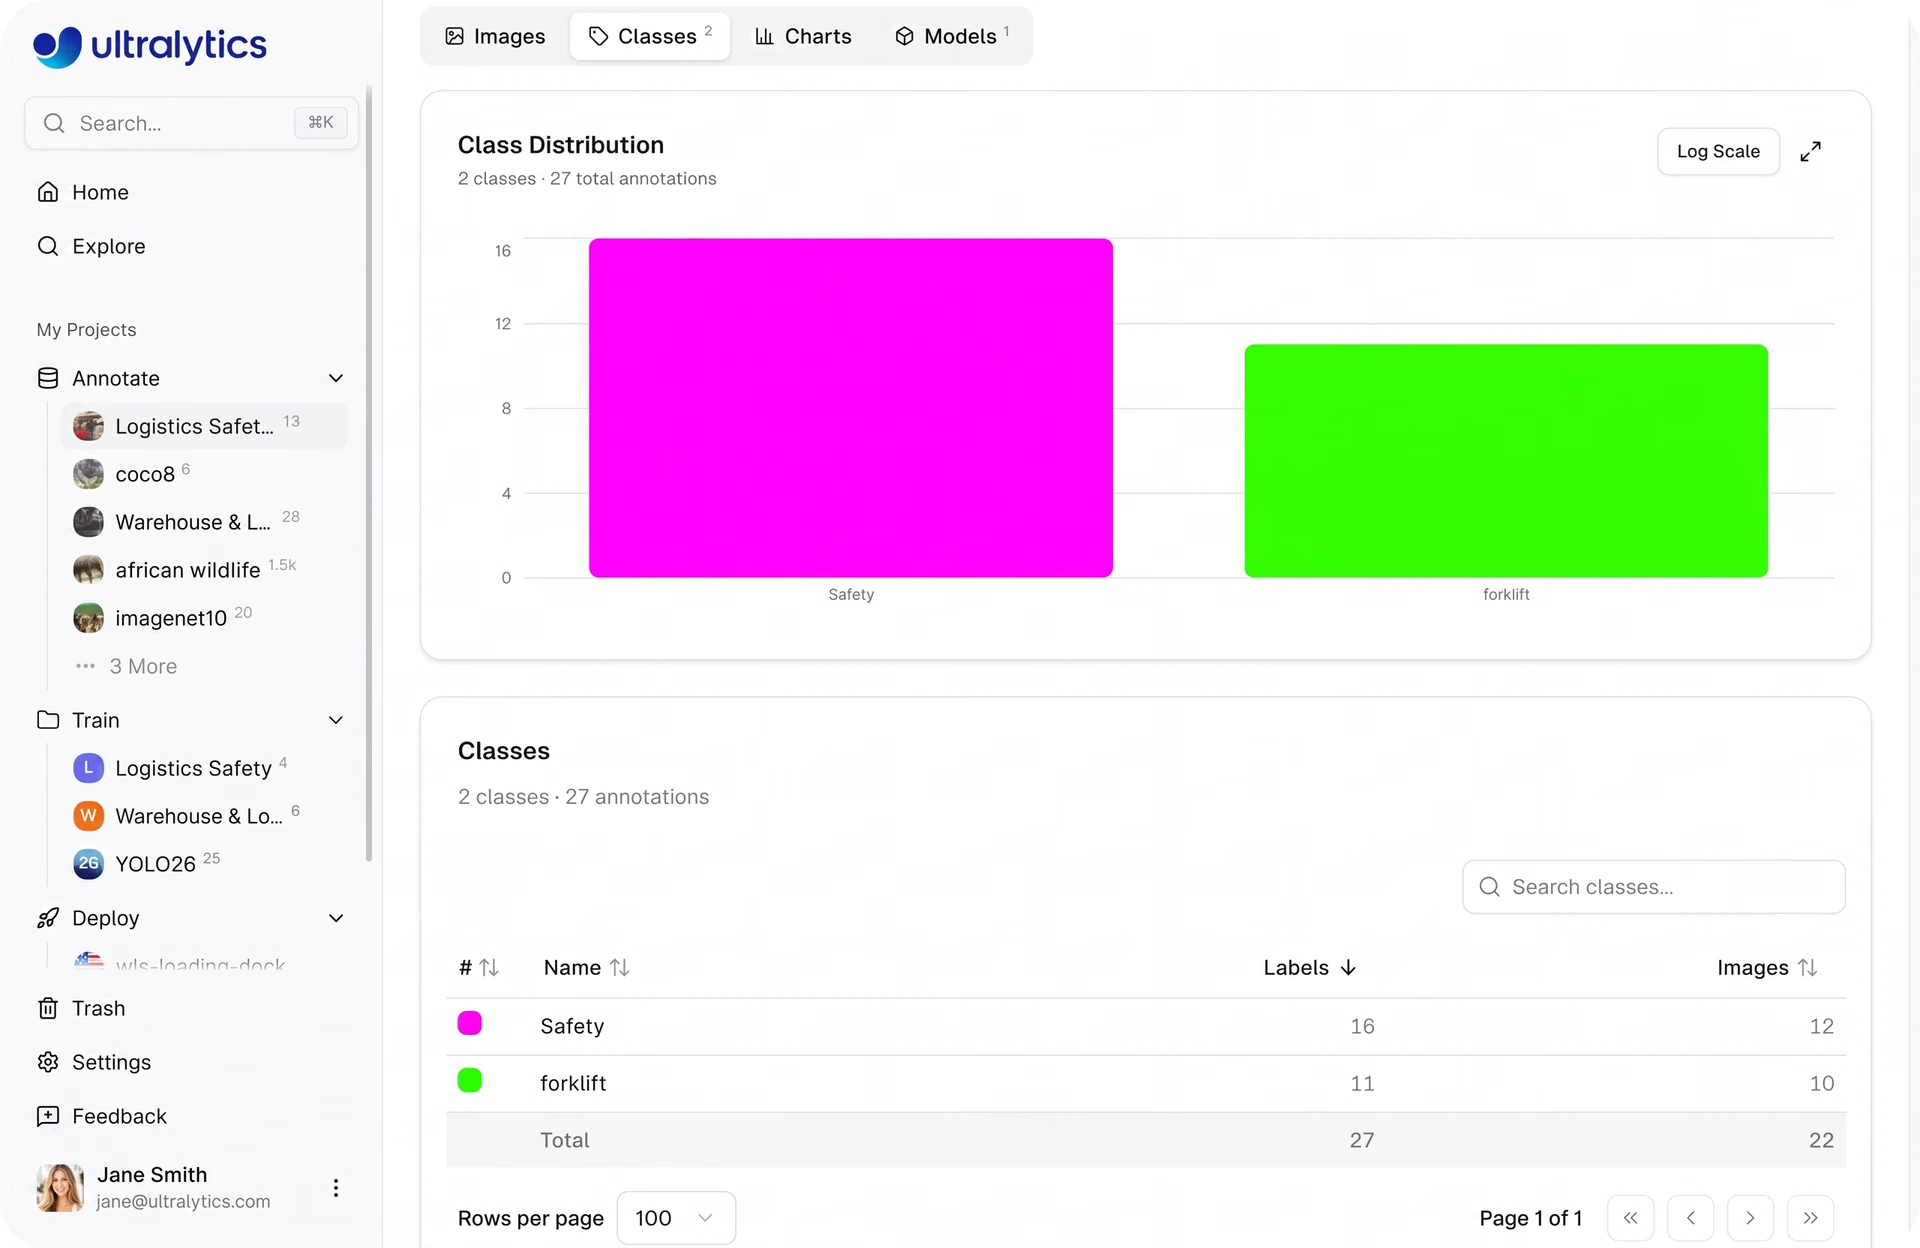
Abb. 4. Analyse der Klassenverteilung eines Datensatzes in der Ultralytics Platform (Quelle)
Datensätze in der Ultralytics Platform mit Training und Bereitstellung verknüpfen#
Die Ultralytics Platform führt verschiedene Phasen der KI-Modellentwicklung in einer einzigen Pipeline zusammen. So wird der Weg von Rohdaten zu produktionsreifen Anwendungen für visuelle KI optimiert.
Sobald Datensätze vorbereitet und annotiert sind, kannst du sie direkt auf der Plattform zum Trainieren von Computer-Vision-Modellen wie Ultralytics YOLO26 verwenden. Während des Trainings kannst du Leistungskennzahlen überwachen, Experimente nachverfolgen und mithilfe integrierter Dashboards auswerten, wie gut das Modell lernt.
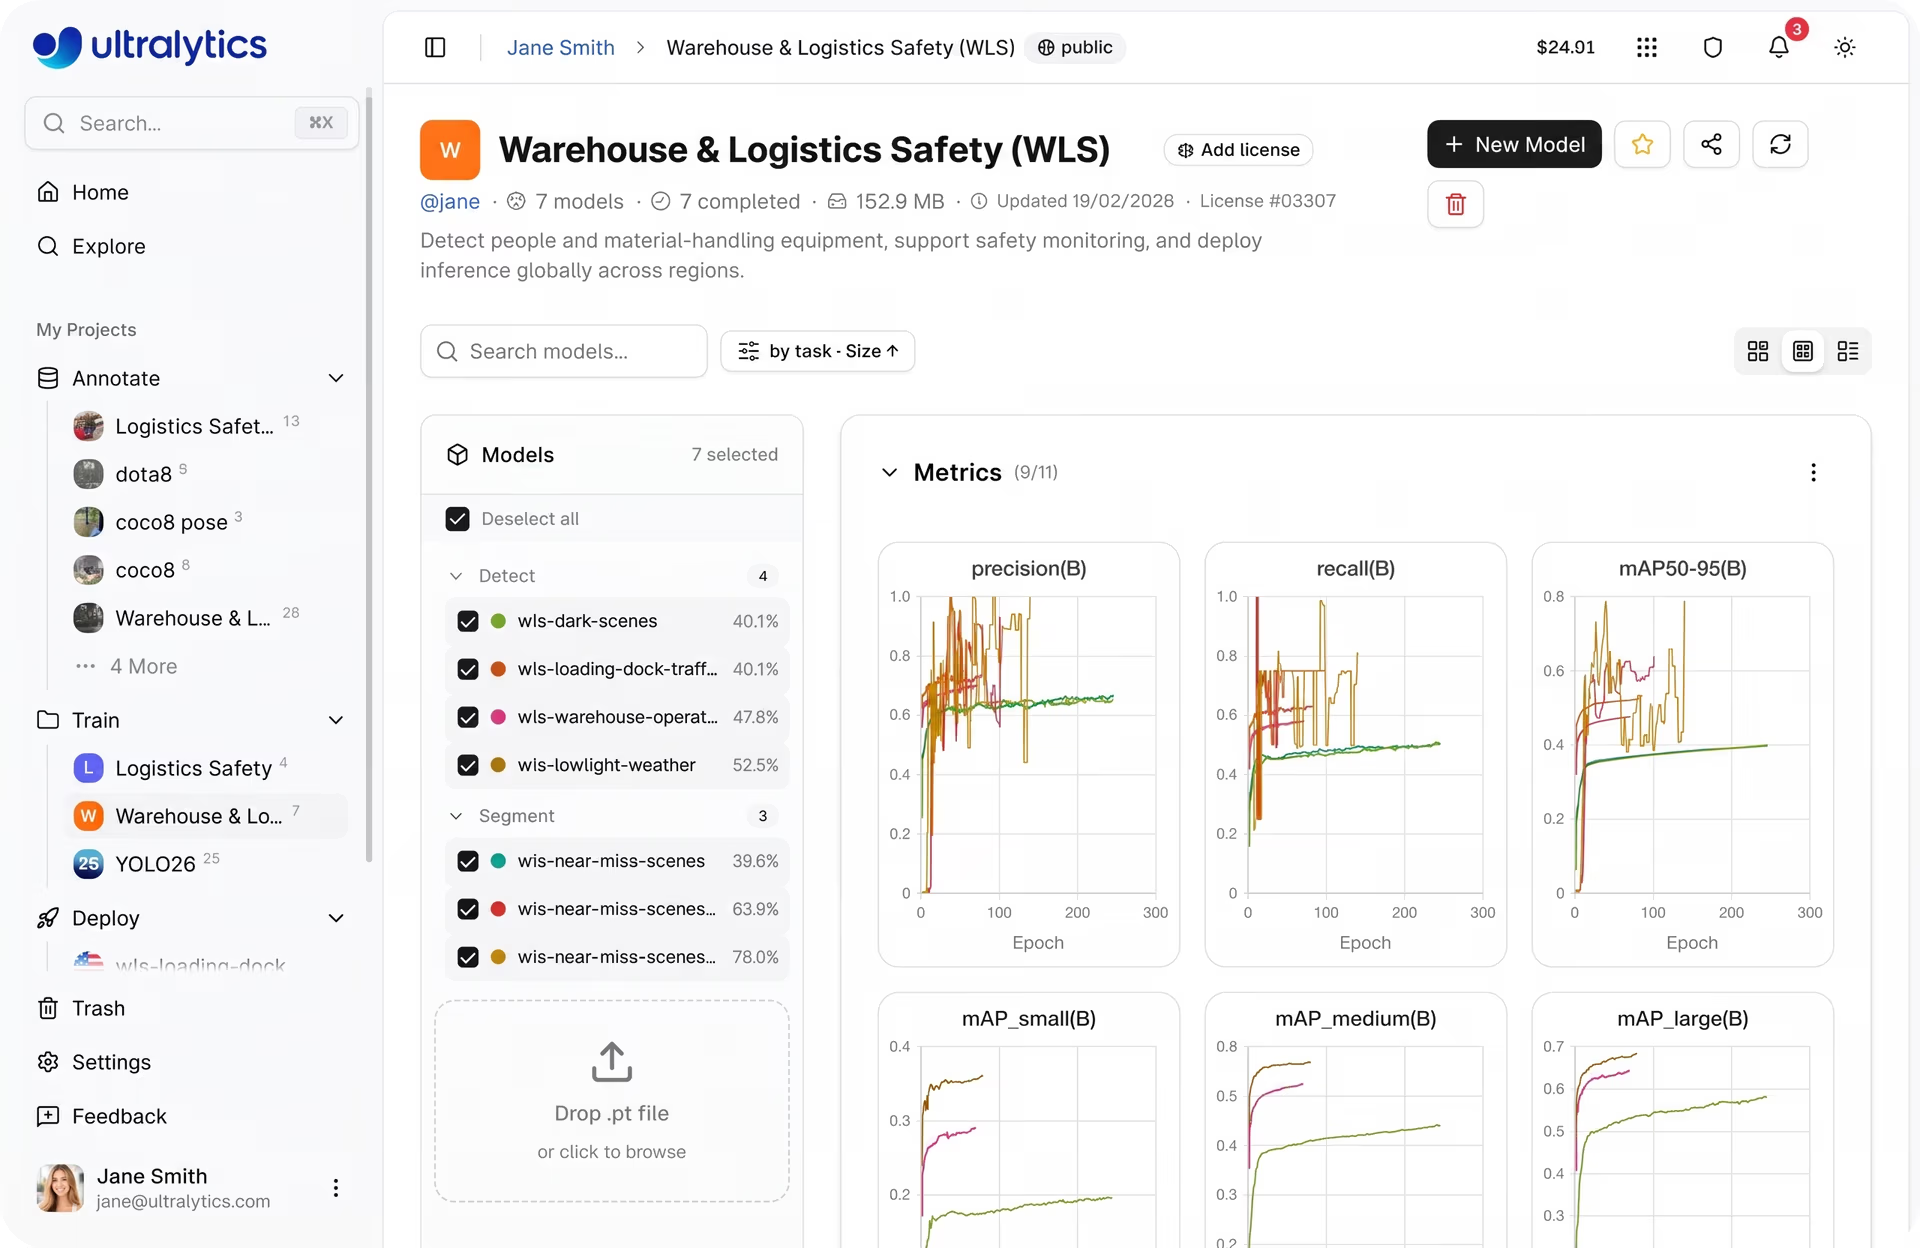
Abb. 5. Ein Blick auf die Anzeige von Trainingskennzahlen eines Modells in der Ultralytics Platform (Quelle)
Nach dem Training kannst du Modelle direkt im Browser mit neuen Bildern testen, um Vorhersagen auszuwerten und vor der Bereitstellung Verbesserungsmöglichkeiten zu erkennen. Wenn das Modell gute Ergebnisse liefert, kann es in den Produktivbetrieb überführt werden.
Die Plattform unterstützt den Export von Modellen in verschiedene Formate sowie ihre Bereitstellung über Inferenzdienste und eigens dafür vorgesehene Endpunkte, sodass sie in unterschiedlichen Umgebungen ausgeführt werden können.
Nach der Bereitstellung helfen integrierte Überwachungswerkzeuge dabei, die Systemleistung im Laufe der Zeit zu verfolgen, einschließlich Kennzahlen zu Nutzung und Modellverhalten. So lassen sich Systeme für visuelle KI in realen Anwendungen einfacher warten und verbessern.
Bewährte Verfahren für die Datensatzverwaltung mit der Ultralytics Platform#
Hier sind einige wichtige Punkte, die du bei der Verwaltung deiner Datensätze mit der Ultralytics Platform beachten solltest:
- Nutze Filter, um Lücken zu finden: Mit Filterwerkzeugen lassen sich unbeschriftete oder unterrepräsentierte Daten aufspüren. So kannst du Annotationen leichter vervollständigen und die Abdeckung verbessern.
- Behebe Fehler frühzeitig: Nutze den Tab „Errors“ zur Qualitätskontrolle, um fehlgeschlagene Uploads, beschädigte Dateien oder nicht unterstützte Formate vor dem Training zu erkennen.
- Aktualisiere Datensätze kontinuierlich: Füge neue Daten hinzu, korrigiere Annotationen und berücksichtige Sonderfälle, sobald sie auftreten. So verbesserst du die Abdeckung und stellst sicher, dass Modelle in realen Szenarien zuverlässig funktionieren.
- Verwalte Datensatzaufteilungen sorgfältig: Sorge für ein ausgewogenes Verhältnis zwischen Trainings-, Validierungs- und Testdaten. Bei Bedarf kannst du die Aufteilungen manuell neu organisieren oder automatisch neu verteilen lassen.
Weitere Informationen zur Ultralytics Platform findest du in der offiziellen Dokumentation zur Ultralytics Platform.
Die wichtigsten Erkenntnisse#
Mit zunehmendem Umfang von Computer-Vision-Projekten wird eine effektive Verwaltung von Datensätzen genauso wichtig wie die Modellentwicklung. Ein strukturierter Ansatz für die Datensatzverwaltung trägt dazu bei, die Datenqualität zu verbessern, Arbeitsabläufe zu optimieren und die Modellleistung langfristig zu steigern.
Die Ultralytics Platform vereinfacht diesen Prozess, indem sie Datensatzverwaltung, Training und Bereitstellung in einem einzigen Arbeitsablauf zusammenführt. Mit einem strukturierten Ansatz für die Datensatzverwaltung können Teams die Komplexität verringern, die Effizienz steigern und besser skalierbare und zuverlässigere Computer-Vision-Systeme entwickeln.
Werde Teil unserer wachsenden Community und entdecke unser GitHub-Repository mit Ressourcen zu KI. Wenn du heute mit Vision-KI entwickeln möchtest, informiere dich über unsere Lizenzoptionen. Erfahre auf unseren Lösungsseiten, wie KI in der Landwirtschaft die Landwirtschaft verändert und wie Vision-KI im Gesundheitswesen die Zukunft mitgestaltet.
Verfasst von
Content Creator · Ultralytics
Kommentare
Stelle eine Frage, teile deine Ergebnisse oder hilf anderen.









