Cómo Ultralytics YOLO26 se entrena de forma más inteligente con ProgLoss, STAL y MuSGD
Descubre cómo Ultralytics YOLO26 se entrena de forma más fiable gracias al equilibrio progresivo de pérdidas, la asignación de etiquetas adaptada a objetos pequeños y el optimizador MuSGD.
 Abirami Vina11 min de lectura
La semana pasada lanzamos Ultralytics YOLO26, un modelo de visión artificial en tiempo real diseñado prioritariamente para dispositivos perimetrales. Al igual que los anteriores modelos Ultralytics YOLO, como Ultralytics YOLO11, YOLO26 admite las principales tareas de visión artificial que ya conocen los usuarios, como la detección de objetos, la segmentación de instancias y la estimación de la pose.
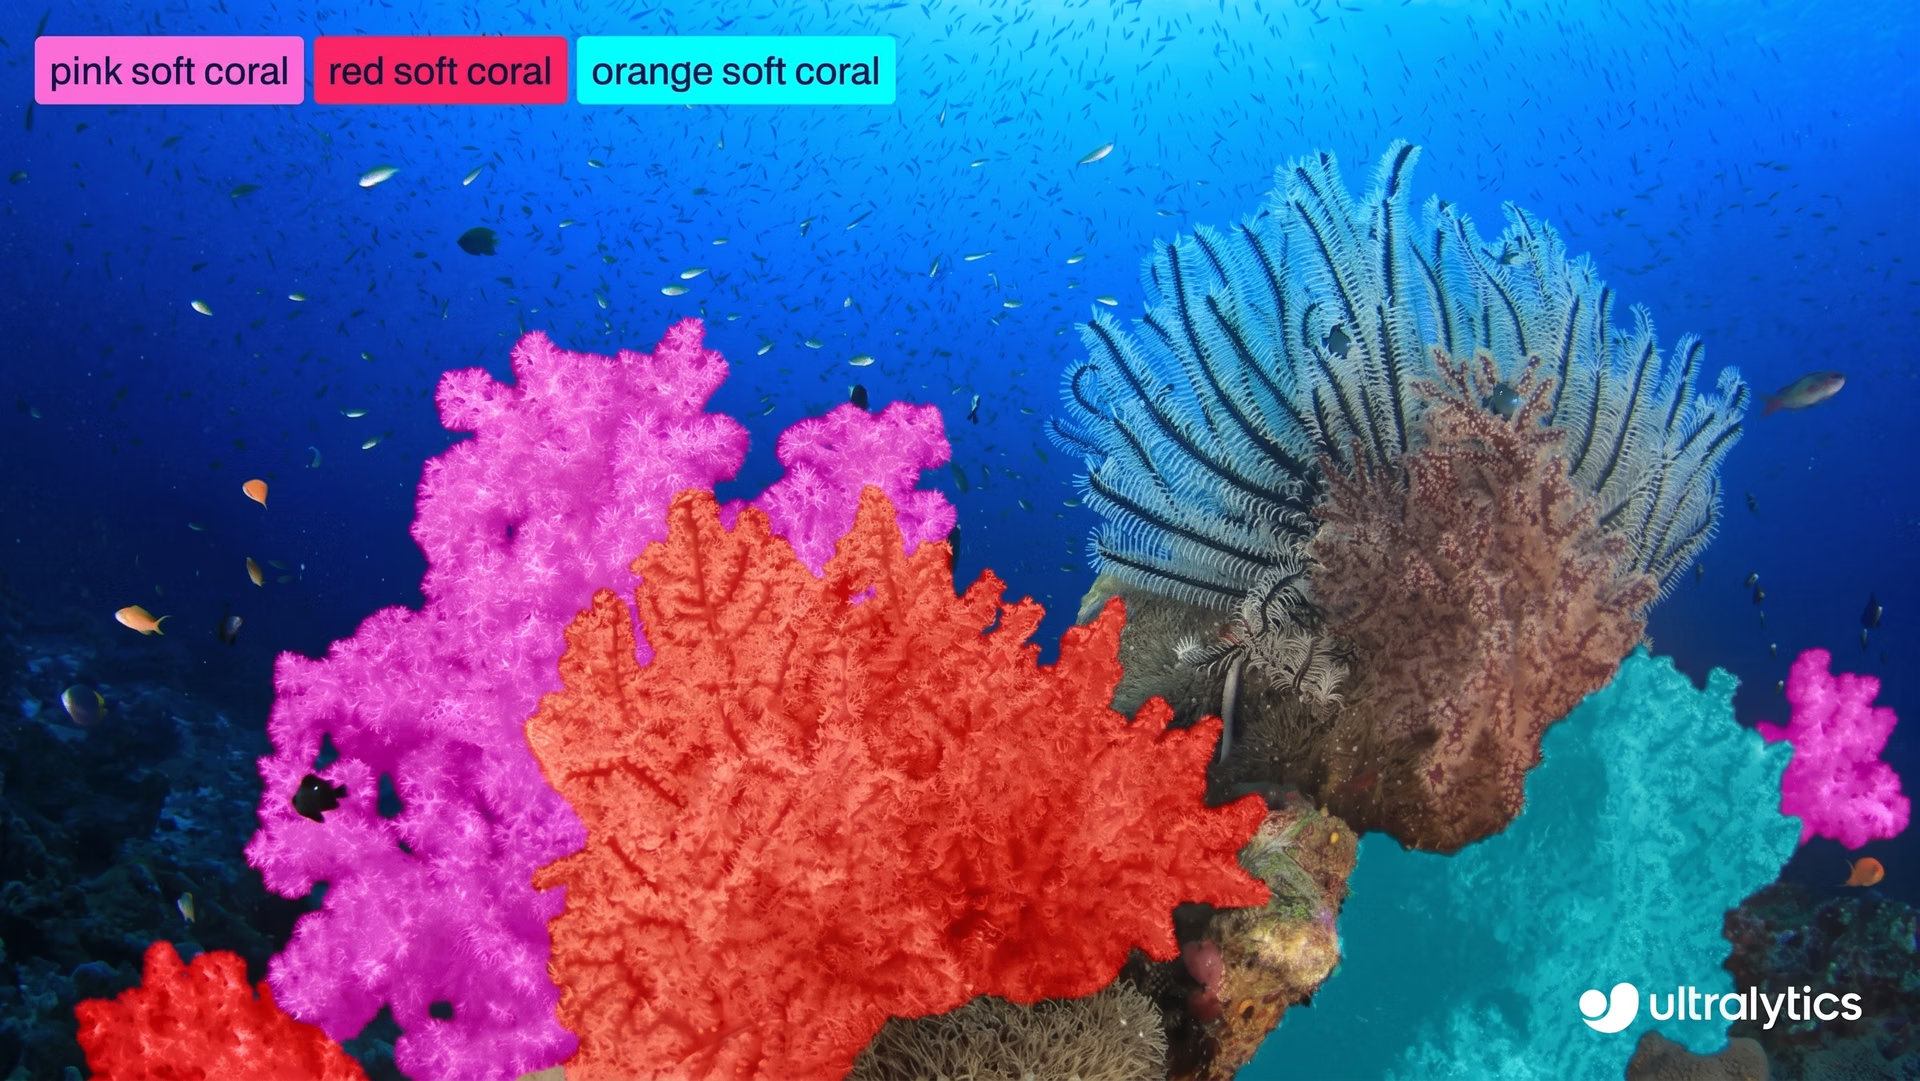
Fig. 1. Ejemplo del uso de Ultralytics YOLO26 para segmentar objetos en una imagen.
Sin embargo, Ultralytics YOLO26 no es una simple actualización incremental. Aunque las tareas admitidas puedan parecer conocidas, este nuevo modelo supone un avance en la forma de entrenar los modelos de visión artificial. Con YOLO26, el enfoque va más allá de la eficiencia de la inferencia y busca que el entrenamiento sea más estable.
Ultralytics YOLO26 se diseñó teniendo en cuenta todo el ciclo de vida del entrenamiento. Esto se traduce en una convergencia más rápida, ejecuciones de entrenamiento más fiables y un comportamiento coherente del modelo. Estas mejoras son especialmente importantes en los flujos de trabajo reales, donde la fiabilidad del entrenamiento afecta directamente a la rapidez con la que se pueden iterar e implementar los modelos.
Para lograrlo, Ultralytics YOLO26 incorpora varias innovaciones específicas en el entrenamiento, como la compensación progresiva de pérdidas (ProgLoss), la asignación de etiquetas con atención a objetos pequeños (STAL) y el optimizador MuSGD. En conjunto, estos cambios mejoran el equilibrio de las pérdidas de aprendizaje, la asignación de etiquetas y el comportamiento de la optimización a lo largo del tiempo.
En este artículo veremos cómo funciona cada uno de estos mecanismos y por qué facilitan el entrenamiento de Ultralytics YOLO26 y mejoran su fiabilidad a gran escala. ¡Empecemos!
Ultralytics YOLO26: diseñado para entrenar de forma más inteligente, no solo para ejecutarse más rápido#
Ultralytics YOLO26 optimiza de forma nativa toda la canalización de inferencia al eliminar la dependencia de pasos de posprocesamiento como la supresión no máxima (NMS). En lugar de generar numerosas predicciones superpuestas y filtrarlas después, YOLO26 produce las detecciones finales directamente desde la red.
Esto convierte a YOLO26 en un modelo de extremo a extremo, en el que la predicción, la resolución de duplicados y los resultados finales se aprenden dentro de la propia red. Esto simplifica la implementación y mejora la eficiencia de la inferencia, al tiempo que influye en la forma en que aprende el modelo durante el entrenamiento.
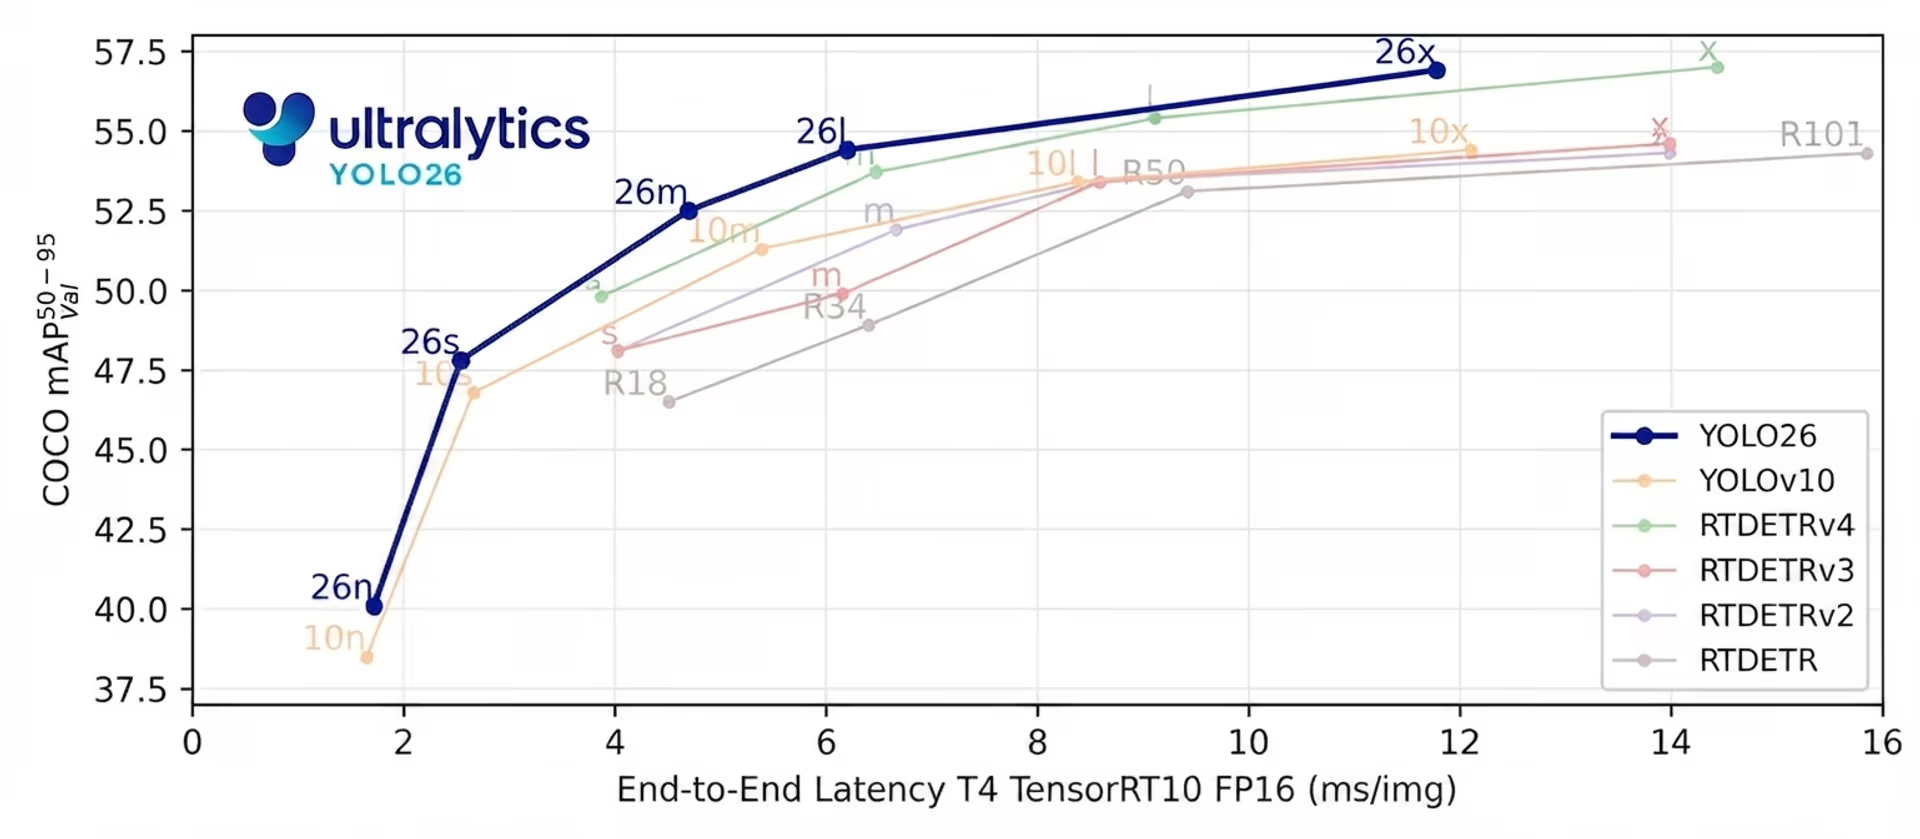
Fig. 2. YOLO26 ofrece inferencia de última generación de extremo a extremo y sin NMS (Fuente)
En un sistema de extremo a extremo como este, el entrenamiento y la inferencia están estrechamente relacionados. Como no hay una fase de posprocesamiento externa que corrija las predicciones más adelante, el modelo debe aprender a tomar decisiones claras y seguras durante el propio entrenamiento.
Por eso es especialmente importante que los objetivos de entrenamiento y el comportamiento durante la inferencia estén alineados. Cualquier discrepancia entre cómo se entrena el modelo y cómo se utiliza durante la inferencia puede provocar un aprendizaje inestable o una convergencia más lenta.
Ultralytics YOLO26 resuelve este problema diseñando su proceso de entrenamiento desde el principio en torno al uso en condiciones reales. En lugar de centrarse únicamente en la velocidad de inferencia, el sistema de entrenamiento está diseñado para favorecer un aprendizaje estable durante entrenamientos prolongados, una convergencia uniforme en tamaños de modelo que van desde Nano hasta Extra Large y un rendimiento sólido en conjuntos de datos diversos.
Cómo mejoran el aprendizaje los dos cabezales de entrenamiento de Ultralytics YOLO26#
Una de las principales innovaciones de entrenamiento de Ultralytics YOLO26 se basa en un enfoque de entrenamiento con dos cabezales, utilizado en modelos YOLO anteriores. En los modelos de detección de objetos, un cabezal es la parte de la red responsable de realizar predicciones.
En otras palabras, los cabezales de detección aprenden a predecir dónde están los objetos en una imagen y qué son. Para ello, regresan las coordenadas de las cajas delimitadoras, es decir, aprenden a estimar la posición y el tamaño de cada objeto en la imagen de entrada.
Durante el entrenamiento, el modelo aprende minimizando una pérdida, que es una medida numérica de cuánto se alejan sus predicciones de las respuestas correctas o valores de referencia. Una pérdida más baja significa que las predicciones del modelo se acercan más a los valores de referencia, mientras que una pérdida más alta indica errores mayores. El cálculo de la pérdida guía cómo actualiza el modelo sus parámetros durante el entrenamiento.
Ultralytics YOLO26 utiliza dos cabezales de detección durante el entrenamiento que comparten el mismo modelo subyacente, pero cumplen funciones distintas. El cabezal uno a uno es el que se utiliza durante la inferencia. Aprende a asociar cada objeto con una única predicción segura, algo esencial para el diseño de extremo a extremo y sin NMS de YOLO26.
Por su parte, el cabezal uno a muchos solo se utiliza durante el entrenamiento. Permite asociar varias predicciones al mismo objeto y proporciona una supervisión más densa. Esta señal de aprendizaje más rica ayuda a estabilizar el entrenamiento y mejorar la precisión, especialmente en las primeras etapas.
En Ultralytics YOLO26, ambos cabezales utilizan el mismo cálculo de pérdida para la regresión de cajas y la clasificación. En implementaciones anteriores se aplicaba un equilibrio fijo entre estas dos señales de pérdida durante todo el entrenamiento.
Sin embargo, en la práctica, la importancia de cada cabezal cambia con el tiempo. La supervisión densa resulta más útil al principio, mientras que la alineación con el comportamiento durante la inferencia cobra más importancia en las últimas fases del entrenamiento. Ultralytics YOLO26 está diseñado en torno a esta idea, que determina directamente cómo reequilibra las señales de aprendizaje a medida que avanza el entrenamiento.
Ultralytics YOLO26 utiliza el equilibrado progresivo de la pérdida#
Entonces, ¿cómo gestiona Ultralytics YOLO26 estas necesidades de aprendizaje cambiantes durante el entrenamiento? Utiliza el equilibrado progresivo de la pérdida para ajustar la ponderación de las señales de aprendizaje a lo largo del tiempo.
ProgLoss cambia dinámicamente la contribución de cada cabezal a la pérdida total a medida que avanza el entrenamiento. Al principio, se da más peso al cabezal uno a muchos para estabilizar el aprendizaje y mejorar la exhaustividad. A medida que continúa el entrenamiento, el equilibrio se desplaza gradualmente hacia el cabezal uno a uno, alineando el entrenamiento más estrechamente con el comportamiento durante la inferencia.
Esta transición gradual permite que Ultralytics YOLO26 aprenda en el orden adecuado. En lugar de obligar al modelo a optimizar objetivos contrapuestos a la vez, el equilibrado progresivo de la pérdida prioriza la señal de aprendizaje más útil en cada fase del entrenamiento. El resultado es una convergencia más fluida, menos entrenamientos inestables y un rendimiento final más uniforme.
Cómo ayuda STAL a Ultralytics YOLO26 a aprender de objetos diminutos#
Otra mejora interesante del entrenamiento de Ultralytics YOLO26 tiene que ver con cómo el modelo asigna los objetivos de entrenamiento a las predicciones, un proceso conocido como asignación de etiquetas. Este proceso se encarga de emparejar los objetos de referencia con las predicciones candidatas, a menudo denominadas anclas.
Estos emparejamientos determinan qué predicciones reciben supervisión y contribuyen a la pérdida. Ultralytics YOLO26 se basa en un método de asignación de etiquetas ya existente llamado aprendizaje de alineación de tareas (TAL), diseñado para alinear mejor la clasificación y la localización durante el entrenamiento.
Aunque TAL funciona bien con la mayoría de los objetos, el entrenamiento reveló una limitación importante. Durante el proceso de emparejamiento, los objetos muy pequeños podían descartarse por completo. En la práctica, los objetos de menos de unos 8 píxeles en una imagen de entrada de 640 píxeles a menudo no recibían ninguna asignación de anclas. Cuando esto ocurre, el modelo recibe poca o ninguna supervisión para esos objetos, lo que dificulta aprender a detectarlos de forma fiable.
Para abordar este problema, Ultralytics YOLO26 introduce la asignación de etiquetas consciente de objetivos pequeños (STAL). STAL modifica el proceso de asignación para garantizar que los objetos pequeños no se ignoren durante el entrenamiento. En concreto, durante la selección de candidatos amplía a 16 píxeles cualquier anchura o altura de caja inferior a 8 píxeles, mientras que sigue utilizando la caja original para la correspondencia y la regresión. Así se garantiza que incluso los objetos diminutos contribuyan de forma constante a la pérdida de entrenamiento.
Al reforzar la supervisión de los objetivos pequeños, STAL mejora la estabilidad del aprendizaje y el rendimiento de detección en situaciones donde abundan los objetos pequeños o lejanos. Esta mejora es especialmente importante en aplicaciones de YOLO26 diseñado primero para el edge, como las imágenes aéreas, la robótica y los sistemas del Internet de las cosas (IoT), donde los objetos suelen ser pequeños, lejanos o parcialmente visibles, y es fundamental detectarlos de forma fiable.
Ultralytics YOLO26 incorpora el optimizador MuSGD#
Para ofrecer un entrenamiento más estable y predecible, Ultralytics YOLO26 también incorpora un nuevo optimizador llamado MuSGD. Este optimizador está diseñado para mejorar la convergencia y la fiabilidad del entrenamiento en modelos de detección de extremo a extremo, especialmente cuando aumentan el tamaño del modelo y la complejidad del entrenamiento.
Para que una red neuronal aprenda y actualice sus pesos durante el entrenamiento, calculamos un error, también llamado pérdida. El modelo mide cuánto se equivocan sus predicciones mediante un valor de pérdida, calcula gradientes que indican cómo deben cambiar sus parámetros y, a continuación, actualiza esos parámetros para reducir el error. El descenso de gradiente estocástico (SGD) es un optimizador muy utilizado que realiza estas actualizaciones y permite que el entrenamiento sea eficiente y escalable.
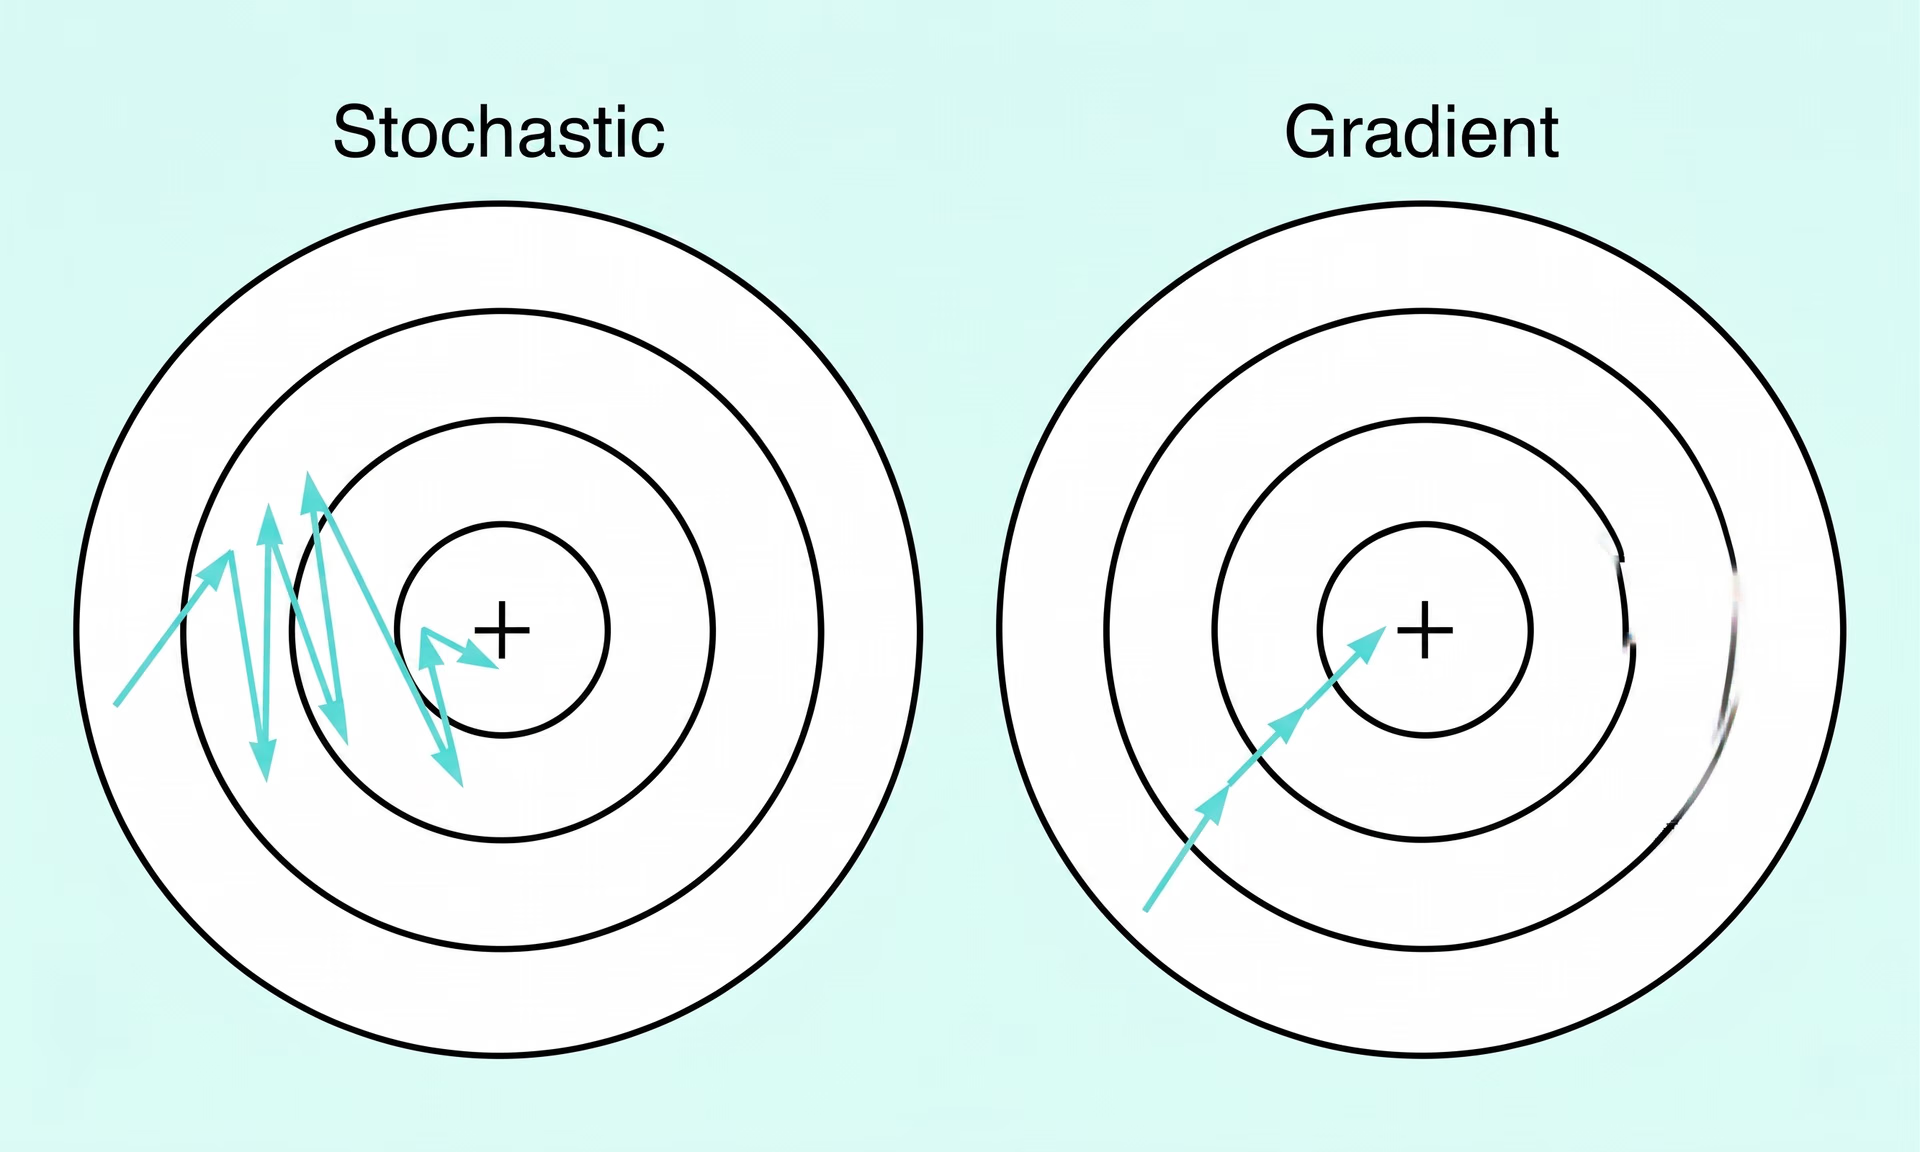
Fig. 3. Descenso de gradiente estocástico frente a descenso de gradiente (Fuente)
MuSGD parte de esta base conocida e incorpora ideas de optimización inspiradas en Muon, un método utilizado para entrenar modelos de lenguaje grandes. Estas ideas se han visto influidas por avances recientes como Kimi K2 de Moonshot AI, que demostró un comportamiento de entrenamiento mejorado mediante actualizaciones de parámetros más estructuradas.
Ultralytics YOLO26 utiliza una estrategia de actualización híbrida. Algunos parámetros se actualizan mediante una combinación de actualizaciones inspiradas en Muon y SGD, mientras que otros se actualizan únicamente con SGD. Esto permite que YOLO26 introduzca una estructura adicional en el proceso de optimización y mantenga, a la vez, la robustez y la capacidad de generalización que han hecho que SGD sea eficaz.
El resultado es una optimización más fluida, una convergencia más rápida y un comportamiento de entrenamiento más predecible en todos los tamaños de modelo, lo que convierte a MuSGD en un elemento clave para que Ultralytics YOLO26 sea más fácil de entrenar y más fiable a escala.
La importancia de las innovaciones de entrenamiento de Ultralytics YOLO26#
Las innovaciones de entrenamiento de Ultralytics YOLO26, junto con características clave como su diseño de extremo a extremo, sin NMS y pensado primero para el edge, hacen que el modelo sea más fácil de entrenar y más fiable a escala. Quizá te preguntes qué significa esto realmente para las aplicaciones de visión artificial.
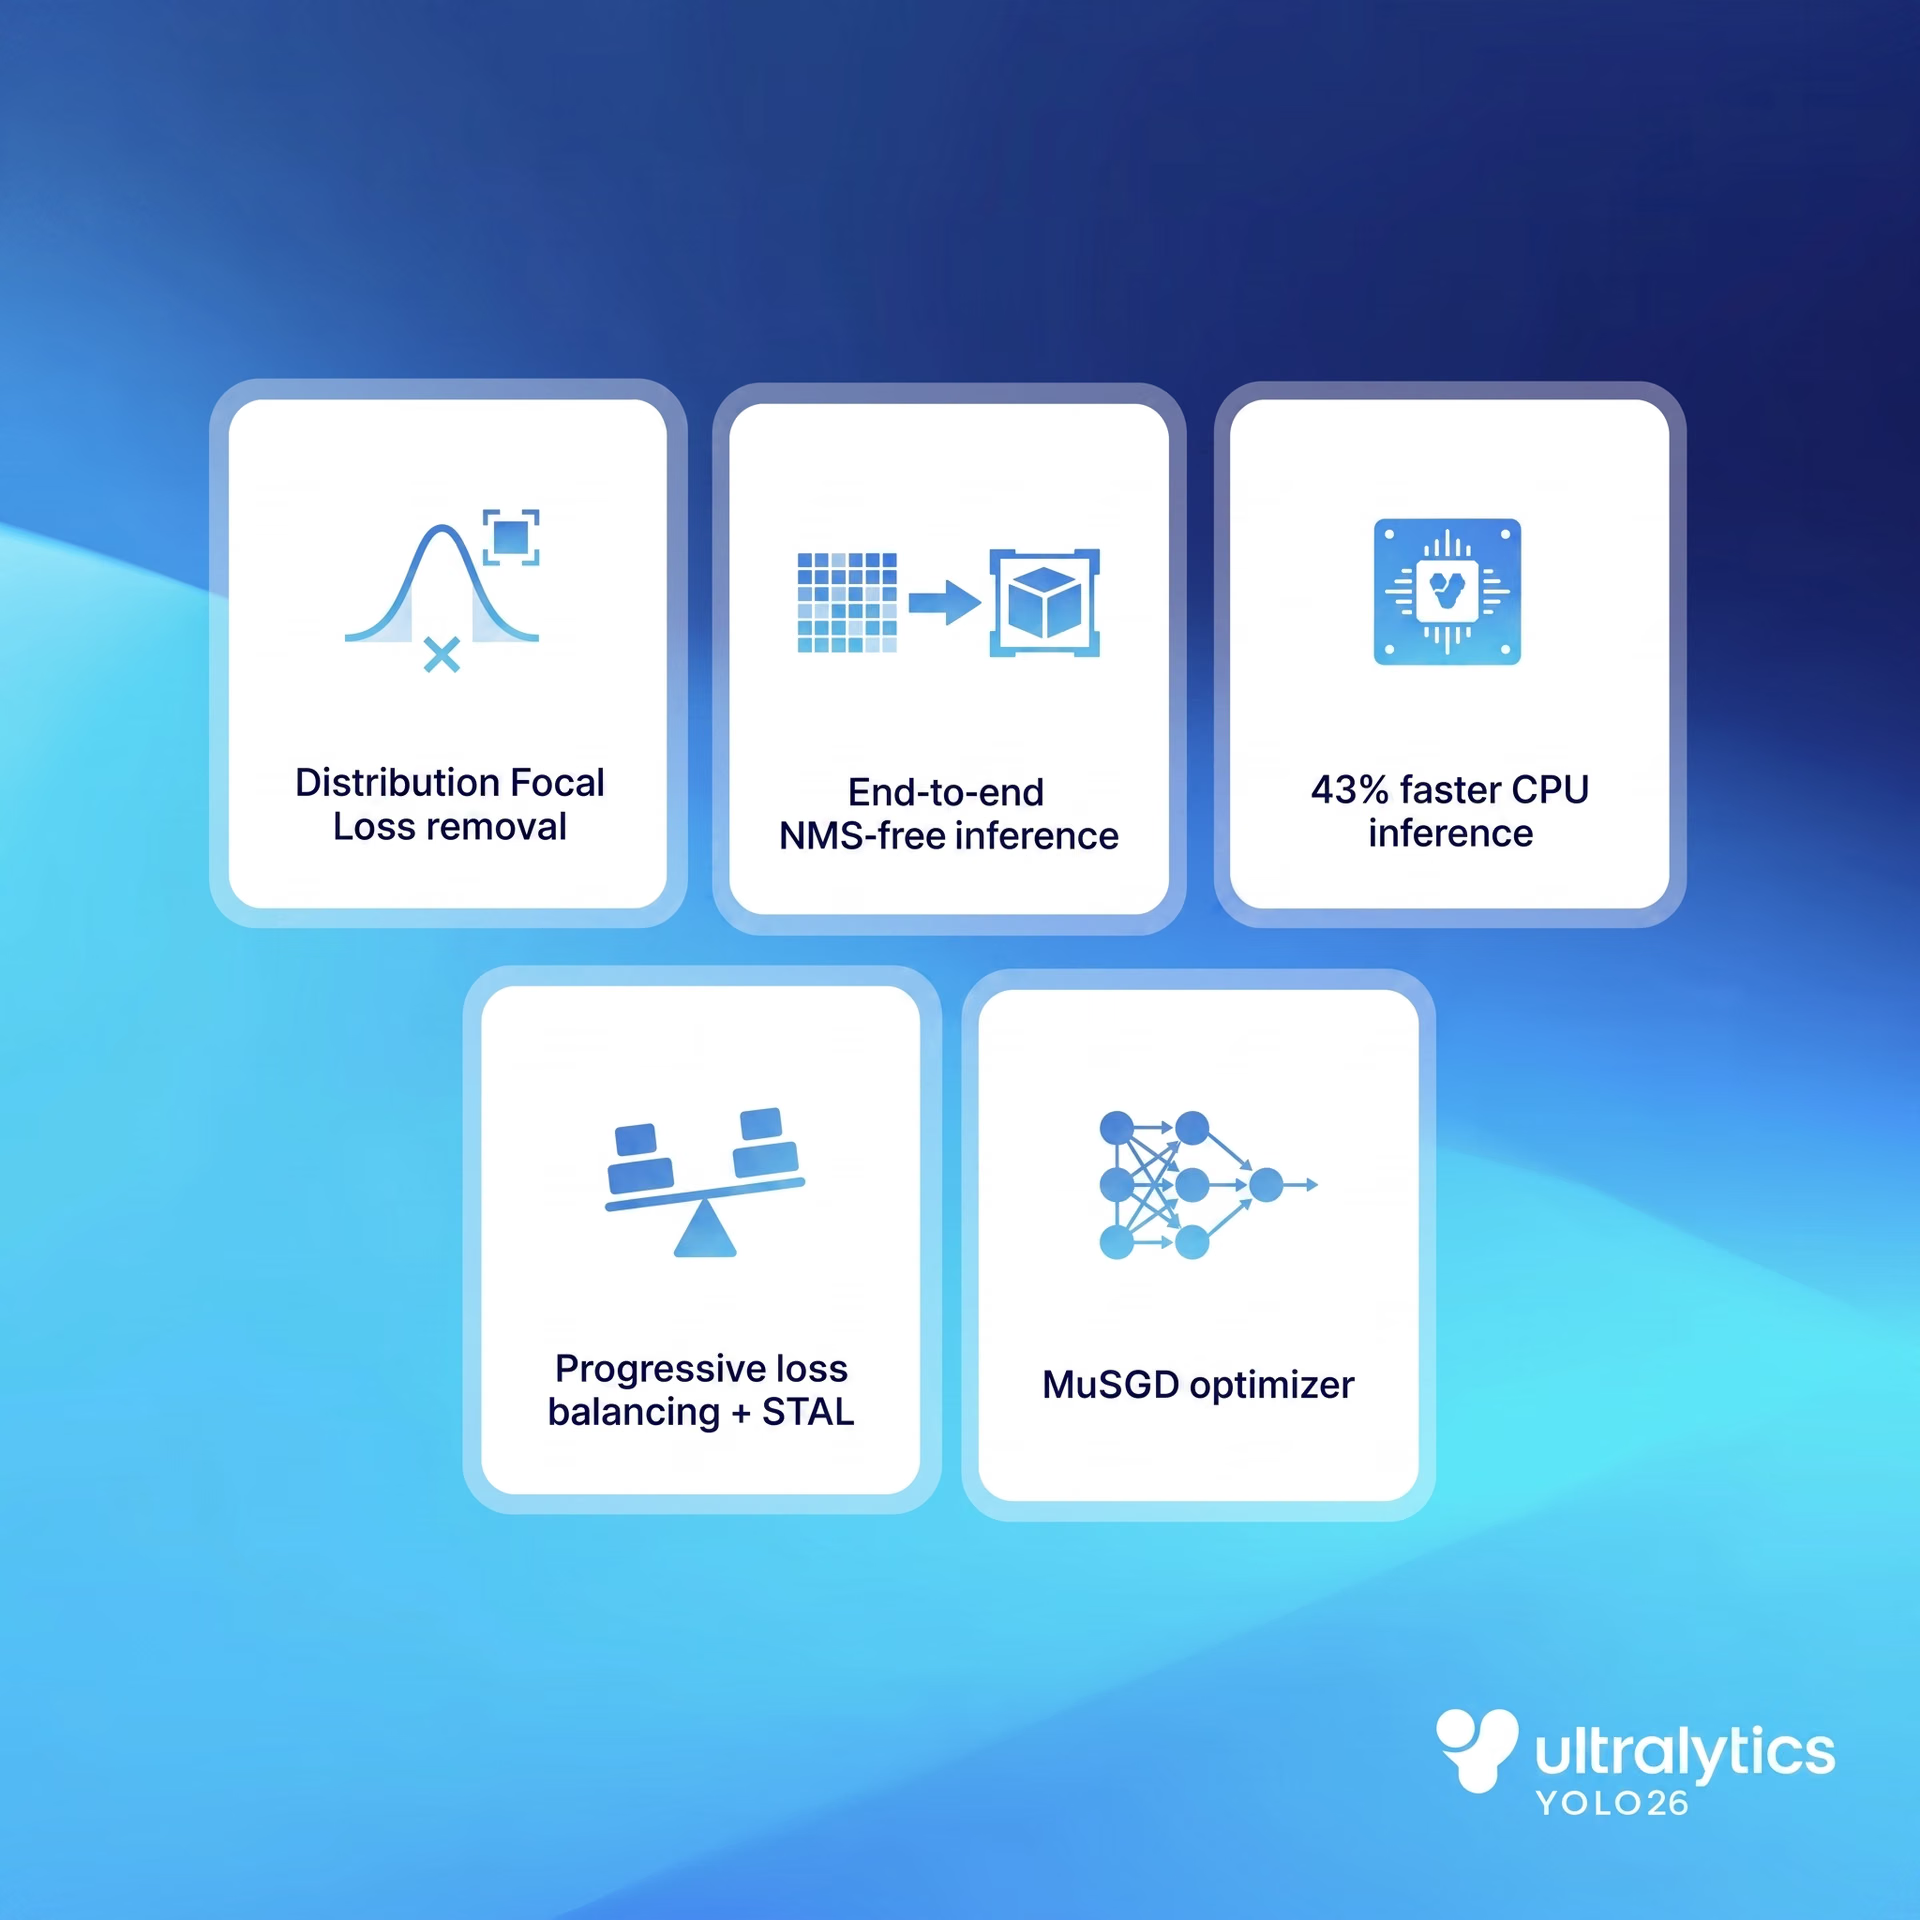
Fig. 4. Un repaso a las características clave de YOLO26 (Fuente)
En la práctica, facilita mucho llevar la visión artificial al lugar donde realmente se ejecuta. Los modelos se entrenan de forma más predecible, se escalan de manera más uniforme en distintos tamaños y son más fáciles de adaptar a nuevos conjuntos de datos. Esto reduce las dificultades entre la experimentación y el despliegue, sobre todo en entornos donde la fiabilidad y la eficiencia importan tanto como el rendimiento bruto.
Por ejemplo, en aplicaciones de robótica y visión industrial, a menudo es necesario volver a entrenar los modelos cuando cambian los entornos, los sensores o las tareas. Con Ultralytics YOLO26, los equipos pueden iterar más rápido sin preocuparse por entrenamientos inestables ni por un comportamiento desigual en distintos tamaños de modelo.
Conclusiones clave#
La fiabilidad de los sistemas de visión artificial depende tanto de cómo se entrenan los modelos como de su rendimiento durante la inferencia. Al mejorar el equilibrio de las señales de aprendizaje, el tratamiento de los objetos pequeños y el progreso de la optimización, Ultralytics YOLO26 hace que el entrenamiento sea más estable y fácil de escalar. La receta de entrenamiento de YOLO26 documenta los ajustes utilizados para los puntos de control oficiales. Este enfoque centrado en un entrenamiento fiable ayuda a los equipos a pasar con mayor facilidad de la experimentación al despliegue en el mundo real, especialmente en aplicaciones diseñadas prioritariamente para dispositivos perimetrales.
¿Quieres aprender sobre IA? Visita nuestro repositorio de GitHub para descubrir más. Únete a nuestra activa comunidad y descubre las innovaciones en sectores como la IA en logística y la IA de visión en la industria automovilística. Para empezar hoy mismo con la visión artificial, consulta nuestras opciones de licencia.
Escrito por
Creador de contenido · Ultralytics
Comentarios
Haz una pregunta, comparte tus resultados o ayuda a otra persona.









