Por qué Ultralytics YOLO26 elimina NMS y cómo cambia el despliegue
Descubre cómo Ultralytics YOLO26 permite realizar inferencias verdaderamente de extremo a extremo y sin NMS, y por qué eliminar el posprocesamiento simplifica la exportación y el despliegue en el edge.
 Abirami Vina12 min de lectura
El 14 de enero de 2026 lanzamos Ultralytics YOLO26, la última generación de nuestros modelos de visión artificial. Con YOLO26, nuestro objetivo no era solo mejorar la precisión o la velocidad, sino replantearnos cómo se crean y se implementan los modelos de detección de objetos en sistemas del mundo real.
A medida que la visión artificial pasa de la investigación a la producción, cada vez se espera más que los modelos se ejecuten en CPU, dispositivos periféricos, cámaras, robots y hardware integrado. En estos entornos, la fiabilidad, la baja latencia y la facilidad de despliegue importan tanto como el rendimiento.
Ultralytics YOLO26 se diseñó teniendo en cuenta esta realidad, con una arquitectura integral optimizada que elimina la complejidad innecesaria de la canalización de inferencia. Una de las innovaciones más importantes de YOLO26 es la opción de eliminar la supresión no máxima, conocida habitualmente como NMS.
Durante años, NMS ha sido una parte estándar de los sistemas de detección de objetos y se ha utilizado como paso de posprocesamiento para eliminar detecciones duplicadas. Aunque es eficaz, también añadía cálculos y dificultades de despliegue, especialmente en hardware periférico.
Con YOLO26, adoptamos un enfoque diferente. Al replantearnos cómo se generan y entrenan las predicciones, hacemos posible una inferencia verdaderamente integral y sin NMS. El modelo produce las detecciones finales directamente, sin depender de pasos externos de limpieza ni de reglas diseñadas a mano. Esto hace que YOLO26 sea más rápido, más fácil de exportar y más fiable de desplegar en una amplia variedad de plataformas de hardware.
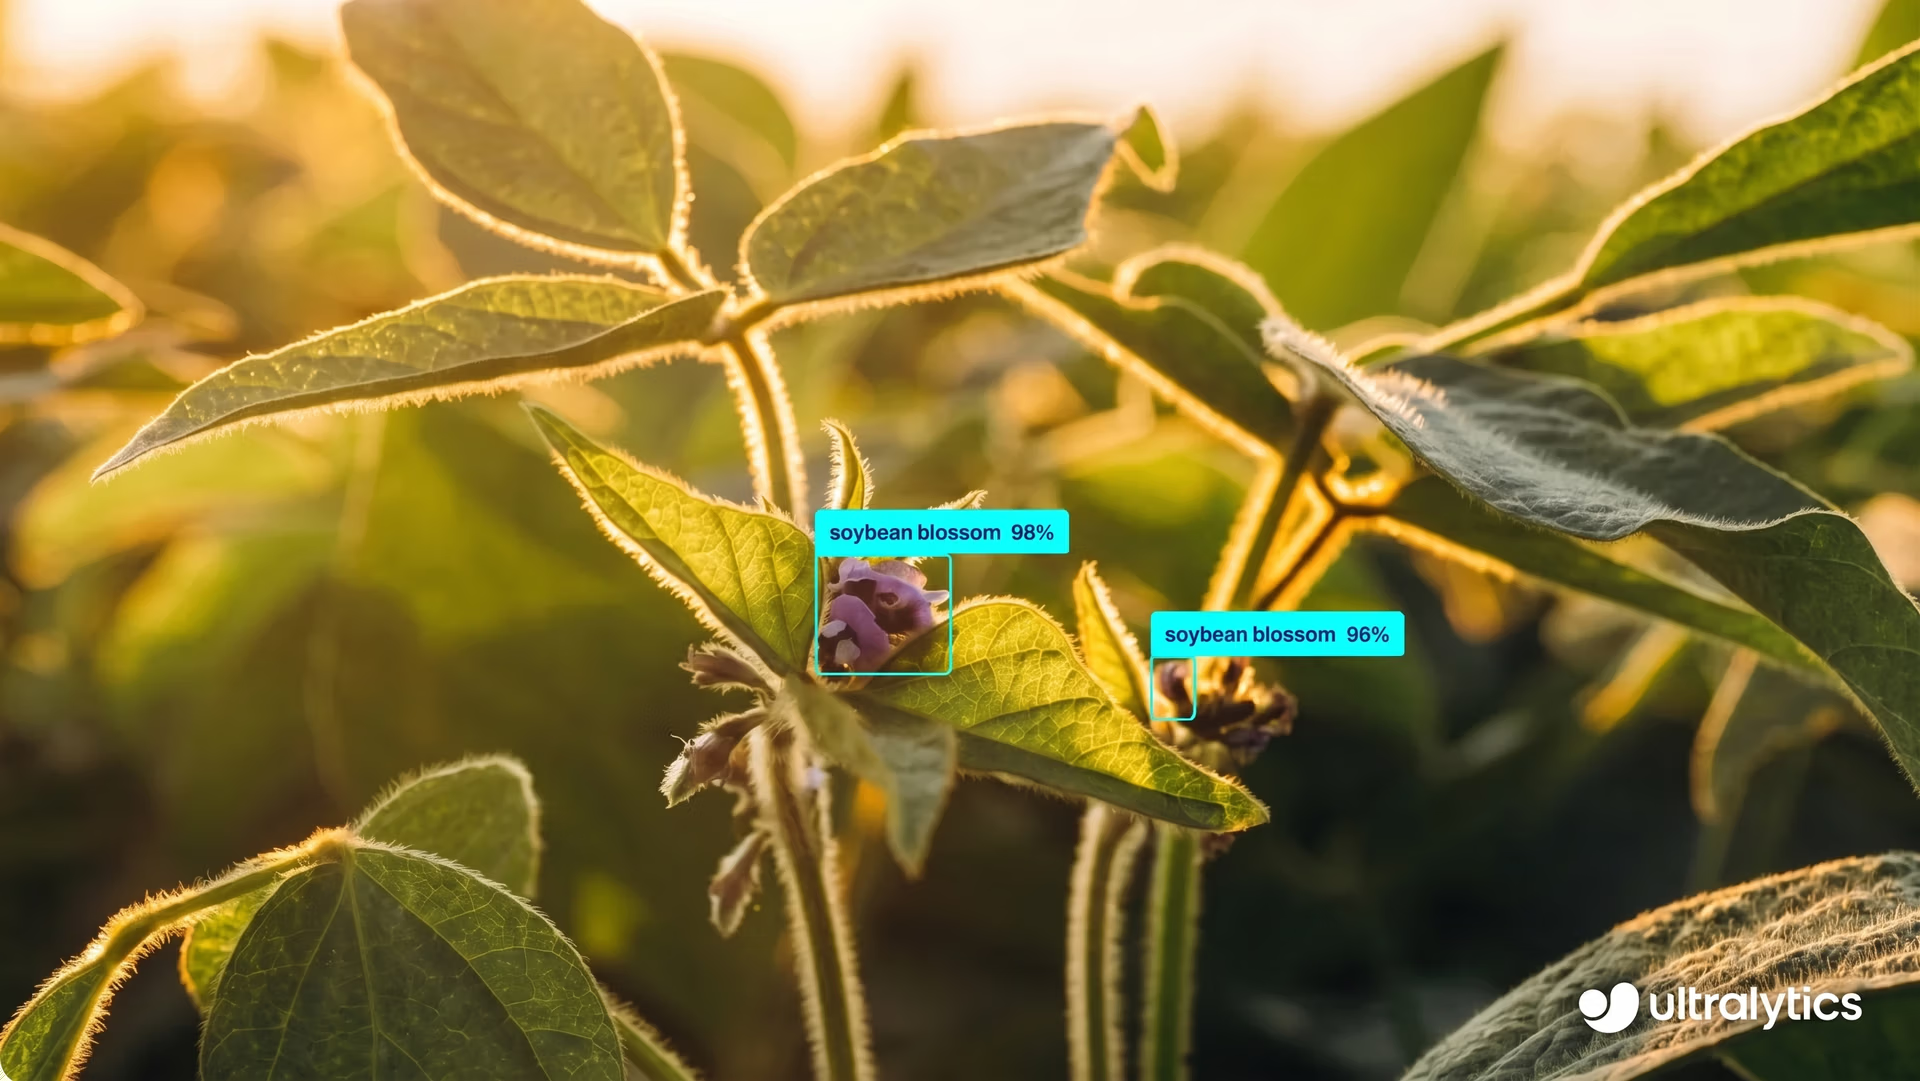
Fig. 1. Detección de objetos en una imagen con Ultralytics YOLO26.
En este artículo, veremos por qué la detección de objetos tradicional dependía de NMS, cómo se convirtió en un cuello de botella para la implementación y cómo Ultralytics YOLO26 elimina la necesidad de recurrir a soluciones alternativas.
La detección de objetos tradicional produce detecciones duplicadas#
Antes de profundizar en qué es NMS y por qué lo eliminamos en Ultralytics YOLO26, demos un paso atrás y veamos cómo generan sus predicciones los modelos tradicionales de detección de objetos.
Los modelos tradicionales de detección de objetos suelen producir varios cuadros delimitadores superpuestos para un mismo objeto. Cada cuadro tiene su propia puntuación de confianza, aunque todos se refieran al mismo objeto de la imagen.
Esto ocurre por varios motivos. En primer lugar, el modelo realiza predicciones simultáneamente en muchas ubicaciones espaciales y a distintas escalas. Esto le ayuda a detectar objetos de diferentes tamaños, pero también significa que varias ubicaciones cercanas pueden identificar por separado el mismo objeto.
En segundo lugar, muchos sistemas de detección de objetos utilizan métodos basados en anclajes, que generan un gran número de cuadros candidatos alrededor de cada ubicación. Aunque esto aumenta las posibilidades de encontrar objetos con precisión, también incrementa el número de predicciones superpuestas.
Por último, la propia detección basada en cuadrículas genera redundancia de forma natural. Cuando un objeto está cerca del límite de varias celdas de la cuadrícula, varias celdas pueden predecir un cuadro para ese objeto, lo que da lugar a varias detecciones superpuestas.
Por este motivo, la salida sin procesar del modelo suele contener varios cuadros para un único objeto. Para que los resultados sean útiles, hay que filtrar estas predicciones redundantes y dejar una sola detección final.
Cómo funciona la supresión de no máximos#
Cuando un modelo de detección de objetos produce varios cuadros delimitadores superpuestos para un mismo objeto, hay que depurar esos resultados antes de utilizarlos. Aquí es donde se aplica la supresión de no máximos.
La supresión de no máximos es un paso de posprocesamiento que se ejecuta después de que el modelo haya terminado de hacer sus predicciones. Su objetivo es reducir las detecciones duplicadas para que cada objeto quede representado por un único cuadro delimitador final.
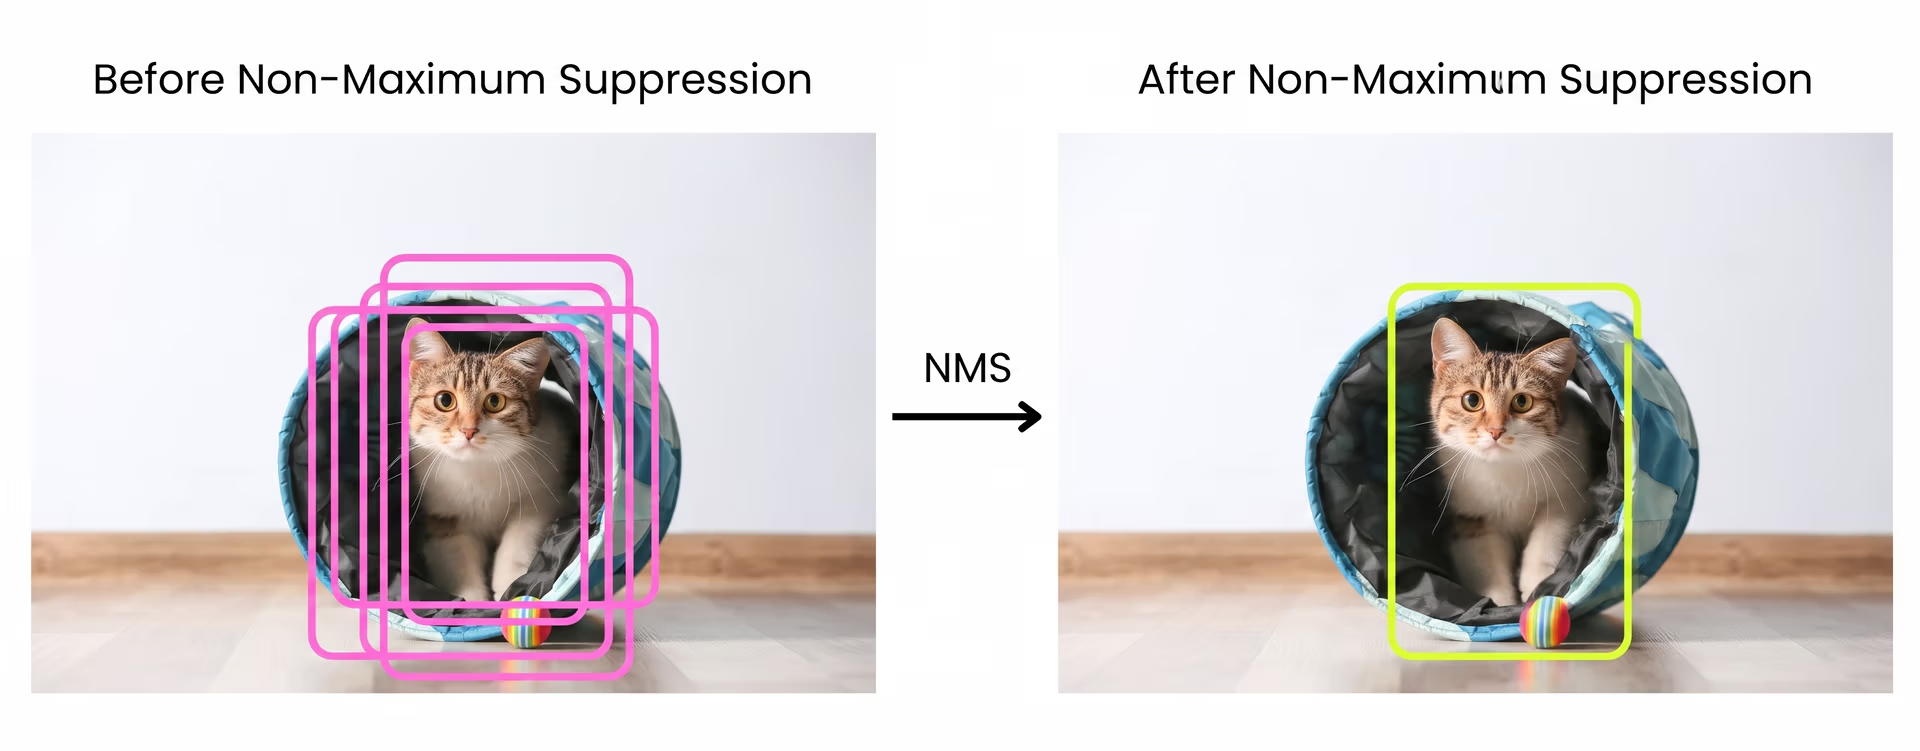
Fig. 2. Esquema general de NMS. Imagen del autor.
El proceso compara los cuadros delimitadores según sus puntuaciones de confianza y el grado de superposición. Primero se eliminan las predicciones con una confianza muy baja.
A continuación, los cuadros restantes se ordenan por confianza y se selecciona como mejor detección el cuadro con la puntuación más alta. Después, se compara ese cuadro seleccionado con los demás.
Si otro cuadro se superpone demasiado con él, se suprime y se elimina. La superposición suele medirse mediante la intersección sobre unión, una métrica que calcula la proporción entre el área compartida por dos cuadros y el área total cubierta por ambos. El proceso se repite hasta que solo quedan las detecciones con mayor confianza y sin superposición.
Por qué NMS complica el despliegue#
Aunque la supresión de no máximos ayuda a filtrar las detecciones duplicadas, también plantea dificultades que se hacen más evidentes cuando los modelos salen del entorno de investigación y se despliegan en el mundo real.
Uno de los mayores problemas es el rendimiento. NMS se ejecuta después de la inferencia y requiere comparar entre sí los cuadros delimitadores para decidir cuáles se conservan.
Este proceso requiere muchos cálculos y es difícil de paralelizar de forma eficiente. En dispositivos periféricos y sistemas basados en CPU, este trabajo adicional puede añadir una latencia apreciable y dificultar el cumplimiento de los requisitos de tiempo real.
NMS también aumenta la complejidad del despliegue. Como no forma parte del modelo, hay que implementarlo por separado mediante código de posprocesamiento.
Los distintos entornos de ejecución y plataformas gestionan NMS de maneras diferentes, lo que a menudo obliga a mantener implementaciones personalizadas para cada entorno de destino. Lo que funciona en una configuración puede comportarse de forma ligeramente distinta en otra, lo que hace que el despliegue sea más frágil y difícil de escalar.
La optimización del hardware es otro reto. NMS no se adapta bien a los aceleradores de IA especializados, diseñados para ejecutar operaciones de redes neuronales con eficiencia. Por eso, aunque el modelo se ejecute rápidamente en hardware optimizado, NMS puede convertirse en un cuello de botella que limite el rendimiento general.
Además de estos factores, NMS depende de parámetros elegidos manualmente, como los umbrales de confianza y de superposición. Estos ajustes pueden afectar considerablemente a los resultados y a menudo hay que afinarlos para diferentes conjuntos de datos, aplicaciones o equipos. Esto hace que el comportamiento sea menos predecible en los sistemas de producción y añade trabajo de configuración.
Explicación de la inferencia integral en la detección de objetos#
Las limitaciones de la supresión de no máximos nos llevaron a replantearnos cómo deberían comportarse los modelos de detección de objetos durante la inferencia. En lugar de generar muchas predicciones superpuestas y depurarlas después, nos planteamos una pregunta más fundamental.
¿Y si el modelo pudiera producir directamente las detecciones finales? Esta pregunta es fundamental para la inferencia integral en la detección de objetos. En un sistema integral, el modelo se entrena para gestionar todo el proceso de detección de principio a fin, sin depender de pasos externos de limpieza.
En lugar de producir muchos cuadros candidatos y filtrarlos después de la inferencia, el modelo aprende a generar por sí mismo un conjunto reducido de predicciones seguras y sin superposición. Las detecciones duplicadas se resuelven dentro de la red, en lugar de eliminarse durante el posprocesamiento.
Arquitecturas de modelos más recientes demostraron que este enfoque era posible y práctico. Con la estrategia de entrenamiento adecuada, los modelos podían aprender a asociar cada objeto con una única predicción en lugar de con muchas predicciones en competencia, lo que reduce la redundancia desde su origen.
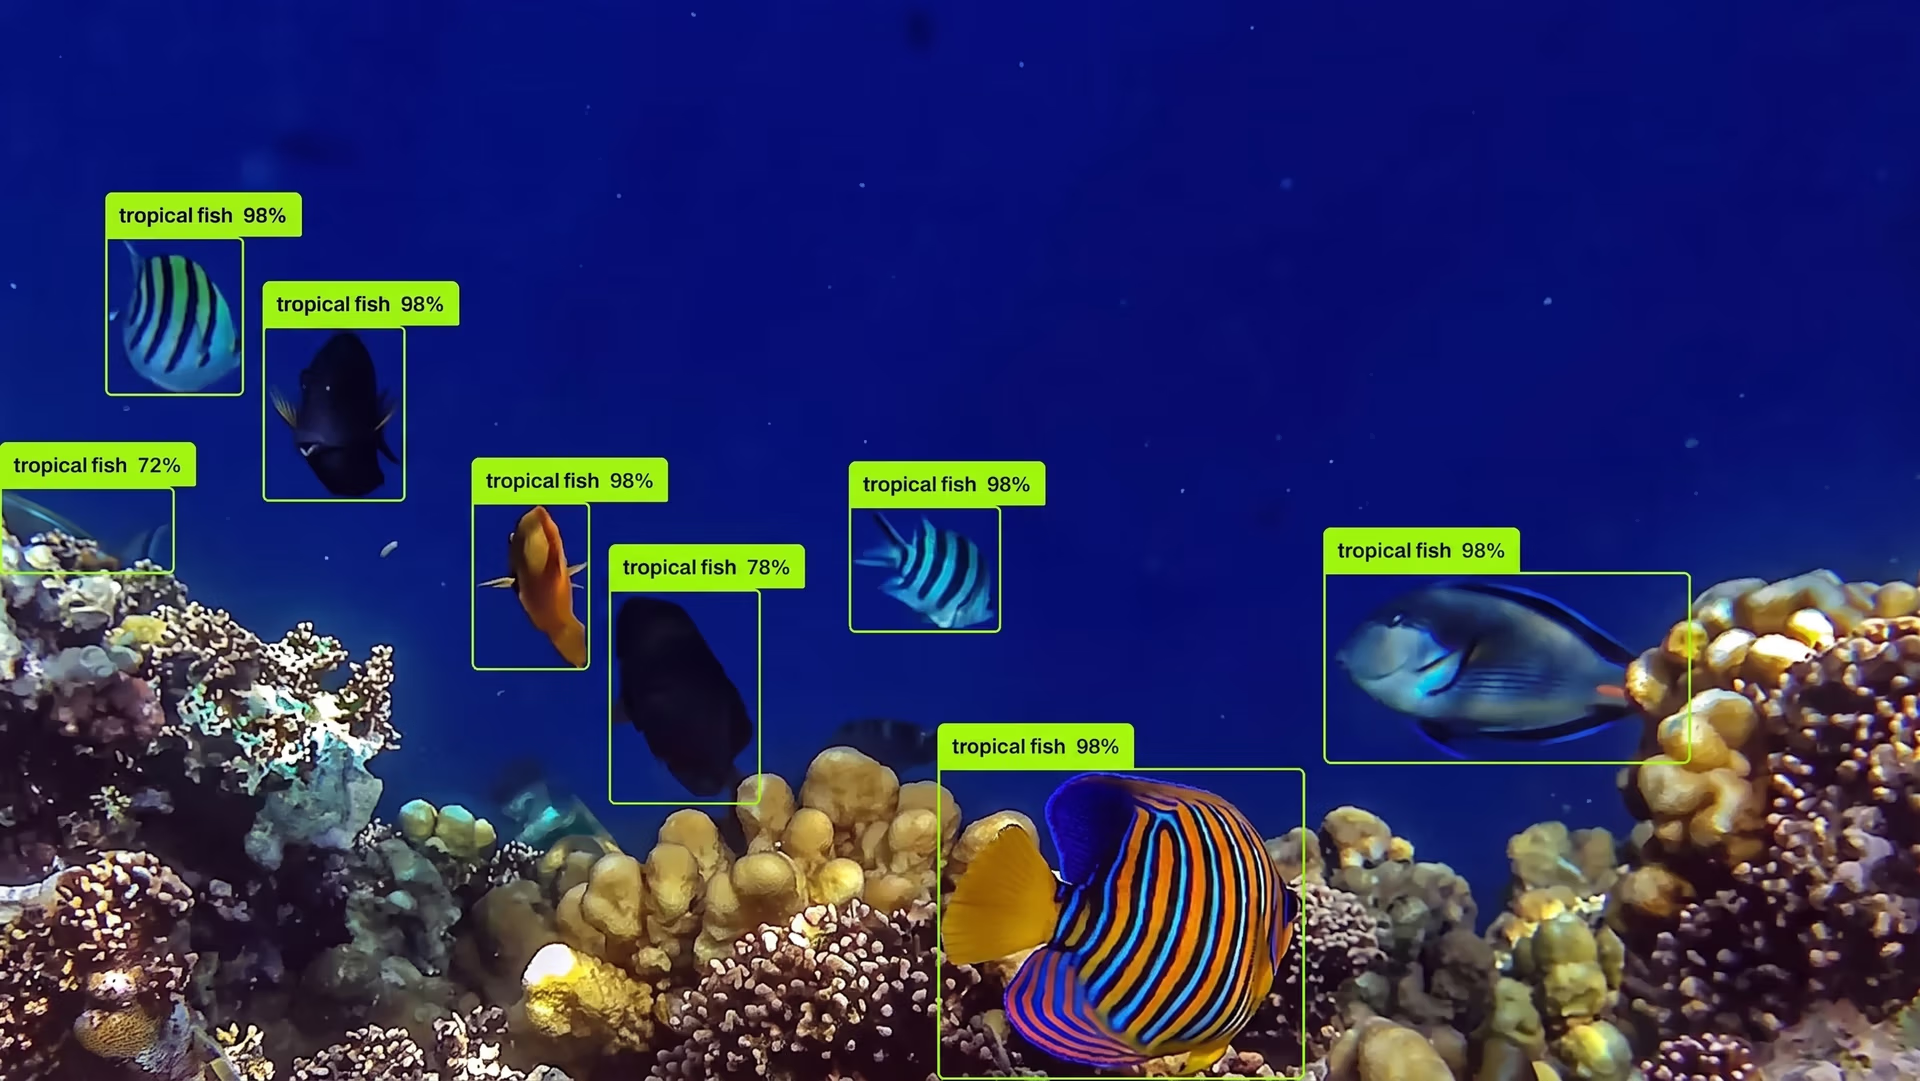
Fig. 3. Ejemplo de detección de objetos con Ultralytics YOLO26.
Para que esto funcione, también hay que cambiar el entrenamiento. En lugar de permitir que muchas predicciones compitan por el mismo objeto, el modelo aprende a tomar una decisión clara, lo que produce menos detecciones y con mayor confianza.
El resultado general es una canalización de inferencia más sencilla. Como las duplicaciones ya se resuelven internamente, no hace falta aplicar la supresión de no máximos durante la inferencia. La salida del modelo ya es el conjunto final de detecciones.
Este diseño integral también facilita el despliegue. Sin pasos de posprocesamiento ni implementaciones de NMS específicas para cada plataforma, el modelo exportado es totalmente autónomo y se comporta de forma coherente en distintos marcos de inferencia y plataformas de hardware.
Como explica nuestro ingeniero jefe de colaboraciones, Francesco Mattioli: «El verdadero aprendizaje integral significa que el modelo debe encargarse de todo, desde los píxeles hasta las predicciones, sin pasos de posprocesamiento diseñados a mano que rompan la diferenciabilidad y compliquen el despliegue».
Cómo elimina NMS Ultralytics YOLO26#
Ultralytics YOLO26 elimina la supresión de no máximos cambiando la forma en que aprende y produce las detecciones, en vez de depender del posprocesamiento para depurarlas. En lugar de permitir que muchas predicciones compitan por el mismo objeto, YOLO26 se entrena para aprender una relación clara de uno a uno entre los objetos y las salidas.
Esto se consigue en parte gracias a una cabeza de detección específica uno a uno, entrenada junto con una cabeza convencional de uno a muchos, que ayuda al modelo a centrarse en generar una única predicción fiable para cada objeto, en lugar de muchos candidatos superpuestos. Cada objeto se asocia a una predicción, lo que reduce de forma natural las detecciones duplicadas.
Este comportamiento se refuerza mediante estrategias de emparejamiento coherentes durante el entrenamiento, que animan al modelo a tomar una decisión segura por objeto en lugar de generar predicciones superpuestas. En definitiva, el modelo produce menos predicciones, pero cada una representa una detección final.
Por qué eliminar DFL hizo posible la detección sin NMS#
Otra innovación importante que permite la inferencia sin NMS en Ultralytics YOLO26 es la eliminación de la pérdida focal de distribución, o DFL. En modelos YOLO anteriores, DFL se utilizaba para mejorar la regresión de cuadros delimitadores prediciendo una distribución de posibles ubicaciones del cuadro, en lugar de un único valor.
Aunque este enfoque mejoraba la precisión de localización, también añadía complejidad a la canalización de detección. Esa complejidad se convirtió en una limitación al avanzar hacia una inferencia realmente integral.
DFL añadía cálculos y rangos de regresión fijos, lo que dificultaba que el modelo aprendiese asignaciones de objetos claras y uno a uno, y aumentaba la dependencia de pasos de posprocesamiento como la supresión de no máximos. En Ultralytics YOLO26, eliminamos DFL y rediseñamos la regresión de cuadros delimitadores para que fuera más sencilla y directa.
En lugar de depender de salidas basadas en distribuciones, el modelo aprende a predecir coordenadas precisas de los cuadros de forma que admite menos detecciones y con mayor confianza. Este cambio ayuda a reducir las predicciones superpuestas desde su origen y alinea la regresión de cuadros delimitadores con el diseño integral y sin NMS de Ultralytics YOLO26.
Ultralytics YOLO26 no necesita NMS y es fácil de desplegar#
Un diseño sin NMS convierte a Ultralytics YOLO26 en un modelo verdaderamente integral. Esto tiene un efecto importante en la exportación de modelos.
Exportar consiste en convertir un modelo entrenado a un formato que pueda ejecutarse fuera del entorno de entrenamiento, como ONNX, TensorRT, CoreML u OpenVINO. En las canalizaciones tradicionales, este proceso suele fallar porque la supresión de no máximos no forma parte del propio modelo.
Al eliminar NMS, Ultralytics YOLO26 evita por completo este problema. El modelo exportado ya incluye todo lo necesario para generar las detecciones finales. En las versiones actuales de Ultralytics, selecciona esta cabeza uno a uno sin NMS con nms=False al realizar predicciones, validar o exportar; la cabeza predeterminada de uno a muchos con NMS sigue disponible y ofrece una precisión ligeramente mayor. La guía de detección integral explica ambas opciones.
Esto hace que el modelo exportado sea totalmente autónomo y más portable entre marcos de inferencia y plataformas de hardware. El mismo modelo se comporta de forma coherente tanto si se despliega en servidores como en sistemas que solo usan CPU, dispositivos integrados o aceleradores periféricos. El despliegue es más sencillo porque lo que exportas es exactamente lo que ejecutas.
Esta sencillez es especialmente importante para las aplicaciones periféricas. Por ejemplo, YOLO26 se puede desplegar fácilmente en dispositivos como los drones para casos de uso como la supervisión de cultivos, la inspección de campos y el análisis de la salud de las plantas, donde las limitaciones de cálculo y consumo energético hacen inviables las complejas canalizaciones de posprocesamiento. Como el modelo genera directamente las detecciones finales, funciona de forma fiable en hardware ligero, sin pasos de procesamiento adicionales.
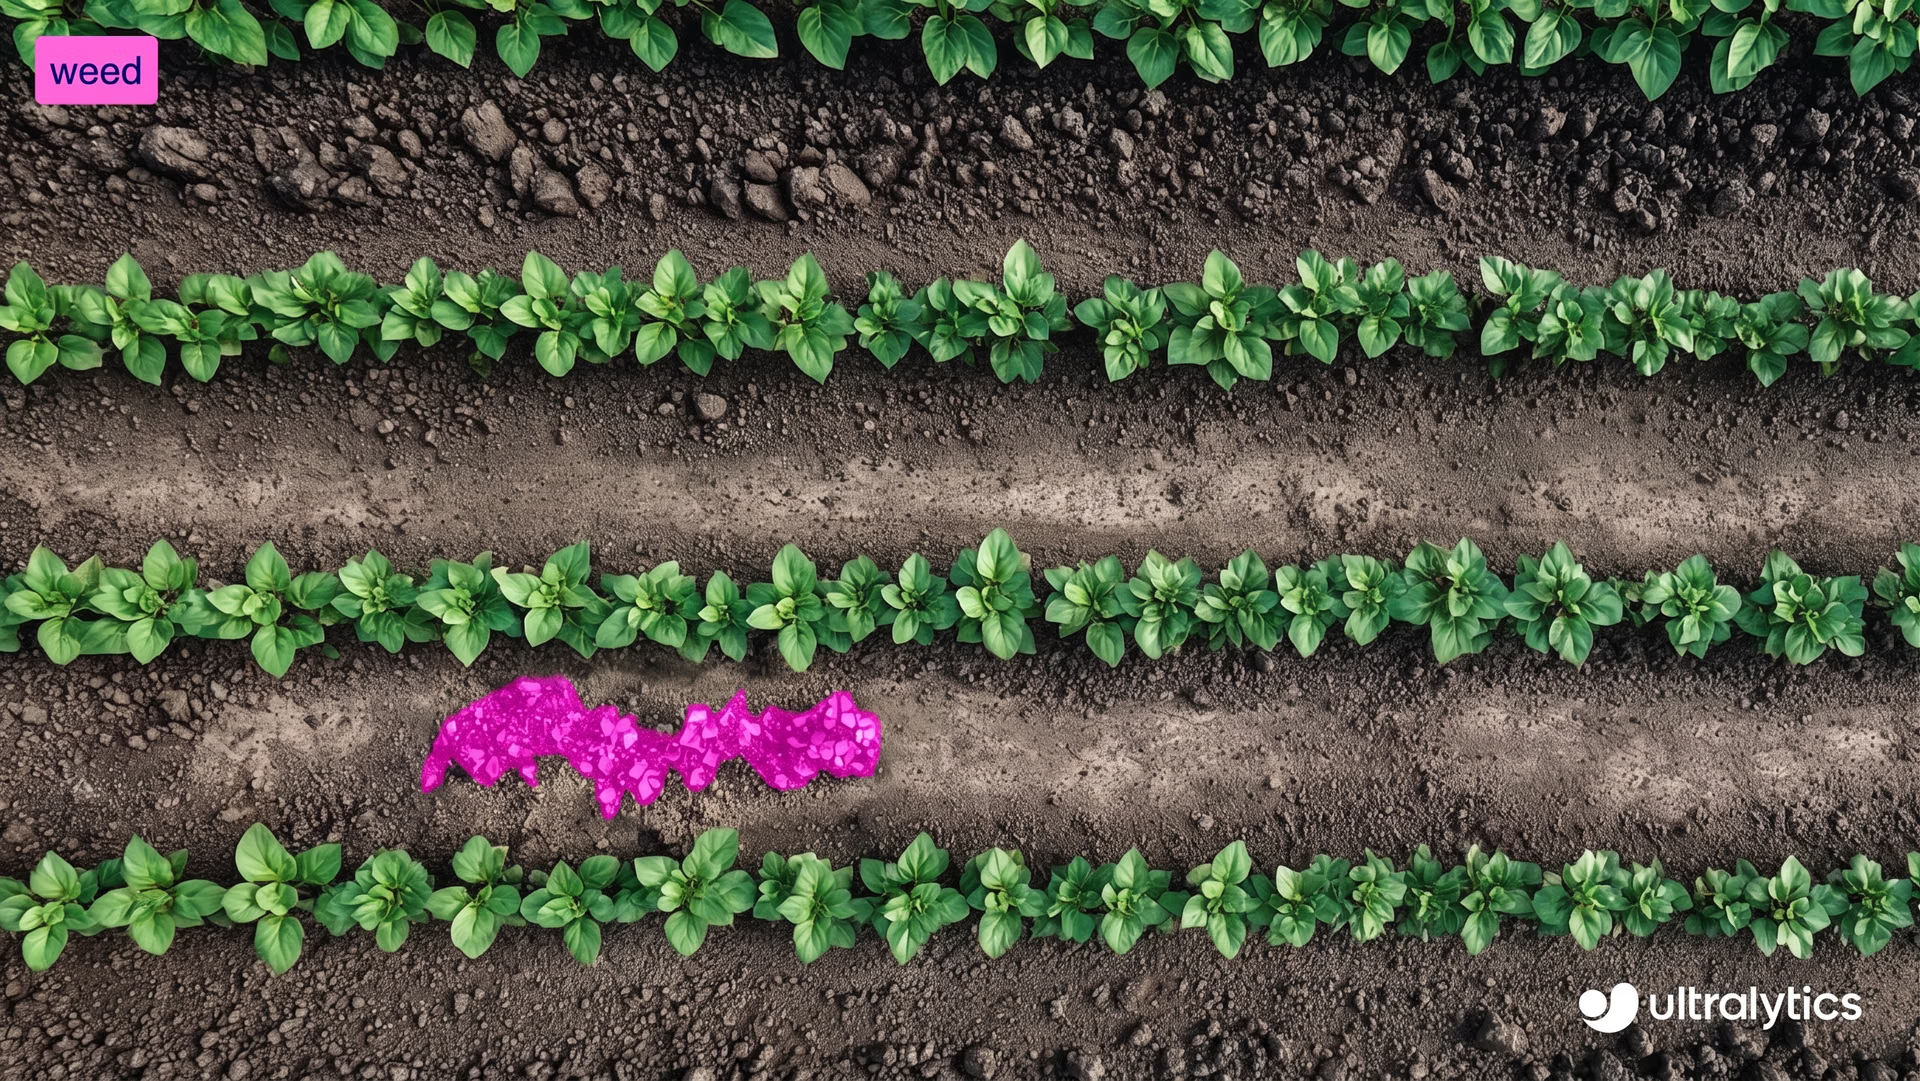
Fig. 4. Ultralytics YOLO26 se despliega fácilmente en dispositivos periféricos como los drones.
En resumen, la inferencia sin NMS simplifica la exportación y el despliegue y permite crear sistemas de visión más limpios y fiables. NMS era una solución provisional. Ultralytics YOLO26 ya no necesita soluciones provisionales.
Conclusiones clave#
Ultralytics YOLO26 puede prescindir de la supresión no máxima al resolver el problema de fondo de las detecciones duplicadas, en lugar de corregirlas a posteriori. Su diseño integral permite al modelo generar directamente las detecciones finales, lo que simplifica la exportación y el despliegue y aporta más coherencia en distintos tipos de hardware. NMS era una solución provisional útil para sistemas anteriores, pero YOLO26 ya no la necesita.
Únete a nuestra comunidad y echa un vistazo a nuestro repositorio de GitHub para aprender más sobre IA. Explora nuestras páginas de soluciones sobre la IA en la agricultura y la visión artificial en el comercio minorista. Descubre nuestras opciones de licencia y empieza hoy mismo con la IA para visión.
Escrito por
Creador de contenido · Ultralytics
Comentarios
Haz una pregunta, comparte tus resultados o ayuda a otra persona.









