Ultralytics Platform: distribuire modelli di computer vision in qualsiasi area geografica
Scopri come distribuire modelli di computer vision su endpoint dedicati in 42 regioni globali con Ultralytics Platform e monitoraggio integrato.
All'inizio di questa settimana, Ultralytics ha lanciato Ultralytics Platform, un nuovo ambiente end-to-end progettato per accelerare la distribuzione dei sistemi di visione artificiale (CV), semplificando ogni fase del flusso di lavoro dell'IA per la visione, dalla preparazione dei dati e lo sviluppo dei modelli fino alla distribuzione.
Uno dei motivi principali per cui è stata sviluppata Ultralytics Platform è che trasformare un'idea di visione artificiale in un impatto concreto richiede più della creazione di un modello efficace. Una volta addestrato e convalidato, un modello deve essere distribuito affinché le applicazioni possano inviare immagini, ricevere previsioni ed eseguire inferenze in modo affidabile in ambienti reali.
È in questa fase del ciclo di vita del machine learning che i modelli di visione artificiale vanno oltre la sperimentazione e iniziano ad alimentare sistemi pratici. Anche se le fasi precedenti, come la preparazione del set di dati, l'annotazione, l'addestramento del modello e i test, procedono senza intoppi, senza un metodo affidabile per distribuire i modelli, quei risultati non possono fare la differenza.
La realtà di molti progetti di visione artificiale è che la distribuzione può essere una delle fasi più complesse del flusso di lavoro.
Spesso i team devono configurare API di inferenza, gestire le risorse di calcolo, distribuire i modelli vicino agli utenti per ridurre la latenza e monitorare le prestazioni una volta che i sistemi sono in produzione.
Ultralytics Platform semplifica e automatizza questo processo offrendo diverse opzioni di distribuzione, tra cui formati di esportazione dei modelli, servizi di inferenza condivisi ed endpoint dedicati in regioni di tutto il mondo. Grazie all'infrastruttura gestita e al monitoraggio integrato, i team possono passare facilmente dai modelli addestrati ai sistemi di visione artificiale pronti per la produzione.
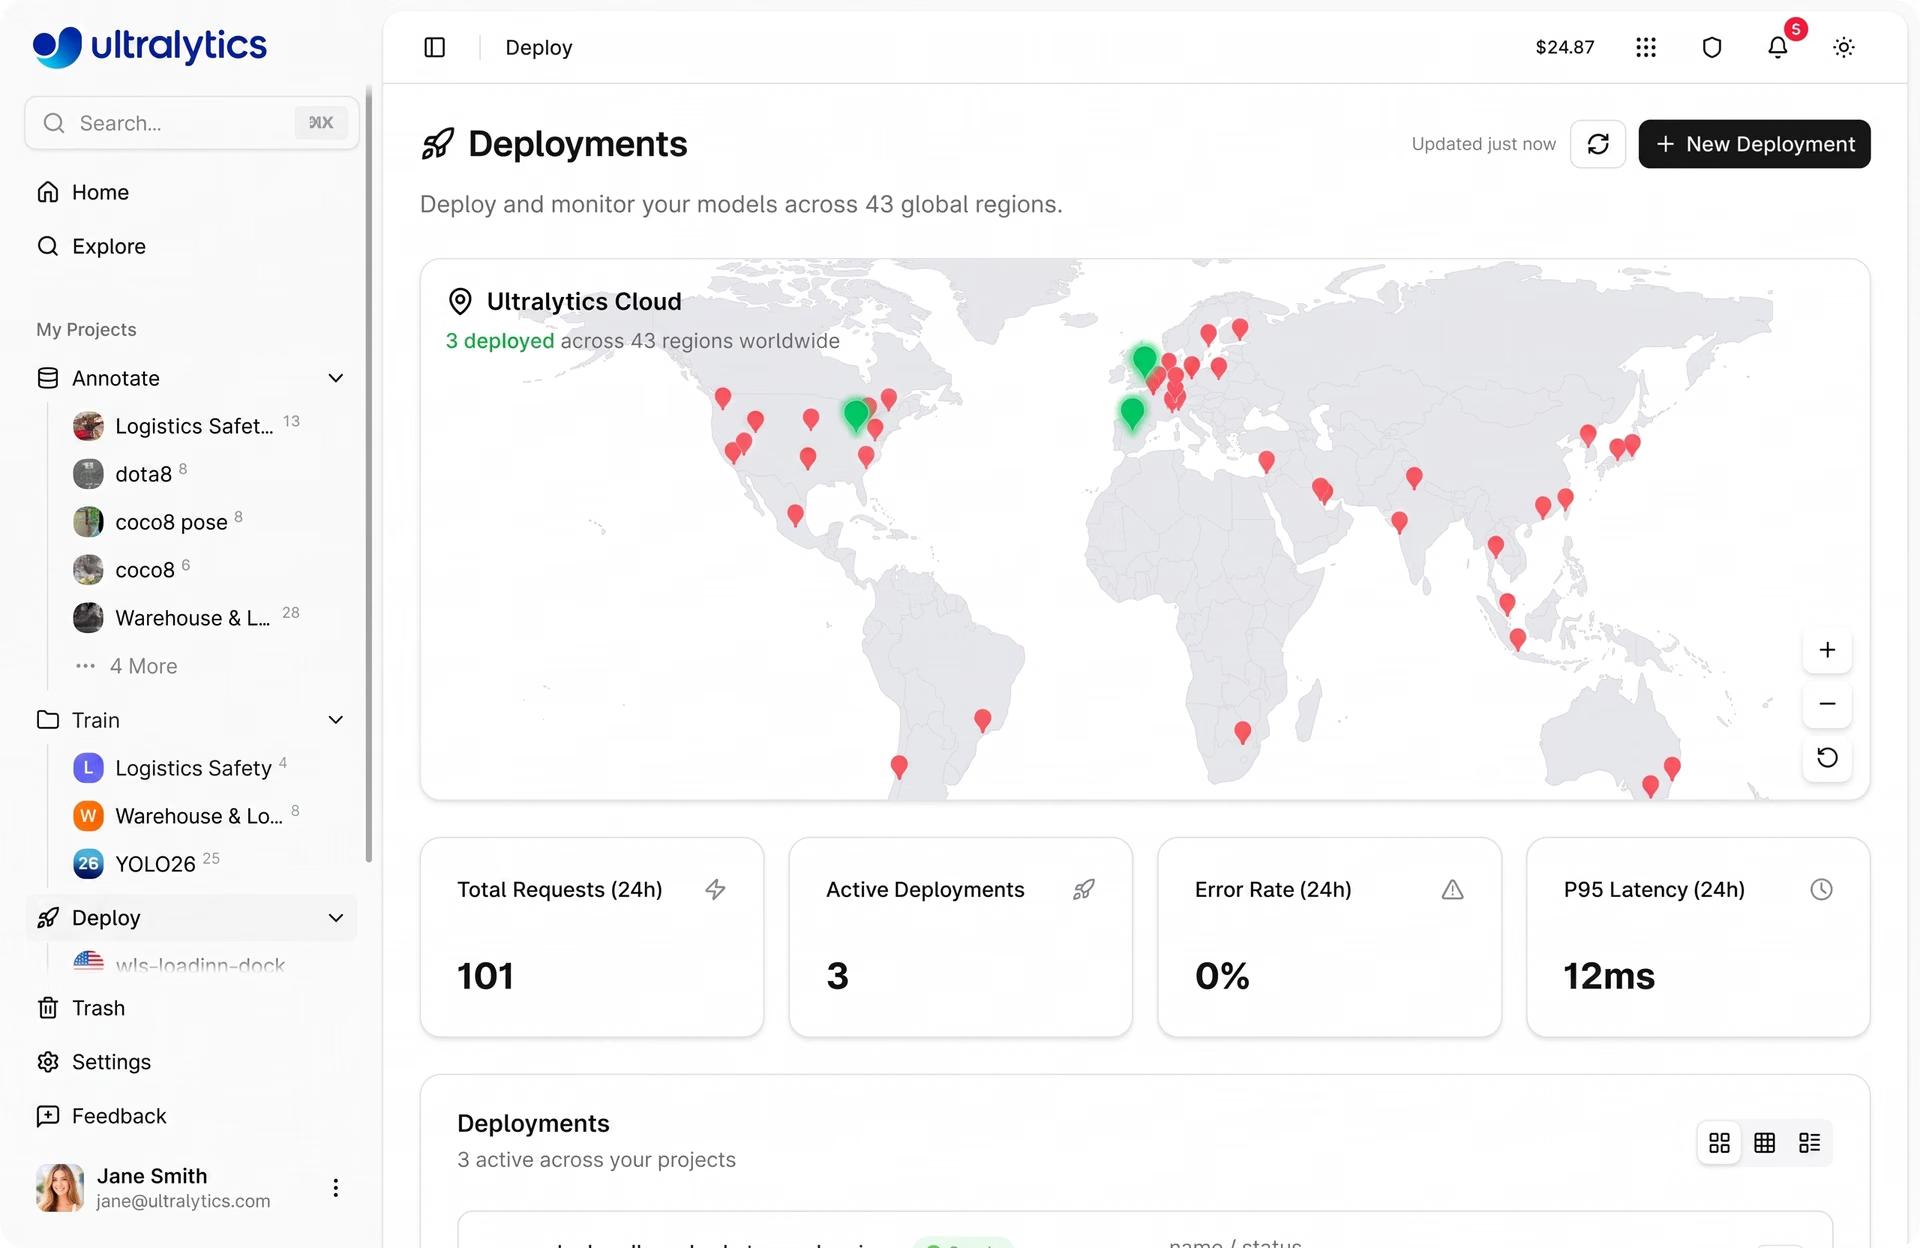
Fig. 1. Uno sguardo alla distribuzione dei modelli con Ultralytics Platform (Fonte)
In questo articolo vedremo come distribuire modelli di visione artificiale in qualsiasi area geografica usando gli endpoint dedicati di Ultralytics Platform.
Cos'è la distribuzione di modelli CV?#
Prima di approfondire come distribuire modelli di deep learning utilizzando Ultralytics Platform, cerchiamo di capire meglio cosa significa davvero distribuire un modello di visione artificiale.
La distribuzione di un modello di visione artificiale consiste nel rendere disponibile all'uso nel mondo reale un modello addestrato. Invece di essere eseguito solo in un ambiente di addestramento, il modello viene configurato in modo che le applicazioni possano inviargli immagini o video e ricevere previsioni in risposta.
Ad esempio, un modello potrebbe rilevare oggetti in un'immagine, eseguire la segmentazione delle immagini, identificare articoli in un magazzino o riconoscere schemi nelle riprese video. Nella maggior parte dei sistemi reali, tutto questo avviene tramite un'API o un endpoint di inferenza.
Un'applicazione invia un'immagine al modello, il modello la elabora e restituisce una previsione in pochi millisecondi. È così che i modelli di visione artificiale come Ultralytics YOLO consentono di realizzare applicazioni in tempo reale.
I modelli possono essere distribuiti in ambienti diversi a seconda del caso d'uso. Alcuni vengono eseguiti nel cloud (tramite piattaforme cloud) e possono essere utilizzati da molte applicazioni, mentre altri funzionano su dispositivi edge, come telecamere in sede, robot o sistemi embedded che necessitano di previsioni locali rapide.
Opzioni per la distribuzione di modelli di IA su Ultralytics Platform#
Ultralytics Platform affronta molte delle sfide che la community della visione artificiale incontra nella distribuzione dei modelli e offre metodi flessibili per eseguire inferenze in base alle esigenze della tua applicazione.
Ecco una rapida panoramica delle opzioni di distribuzione dei modelli disponibili sulla piattaforma:
- Esportazione dei modelli: puoi esportare i modelli in 22 formati diversi, tra cui ONNX, TensorRT, CoreML e TFLite, ed eseguirli in un'ampia gamma di ambienti, come dispositivi edge quali Raspberry Pi e NVIDIA Jetson, app per dispositivi mobili, container Docker e infrastrutture personalizzate.
- Inferenza condivisa: la piattaforma ti consente di eseguire previsioni tramite un servizio gestito di inferenza condivisa, ideale per testare rapidamente i modelli.
- Endpoint dedicati: distribuisci facilmente i modelli come servizi indipendenti con URL API univoci, eseguibili in 42 regioni globali, con ridimensionamento a zero, monitoraggio e controlli dello stato di salute per le distribuzioni in produzione.
Distribuzione tramite endpoint dedicati#
Uno dei metodi più scalabili per eseguire in produzione su Ultralytics Platform modelli preaddestrati o modelli di visione artificiale addestrati su misura consiste nell'utilizzare endpoint dedicati. Un endpoint dedicato consente di distribuire un modello addestrato come servizio autonomo, in modo che le applicazioni possano inviargli immagini e ricevere previsioni tramite un'API.
Invece di eseguire un modello solo in un ambiente di addestramento o in un notebook locale, distribuirlo come endpoint lo rende accessibile alle applicazioni reali. Ad esempio, un sistema di magazzino potrebbe inviare immagini di pacchi per rilevare gli oggetti, una telecamera intelligente potrebbe analizzare i fotogrammi video oppure un sistema robotico potrebbe utilizzare le previsioni per guidare le proprie azioni.
Ogni endpoint dedicato viene eseguito come servizio a tenant singolo, il che significa che l'infrastruttura su cui viene eseguito il tuo modello non è condivisa con altri utenti. Questo garantisce prestazioni più prevedibili e semplifica il monitoraggio del comportamento del modello in produzione.
Come funzionano gli endpoint di inferenza dedicati#
Puoi considerare un endpoint dedicato come un servizio ospitato per il tuo modello. Ultralytics Platform fornisce un URL univoco per l'endpoint, che funge da punto di accesso per le applicazioni.
Quando un'applicazione invia una richiesta a quell'URL, include un'immagine e parametri facoltativi, come le soglie di confidenza o le dimensioni dell'immagine, oltre a una chiave API per l'autenticazione.
Il servizio esegue l'inferenza sull'immagine utilizzando il tuo modello e restituisce le previsioni in una risposta strutturata. Questa configurazione consente agli sviluppatori di integrare modelli di visione artificiale in sistemi reali utilizzando strumenti web standard.
Le applicazioni possono inviare richieste utilizzando Python, JavaScript, cURL o altri client HTTP, così è facile collegare i modelli a dashboard, sistemi robotici o applicazioni cloud. Poiché l'endpoint viene eseguito in modo indipendente, può supportare anche scalabilità, monitoraggio e distribuzione globale, aiutando i team a creare sistemi di visione artificiale affidabili per la produzione.
La distribuzione in più regioni migliora l'inferenza in tempo reale#
Un vantaggio fondamentale degli endpoint dedicati su Ultralytics Platform è la possibilità di distribuire i modelli in 42 regioni globali. Queste regioni coprono diverse aree del mondo, tra cui Nord America, Sud America, Europa, Asia-Pacifico, Medio Oriente e Africa.
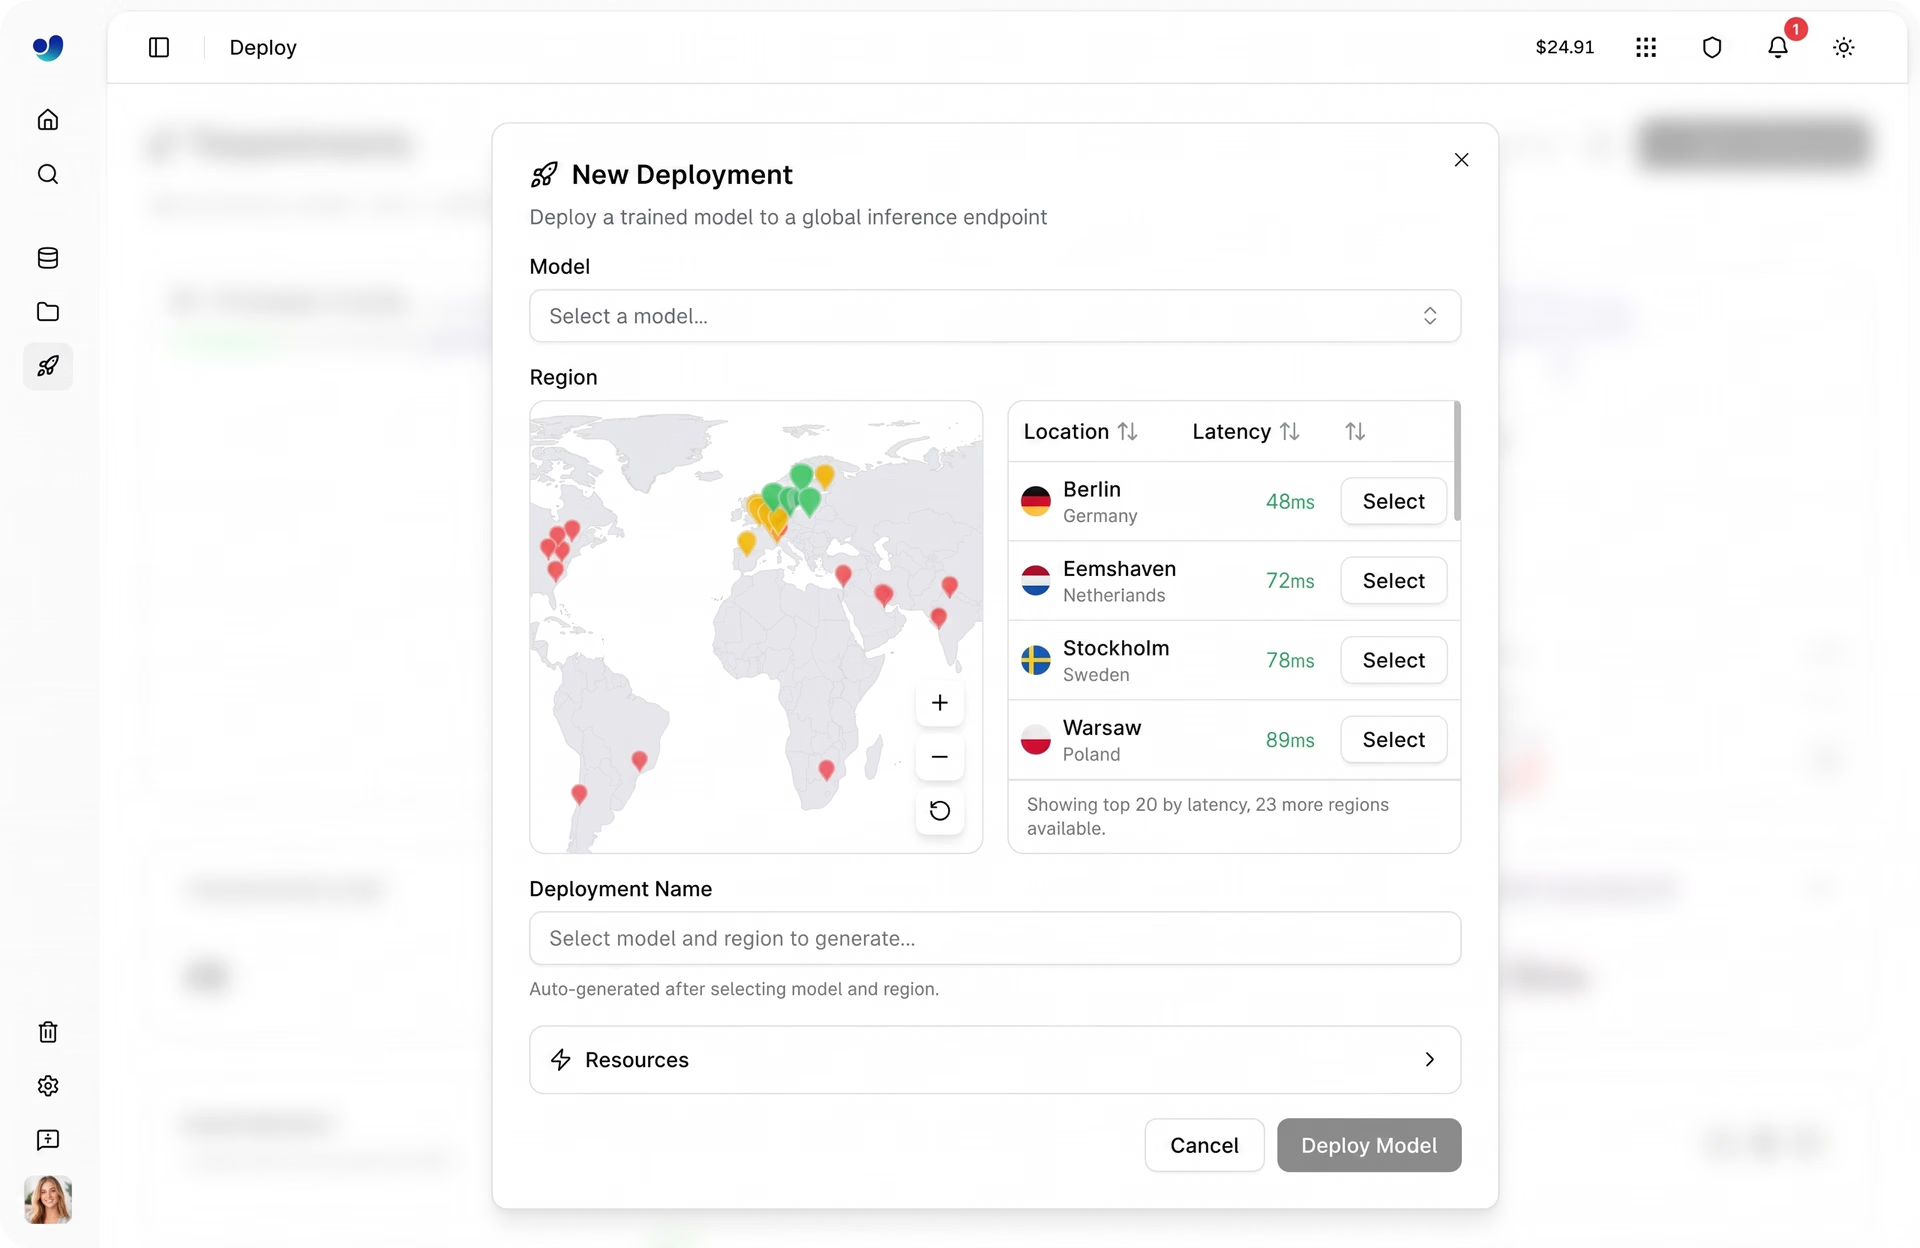
Fig. 2. Ultralytics Platform supporta 42 regioni globali (Fonte)
Distribuire i modelli in regioni vicine a quelle in cui operano le applicazioni aiuta a ridurre la latenza, cioè il tempo necessario a un'applicazione per inviare un'immagine e ricevere una previsione. Può anche aiutare le organizzazioni a soddisfare i requisiti di privacy e residenza dei dati, mantenendo il trattamento dei dati vicino al luogo in cui hanno origine.
La bassa latenza è importante per molte applicazioni di computer vision che si affidano all'inferenza in tempo reale, come i sistemi robotici, i dispositivi Internet of Things (IoT), le pipeline di ispezione industriale e le infrastrutture delle smart city.
Ad esempio, se un'applicazione viene usata principalmente in Europa, distribuire il modello in una regione europea può migliorare notevolmente i tempi di risposta rispetto all'esecuzione del modello in una regione lontana.
Come distribuire in qualsiasi regione con Ultralytics Platform#
Distribuire un modello in una regione specifica è semplice e richiede di solito solo un paio di minuti. La piattaforma gestisce la configurazione dell'infrastruttura, così gli sviluppatori possono concentrarsi sull'integrazione del modello nelle proprie applicazioni. Vediamo i passaggi da seguire.
Passaggio 1: addestra o carica un modello#
Prima di procedere alla distribuzione, devi avere un modello addestrato disponibile nel tuo progetto. Può trattarsi di un modello addestrato direttamente su Ultralytics Platform, di un modello caricato dopo essere stato addestrato altrove oppure di un modello clonato da un progetto della community trovato nella scheda «Esplora», dove puoi copiare con un solo clic nel tuo account i progetti pubblici condivisi da altri utenti.
Quando il modello è pronto, apri la relativa pagina nel tuo progetto per procedere.
Passaggio 2: apri la scheda Deploy#
Vai alla scheda Deploy del modello. Questa sezione della piattaforma ti consente di configurare e avviare le distribuzioni.
In questa pagina vedrai una tabella delle regioni e una mappa interattiva che mostra le località disponibili per la distribuzione in tutto il mondo. La piattaforma misura la latenza dalla tua posizione e ordina di conseguenza le regioni, aiutandoti a scegliere quella più adatta.
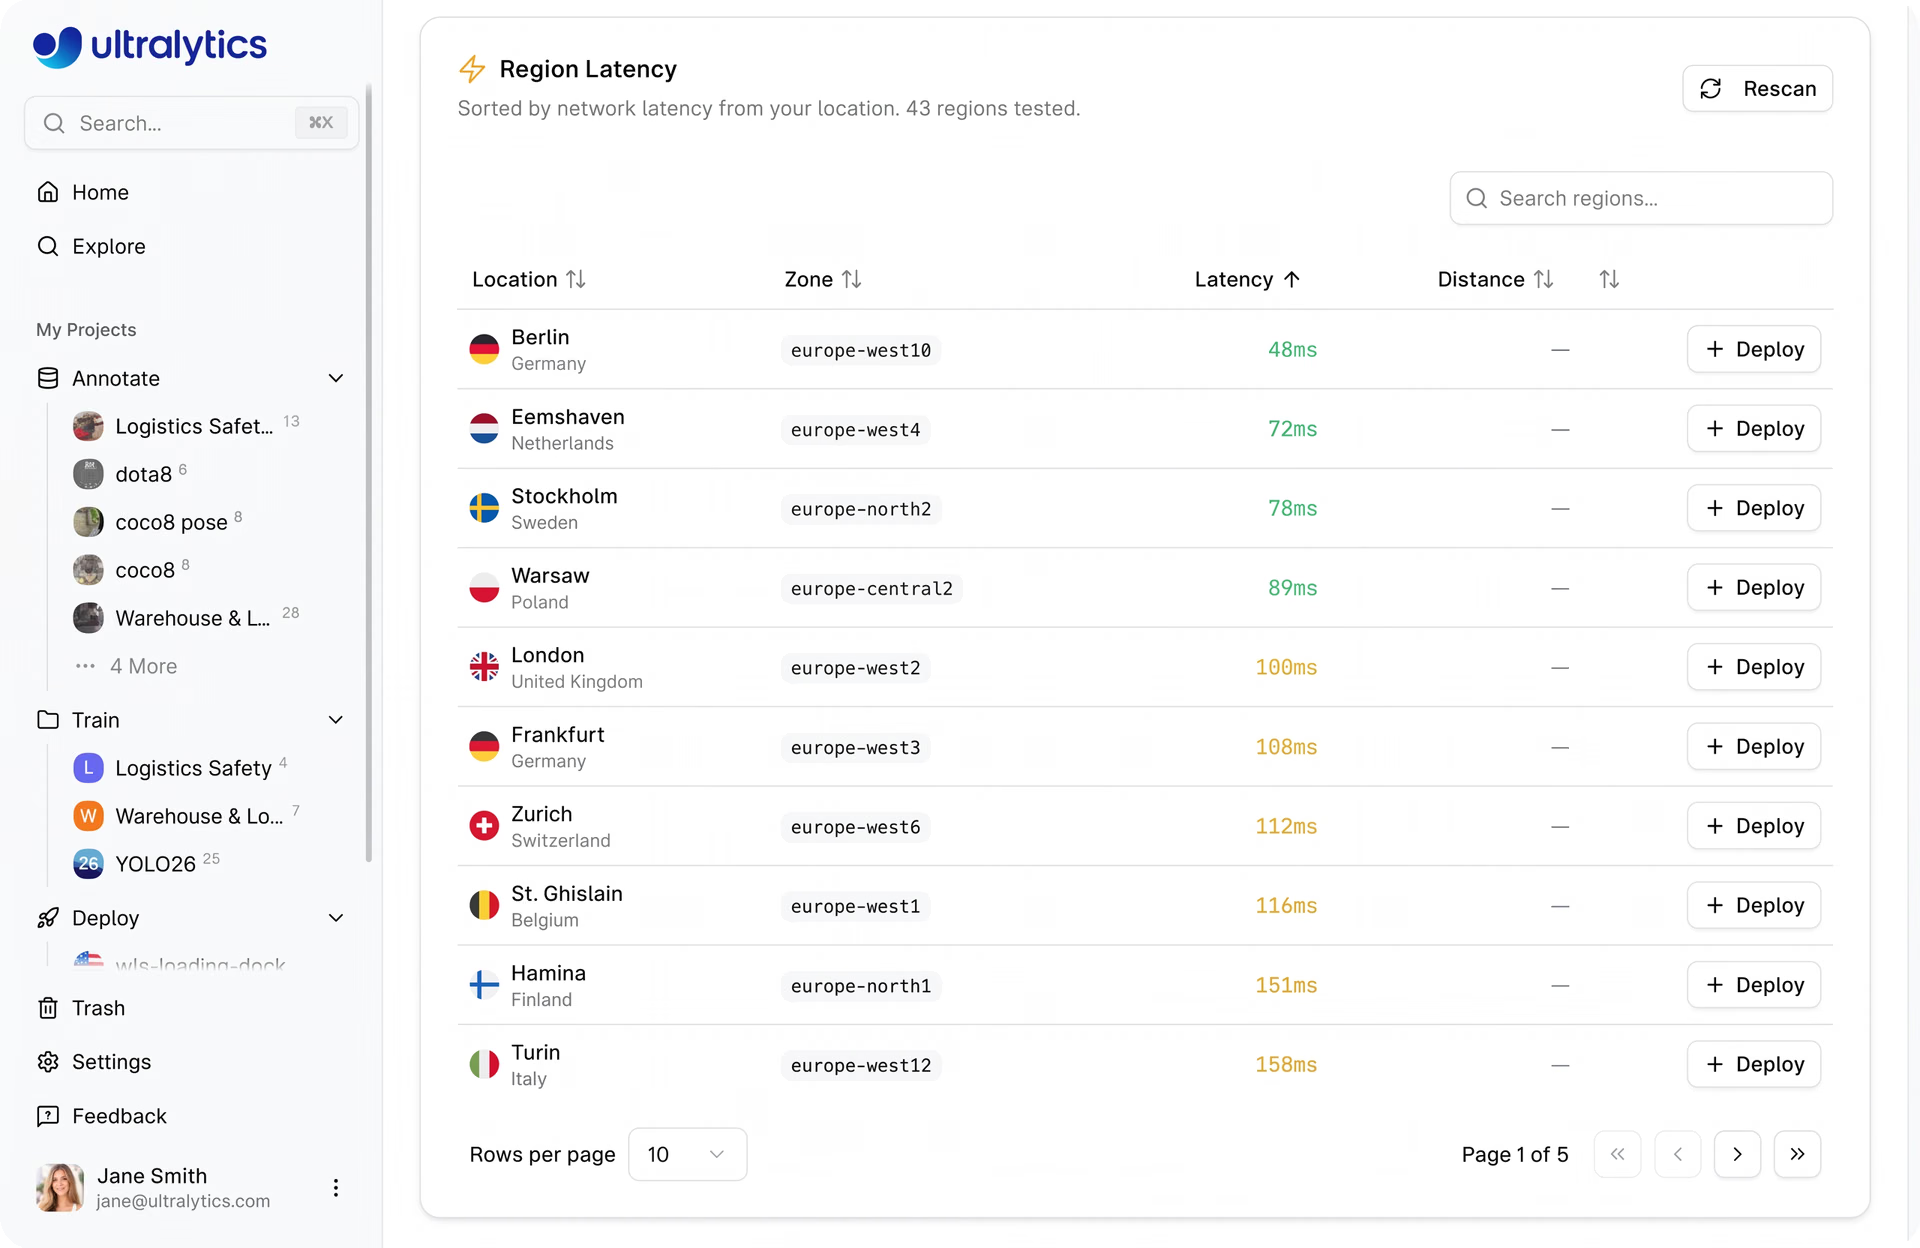
Fig. 3. Regioni ordinate per latenza su Ultralytics Platform (Fonte)
Passaggio 3: scegli una regione di distribuzione#
Seleziona una regione in base alla posizione dei tuoi utenti o delle tue applicazioni. Distribuire il modello più vicino alla provenienza delle richieste può ridurre notevolmente i tempi di risposta.
Passaggio 4: distribuisci l'endpoint#
Dopo aver selezionato la regione e confermato la configurazione, puoi fare clic su Deploy.
La piattaforma prepara quindi l'ambiente di distribuzione, recupera l'immagine del modello, avvia il servizio ed esegue un controllo dello stato per verificare che l'endpoint sia pronto. Il processo richiede in genere da uno a due minuti.
Al termine della distribuzione, la piattaforma genera un URL univoco per l'endpoint che le applicazioni possono usare per inviare richieste di inferenza.
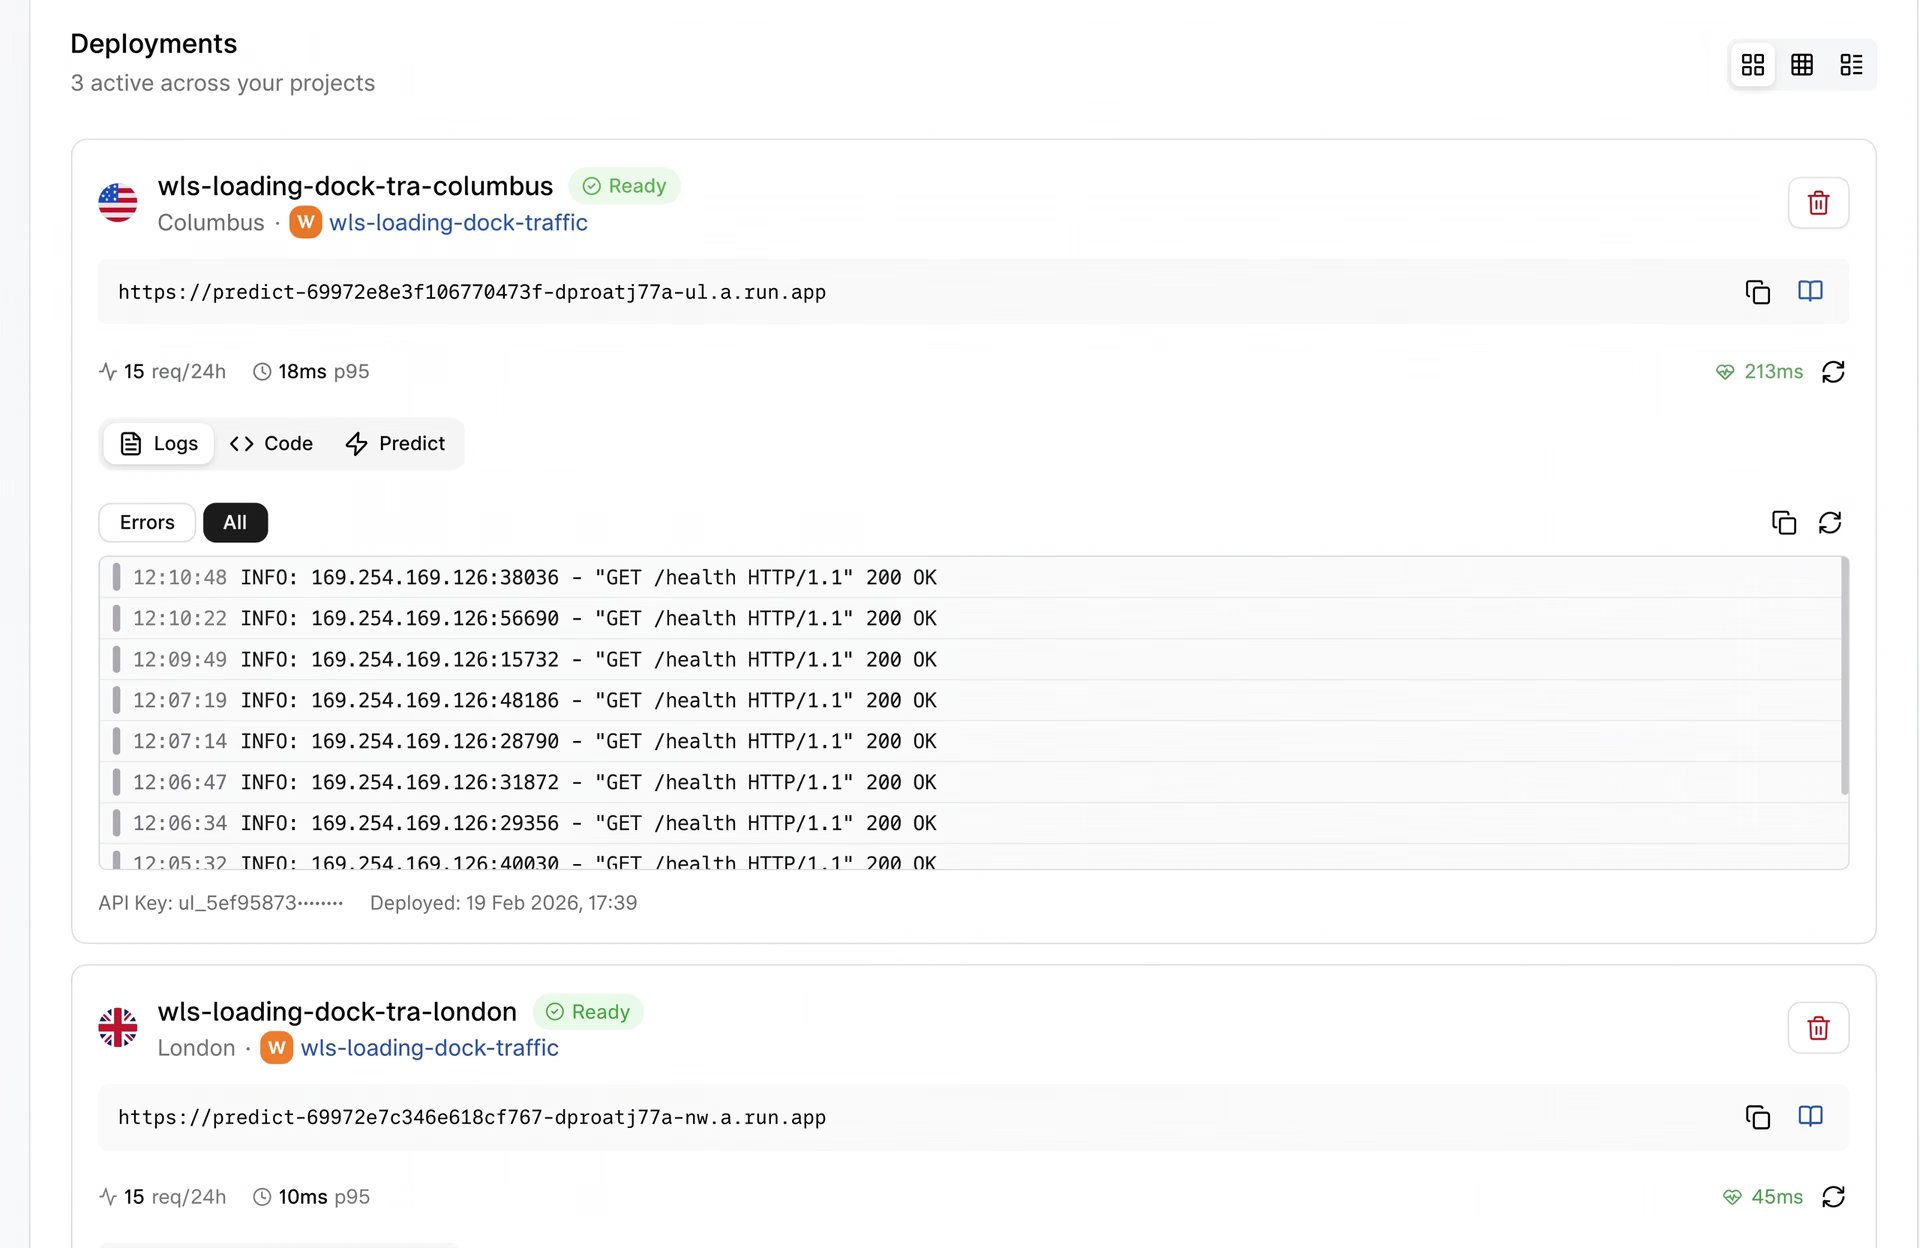
Fig. 4. Un esempio di endpoint distribuito (Fonte)
Passaggio 5: inizia a inviare richieste di inferenza#
Una volta attivo l'endpoint, le applicazioni possono iniziare a inviare immagini al modello usando l'endpoint REST API fornito e una chiave API inserita nell'intestazione Authorization. L'endpoint elabora ogni richiesta e restituisce previsioni, come oggetti rilevati, riquadri di delimitazione o altri output specifici dell'attività.
Per maggiori dettagli sulla distribuzione dei modelli, consulta la documentazione ufficiale di Ultralytics Platform.
Monitoraggio delle prestazioni e delle metriche dei modelli per gli endpoint distribuiti#
Una volta distribuito un modello di computer vision, monitorarne le prestazioni diventa essenziale per mantenere l'affidabilità e la robustezza del sistema. Anche un modello ben addestrato va osservato in produzione per verificare che continui a rispondere rapidamente, gestisca correttamente le richieste in arrivo e fornisca previsioni accurate.
Ultralytics Platform offre strumenti di monitoraggio integrati che consentono ai team di vedere come si comportano gli endpoint distribuiti. La pagina Deploy della piattaforma funge da dashboard di monitoraggio e offre una panoramica centralizzata di tutti gli endpoint attivi, insieme alle metriche chiave per tenere traccia dello stato e dell'utilizzo del sistema.
Ecco alcune metriche che puoi monitorare con la Platform:
- Latenza P95: questa metrica misura il tempo di risposta lato server al 95° percentile per le richieste di inferenza. Offre indicazioni sulla durata della maggior parte delle richieste di inferenza e individua i rallentamenti delle prestazioni.
- Tasso di errore: indica la percentuale di richieste non riuscite o che hanno restituito errori nell'intervallo di monitoraggio selezionato. Monitorare i tassi di errore consente ai team di rilevare rapidamente i problemi legati alle distribuzioni o alle richieste in arrivo.
- Richieste totali: questa metrica mostra il numero complessivo di richieste di inferenza elaborate dagli endpoint distribuiti nel periodo selezionato, ad esempio nelle ultime 24 ore. Aiuta i team a comprendere i livelli di traffico e la frequenza di utilizzo dei modelli.
Oltre a queste metriche, la piattaforma offre anche controlli dello stato degli endpoint e log delle distribuzioni. I controlli dello stato indicano se un endpoint risponde correttamente, mentre i log forniscono informazioni dettagliate sulle richieste recenti e sulle attività del sistema.
Punti chiave#
La distribuzione dei modelli di computer vision è un passaggio fondamentale per trasformare i modelli addestrati in sistemi che alimentano applicazioni del mondo reale. Con Ultralytics Platform, i team possono distribuire facilmente i modelli tramite endpoint dedicati in 42 regioni globali, eseguire inferenze in tempo reale tramite API e monitorare le prestazioni da un unico ambiente. Combinando opzioni di distribuzione flessibili, monitoraggio integrato e infrastruttura scalabile, la piattaforma aiuta gli sviluppatori a passare più rapidamente dai modelli di machine learning addestrati ad applicazioni di computer vision affidabili.
Entra a far parte della nostra community in continua crescita! Esplora il nostro repository GitHub per saperne di più sull'AI. Se vuoi sviluppare soluzioni di computer vision, scopri le nostre opzioni di licenza. Approfondisci i vantaggi della computer vision in ambito sanitario e scopri come l'AI nella logistica sta facendo la differenza!
Comments
Ask a question, share your results, or help someone else.









