Come esportare modelli Ultralytics YOLO con Ultralytics Platform
Esporta facilmente modelli di IA per la visione con Ultralytics Platform. Scopri come preparare i modelli in pochi clic per la distribuzione su edge, dispositivi mobili e cloud.
Il mese scorso abbiamo lanciato Ultralytics Platform, uno spazio di lavoro unificato progettato per semplificare l'intero flusso di lavoro della computer vision. Riunisce in un'unica interfaccia snella le principali funzionalità dell'IA visiva, tra cui la gestione dei dataset, l'annotazione, l'addestramento dei modelli, i test, la distribuzione e il monitoraggio.
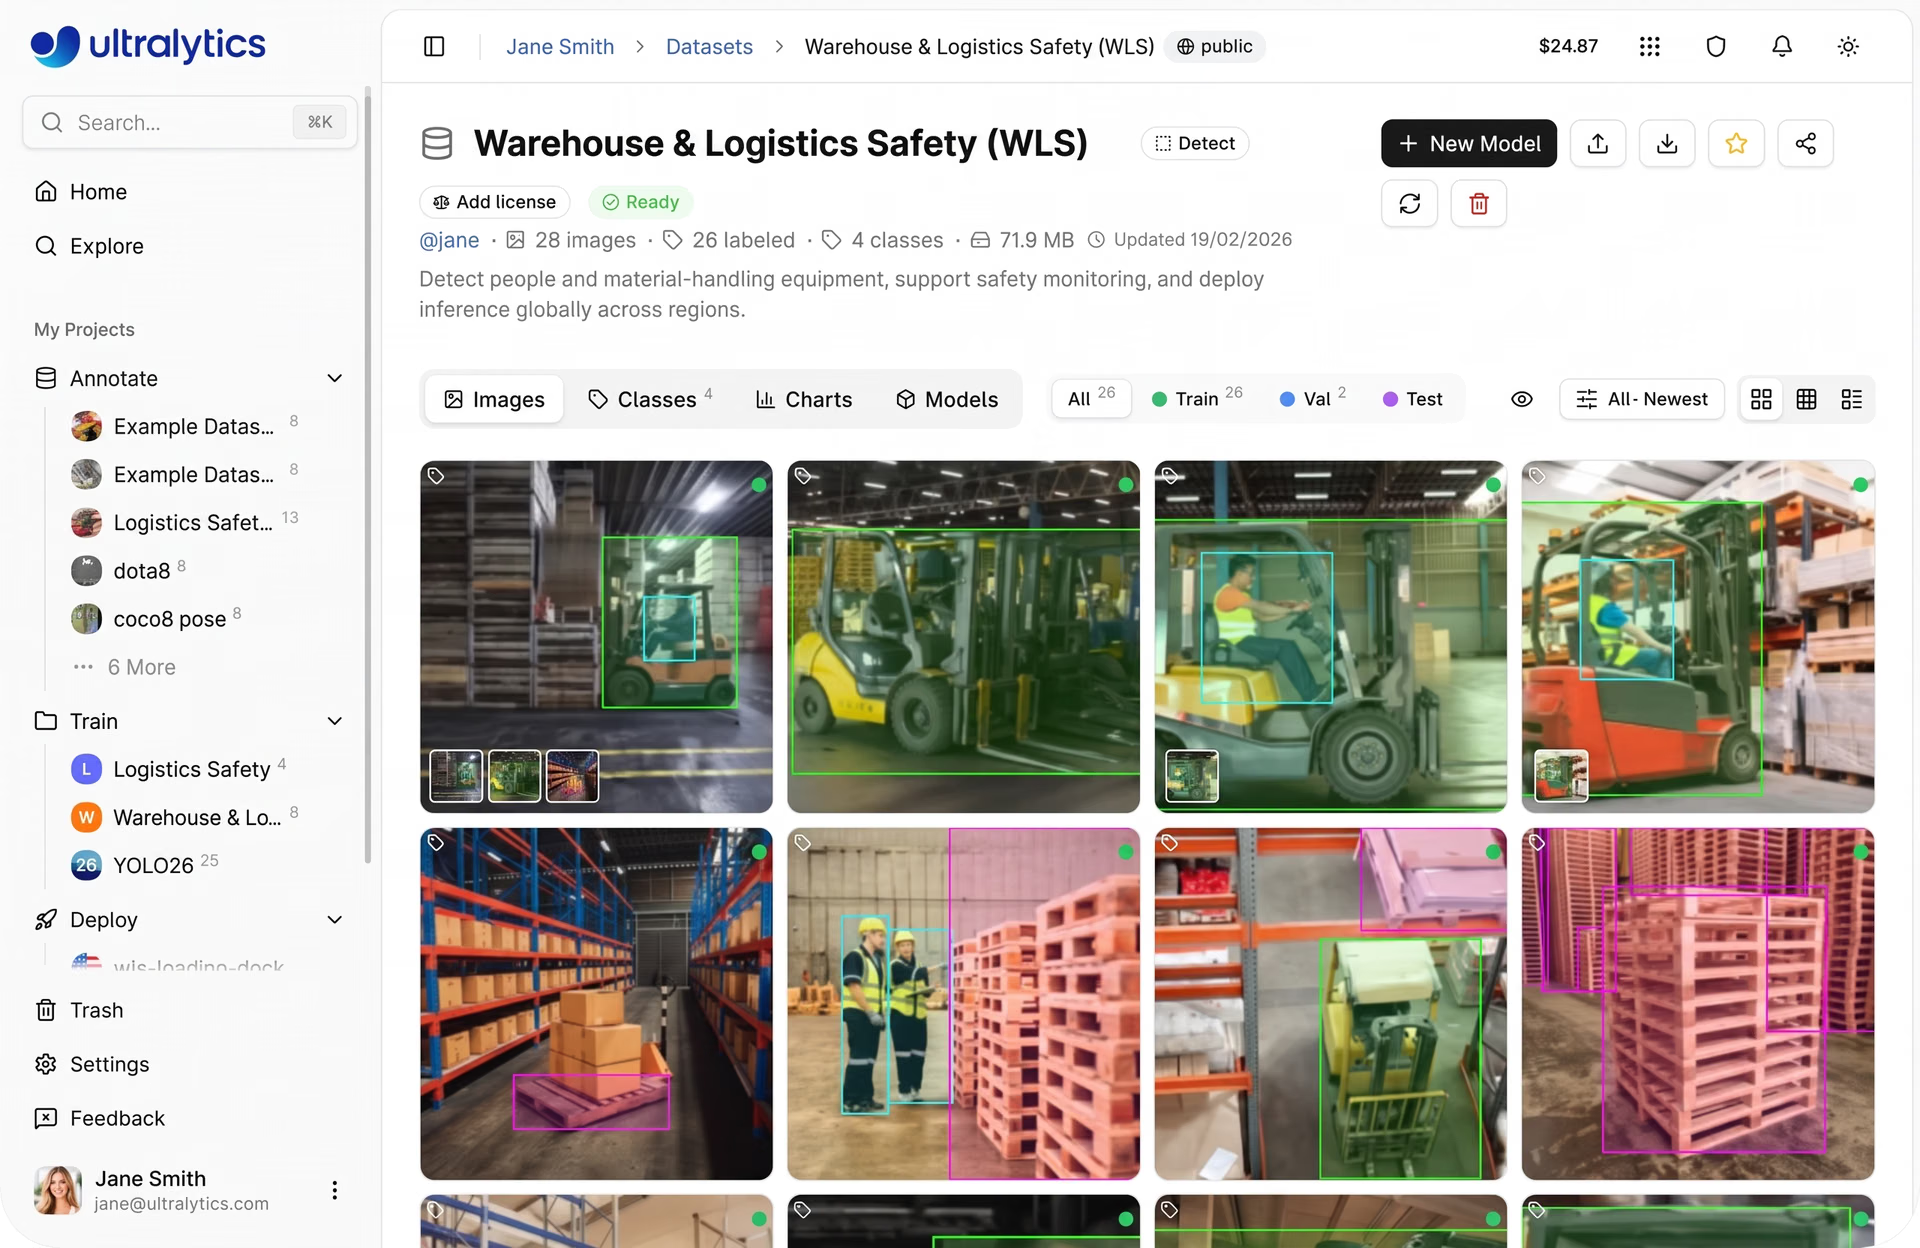
Fig. 1. Uno sguardo a Ultralytics Platform (Fonte)
In questo flusso di lavoro end-to-end, la distribuzione svolge un ruolo cruciale nel portare i modelli dalla sperimentazione all'uso nel mondo reale. In precedenza abbiamo esaminato le diverse opzioni di distribuzione disponibili sulla piattaforma, tra cui l'inferenza condivisa tramite API, endpoint dedicati per distribuzioni scalabili in produzione ed esportazione dei modelli per l'esecuzione su dispositivi edge o infrastrutture esterne.
Ora vediamo più da vicino l'esportazione dei modelli e il modo in cui consente la distribuzione in ambienti diversi. A differenza dell'inferenza e degli endpoint dedicati, che eseguono i modelli all'interno dell'infrastruttura gestita da Ultralytics Platform, l'esportazione dei modelli permette di distribuirli ed eseguirli in ambienti esterni, come dispositivi edge, applicazioni mobili e infrastrutture personalizzate.
Prima di poter essere eseguiti in questi ambienti, i modelli devono essere convertiti in formati supportati dal runtime di destinazione. Ogni configurazione di distribuzione ha requisiti specifici: si va dai formati leggeri per dispositivi mobili ed edge a quelli ad alte prestazioni per sistemi cloud e basati su GPU.
Tradizionalmente, questo processo può richiedere molto tempo e comportare l'uso di script, dipendenze e diversi strumenti. Con Ultralytics Platform, l'esportazione è molto più semplice. Puoi convertire e ottimizzare i modelli in pochi clic, senza configurazioni aggiuntive.
In questo articolo vedremo cosa significa esportare un modello, quali formati supporta Ultralytics Platform e come scegliere quello giusto per il tuo caso d'uso. Iniziamo!
Panoramica sull'esportazione di un modello#
Esportare un modello significa convertire un modello preaddestrato o addestrato su misura in un formato utilizzabile al di fuori del framework originale. I modelli Ultralytics YOLO sono realizzati con PyTorch e salvati nel formato nativo, ideale per l'addestramento, la valutazione e la sperimentazione nell'ecosistema PyTorch.
Tuttavia, gli ambienti di distribuzione hanno spesso runtime e requisiti hardware diversi. Per questo, il formato utilizzato durante l'addestramento non è sempre adatto alla distribuzione.
Per esempio, un'applicazione mobile potrebbe richiedere un formato leggero, ottimizzato per consumare poca energia, mentre un'app basata su browser ha bisogno di un formato che funzioni in modo efficiente negli ambienti web.
I dispositivi edge, come le telecamere e i sistemi embedded, traggono vantaggio da modelli compatti e veloci, mentre i sistemi cloud sono progettati per l'inferenza ad alte prestazioni. Per supportare questi diversi scenari, i modelli devono essere esportati in formati compatibili.
Perché la possibilità di esportare i modelli è più importante che mai#
Oggi i modelli di computer vision vengono distribuiti sempre più vicino al luogo in cui vengono generati i dati, soprattutto sui dispositivi edge. Gli smartphone eseguono applicazioni di visione in tempo reale, le telecamere CCTV effettuano il monitoraggio direttamente sul dispositivo e i sistemi autonomi si affidano a decisioni istantanee.
La distribuzione in questi ambienti comporta però una serie di sfide. I dispositivi edge hanno una potenza di calcolo limitata, requisiti rigorosi in termini di latenza e vincoli di memoria e consumo energetico. Un modello che funziona bene durante l'addestramento, con risorse adeguate, potrebbe non essere efficiente in queste condizioni limitate.
Esportare un modello nel formato giusto può aiutare ad affrontare queste sfide. Convertendolo in modo appropriato, puoi ottimizzarlo per la velocità, ridurne le dimensioni e renderlo compatibile con hardware specifici.
Allo stesso tempo, l'esportazione offre flessibilità. Puoi adattare lo stesso modello a diversi ambienti di distribuzione convertendolo in più formati in base a requisiti specifici.
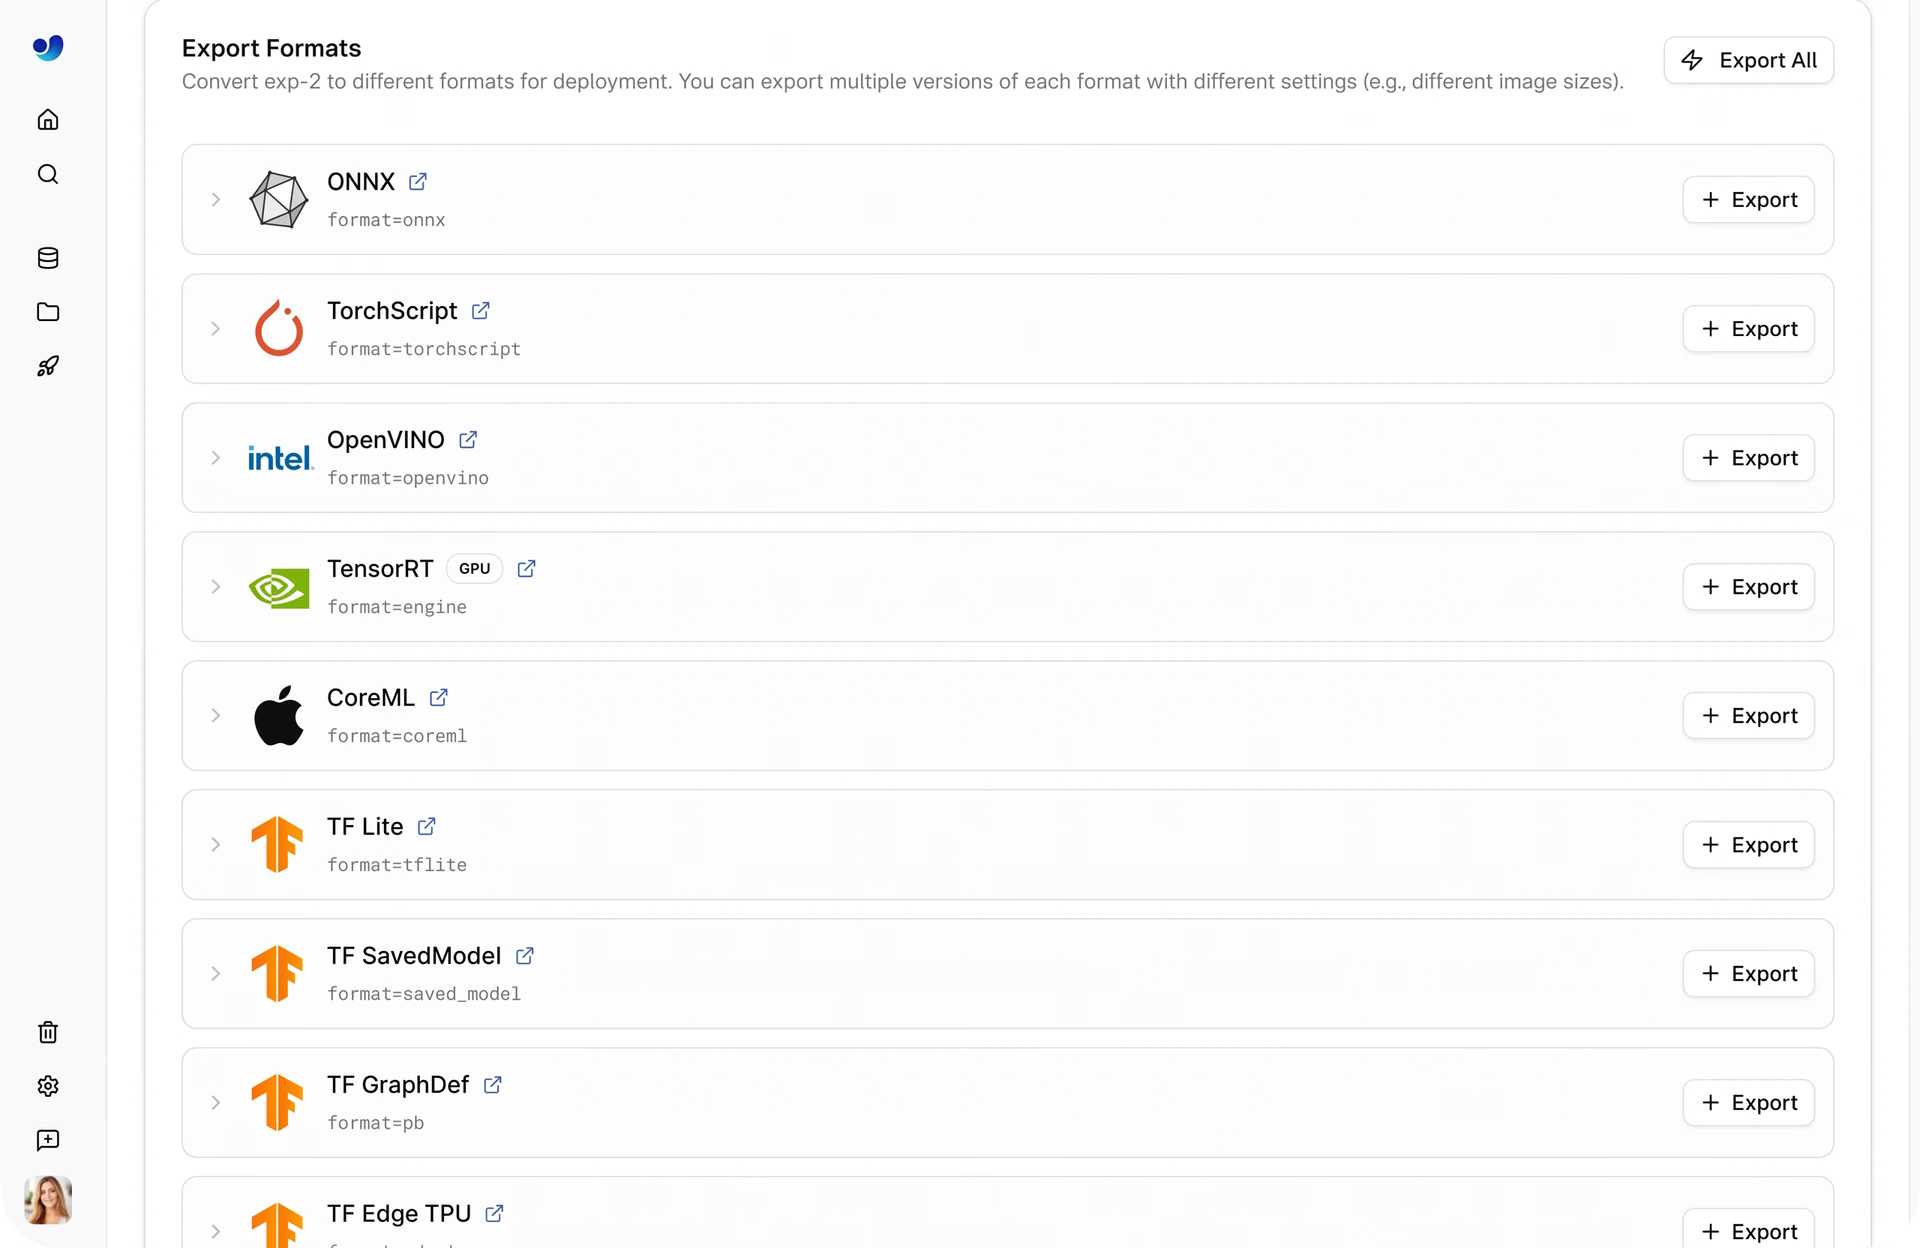
Fig. 2. Alcuni dei formati di esportazione disponibili in Ultralytics Platform (Fonte)
Per esempio, il formato di modello NCNN è ottimizzato per dispositivi mobili ed edge con un basso consumo di risorse. Il formato OpenVINO, invece, è pensato per l'hardware Intel e offre prestazioni migliori su unità centrali di elaborazione (CPU), unità di elaborazione grafica (GPU) e unità di elaborazione neurale (NPU).
Nella maggior parte dei casi, per ottenere questo livello di flessibilità bisognava affrontare conversioni manuali, dipendenze e l'uso di diversi strumenti, rendendo il processo complesso e dispendioso in termini di tempo. Ultralytics Platform semplifica questo flusso di lavoro, rendendo l'esportazione dei modelli più accessibile e facile da gestire.
Come Ultralytics Platform semplifica l'esportazione dei modelli#
Di solito, l'esportazione di un modello viene considerata una fase separata e complessa nei flussi di lavoro di computer vision. Ultralytics Platform cambia le cose integrando l'esportazione direttamente in un unico spazio di lavoro che copre tutto, dall'addestramento alla distribuzione.
Uno dei principali vantaggi è la possibilità di esportare senza scrivere codice. Non devi scrivere script, gestire ambienti o usare comandi specifici del framework. Puoi esportare i modelli in pochi clic tramite un'interfaccia intuitiva.
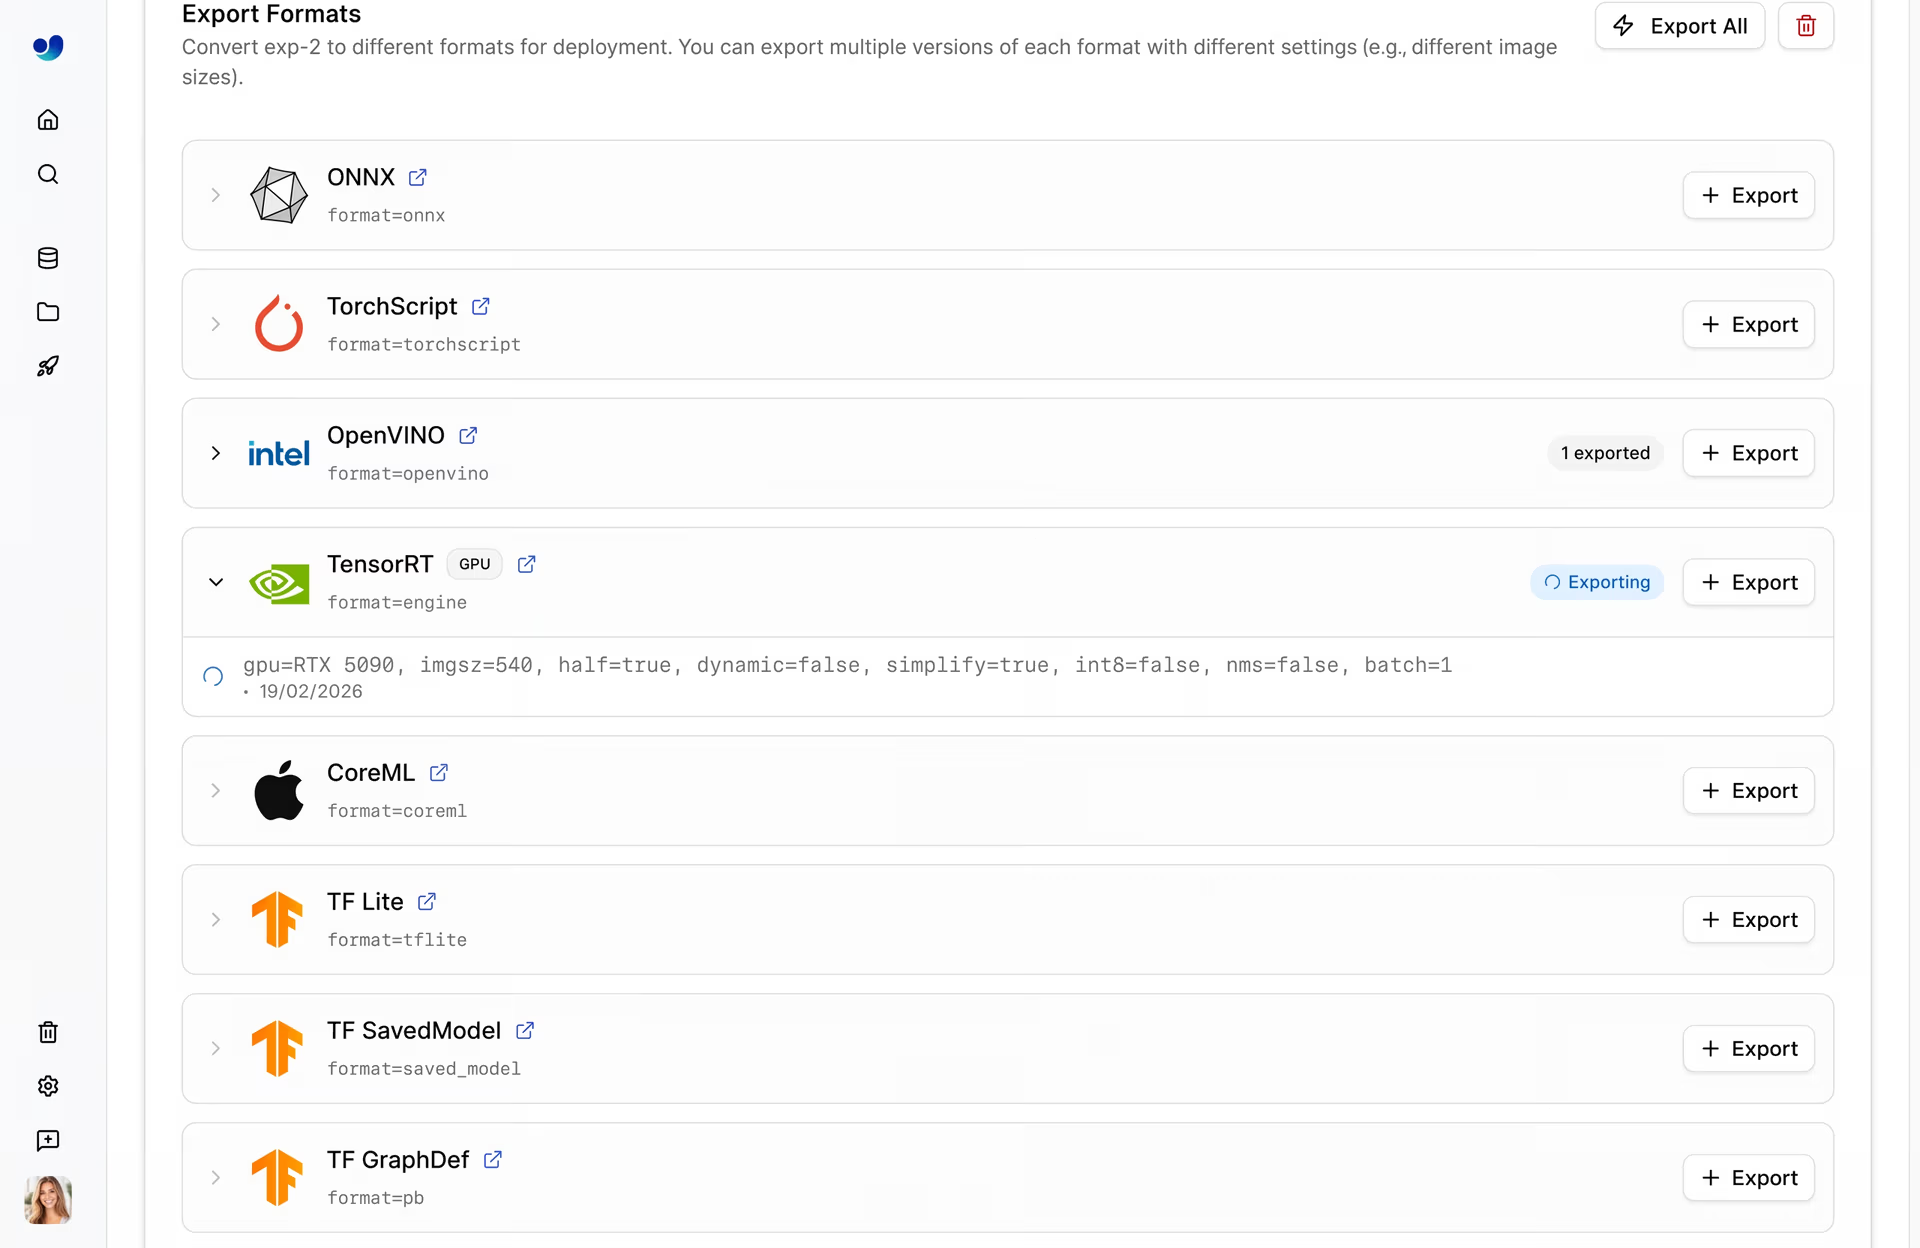
Fig. 3. Esempio di esportazione di un modello da Ultralytics Platform (Fonte)
Dietro le quinte, la piattaforma gestisce le operazioni più complesse. Le attività che normalmente richiederebbero diversi strumenti e una configurazione manuale vengono riunite in un unico processo. Non devi installare dipendenze aggiuntive né affrontare problemi di compatibilità: passare da un modello addestrato a una soluzione pronta per la produzione diventa molto più semplice.
Formati di esportazione dei modelli supportati da Ultralytics Platform#
Ultralytics Platform supporta 21 formati di esportazione, così puoi preparare facilmente i modelli per un'ampia gamma di ambienti di distribuzione senza complicazioni aggiuntive.
Ecco una panoramica di alcuni dei formati di esportazione più utilizzati:
- Compatibilità tra piattaforme e interoperabilità: ONNX e TorchScript sono ampiamente utilizzati per eseguire modelli su framework e ambienti diversi. ONNX funge da ponte tra gli ecosistemi e semplifica il trasferimento dei modelli tra gli strumenti, mentre TorchScript consente di eseguire modelli PyTorch in produzione senza richiedere un runtime Python.
- Inferenza ad alte prestazioni su GPU: TensorRT è progettato per le GPU NVIDIA e punta a ottimizzare i modelli per ridurre la latenza e aumentare il throughput. Supporta tecniche come la riduzione della precisione e la fusione dei layer per accelerare l'inferenza, risultando una scelta ideale per applicazioni in tempo reale e su scala di produzione.
- Distribuzione su dispositivi mobili ed edge: CoreML, LiteRT (TensorFlow Lite) e NCNN sono ottimizzati per dispositivi con capacità di calcolo e memoria limitate. Questi formati riducono le dimensioni dei modelli e ne migliorano l'efficienza, garantendo prestazioni fluide su smartphone, sistemi embedded e hardware edge. CoreML è usato soprattutto negli ecosistemi Apple, mentre LiteRT è comune su Android.
- Esecuzione ottimizzata per l'hardware: OpenVINO è pensato per l'hardware Intel, comprese CPU, GPU e VPU, e contribuisce a migliorare la velocità e l'efficienza dell'inferenza su questi dispositivi. I formati specifici per l'hardware, come questo, sono utili quando vuoi ottenere le migliori prestazioni da un determinato sistema.
- Runtime specifici per framework e specializzati: formati come PaddlePaddle ed ExecuTorch supportano ecosistemi ed esigenze di distribuzione specifici, tra cui l'esecuzione efficiente dei modelli su dispositivi edge o l'integrazione con particolari stack di deep learning.
Come esportare un modello con Ultralytics Platform#
Esportare un modello su Ultralytics Platform è un processo semplice, gestito tramite interfaccia utente. Puoi svolgere l'intero flusso di lavoro dall'interfaccia, senza bisogno di script o strumenti a riga di comando.
Ecco come esportare un modello usando la piattaforma:
- Accedi e scegli il modello: vai al tuo progetto e apri il modello addestrato che vuoi esportare.
- Vai alla scheda Export: nella dashboard del modello, fai clic sulla scheda Export per visualizzare le opzioni di esportazione disponibili.
- Seleziona un formato di esportazione: scegli un formato come ONNX, TensorRT o CoreML in base alle esigenze di distribuzione.
- Configura le impostazioni di esportazione (facoltativo): regola parametri come le dimensioni dell'immagine, la precisione o la dimensione del batch per ottimizzare le prestazioni.
- Avvia il processo di esportazione: fai clic su “Start Export” per avviare il processo. La piattaforma gestisce automaticamente la conversione.
- Scarica il modello esportato: al termine dell'esportazione, puoi scaricare il modello e usarlo nella pipeline di distribuzione.
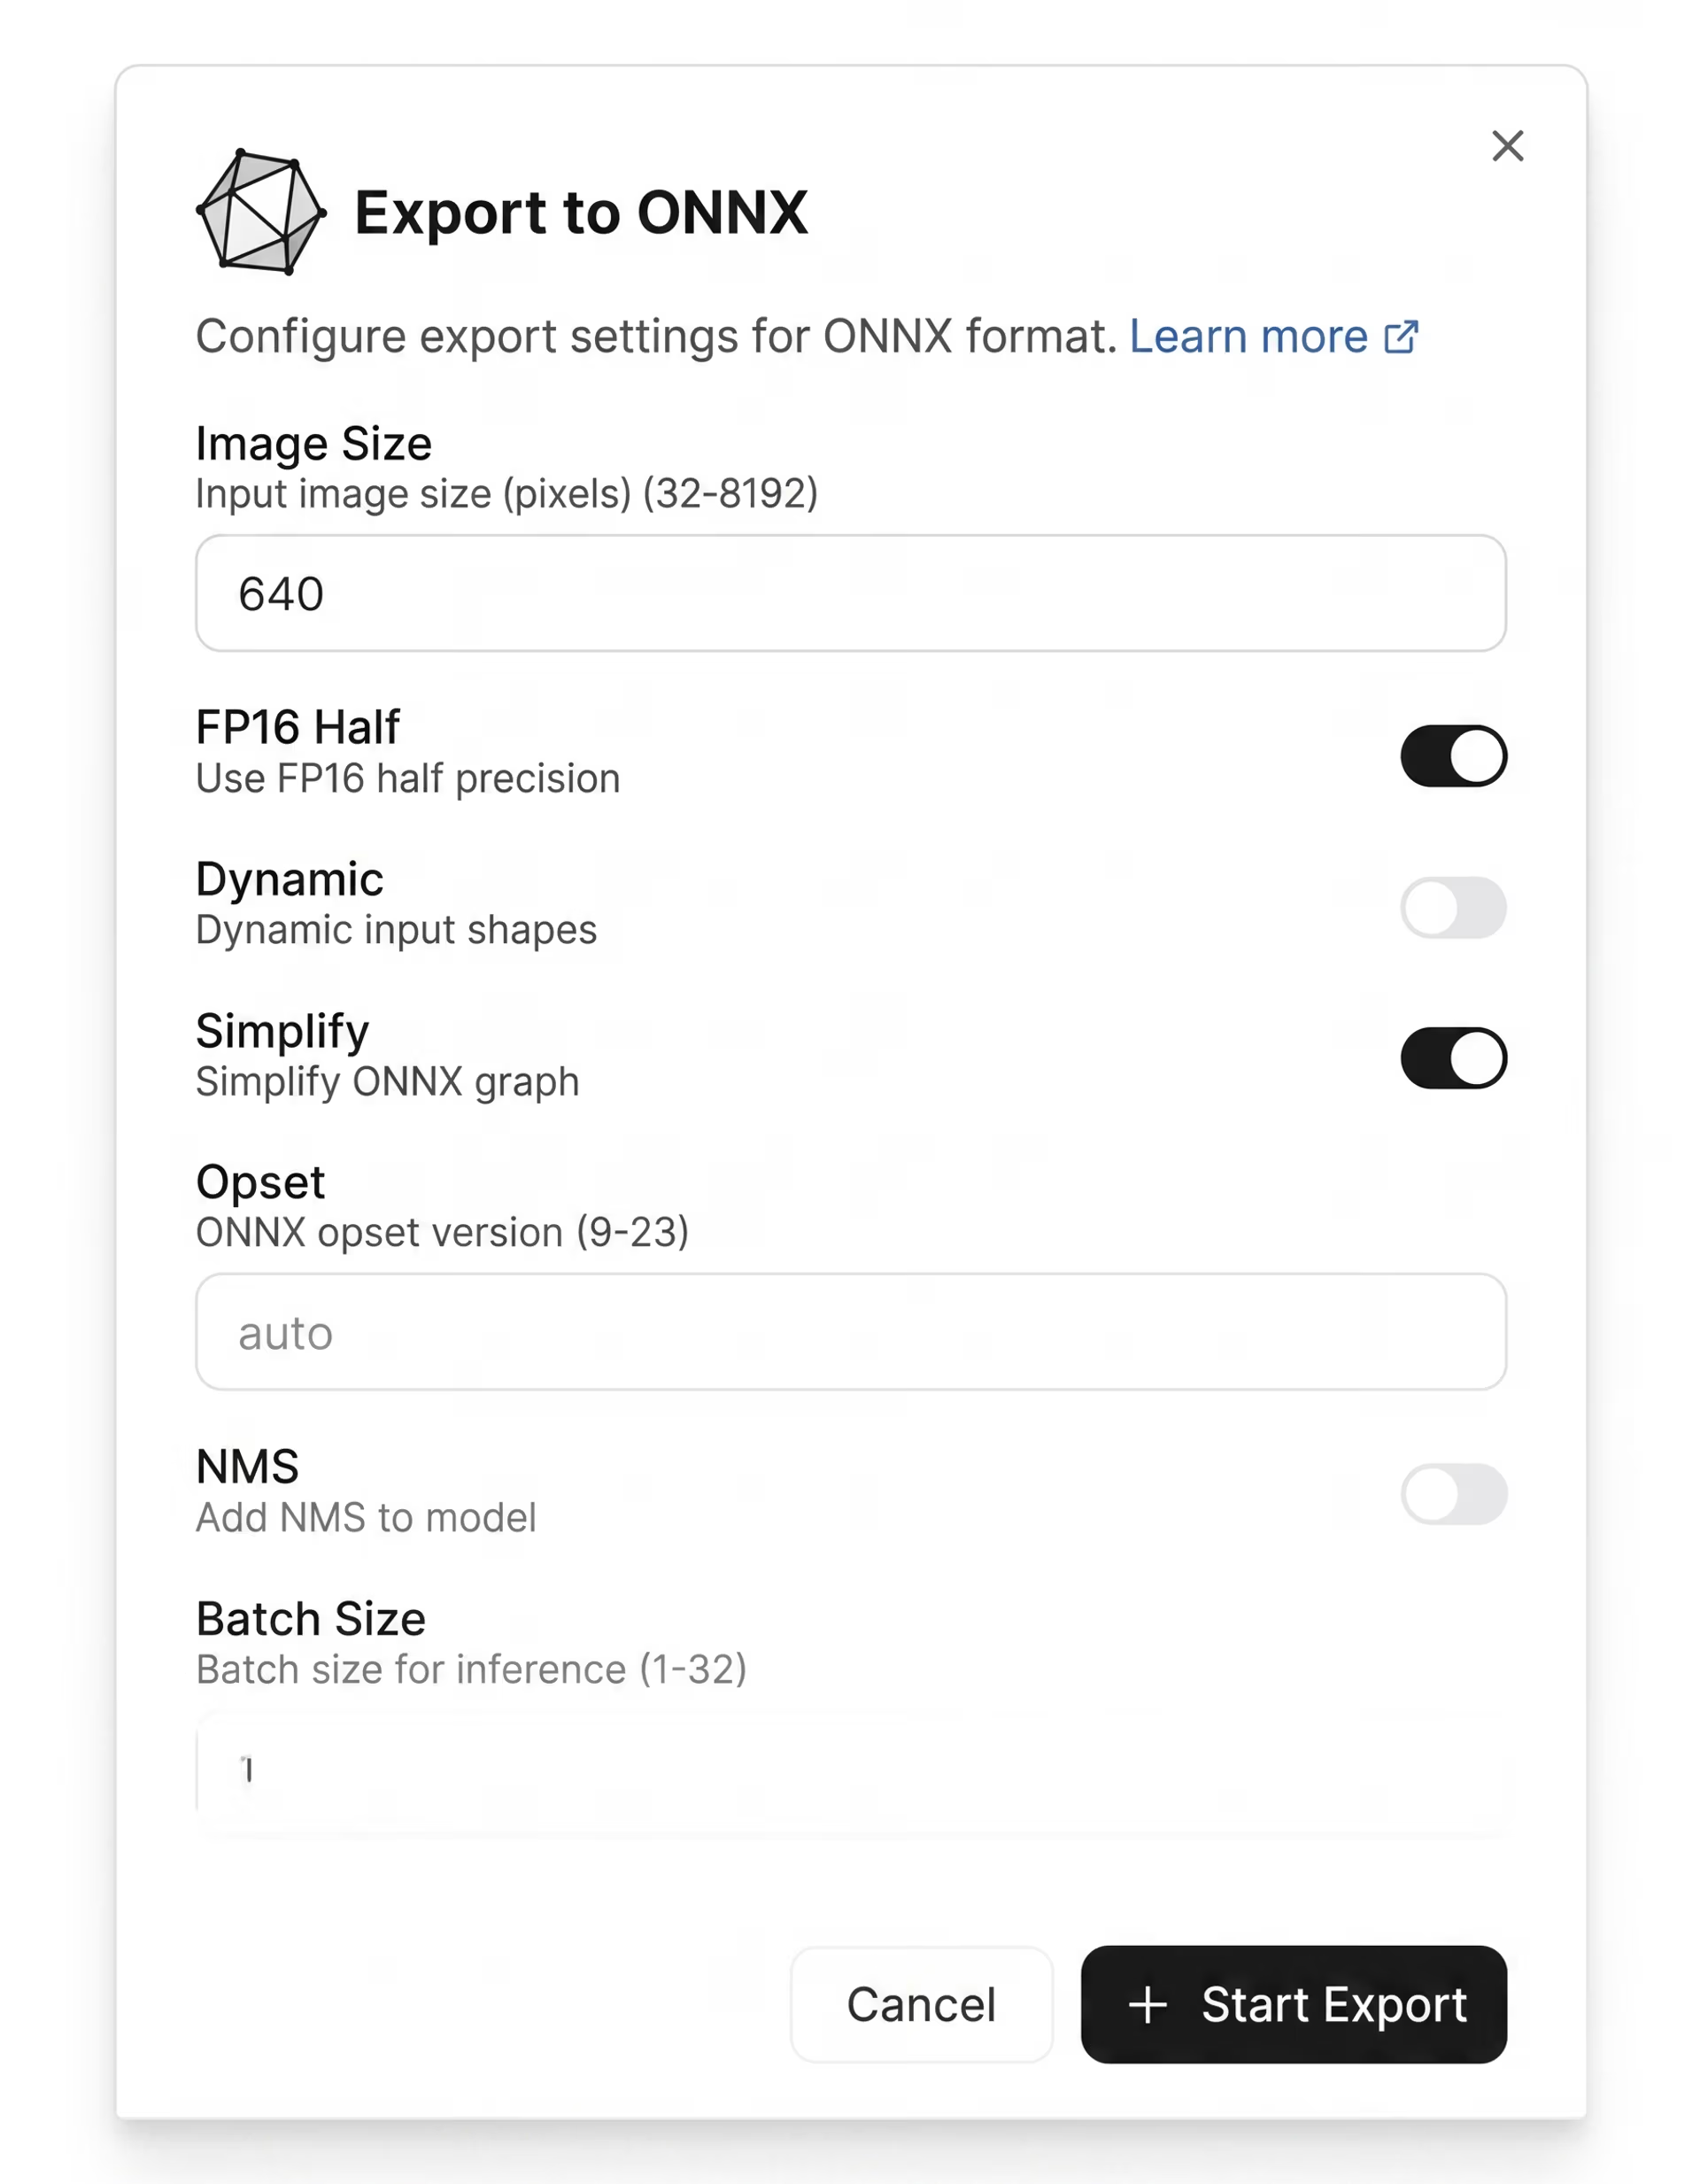
Fig. 4. Uno sguardo alla configurazione delle impostazioni di esportazione in Ultralytics Platform
Scegliere il formato di esportazione giusto#
Esplorando i diversi formati di esportazione supportati da Ultralytics Platform, potresti chiederti quale scegliere. La risposta dipende da dove e come intendi usare il modello.
Ecco alcuni fattori da considerare:
- Requisiti di latenza: per applicazioni in tempo reale come l'analisi video o i sistemi autonomi, una bassa latenza è fondamentale. Spesso sono più adatti i formati ottimizzati per l'inferenza ad alte prestazioni, come TensorRT.
- Vincoli hardware: i dispositivi con memoria e potenza di elaborazione limitate, come i telefoni cellulari o i sistemi embedded, richiedono formati leggeri come LiteRT o NCNN.
- Dimensioni del modello e consumo energetico: quando lavori con dispositivi edge, le dimensioni del modello e il consumo energetico sono importanti. I modelli più piccoli e ottimizzati contribuiscono a garantire prestazioni costanti senza esaurire le risorse.
- Ambiente di distribuzione: se il modello deve funzionare su piattaforme diverse, formati come ONNX offrono flessibilità. Per casi d'uso specifici di una piattaforma, come le app iOS, spesso la scelta migliore è CoreML.
Non esiste un formato adatto a tutti i casi. La scelta dipende dall'equilibrio tra prestazioni, compatibilità e limiti dell'ambiente di destinazione. Ultralytics Platform semplifica il processo, permettendoti di provare e confrontare diversi formati senza sforzi aggiuntivi.
Punti chiave#
L'esportazione è un passaggio fondamentale per preparare il modello all'uso nel mondo reale in ambienti diversi. Con Ultralytics Platform, il processo diventa molto più semplice: puoi convertire e ottimizzare i modelli senza configurazioni aggiuntive né complicazioni. Scegliendo il formato giusto per il tuo caso d'uso, puoi assicurarti che il modello funzioni in modo efficiente ovunque lo distribuisci.
Unisciti alla nostra community in crescita e dai un'occhiata al nostro repository GitHub per saperne di più sulla computer vision. Scopri le nostre pagine dedicate alle soluzioni per approfondire applicazioni come l'IA nella robotica e la computer vision nella logistica. Scopri le nostre opzioni di licenza e inizia a sviluppare con l'IA visiva!









