Come Ultralytics Platform semplifica la distribuzione dei modelli di computer vision
Scopri come Ultralytics Platform riunisce tutto ciò che serve per distribuire modelli di computer vision, dai test alle API pronte per la produzione.
Ultralytics collabora da anni con la community della computer vision, creando modelli e strumenti che rendono l'AI per la visione più accessibile a tutti. Con Ultralytics Platform, facciamo un ulteriore passo avanti portando l'intero workflow di sviluppo della computer vision in un unico ambiente unificato, dalla gestione dei dataset e dall'annotazione fino all'addestramento, alla validazione e al deployment dei modelli.
In particolare, siamo entusiasti di rendere più semplice il deployment dei modelli di computer vision. Mentre la computer vision continua a farsi strada nelle applicazioni del mondo reale, analizzare immagini e video al di fuori di ambienti controllati rimane complesso.
A differenza degli ambienti di test, in cui le condizioni sono prevedibili, gli scenari reali comportano illuminazione variabile, input mutevoli e carichi di lavoro imprevedibili, rendendo il deployment una delle parti più impegnative del workflow di visione.
Il deployment richiede più della semplice disponibilità di un modello. È necessario configurare processi in grado di gestire dati reali e assicurarsi che tutto funzioni correttamente con l'aumento dell'utilizzo e della scala dei progetti.
I team devono inoltre monitorare le prestazioni e mantenere l'affidabilità nel tempo. Spesso ciò significa passare da uno strumento AI all'altro per test, integrazione, deployment e monitoraggio, rallentando lo sviluppo dei modelli e aggiungendo complessità non necessaria.
I workflow finiscono per diventare frammentati. Ultralytics Platform unifica e semplifica questo processo.
Offre supporto integrato per il model serving, i test e il monitoraggio all'interno di un unico ambiente. I team possono validare i modelli usando l'inferenza basata su browser, integrarli nelle applicazioni tramite servizi di inferenza condivisi e distribuirli su endpoint dedicati con funzionalità di monitoraggio delle prestazioni.
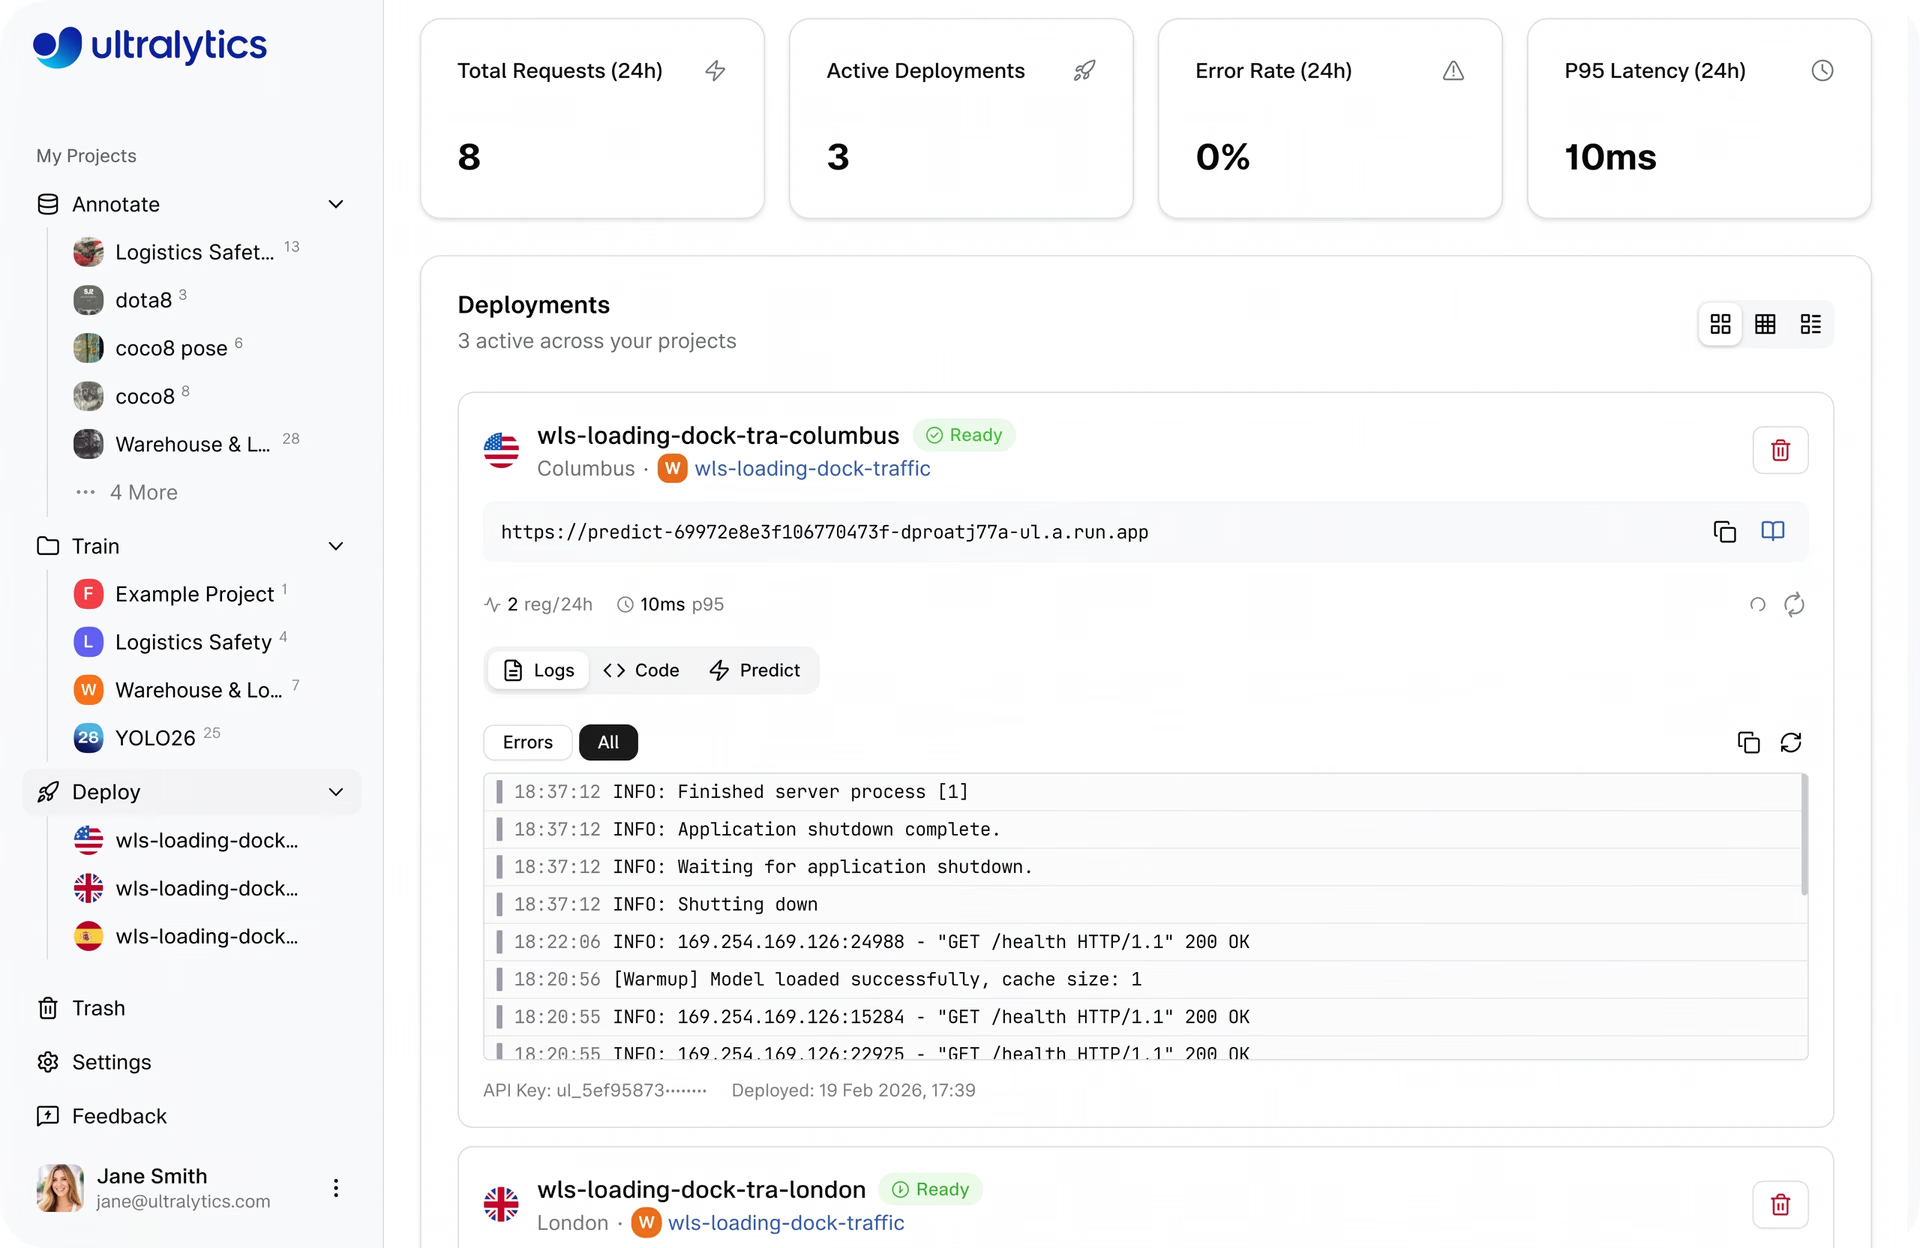
Fig. 1. Panoramica della pagina di deployment all'interno di Ultralytics Platform (Fonte)
In questo articolo esploreremo come Ultralytics Platform ridefinisce il deployment dei modelli di computer vision, dai test e dall'integrazione fino al deployment in produzione e al monitoraggio. Iniziamo!
Panoramica del deployment dei modelli di computer vision#
Nel ciclo di vita del machine learning, il deployment dei modelli è la fase in cui un modello passa dalla sperimentazione all'utilizzo nel mondo reale. Per i modelli di computer vision basati sul deep learning e sulle reti neurali convoluzionali, ciò significa generalmente renderli disponibili per elaborare immagini e video in tempo reale.
Una volta distribuiti, questi modelli ricevono nuovi dati, che solitamente passano attraverso fasi di preelaborazione come ridimensionamento, normalizzazione o formattazione. I dati elaborati vengono quindi passati al modello, che applica gli schemi appresi durante l'addestramento per generare previsioni ad alta precisione.
A seconda del caso d'uso, ciò può includere diverse attività di computer vision. Ad esempio, i modelli Ultralytics YOLO, come Ultralytics YOLO26, supportano un'ampia gamma di attività di visione, tra cui rilevamento degli oggetti, classificazione delle immagini, segmentazione delle istanze, stima della posa e rilevamento di bounding box orientati (OBB).
Per rendere tutto ciò pratico nelle applicazioni del mondo reale, spesso i modelli devono essere integrati in sistemi in grado di gestire in modo efficiente sia la preelaborazione sia l'inferenza. È qui che l'infrastruttura di deployment diventa essenziale.
Negli ambienti di produzione, i modelli vengono generalmente utilizzati tramite REST API o sistemi di model serving. Queste interfacce consentono alle applicazioni di inviare dati e ricevere previsioni a livello programmatico, facilitando l'integrazione con applicazioni esterne, dispositivi IoT o sistemi robotici che si basano sulla comprensione visiva in tempo reale.
Limiti degli strumenti tradizionali per il deployment della computer vision#
Il deployment dei modelli di computer vision può sembrare semplice, ma finora nella pratica è apparso piuttosto diverso. Considera una configurazione comune: i dati vengono prima acquisiti da telecamere o sensori, inviati a un modello per l'inferenza e poi restituiti a un'applicazione sotto forma di previsioni.
Nella realtà, ciascuno di questi passaggi viene spesso gestito da strumenti e servizi separati. Un sistema può occuparsi dell'acquisizione dei dati, un altro gestire il model serving, mentre strumenti aggiuntivi vengono utilizzati per scalabilità, monitoraggio e logging. Mantenere questi componenti connessi e affidabili può diventare rapidamente complesso.
Con l'aumento dell'utilizzo, questa complessità cresce. Gestire l'infrastruttura, le dipendenze e prestazioni coerenti lungo l'intera pipeline end-to-end può rallentare lo sviluppo e rendere più difficile distribuire modelli di computer vision nelle applicazioni del mondo reale.
Ultralytics Platform riunisce questi componenti in un unico ambiente unificato. Ciò offre un modo più coerente di gestire l'intero workflow di deployment, supportando al contempo prestazioni e affidabilità su larga scala.
Opzioni di deployment dei modelli abilitate da Ultralytics Platform#
Oltre a unificare il processo di deployment dei modelli, Ultralytics Platform offre anche flessibilità nel modo in cui i modelli vengono distribuiti e utilizzati.
Per supportare le diverse fasi del deployment dei modelli di computer vision, la piattaforma offre quattro opzioni: test basati su browser con inferenza immediata, inferenza condivisa tramite API per lo sviluppo, endpoint dedicati per deployment di produzione scalabili nelle regioni globali ed esportazione dei modelli per eseguirli su infrastrutture esterne o dispositivi edge.
Vediamo quindi più da vicino come funziona ciascuna di queste opzioni.
Valida rapidamente i modelli usando la scheda Predict#
Prima di portare un modello in produzione, è importante capire come si comporta su dati nuovi e mai visti. Ultralytics Platform include una scheda Predict integrata che ti permette di eseguire l'inferenza direttamente nel browser, senza configurazione, infrastruttura o dipendenze.
La scheda Predict rende la validazione dei modelli rapida e interattiva. Puoi caricare immagini, usare esempi precaricati o acquisire input con una webcam; l'inferenza viene eseguita automaticamente non appena vengono forniti i dati.
I risultati vengono visualizzati immediatamente con sovrapposizioni grafiche, punteggi di confidenza e output dettagliati, offrendoti una visione chiara del comportamento del modello.
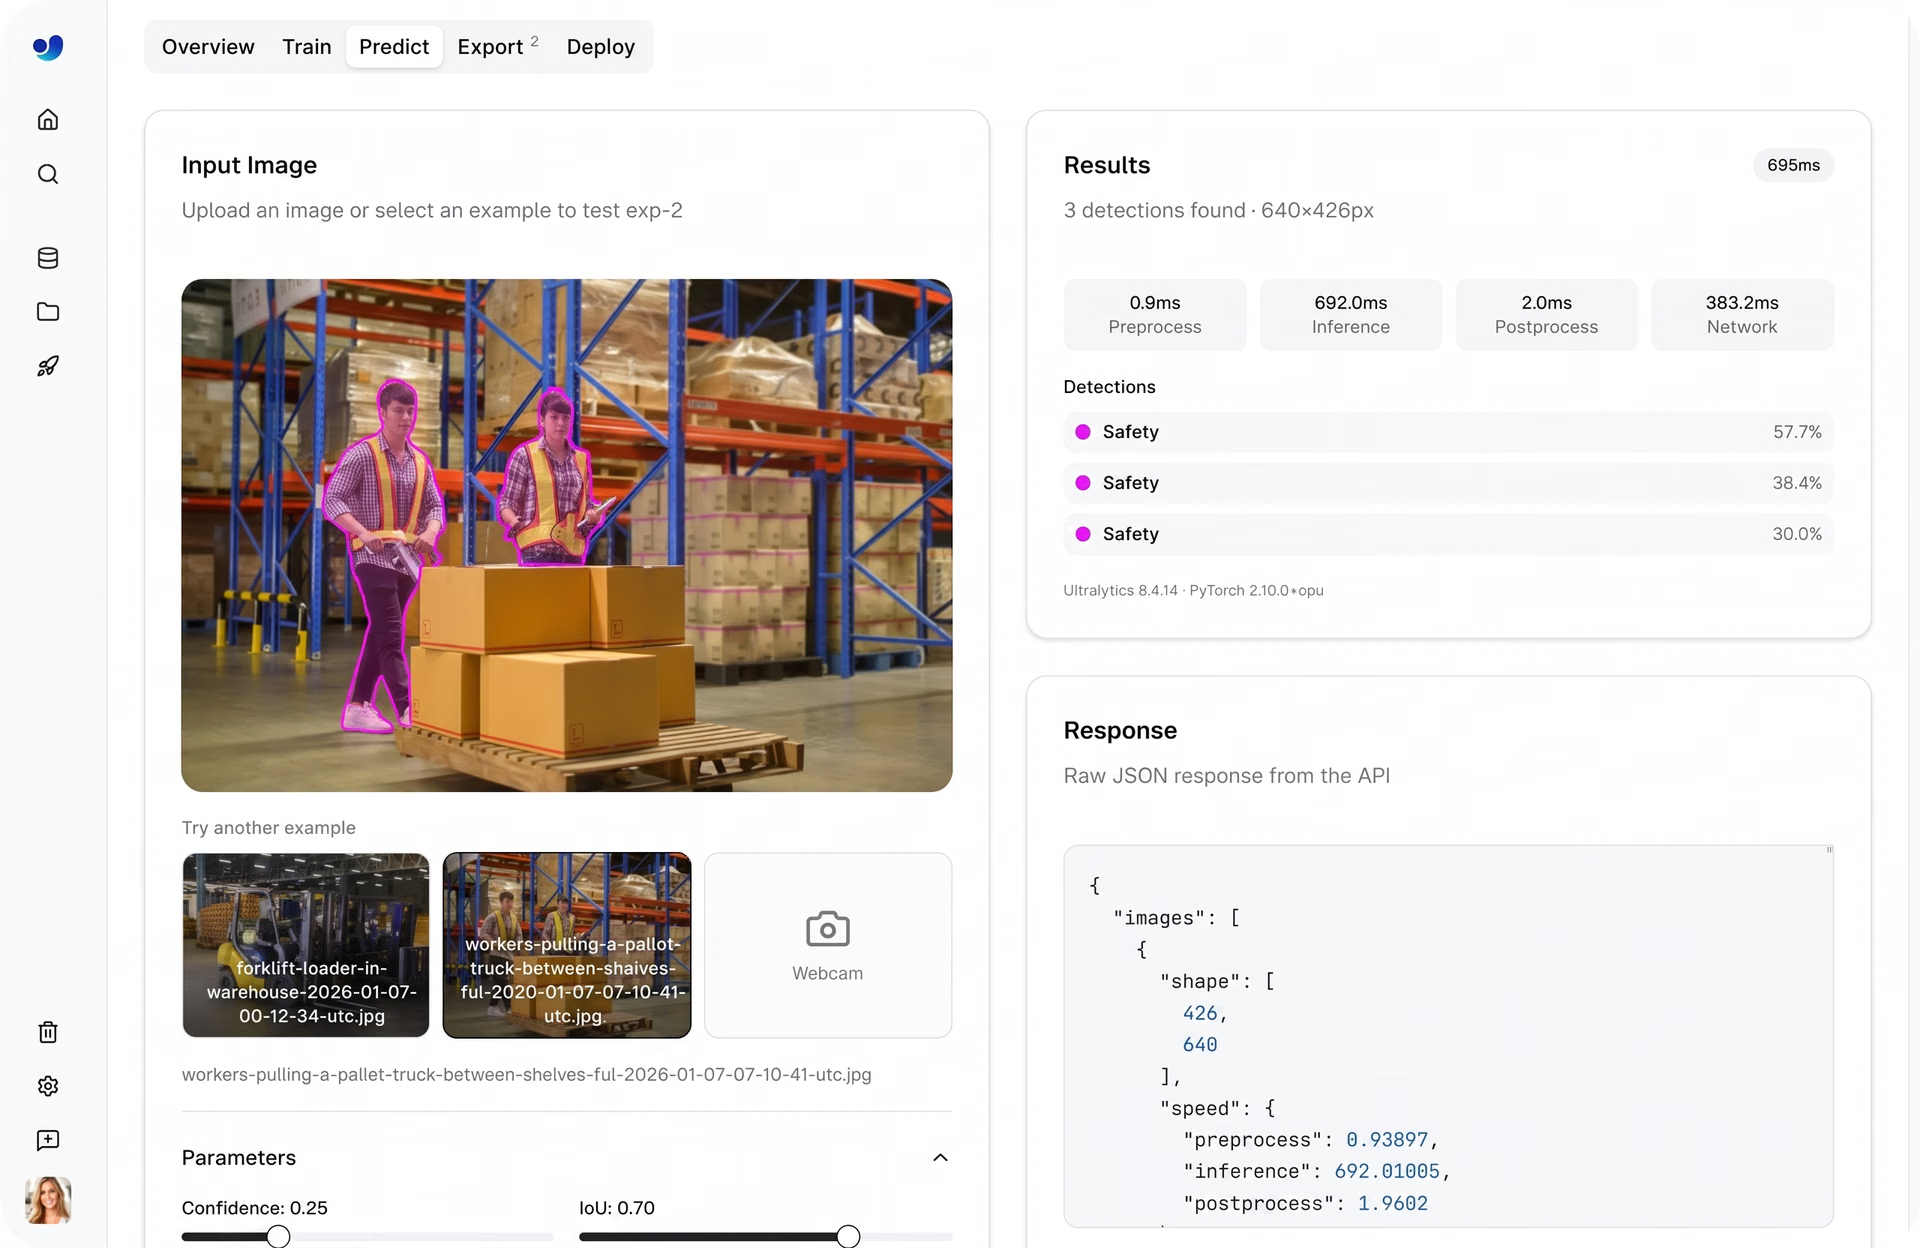
Fig. 2. Esempio di validazione di un modello usando la scheda Predict (Fonte)
Ciò significa che, con pochi clic, puoi testare diversi input, modificare i parametri e valutare le prestazioni in un'unica interfaccia prima di passare al deployment.
Esecuzione di inferenze condivise per test o utilizzi leggeri#
Supponiamo che tu abbia addestrato un modello e lo abbia validato usando la scheda Predict. Il passaggio successivo consiste spesso nell'integrare il modello in un'applicazione o in un workflow.
Invece di configurare infrastrutture o gestire server, Ultralytics Platform offre servizi di inferenza condivisi che ti consentono di inviare dati al modello e ricevere previsioni tramite semplici REST API.
Dietro le quinte, l'inferenza condivisa viene eseguita su un sistema multi-tenant distribuito in alcune regioni principali, dove le richieste vengono instradate automaticamente al servizio disponibile più vicino. Ciò aiuta a mantenere prestazioni reattive, consentendo agli utenti in luoghi diversi di accedere ai modelli in modo coerente.
Puoi inviare gli input usando richieste HTTP standard e ricevere in risposta output strutturati, rendendo semplice collegare i modelli ad applicazioni, script o workflow di automazione. Questa configurazione è un'ottima opzione per sviluppo, test, integrazioni o utilizzi più leggeri prima di passare a deployment di produzione più scalabili.
Distribuisci i modelli a livello globale tramite endpoint dedicati#
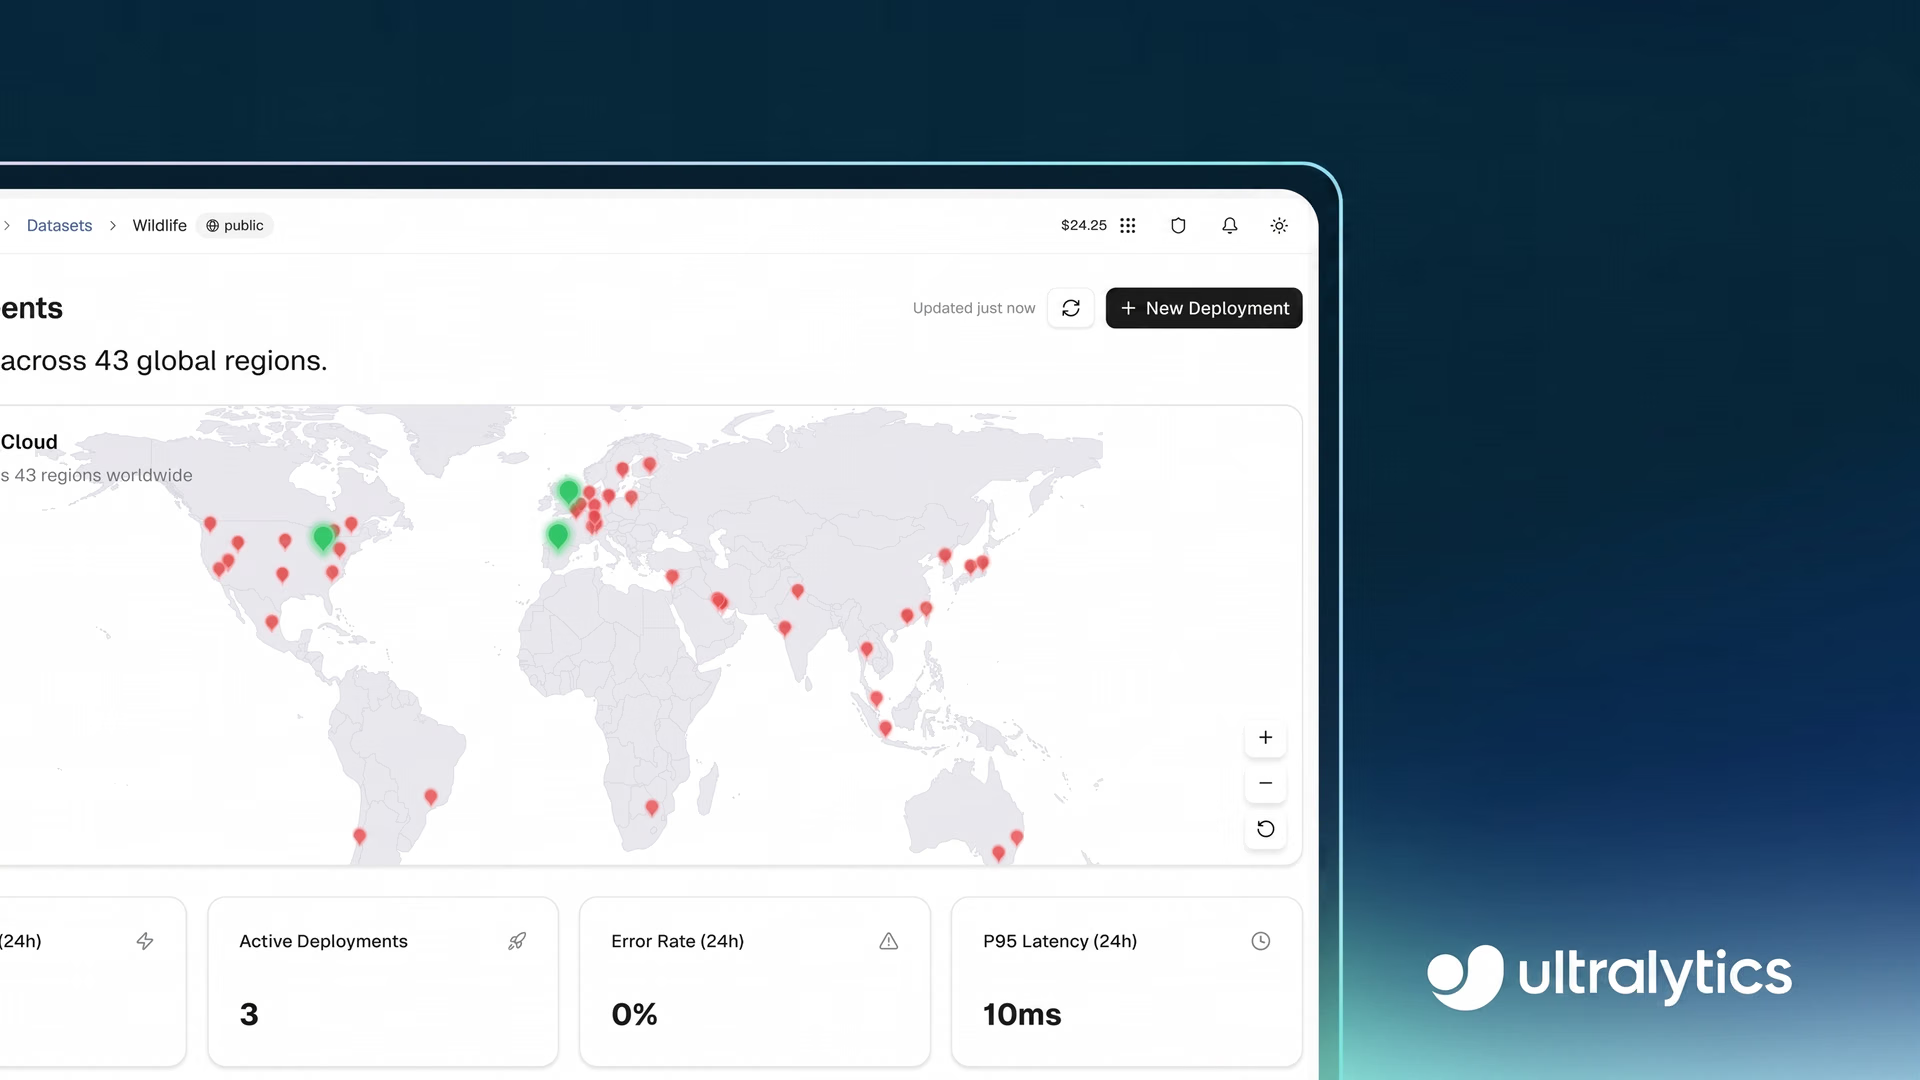
Quando un modello è pronto per la produzione, deve gestire in modo affidabile il traffico reale e operare su larga scala. Ultralytics Platform lo supporta con endpoint dedicati, in cui i modelli vengono eseguiti come servizi single-tenant in 43 regioni globali. Distribuire i modelli più vicino agli utenti finali aiuta a ridurre la latenza e a mantenere prestazioni coerenti in luoghi diversi.
Ogni endpoint viene eseguito con risorse di calcolo allocate in modo indipendente e con un URL univoco per le richieste di inferenza. Questo livello di controllo facilita l'ottimizzazione dei deployment in base alle esigenze prestazionali, dai casi d'uso leggeri alle applicazioni più impegnative e ad alto throughput che richiedono maggiori risorse computazionali.
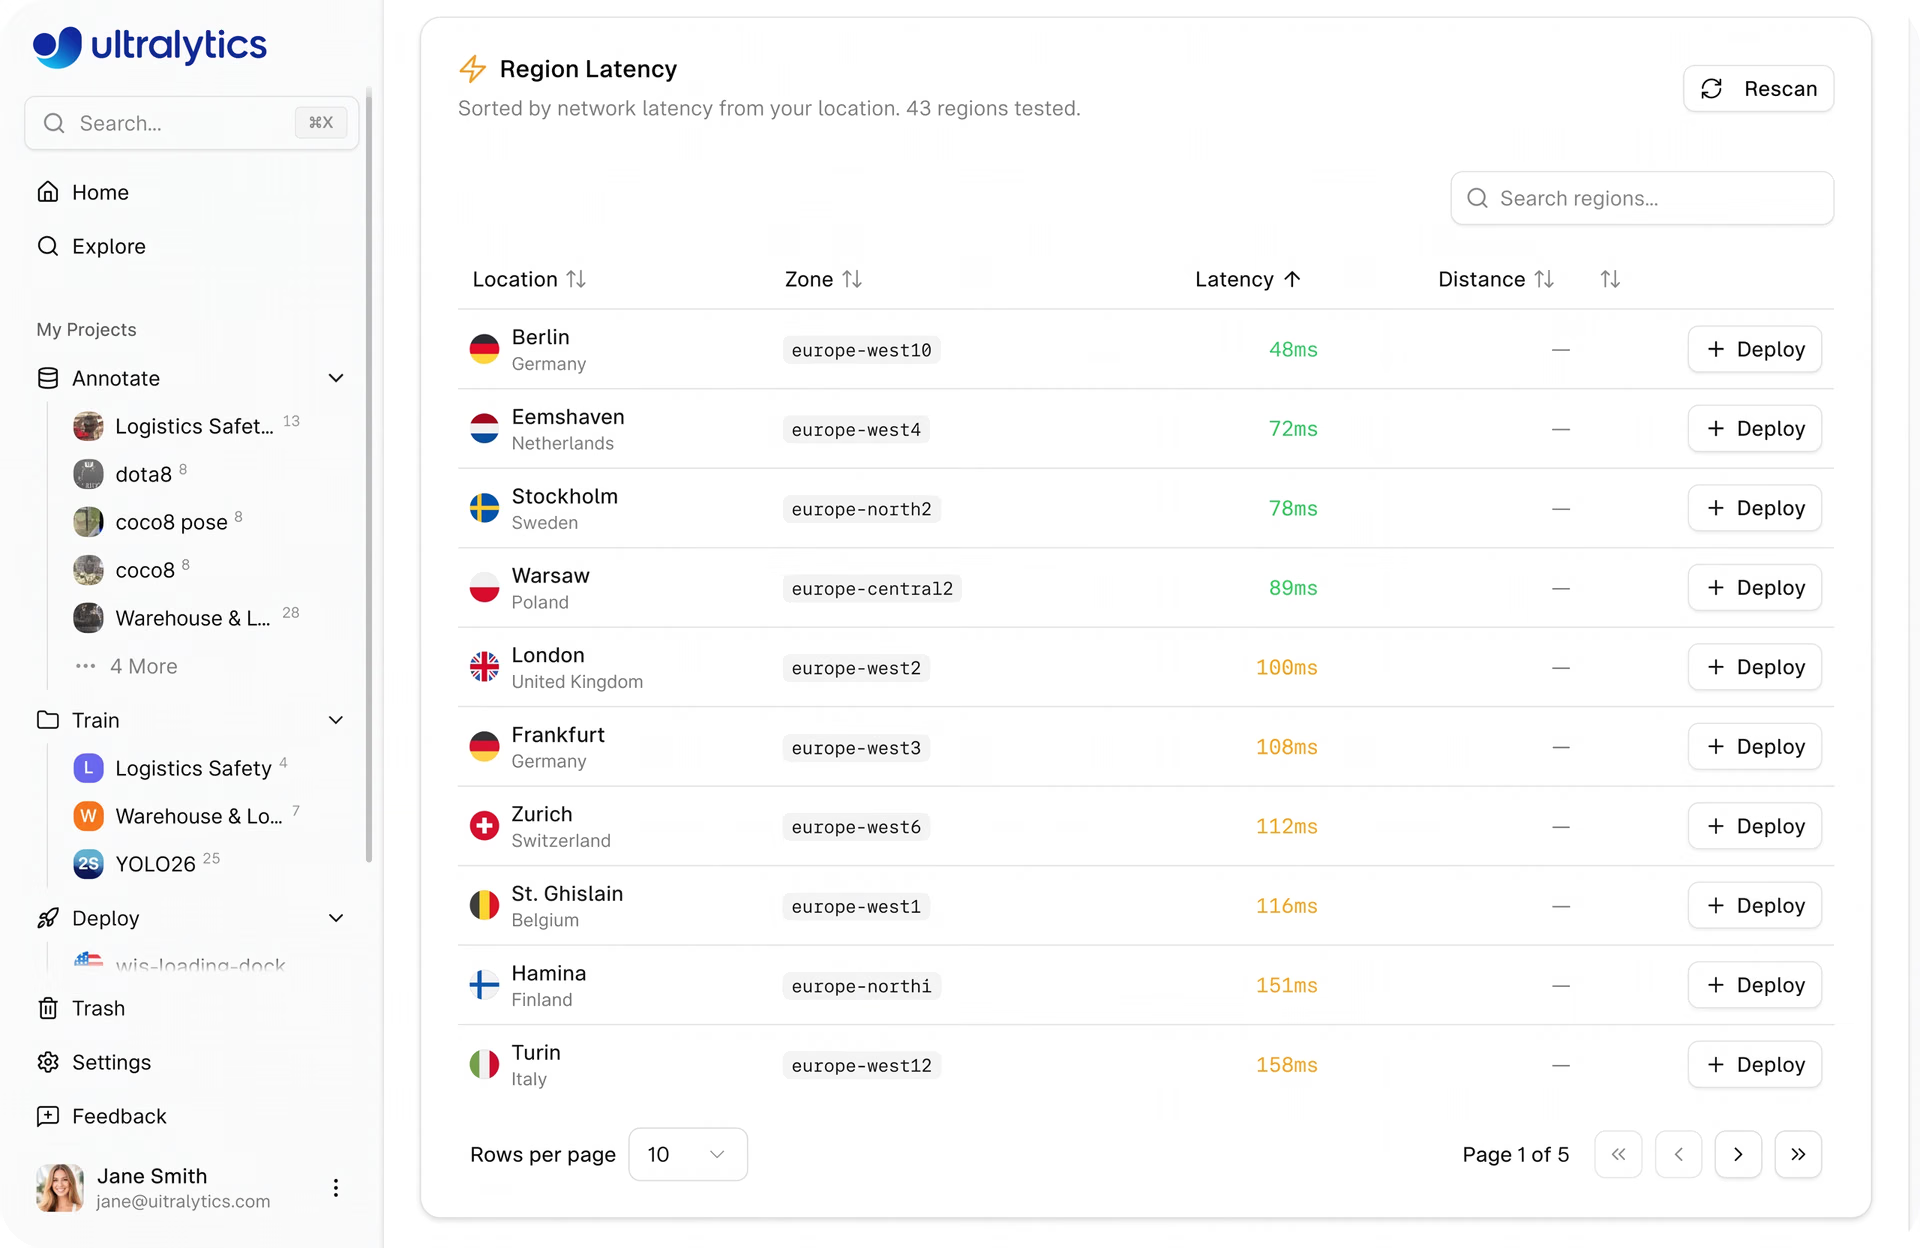
Fig. 3. Puoi distribuire i modelli in 43 regioni globali usando Ultralytics Platform (Fonte)
Tuttavia, gli endpoint dedicati sono progettati per gestire autonomamente i carichi di lavoro variabili, grazie all'auto scaling che adatta le risorse in base al traffico in ingresso. Aumentano le risorse nei periodi di domanda elevata e le riducono quando l'utilizzo cala. Con lo scale-to-zero abilitato per impostazione predefinita, gli endpoint inattivi si arrestano automaticamente e si riavviano quando arrivano nuove richieste, contribuendo a ottimizzare l'uso delle risorse senza interventi manuali.
Esporta facilmente il tuo modello con Ultralytics Platform#
Oggi l'AI edge sta diventando sempre più essenziale, poiché un numero crescente di applicazioni si basa sull'esecuzione dei modelli direttamente su dispositivi come smartphone, telecamere e sistemi embedded. Eseguire i modelli localmente può inoltre aiutare a soddisfare i requisiti di privacy dei dati, poiché dati sensibili come immagini o flussi video possono essere elaborati direttamente sul dispositivo senza essere inviati a server esterni.
In questi scenari, i modelli devono essere eseguiti al di fuori di Ultralytics Platform, rendendo l'esportazione dei modelli una parte fondamentale del processo di deployment. I modelli Ultralytics YOLO vengono spesso addestrati usando Python e PyTorch e possono poi essere esportati in oltre 17 formati diversi, tra cui ONNX, TensorRT, CoreML e OpenVINO.
Questa vasta gamma di formati garantisce la compatibilità con hardware diversi, dalle unità di elaborazione grafica ad alte prestazioni (GPUs) ai dispositivi mobili ed embedded. Inoltre, l'esportazione consente di ottimizzare le prestazioni per ambienti specifici.
A seconda del formato, i modelli possono raggiungere velocità di inferenza superiori, ad esempio con prestazioni migliori delle GPU tramite TensorRT o un'esecuzione ottimizzata sulla CPU con ONNX e OpenVINO. Opzioni come la quantizzazione FP16 e INT8 possono ridurre ulteriormente le dimensioni del modello e migliorare il throughput, risultando particolarmente utili per i deployment edge.
Su Ultralytics Platform, l'esportazione è integrata direttamente nel workflow, rendendo rapida la generazione di modelli ottimizzati con pochi clic. I team possono passare dall'addestramento all'esecuzione dei modelli su sistemi esterni senza aggiungere sovraccarico.
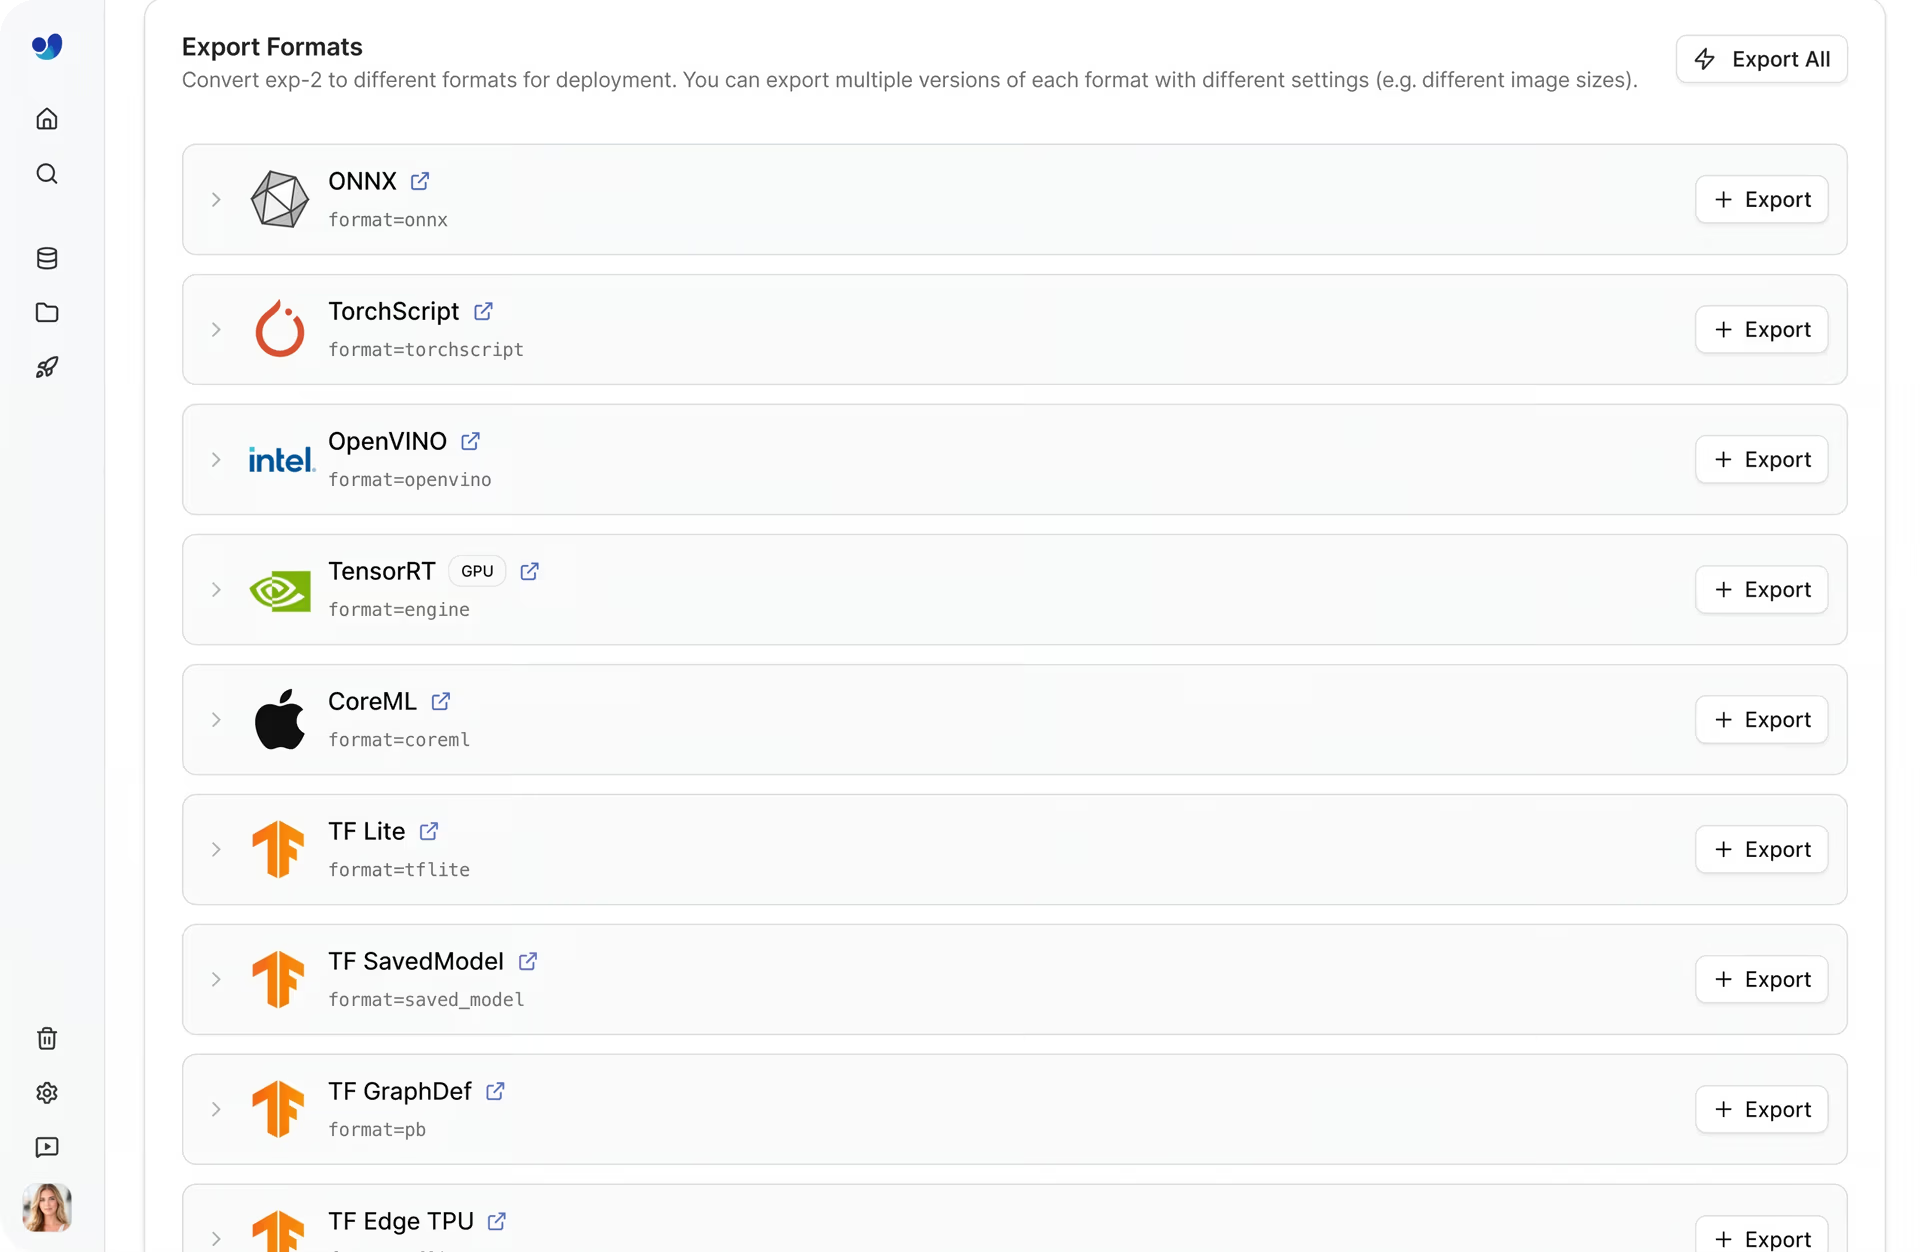
Fig. 4. Una selezione di formati di esportazione su Ultralytics Platform.
Scegliere l'opzione di deployment dei modelli più adatta#
Ogni opzione di deployment in Ultralytics Platform supporta una fase diversa del workflow, dai primi test all'utilizzo in produzione. Ecco una panoramica di quando potresti usare ciascuna opzione:
- Scheda Predict: viene generalmente utilizzata subito dopo l'addestramento o il fine-tuning, quando vuoi validare le prestazioni di un modello su dati nuovi usando l'inferenza basata su browser.
- Inferenza condivisa: in questa fase, i modelli possono essere integrati nelle applicazioni tramite API, consentendo di testare le interazioni nel mondo reale durante lo sviluppo.
- Endpoint dedicati: vengono utilizzati per i deployment in produzione, quando i modelli richiedono prestazioni coerenti, risorse dedicate e la capacità di scalare nelle regioni globali.
- Esportazione del modello: quando i modelli devono essere eseguiti al di fuori della piattaforma, l'opzione di esportarli consente il deployment su dispositivi edge, app mobili o infrastrutture personalizzate.
I team passano spesso attraverso queste opzioni in modo graduale, dalla validazione all'integrazione e infine al deployment in produzione, tutto all'interno della piattaforma.
Monitoraggio dei modelli distribuiti tramite Ultralytics Platform#
Per quanto il deployment sia fondamentale, il workflow di visione non finisce qui. Una volta che un modello è in esecuzione in produzione, il monitoraggio continuo è essenziale per assicurarsi che mantenga prestazioni affidabili nel tempo.
Ultralytics Platform offre strumenti di monitoraggio integrati che forniscono ai team una visibilità chiara sul comportamento nel tempo dei loro modelli di AI per la visione, supportando un workflow di operazioni di machine learning (MLOps) più strutturato.
La pagina Deploy include una dashboard che monitora metriche chiave come il numero totale di richieste, i deployment attivi, la latenza delle risposte e i tassi di errore. Questi dati aiutano i team a comprendere i modelli di utilizzo, valutare la reattività del sistema e garantire prestazioni a bassa latenza con carichi di lavoro diversi.
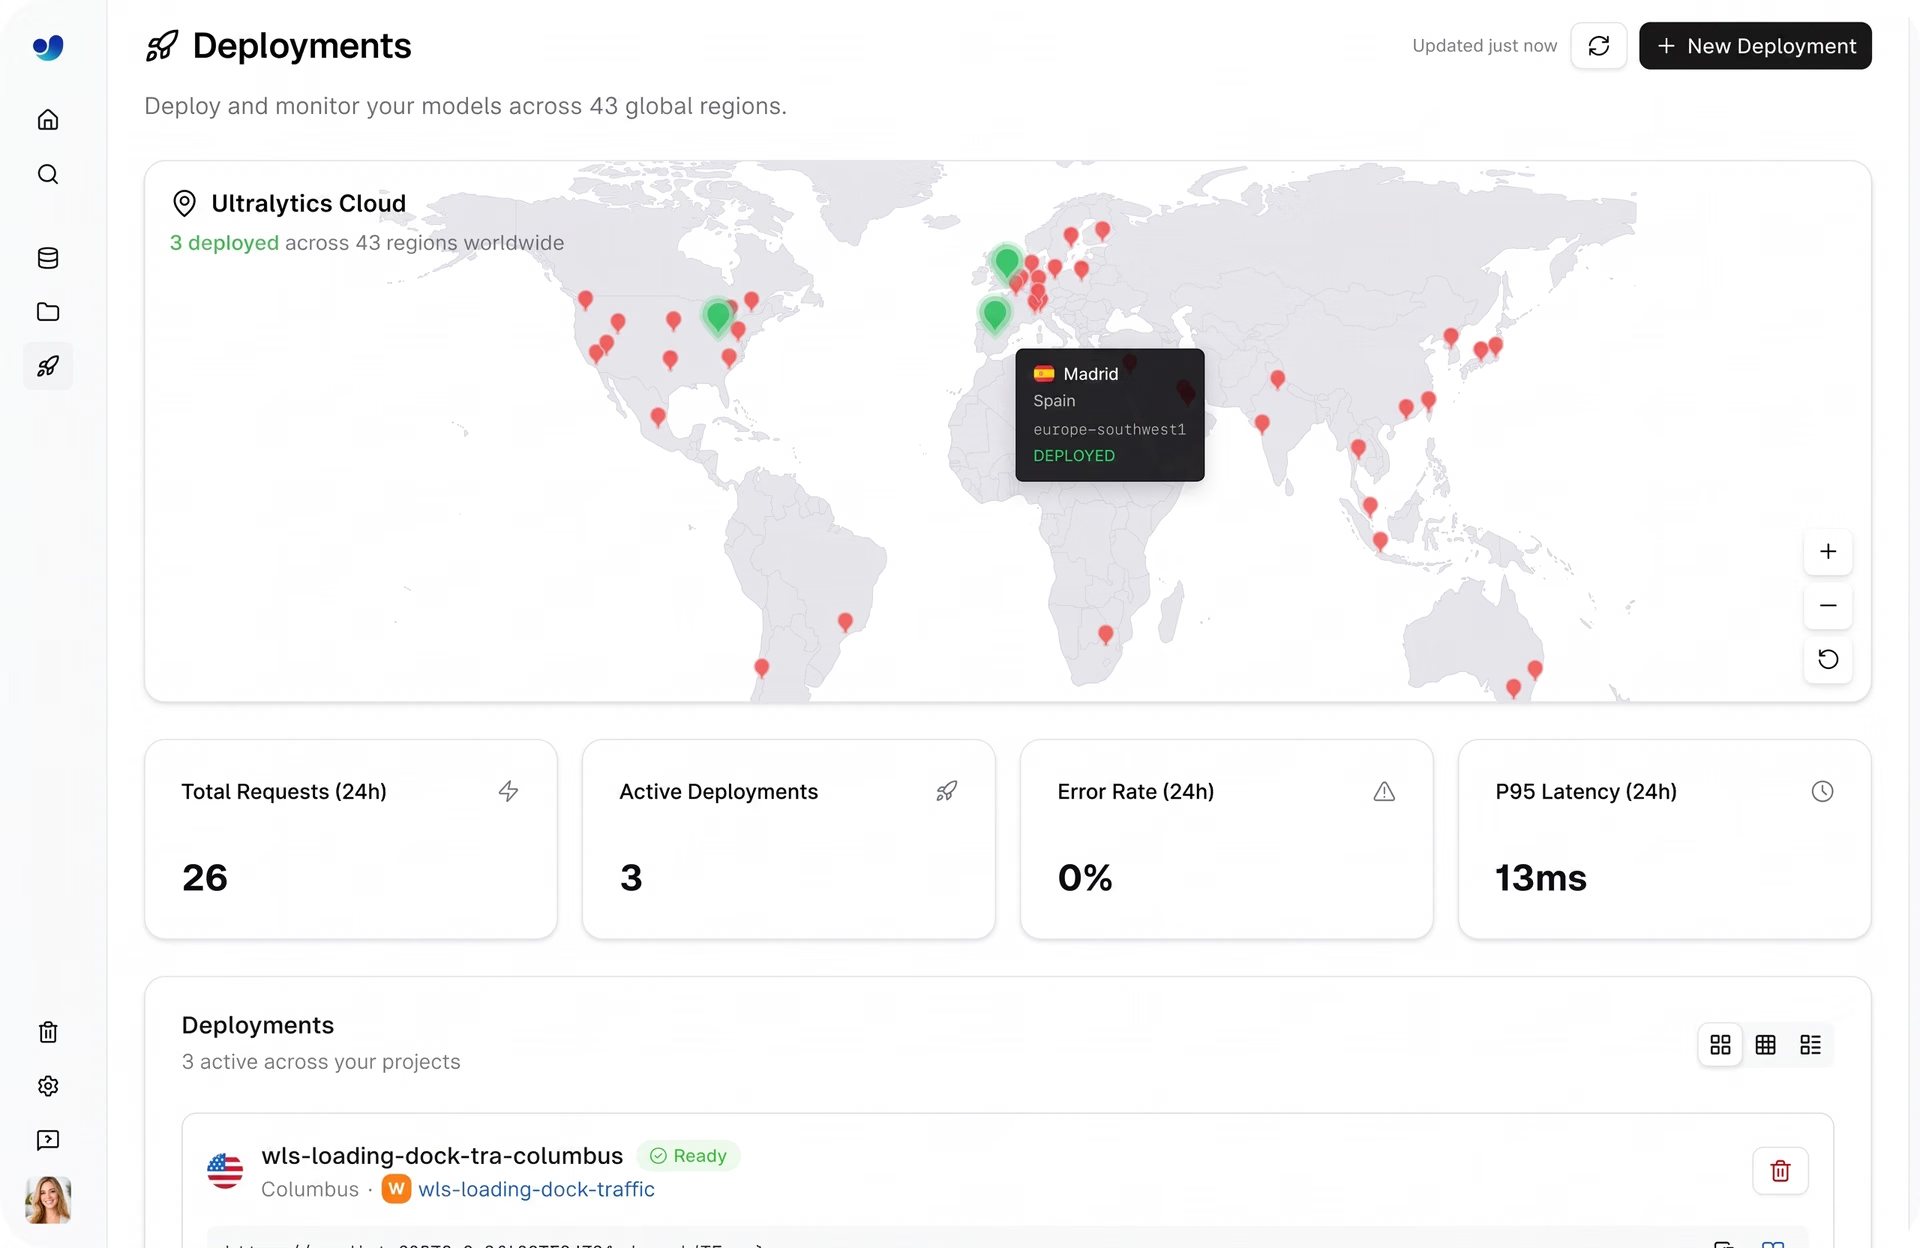
Fig. 5. Ultralytics Platform semplifica il monitoraggio dei modelli distribuiti. (Fonte)
Ogni endpoint dedicato offre inoltre un'osservabilità dettagliata tramite viste individuali dei deployment. Ciò include l'accesso ai log, allo stato di salute del modello e ai dati sulle prestazioni in tempo reale. I log possono essere usati per eseguire il debug dei problemi, tracciare le richieste non riuscite e identificare potenziali problemi legati alle dipendenze o all'infrastruttura.
Con l'evoluzione degli ambienti di produzione, fattori come il cambiamento dei dati di input, le esigenze di scalabilità o la variazione dei modelli di utilizzo possono influire sull'accuratezza e sulla robustezza dei modelli. Monitorando continuamente le metriche delle prestazioni, i team possono rilevare anomalie, identificare colli di bottiglia e adottare azioni correttive, come l'ottimizzazione dei modelli o l'adeguamento delle risorse, per mantenere un model serving coerente e affidabile.
Integrare la scalabilità nei deployment dei modelli di computer vision#
Tradizionalmente, scalare i sistemi di computer vision ha significato mettere insieme workflow e framework che non erano mai stati progettati per funzionare come un tutt'uno. Pipeline di dati, cicli di addestramento, infrastrutture di deployment e sistemi di monitoraggio risiedono spesso in luoghi separati, creando attriti in ogni fase.
La vera sfida non consiste solo nel creare modelli, ma nel mantenerli in movimento. Passare dai dati alla produzione, adattarsi a nuovi input, gestire una domanda crescente e migliorare continuamente senza rallentare.
Ciò che distingue Ultralytics Platform è che questo movimento è integrato. Invece di trattare ogni fase come un passaggio separato, la piattaforma le collega in un ciclo continuo in cui i modelli possono essere sviluppati, distribuiti, osservati e aggiornati nello stesso ambiente.
Questo cambiamento modifica il modo in cui i team scalano. Non si tratta più di orchestrare strumenti o infrastrutture, ma di mantenere lo slancio con la crescita dei sistemi.
Punti chiave#
Portare modelli di machine learning, come i modelli di computer vision, nelle applicazioni del mondo reale richiede che siano affidabili, scalabili e facili da gestire. Ultralytics Platform semplifica questo processo combinando diverse funzioni, come model serving, deployment e monitoraggio, in un unico ambiente unificato. Grazie a opzioni di deployment flessibili e strumenti integrati, i team possono passare dalla sperimentazione alla produzione più rapidamente e con meno complessità.
Visita la nostra community ed esplora il nostro repository GitHub per saperne di più. Consulta le nostre pagine sulle soluzioni per scoprire applicazioni diverse, come l'AI nel settore sanitario e la computer vision nella logistica. Scopri le nostre opzioni di licenza e inizia a creare oggi stesso!








