Monitoraggio dei modelli di computer vision distribuiti su Ultralytics Platform
Scopri come monitorare i modelli di computer vision in produzione con Ultralytics Platform. Tieni traccia delle metriche, rileva i problemi e migliora l'affidabilità.
Testare i modelli di computer vision che analizzano immagini e video non equivale sempre a eseguirli in produzione. Durante lo sviluppo, questi modelli o algoritmi vengono testati su dataset puliti e ben preparati, in condizioni controllate e prevedibili.
Una volta distribuiti, però, lo scenario diventa più dinamico. I modelli sono esposti al traffico reale, in cui il volume delle richieste può variare, i tempi di risposta possono cambiare e possono verificarsi malfunzionamenti occasionali.
A questo punto, l'attenzione si sposta sull'affidabilità del sistema: gli endpoint devono rimanere disponibili, reattivi e stabili al variare delle condizioni.
Ecco perché il monitoraggio è essenziale. Offre una visione chiara del comportamento in produzione degli endpoint distribuiti tramite metriche come il volume delle richieste, la latenza, il tasso di errori e lo stato generale del sistema.
Per semplificare il lavoro, disporre degli strumenti giusti diventa importante quanto il modello stesso. Di recente, Ultralytics ha presentato Ultralytics Platform, il nostro nuovo ambiente end-to-end che riunisce l'intero flusso di lavoro di computer vision, dai dati e dall'addestramento fino alla distribuzione e al monitoraggio.
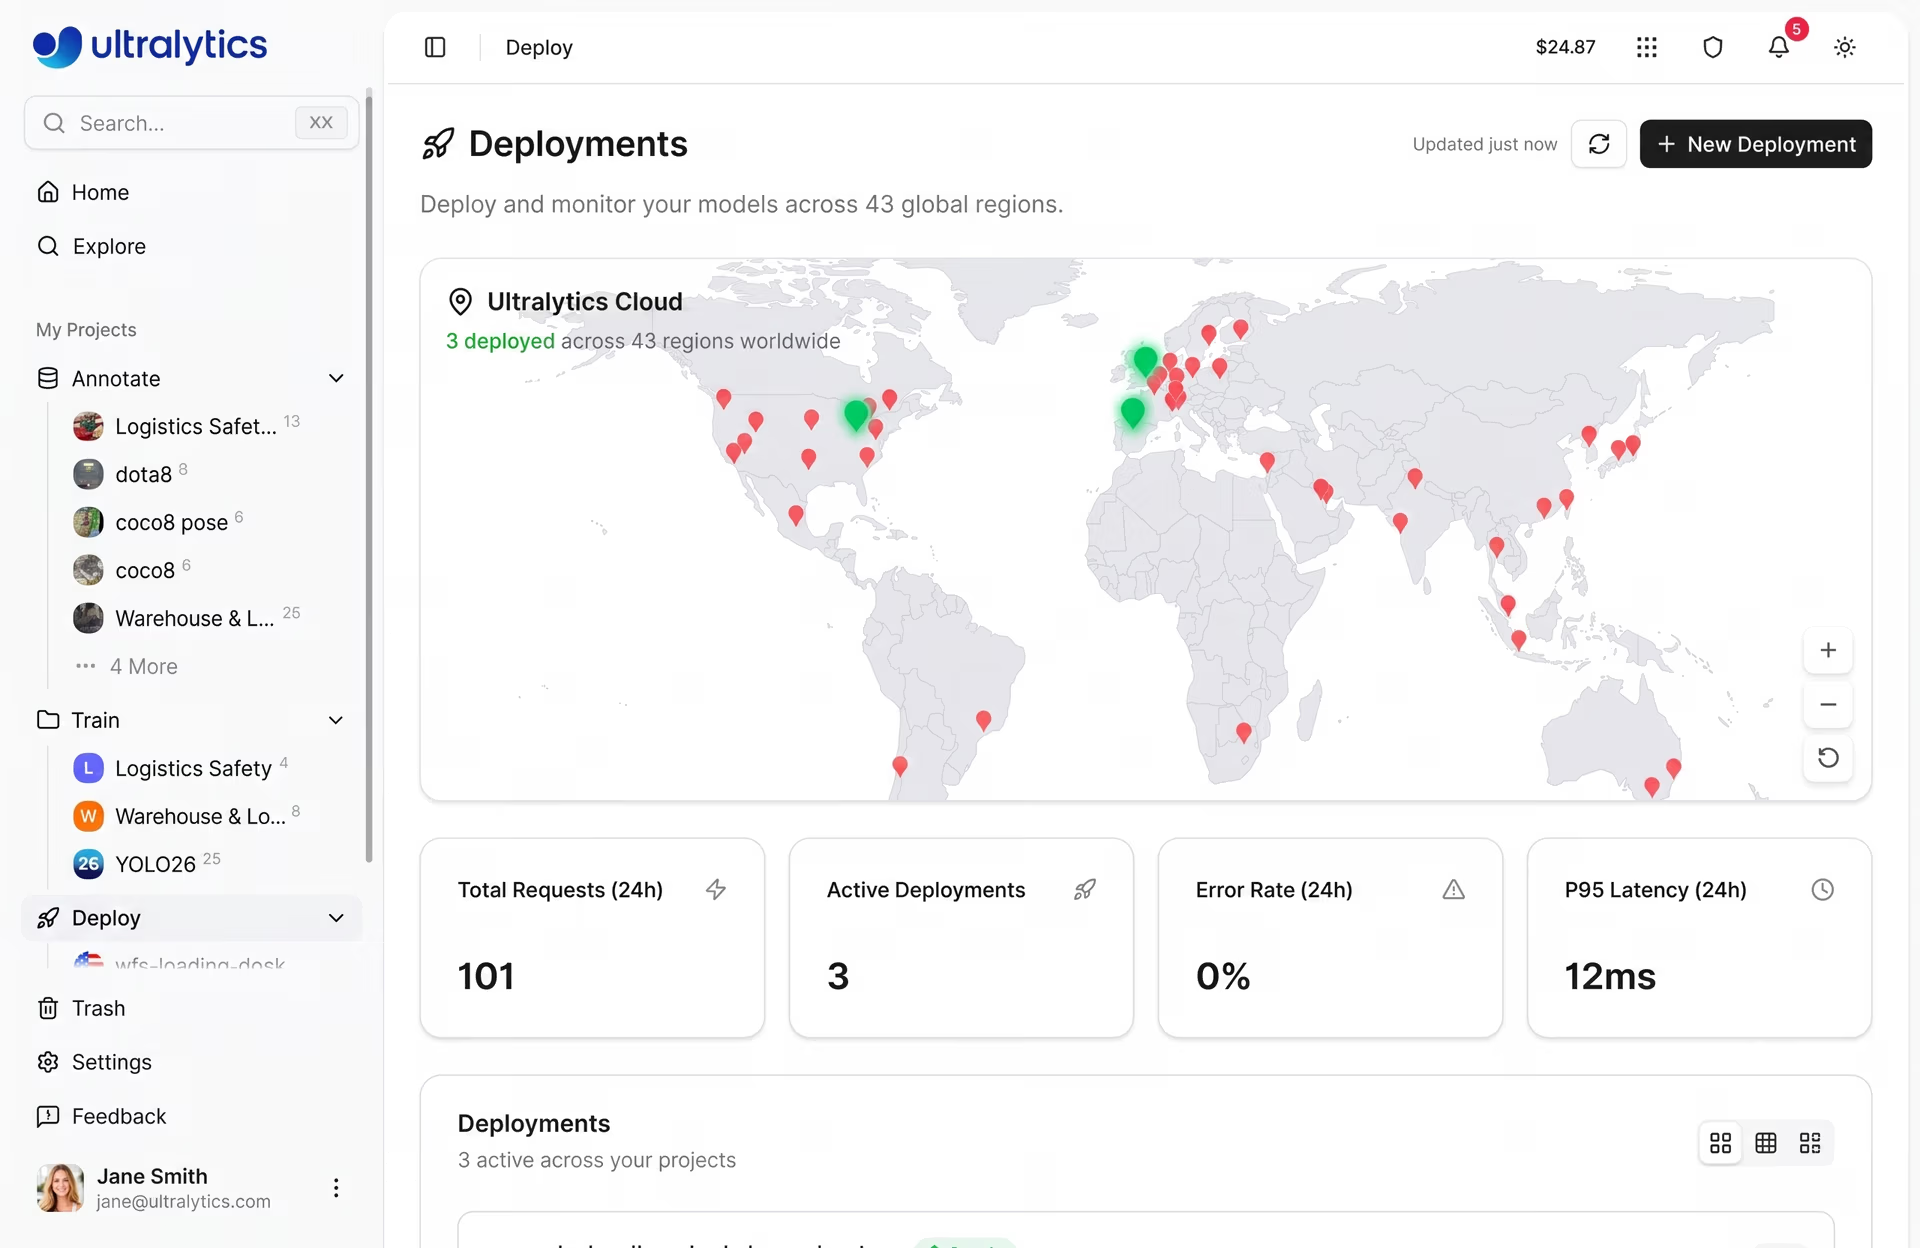
Fig. 1. Dashboard di distribuzione di Ultralytics Platform con funzionalità di monitoraggio (Fonte)
Con il monitoraggio integrato direttamente in questo flusso di lavoro, gli utenti possono controllare lo stato degli endpoint, esaminare il comportamento delle richieste e mantenere sistemi affidabili senza dipendere da strumenti separati. In questo articolo vedremo come usare Ultralytics Platform per monitorare gli endpoint dei modelli distribuiti e mantenere operativi i sistemi di produzione. Iniziamo!
Panoramica sul monitoraggio dei modelli di AI#
Nel ciclo di vita di un modello di AI, il monitoraggio consiste nell'osservare il comportamento dei sistemi distribuiti una volta che il modello è attivo e gestisce richieste reali. Mentre l'addestramento e la convalida mostrano le prestazioni di un modello di machine learning (modello ML) su dataset preparati, il monitoraggio si concentra sul funzionamento dell'endpoint distribuito in un ambiente di produzione.
Una parte fondamentale del monitoraggio consiste nel seguire le metriche a livello di sistema che riflettono affidabilità e reattività. Metriche come la latenza e il tempo di attività aiutano a capire quanto bene il sistema gestisce le richieste in arrivo. La latenza misura il tempo necessario per elaborare una richiesta e restituire una risposta, mentre il tempo di attività indica con quale continuità l'endpoint rimane disponibile.
Un altro aspetto fondamentale è l'osservabilità, che offre visibilità sulla gestione delle richieste. Ogni volta che un input, come un'immagine o un fotogramma video, viene inviato a un modello distribuito, viene elaborato come richiesta di inferenza.
I log registrano queste richieste insieme a dettagli come timestamp, tempi di risposta e codici di stato. Semplificano il tracciamento delle richieste, il debug dei problemi e l'analisi dei malfunzionamenti quando si verificano. Sono particolarmente utili per individuare schemi come errori ripetuti, risposte lente o comportamenti imprevisti del sistema.
Combinando metriche e log, il monitoraggio aiuta gli utenti a capire come funzionano i sistemi in produzione e a intervenire rapidamente quando si presentano problemi.
Confronto tra metriche delle prestazioni del modello e metriche di sistema#
Prima di approfondire il monitoraggio in produzione, vediamo la differenza tra le metriche delle prestazioni del modello e le metriche di sistema.
In genere, il monitoraggio dei modelli è associato alle metriche di valutazione, note anche come metriche del modello, quali accuratezza, precisione, richiamo e mAP (precisione media). Queste metriche descrivono il comportamento del modello e valutano la qualità delle sue predizioni, spesso in relazione ai dati di produzione o ai dati di input. Possono essere particolarmente utili per individuare casi limite o valori anomali nei nuovi dati.
Il monitoraggio di un sistema distribuito in produzione è però diverso. In questo contesto, si concentra sul funzionamento del sistema, anziché valutare direttamente le predizioni del modello.
Invece di basarsi sulle metriche del modello, il monitoraggio della distribuzione si affida a indicatori a livello di sistema, come il volume delle richieste, la latenza, il tasso di errori e il tempo di attività. Queste metriche offrono visibilità sul modo in cui gli endpoint gestiscono i dati di input, sulla coerenza delle risposte e sul funzionamento negli ambienti di produzione.
Il ruolo del monitoraggio dei modelli nei progetti di computer vision#
Ora vediamo un esempio reale che mette in evidenza la necessità di un sistema di monitoraggio nelle distribuzioni di computer vision.
Immagina una soluzione di visione che usa la stima della posa, un'attività di computer vision utilizzata per identificare e analizzare i movimenti del corpo umano, per verificare che gli operai edili rispettino le norme di sicurezza. Durante la distribuzione iniziale del modello, un sistema del genere potrebbe funzionare bene in condizioni controllate, con buona visibilità e scenari standard.
I cantieri reali, però, introducono ulteriori complessità. Il volume delle richieste può variare nel corso della giornata, le condizioni di rete possono essere instabili e più telecamere o endpoint possono inviare dati contemporaneamente. Se il sistema non viene monitorato correttamente, questi fattori possono causare risposte più lente o malfunzionamenti occasionali.
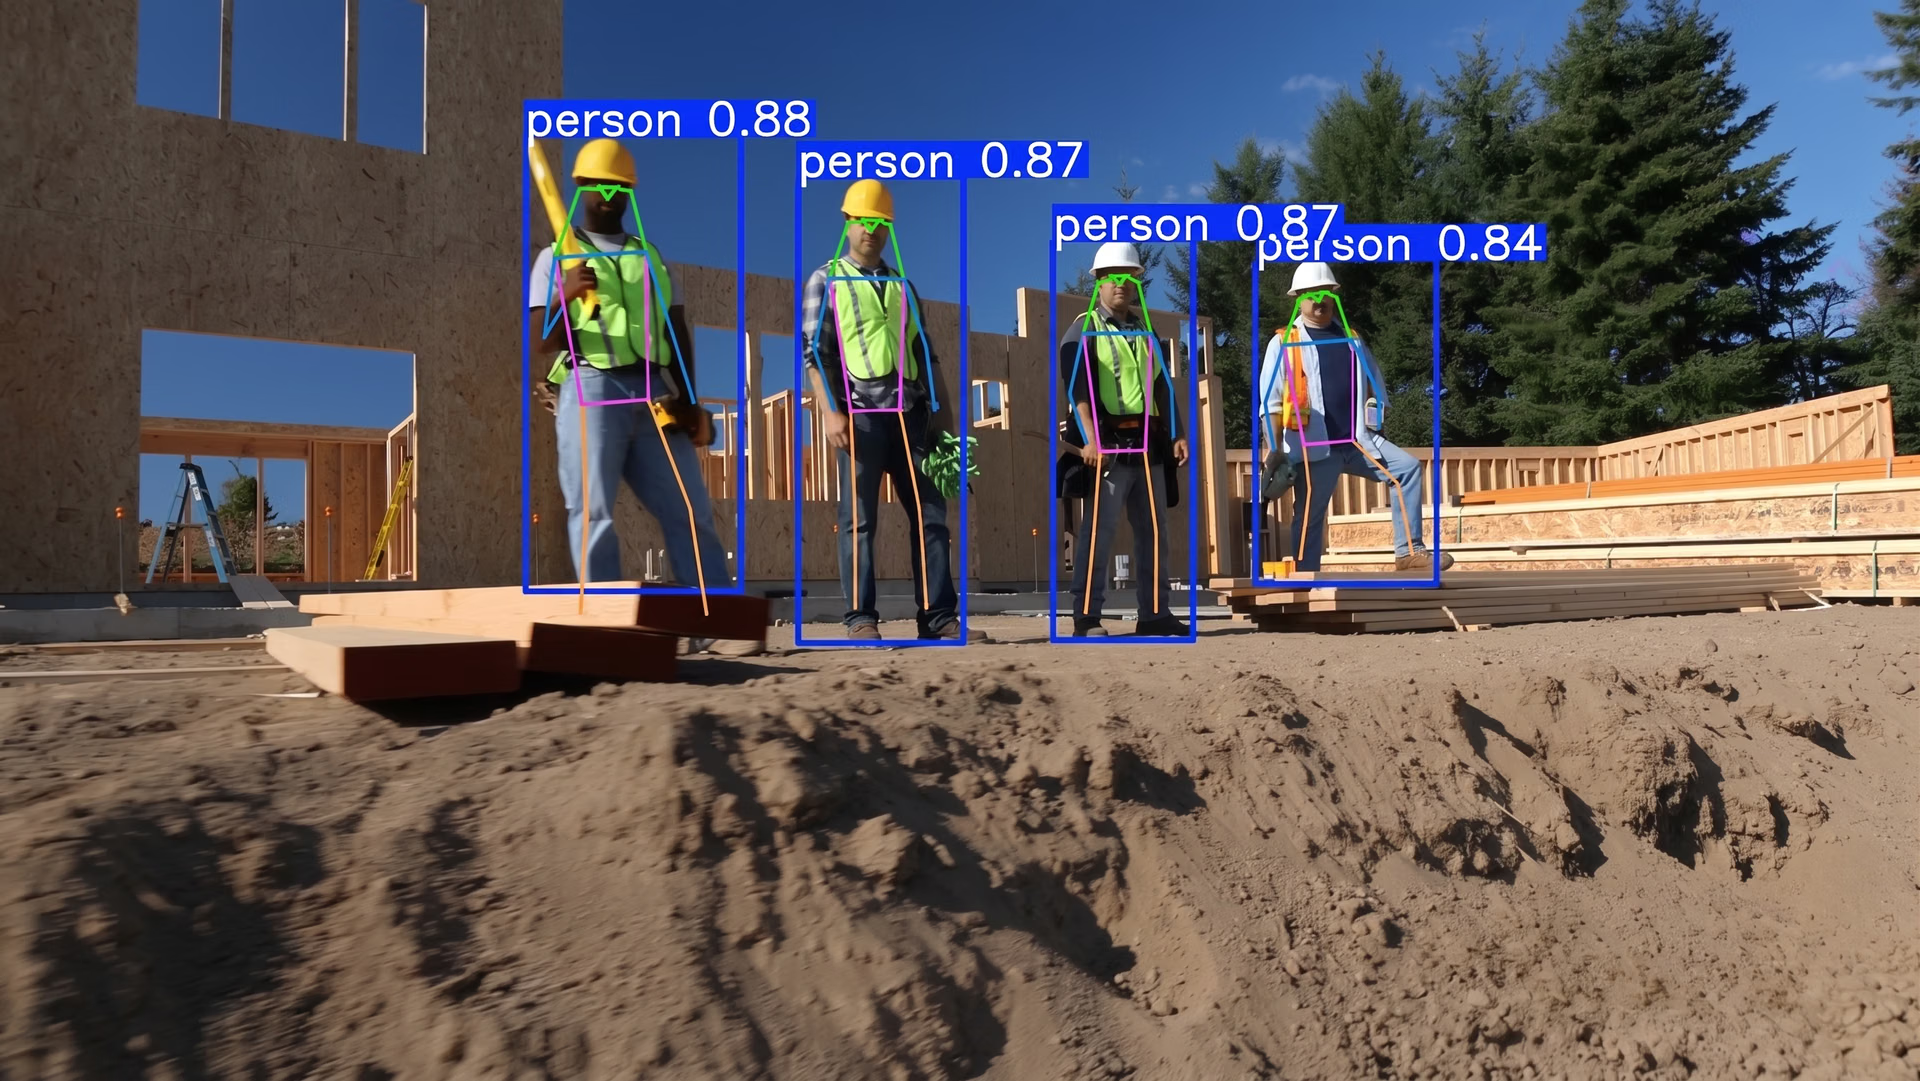
Fig. 2. Utilizzo della stima della posa per monitorare gli operai in un cantiere (Fonte)
In un ambiente di produzione di questo tipo, è importante capire quanto sia affidabile il funzionamento del sistema. Il monitoraggio offre visibilità sulla disponibilità degli endpoint, sulla velocità con cui rispondono alle richieste in arrivo e sulla coerenza con cui gestiscono il traffico nel tempo.
Per esempio, un aumento della latenza può indicare un carico maggiore o vincoli sulle risorse, mentre un incremento del tasso di errori può segnalare problemi nella gestione delle richieste o nella stabilità del sistema. I log aggiungono ulteriore contesto, mostrando come vengono elaborate le singole richieste e dove si verificano i malfunzionamenti.
Monitorando questi indicatori, gli appassionati di AI e i data scientist possono individuare i problemi in anticipo, risolverli in modo più efficace e assicurarsi che i sistemi continuino a funzionare in modo affidabile al variare delle condizioni reali.
Usare Ultralytics Platform per monitorare i modelli di visione distribuiti#
In molti flussi di lavoro di deep learning, il monitoraggio viene spesso gestito con strumenti separati per i log, le metriche e lo stato del sistema. Questa configurazione frammentata può rendere difficile avere una visione chiara del funzionamento in produzione degli endpoint distribuiti e aggiunge complessità alla gestione delle distribuzioni.
Ultralytics Platform semplifica il processo integrando il monitoraggio in un ambiente unificato che copre l'intero flusso di lavoro di computer vision, dall'acquisizione e annotazione dei dati all'addestramento, alla distribuzione e al monitoraggio.
Con questa configurazione integrata, gli utenti possono monitorare la gestione del traffico reale da parte dei propri endpoint distribuiti senza configurare sistemi di log esterni o dashboard aggiuntive. Tutto è disponibile in un unico posto, semplificando l'osservazione del comportamento del sistema e il mantenimento di distribuzioni affidabili nel tempo.
Puoi accedere alle funzionalità di monitoraggio direttamente dalla scheda Deploy. Da un'unica dashboard, gli utenti possono monitorare le metriche principali, analizzare il comportamento delle singole richieste e visualizzare gli andamenti. Queste visualizzazioni integrate facilitano la comprensione delle prestazioni delle soluzioni senza dover passare da uno strumento all'altro.
Riunendo monitoraggio, distribuzione e gestione dei modelli nel flusso di lavoro più ampio, la piattaforma riduce la complessità. In questo modo è più semplice concentrarsi sulla gestione delle distribuzioni, sull'ottimizzazione delle prestazioni del sistema e sul mantenimento dell'affidabilità.
Funzionalità di monitoraggio integrate di Ultralytics Platform#
Nelle distribuzioni reali, il monitoraggio richiede una visione chiara del funzionamento dei sistemi mentre le condizioni cambiano nel tempo. Non si limita a controllare alcune metriche, ma implica capire come si comportano gli endpoint distribuiti nei diversi ambienti e gestire più distribuzioni in modo efficace.
Ispirata ai commenti della comunità di vision AI sulle sfide comuni della computer vision, Ultralytics Platform include diverse funzionalità che rendono il monitoraggio più pratico e scalabile.
Ecco una panoramica di alcune delle funzionalità principali:
- Visibilità globale delle distribuzioni: la pagina Deploy include una mappa interattiva del mondo che mostra le aree di distribuzione e indicatori visivi per gli endpoint attivi e in fase di avvio, consentendo agli utenti di monitorare la distribuzione geografica e l'attività regionale.
- Visualizzazioni flessibili della dashboard: la dashboard delle distribuzioni offre diverse modalità di visualizzazione, tra cui la visualizzazione a schede, la griglia compatta e la visualizzazione tabellare con colonne ordinabili, come nome, regione, stato e richieste, per agevolare il monitoraggio strutturato e il confronto.
- Monitoraggio di più endpoint: la dashboard aggrega i dati di monitoraggio di tutte le distribuzioni usando schede di riepilogo ed elenchi delle distribuzioni.
- Politiche di conservazione dei dati: i dati di monitoraggio vengono conservati per un periodo definito; le metriche sono disponibili per 30 giorni e i log per 7 giorni, a supporto dell'analisi delle prestazioni recenti e dei flussi di lavoro di debug.
- Supporto per il monitoraggio esterno: gli endpoint di distribuzione possono essere monitorati con strumenti esterni come Datadog, New Relic e servizi di monitoraggio del tempo di attività, oppure accessibili tramite endpoint API per monitoraggio personalizzato e controlli dello stato.
Ora esamineremo più nel dettaglio alcune di queste funzionalità e vedremo come possono essere utilizzate per monitorare gli endpoint distribuiti in produzione.
Come monitorare le metriche di prestazione principali con Ultralytics Platform#
Una volta distribuito un modello, il monitoraggio inizia con il tracciamento delle metriche di sistema principali. Mentre metriche come accuratezza e richiamo sono utili durante lo sviluppo, il monitoraggio in produzione si concentra su segnali a livello di sistema, come i tempi di risposta e i tassi di errore, che forniscono informazioni misurabili sull'affidabilità con cui gli endpoint gestiscono il traffico reale.
Ultralytics Platform offre una dashboard centralizzata che mostra chiaramente l'attività degli endpoint e il comportamento del sistema. In particolare, la dashboard Deployment include quattro metriche chiave che mostrano come vengono utilizzati gli endpoint e come rispondono alle richieste in arrivo.
Ecco un'analisi più approfondita di queste metriche:
- Richieste totali: il numero totale di richieste effettuate su tutti gli endpoint nell'arco di 24 ore. Questa metrica aiuta a identificare le tendenze di utilizzo e la domanda complessiva.
- Distribuzioni attive: il numero di endpoint attualmente in esecuzione e che gestiscono richieste.
- Latenza P95: il tempo di risposta entro il quale viene completato il 95% delle richieste. Questa metrica offre una visione più realistica delle prestazioni, tenendo conto delle risposte più lente.
- Tasso di errore: la percentuale di richieste non riuscite sul totale delle richieste. Questa metrica aiuta a individuare i problemi e può essere utilizzata per rilevare anomalie.
In parole semplici, queste metriche offrono una visione chiara del funzionamento degli endpoint distribuiti in produzione. Analizzando le tendenze di utilizzo, i team e i singoli utenti possono comprendere la distribuzione del traffico, individuare i periodi di carico massimo e assicurarsi che i sistemi restino reattivi e affidabili con l'aumentare dell'utilizzo.
Comprendere il comportamento dei modelli distribuiti tramite i log#
Mentre le metriche offrono una visione generale delle prestazioni del sistema, i log mostrano più nel dettaglio come gli endpoint distribuiti gestiscono le singole richieste. I log registrano ogni richiesta inviata a un endpoint insieme alla relativa risposta.
Sono utili per monitorare i problemi, esaminare gli errori e comprendere come vengono elaborate le richieste. In Ultralytics Platform puoi selezionare qualsiasi distribuzione per visualizzarne i dettagli, inclusi i log.
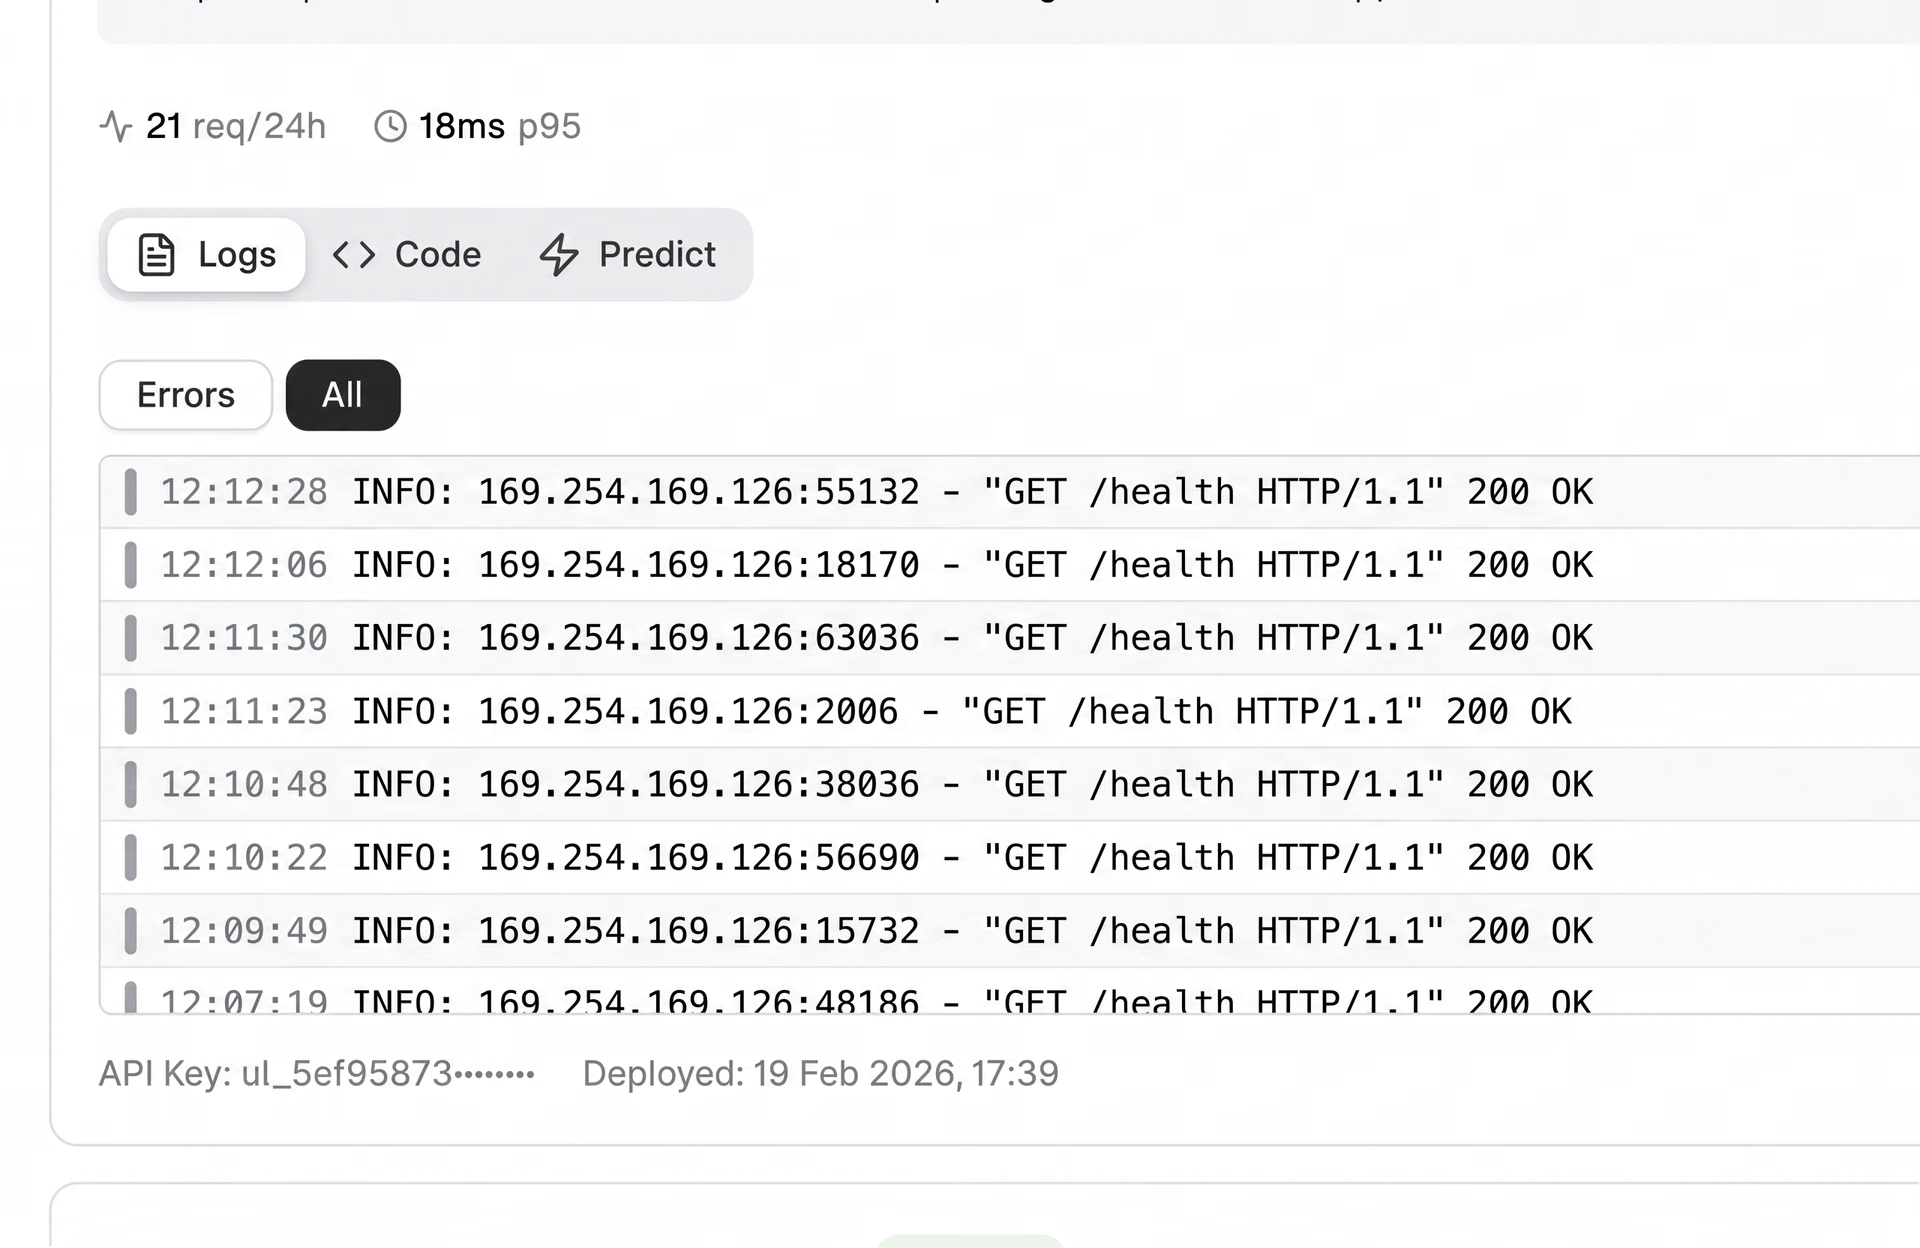
Fig. 3. Un esempio di log in Ultralytics Platform (Fonte)
Una voce di log nella piattaforma viene visualizzata in un formato strutturato, che semplifica la comprensione di ciò che è accaduto durante ogni richiesta. Ogni voce include un livello di gravità, che indica l'importanza dell'evento, insieme a un timestamp che ne mostra l'ora.
Contiene anche un messaggio che descrive l'evento e dettagli relativi a HTTP, come i codici di stato e la latenza. Queste informazioni aiutano a tracciare le richieste, facilitano la risoluzione dei problemi e permettono di eseguire il debug in modo più efficace. Inoltre, i log sono raggruppati per livello di gravità, così gli utenti possono dare la priorità alle distribuzioni che richiedono attenzione.
Analizzare lo stato e l'affidabilità degli endpoint su Ultralytics Platform#
Il monitoraggio comporta anche la comprensione dello stato generale degli endpoint distribuiti, incluso verificare che siano in esecuzione correttamente, rispondano in tempo e gestiscano le richieste con continuità e senza errori. Ultralytics Platform offre una visione chiara dello stato di salute di ogni distribuzione, rendendo semplice verificare che gli endpoint funzionino come previsto.
La piattaforma include indicatori visivi dello stato di salute di ogni distribuzione, mostrati nelle singole schede delle distribuzioni.
Ad esempio, un indicatore verde mostra che l'endpoint è in buono stato e risponde normalmente, mentre un indicatore rosso segnala problemi o un'interruzione del servizio. Un'icona animata indica che il sistema sta controllando attivamente lo stato della distribuzione.
Monitorando nel tempo lo stato degli endpoint, è possibile rilevare tempestivamente i problemi, mantenere prestazioni costanti e garantire un'esperienza stabile alle applicazioni in esecuzione in produzione.
Il legame tra i dati di monitoraggio e il miglioramento delle prestazioni#
Il monitoraggio dei modelli non consiste soltanto nel tenere traccia delle metriche. Crea un ciclo di feedback che favorisce il miglioramento continuo nel tempo. Quando gli endpoint gestiscono traffico reale, nei log e nelle metriche emergono tendenze che possono rivelare problemi come un aumento della latenza, tassi di errore più elevati o un comportamento del sistema incoerente.
Il monitoraggio mette in evidenza le aree che richiedono attenzione. Ad esempio, una latenza costantemente elevata può indicare la necessità di allocare meglio le risorse o di aumentare la capacità, mentre un tasso di errore in crescita può segnalare problemi nella gestione delle richieste o nella stabilità del sistema.
Una volta individuati questi problemi, è possibile intervenire per migliorare l'affidabilità. Potrebbe essere necessario modificare l'infrastruttura, aumentare le risorse o correggere il modo in cui vengono elaborate le richieste. Dopo queste modifiche, si può continuare a monitorare i sistemi per verificare che le prestazioni siano migliorate.
Collegando il monitoraggio ai miglioramenti continui, gli utenti possono mantenere sistemi solidi anche quando l'utilizzo cresce e le condizioni cambiano.
Un esempio concreto: il monitoraggio della gestione dei bagagli in ambito aeronautico#
Per comprendere meglio l'impatto del monitoraggio in uno scenario reale, vediamo come si applica all'automazione delle operazioni aeroportuali a terra.
Prendiamo un sistema di visione progettato per monitorare il carico e lo scarico dei bagagli durante le operazioni a terra degli aeromobili. In questo contesto, un modello di rilevamento degli oggetti come Ultralytics YOLO26 può essere utilizzato per rilevare se i bagagli cadono dai nastri trasportatori o dalle attrezzature di movimentazione.
Durante i test e le prime fasi della distribuzione, il sistema in tempo reale può offrire buone prestazioni, identificando accuratamente i bagagli e rispondendo rapidamente.
In un aeroporto operativo, però, le condizioni sono molto meno prevedibili. L'illuminazione cambia nel corso della giornata, più videocamere trasmettono dati contemporaneamente e il volume delle richieste aumenta nei periodi di maggiore attività. Questi fattori possono far aumentare la latenza o causare errori e, senza visibilità sul sistema, tali problemi possono facilmente passare inosservati.
È qui che il monitoraggio diventa prezioso. Tracciando metriche come il volume delle richieste, la latenza e i tassi di errore insieme a log dettagliati, i team possono individuare rapidamente quando un endpoint rallenta o smette di funzionare. Se la latenza aumenta nelle ore di punta, potrebbe essere necessario aumentare le risorse; un improvviso incremento degli errori, invece, può segnalare problemi con specifiche videocamere o con la gestione delle richieste. Intervenire sulla base di questi segnali aiuta a mantenere affidabile il sistema, così da continuare a monitorare accuratamente la gestione dei bagagli anche quando le condizioni cambiano.
Punti chiave#
Il monitoraggio mantiene affidabili i modelli di visione artificiale distribuiti quando escono dalle condizioni controllate dello sviluppo e iniziano a gestire traffico reale. Concentrandosi su segnali a livello di sistema come il volume delle richieste, la latenza, i tassi di errore e il tempo di attività, insieme a log dettagliati, il monitoraggio offre la visibilità necessaria per rilevare tempestivamente i problemi e mantenere i sistemi di produzione in piena efficienza.
Integrando il monitoraggio direttamente nel flusso di lavoro di distribuzione, Ultralytics Platform semplifica il tracciamento dello stato degli endpoint, l'esame del comportamento delle richieste e la manutenzione di sistemi affidabili, senza dover ricorrere a strumenti separati. Riunendo dati, addestramento, distribuzione e monitoraggio in un unico posto, la piattaforma aiuta i team a passare dalla sperimentazione a distribuzioni affidabili in scenari reali.
Unisciti alla nostra community in crescita ed esplora il nostro repository GitHub per saperne di più sull'IA per la visione. Per sviluppare oggi con l'IA per la visione, scopri le nostre opzioni di licenza. Scopri come l'IA nel settore manifatturiero e l'IA in ambito sanitario stanno plasmando il futuro visitando le nostre pagine dedicate alle soluzioni.









