5 motivos pelos quais os modelos de visão computacional falham em produção
Saiba por que os modelos de visão computacional falham em produção, desde incompatibilidades nos dados até a latência, e como as equipes podem melhorar o desempenho dos modelos em sistemas reais de IA visual.
 Abirami Vina10 min de leitura
A visão computacional é agora uma tecnologia essencial de inteligência artificial, adotada na maioria dos setores, que permite às máquinas interpretar e analisar dados visuais para diversas tarefas. Estes sistemas dão suporte a muitas aplicações do mundo real, desde imagiologia médica e robótica até à produção e à automação do comércio retalhista.
No entanto, criar um sistema de visão computacional nem sempre é simples. Normalmente, envolve desenvolver um modelo de IA visual treinado para identificar padrões em imagens e vídeos e dar suporte a tarefas como a deteção e o seguimento de objetos.
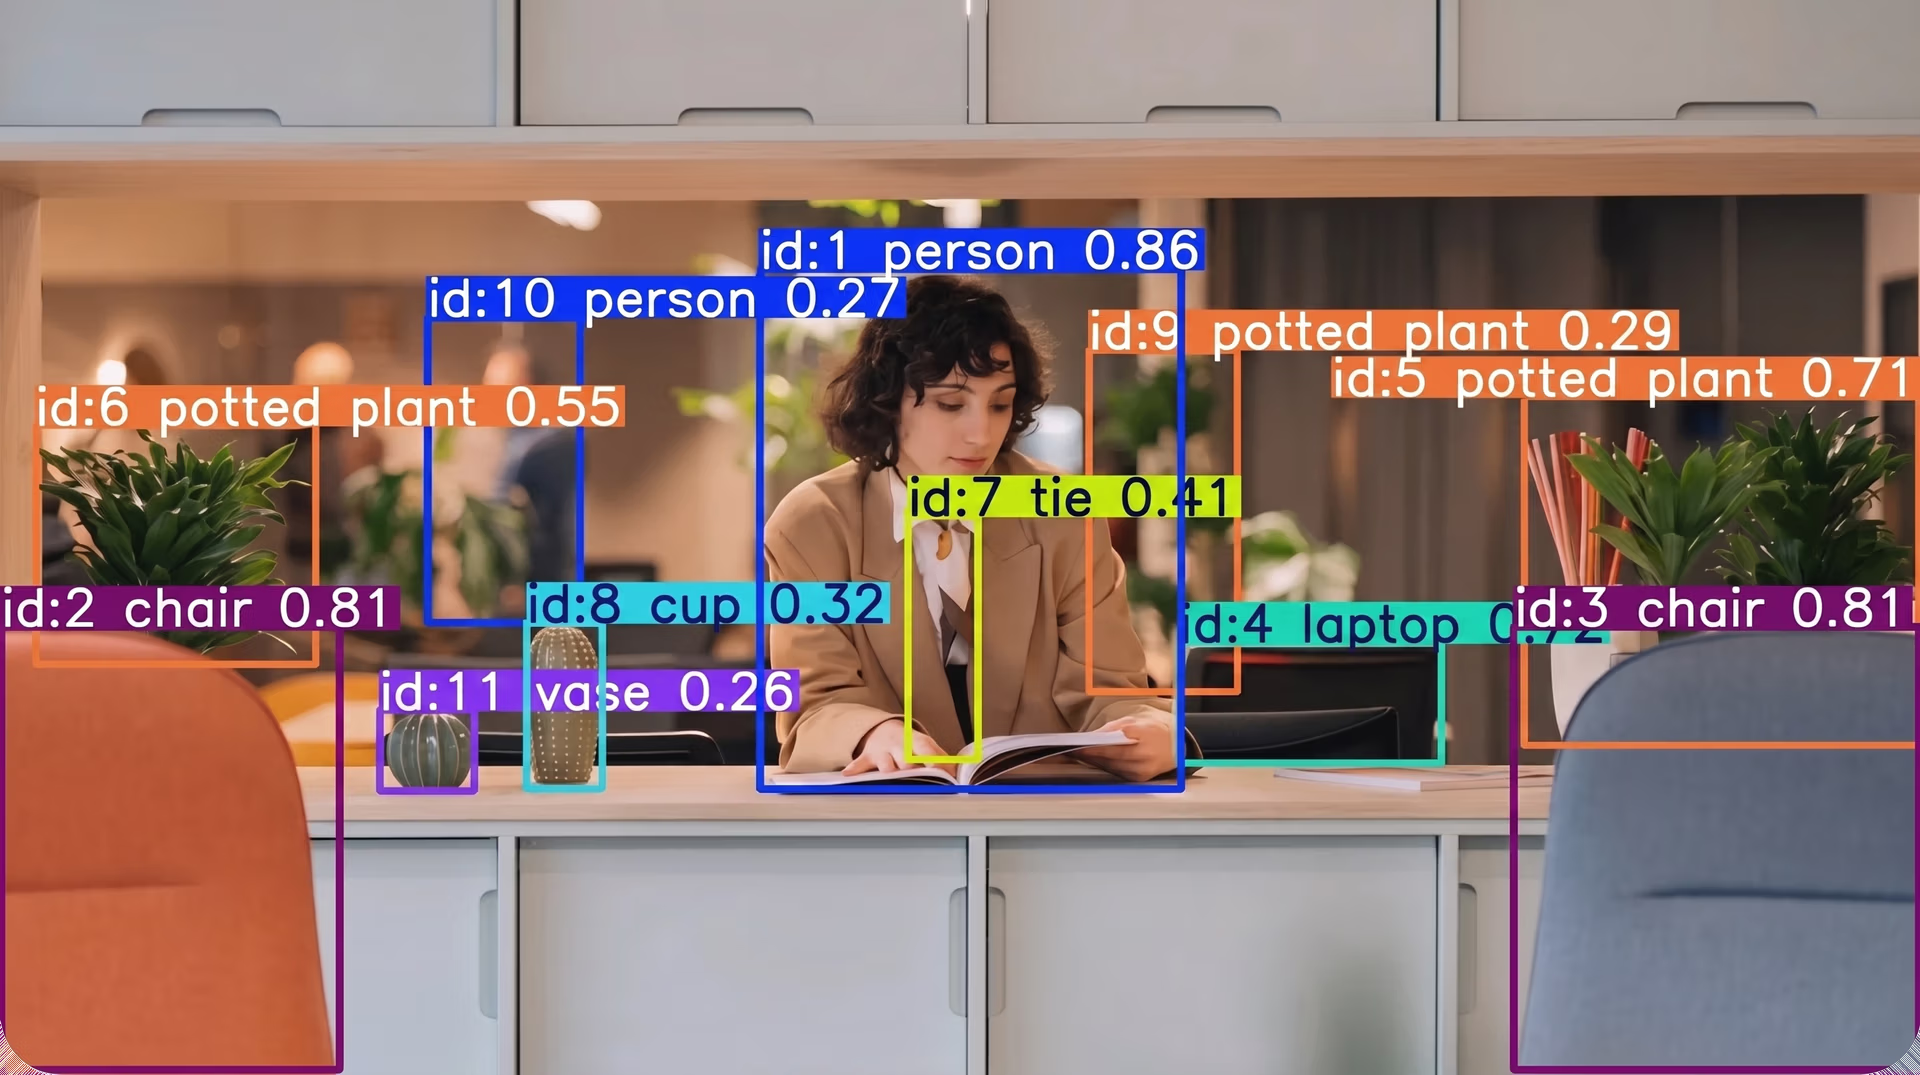
Fig. 1. Exemplo de deteção e seguimento de objetos (Fonte)
Apesar dos avanços dos últimos anos, os modelos de visão computacional ainda podem comportar-se de forma diferente durante o desenvolvimento e após a implementação em ambientes reais. Isto acontece porque a implementação de modelos fora de contextos de desenvolvimento controlados introduz desafios novos e muitas vezes inesperados.
Fatores como a falta de diversidade nos conjuntos de dados, a monitorização deficiente dos modelos e as limitações de infraestrutura podem fazer com que o mesmo modelo se comporte de forma diferente no mundo real após a implementação.
Neste artigo, vamos explorar cinco motivos comuns pelos quais os modelos de visão computacional podem não ter um bom desempenho em produção.
A lacuna entre o treino do modelo e a produção#
O treino de modelos ocorre normalmente num ambiente controlado. Nesta fase, os programadores de IA trabalham com conjuntos de dados de treino cuidadosamente preparados.
Estas vastas coleções de dados visuais incluem anotações bem estruturadas, ou rótulos que descrevem o conteúdo de cada imagem. O treino também decorre em condições consistentes, permitindo que os modelos de IA visual aprendam padrões visuais de forma eficaz.
Para garantir que estes padrões são aprendidos corretamente, os modelos podem ser avaliados sistematicamente durante o desenvolvimento, usando métricas de avaliação padrão e conjuntos de dados de referência. Tal como os conjuntos de dados de treino, estes conjuntos de dados de referência também são cuidadosamente preparados.
No entanto, os dados encontrados pelos sistemas de visão computacional no mundo real podem ser muito diferentes dos dados usados durante o treino e a avaliação. Depois de implementados, estes modelos raramente funcionam em condições controladas.
Podem acabar por processar imagens e vídeos de ambientes imprevisíveis, onde a iluminação muda constantemente, os ângulos da câmara variam e os fundos se alteram ao longo do tempo. Por exemplo, um modelo de IA visual treinado para a deteção de trânsito pode ter dificuldade em detetar veículos à noite se tiver sido treinado e avaliado sobretudo com imagens diurnas.
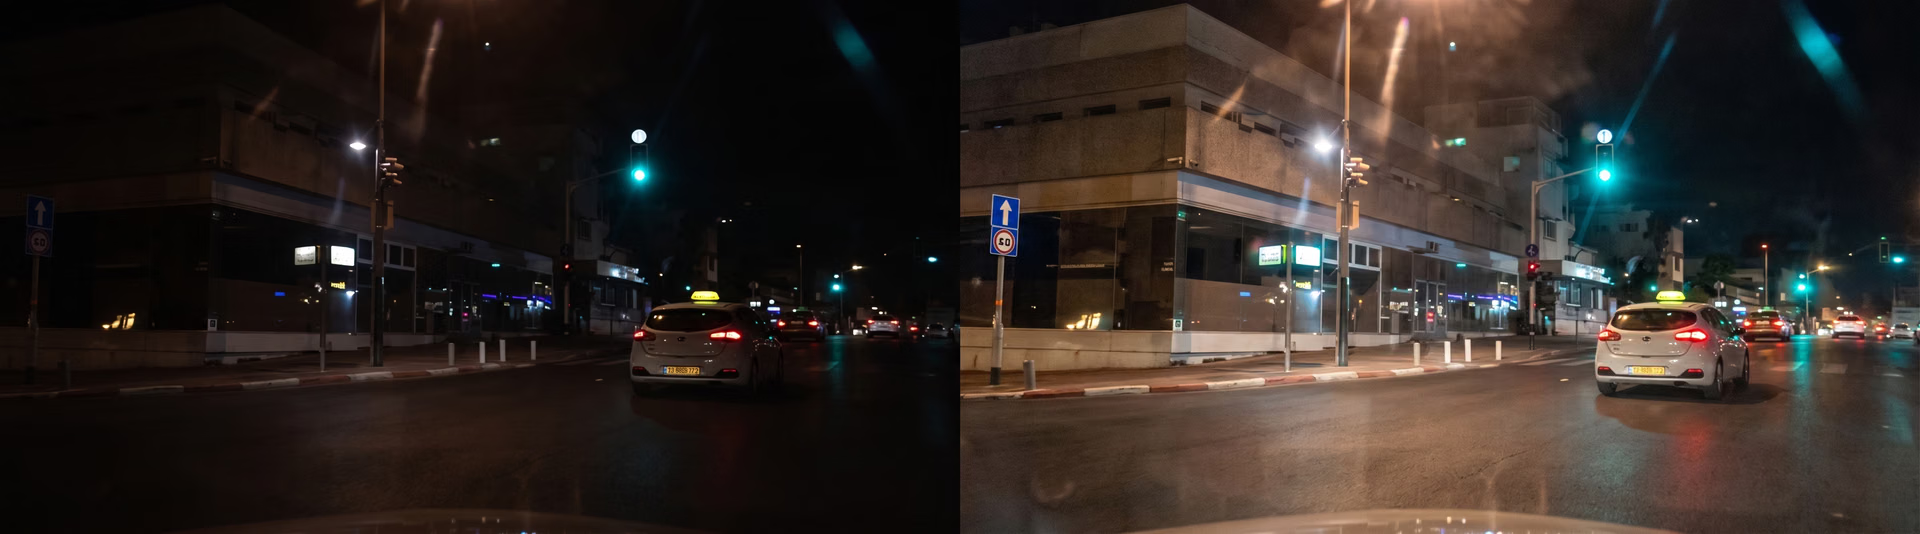
Fig. 2. Mesmo após o melhoramento, é difícil para os modelos treinados com imagens diurnas interpretar imagens noturnas. (Fonte)
Essa diferença entre o desenvolvimento e a implantação no mundo real é a lacuna entre treinamento e produção. Por causa dessa lacuna, muitas falhas de modelos só se tornam visíveis após a implantação, tornando essencial conhecer desde cedo o caminho do laboratório à produção para criar sistemas de visão computacional mais confiáveis e robustos.
5 motivos comuns para os modelos de visão computacional falharem em produção#
A seguir, vamos analisar mais de perto cinco motivos comuns para os modelos de visão computacional falharem em produção.
1. Conjuntos de dados de treino de baixa qualidade#
Os conjuntos de dados desempenham um papel central no treino de modelos de visão computacional, porque determinam o que o modelo aprende durante o treino e como reage a dados de entrada do mundo real após a implementação. Isto é particularmente importante na aprendizagem supervisionada, em que os modelos aprendem a partir de exemplos rotulados que mostram o que cada imagem representa.
Muitos modelos de aprendizagem profunda, incluindo redes neurais convolucionais (CNNs), dependem destes exemplos rotulados para reconhecer padrões em dados visuais. No entanto, quando o conjunto de dados de treino não reflete as condições do mundo real, o modelo pode aprender padrões que não representam totalmente o aspeto dos objetos fora dos dados de treino.
Por exemplo, um modelo treinado com um conjunto de dados de grandes defeitos em forma de fissura pode não detetar um tipo raro de fissura pequena em fluxos de trabalho industriais reais. Da mesma forma, a qualidade das anotações também pode afetar o comportamento do modelo. Rótulos inconsistentes ou a falta de detalhes nos dados rotulados podem levar o modelo a aprender informações incorretas durante o treino.
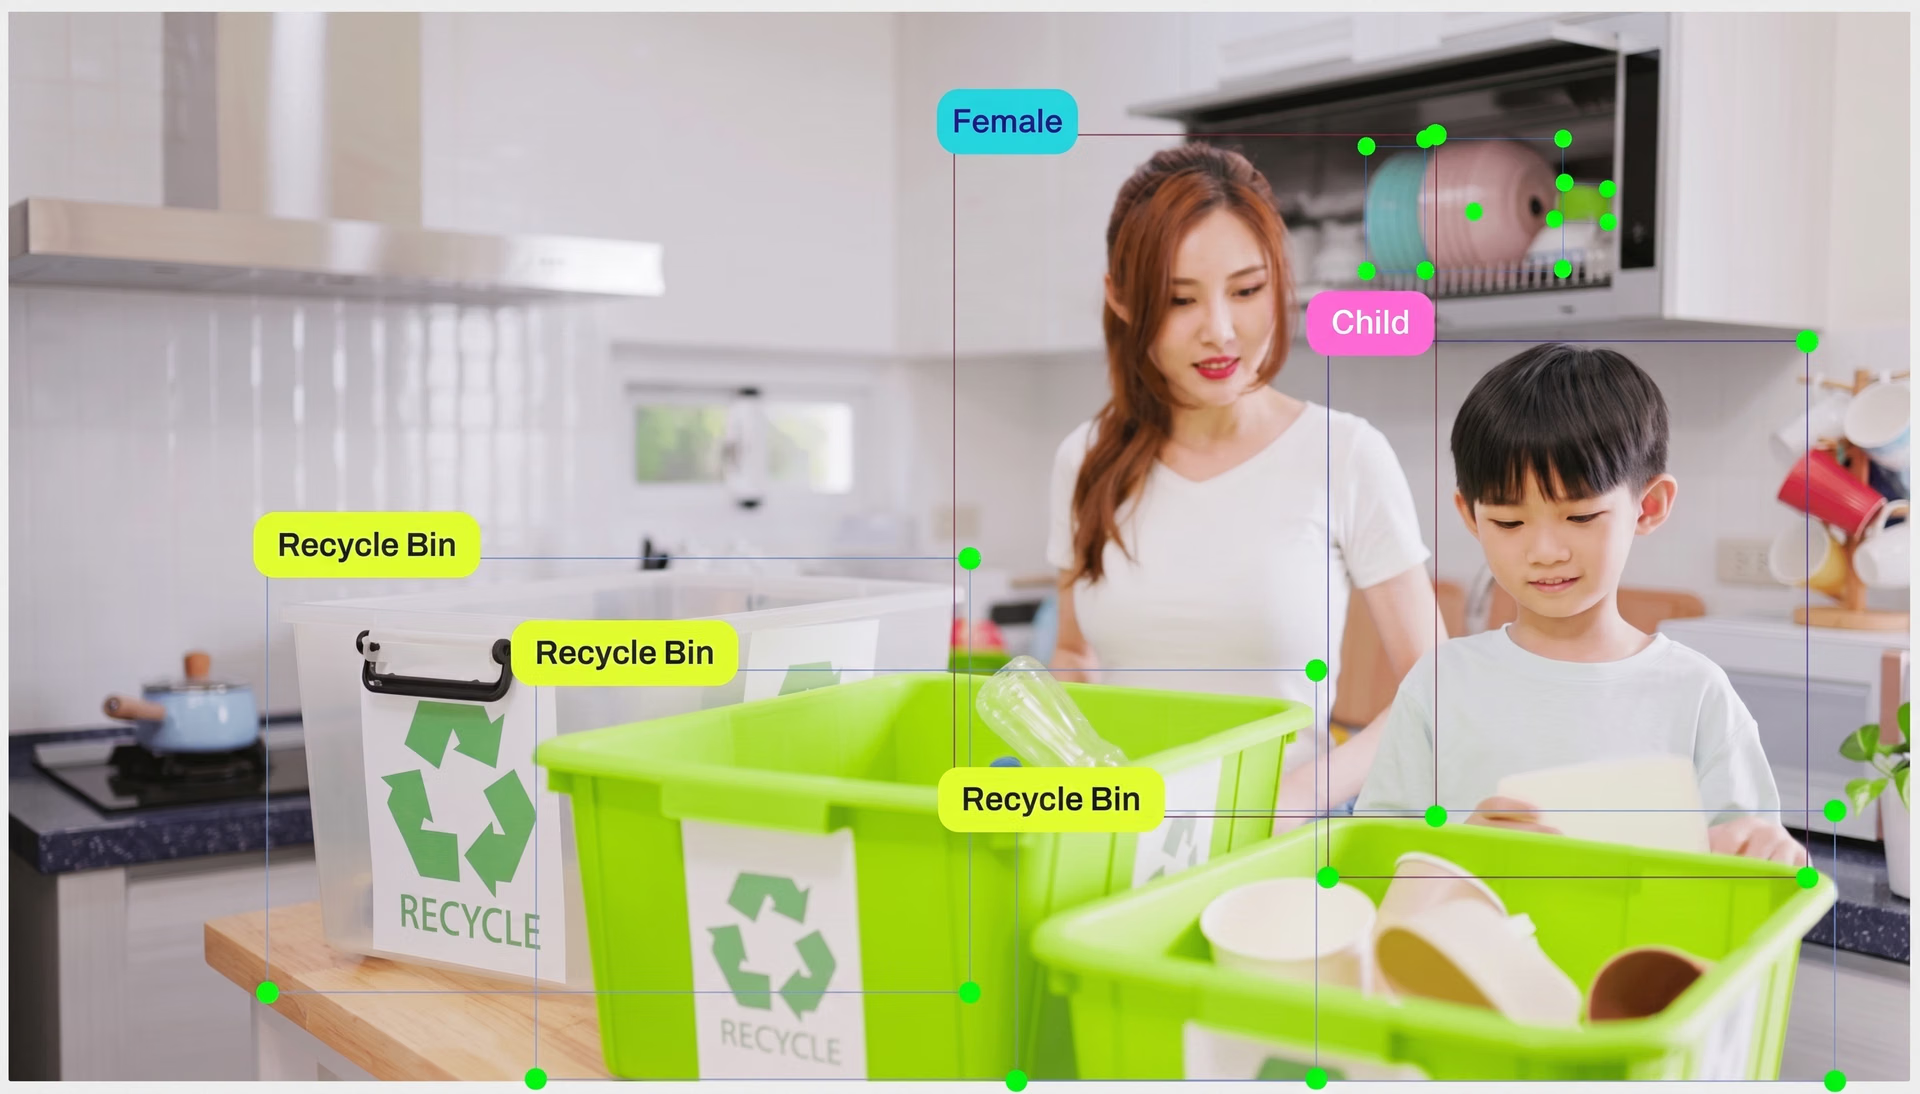
Fig. 3. Um exemplo de anotações de imagens (Fonte)
De modo geral, a qualidade e a diversidade dos dados de treino são essenciais e podem determinar o desempenho de um modelo em aplicações do mundo real. Quando os conjuntos de dados são representativos e estão corretamente rotulados, o modelo tende a ter um desempenho mais fiável após a implementação.
2. Sobreajuste e generalização#
Os modelos de aprendizagem automática, como os modelos de visão, aprendem padrões a partir de conjuntos de dados de treino. Mas, por vezes, um modelo pode depender demasiado de alguns padrões.
Em vez de aprender relações visuais mais abrangentes, pode acabar por memorizar os padrões limitados dos dados de treino. Este comportamento é conhecido como sobreajuste.
O sobreajuste ocorre normalmente quando os conjuntos de dados de treino são pequenos ou não têm diversidade suficiente. Nestes casos, o modelo torna-se bom a reconhecer imagens que já viu, mas tem dificuldade em interpretar dados novos ou entradas desconhecidas.
Como resultado, um modelo pode ter um bom desempenho nos dados de teste (por serem semelhantes aos dados de treinamento), mas se comportar de outra forma em novas condições após a implantação. Por isso, o conceito de generalização é fundamental. Em poucas palavras, trata-se da capacidade dos modelos de aplicar o que aprenderam durante o treinamento a novos cenários.
Para reduzir o sobreajuste, os profissionais costumam treinar modelos com conjuntos de dados mais diversificados e aplicar aumento de dados, um método que modifica ligeiramente as imagens de treinamento para criar mais variação nos dados. Sem essas considerações, o desempenho do modelo pode cair rapidamente quando o sistema começa a operar em ambientes reais.
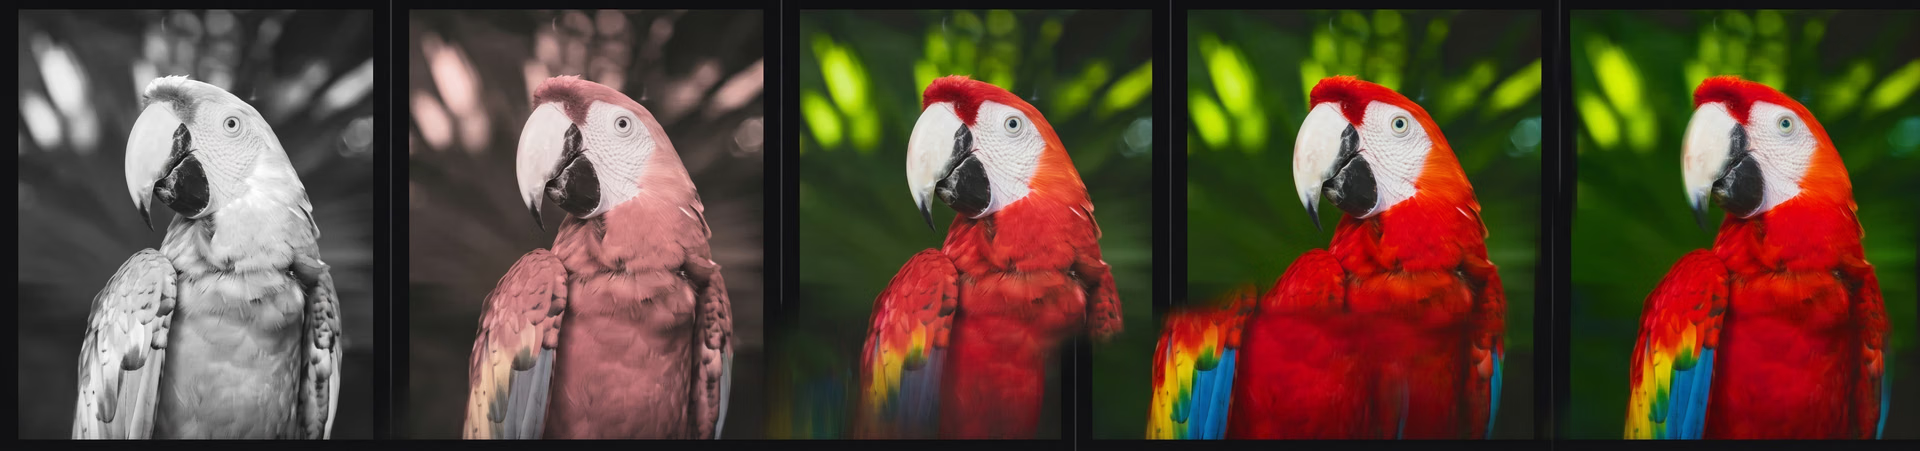
Fig. 4. O aumento de dados pode ajudar a criar variações da mesma imagem num conjunto de dados. (Fonte)
3. Casos extremos ocultos em ambientes reais#
Mesmo quando os modelos de visão computacional generalizam bem para dados novos, os ambientes reais podem introduzir casos extremos inesperados. São situações invulgares que diferem dos padrões típicos aprendidos pelo modelo durante o treino.
Muitos destes cenários são difíceis de captar durante o desenvolvimento porque ocorrem raramente, são difíceis de reproduzir ou podem ser dispendiosos de recolher como dados de treino. Por exemplo, os objetos podem surgir com formas invulgares, mover-se de forma imprevisível ou ficar parcialmente ocultos por outros objetos.
Alterações na iluminação, nos ângulos da câmara ou nas condições do fundo também podem criar situações que dificultam o reconhecimento. Estes casos extremos só costumam ser notados depois de o sistema ser implementado em aplicações do mundo real.
Na robótica e na automação industrial, por exemplo, os artigos podem ser colocados ou posicionados de forma diferente da esperada, criando situações para as quais o modelo não foi concebido. Em última análise, previsões que pareciam fiáveis durante os testes podem tornar-se menos consistentes quando o sistema funciona em ambientes reais.
4. Falta de monitorização e depuração após a implementação#
Além de desenvolver um modelo de IA visual, é essencial monitorizar e melhorar o seu desempenho. No entanto, depois de um sistema entrar em funcionamento, o foco costuma passar a ser simplesmente mantê-lo operacional, em vez de acompanhar de perto o seu desempenho ao longo do tempo. Como resultado, alterações no comportamento do modelo podem passar despercebidas.
Ao mesmo tempo, fatores como mudanças nos dados recebidos, nas configurações das câmeras ou nos ambientes de operação podem afetar gradualmente a precisão com que o modelo detecta ou classifica objetos. Essas mudanças nem sempre são óbvias e podem passar despercebidas durante a operação diária.
A monitorização das saídas do modelo e do comportamento geral do sistema pode ajudar as equipas a identificar estes problemas mais cedo. Verificações regulares, rotinas de validação e fluxos de trabalho de depuração permitem investigar resultados invulgares e perceber o que os pode estar a causar.
Em áreas como a produção industrial, por exemplo, um modelo pode identificar subitamente de forma incorreta objetos numa linha de montagem após uma alteração na configuração da câmara. Acompanhar o comportamento de um sistema de IA visual implementado facilita a resposta a estas alterações e a manutenção de um desempenho estável em ambientes reais.
5. Limitações de infraestrutura e latência#
Muitos sistemas de visão computacional têm de funcionar em tempo real, o que pode sobrecarregar significativamente o hardware, as redes e os fluxos de processamento. Quando os recursos são limitados, podem ocorrer atrasos de cálculo ou latência de rede, fazendo com que as previsões demorem demasiado a chegar e afetando o desempenho geral do sistema.
Em alguns casos, os modelos avançados de aprendizagem profunda também podem criar desafios de infraestrutura. Por exemplo, as arquiteturas baseadas em Transformer foram concebidas para processar grandes quantidades de dados visuais e aprender relações complexas nas imagens, mas muitas vezes exigem recursos computacionais consideráveis. A execução destes modelos pode exigir hardware mais potente ou dispendioso.
Sem a otimização adequada, até os modelos que funcionam rapidamente durante os testes podem ficar mais lentos ou comportar-se de forma inconsistente após a implementação. Para resolver este problema, as equipas otimizam frequentemente os fluxos de processamento, reduzem a complexidade dos modelos sempre que possível e equilibram a precisão com a velocidade.
Isto pode envolver a compressão de modelos grandes em versões mais leves, a utilização de arquiteturas mais eficientes ou o processamento de imagens com resoluções mais baixas para que o sistema funcione sem problemas no hardware disponível. Em muitos casos, as equipas também escolhem modelos leves e mais rápidos, como o Ultralytics YOLO26, para cumprir os requisitos de implementação.
Boas práticas para evitar falhas em modelos de visão computacional#
Seguem-se algumas boas práticas que podem ajudar a reduzir as falhas ao implementar modelos de visão computacional em produção:
- Usa estratégias de implementação faseada: introduz gradualmente os modelos em produção para que as equipas possam observar o seu comportamento e fazer ajustes quando necessário.
- Incorpora ciclos de feedback: recolhe novas imagens e analisa as previsões incorretas para voltar a treinar os modelos com conjuntos de dados atualizados e melhorar o desempenho ao longo do tempo.
- Documenta as limitações do modelo: regista claramente as situações em que o modelo pode ter dificuldades para que as equipas possam antecipar possíveis problemas durante a implementação.
- Projete para a variabilidade do mundo real: Planejar antecipadamente para variações na iluminação, nos ângulos das câmeras, no posicionamento dos objetos ou nas condições do fundo pode ajudar os modelos a permanecerem estáveis em diferentes cenários operacionais.
Principais conclusões#
Os modelos de visão computacional raramente falham por os próprios algoritmos serem fracos. Na maioria dos casos, o verdadeiro desafio está nos ambientes em que estes sistemas funcionam. Os modelos com bom desempenho durante o treino deparam-se muitas vezes com condições imprevisíveis do mundo real que podem afetar o seu comportamento.
É por isso que criar sistemas de IA visual fiáveis exige mais do que simplesmente treinar um modelo. Também implica preparar cuidadosamente os conjuntos de dados, monitorizar o desempenho do modelo após a implementação e adaptar continuamente os sistemas às condições do mundo real.
Queres saber mais sobre IA visual? Junta-te à nossa comunidade e lê sobre aplicações como a IA no setor automóvel e a visão computacional na logística. Consulta as nossas opções de licenciamento para começares os teus projetos de visão computacional. Visita o nosso repositório do GitHub para saberes mais.
Escrito por
Criador de conteúdo · Ultralytics
Comentários
Faça uma pergunta, compartilhe seus resultados ou ajude alguém.









