Explorando o aprendizado supervisionado vs. não supervisionado em visão computacional
Saiba quais são as diferenças entre aprendizado supervisionado e não supervisionado em visão computacional e como escolher a abordagem certa para seus dados e objetivos do projeto.
A inteligência artificial (AI) tem como conceito central ensinar máquinas a aprender e raciocinar de maneiras semelhantes à inteligência humana. Assim como as pessoas aprendem por diferentes métodos, como por instrução direta ou observando padrões e experiências, os sistemas de IA e aprendizado de máquina são projetados para seguir essas mesmas abordagens.
Especificamente, no caso dos algoritmos de aprendizado de máquina, os sistemas são treinados para aprender com dados, em vez de serem programados explicitamente para cada tarefa. Em vez de depender de regras fixas, os modelos de aprendizado de máquina identificam padrões nos dados e os usam para fazer previsões ou tomar decisões.
Por exemplo, a visão computacional é um ramo da IA e do aprendizado de máquina que se concentra em permitir que os sistemas interpretem e compreendam informações visuais, como imagens e vídeos. Desde reconhecer objetos até identificar padrões ocultos em grandes conjuntos de dados, esses sistemas dependem muito da forma como são treinados para aprender.
Diversas técnicas de aprendizado de IA são usadas para treinar esses sistemas, dependendo do tipo de dados disponíveis e do problema a resolver.
Alguns modelos de visão computacional aprendem com dados rotulados, nos quais cada entrada é associada à resposta correta, ou seja, cada imagem ou ponto de dados vem com um rótulo predefinido que informa ao modelo o que ele representa. Isso permite que o modelo aprenda a relação entre a entrada e a saída esperada, melhorando sua capacidade de fazer previsões precisas sobre dados novos que ainda não viu.
Outros modelos de visão aprendem com dados não rotulados, sem respostas predefinidas, e se concentram, em vez disso, em identificar padrões e relações nos próprios dados. Essas abordagens são conhecidas, respectivamente, como aprendizado supervisionado e aprendizado não supervisionado, e formam a base de muitos sistemas de visão computacional de ponta.
Neste artigo, vamos explorar o aprendizado supervisionado e o não supervisionado, como são usados em visão computacional e como escolher a abordagem mais adequada para seu projeto de IA de visão. Vamos começar!
Como as abordagens de aprendizado de IA impulsionam a visão computacional#
Você pode pensar na inteligência artificial como um guarda-chuva que abrange várias tecnologias que permitem às máquinas realizar tarefas que normalmente exigem inteligência humana. Dentro desse guarda-chuva, o aprendizado de máquina é uma área fundamental que permite aos sistemas aprender com dados, em vez de depender apenas de regras fixas.
No aprendizado de máquina, diferentes técnicas de aprendizado determinam como um modelo aprende e melhora ao longo do tempo. Abordagens como aprendizado supervisionado (aprender com dados rotulados e respostas corretas), aprendizado não supervisionado (identificar padrões em dados não rotulados), aprendizado por reforço (aprender por tentativa e erro usando feedback ou recompensas) e aprendizado semissupervisionado (combinar uma pequena quantidade de dados rotulados com uma grande quantidade de dados não rotulados) definem como os sistemas processam dados de entrada e geram dados de saída.
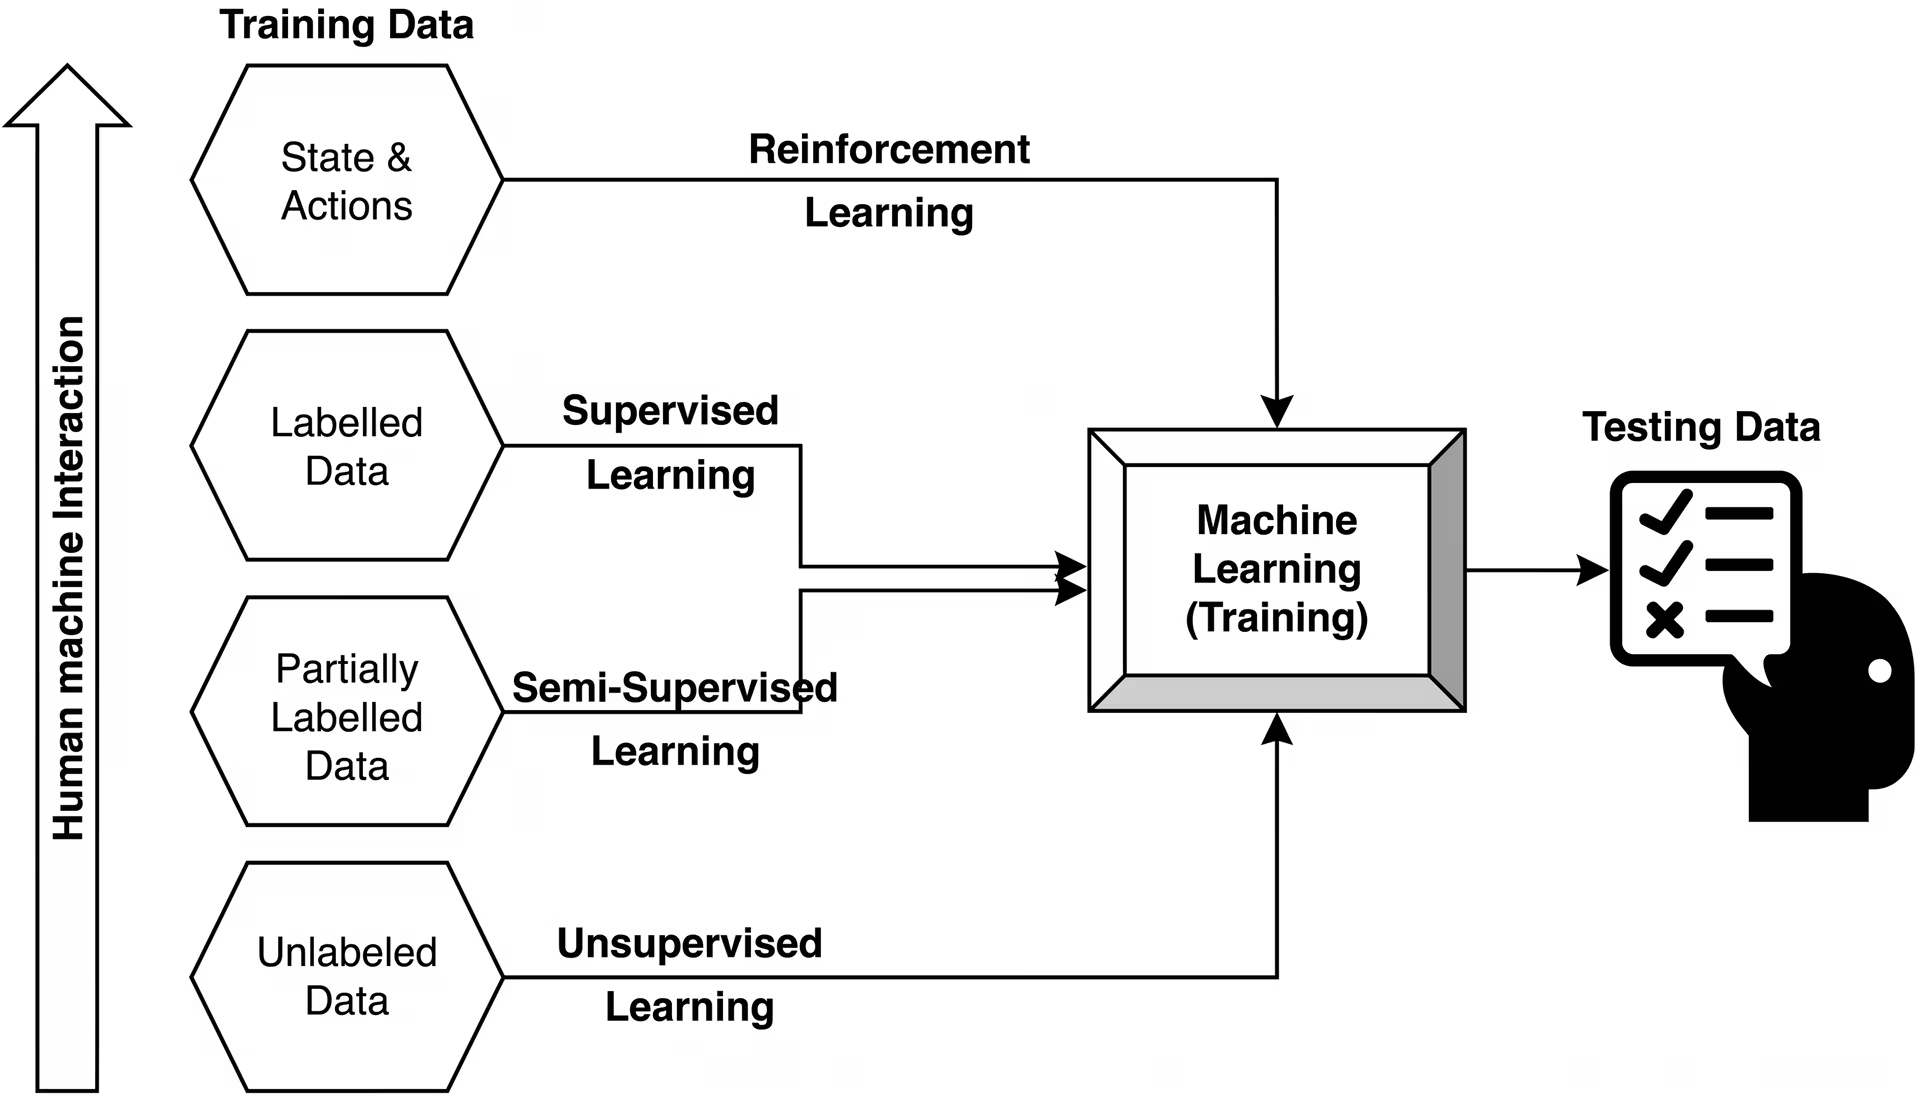
Fig. 1. Visão geral dos métodos de aprendizado de IA (Fonte)
Em particular, os sistemas de visão computacional são desenvolvidos com essas abordagens de aprendizado para interpretar e compreender dados visuais. O aprendizado supervisionado é o método mais usado, pois permite que os modelos aprendam com exemplos claramente rotulados e produzam resultados precisos e confiáveis.
Por exemplo, um modelo pode ser treinado com imagens rotuladas como “gato” e “cachorro”, aprendendo características como formato, orelhas e estrutura facial para classificar corretamente novas imagens usando algoritmos de classificação. O aprendizado não supervisionado e o semissupervisionado também são usados em visão computacional, muitas vezes para explorar padrões nos dados ou melhorar o desempenho quando há poucos dados rotulados.
Uma análise do uso de modelos de aprendizado supervisionado em visão computacional#
Você pode comparar os algoritmos de aprendizado supervisionado com uma sala de aula, onde um professor fornece exemplos com as respostas corretas para que os alunos aprendam o que está certo e o que está errado. No aprendizado de máquina, os modelos aprendem de maneira semelhante usando dados rotulados, nos quais cada entrada é associada a uma saída conhecida.
Digamos que você esteja desenvolvendo um sistema de visão computacional que automatize a análise de jogos de beisebol. Você poderia treinar um modelo como o Ultralytics YOLO26 com imagens ou quadros de vídeo nos quais objetos como a bola, o bastão e os jogadores estejam rotulados.
Cada objeto seria marcado com sua localização e categoria, permitindo que o modelo aprendesse o que procurar. Com o tempo, o modelo pode detectar e localizar esses objetos em novas gravações, viabilizando casos de uso como o rastreamento da bola e a detecção de jogadores entre quadros.
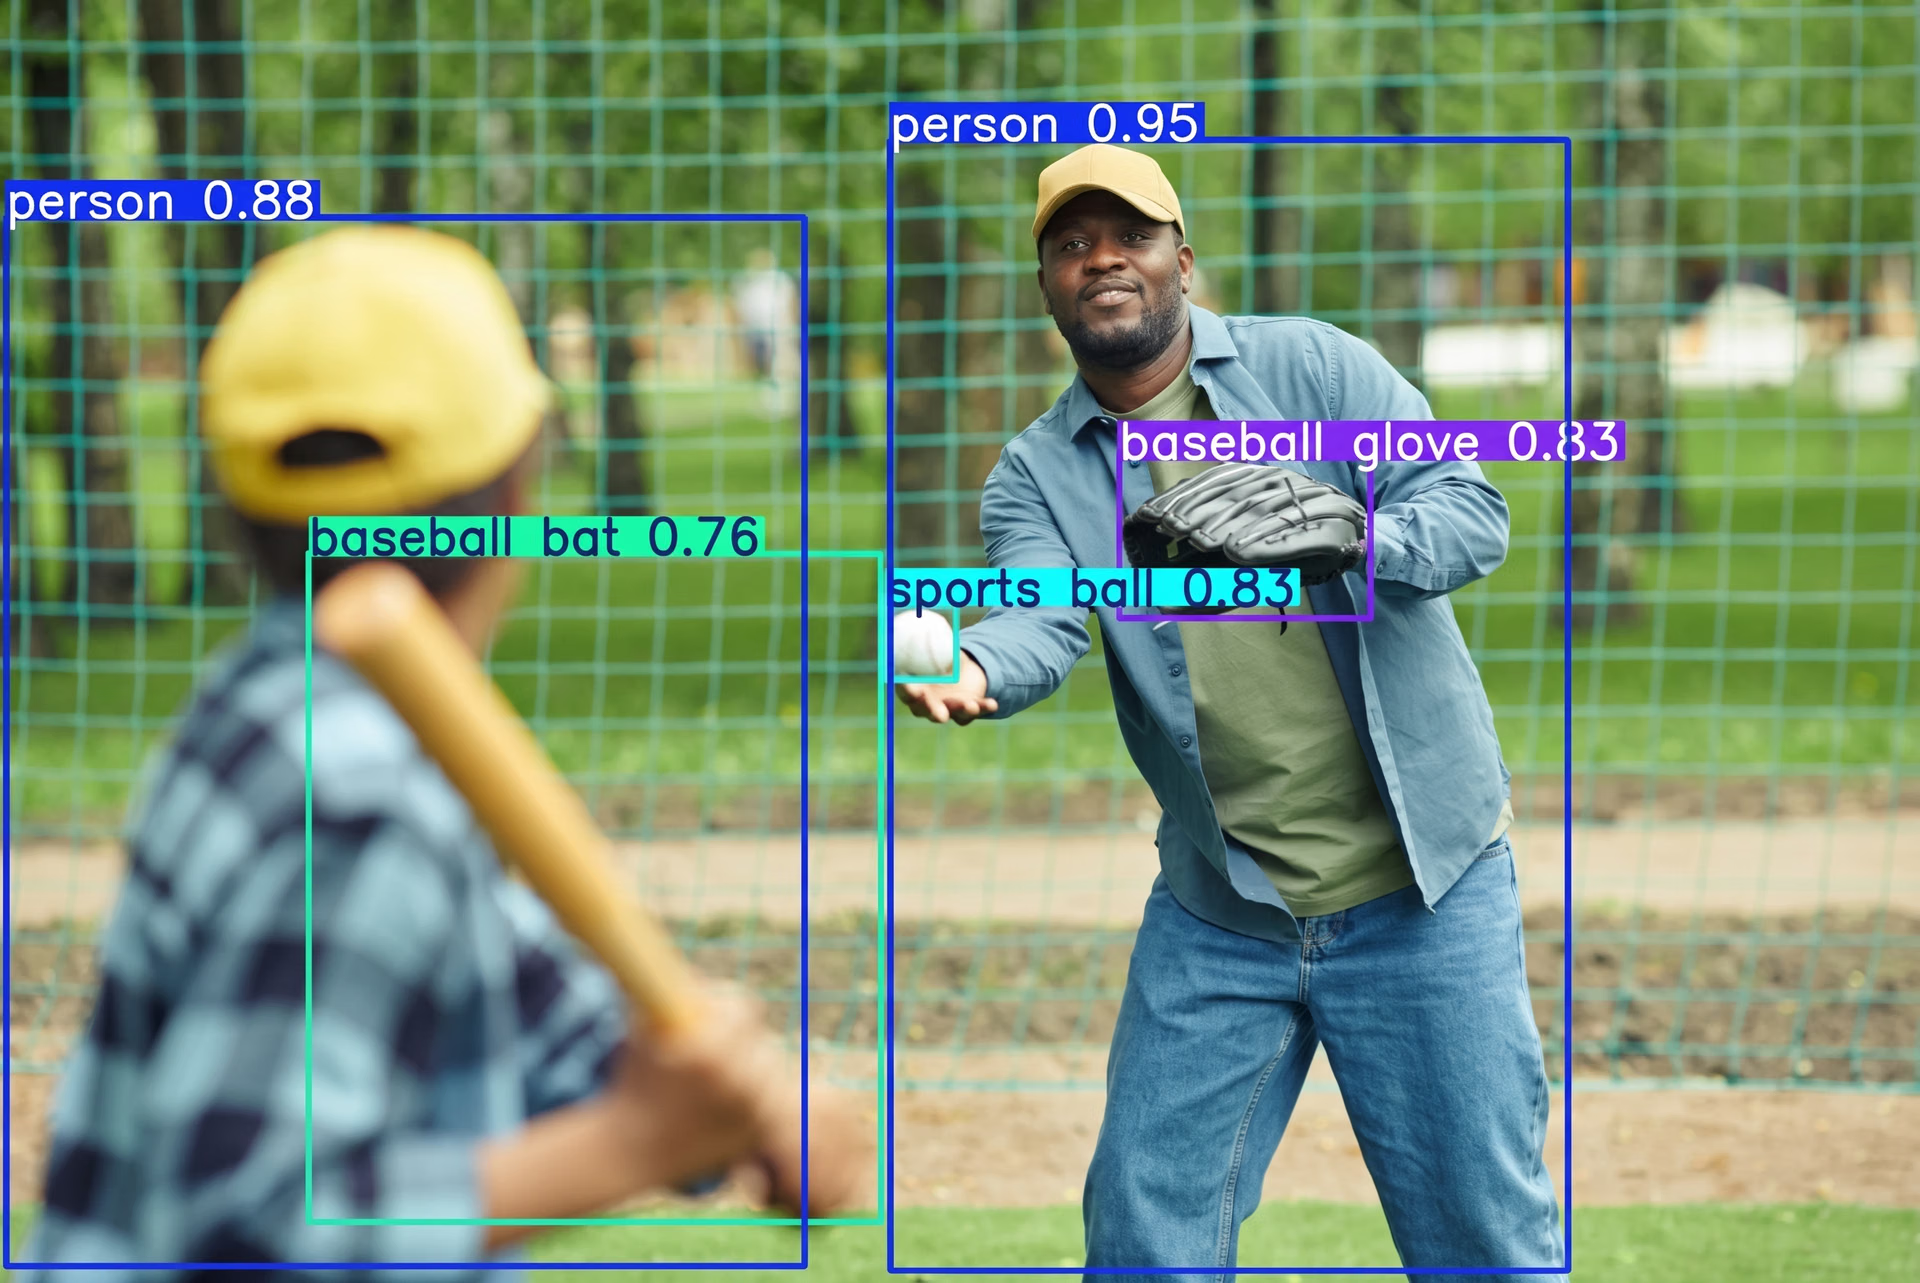
Fig. 2. Exemplo de detecção de objetos possibilitada pelo aprendizado supervisionado (Fonte)
Além da detecção de objetos, o aprendizado supervisionado é amplamente usado em várias tarefas de visão computacional, como classificação de imagens, segmentação de instâncias e estimativa de pose, nas quais a precisão e a consistência são importantes. Em cada uma dessas tarefas, os modelos aprendem com dados rotulados para identificar padrões específicos e fazer previsões confiáveis sobre novas entradas.
Esses modelos geralmente são desenvolvidos com aprendizado profundo, um tipo de aprendizado de máquina que usa redes neurais para aprender padrões diretamente dos dados. As redes neurais são projetadas para processar informações de uma maneira vagamente inspirada no funcionamento do cérebro humano, permitindo que os modelos aprendam características visuais complexas a partir de grandes conjuntos de dados.
As abordagens anteriores de visão computacional geralmente dependiam de características projetadas manualmente, combinadas com algoritmos como máquinas de vetores de suporte (SVMs são modelos que classificam dados encontrando a melhor fronteira entre categorias) ou árvores de decisão (modelos que tomam decisões dividindo os dados em ramificações).
Em contrapartida, os modelos atuais de visão computacional usam aprendizado profundo para aprender automaticamente essas características a partir dos dados, o que os torna mais eficazes em tarefas visuais detalhadas e de grande escala.
Entenda a necessidade de modelos de aprendizado não supervisionado em IA de visão#
Embora o aprendizado supervisionado seja a abordagem preferida em visão computacional, há aplicações de visão em que os dados rotulados não estão disponíveis ou são caros e demorados demais para criar.
Nesses casos, os algoritmos de aprendizado não supervisionado podem ser uma alternativa útil. Digamos que você tenha uma grande coleção de fotos não rotuladas de uma câmera de vida selvagem.
Não há rótulos que indiquem o que cada imagem contém, mas você ainda quer organizar ou compreender os dados. Um modelo não supervisionado pode analisar essas imagens e agrupar as semelhantes, separando em conjuntos animais de aparência parecida, mesmo sem conhecer seus rótulos exatos.
Como funciona o aprendizado não supervisionado em visão computacional#
Então, como funciona o aprendizado de máquina não supervisionado? Em vez de aprender com respostas corretas, o modelo aprende identificando padrões e estruturas nos próprios dados. Ele procura semelhanças e diferenças nos dados sem depender de exemplos rotulados.
Um caso de uso comum é a detecção de anomalias, na qual o modelo aprende como são os dados normais e, em seguida, identifica qualquer elemento que se desvie deles. A detecção de anomalias e valores discrepantes é uma das aplicações industriais de maior impacto. Alguns exemplos incluem encontrar itens defeituosos em uma linha de fabricação, sinalizar exames médicos incomuns para análise de radiologistas ou detectar atividades suspeitas em gravações de vigilância. Como defeitos e anomalias costumam ser raros e variados, rotular todos os casos possíveis é impraticável, o que torna as abordagens não supervisionadas uma escolha natural.
Para isso, técnicas como agrupamento e redução de dimensionalidade são frequentemente usadas, geralmente em características extraídas das imagens, e não nas próprias imagens brutas. Métodos de agrupamento, como o k-means, reúnem imagens semelhantes com base em padrões compartilhados, enquanto técnicas de redução de dimensionalidade, como a análise de componentes principais (PCA), simplificam os dados ao se concentrarem nas características mais importantes.
Isso facilita a identificação de padrões e estruturas relevantes em conjuntos de dados grandes e complexos. A principal vantagem do aprendizado não supervisionado é que ele funciona bem com dados não rotulados e pode revelar padrões que não são imediatamente óbvios. No entanto, é mais difícil de avaliar e oferece menos controle sobre o resultado final do que o aprendizado supervisionado.
Aprendizado autossupervisionado e semissupervisionado em visão computacional#
Ao explorar o aprendizado supervisionado e o não supervisionado, você pode se perguntar se existe um meio-termo entre os dois. Curiosamente, o aprendizado autossupervisionado e o semissupervisionado preenchem essa lacuna.
Essas abordagens permitem que os modelos aprendam com dados não rotulados de forma mais eficaz. Em vez de depender apenas de exemplos rotulados, eles criam suas próprias tarefas de aprendizado a partir dos dados ou combinam um pequeno conjunto de dados rotulados com um conjunto maior de dados não rotulados.
No aprendizado autossupervisionado, o modelo aprende resolvendo tarefas criadas a partir dos próprios dados. Por exemplo, ele pode receber uma imagem com uma parte faltando e aprender a prever o que deve preencher esse espaço, ou aprender a reconhecer diferentes perspectivas do mesmo objeto. Isso ajuda o modelo a aprender características úteis sem precisar de rótulos manuais.
Por outro lado, no aprendizado semissupervisionado, uma pequena quantidade de dados rotulados é usada junto com um conjunto maior de dados não rotulados para melhorar o desempenho. Em alguns casos, o modelo pode gerar rótulos para os dados não rotulados e usá-los para continuar aprendendo.
O principal benefício dessas abordagens é que elas reduzem a necessidade de grandes conjuntos de dados rotulados, cuja criação costuma ser cara e demorada. No entanto, podem ser mais complexas de projetar e avaliar do que os métodos totalmente supervisionados.
Principais diferenças entre aprendizado supervisionado e não supervisionado#
A diferença entre o aprendizado supervisionado e o não supervisionado está na forma como o modelo aprende e no que pretende alcançar. Enquanto o aprendizado supervisionado depende de dados rotulados e orientações claras para aprender tarefas específicas, o aprendizado não supervisionado funciona sem respostas predefinidas e se concentra em descobrir padrões e estruturas nos dados.
Por exemplo, em um sistema de monitoramento de tráfego, um modelo de aprendizado supervisionado pode ser treinado com imagens rotuladas para detectar veículos, pedestres ou semáforos. Em contrapartida, um modelo não supervisionado poderia analisar grandes volumes de gravações de vídeo para agrupar padrões de tráfego semelhantes ou identificar eventos incomuns, como congestionamentos inesperados ou movimentos anormais, sem receber instruções explícitas sobre o que procurar.
Quando usar o aprendizado supervisionado em visão computacional#
O aprendizado supervisionado é uma ótima opção para tarefas de visão computacional cujo objetivo está claramente definido e nas quais o modelo precisa mapear dados de entrada para saídas precisas. Ele funciona especialmente bem quando você tem um conjunto de dados rotulados confiável e precisa de resultados consistentes e previsíveis.
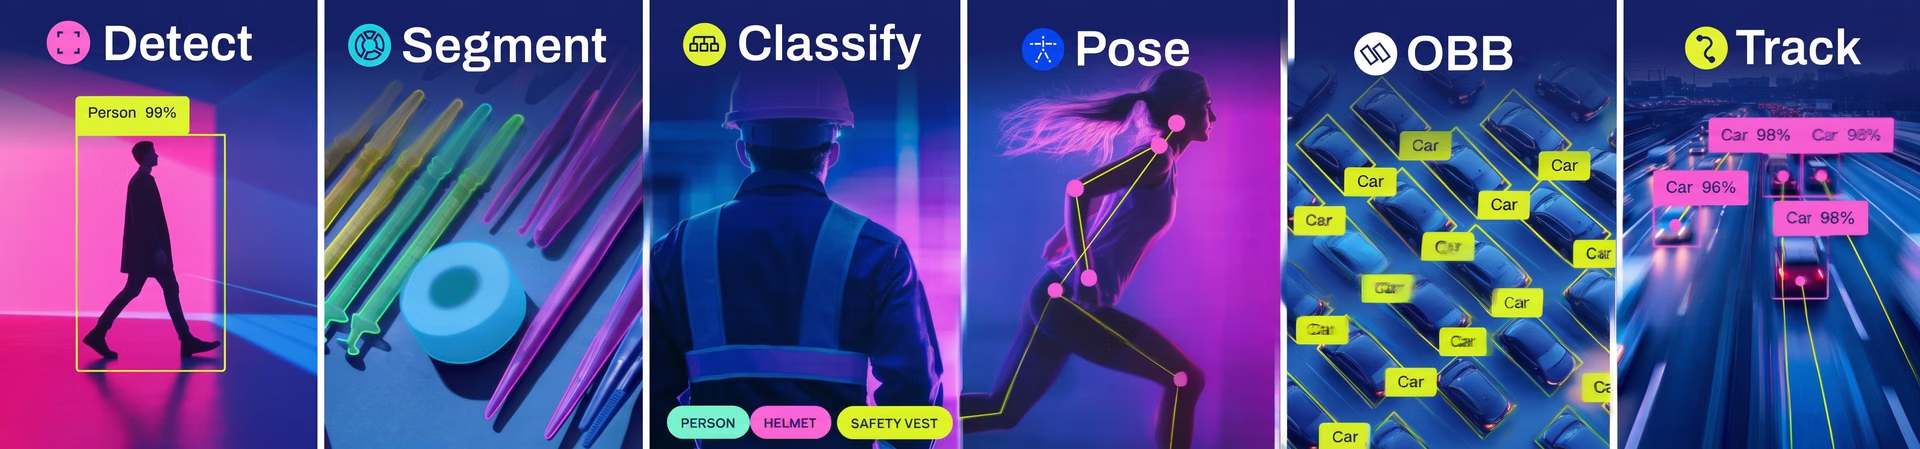
Fig. 3. Tarefas de visão computacional impulsionadas pelo aprendizado supervisionado (Fonte)
Ele é usado com frequência em problemas nos quais o modelo precisa distinguir entre categorias conhecidas ou prever resultados específicos. Em vez de explorar padrões, o foco está em aprender relações precisas a partir de dados rotulados, o que facilita orientar o modelo para o resultado desejado.
Outra vantagem importante é o controle. Com o aprendizado supervisionado, é mais fácil medir o desempenho usando métricas claras, ajustar o modelo e garantir um comportamento estável durante a implantação. Isso o torna ideal para sistemas que exigem consistência e confiabilidade ao longo do tempo.
No entanto, isso envolve uma contrapartida. O modelo depende muito da qualidade e da escala dos dados rotulados, e coletar e anotar esses dados pode levar bastante tempo.
Exemplos reais de visão computacional supervisionada#
Modelos de IA de visão, como os modelos Ultralytics YOLO, usam aprendizado supervisionado para realizar tarefas como detecção de objetos com alta precisão, especialmente em aplicações em tempo real. Confira alguns casos de uso comuns de visão no mundo real em que o aprendizado supervisionado faz a diferença:
- Saúde e diagnóstico por imagem: Os médicos podem usar sistemas de visão computacional treinados com exames rotulados, como raios X ou ressonâncias magnéticas, nos quais classificadores identificam condições como tumores ou fraturas, contribuindo para diagnósticos mais rápidos e precisos.
- Inspeção de qualidade industrial: Em ambientes de fabricação, sistemas de visão treinados com dados rotulados podem inspecionar produtos analisando várias características relacionadas à qualidade, como formato, defeitos superficiais, textura e tamanho. Ao aprender com exemplos de produtos aceitáveis e defeituosos, esses sistemas identificam falhas de forma consistente e mantêm os padrões de produção.
- Condução autônoma: Os sistemas de direção autônoma dependem de modelos treinados com dados de condução rotulados para reconhecer faixas, veículos, pedestres e sinais de trânsito, ajudando os veículos a navegar com segurança em tempo real.
- Varejo e sistemas de caixa: As lojas usam modelos treinados com imagens rotuladas de produtos para identificar itens nas prateleiras ou no caixa, viabilizando a cobrança automatizada e uma gestão de estoque mais eficiente. Quando combinados com dados adicionais, esses sistemas também podem apoiar tarefas como a segmentação de clientes, ajudando as empresas a compreender melhor os hábitos de compra.
- Agricultura e monitoramento de cultivos: Os agricultores podem usar modelos treinados com imagens rotuladas para detectar e classificar cultivos, por exemplo, identificando e contando batatas saudáveis e danificadas, melhorando o controle de qualidade e reduzindo perdas.
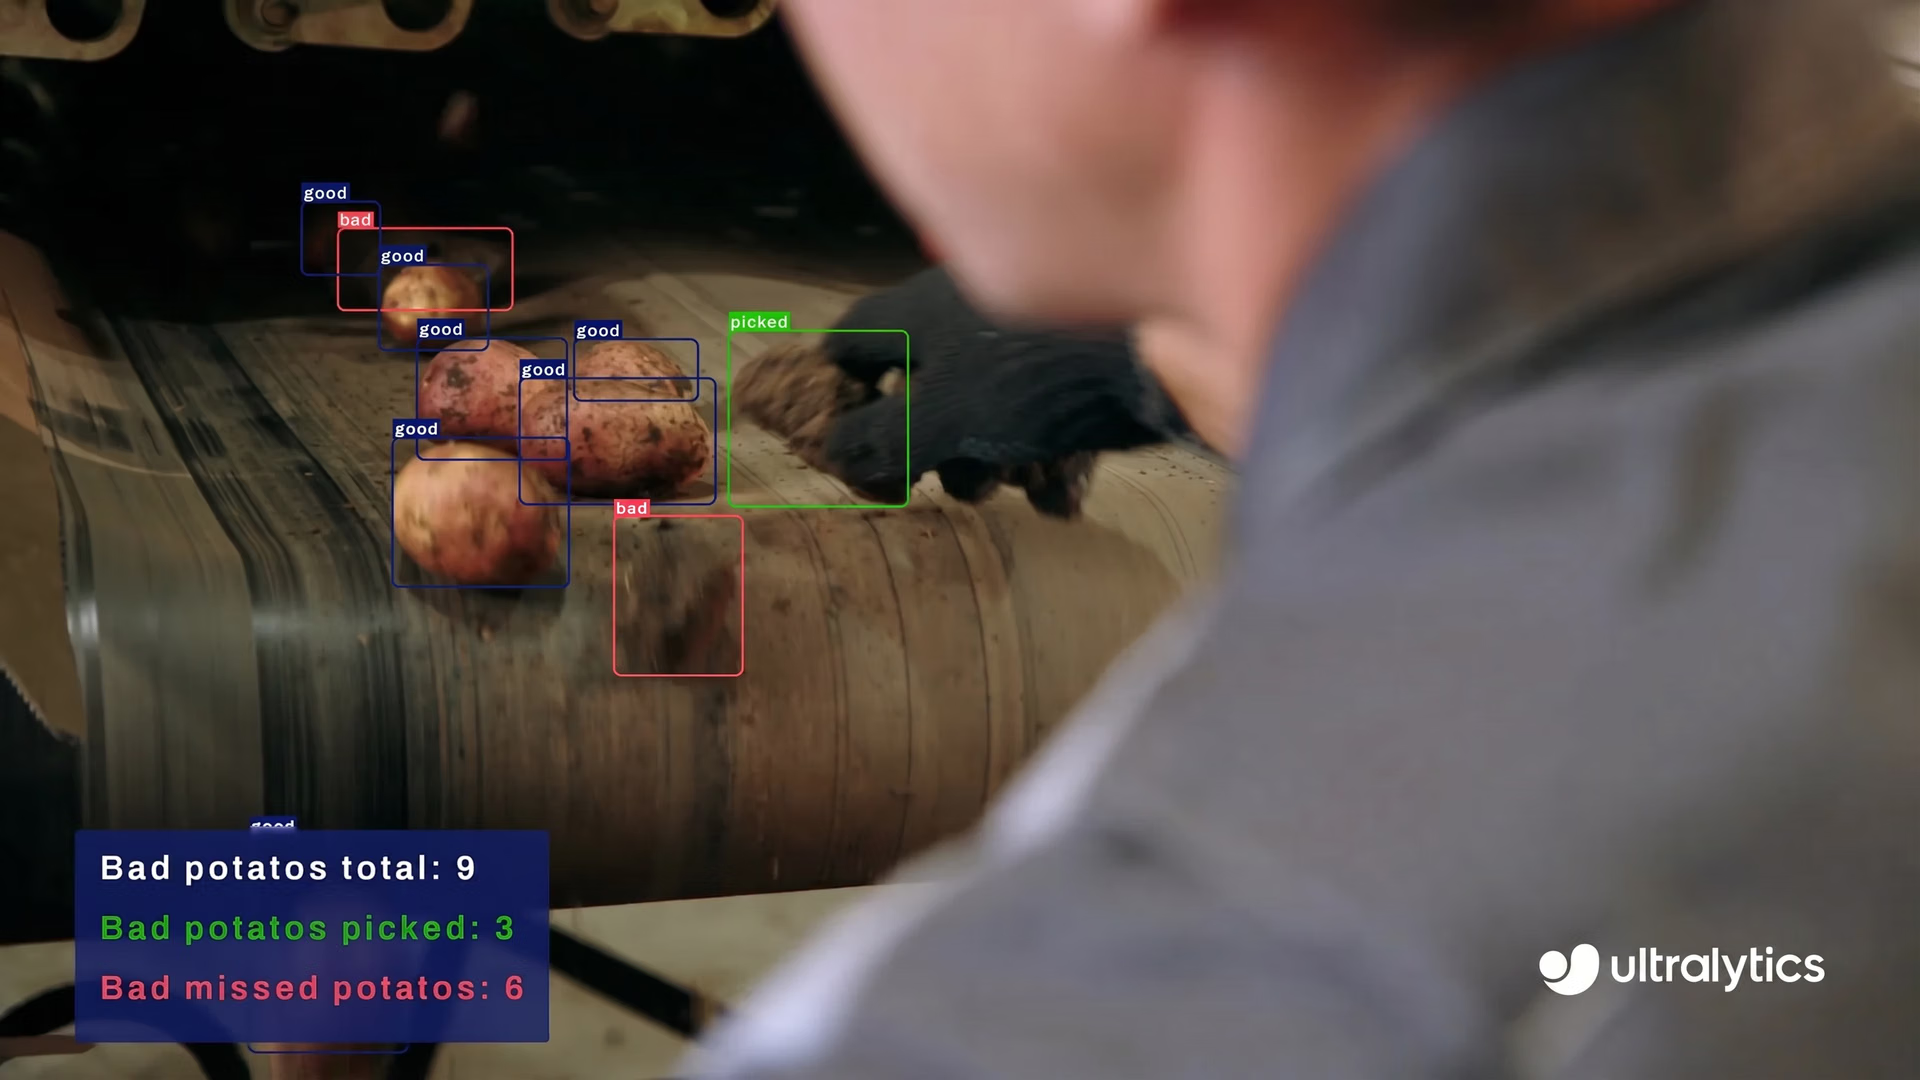
Fig. 4. Uso do YOLO para detectar e contar batatas saudáveis e defeituosas
Que tipos de problemas de visão computacional o aprendizado não supervisionado pode resolver#
O aprendizado não supervisionado é útil quando você não tem dados rotulados suficientes ou quando seus dados não vêm acompanhados de respostas claras. Nessas situações, o objetivo não é fazer previsões exatas, mas compreender os padrões e as estruturas dos dados.
Ele é frequentemente usado na primeira exploração de um conjunto de dados não rotulados. Em vez de dizer ao modelo o que procurar, você permite que ele identifique semelhanças, agrupe imagens relacionadas ou destaque padrões incomuns por conta própria.
Em uma grande coleção de imagens, uma abordagem não supervisionada pode ajudar a agrupar imagens semelhantes ou sinalizar valores discrepantes que talvez precisem de mais atenção. Isso a torna um ponto de partida útil em projetos de ciência de dados.
Modelos generativos, incluindo GANs, autoencoders variacionais e modelos de difusão, aprendem a distribuição subjacente das imagens para criar imagens totalmente novas. Esses modelos viabilizam aplicações como síntese de imagens, preenchimento de imagens, super-resolução e transferência de estilo, além de serem a base dos sistemas de IA generativa atuais.
Na segmentação não supervisionada, alguns métodos agrupam pixels ou regiões em segmentos coerentes sem depender de máscaras rotuladas. Isso é útil quando a anotação é muito cara ou quando o objetivo é descobrir estruturas em vez de corresponder a categorias predefinidas.
O aprendizado não supervisionado também é muito útil ao trabalhar com grandes conjuntos de dados cuja rotulagem é demorada ou impraticável. Nesses casos, ele permite obter insights dos dados sem depender de dados de treinamento rotulados.
Ele também é usado com frequência em áreas como IA generativa (modelos que criam novos dados, como imagens, texto ou áudio) e aprendizado de representações (modelos que aprendem características ou padrões úteis a partir de dados brutos), nas quais os modelos aprendem características gerais a partir de grandes volumes de dados. Em geral, se seu problema envolve exploração, descoberta de padrões ou trabalho com dados não rotulados, o aprendizado não supervisionado é uma abordagem flexível e prática a considerar.
Exemplos reais de aprendizado não supervisionado em visão computacional#
Confira alguns exemplos de casos de uso do aprendizado não supervisionado em visão computacional:
- Detecção de anomalias na fabricação: Os modelos podem aprender a aparência de produtos normais e sinalizar defeitos ou irregularidades sem precisar de exemplos rotulados de todos os defeitos possíveis.
- Organização e busca de imagens: Grandes coleções de imagens, como bibliotecas de fotos ou catálogos de comércio eletrônico, podem ser agrupadas automaticamente com base na semelhança visual, facilitando para os cientistas de dados organizar, explorar e pesquisar grandes conjuntos de dados.
- Vigilância e segurança: Os sistemas podem analisar gravações de vídeo para identificar padrões ou comportamentos incomuns, como movimentos inesperados ou mudanças em multidões, sem terem sido treinados explicitamente com eventos rotulados.
- Pré-processamento e exploração de dados: Métodos não supervisionados são frequentemente usados para explorar e estruturar dados brutos de imagens antes de treinar modelos supervisionados, ajudando a melhorar a qualidade dos dados e reduzir o trabalho manual.
Limitações práticas do aprendizado supervisionado e não supervisionado#
Apesar das vantagens das duas abordagens de aprendizado, há algumas limitações a considerar. Confira alguns fatores práticos que você deve ter em mente ao desenvolver modelos de visão computacional:
- Sobreajuste em modelos supervisionados: No aprendizado supervisionado, um modelo pode aprender os dados de treinamento detalhadamente demais, em vez de aprender padrões gerais. Isso costuma acontecer quando o conjunto de dados é pequeno ou pouco diversificado. Por exemplo, um modelo treinado para detectar defeitos em um tipo de produto pode falhar quando testado com novos dados que contenham produtos ou condições de iluminação ligeiramente diferentes.
- Desafios com algoritmos de agrupamento: No aprendizado não supervisionado, um modelo pode agrupar pontos de dados semelhantes. No entanto, isso pode falhar quando os dados são ruidosos, inconsistentes ou não têm uma estrutura clara. Por exemplo, em tarefas de agrupamento de imagens, imagens com cores semelhantes, mas de objetos diferentes, podem acabar agrupadas incorretamente.
- Importância do pré-processamento adequado: Antes do treinamento, os dados precisam ser limpos e preparados. Isso costuma ser feito usando bibliotecas Python que processam imagens e transformam dados. Esse processo é especialmente importante em visão computacional, na qual as imagens podem variar em tamanho, qualidade ou iluminação. Sem o pré-processamento adequado, os modelos podem aprender com ruído em vez de padrões relevantes, o que leva a um desempenho insatisfatório.
Principais conclusões#
Em visão computacional, tanto o aprendizado supervisionado quanto o não supervisionado desempenham papéis importantes. A abordagem certa depende do tipo de dados que você tem, sejam eles rotulados ou não, além do problema que está tentando resolver e dos seus requisitos de implantação.
Se seu objetivo é obter alta precisão e saídas claramente definidas, o aprendizado de máquina supervisionado costuma ser a melhor escolha. Se você está explorando dados ou trabalhando sem rótulos, o aprendizado não supervisionado pode ser mais adequado.
Quer saber mais sobre IA? Confira nossa comunidade e nosso repositório no GitHub. Explore nossas páginas de soluções para saber mais sobre IA em robótica e visão computacional na agricultura. Conheça nossas opções de licenciamento e comece hoje mesmo a desenvolver com visão computacional!









