A evolução da deteção de objetos e dos modelos YOLO da Ultralytics
Junta-te a nós para revisitar a evolução da deteção de objetos. Vamos analisar como os modelos YOLO (Só é preciso olhar uma vez) evoluíram nos últimos anos.
A visão computacional é um subcampo da inteligência artificial (IA) que se concentra em ensinar máquinas a ver e compreender imagens e vídeos, de forma semelhante à maneira como os seres humanos percebem o mundo real. Embora reconhecer objetos ou identificar ações seja algo natural para os seres humanos, essas tarefas exigem técnicas de visão computacional específicas e especializadas quando realizadas por máquinas. Por exemplo, uma tarefa importante da visão computacional é a deteção de objetos, que consiste em identificar e localizar objetos em imagens ou vídeos.
Desde a década de 1960, os investigadores trabalham para melhorar a capacidade dos computadores de detetar objetos. Os primeiros métodos, como a correspondência de modelos, consistiam em deslizar um modelo predefinido sobre uma imagem para encontrar correspondências. Embora inovadoras, essas abordagens tinham dificuldades com mudanças no tamanho e na orientação dos objetos e na iluminação. Hoje, temos modelos avançados, como o Ultralytics YOLO11, que conseguem detetar até objetos pequenos e parcialmente ocultos, conhecidos como objetos ocluídos, com uma precisão impressionante.
À medida que a visão computacional continua a evoluir, é importante olhar para trás e ver como essas tecnologias se desenvolveram. Neste artigo, vamos explorar a evolução da deteção de objetos e destacar a transformação dos modelos YOLO (Você Só Olha Uma Vez). Vamos começar!
As origens da visão computacional#
Antes de nos aprofundarmos na deteção de objetos, vamos ver como a visão computacional surgiu. As origens da visão computacional remontam ao final da década de 1950 e ao início da década de 1960, quando os cientistas começaram a explorar como o cérebro processa informações visuais. Em experiências com gatos, os investigadores David Hubel e Torsten Wiesel descobriram que o cérebro reage a padrões simples, como arestas e linhas. Essa descoberta estabeleceu as bases da extração de características — o conceito de que os sistemas visuais detetam e reconhecem características básicas em imagens, como arestas, antes de avançar para padrões mais complexos.
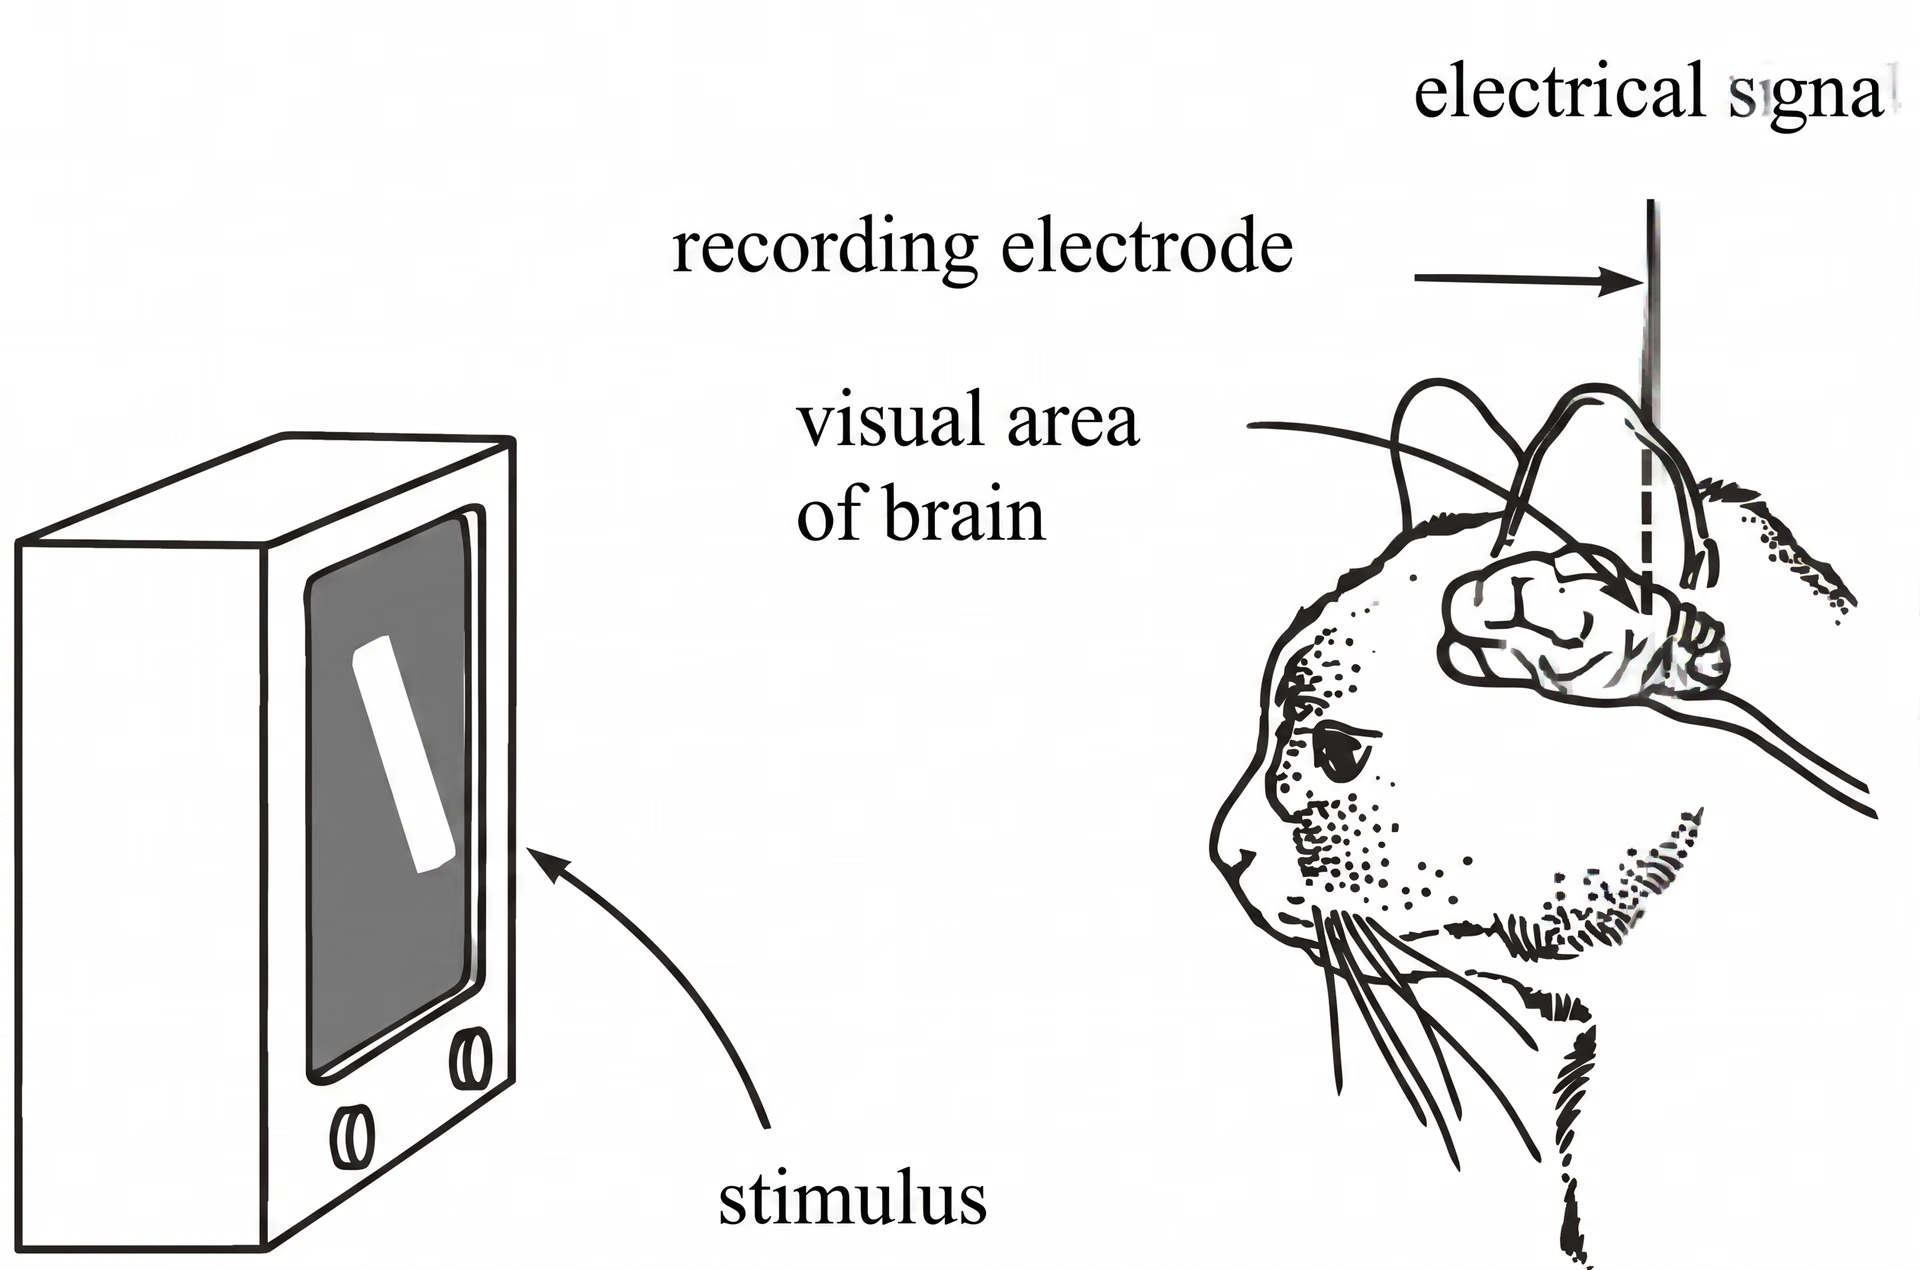
Fig. 1. Aprender como o cérebro de um gato reage a barras de luz ajudou a desenvolver a extração de características em visão computacional.
Por volta da mesma época, surgiu uma nova tecnologia capaz de converter imagens físicas em formatos digitais, despertando o interesse por como as máquinas poderiam processar informações visuais. Em 1966, o Projeto Summer Vision do Instituto de Tecnologia de Massachusetts (MIT) levou essa iniciativa mais longe. Embora o projeto não tenha sido totalmente bem-sucedido, o seu objetivo era criar um sistema capaz de separar o primeiro plano do plano de fundo em imagens. Para muitos membros da comunidade de IA visual, esse projeto marca o início oficial da visão computacional como campo científico.
Compreender a história da deteção de objetos#
À medida que a visão computacional avançava no final da década de 1990 e no início dos anos 2000, os métodos de deteção de objetos passaram de técnicas básicas, como a correspondência de modelos, para abordagens mais avançadas. Um método popular era o Haar Cascade, que passou a ser amplamente utilizado em tarefas como a deteção de rostos. O método percorria as imagens com uma janela deslizante, verificando características específicas, como arestas ou texturas, em cada secção da imagem e, em seguida, combinava essas características para detetar objetos, como rostos. O Haar Cascade era muito mais rápido do que os métodos anteriores.
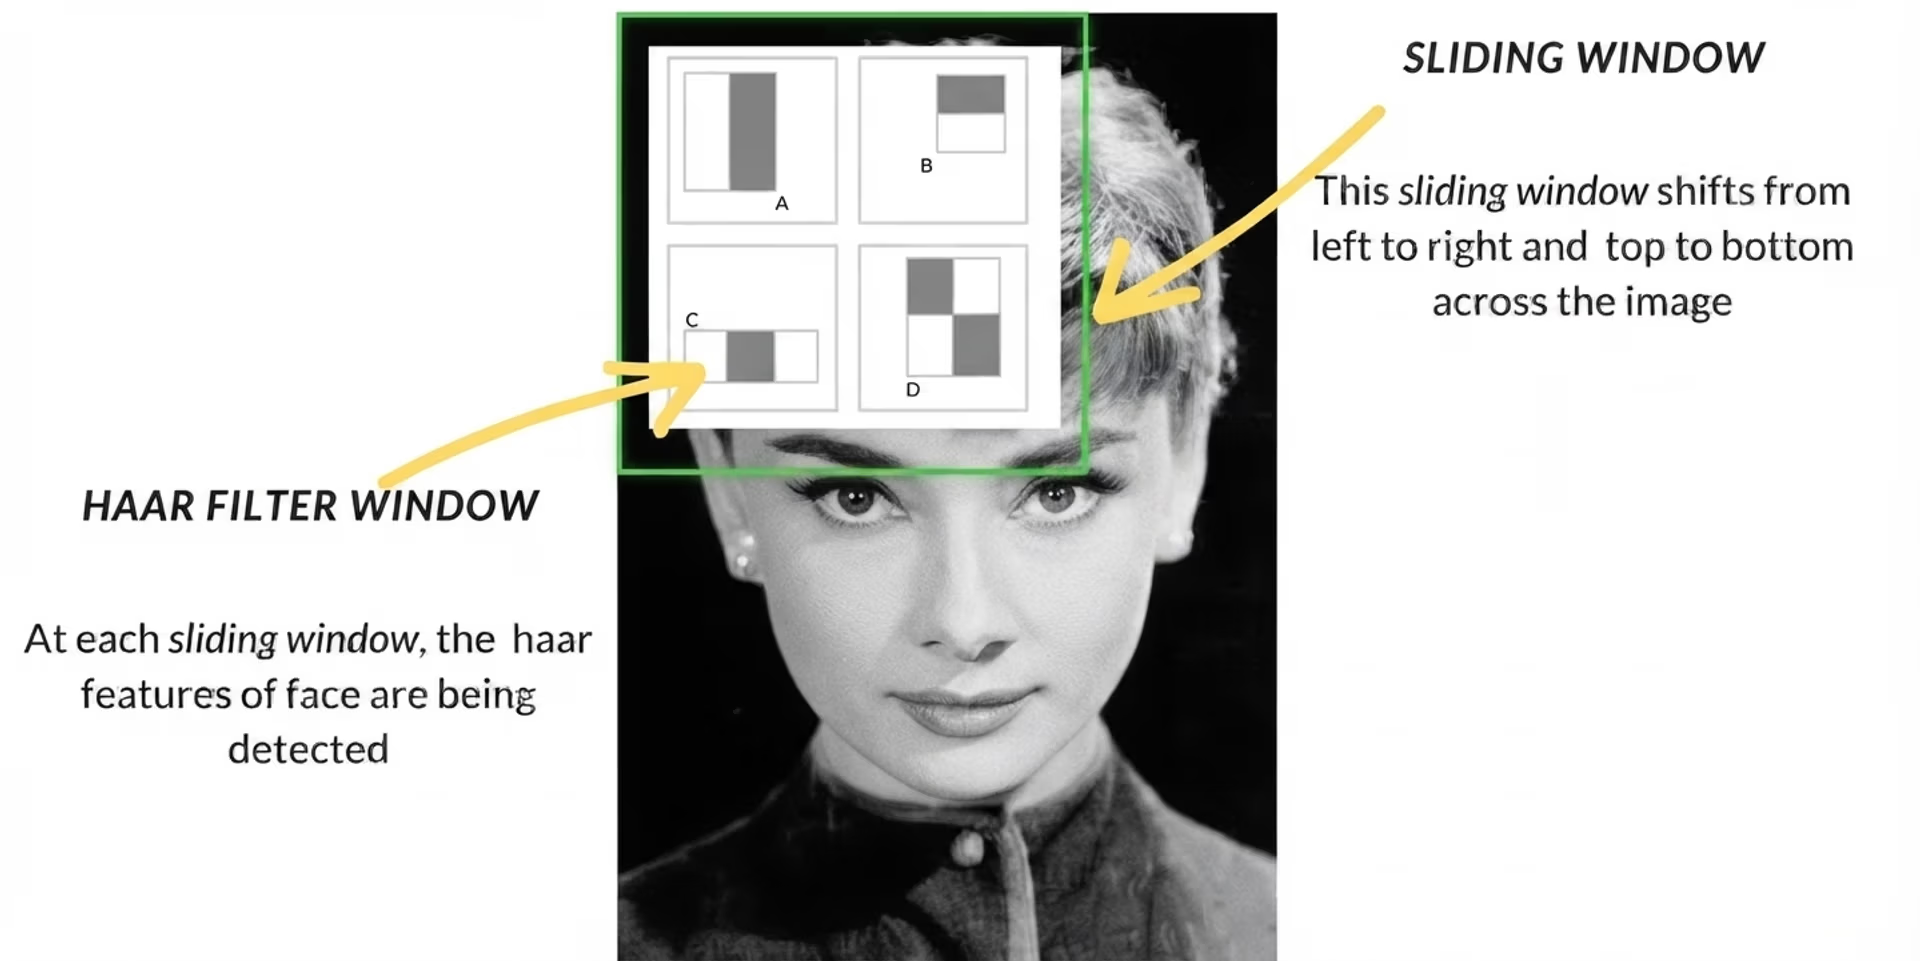
Fig. 2. Uso do Haar Cascade para deteção de rostos.
Também foram introduzidos métodos como Histograma de Gradientes Orientados (HOG) e Máquinas de Vetores de Suporte (SVMs). O HOG usava a técnica da janela deslizante para analisar as mudanças de luz e sombra em pequenas secções de uma imagem, ajudando a identificar objetos com base nas suas formas. Em seguida, as SVMs classificavam essas características para determinar a identidade do objeto. Esses métodos melhoraram a precisão, mas ainda tinham dificuldades em ambientes reais e eram mais lentos do que as técnicas atuais.
A necessidade de deteção de objetos em tempo real#
Na década de 2010, o crescimento da aprendizagem profunda e das Redes Neurais Convolucionais (CNNs) provocou uma grande mudança na deteção de objetos. As CNNs permitiram que os computadores aprendessem automaticamente características importantes a partir de grandes quantidades de dados, tornando a deteção muito mais precisa.
Os primeiros modelos, como as Redes Neurais Convolucionais baseadas em regiões (R-CNN), representaram uma grande melhoria na precisão, ajudando a identificar objetos com maior precisão do que os métodos anteriores.
No entanto, esses modelos eram lentos porque processavam as imagens em várias etapas, o que os tornava impraticáveis para aplicações em tempo real em áreas como carros autónomos ou videovigilância.
Com o objetivo de acelerar o processo, foram desenvolvidos modelos mais eficientes. Modelos como Fast R-CNN e Faster R-CNN ajudaram a aperfeiçoar a seleção de regiões de interesse e a reduzir o número de etapas necessárias para a deteção. Embora isso tenha tornado a deteção de objetos mais rápida, ainda não era suficientemente rápida para muitas aplicações do mundo real que precisavam de resultados imediatos. A crescente procura por deteção em tempo real impulsionou o desenvolvimento de soluções ainda mais rápidas e eficientes, capazes de equilibrar velocidade e precisão.
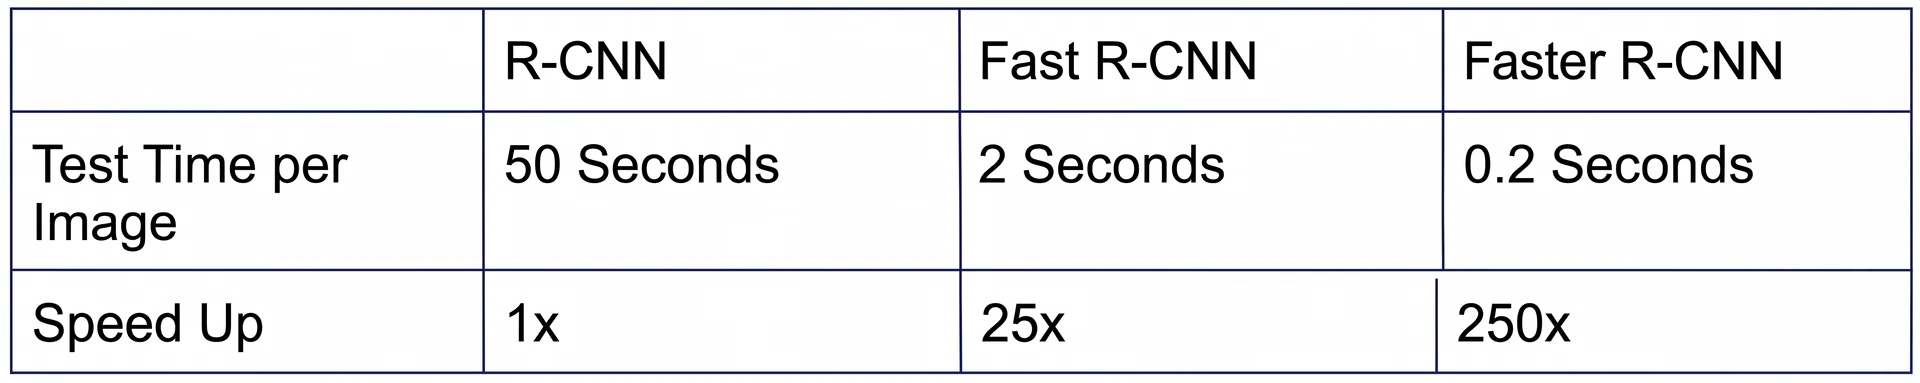
Fig. 3. Comparação das velocidades de R-CNN, Fast R-CNN e Faster R-CNN.
Modelos YOLO (Você Só Olha Uma Vez): um marco importante#
YOLO é um modelo de deteção de objetos que redefiniu a visão computacional ao permitir a deteção em tempo real de vários objetos em imagens e vídeos, tornando-o bastante diferente dos métodos de deteção anteriores. Em vez de analisar cada objeto detetado individualmente, a arquitetura do YOLO trata a deteção de objetos como uma única tarefa, prevendo de uma só vez a localização e a classe dos objetos por meio de CNNs.
O modelo funciona dividindo uma imagem numa grelha, em que cada parte é responsável por detetar objetos na respetiva área. O modelo faz várias previsões para cada secção e filtra os resultados menos confiáveis, mantendo apenas os mais precisos.
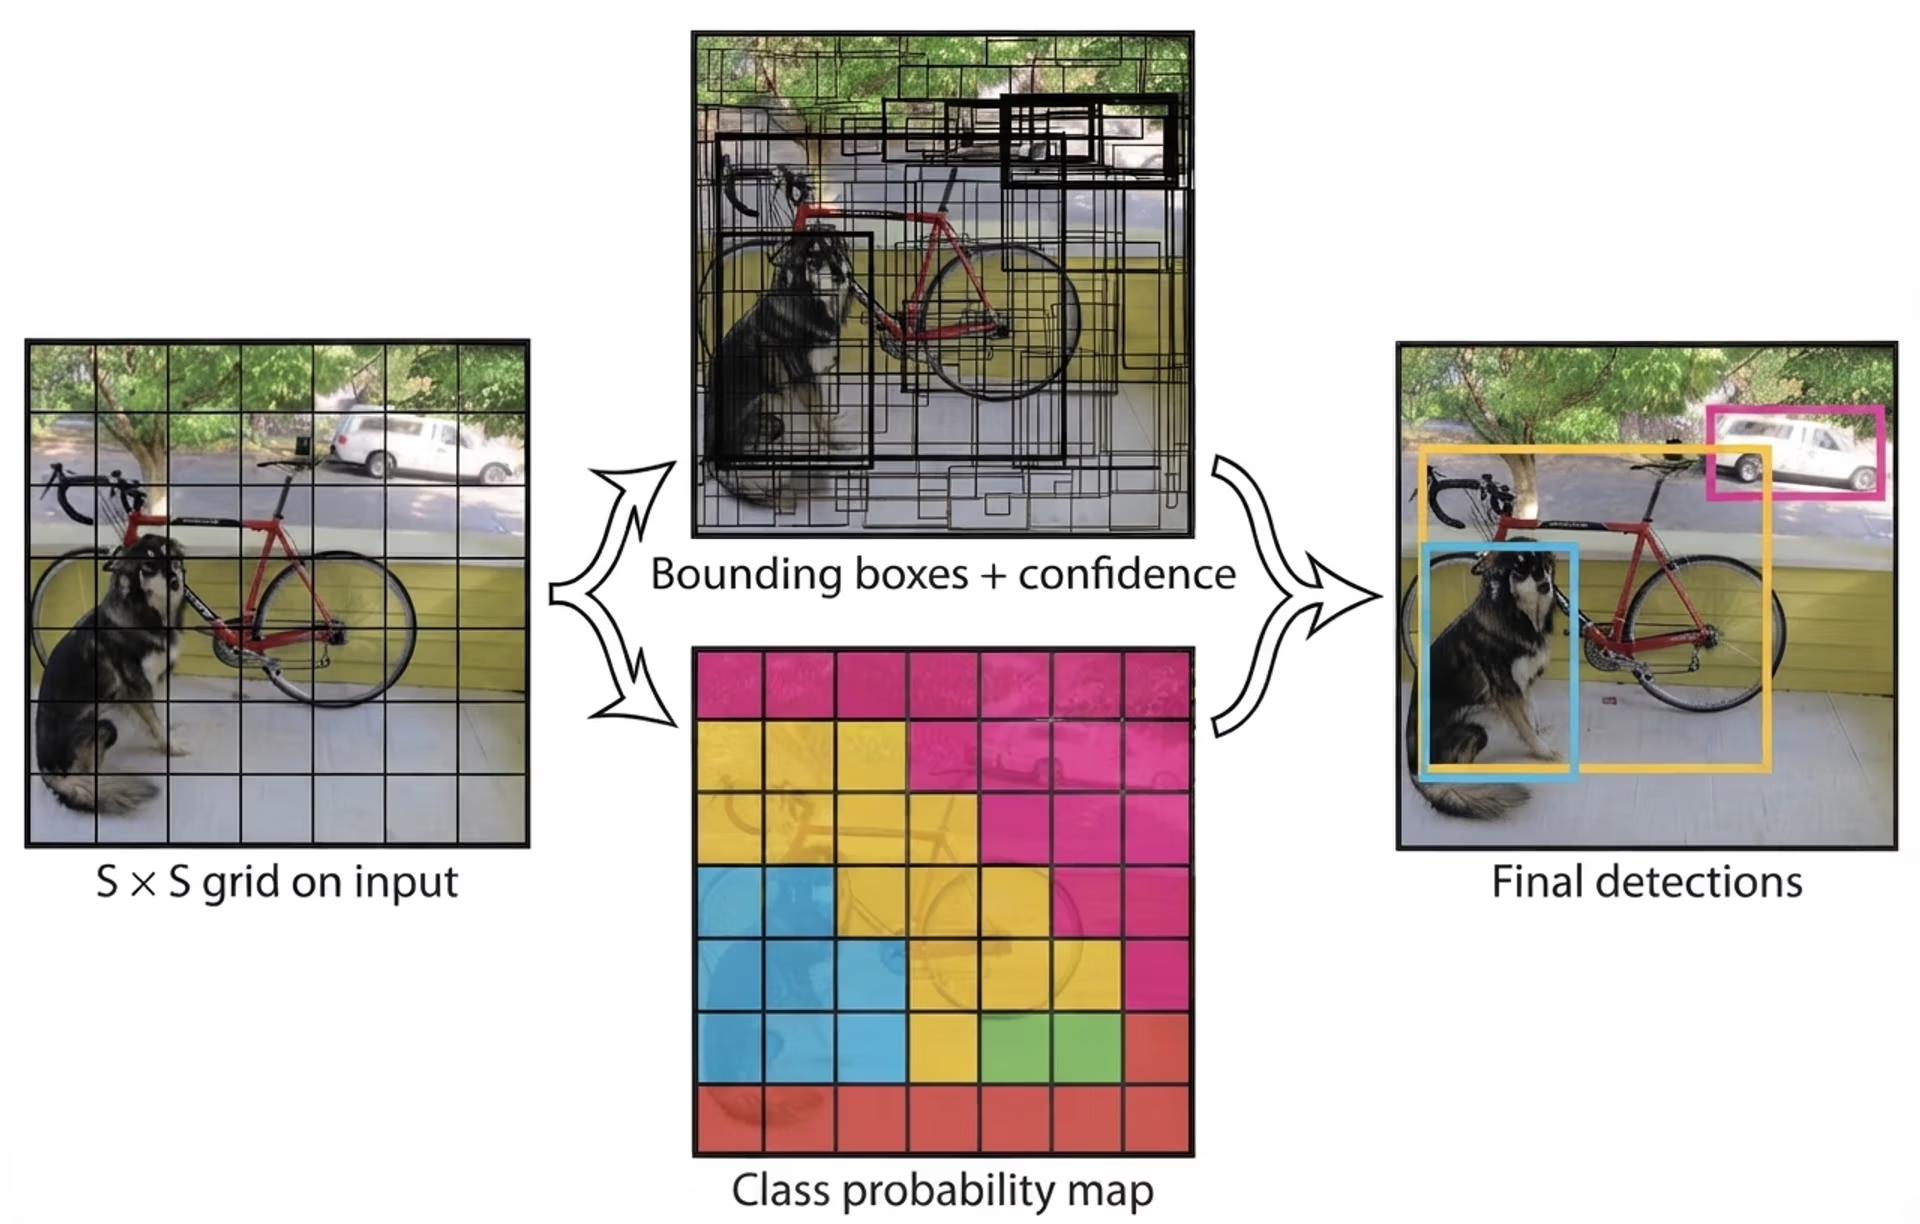
Fig. 4. Visão geral do funcionamento do YOLO.
A introdução do YOLO nas aplicações de visão computacional tornou a deteção de objetos muito mais rápida e eficiente do que nos modelos anteriores. Graças à sua velocidade e precisão, o YOLO tornou-se rapidamente uma opção popular para soluções em tempo real em setores como a indústria, a saúde e a robótica.
Outro aspeto importante é que, por ser de código aberto, o YOLO permitiu que desenvolvedores e investigadores o aprimorassem continuamente, dando origem a versões ainda mais avançadas.
O caminho do YOLO ao Ultralytics YOLO11#
Os modelos YOLO têm melhorado de forma constante ao longo do tempo, aproveitando os avanços de cada versão. Além de melhorar o desempenho, essas melhorias tornaram os modelos mais fáceis de usar para pessoas com diferentes níveis de experiência técnica.
Por exemplo, quando o Ultralytics YOLOv5 foi lançado, implantar modelos tornou-se mais simples com o PyTorch, permitindo que mais utilizadores trabalhassem com IA avançada. O modelo combinou precisão e facilidade de uso, possibilitando que mais pessoas implementassem a deteção de objetos sem precisarem de ser especialistas em programação.
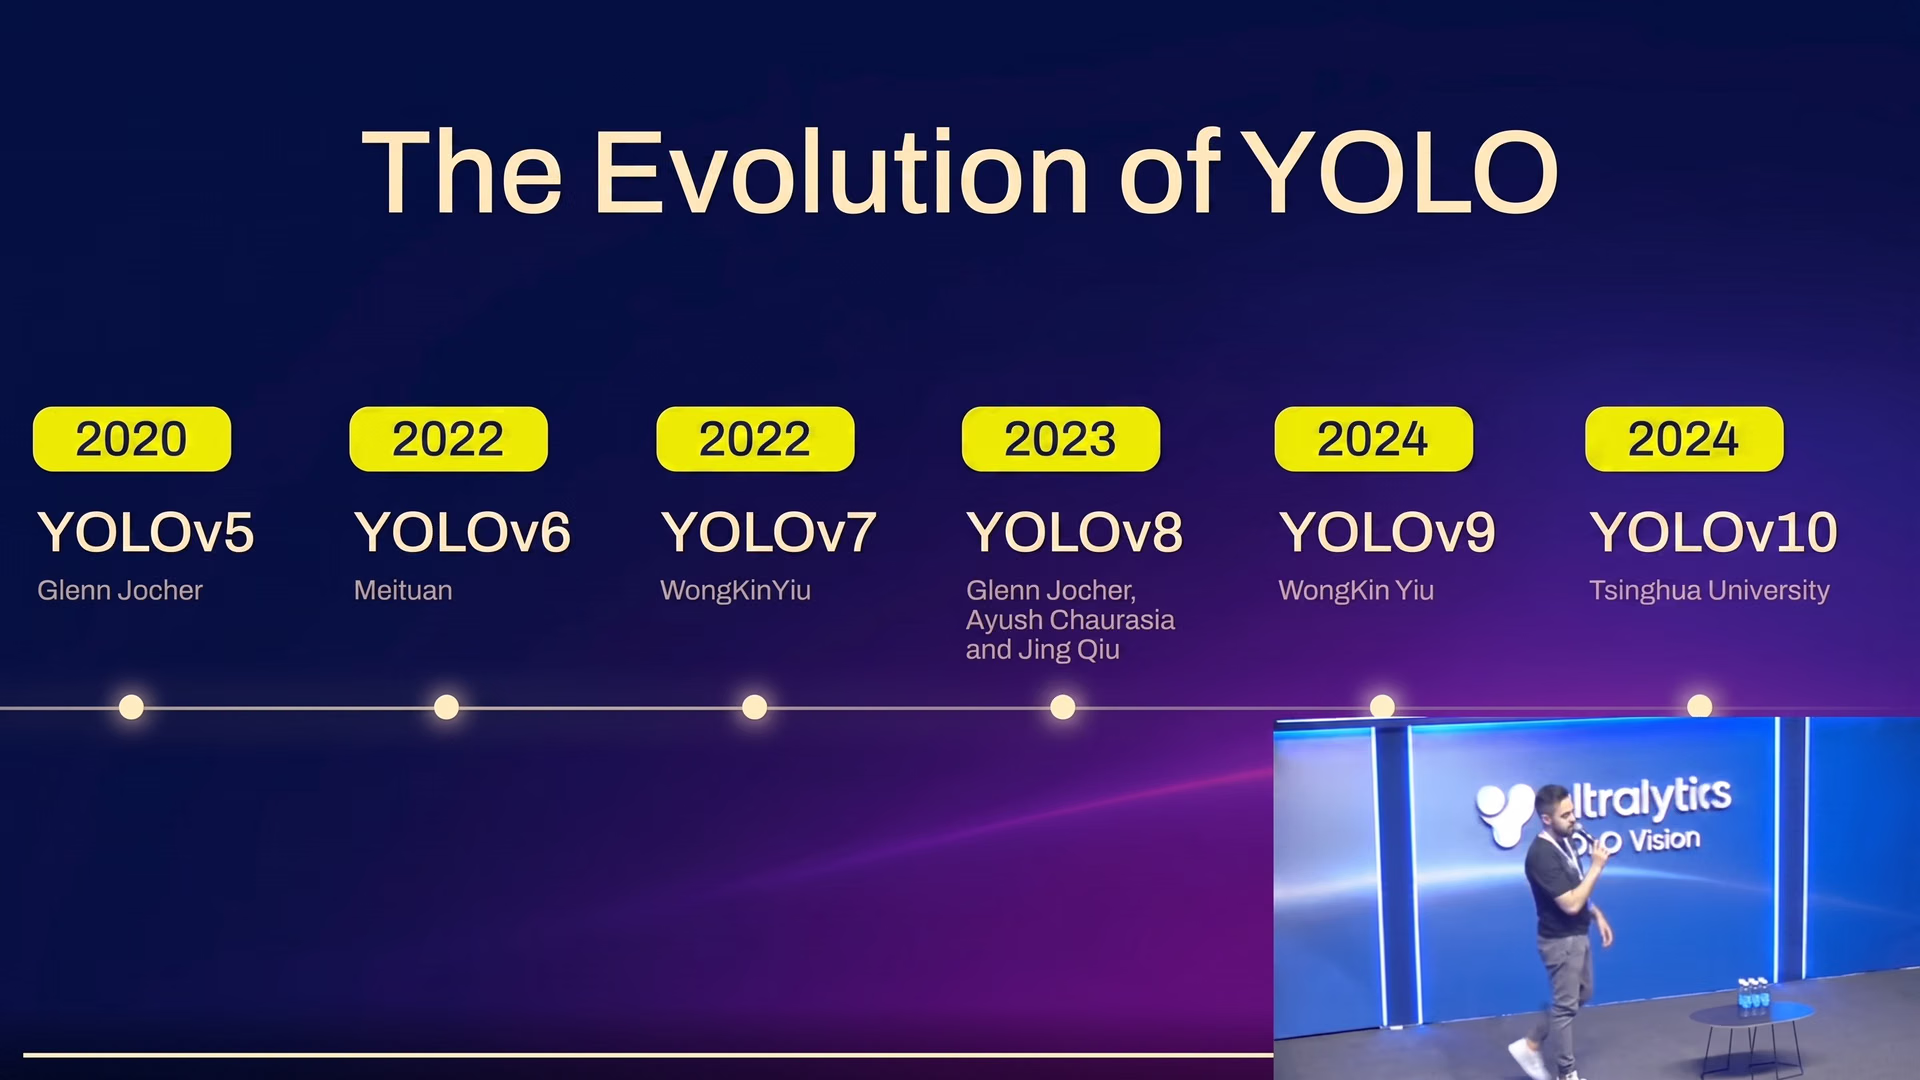
Fig. 5. A evolução dos modelos YOLO.
O Ultralytics YOLOv8 deu continuidade a esse progresso, adicionando suporte a tarefas como a segmentação de instâncias e tornando os modelos mais flexíveis. Ficou mais fácil usar o YOLO tanto em aplicações básicas como em aplicações mais complexas, tornando-o útil numa variedade de cenários.
Com o modelo mais recente, o Ultralytics YOLO11, foram feitas novas otimizações. Ao reduzir o número de parâmetros e, ao mesmo tempo, melhorar a precisão, o modelo tornou-se mais eficiente para tarefas em tempo real. Quer sejas um desenvolvedor experiente ou estejas a começar na IA, o YOLO11 oferece uma abordagem avançada à deteção de objetos, facilmente acessível.
Conhece o Ultralytics YOLO11: novos recursos e melhorias#
Lançado no evento híbrido anual da Ultralytics, o YOLO Vision 2024 (YV24), o YOLO11 oferece suporte às mesmas tarefas de visão computacional do YOLOv8, como deteção de objetos, segmentação de instâncias, classificação de imagens e estimativa de pose. Assim, os utilizadores podem mudar facilmente para este novo modelo sem precisarem de ajustar os seus fluxos de trabalho. Além disso, a arquitetura aprimorada do YOLO11 torna as previsões ainda mais precisas. Na verdade, o YOLO11m alcança uma precisão média média (mAP) superior no conjunto de dados COCO, com 22% menos parâmetros do que o YOLOv8m.
O YOLO11 também foi desenvolvido para funcionar com eficiência numa variedade de plataformas, desde smartphones e outros dispositivos de borda até sistemas de nuvem mais potentes. Essa flexibilidade garante um desempenho fluido em diferentes configurações de hardware para aplicações em tempo real. Além disso, o YOLO11 é mais rápido e eficiente, reduzindo os custos computacionais e acelerando os tempos de inferência. Quer uses o pacote Python da Ultralytics ou a plataforma Ultralytics HUB sem código, é fácil integrar o YOLO11 nos teus fluxos de trabalho existentes.
O futuro dos modelos YOLO e da deteção de objetos#
O impacto da deteção avançada de objetos em aplicações em tempo real e na IA de borda já se faz sentir em todos os setores. À medida que setores como o petróleo e gás, a saúde e o retalho dependem cada vez mais da IA, a procura por uma deteção de objetos rápida e precisa continua a crescer. O Ultralytics YOLO11 pretende responder a essa procura, permitindo uma deteção de alto desempenho mesmo em dispositivos com capacidade computacional limitada.
À medida que a IA de borda cresce, é provável que modelos de deteção de objetos como o Ultralytics YOLO11 se tornem ainda mais essenciais para a tomada de decisões em tempo real em ambientes onde a velocidade e a precisão são fundamentais. Com melhorias contínuas no design e na adaptabilidade, o futuro da deteção de objetos promete trazer ainda mais inovações para diversas aplicações.
Principais conclusões#
A deteção de objetos evoluiu muito, passando de métodos simples para as técnicas avançadas de aprendizagem profunda que vemos hoje. Os modelos YOLO têm estado no centro desse progresso, oferecendo uma deteção em tempo real mais rápida e precisa em diferentes setores. O Ultralytics YOLO11 dá continuidade a esse legado, melhorando a eficiência, reduzindo os custos computacionais e aumentando a precisão, o que o torna uma opção confiável para várias aplicações em tempo real. Com os avanços contínuos da IA e da visão computacional, o futuro da deteção de objetos parece promissor, com espaço para ainda mais melhorias em velocidade, precisão e adaptabilidade.
Tens curiosidade sobre IA? Mantém-te em contacto com a nossa comunidade para continuares a aprender! Consulta o nosso repositório do GitHub para descobrires como usamos IA para criar soluções inovadoras em setores como a indústria e a saúde. 🚀









