Как пользоваться разделом Reference в документации Ultralytics YOLO
Узнай, как пользоваться разделом Reference в документации Ultralytics YOLO, чтобы разобраться во внутреннем устройстве пакета Ultralytics Python.
Сегодня искусственный интеллект (AI) стал доступнее, чем когда-либо: теперь каждый может быстро приступить к работе с разными моделями ИИ для решения самых современных задач.
Например, компьютерное зрение — это область ИИ, которая позволяет компьютерам интерпретировать и понимать визуальную информацию на изображениях и видео, а с моделями компьютерного зрения, такими как Ultralytics YOLO11, легко начать работать.
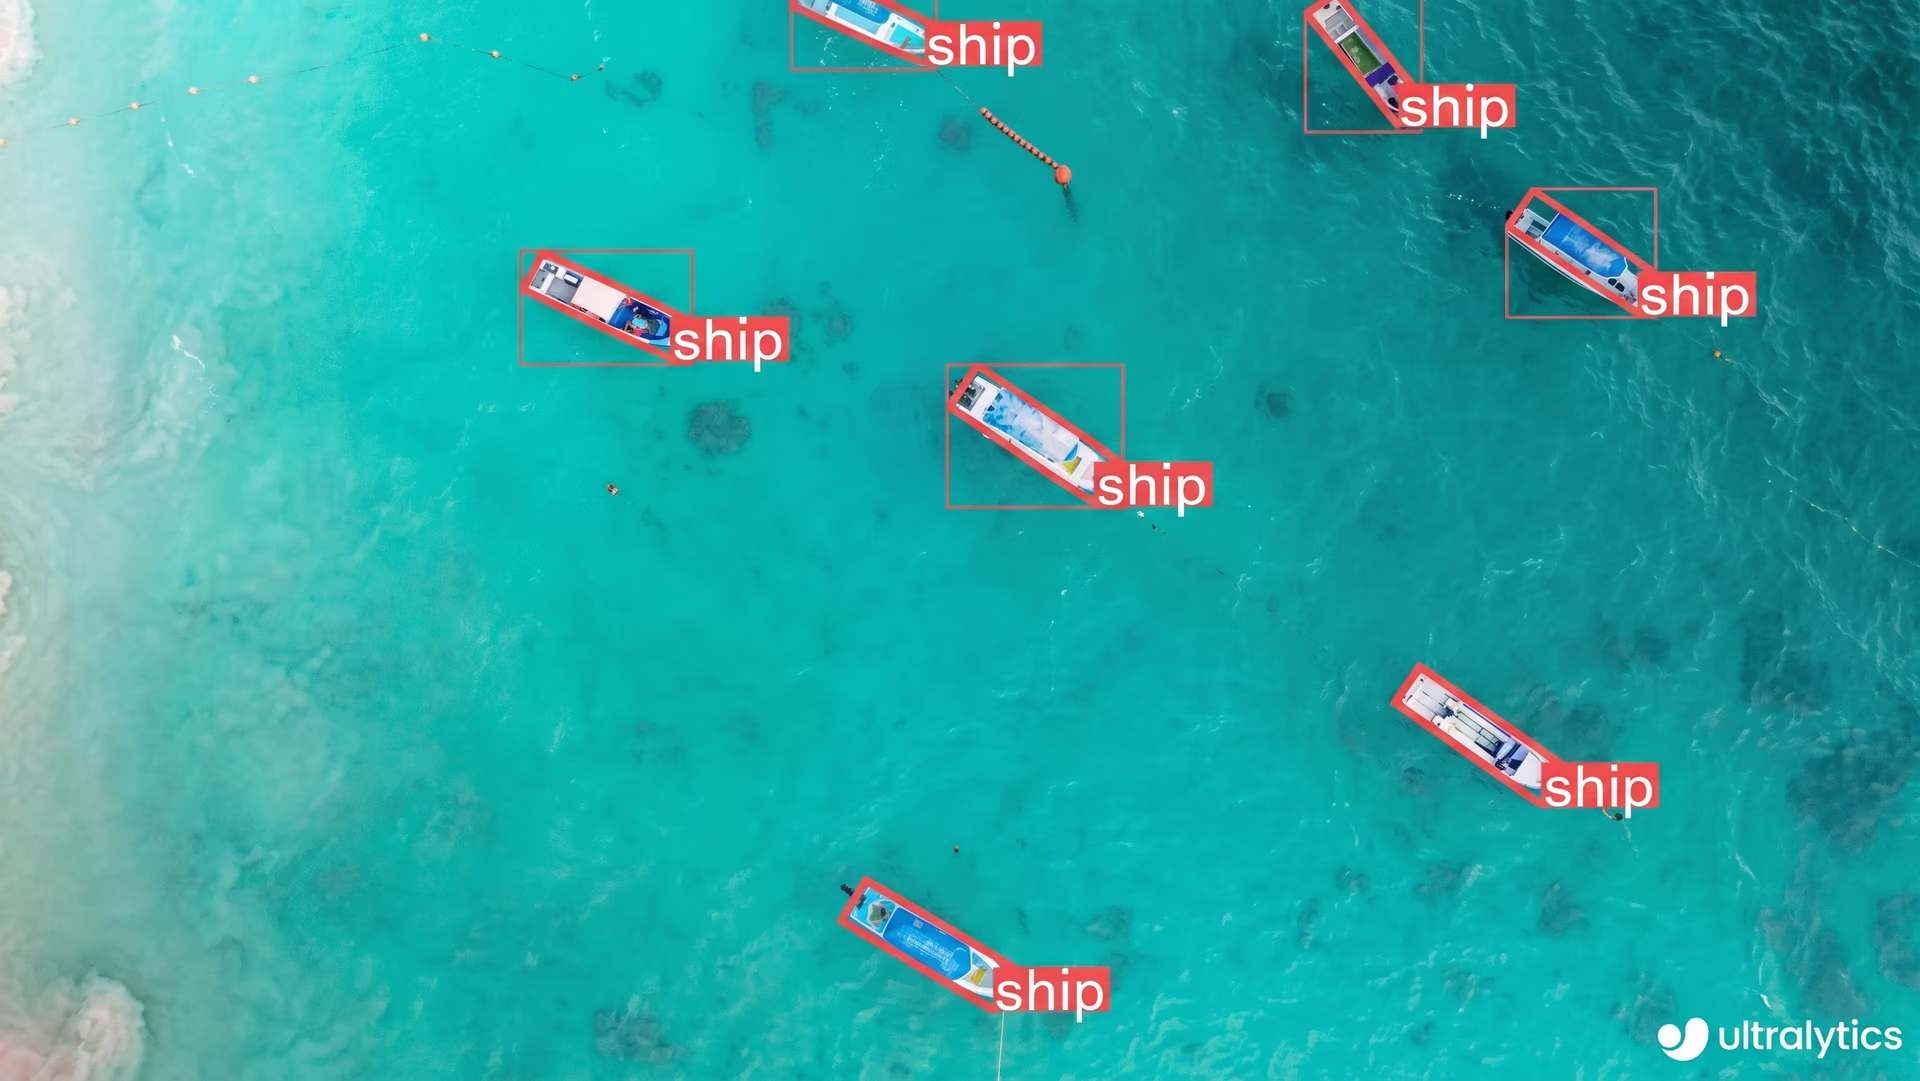
Ultralytics YOLO11 поддерживает такие задачи, как обнаружение объектов, сегментация экземпляров и классификация изображений, и подходит для применения в автономном вождении, видеонаблюдении и аналитике розничной торговли.
Рис. 1. Ultralytics YOLO11 можно использовать для обнаружения различных объектов.
Пакет Ultralytics для Python предоставляет удобные инструменты для быстрой тренировки, настройки и развёртывания моделей ИИ, позволяя пользователям любого уровня подготовки легко создавать передовые приложения компьютерного зрения.
Если ты хочешь глубже разобраться в том, как всё устроено, или создать собственные настройки, загляни в раздел Справочник документации Ultralytics. В нём описано внутреннее устройство пакета Ultralytics для Python, в том числе обработка данных, процесс тренировки модели и визуализация предсказаний.
В этой статье мы подробнее рассмотрим раздел «Справочник» в документации Ultralytics и расскажем, как использовать его в проектах по компьютерному зрению. Начнём!
Подробнее о работе с моделями Ultralytics YOLO#
Работать с пакетом Ultralytics для Python просто и удобно. Всего несколькими строками кода можно тренировать модели YOLO или обнаруживать объекты на изображениях.
Когда ты освоишь работу с моделями компьютерного зрения, раздел «Справочник» в документации Ultralytics поможет глубже разобраться в том, как работает код и какие функции поддерживает пакет. В нём также есть понятные объяснения, настраиваемые параметры и ссылки на соответствующий код в репозитории Ultralytics на GitHub.
В нём объясняется структура пакета Ultralytics для Python и описываются его ключевые компоненты: настройка модели, загрузка данных, процесс тренировки, а также создание и возврат предсказаний.
Всё распределено по понятным категориям, поэтому нужную информацию легко найти. Например, если ты тренируешь модель на собственном наборе данных, открой раздел «Справочника», посвящённый данным: он поможет понять, как данные будут использоваться при тренировке модели.
Как начать работу с разделом «Справочник»#
Открой раздел «Справочник» в документации Ultralytics YOLO: слева на странице ты увидишь меню с различными категориями. Каждая категория соответствует определённой части кодовой базы Ultralytics, например моделям, обработке данных или функциям тренировки.
Нажми на категорию, чтобы перейти на страницу с подробной информацией.
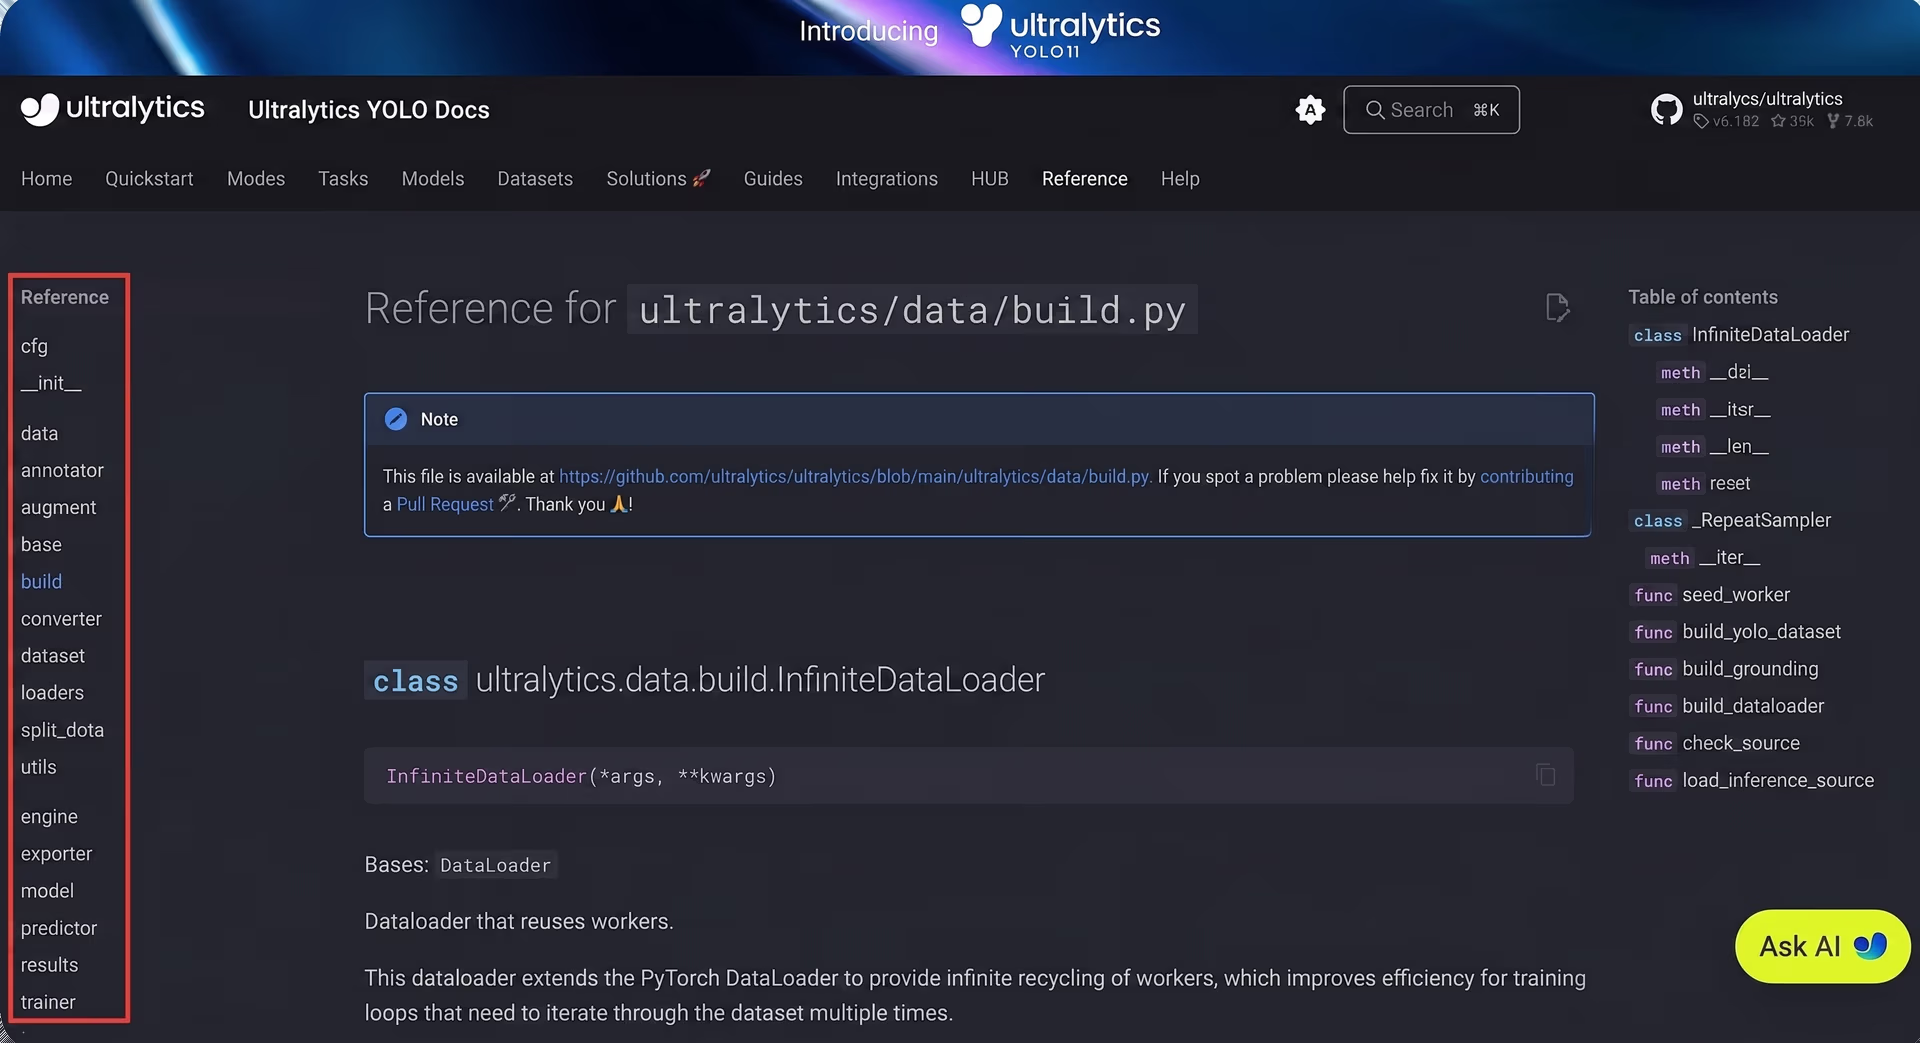
Рис. 2. Слева расположено меню с различными категориями справочника.
Справа на странице находится оглавление, в котором каждая страница справочника разбита на ключевые компоненты: функции (повторно используемые блоки кода), классы (шаблоны для создания объектов) и методы (функции, определённые внутри классов). Так ты сможешь сразу перейти к нужному разделу.
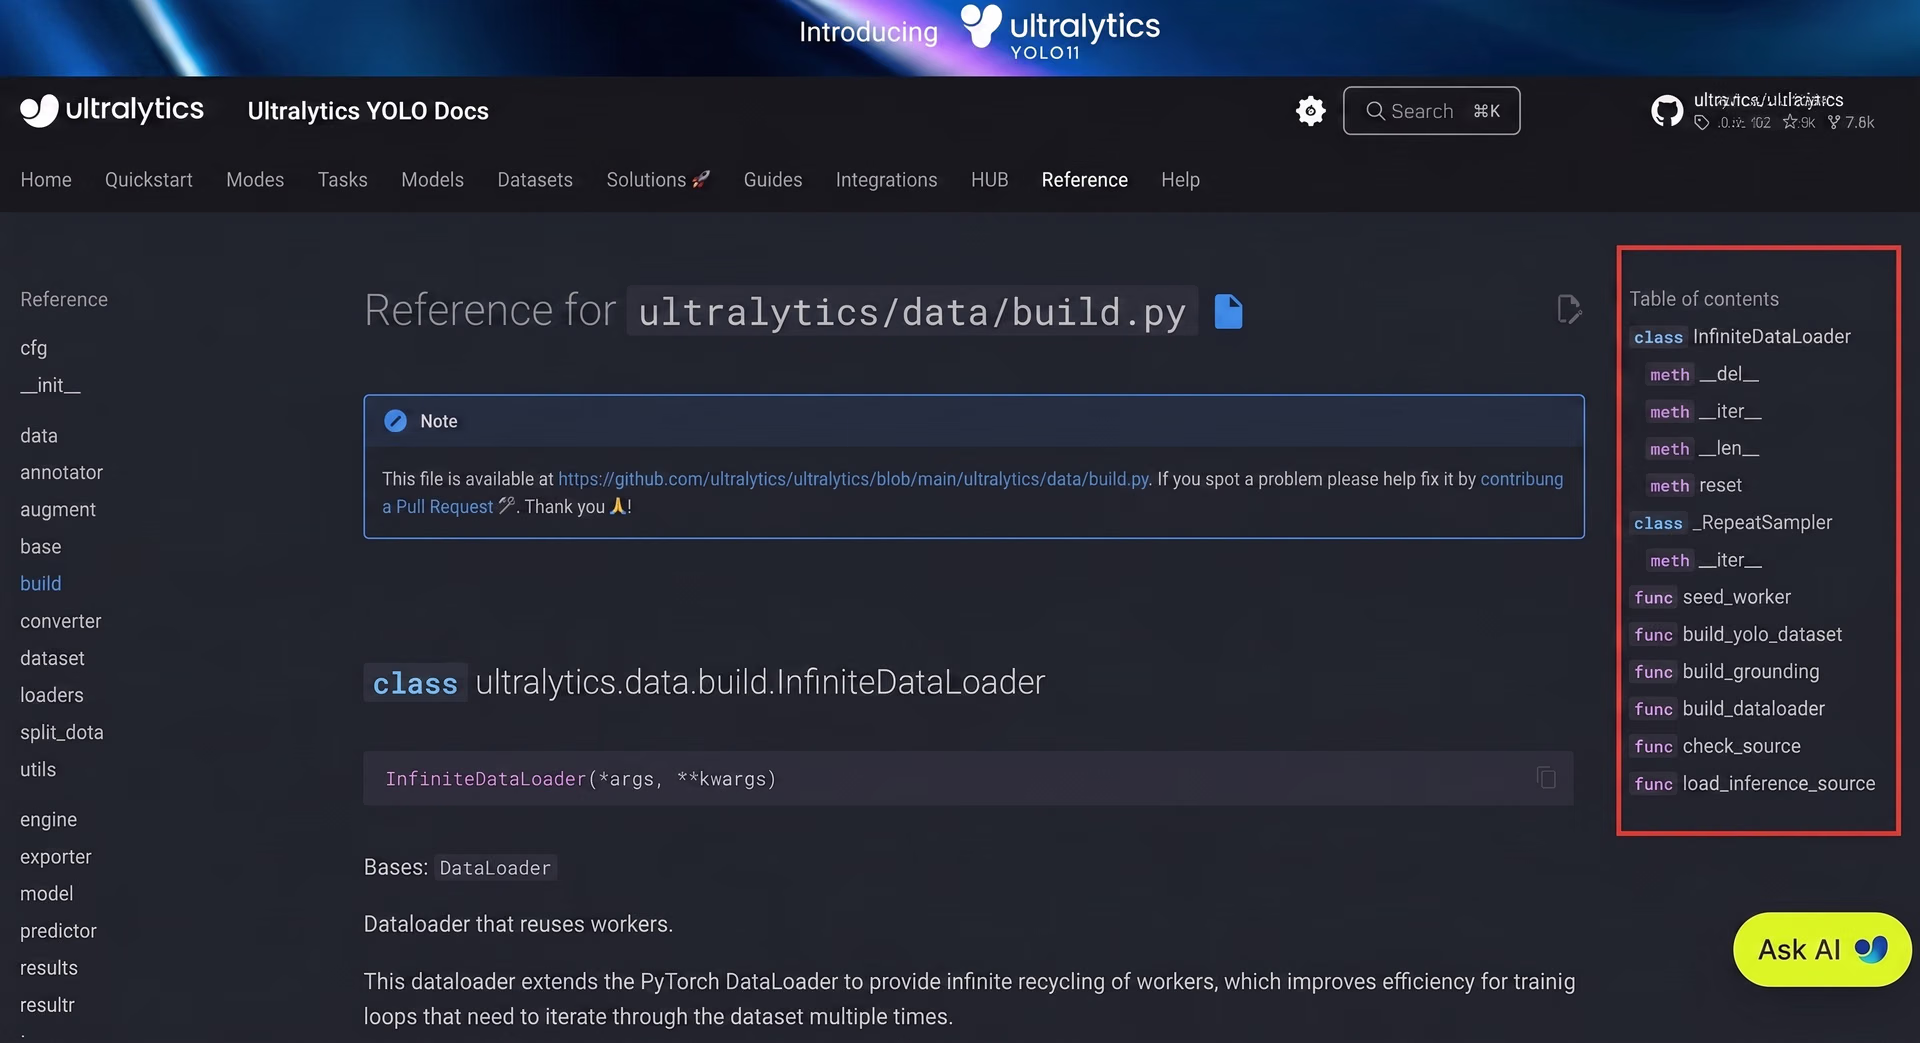
Рис. 3. Справа находится оглавление открытой страницы справочника.
Структура репозитория Ultralytics на GitHub#
Репозиторий Ultralytics на GitHub организован в подкаталоги или подпакеты, соответствующие разным частям пакета Ultralytics, например моделям, тренировке и данным. Раздел «Справочник» в документации повторяет эту структуру, поэтому разобраться во взаимосвязях компонентов проще.
Вот некоторые основные подкаталоги и категории, которые есть и в репозитории Ultralytics на GitHub, и в разделе «Справочник» документации Ultralytics:
- Модели: в этом разделе рассматриваются различные модели и их режимы, например создание предсказаний, проверка производительности и экспорт обученных моделей.
- Движок: здесь реализована основная логика тренировки, валидации, предсказания, экспорта и оценки моделей.
- Данные: этот раздел отвечает за загрузку, обработку и аугментацию наборов данных. Здесь находятся функции для создания загрузчиков данных (инструментов, которые передают данные модели пакетами), применения преобразований (например, изменения размера или отражения изображений, помогающих модели лучше обучаться) и подготовки данных к тренировке (упорядочивания и форматирования изображений и меток).
- Утилиты: в этом разделе собраны различные вспомогательные функции для всей кодовой базы, например инструменты визуализации, работы с файлами и расчёта метрик.
- HUB: этот раздел обеспечивает подключение к Ultralytics HUB — платформе компьютерного зрения без кода. Благодаря этому доступны облачные функции: вход в систему, загрузка моделей и управление наборами данных через API.
- Трекеры: здесь реализована логика отслеживания объектов для приложений, работающих с видео или последовательностями кадров.
Каждому подкаталогу репозитория на GitHub соответствует раздел документации. Такая структура повторяется намеренно, чтобы можно было легко переключаться между документацией и исходным кодом.
Кроме того, на многих страницах справочника показан исходный код, поэтому ты можешь изучить реализацию функций и классов, не покидая документацию.
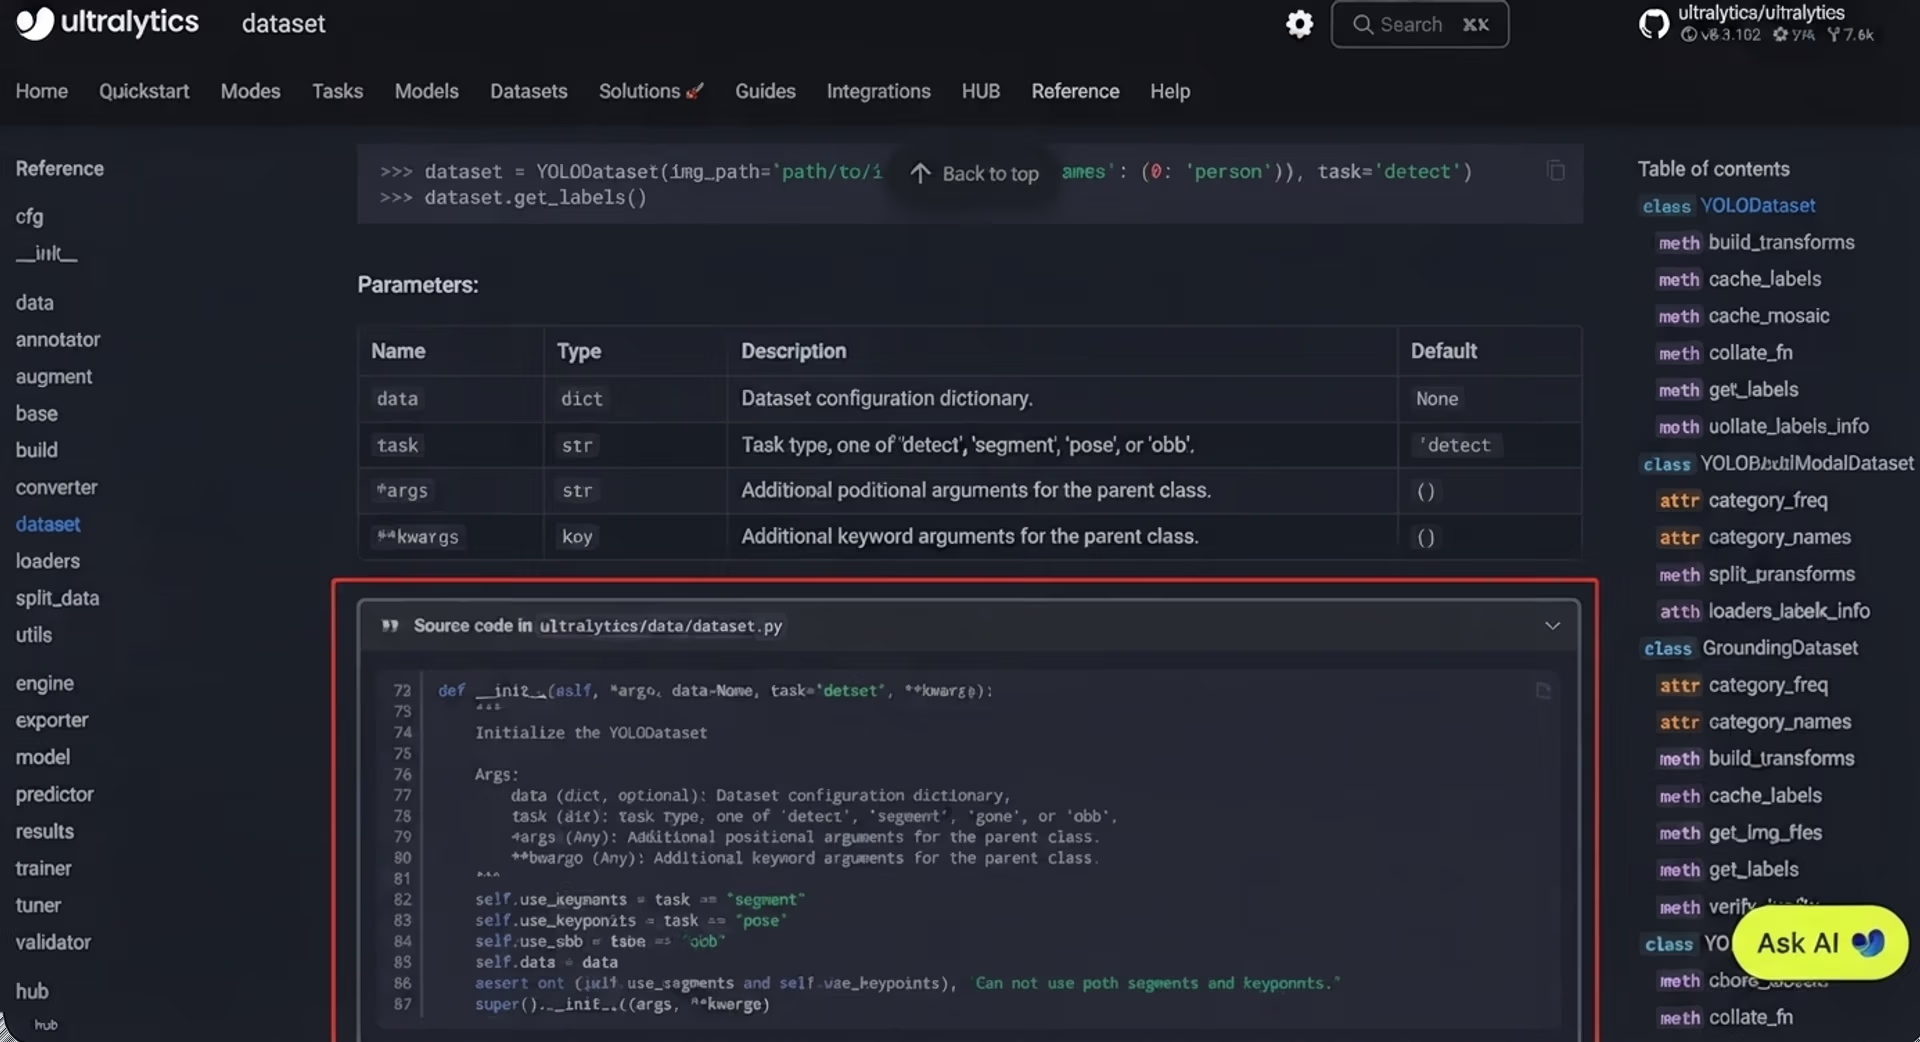
Рис. 4. Исходный код также приведён на страницах справочника.
Разбираемся в компонентах моделей, движка и данных#
Теперь, когда мы разобрались со структурой раздела «Справочник», давай подробнее рассмотрим три ключевые части пакета Ultralytics: модели, движок и данные.
В подкаталоге моделей находится код, который определяет принцип работы каждого типа моделей. Структура организована по типам моделей (например, YOLO, FastSAM или RT-DETR) и задачам — обнаружению, сегментации или классификации. В каждом разделе ты найдёшь файлы и модули для выполнения определённых действий: например, для создания предсказаний, тренировки модели или оценки её производительности.
Подкаталог движка тем временем управляет всем процессом «за кулисами». Подкаталог моделей описывает, что должна делать каждая модель, а подкаталог движка — как выполнять эти задачи единообразно и эффективно.
Подкаталог данных отвечает за загрузку и подготовку наборов данных. Эта часть кодовой базы гарантирует, что данные для тренировки будут чистыми, структурированными и разнообразными, помогая модели лучше обучаться и эффективнее обобщать закономерности.
Чёткое разделение упрощает поддержку кода и позволяет пользователям гибко настраивать его.
Примеры работы с разделом «Справочник»#
Зачем разбираться в разных частях кодовой базы Ultralytics? Если ты знаешь, за что отвечает та или иная часть кода, тебе будет проще найти нужную информацию, внести изменения или устранить неполадки.
Вот несколько примеров использования раздела «Справочник» в документации:
- Если ты хочешь узнать, «Как модель создаёт предсказания?», открой в справочнике категорию «Модели», выбери тип модели (например, YOLO), укажи задачу (например, detect), а затем открой страницу Predict.
- Чтобы узнать, как применяются аугментации данных, изучи страницу Augment в категории Data. На ней перечислены встроенные методы аугментации, которые повышают производительность модели и разнообразие данных для тренировки.
Изучение результатов с помощью раздела «Справочник»#
Раздел «Справочник» также пригодится, если ты хочешь разобраться в результатах, которые возвращает модель. После выполнения инференса на изображении с помощью модели, например Ultralytics YOLO11, она возвращает набор результатов с описанием обнаруженных объектов.
Например, на изображении с камеры модель может обнаружить человека и выделить его местоположение с помощью ограничивающей рамки, а также присвоить оценку уверенности — значение от 0 до 1, показывающее, насколько модель уверена в обнаружении.
Если ты хочешь понять, как использовать эти выходные данные в своём проекте, раздел «Справочник» подскажет, что делать. На странице модуля Results описано, что входит в результаты и как получить к ним доступ в коде. Там также рассказывается, как просматривать рамки обнаруженных объектов, проверять оценки уверенности, отображать результаты и сохранять их.
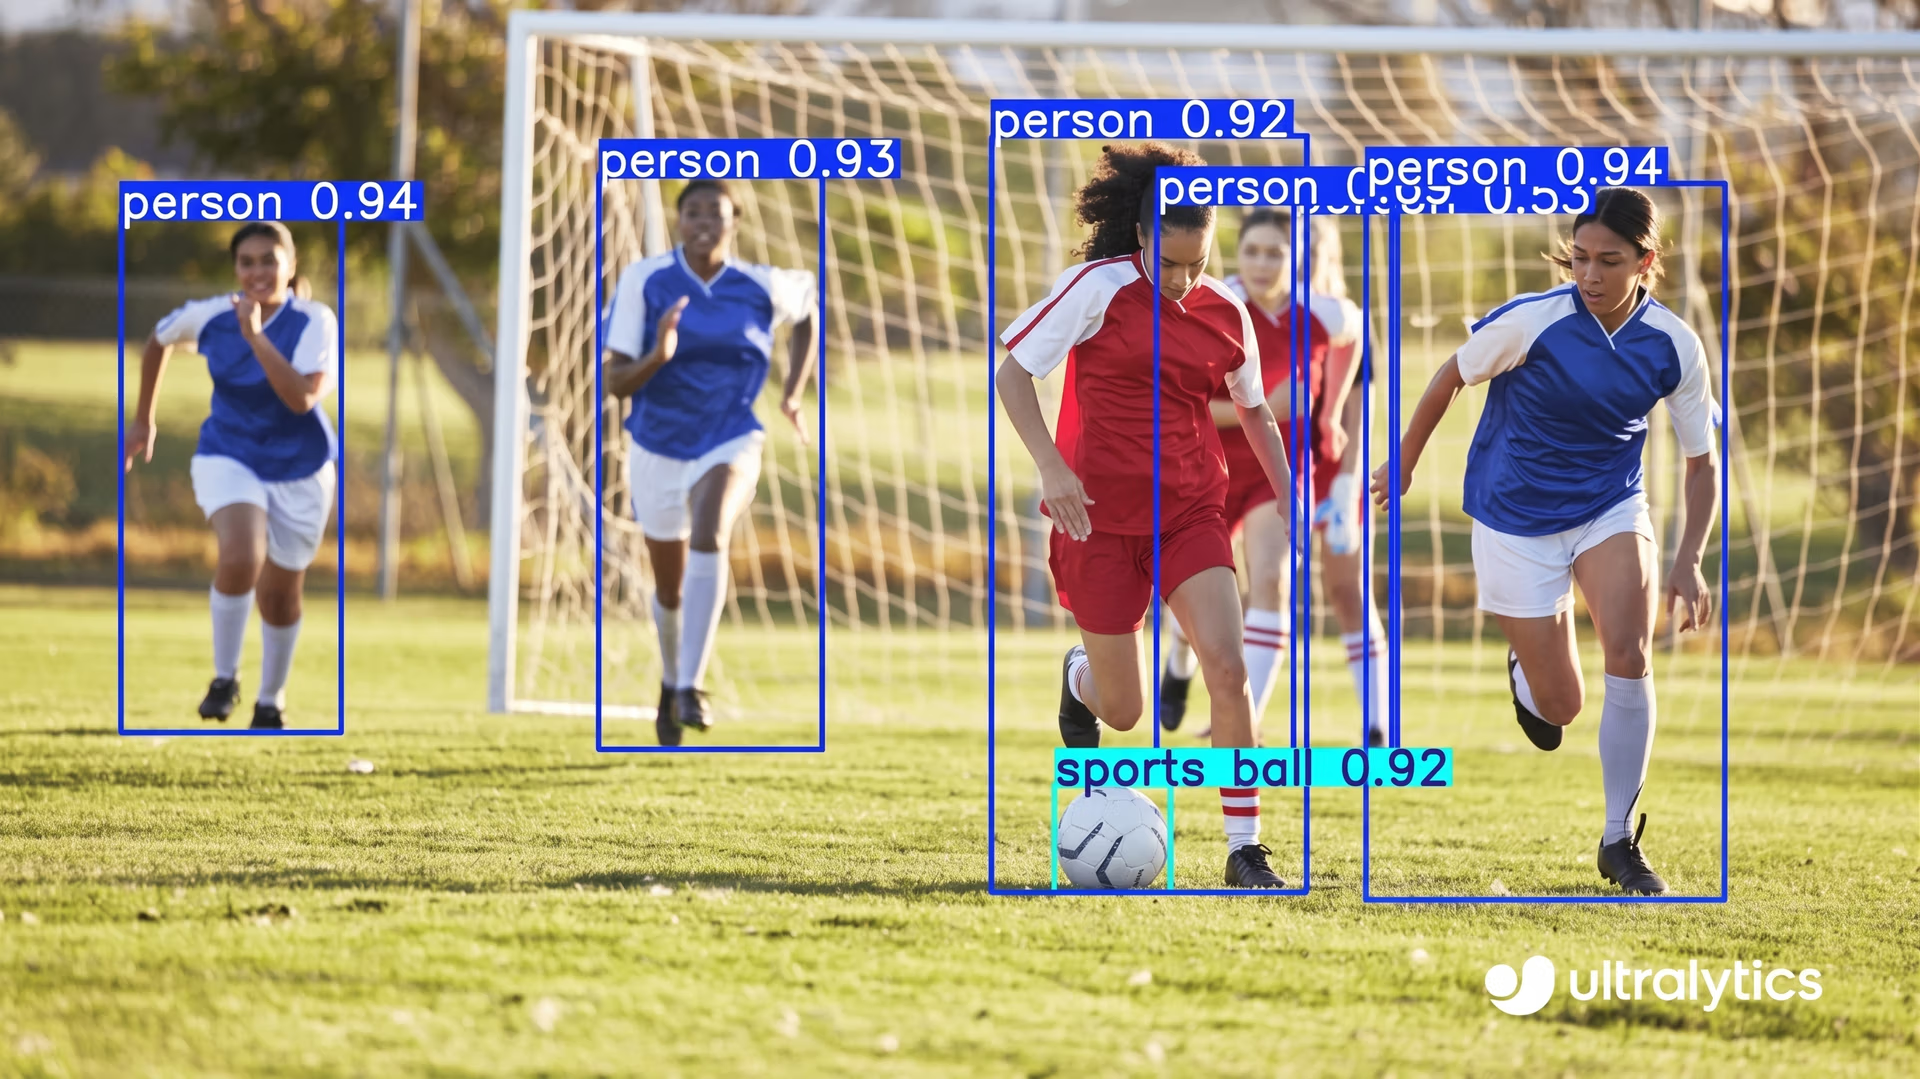
Рис. 5. Пример визуализации результатов, возвращённых YOLO11.
Главные выводы#
Документация Ultralytics помогает эффективно использовать модели YOLO. В ней объясняются ключевые процессы: тренировка моделей, подготовка данных и работа с результатами. На каждой странице есть понятные объяснения и примеры кода, которые помогут быстро начать работу.
Если тебе интересно, что происходит «за кулисами», раздел «Справочник» в документации также подробно описывает весь процесс. В нём показано, как устроен код, за что отвечает каждый компонент и как они взаимодействуют. Благодаря этому ты сможешь быстрее учиться, настраивать решения и уверенно создавать собственные проекты в области компьютерного зрения.
Стань частью нашего активного сообщества и изучи репозиторий на GitHub, чтобы узнать больше о создании решений на основе ИИ. Готов воплотить собственные идеи в области компьютерного зрения? Начни с изучения вариантов лицензирования. Узнай, как компьютерное зрение в автомобильной отрасли и ИИ в здравоохранении меняют мир, на страницах наших решений.









