Эффективное управление наборами данных для компьютерного зрения с Ultralytics Platform
Узнай, как использовать Ultralytics Platform для более эффективного управления наборами данных в проектах компьютерного зрения. Легко отслеживай, сравнивай и улучшай наборы данных.
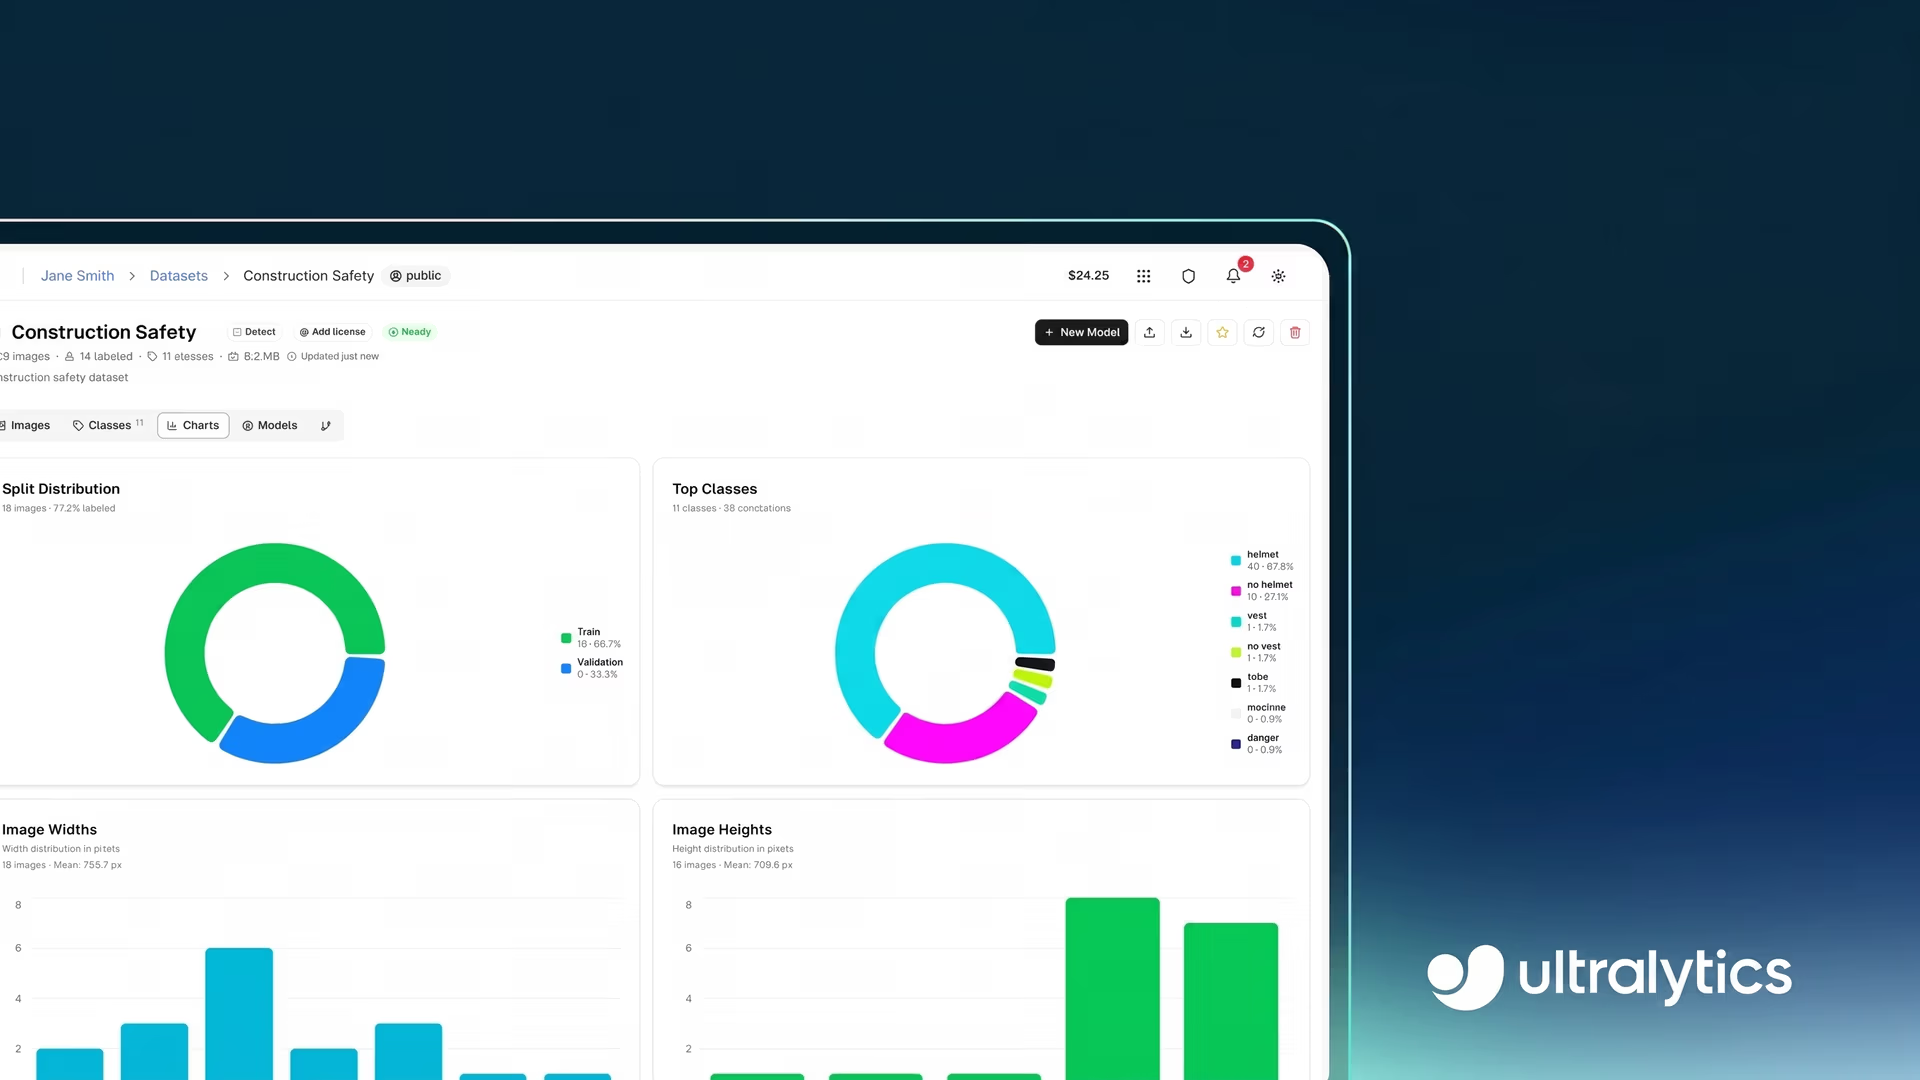
Компьютерное зрение на основе ИИ, или компьютерное зрение, прошло большой путь с первых дней своего развития: из экспериментального направления исследований оно превратилось в ключевую технологию для реальных приложений. Сегодня энтузиасты ИИ могут создавать мощные модели для таких задач, как обнаружение объектов и сегментация экземпляров, используя доступные инструменты и фреймворки.
Однако по мере перехода этих приложений от экспериментов к промышленной эксплуатации управление наборами данных остается критически важной и часто упускаемой из виду задачей. По мере роста объема и сложности наборов данных для компьютерного зрения командам часто становится сложно поддерживать единообразие аннотаций, отслеживать изменения между версиями и обеспечивать общее качество данных.
Даже самые передовые модели могут работать хуже в реальных условиях, если данные, на которых их обучали, неполны, несбалансированны или плохо организованы. Этот растущий разрыв между качеством разработки и надежностью в реальных условиях требует более структурированного подхода к управлению наборами данных.
Еще одно распространенное ограничение состоит в том, что сбор данных, аннотирование и обучение часто выполняются в разных инструментах. Фрагментированный рабочий процесс затрудняет эффективное управление наборами данных, повышает риск несоответствий и замедляет итерации.
Чтобы устранить узкие места в компьютерном зрении на основе ИИ, такие как управление наборами данных и фрагментированные рабочие процессы, мы недавно запустили Ultralytics Platform. Это комплексное рабочее пространство, объединяющее управление наборами данных, аннотирование, обучение, развертывание и мониторинг в единый рабочий процесс.
Объединив все этапы жизненного цикла компьютерного зрения, ты сможешь проще отслеживать изменения наборов данных, сравнивать производительность разных версий и постоянно улучшать данные для получения лучших результатов.
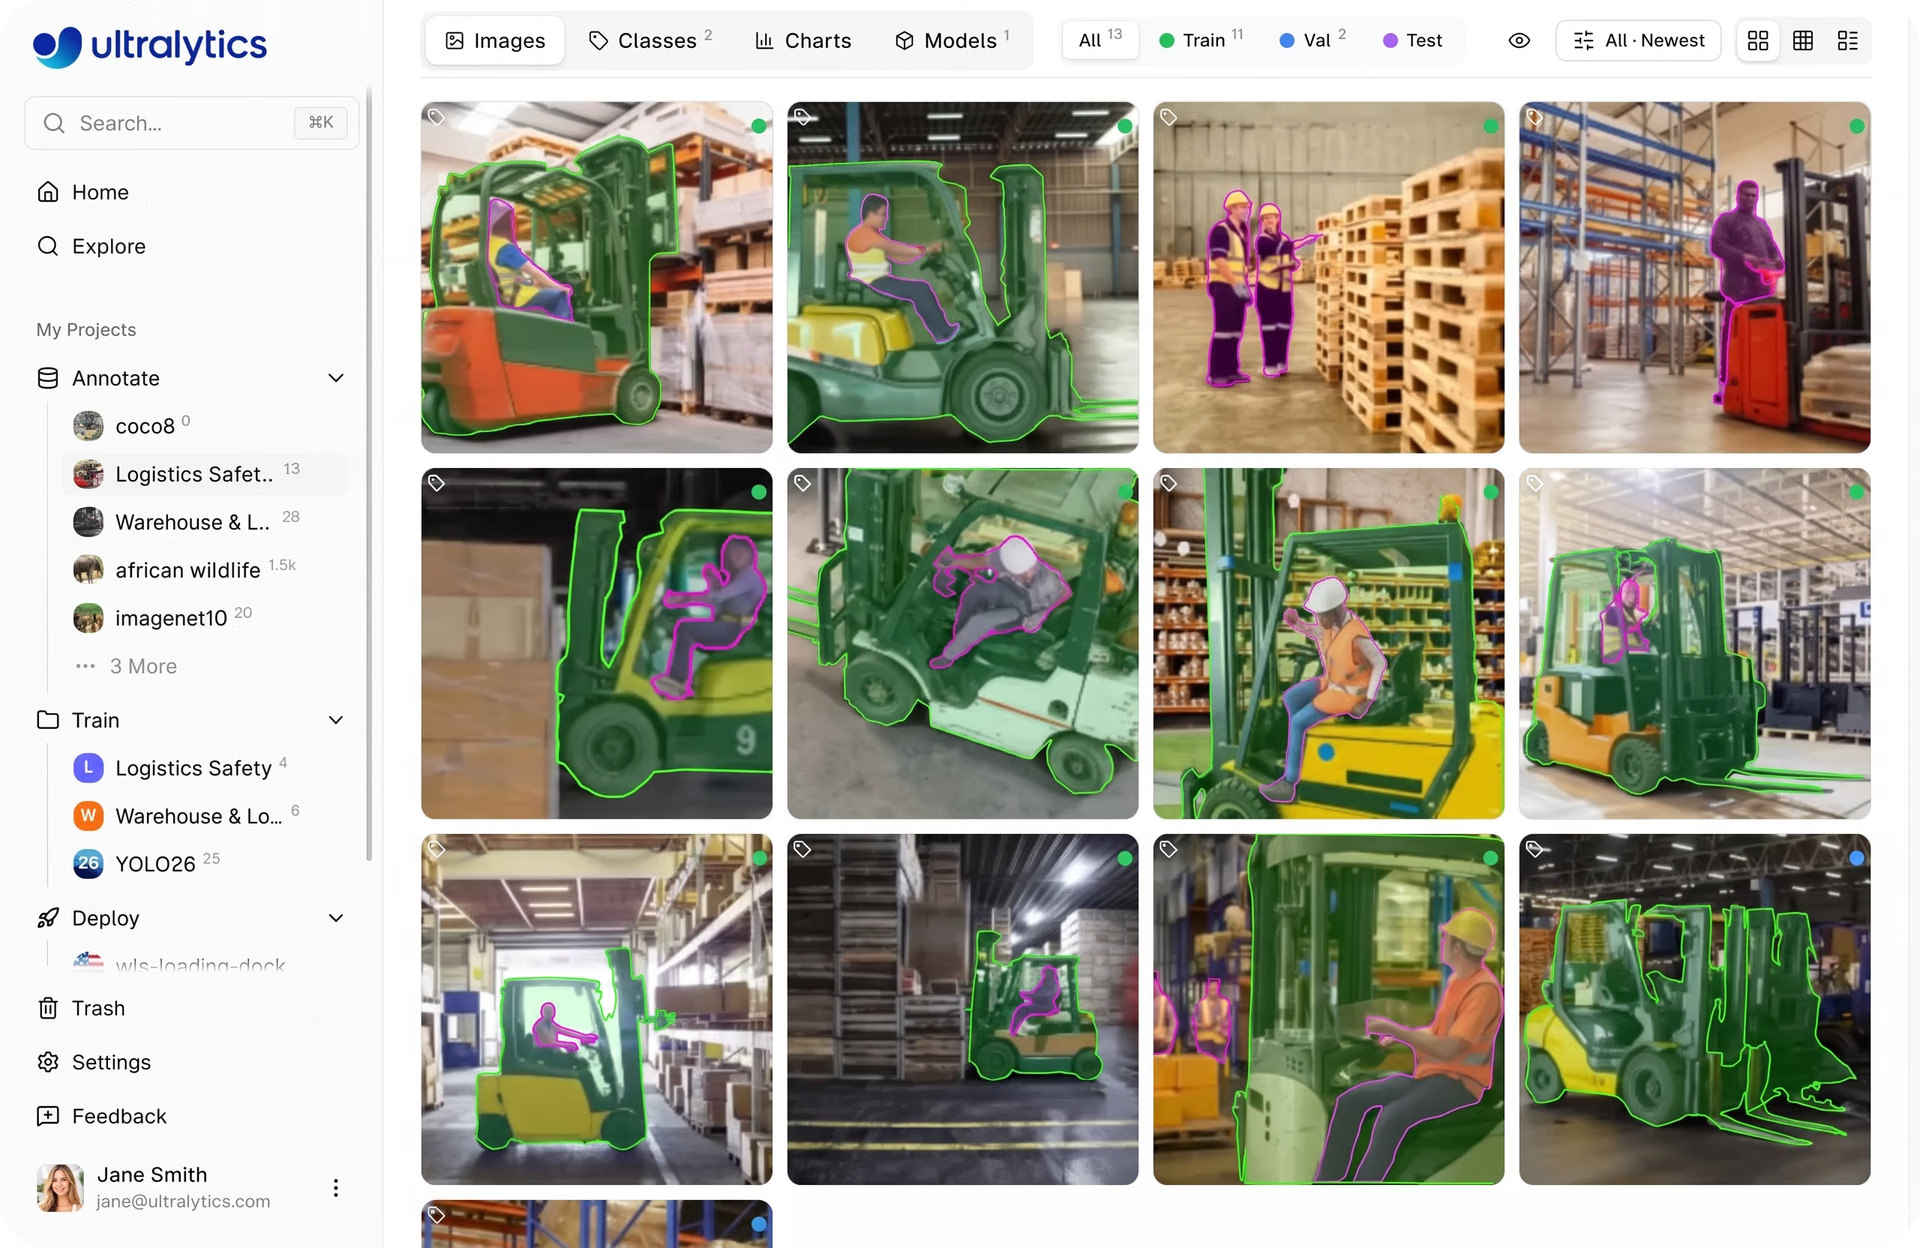
Рис. 1. Пример просмотра изображений набора данных в Ultralytics Platform (Источник)
В этой статье мы подробно рассмотрим, как Ultralytics Platform помогает отслеживать, сравнивать и улучшать наборы данных, чтобы создавать более надежные модели компьютерного зрения. Приступим!
Важность управления наборами данных в компьютерном зрении#
Производительность модели компьютерного зрения тесно связана с данными, на которых ее обучали. Точность модели — то, насколько часто ее предсказания верны, — зависит не только от алгоритма, но и от того, насколько хорошо набор данных отражает реальные условия.
Проще говоря, модель обучается непосредственно на данных, поэтому любые пробелы, смещения или несоответствия в наборе данных могут повлиять на ее предсказания. Иными словами, низкое качество данных, неверные аннотации или недостаточный охват изменений реальных условий на изображениях — например, освещения, ракурсов объектов, фона или степени окклюзии — могут значительно снизить точность, даже если архитектура модели сама по себе эффективна.
Это относится и к дообучению модели: предварительно обученную модель дополнительно обучают на новых или обновленных данных, чтобы лучше адаптировать ее к конкретной задаче или среде. Поскольку точность модели так сильно зависит от данных, правильное управление ими становится необходимым.
Управление набором данных включает организацию, разметку и постоянное обновление данных, чтобы они оставались точными и актуальными. Это упрощает постепенное повышение производительности, особенно при переобучении или дообучении моделей на новых данных.
Как качество набора данных влияет на надежность в реальных условиях#
Сценарии применения компьютерного зрения, например системы видеонаблюдения, наглядно показывают, почему правильное управление данными так важно. Такие системы должны надежно работать в самых разных реальных условиях, включая разное освещение, ракурсы камер, плотность толпы и частичную окклюзию.
Если обучающие данные не охватывают такие вариации или в них недостаточно разнообразных примеров появления объектов в разных сценах и условиях, модели может быть сложно точно обнаруживать объекты. Например, модель, обученная преимущественно на хорошо освещенных и незагроможденных сценах, может плохо работать при слабом освещении или в местах скопления людей. В системах безопасности это может привести к пропущенным событиям или ложным тревогам.
Чтобы этого избежать, важно поддерживать наборы данных не только чистыми и точно размеченными, но также сбалансированными и постоянно обновляемыми. Для этого нужно выявлять пробелы в данных, добавлять новые примеры по мере изменения условий и обеспечивать равномерное представление разных классов и сред.
Более полный и структурированный набор данных помогает моделям лучше справляться с изменчивостью реальных условий и выдавать более надежные предсказания.
Ключевые аспекты управления наборами данных#
Итак, что на практике включает управление наборами данных? Это организация, разметка и поддержка данных, чтобы их можно было эффективно использовать на всех этапах разработки модели.
Например, организация данных включает структурирование набора и разделение его на обучающую, валидационную и тестовую выборки. Обучающая выборка используется для обучения модели, валидационная — для отслеживания ее производительности и корректировки настроек в процессе разработки, а тестовая — для оценки того, насколько хорошо итоговая модель работает на совершенно новых данных.
Разметка включает аннотирование изображений с указанием таких сведений, как метки классов, ограничивающие рамки или маски сегментации. Поскольку модель обучается на этих аннотациях, их точность и согласованность крайне важны для усвоения значимых закономерностей и получения надежных предсказаний.
Кроме того, поддержка набора данных подразумевает проверку и обновление данных со временем. Это может включать исправление ошибок аннотирования, удаление некачественных или дублирующихся данных и добавление новых примеров для охвата недостающих случаев или меняющихся условий.
В более широком смысле управление набором данных — это непрерывный процесс. По мере оценки моделей и сбора новых данных наборы данных необходимо обновлять, чтобы они отражали реальные условия и нестандартные случаи. Отслеживание этих обновлений и сравнение разных версий помогает командам понять, что улучшает производительность и где требуются дальнейшие изменения.
Управление наборами данных с помощью Ultralytics Platform#
Ultralytics Platform предоставляет структурированный рабочий процесс для управления наборами данных в единой среде — от подготовки данных до экспорта. Платформа рассчитана как на отдельных разработчиков, так и на команды, упрощая последовательное управление наборами данных при самостоятельной работе и совместной работе над проектами.
Каждый этап призван упростить организацию, обработку и использование наборов данных на протяжении всего жизненного цикла разработки модели. Объединяя эти этапы в одном месте, платформа сокращает фрагментацию и помогает проще поддерживать согласованность рабочих процессов.
Далее рассмотрим основные этапы и то, как платформа помогает на каждом из них.
Загрузка наборов данных в Ultralytics Platform#
Начать работу с наборами данных на платформе можно разными способами: импортировать или повторно использовать данные. Ты можешь загрузить собственные данные или быстрее приступить к работе с общедоступными наборами данных на платформе. Также можно клонировать наборы данных, которыми поделилось сообщество, и развивать их дальше.
Функции сообщества платформы упрощают поиск и повторное использование уже созданных материалов. Получив доступ к наборам данных других пользователей, содержащим миллионы изображений и аннотаций, ты можешь быстро приступить к работе, не собирая и не размечая все самостоятельно. При клонировании набора данных в рабочем пространстве создается его копия: ты можешь изменять и расширять ее, сохраняя оригинал.
Для загрузки платформа поддерживает отдельные изображения, видео и архивы наборов данных, например файлы ZIP, TAR или GZ. Также поддерживаются популярные форматы наборов данных, такие как YOLO и COCO, поэтому существующие наборы данных и аннотации можно импортировать без дополнительного преобразования. Кроме того, набор данных можно загрузить из файла NDJSON, экспортированного с платформы, что упрощает воссоздание наборов данных и их повторное использование в разных проектах.
После загрузки данные проходят структурированный конвейер обработки. Он включает проверку форматов и размеров файлов, изменение размера изображений при необходимости, разбор аннотаций и формирование статистики набора данных.
Например, видео преобразуются в кадры, чтобы использовать их для обучения, а изображения оптимизируются и подготавливаются для удобного просмотра и анализа. После обработки наборы данных готовы к аннотированию, анализу и обучению моделей на платформе.
Аннотирование данных в Ultralytics Platform#
После загрузки наборы данных можно проверять и аннотировать непосредственно на платформе. В платформу встроены инструменты аннотирования изображений для различных задач компьютерного зрения, таких как обнаружение объектов, сегментация экземпляров, оценка позы, обнаружение объектов в ориентированных ограничивающих рамках (OBB) и классификация изображений.
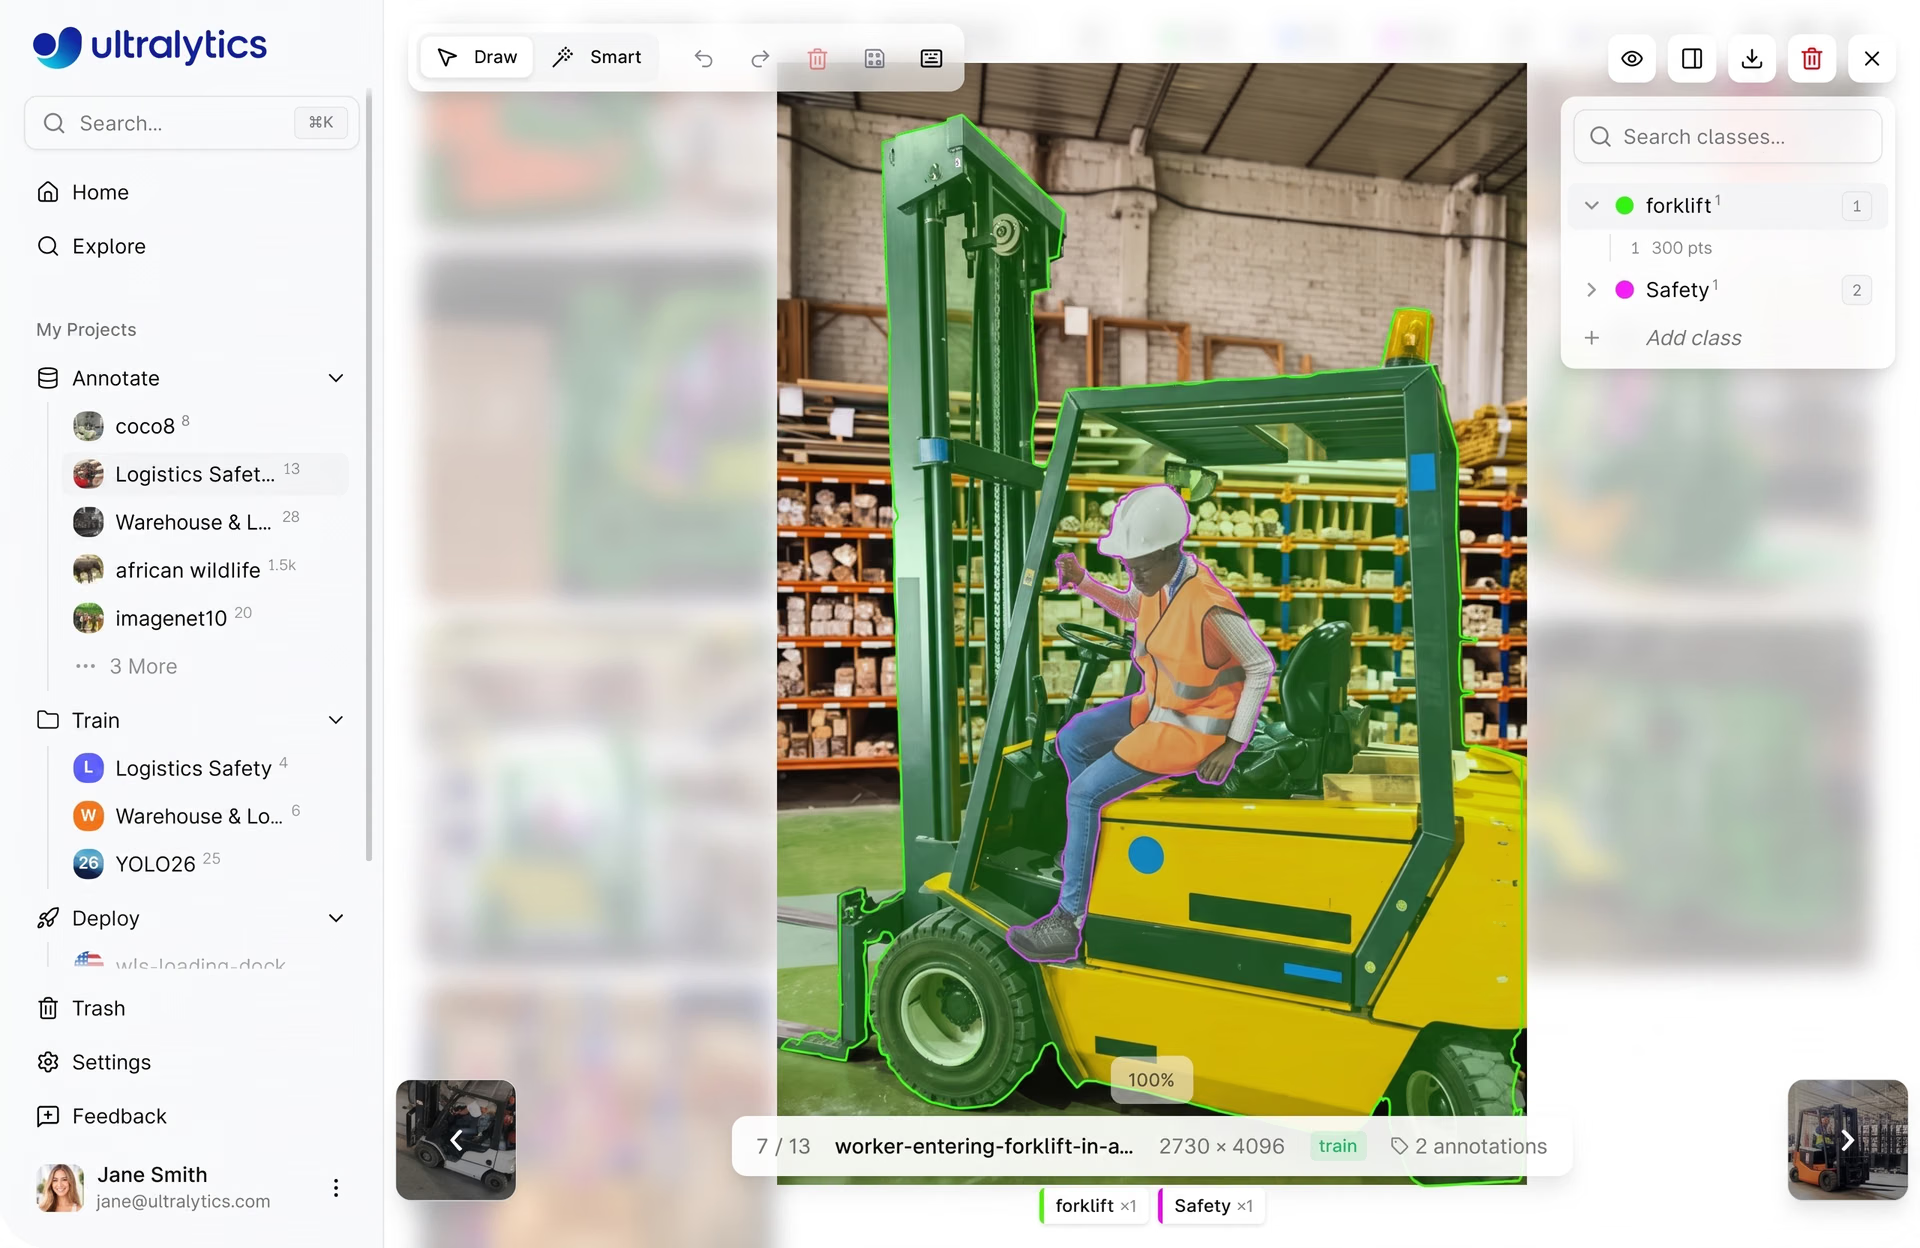
Рис. 2. Разметка данных с помощью Ultralytics Platform (Источник)
Аннотации можно создавать вручную с помощью этих инструментов или ускорить процесс с помощью функций на базе ИИ, например интеллектуального аннотирования на основе SAM. С помощью SAM можно создавать маски, ограничивающие рамки или ориентированные рамки, взаимодействуя с изображением. Это ускоряет разметку и помогает сохранять ее точность.
Анализ качества набора данных с помощью Ultralytics Platform#
Помимо подготовки и аннотирования данных, понимание качества набора данных необходимо для создания надежных моделей компьютерного зрения. Без четкого представления о таких факторах, как распределение классов, качество аннотаций, разбиение набора данных и представленность данных в разных условиях, бывает трудно выявлять проблемы, влияющие на производительность модели.
В Ultralytics Platform встроены функции, помогающие эффективнее анализировать наборы данных. Эти сведения доступны непосредственно в интерфейсе набора данных, на таких вкладках, как «Изображения», «Классы» и «Диаграммы».
На вкладке «Диаграммы» можно просматривать статистику всего набора данных: распределение по выборкам (обучающая, валидационная и тестовая), частоту классов и тепловые карты аннотаций, показывающие расположение объектов на изображениях.
На вкладке «Классы» представлено количество аннотаций для каждого класса, что упрощает выявление дисбаланса классов. На вкладке «Изображения» отображаются сведения об отдельных изображениях: размеры, количество аннотаций и распределение меток.
Эти сведения упрощают выявление таких проблем, как дисбаланс классов, отсутствие отдельных сценариев или неравномерное распределение данных. Например, ты можешь заметить, что у некоторых классов очень мало примеров или что большинство аннотаций сосредоточено в определенных областях изображения.
Помимо анализа данных, платформа поддерживает курирование и аугментацию наборов данных: улучшение наборов путем исправления или удаления проблемных данных и создания вариантов имеющихся данных для повышения производительности модели. Такие улучшения можно вносить прямо на платформе, обновляя аннотации, добавляя новые данные или перестраивая разделение набора данных на основе результатов анализа.
Экспорт наборов данных из Ultralytics Platform#
После подготовки и проверки набор данных можно экспортировать для использования в разных средах. Это позволяет использовать данные для компьютерного зрения там, где тебе удобно: обучать модели локально, в облаке или с помощью других инструментов и рабочих процессов.
Ultralytics Platform поддерживает экспорт в несколько форматов, включая YOLO, COCO и NDJSON, что упрощает интеграцию наборов данных с различными инструментами и рабочими процессами обучения.
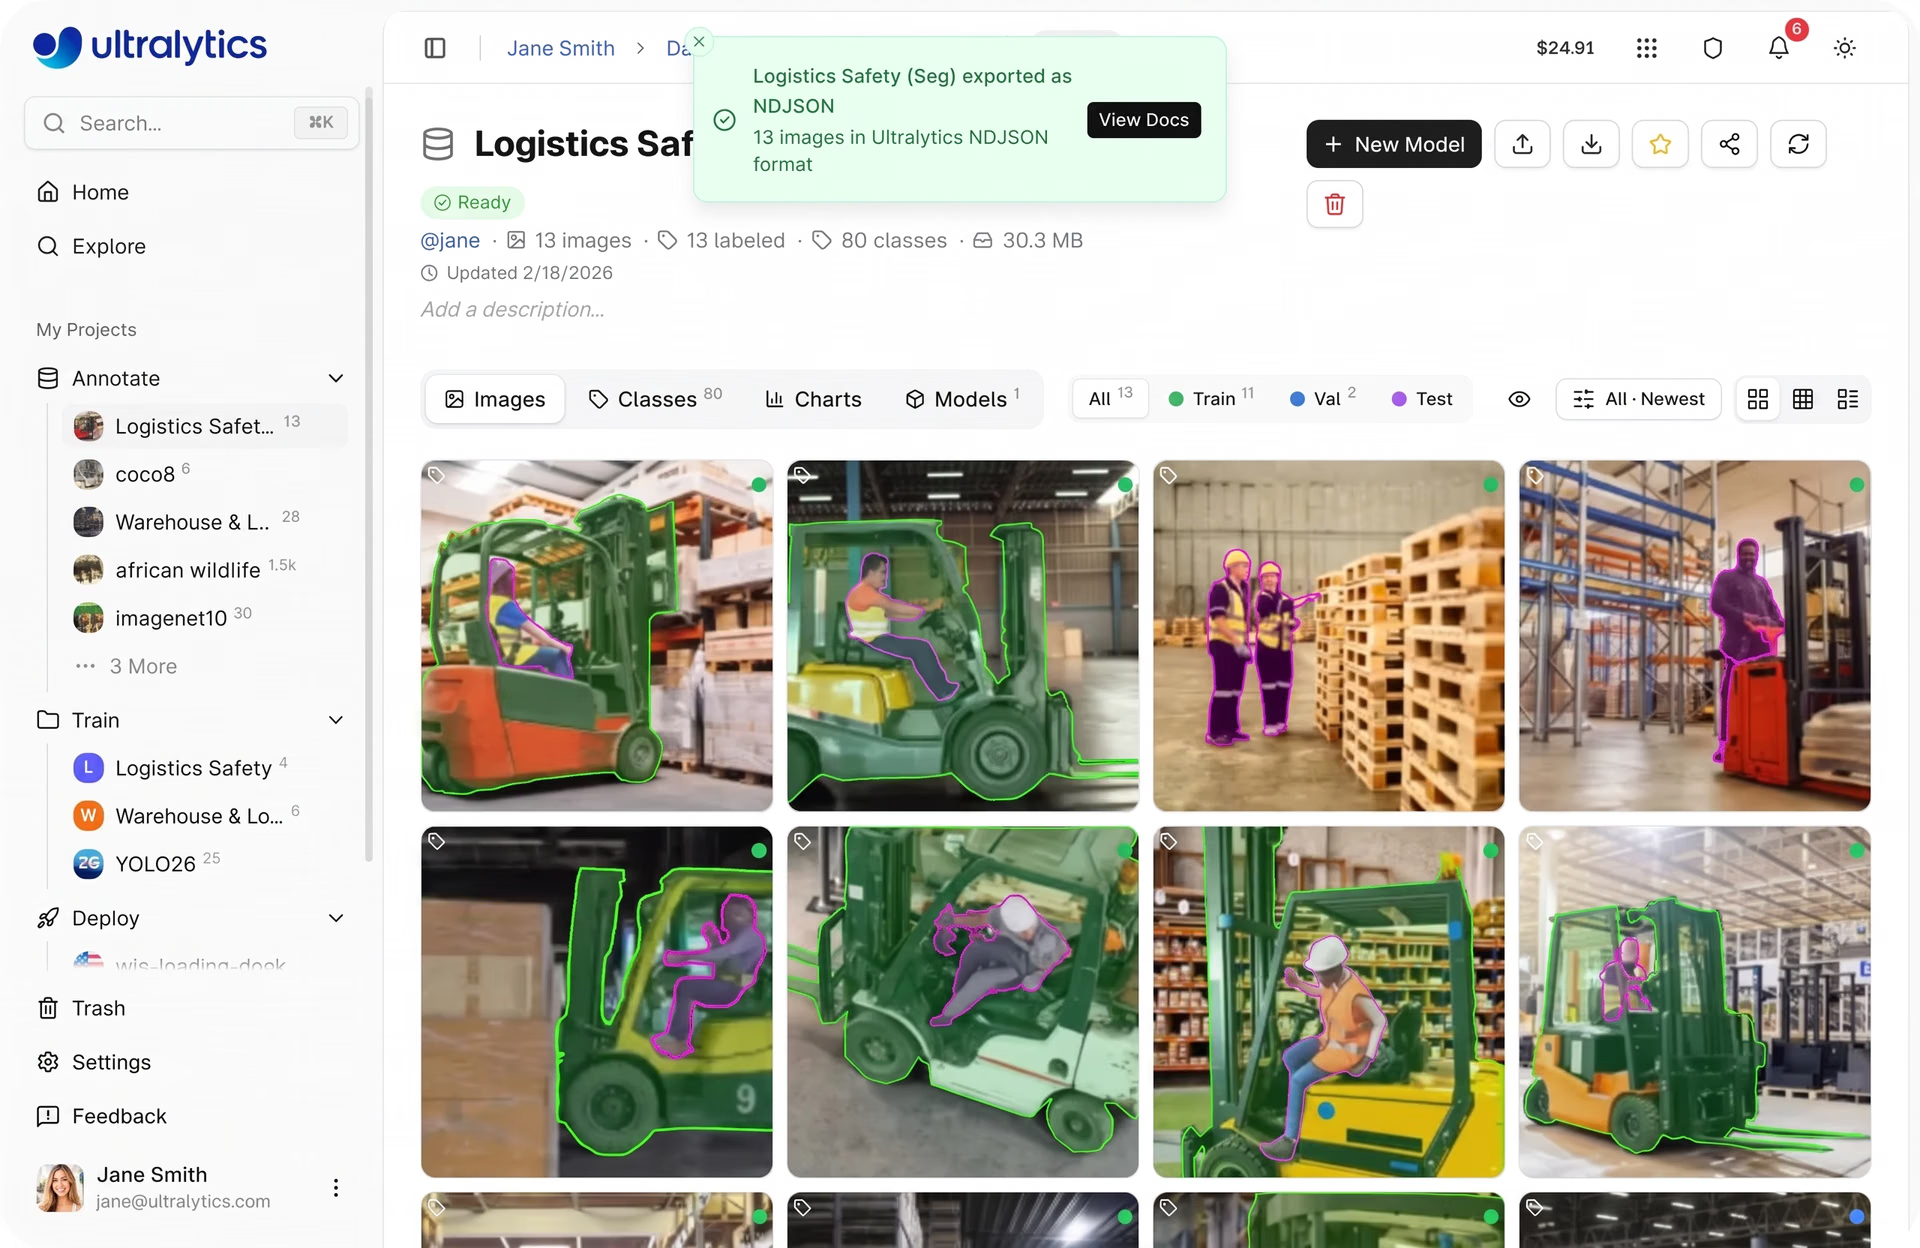
Рис. 3. Экспорт набора данных из Ultralytics Platform (Источник)
При экспорте набора данных создается неизменяемый снимок данных на определенный момент времени, включая изображения, аннотации и структуру. Это полезно, поскольку наборы данных часто меняются: добавляются новые данные, обновляются аннотации или корректируется разбиение. Экспортируя снимок, ты можешь сохранить точную версию набора данных, использованную для конкретного запуска обучения.
Так проще воспроизводить результаты позже: ты можешь снова обучить модель на тех же данных и сравнить производительность разных версий набора данных. Например, ты можешь проверить, действительно ли добавление новых изображений или исправление аннотаций повышает точность модели, вместо того чтобы гадать, что изменилось.
Экспорт выполняется асинхронно. Когда набор данных будет готов, его можно скачать и использовать в локальной, облачной или автономной среде обучения.
Повышение качества наборов данных с помощью итераций в Ultralytics Platform#
В рабочих процессах машинного и глубокого обучения управление наборами данных не заканчивается после развертывания, поскольку реальные данные часто отличаются от тех, что использовались при обучении.
Когда модели получают новые входные данные, становятся заметнее пробелы в наборе данных — например, отсутствие условий слабого освещения, разных ракурсов камеры, окклюзий или переполненных сцен, — а также ошибки аннотирования. Поэтому со временем данные нужно улучшать.
Улучшить набор данных можно несколькими способами. Ты можешь добавить новые изображения или видео, чтобы охватить недостающие условия, например слабое освещение, разные ракурсы камеры, окклюзии или переполненные сцены, и тем самым сократить количество слепых зон в данных.
При этом точные и согласованные аннотации — например, правильно размеченные объекты и точные ограничивающие рамки или маски — помогают модели усваивать более надежные закономерности.
Обычно это простой цикл: обучи модель, оцени результаты, найди ошибки, улучши набор данных и запусти обучение снова. Каждый этап помогает выявить такие проблемы, как неверные аннотации, недостающие данные или недостаточно представленные случаи.
Представь, что ты работаешь над системой мониторинга торговых полок в реальном времени, которая обнаруживает товары в магазинах. В ранних версиях набора данных могут отсутствовать некоторые виды товаров, условия освещения или варианты загромождения полок. Во время оценки ты можешь заметить, что модели сложно обнаруживать товары в таких ситуациях.
Чтобы повысить производительность, ты можешь собрать новые изображения, охватывающие недостающие сценарии, и при необходимости обновить аннотации. Повторение этого процесса со временем помогает модели точнее и надежнее работать в реальных условиях.
Ultralytics Platform поддерживает такой рабочий процесс, связывая обновления наборов данных с обучением и оценкой. Встроенное отслеживание экспериментов и метрики производительности упрощают контроль прогресса и постоянное улучшение наборов данных.
Отслеживание изменений наборов данных с помощью Ultralytics Platform#
Мы вкратце обсудили, как наборы данных меняются со временем в процессе разработки модели. По мере добавления новых данных, уточнения аннотаций и обновления классов становится важно отслеживать эти изменения, чтобы поддерживать качество данных и обеспечивать стабильную производительность модели.
Вот несколько ключевых функций Ultralytics Platform для отслеживания наборов данных и контроля версий:
- Версионирование наборов данных: ты можешь создавать неизменяемые версии наборов данных в виде снимков NDJSON. В каждой версии сохраняются такие важные сведения, как количество изображений, классов и аннотаций, а также размер набора данных на определенный момент времени. Версии хранятся и доступны для скачивания в любое время, что упрощает воспроизведение экспериментов и сравнение результатов для разных состояний набора данных.
- Вкладка «Версии»: все версии набора данных собраны на вкладке «Версии». Здесь можно просматривать историю версий, добавлять описания изменений и отслеживать развитие набора данных со временем.
- Связь с моделями: на вкладке «Модели» отображаются все модели, обученные на наборе данных, а также такие метрики, как mAP, и сведения об обучении. Версии наборов данных связаны с запусками обучения, что помогает понять, как изменения данных влияют на производительность модели.
- Вкладка «Ошибки»: на вкладке «Ошибки» отображаются файлы, обработка которых завершилась неудачно, а также сведения об ошибках и рекомендации. Это помогает выявлять и устранять проблемы, например поврежденные файлы или неподдерживаемые форматы, до начала обучения.
- Интерфейс набора данных (вкладки «Изображения» и «Классы»): эти представления позволяют просматривать изображения, проверять аннотации, управлять метками классов и анализировать распределение классов. Фильтрация, сортировка и поиск изображений без аннотаций упрощают контроль качества набора данных со временем.
- Статистика и диаграммы: встроенные визуализации данных, например распределение по выборкам, частота классов и тепловые карты аннотаций, помогают отслеживать изменения в распределении данных и выявлять дисбаланс по мере развития набора данных.
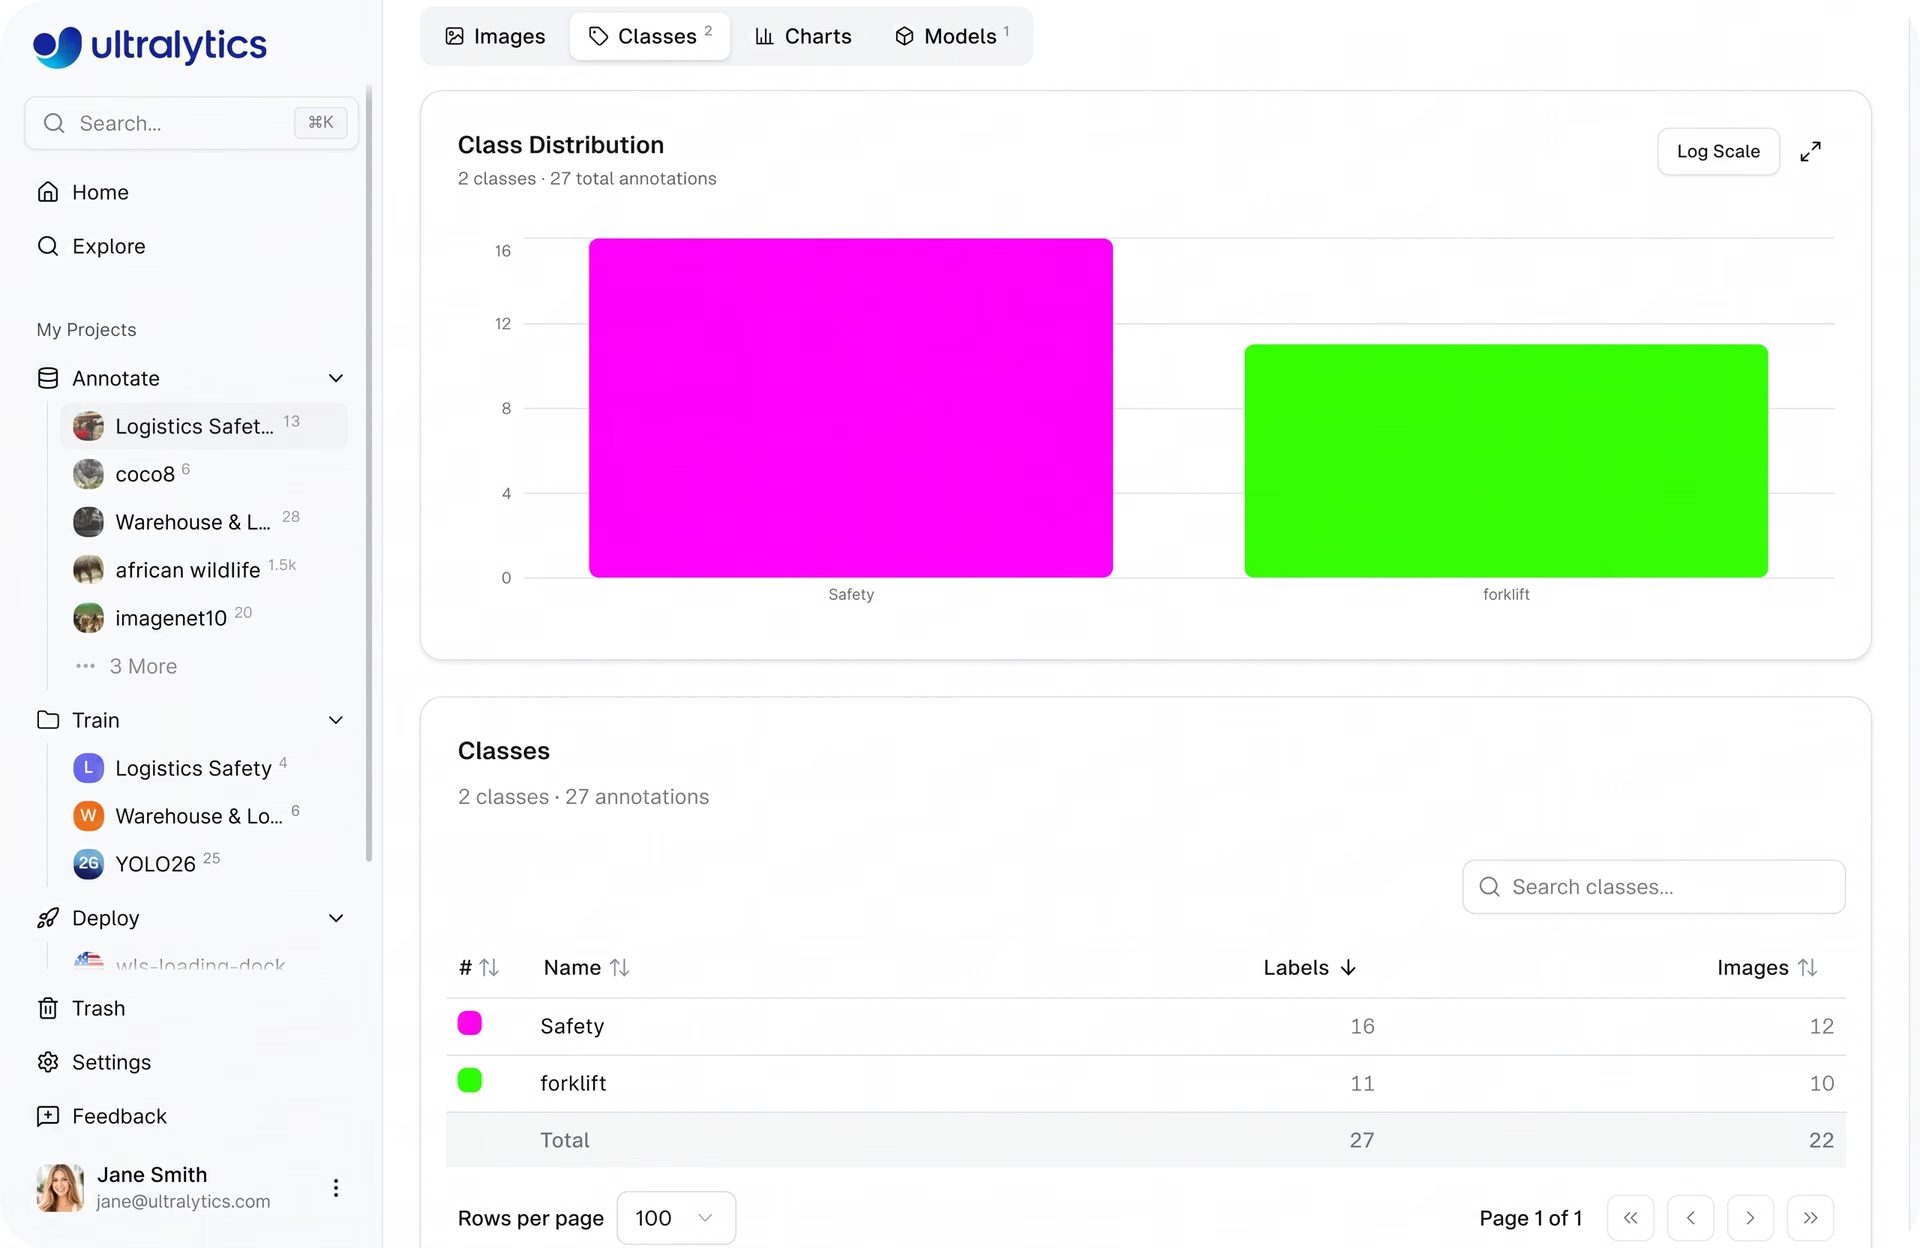
Рис. 4. Пример анализа распределения классов набора данных в Ultralytics Platform (Источник)
Связь наборов данных с обучением и развертыванием в Ultralytics Platform#
Ultralytics Platform объединяет разные этапы разработки моделей ИИ в единый конвейер. Это упрощает переход от исходных данных к готовым к промышленной эксплуатации приложениям компьютерного зрения на основе ИИ.
После подготовки и аннотирования наборы данных можно использовать для обучения моделей компьютерного зрения, например Ultralytics YOLO26, прямо на платформе. Во время обучения ты можешь отслеживать метрики производительности и эксперименты, а также оценивать качество обучения модели с помощью встроенных панелей мониторинга.
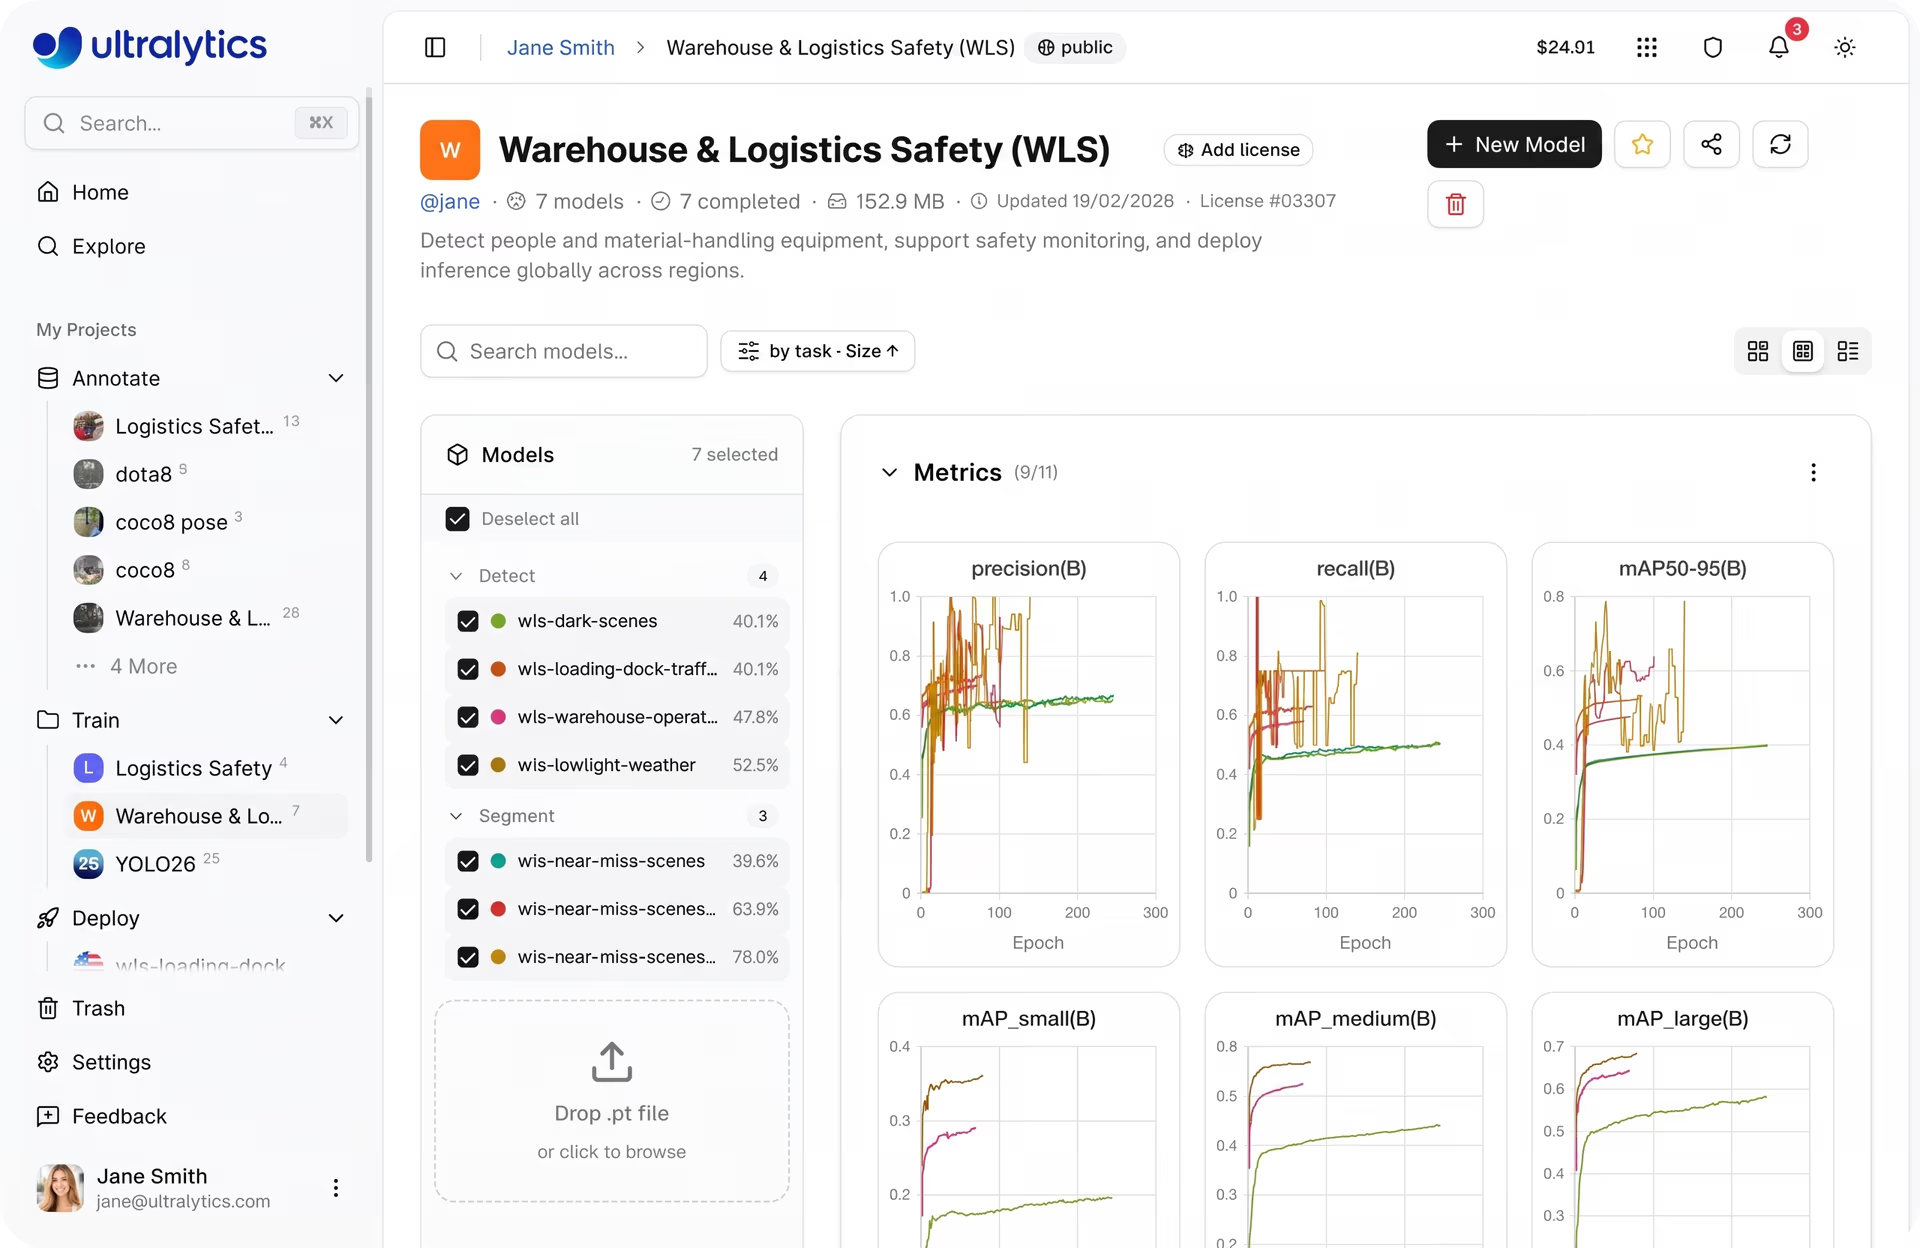
Рис. 5. Пример просмотра метрик обучения модели в Ultralytics Platform (Источник)
После обучения модели можно тестировать на новых изображениях прямо в браузере, чтобы оценить предсказания и выявить области для улучшения до развертывания. Если модель работает хорошо, ее можно развернуть в промышленной среде.
Платформа поддерживает экспорт моделей в разные форматы и их развертывание через сервисы инференса и выделенные конечные точки, позволяя запускать модели в разных средах.
После развертывания встроенные инструменты мониторинга помогают отслеживать производительность системы со временем, включая метрики использования и поведения модели. Это упрощает поддержку и улучшение систем компьютерного зрения на основе ИИ в реальных приложениях.
Рекомендации по управлению наборами данных с помощью Ultralytics Platform#
Вот несколько важных моментов, которые стоит учитывать при управлении наборами данных с помощью Ultralytics Platform:
- Используй фильтры для поиска пробелов: с помощью инструментов фильтрации выявляй данные без меток или с недостаточным представлением. Так будет проще завершить аннотирование и расширить охват данных.
- Исправляй ошибки на раннем этапе: используй вкладку «Ошибки» для контроля качества и выявления неудачных загрузок, поврежденных файлов или неподдерживаемых форматов до начала обучения.
- Постоянно обновляй наборы данных: добавляй новые данные, исправляй аннотации и включай нестандартные случаи по мере их появления. Это расширяет охват и помогает моделям надежно работать в реальных условиях.
- Внимательно управляй разбиением наборов данных: обеспечивай сбалансированное распределение между обучающей, валидационной и тестовой выборками. При необходимости можно перестроить разбиение вручную или использовать автоматическое перераспределение.
Чтобы узнать больше об Ultralytics Platform, ознакомься с официальной документацией Ultralytics.
Главные выводы#
По мере масштабирования проектов компьютерного зрения эффективное управление наборами данных становится не менее важным, чем разработка моделей. Структурированный подход к управлению наборами данных помогает повысить качество данных, оптимизировать рабочие процессы и со временем улучшать производительность моделей.
Ultralytics Platform упрощает этот процесс, объединяя управление наборами данных, обучение и развертывание в едином рабочем процессе. Структурированный подход к управлению наборами данных помогает командам снизить сложность, повысить эффективность и создавать более масштабируемые и надежные системы компьютерного зрения.
Присоединяйся к нашему растущему сообществу и загляни в наш репозиторий GitHub, где найдешь материалы по ИИ. Чтобы уже сегодня создавать решения на основе компьютерного зрения с ИИ, ознакомься с нашими вариантами лицензирования. Узнай, как ИИ в сельском хозяйстве меняет фермерское дело и как компьютерное зрение на основе ИИ в здравоохранении формирует будущее, посетив страницы наших решений.








