Hướng dẫn về kiến trúc U-Net và các ứng dụng
Tìm hiểu về kiến trúc U-Net, cách kiến trúc này hỗ trợ phân đoạn ảnh, các ứng dụng và tầm quan trọng của nó đối với sự phát triển của thị giác máy tính.
Thị giác máy tính là một nhánh của trí tuệ nhân tạo (AI), tập trung vào phân tích dữ liệu hình ảnh. Lĩnh vực này đã mở đường cho nhiều hệ thống tiên tiến, chẳng hạn như tự động hóa quy trình kiểm tra sản phẩm tại nhà máy và hỗ trợ xe tự hành di chuyển trên đường.
Phát hiện đối tượng là một trong những tác vụ thị giác máy tính phổ biến nhất. Tác vụ này cho phép model định vị và nhận diện các đối tượng trong ảnh bằng bounding box. Dù bounding box hữu ích trong nhiều ứng dụng, chúng chỉ cung cấp ước lượng sơ bộ về vị trí của đối tượng.
Tuy nhiên, trong các lĩnh vực như y tế, nơi độ chính xác rất quan trọng, các trường hợp ứng dụng AI thị giác không chỉ phụ thuộc vào việc nhận diện đối tượng. Chúng thường còn đòi hỏi thông tin về hình dạng và vị trí chính xác của đối tượng.
Đó chính là mục tiêu của tác vụ thị giác máy tính mang tên segmentation. Thay vì dùng bounding box, các model segmentation phát hiện đối tượng ở cấp độ pixel. Qua nhiều năm, các nhà nghiên cứu đã phát triển những model thị giác máy tính chuyên biệt cho segmentation.
U-Net là một model như vậy. Dù các model mới hơn và tiên tiến hơn đã vượt qua hiệu năng của U-Net, model này vẫn có vị trí quan trọng trong lịch sử thị giác máy tính. Trong bài viết này, chúng ta sẽ tìm hiểu kỹ hơn về kiến trúc U-Net, cách hoạt động, các ứng dụng và cách model này so sánh với những model segmentation hiện đại hơn đang có.
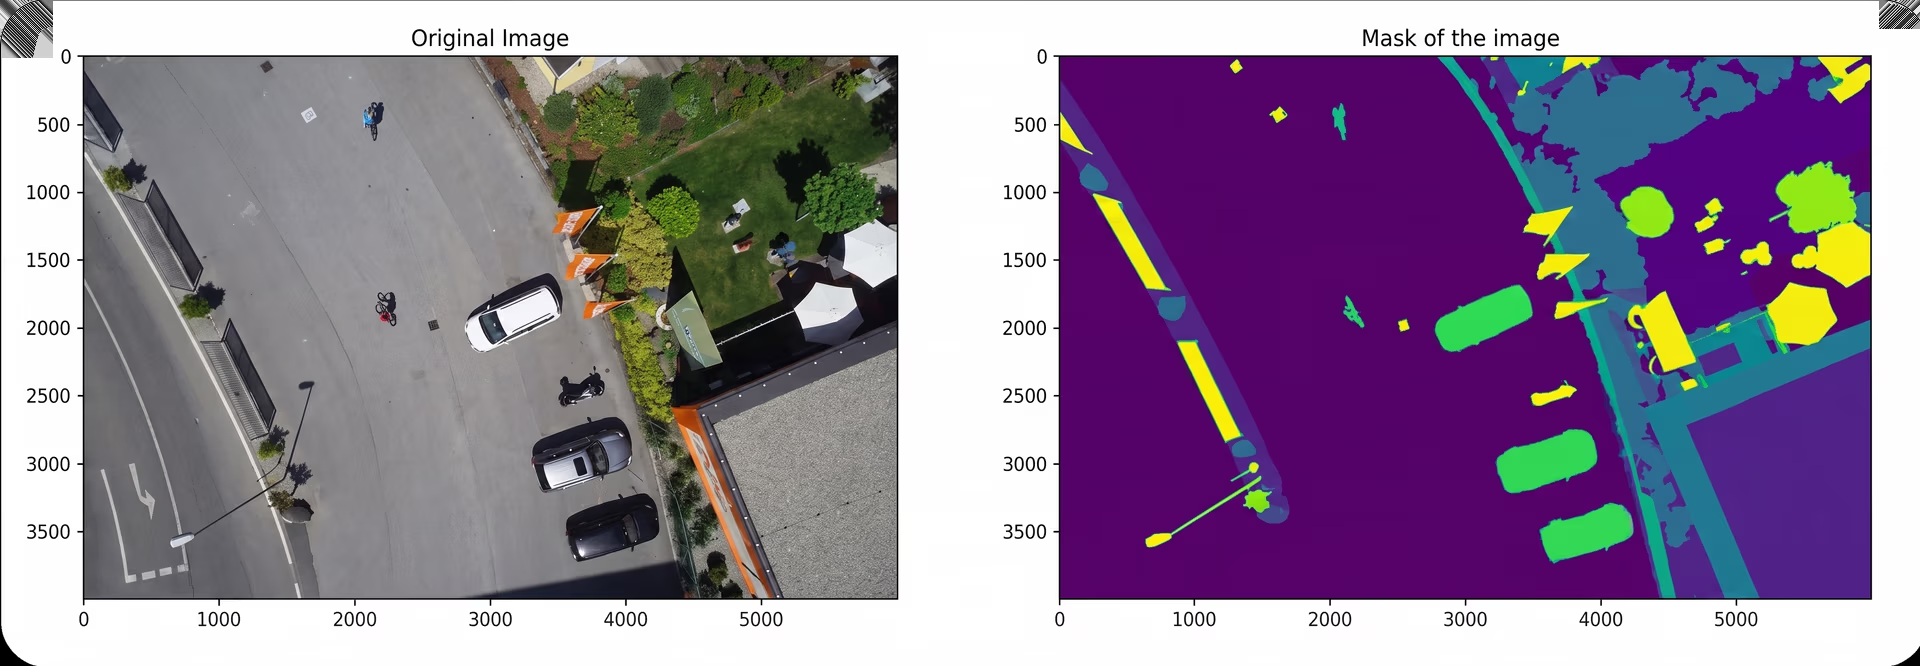
Hình 1. Ví dụ về segmentation bằng model deep learning U-Net. (Nguồn)
Lịch sử của image segmentation#
Trước khi tìm hiểu U-Net là gì, hãy cùng điểm qua quá trình phát triển của các model image segmentation.
Ban đầu, thị giác máy tính dựa vào các kỹ thuật truyền thống như phát hiện cạnh, phân ngưỡng hoặc tăng trưởng vùng để tách đối tượng trong ảnh. Những kỹ thuật này được dùng để phát hiện đường biên đối tượng dựa trên cạnh, tách vùng theo cường độ pixel và nhóm các pixel tương tự nhau. Chúng hoạt động tốt trong các trường hợp đơn giản nhưng thường thất bại khi ảnh có nhiễu, hình dạng chồng lấp hoặc đường biên không rõ ràng.
Sau sự phát triển của deep learning vào năm 2012, năm 2014, các nhà nghiên cứu giới thiệu khái niệm mạng tích chập hoàn toàn (FCNs) cho những tác vụ như semantic segmentation. Các model này thay thế một số thành phần của mạng tích chập, cho phép máy tính xử lý toàn bộ ảnh cùng lúc thay vì chia ảnh thành các phần nhỏ. Nhờ đó, model có thể tạo ra các bản đồ chi tiết, thể hiện rõ hơn nội dung trong ảnh.
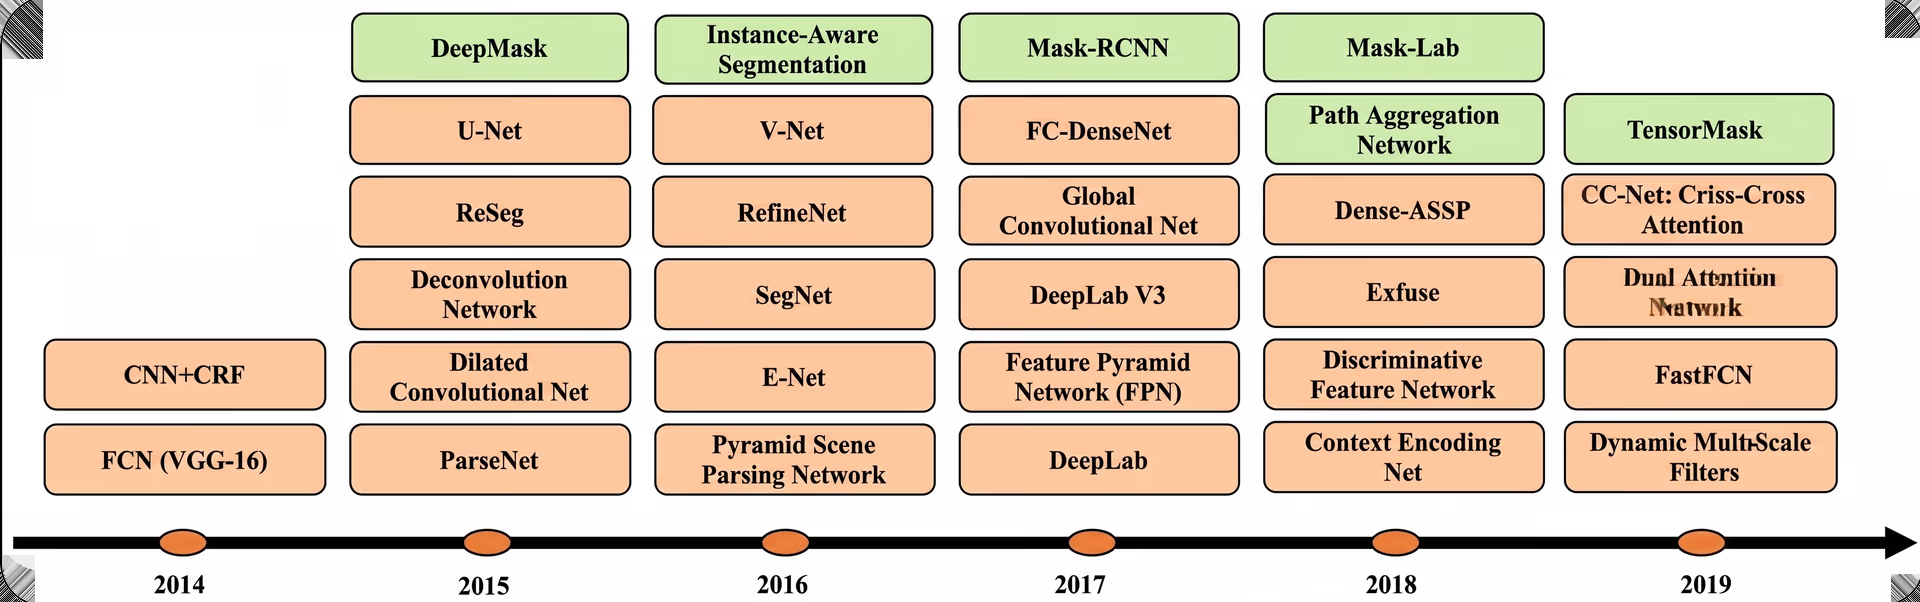
Hình 2. Quá trình phát triển của các thuật toán segmentation dựa trên deep learning. (Nguồn)
Dựa trên FCNs, U-Net được các nhà nghiên cứu tại Đại học Freiburg giới thiệu vào năm 2015. Model này ban đầu được thiết kế cho segmentation ảnh y sinh. Cụ thể, U-Net được thiết kế để hoạt động hiệu quả trong những tình huống có ít dữ liệu được gán nhãn.
Trong khi đó, các phiên bản ra đời sau như UNet++ và TransUNet bổ sung những cải tiến như các lớp attention và trích xuất đặc trưng tốt hơn. Các lớp attention giúp model tập trung vào những vùng quan trọng, còn khả năng trích xuất đặc trưng được nâng cao giúp nắm bắt thông tin chi tiết hơn.
U-Net là gì và các đặc trưng đi qua model như thế nào?#
U-Net là model deep learning được xây dựng chuyên biệt cho image segmentation. Model nhận ảnh đầu vào và tạo ra segmentation mask, phân loại từng pixel theo đối tượng hoặc vùng mà pixel đó thuộc về.
Tên của model bắt nguồn từ kiến trúc hình chữ U. Model gồm hai phần chính: encoder nén ảnh và học các đặc trưng, còn decoder khôi phục ảnh về kích thước ban đầu. Thiết kế này tạo thành hình chữ U đối xứng, giúp model hiểu cả cấu trúc tổng thể lẫn những chi tiết nhỏ của ảnh.
Một đặc điểm quan trọng của U-Net là sử dụng các skip connection, cho phép truyền trực tiếp thông tin từ encoder sang decoder. Nhờ vậy, model có thể giữ lại những chi tiết quan trọng vốn có thể bị mất khi ảnh được nén.
Tổng quan về kiến trúc U-Net#
Dưới đây là tổng quan về cách hoạt động của kiến trúc U-Net:
- Ảnh đầu vào: U-Net bắt đầu với một ảnh 2D, chẳng hạn như ảnh chụp y tế hoặc ảnh vệ tinh. Mục tiêu là gán nhãn lớp cho từng pixel trong ảnh.
- Downsampling: Ảnh đi qua các lớp tích chập để học những đặc trưng hình ảnh quan trọng. Khi ảnh đi qua các lớp khác nhau, độ phân giải giảm xuống và model nhận diện các mẫu hình tổng quát hơn.
- Lớp bottleneck: Ở trung tâm mạng, các feature map đạt độ phân giải không gian nhỏ nhất trong khi nắm bắt những đặc trưng ngữ nghĩa cấp cao. Nói đơn giản, biểu diễn nén của các feature map này thể hiện ngữ cảnh tổng thể của đầu vào.
- Upsampling: Sau đó, mạng tái tạo ảnh bằng cách tăng dần độ phân giải. Các phép tích chập chuyển vị giúp mở rộng feature map trở lại gần kích thước ban đầu.
- Skip connection: Các feature map từ nhánh downsampling được nối với feature map ở nhánh upsampling. Việc này giúp bảo toàn chi tiết không gian ở mức độ cao, đồng thời tích hợp thông tin ngữ cảnh cấp cao.
- Đầu ra là segmentation map: Đầu ra cuối cùng là segmentation mask theo từng pixel, có kích thước khớp với ảnh đầu vào. Mỗi pixel được phân loại vào một nhóm như đối tượng, nền hoặc vùng quan tâm.
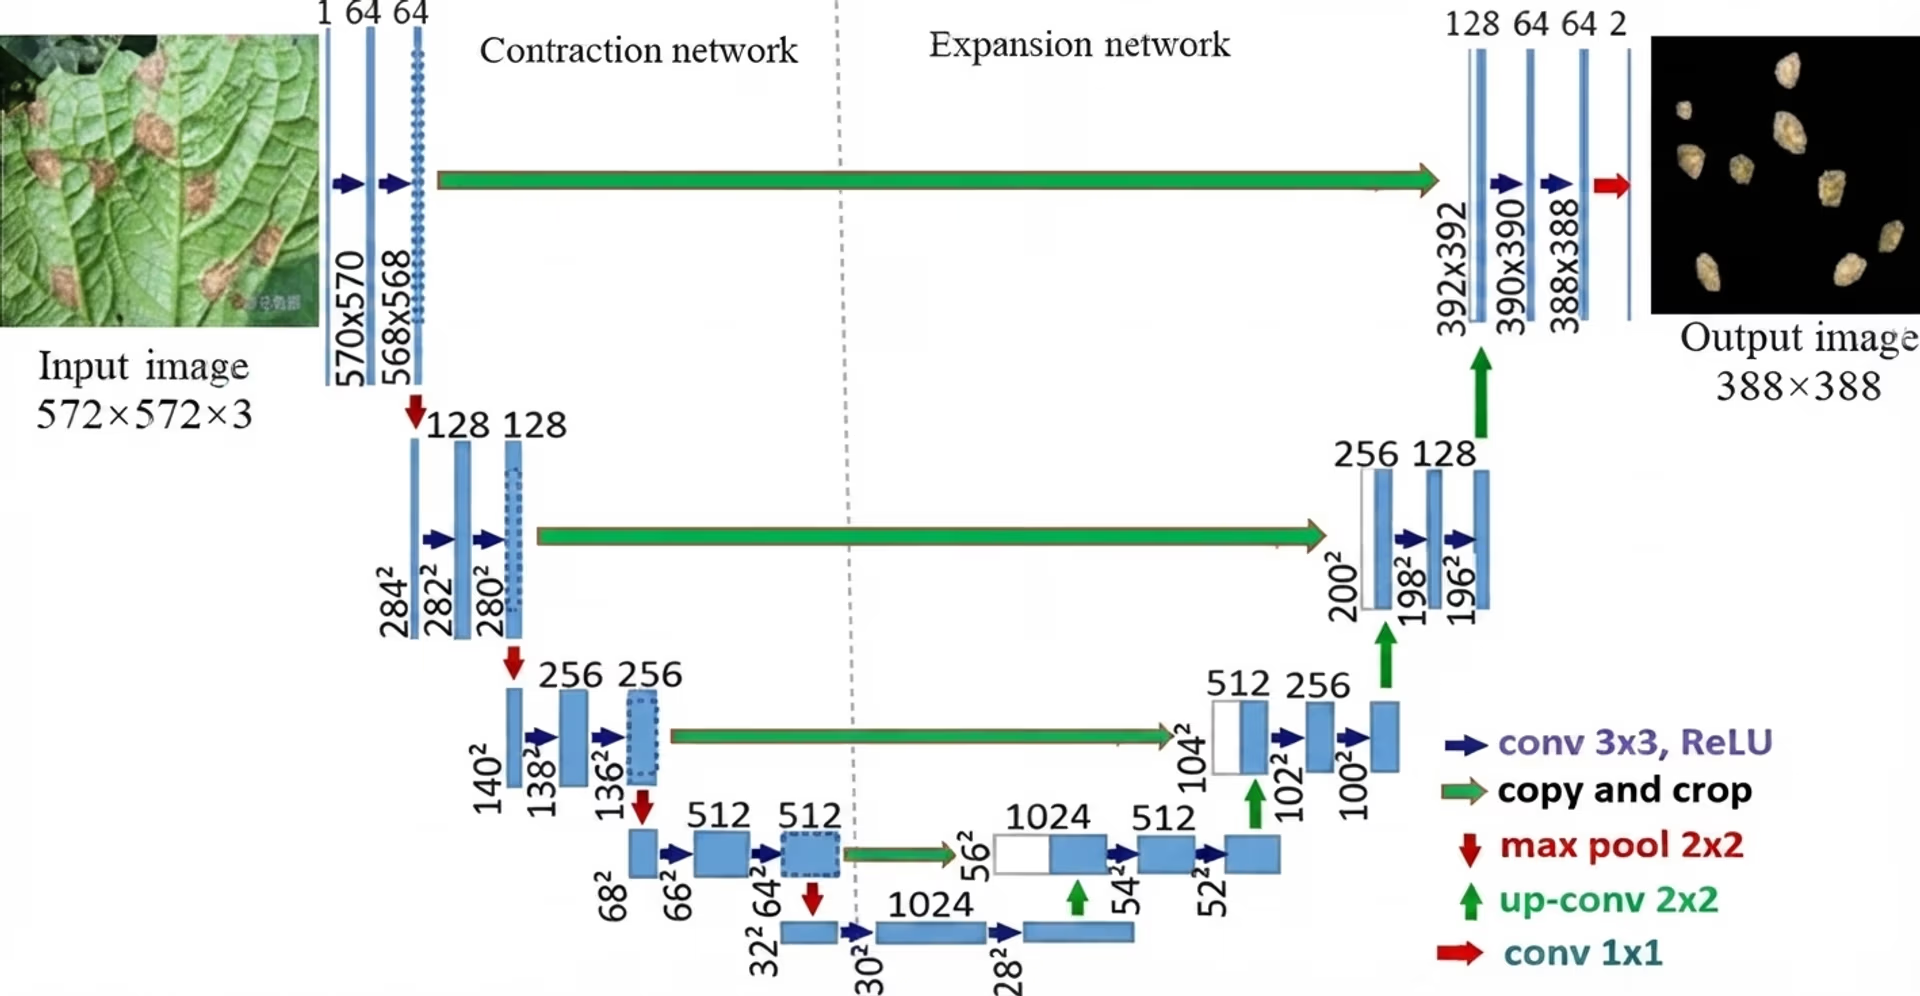
Hình 3. Sơ đồ kiến trúc U-Net. (Nguồn)
Tìm hiểu sự khác nhau giữa ViT và U-Net#
Khi tìm hiểu U-Net, có thể bạn sẽ thắc mắc model này khác gì so với các model deep learning khác, chẳng hạn như Vision Transformer (ViT), vốn cũng có thể thực hiện các tác vụ segmentation. Dù cả hai model có thể thực hiện những tác vụ tương tự, chúng khác nhau về cấu trúc và cách xử lý segmentation.
U-Net xử lý ảnh ở cấp độ pixel thông qua các lớp tích chập trong cấu trúc encoder-decoder. Model thường được dùng cho các tác vụ đòi hỏi segmentation chính xác, như ảnh chụp y tế hoặc cảnh đường phố dành cho xe tự hành.
Ngược lại, Vision Transformer (ViT) chia ảnh thành các patch và xử lý chúng đồng thời bằng cơ chế attention. ViT sử dụng self-attention (cơ chế cho phép model cân nhắc tầm quan trọng của các phần khác nhau trong ảnh so với nhau) để nắm bắt mối liên hệ giữa các phần của ảnh, khác với phương pháp tích chập của U-Net.
Một khác biệt quan trọng khác là ViT thường cần nhiều dữ liệu hơn để hoạt động tốt, nhưng lại rất hiệu quả trong việc nhận diện các mẫu phức tạp. Ngược lại, U-Net hoạt động tốt với tập dữ liệu nhỏ hơn, huấn luyện nhanh hơn và thường cần ít thời gian huấn luyện hơn.
Các ứng dụng của model U-Net#
Giờ đây, khi đã hiểu rõ hơn U-Net là gì và hoạt động ra sao, hãy cùng khám phá cách U-Net được ứng dụng trong nhiều lĩnh vực khác nhau.
Phân đoạn xuất huyết não trong ảnh y tế#
U-Net trở thành một phương pháp đáng tin cậy để segmentation phức tạp ở cấp độ pixel trong ảnh y tế, đặc biệt là vào giai đoạn nghiên cứu phát triển mạnh. Các nhà nghiên cứu sử dụng U-Net để đánh dấu những vùng quan trọng trên ảnh chụp y tế, chẳng hạn như khối u và dấu hiệu chảy máu trong trên ảnh CT và MRI. Phương pháp này cải thiện đáng kể độ chính xác của chẩn đoán và đơn giản hóa việc phân tích dữ liệu y tế phức tạp trong môi trường nghiên cứu.
Một ví dụ về tác động của U-Net trong nghiên cứu y tế là ứng dụng nhận diện đột quỵ và xuất huyết não trên ảnh chụp y tế. Các nhà nghiên cứu có thể dùng U-Net để phân tích ảnh chụp đầu và đánh dấu những vùng đáng lo ngại, qua đó nhanh chóng xác định các trường hợp cần được xử lý ngay.
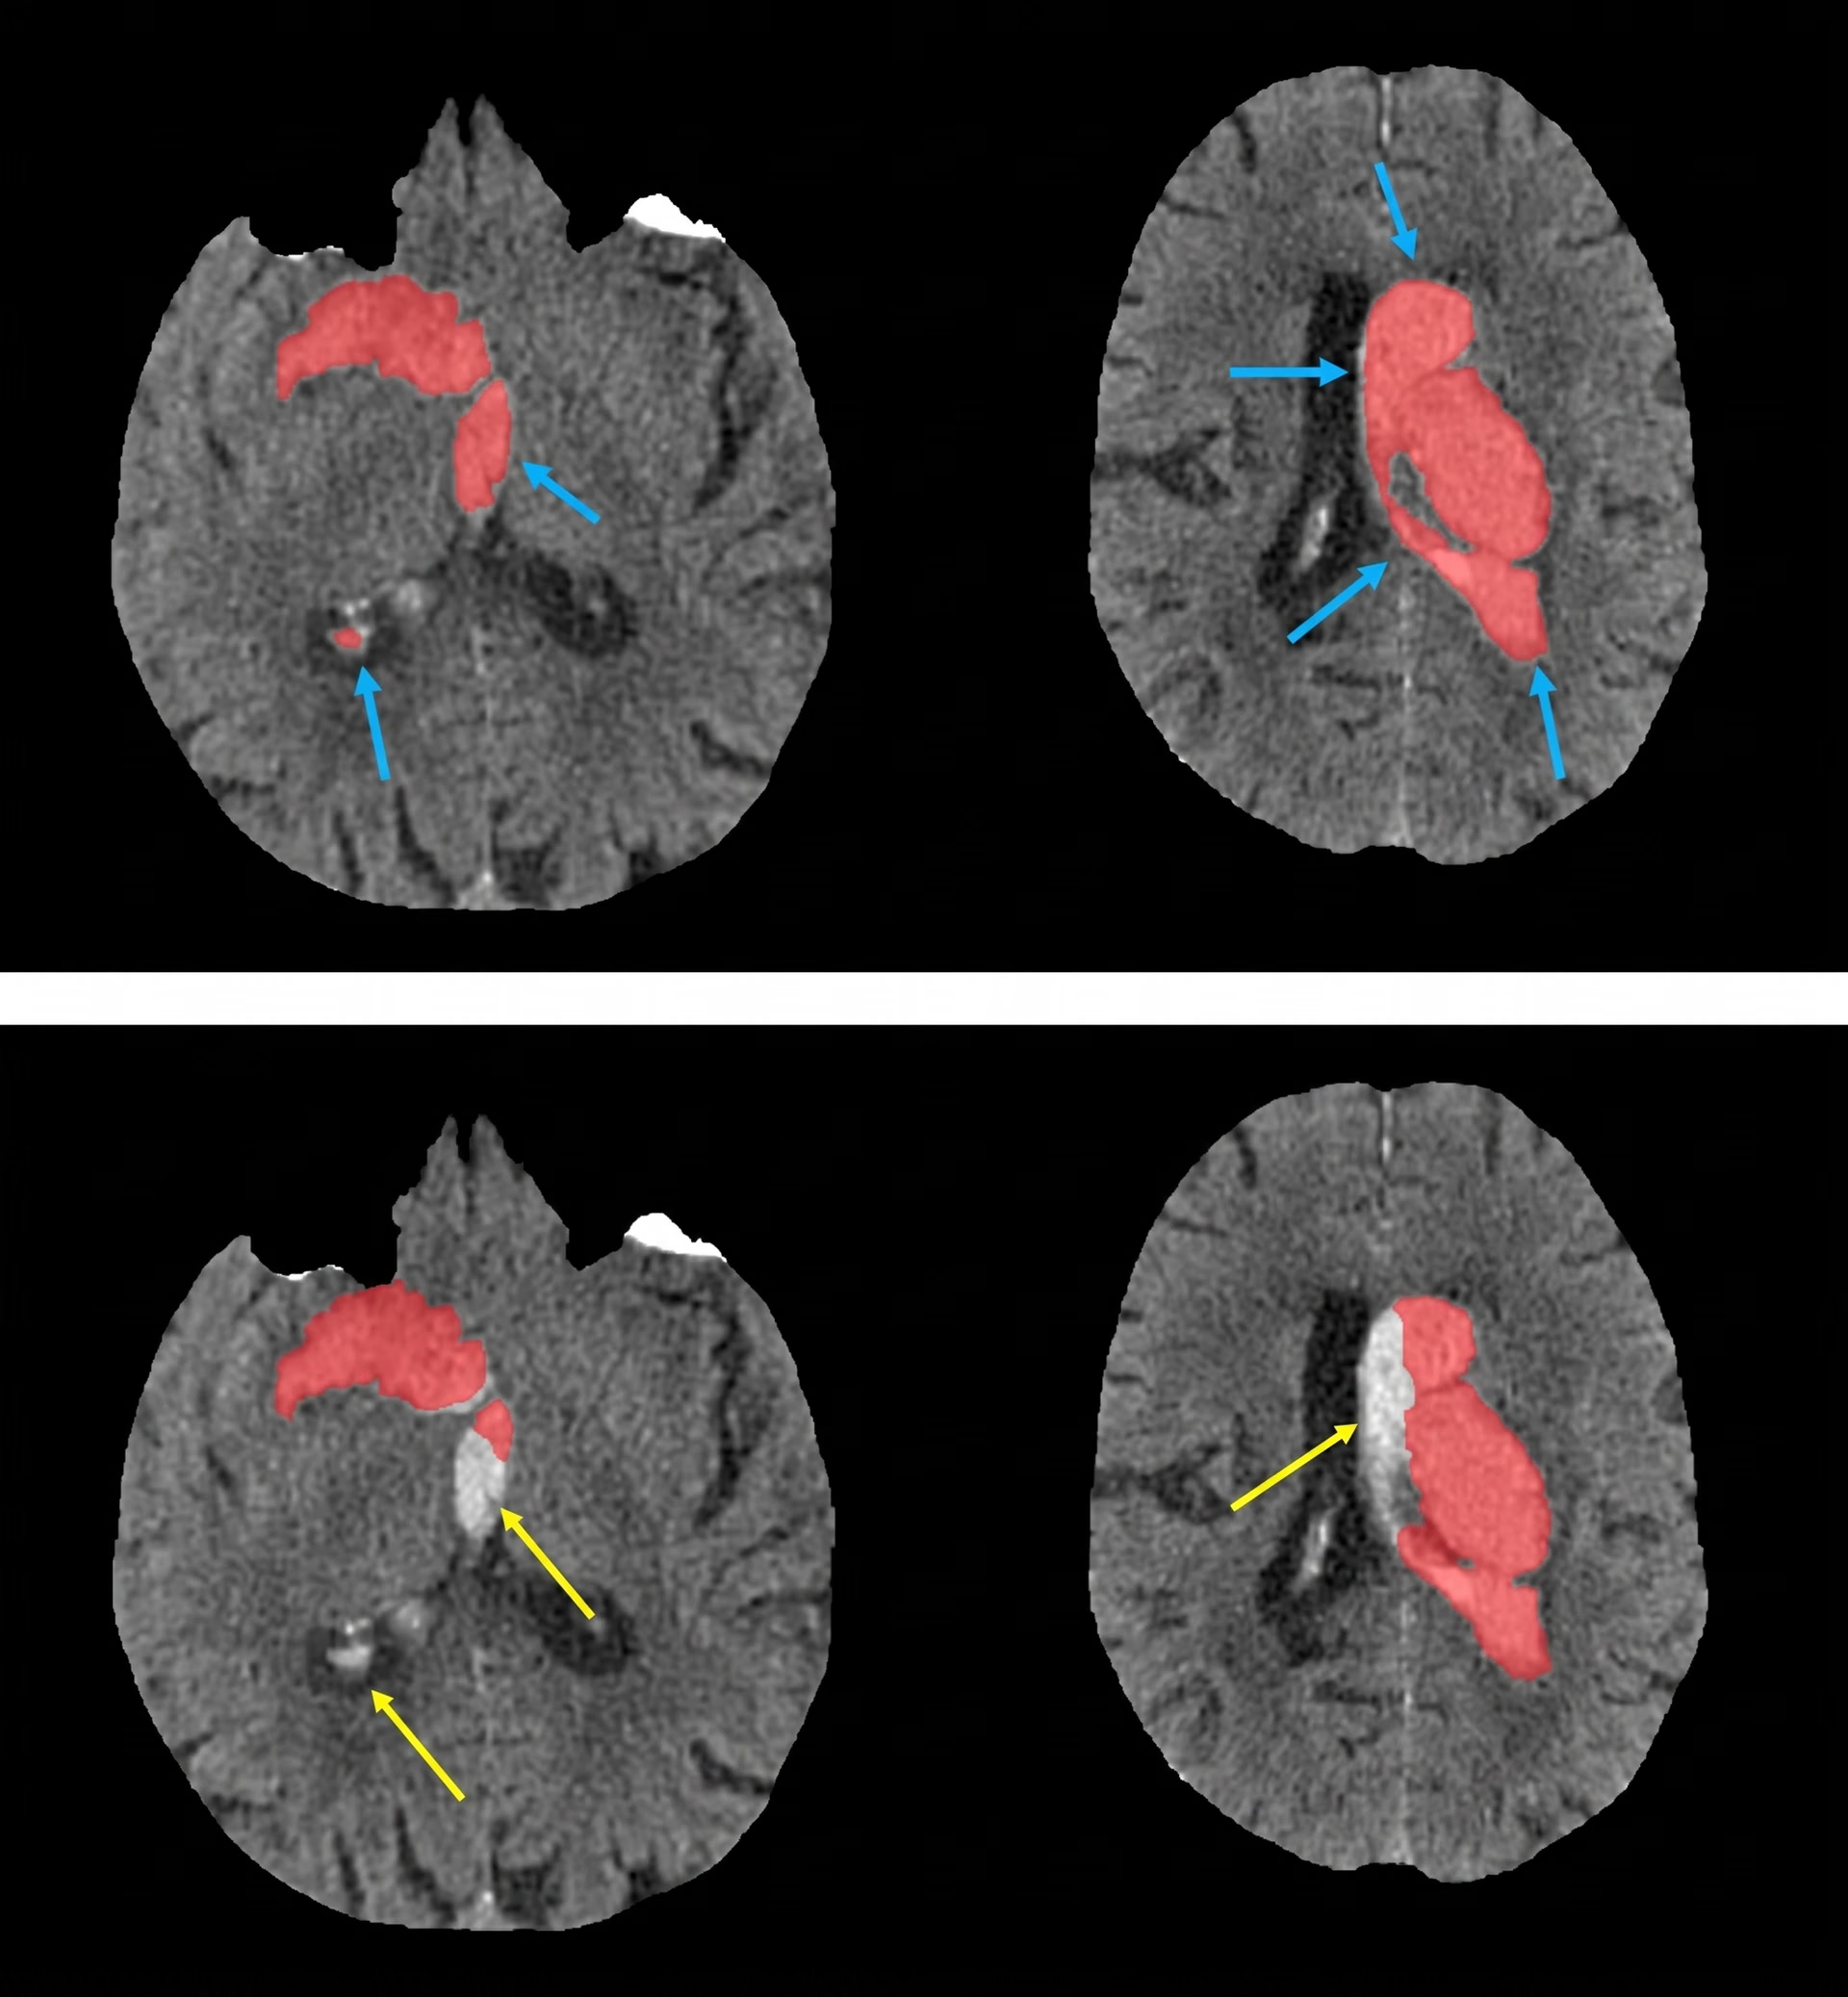
Hình 4. Phân đoạn tổn thương do đột quỵ xuất huyết bằng 3D U-Net. (Nguồn)
Phân đoạn cây trồng trong nông nghiệp#
Nông nghiệp là một lĩnh vực khác mà các nhà nghiên cứu đã ứng dụng U-Net, đặc biệt là để phân đoạn cây trồng, cỏ dại và đất. Model giúp nông dân theo dõi sức khỏe cây trồng, ước tính sản lượng và đưa ra quyết định tốt hơn trên những trang trại rộng lớn. Ví dụ, U-Net có thể tách cây trồng khỏi cỏ dại, giúp sử dụng thuốc diệt cỏ hiệu quả hơn và giảm lãng phí.
Để giải quyết các thách thức như nhòe chuyển động trong ảnh chụp bằng drone, các nhà nghiên cứu đã cải tiến U-Net bằng những kỹ thuật khử nhòe ảnh. Nhờ vậy, segmentation rõ nét hơn ngay cả khi dữ liệu được thu thập trong lúc di chuyển, chẳng hạn như khi khảo sát trên không.
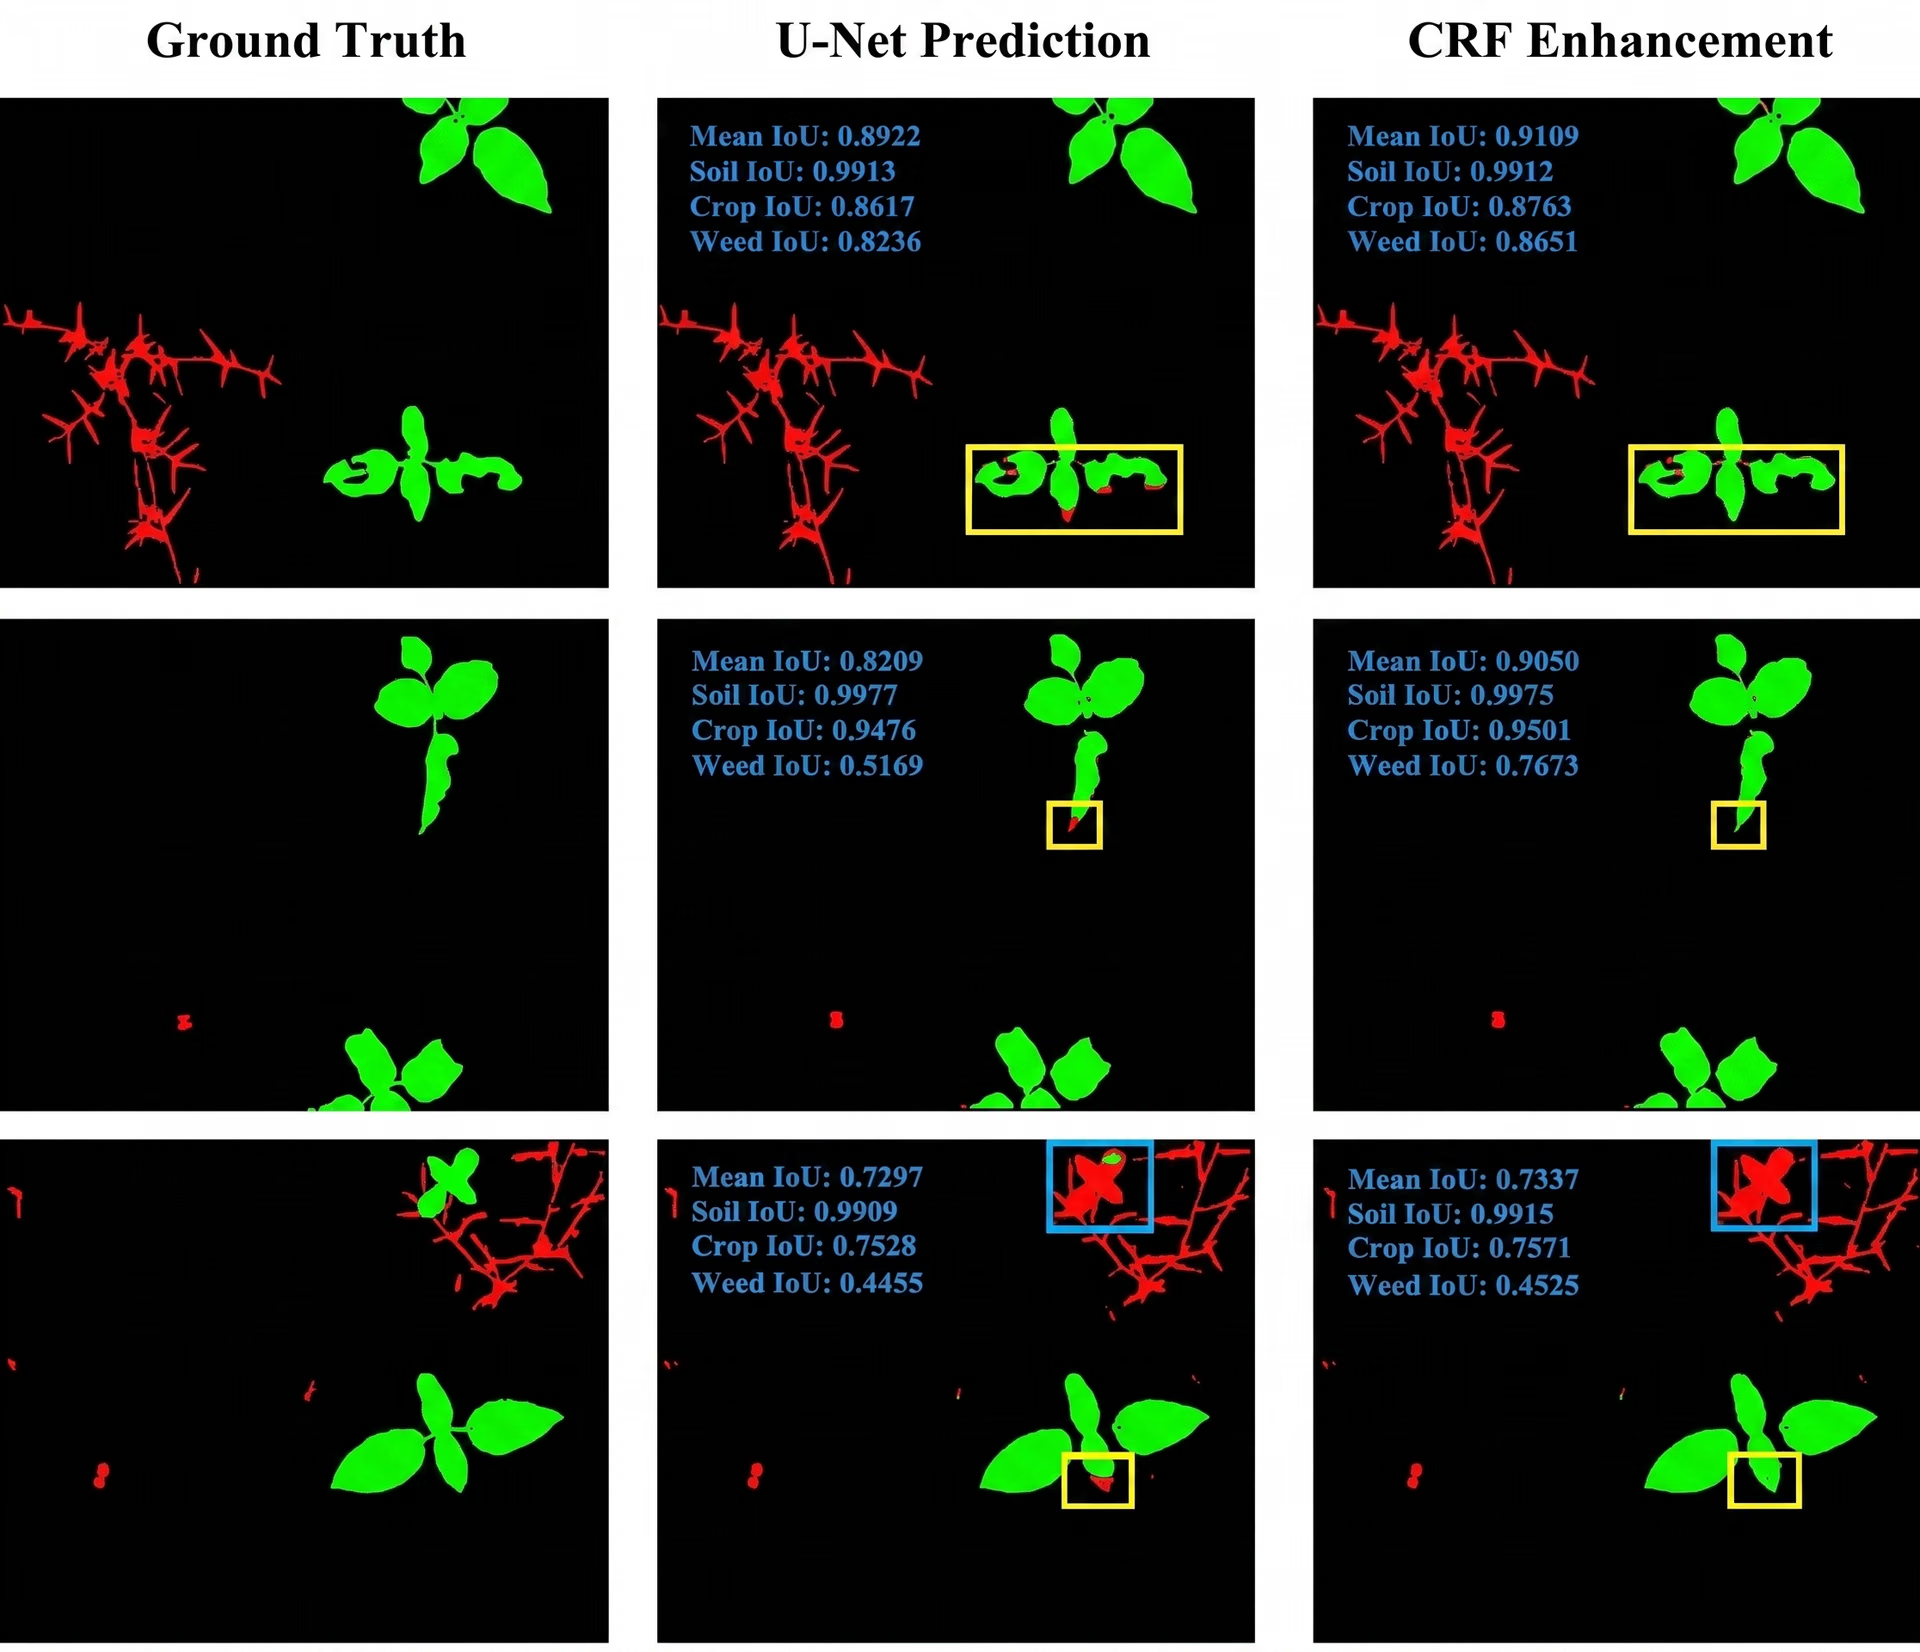
Hình 5. Tách cây trồng khỏi cỏ dại trên đồng ruộng bằng U-Net. (Nguồn)
Xe tự hành#
Trước khi các model AI tiên tiến hơn ra đời, U-Net đóng vai trò thiết yếu trong việc nghiên cứu cách segmentation có thể cải thiện khả năng lái xe tự hành. Trong xe tự hành, semantic segmentation của U-Net có thể phân loại từng pixel trong ảnh thành các nhóm như đường, phương tiện, người đi bộ và vạch kẻ làn đường. Nhờ đó, xe có thể nhận biết rõ môi trường xung quanh, hỗ trợ điều hướng an toàn và đưa ra quyết định hiệu quả.
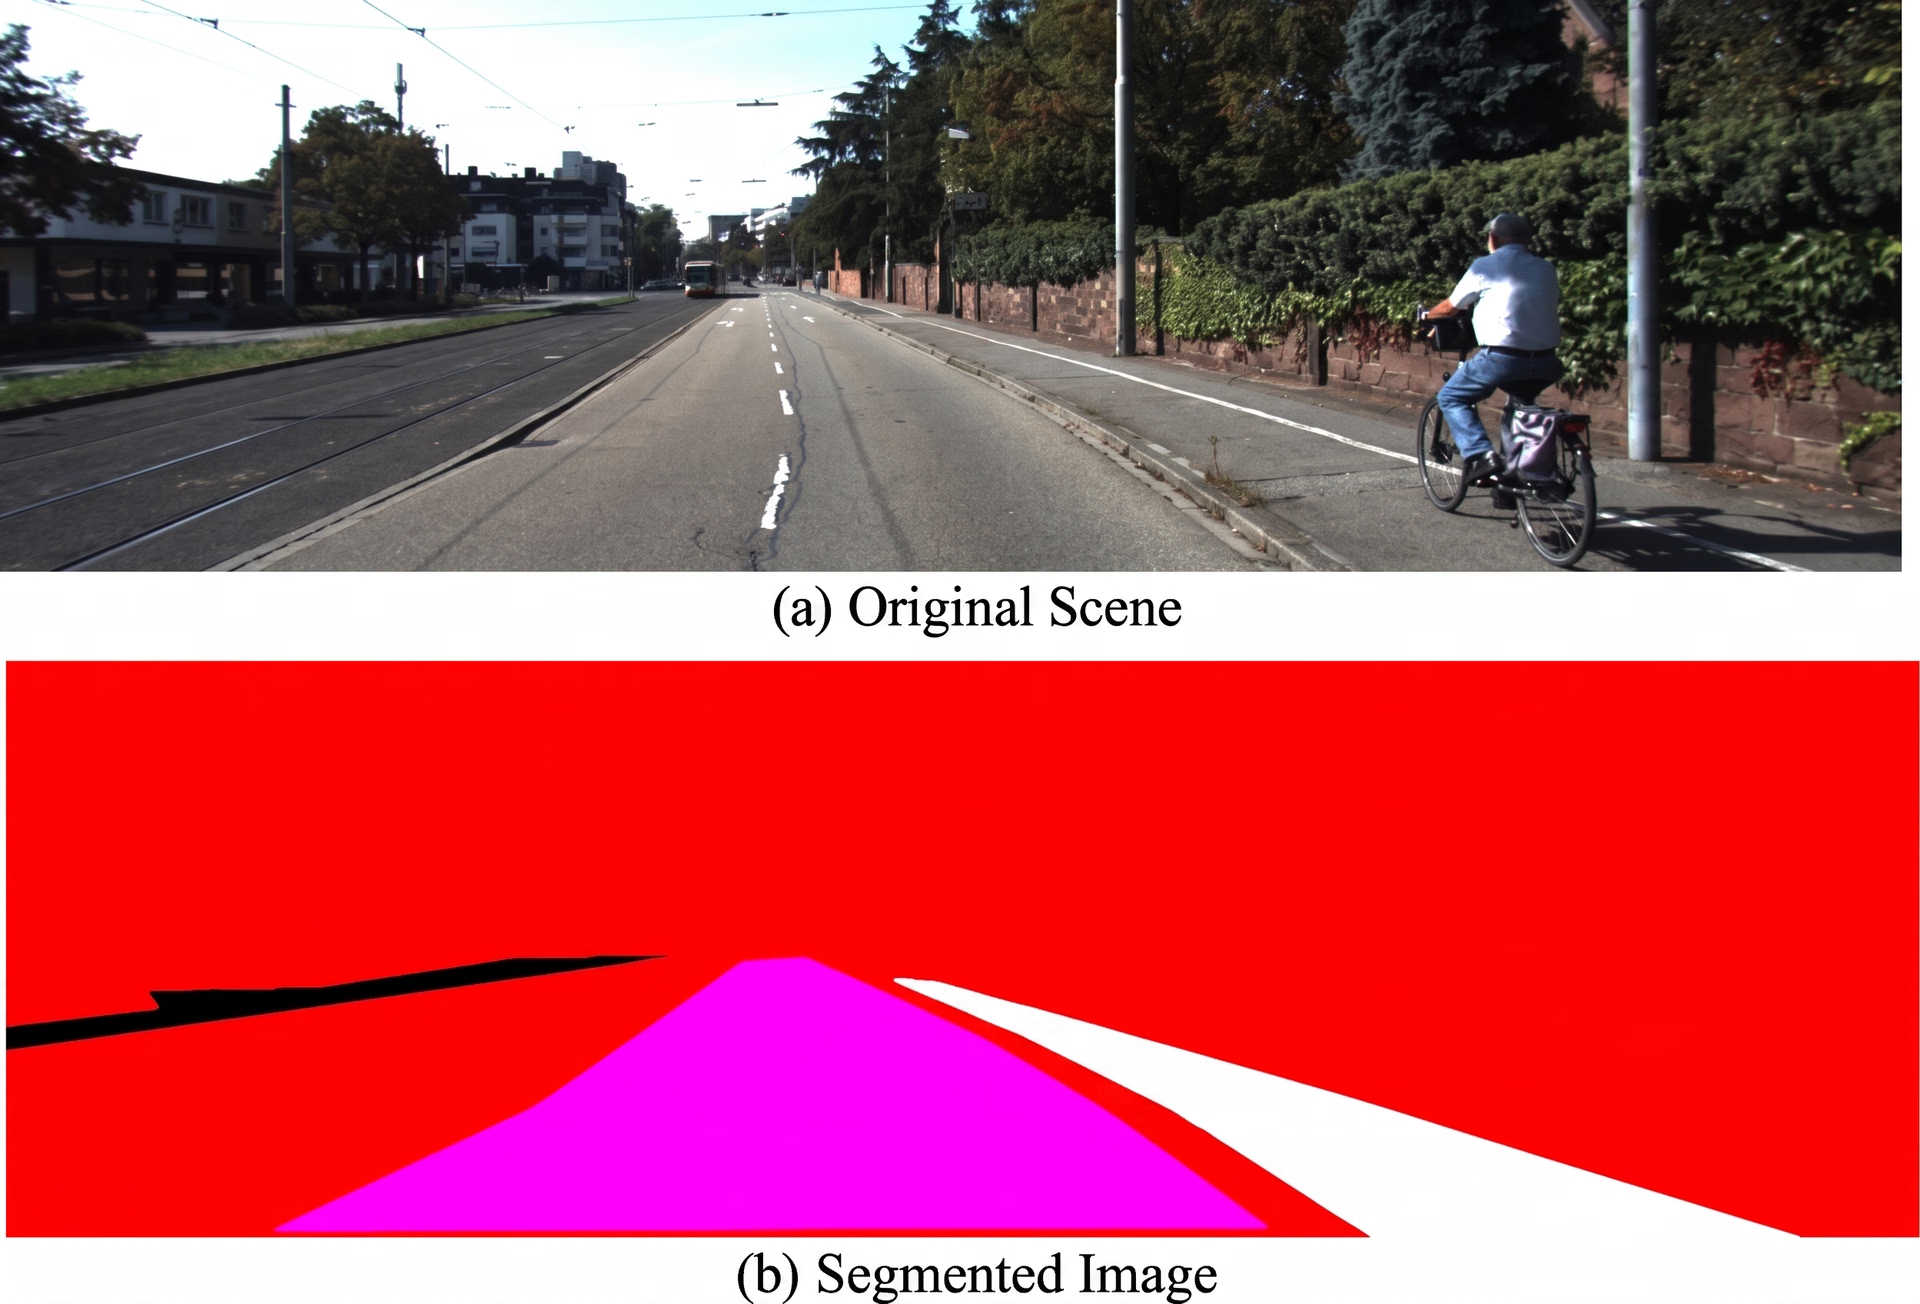
Hình 6. Cảnh đường phố có vùng có thể lái xe được phân đoạn bằng U-Net. (Nguồn)
Ưu và nhược điểm của U-Net#
Ngay cả hiện nay, U-Net vẫn là lựa chọn phù hợp cho image segmentation trong giới nghiên cứu nhờ cân bằng giữa tính đơn giản, độ chính xác và khả năng thích ứng. Dưới đây là một số ưu điểm chính giúp U-Net nổi bật:
- Thích ứng với nhiều loại dữ liệu: U-Net đã được điều chỉnh cho nhiều loại dữ liệu khác nhau, bao gồm ảnh chụp y tế 3D, ảnh vệ tinh và cả khung hình video.
- Inference nhanh khi được tối ưu: Khi được tinh chỉnh phù hợp, U-Net có thể chạy hiệu quả, phù hợp với các ứng dụng thời gian thực hoặc gần thời gian thực.
- Mã nguồn mở và cộng đồng: U-Net có mặt trong các thư viện deep learning lớn và được hỗ trợ bởi cộng đồng đông đảo gồm các nhà phát triển và nhà nghiên cứu.
U-Net có nhiều ưu điểm, nhưng cũng có một số hạn chế cần lưu ý. Dưới đây là những yếu tố cần cân nhắc:
- Nhạy cảm với chất lượng dữ liệu: Hiệu suất của U-Net có thể bị ảnh hưởng tiêu cực bởi dữ liệu kém chất lượng, chẳng hạn như ảnh nhiễu hoặc độ phân giải thấp.
- Dễ overfit với tập dữ liệu nhỏ: Dù U-Net hoạt động tốt với lượng dữ liệu hạn chế, model vẫn có nguy cơ overfit nếu không được regularization phù hợp, đặc biệt khi tập dữ liệu quá nhỏ hoặc thiếu đa dạng.
- Tài nguyên tính toán: U-Net có thể tiêu tốn nhiều tài nguyên tính toán, đặc biệt khi làm việc với tập dữ liệu lớn, và cần phần cứng đáng kể để huấn luyện.
Điểm chính cần ghi nhớ#
U-Net là một cột mốc quan trọng trong quá trình phát triển của image segmentation. Model chứng minh rằng các model deep learning có thể cho kết quả chính xác với tập dữ liệu nhỏ hơn, đặc biệt trong những lĩnh vực như chẩn đoán hình ảnh y tế.
Bước đột phá này mở đường cho các ứng dụng tiên tiến hơn trong nhiều lĩnh vực. Khi thị giác máy tính tiếp tục phát triển, các model segmentation như U-Net vẫn giữ vai trò nền tảng, giúp máy móc hiểu và diễn giải dữ liệu hình ảnh với độ chính xác cao.
Bạn muốn xây dựng các dự án thị giác máy tính của riêng mình? Khám phá kho GitHub của chúng tôi để tìm hiểu sâu hơn về AI và xem các tùy chọn cấp phép. Tìm hiểu cách thị giác máy tính trong y tế cải thiện hiệu quả và khám phá tác động của AI trong bán lẻ trên các trang giải pháp của chúng tôi! Hãy tham gia cộng đồng đang ngày càng phát triển ngay hôm nay!









