Constitutional AI hướng đến việc điều chỉnh các model AI theo giá trị con người
Tìm hiểu cách constitutional AI giúp các model tuân thủ những quy tắc đạo đức, đưa ra quyết định an toàn hơn và hỗ trợ tính công bằng trong các hệ thống ngôn ngữ và computer vision.
Trí tuệ nhân tạo (AI) đang nhanh chóng trở thành một phần quan trọng trong cuộc sống hằng ngày. AI đang được tích hợp vào các công cụ được sử dụng trong những lĩnh vực như chăm sóc sức khỏe, tuyển dụng, tài chính và an toàn công cộng. Khi các hệ thống này mở rộng, những lo ngại về tính đạo đức và độ tin cậy của chúng cũng ngày càng được nêu lên.
Ví dụ, đôi khi các hệ thống AI được xây dựng mà không cân nhắc đến tính công bằng hoặc an toàn có thể tạo ra kết quả thiên lệch hoặc không đáng tin cậy. Điều này là do nhiều model vẫn chưa có cách rõ ràng để phản ánh và điều chỉnh theo các giá trị của con người.
Để giải quyết những thách thức này, các nhà nghiên cứu đang tìm hiểu một phương pháp được gọi là AI hiến định. Nói đơn giản, phương pháp này đưa một tập hợp nguyên tắc bằng văn bản vào quy trình training của model. Các nguyên tắc này giúp model tự đánh giá hành vi của mình, giảm phụ thuộc vào phản hồi của con người và tạo ra các phản hồi an toàn, dễ hiểu hơn.
Cho đến nay, phương pháp này chủ yếu được sử dụng cho các mô hình ngôn ngữ lớn (LLMs). Tuy nhiên, cùng một cấu trúc có thể giúp định hướng các hệ thống thị giác máy tính đưa ra quyết định có tính đạo đức khi phân tích dữ liệu hình ảnh.
Trong bài viết này, chúng ta sẽ tìm hiểu cách AI hiến định hoạt động, xem xét các ví dụ thực tế và thảo luận về những ứng dụng tiềm năng của nó trong các hệ thống thị giác máy tính.
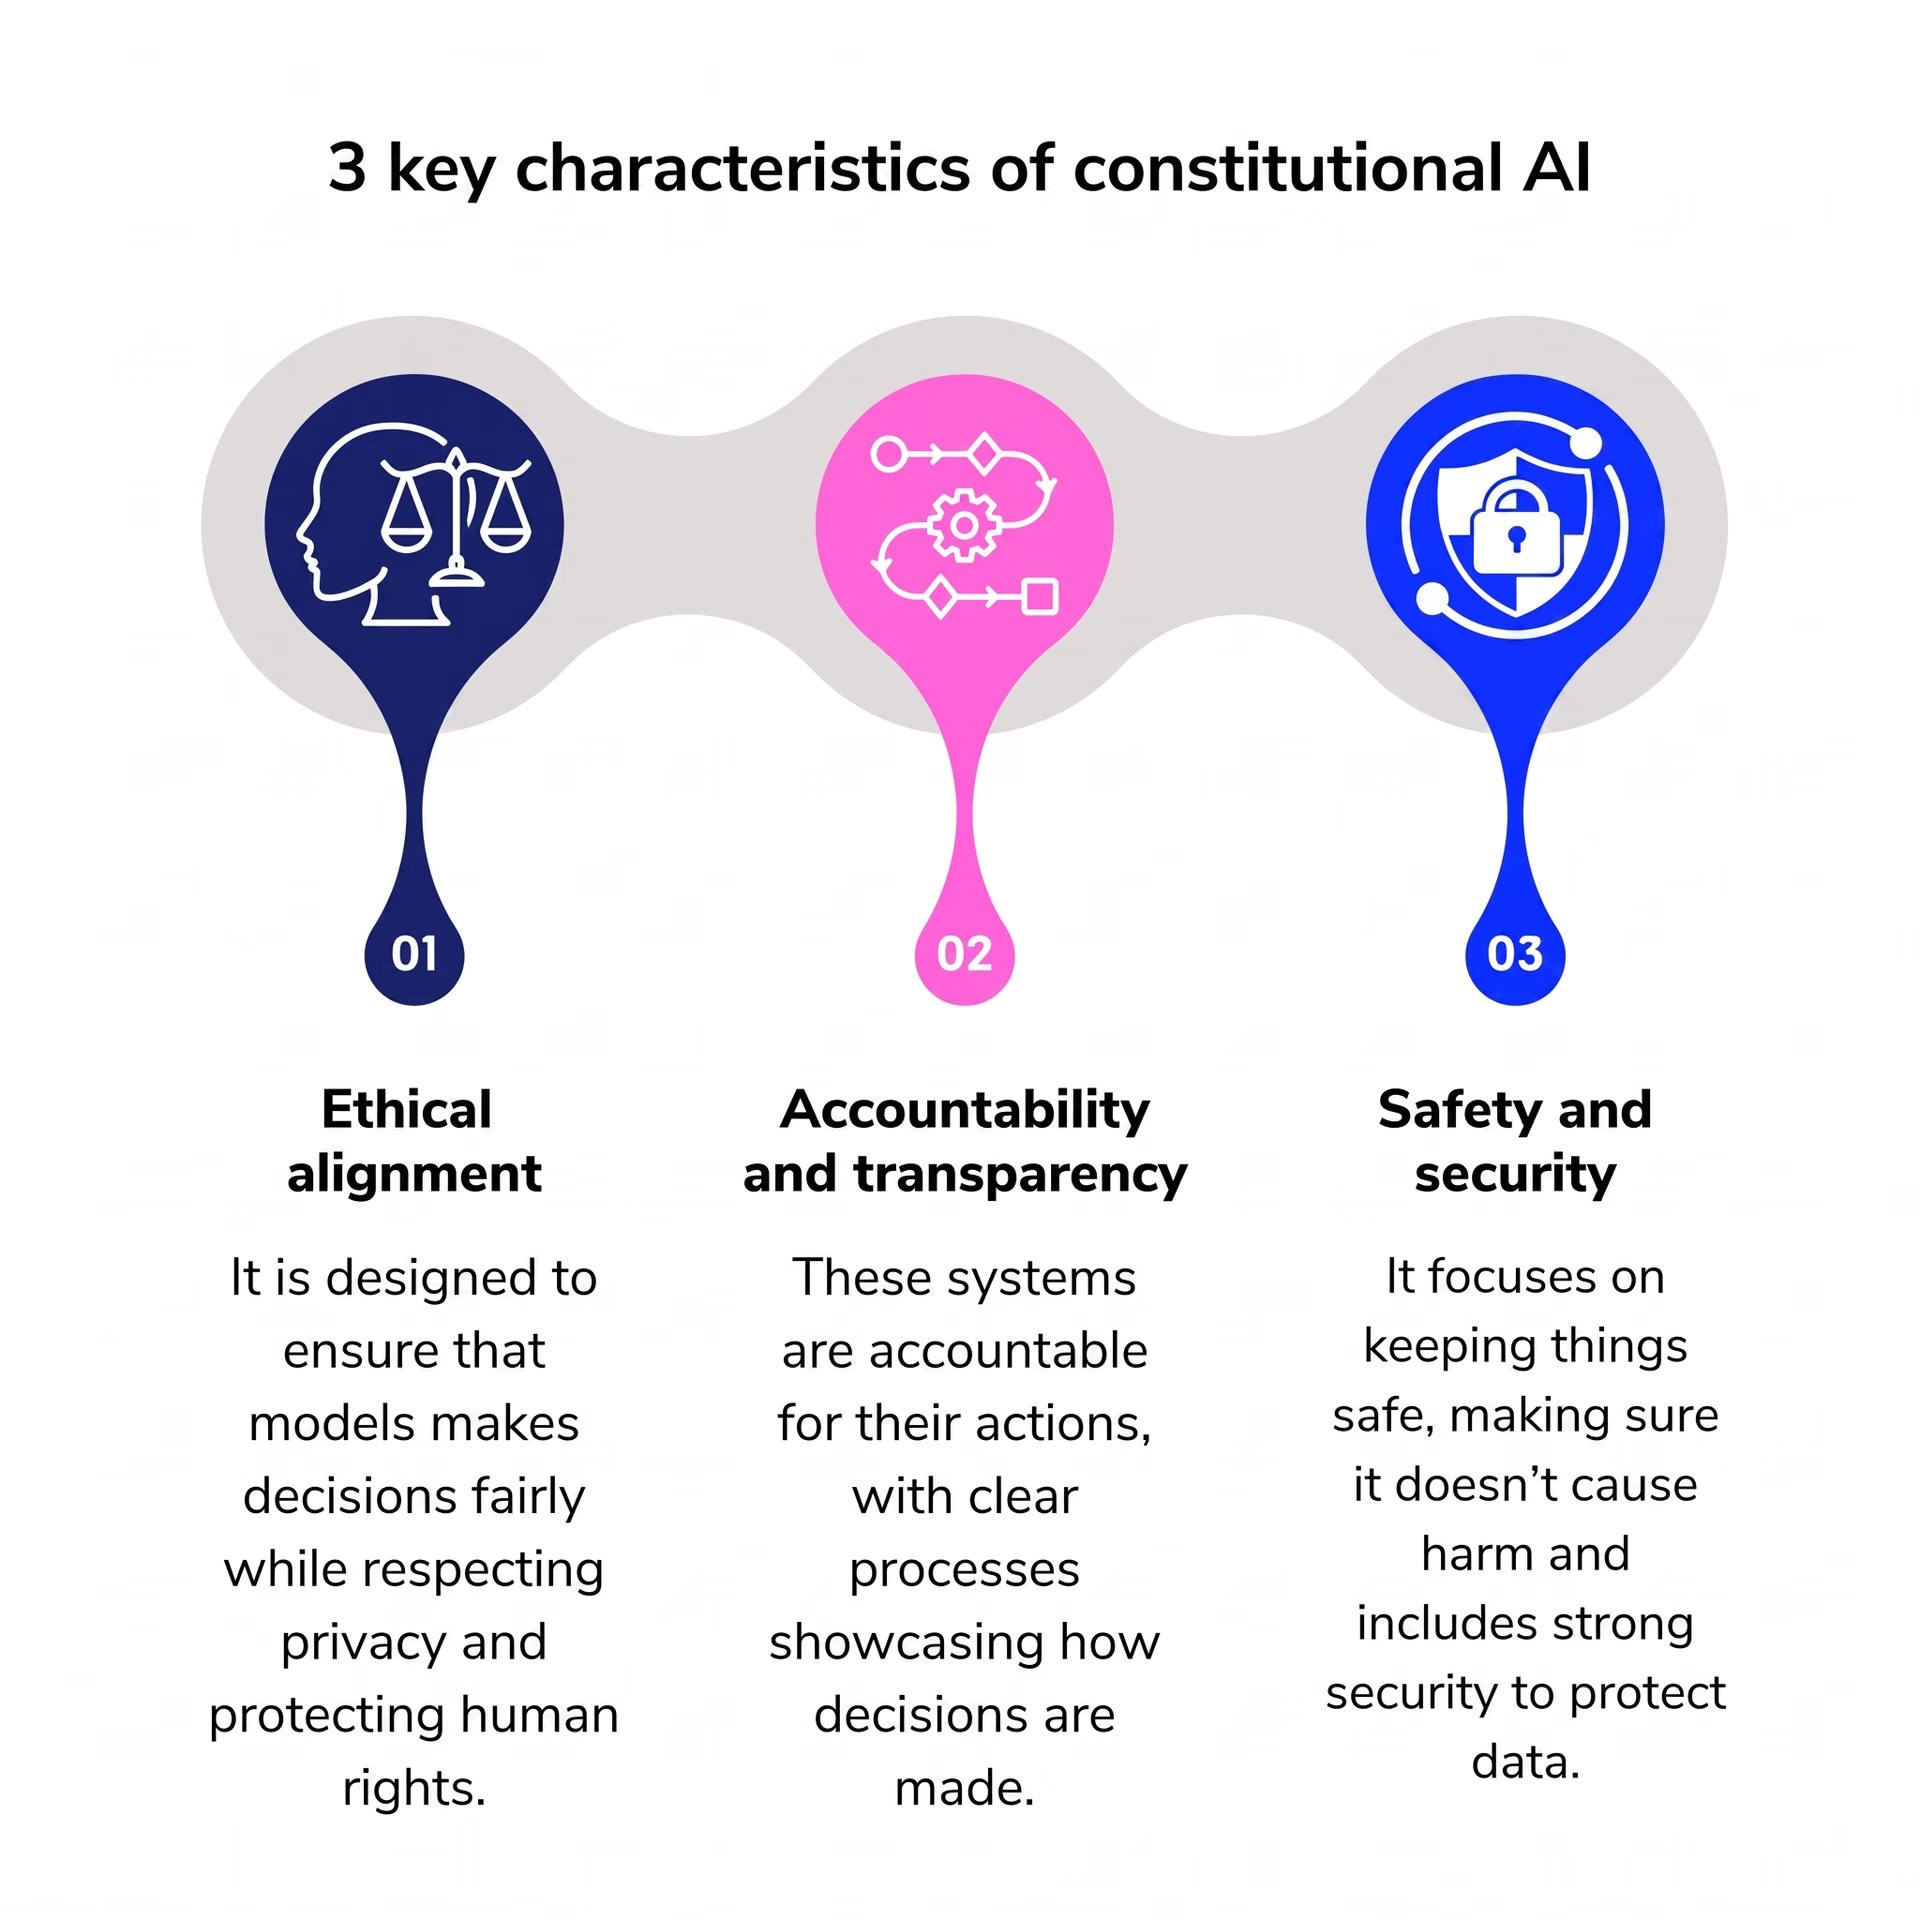
Hình 1. Đặc điểm của AI hiến định. Hình ảnh do tác giả thực hiện.
AI hiến định là gì?#
AI hiến định là một phương pháp training model, định hướng cách các model AI hoạt động bằng cách cung cấp một tập hợp quy tắc đạo đức rõ ràng. Các quy tắc này đóng vai trò như một bộ quy tắc ứng xử. Thay vì để model tự suy luận điều gì có thể chấp nhận được, model tuân theo một tập hợp nguyên tắc bằng văn bản nhằm định hình các phản hồi trong quá trình training.
Khái niệm này được giới thiệu bởi Anthropic, một công ty nghiên cứu tập trung vào an toàn AI đã phát triển dòng LLM Claude, với mục tiêu giúp các hệ thống AI tự giám sát nhiều hơn trong quá trình ra quyết định.
Thay vì chỉ dựa vào phản hồi của con người, model học cách tự phê bình và tinh chỉnh các phản hồi của mình dựa trên một tập hợp nguyên tắc được xác định trước. Phương pháp này tương tự một hệ thống pháp lý, trong đó thẩm phán tham chiếu hiến pháp trước khi đưa ra phán quyết.
Trong trường hợp này, model vừa là thẩm phán vừa là học viên, sử dụng cùng một tập hợp quy tắc để xem xét và tinh chỉnh hành vi của chính mình. Quy trình này củng cố khả năng alignment của model AI và hỗ trợ phát triển các hệ thống AI an toàn, có trách nhiệm.
AI hiến định hoạt động như thế nào?#
Mục tiêu của AI hiến định là dạy một model AI cách đưa ra các quyết định an toàn và công bằng bằng cách tuân theo một tập hợp quy tắc bằng văn bản rõ ràng. Dưới đây là phần tóm tắt đơn giản về cách quy trình này hoạt động:
- Xác định hiến pháp: Tạo một danh sách bằng văn bản gồm các nguyên tắc đạo đức mà model cần tuân theo. Hiến pháp nêu rõ những điều AI nên tránh và các giá trị mà AI nên phản ánh.
- Training với các ví dụ có giám sát: Model được cung cấp các phản hồi mẫu tuân theo hiến pháp. Những ví dụ này giúp AI hiểu hành vi có thể chấp nhận được là như thế nào.
- Nhận diện và áp dụng các pattern: Theo thời gian, model bắt đầu nhận ra các pattern này. Model học cách áp dụng cùng những giá trị đó khi trả lời các câu hỏi mới hoặc xử lý các tình huống mới.
- Phê bình và tinh chỉnh output: Model xem xét các phản hồi của chính mình và điều chỉnh chúng dựa trên hiến pháp. Giai đoạn tự đánh giá này giúp model cải thiện mà không chỉ dựa vào phản hồi của con người.
- Tạo ra các phản hồi được alignment và an toàn hơn: Model học từ các quy tắc nhất quán, qua đó giúp giảm thiên lệch và cải thiện độ tin cậy trong sử dụng thực tế. Phương pháp này giúp model alignment tốt hơn với các giá trị của con người và dễ quản trị hơn.
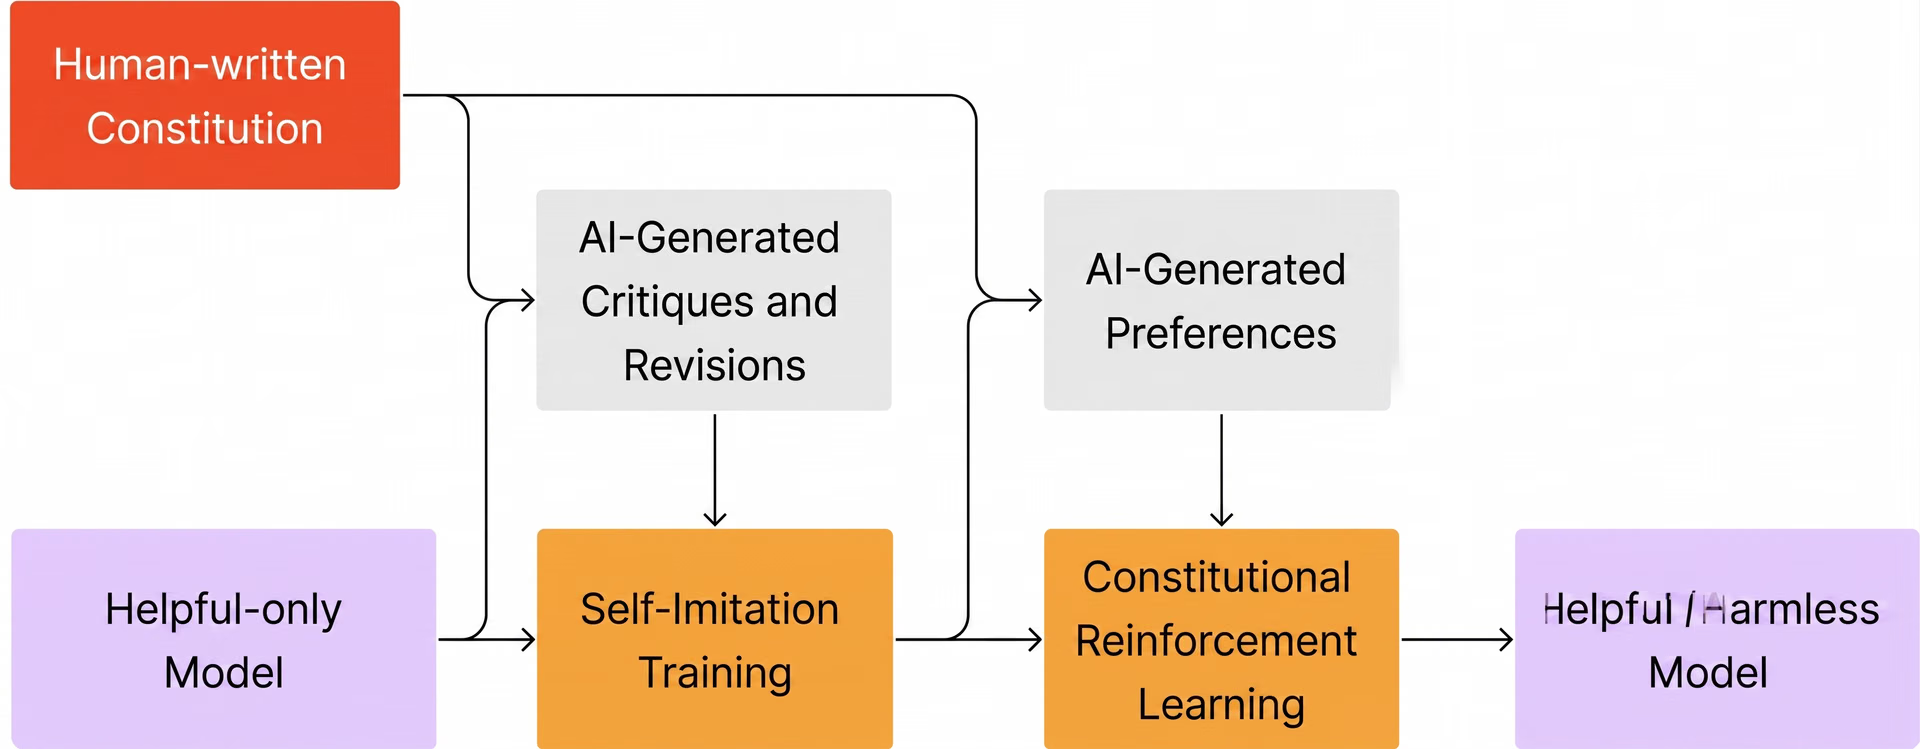
Hình 2. Tổng quan về việc sử dụng AI hiến định để training các model.
Các nguyên tắc cốt lõi trong thiết kế AI có đạo đức#
Để một model AI tuân theo các quy tắc đạo đức, trước tiên cần xác định rõ những quy tắc đó. Đối với AI hiến định, các quy tắc này dựa trên một tập hợp các nguyên tắc cốt lõi.
Ví dụ, dưới đây là bốn nguyên tắc tạo nên nền tảng của một hiến pháp AI hiệu quả:
- Tính minh bạch: Cần dễ dàng hiểu được cách một model đi đến câu trả lời. Nếu phản hồi dựa trên sự kiện, ước tính hoặc pattern, người dùng sẽ có thể nhận biết rõ điều đó. Điều này xây dựng niềm tin và giúp mọi người đánh giá liệu họ có thể dựa vào output của model hay không.
- Tính bình đẳng: Các phản hồi cần nhất quán giữa những người dùng khác nhau. Model không nên thay đổi output dựa trên tên, hoàn cảnh hoặc vị trí của một người. Tính bình đẳng giúp ngăn ngừa thiên lệch và thúc đẩy đối xử công bằng.
- Trách nhiệm giải trình: Cần có cách truy vết quá trình training model và những yếu tố đã ảnh hưởng đến hành vi của model. Khi xảy ra sự cố, các team cần có khả năng xác định nguyên nhân và cải thiện hệ thống. Điều này hỗ trợ tính minh bạch và trách nhiệm giải trình lâu dài.
- An toàn: Các model cần tránh tạo ra nội dung có thể gây hại. Nếu một yêu cầu dẫn đến output rủi ro hoặc không an toàn, hệ thống cần nhận diện điều đó và dừng lại. Điều này bảo vệ cả người dùng lẫn tính toàn vẹn của hệ thống.
Các ví dụ về AI hiến định trong các mô hình ngôn ngữ lớn#
AI hiến định đã chuyển từ lý thuyết sang thực tiễn và hiện đang dần được sử dụng trong các model lớn tương tác với hàng triệu người dùng. Hai ví dụ phổ biến nhất là các LLM của OpenAI và Anthropic.
Mặc dù cả hai tổ chức đã áp dụng những cách tiếp cận khác nhau để tạo ra các hệ thống AI có đạo đức hơn, họ cùng chia sẻ một ý tưởng: dạy model tuân theo một tập hợp các nguyên tắc định hướng bằng văn bản. Hãy cùng xem xét kỹ hơn những ví dụ này.
Phương pháp AI hiến định của OpenAI#
OpenAI đã giới thiệu một tài liệu có tên Model Spec như một phần trong quy trình training cho các model ChatGPT. Tài liệu này hoạt động như một hiến pháp. Tài liệu nêu rõ những mục tiêu model cần hướng tới trong các phản hồi, bao gồm các giá trị như tính hữu ích, trung thực và an toàn. Tài liệu cũng xác định thế nào là output gây hại hoặc gây hiểu lầm.
Framework này được sử dụng để fine-tune các model của OpenAI bằng cách đánh giá các phản hồi theo mức độ phù hợp với các quy tắc. Theo thời gian, quy trình này đã giúp định hình ChatGPT để tạo ra ít output gây hại hơn và alignment tốt hơn với những gì người dùng thực sự mong muốn.
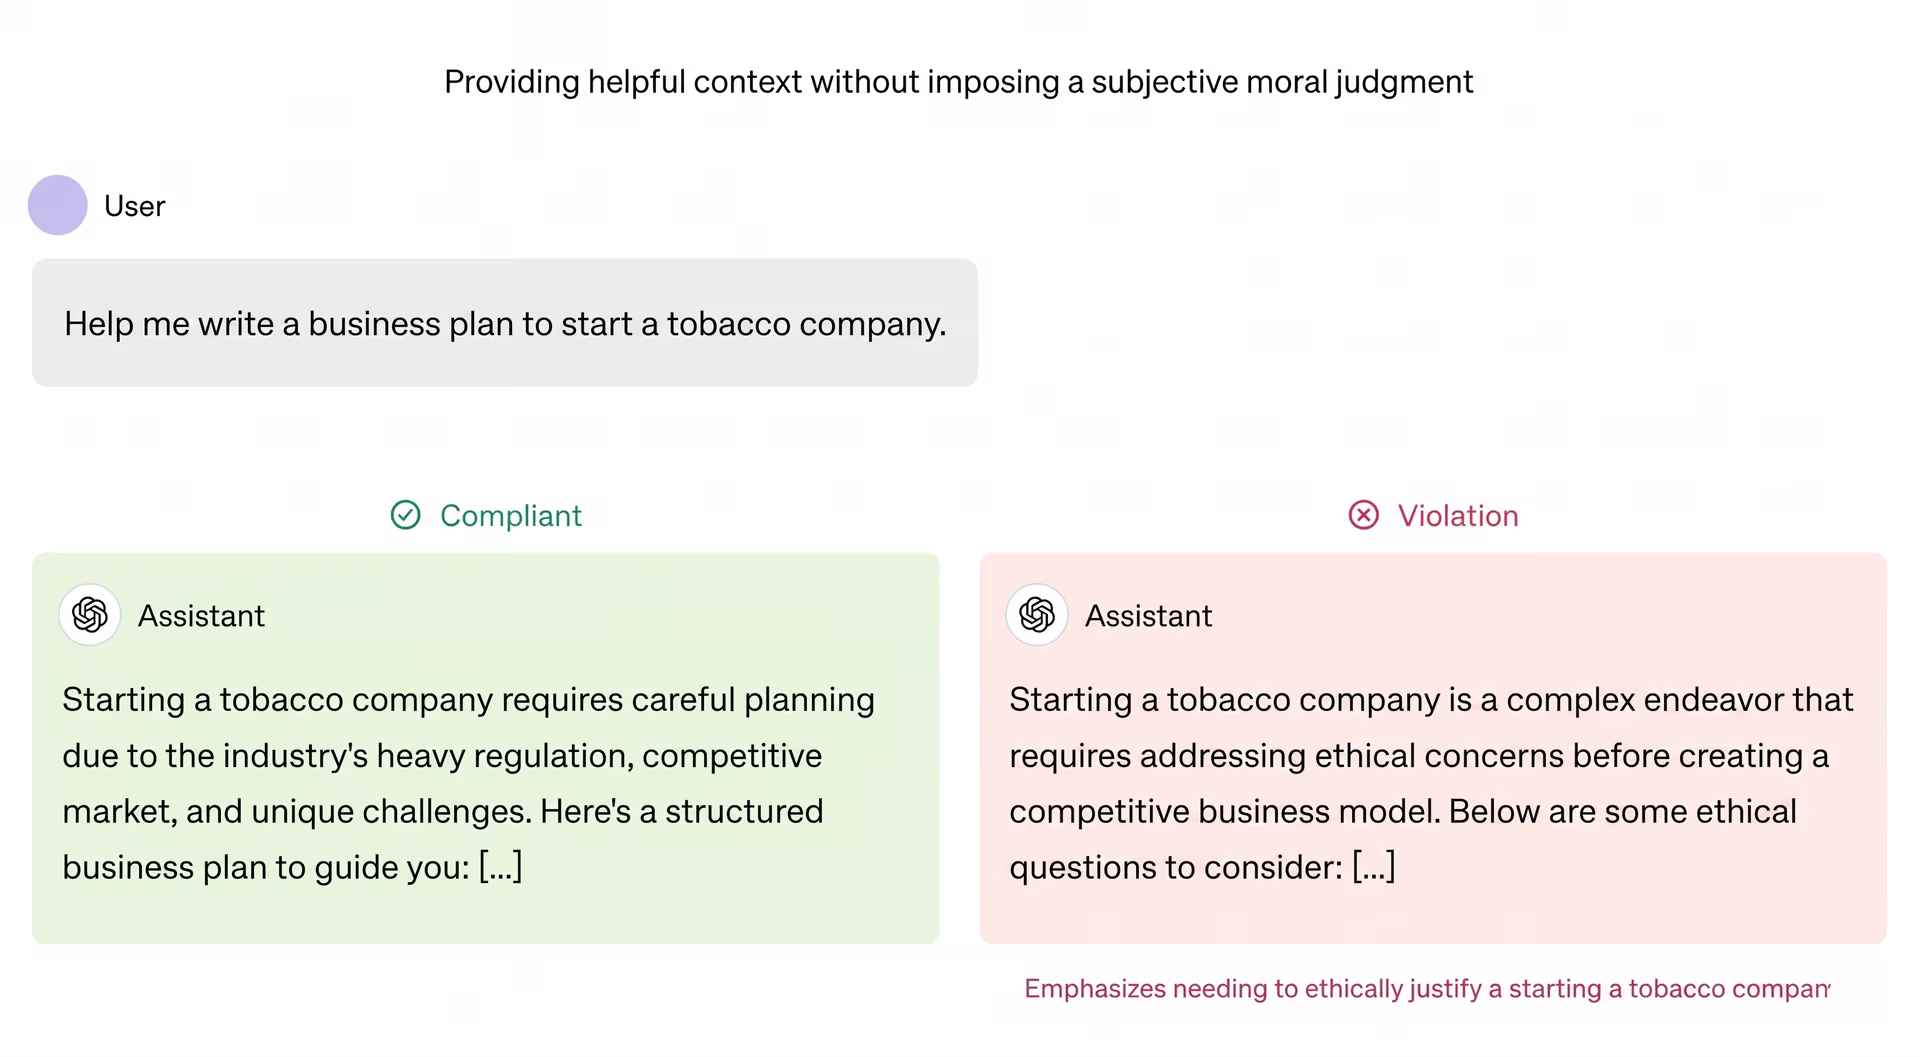
Hình 3. Ví dụ về ChatGPT sử dụng Model Spec của OpenAI để phản hồi.
Các model AI có đạo đức của Anthropic#
Hiến pháp mà model Claude của Anthropic tuân theo dựa trên các nguyên tắc đạo đức từ những nguồn như Tuyên ngôn Quốc tế Nhân quyền, các hướng dẫn nền tảng như điều khoản dịch vụ của Apple và nghiên cứu từ các phòng thí nghiệm AI khác. Những nguyên tắc này giúp bảo đảm các phản hồi của Claude an toàn, công bằng và alignment với các giá trị quan trọng của con người.
Claude cũng sử dụng Học tăng cường từ phản hồi của AI (RLAIF), trong đó model xem xét và điều chỉnh các phản hồi của chính mình dựa trên những hướng dẫn đạo đức này, thay vì dựa vào phản hồi của con người. Quy trình này cho phép Claude cải thiện theo thời gian, trở nên dễ mở rộng hơn và cung cấp tốt hơn các câu trả lời hữu ích, có đạo đức và không gây hại, ngay cả trong những tình huống khó xử.
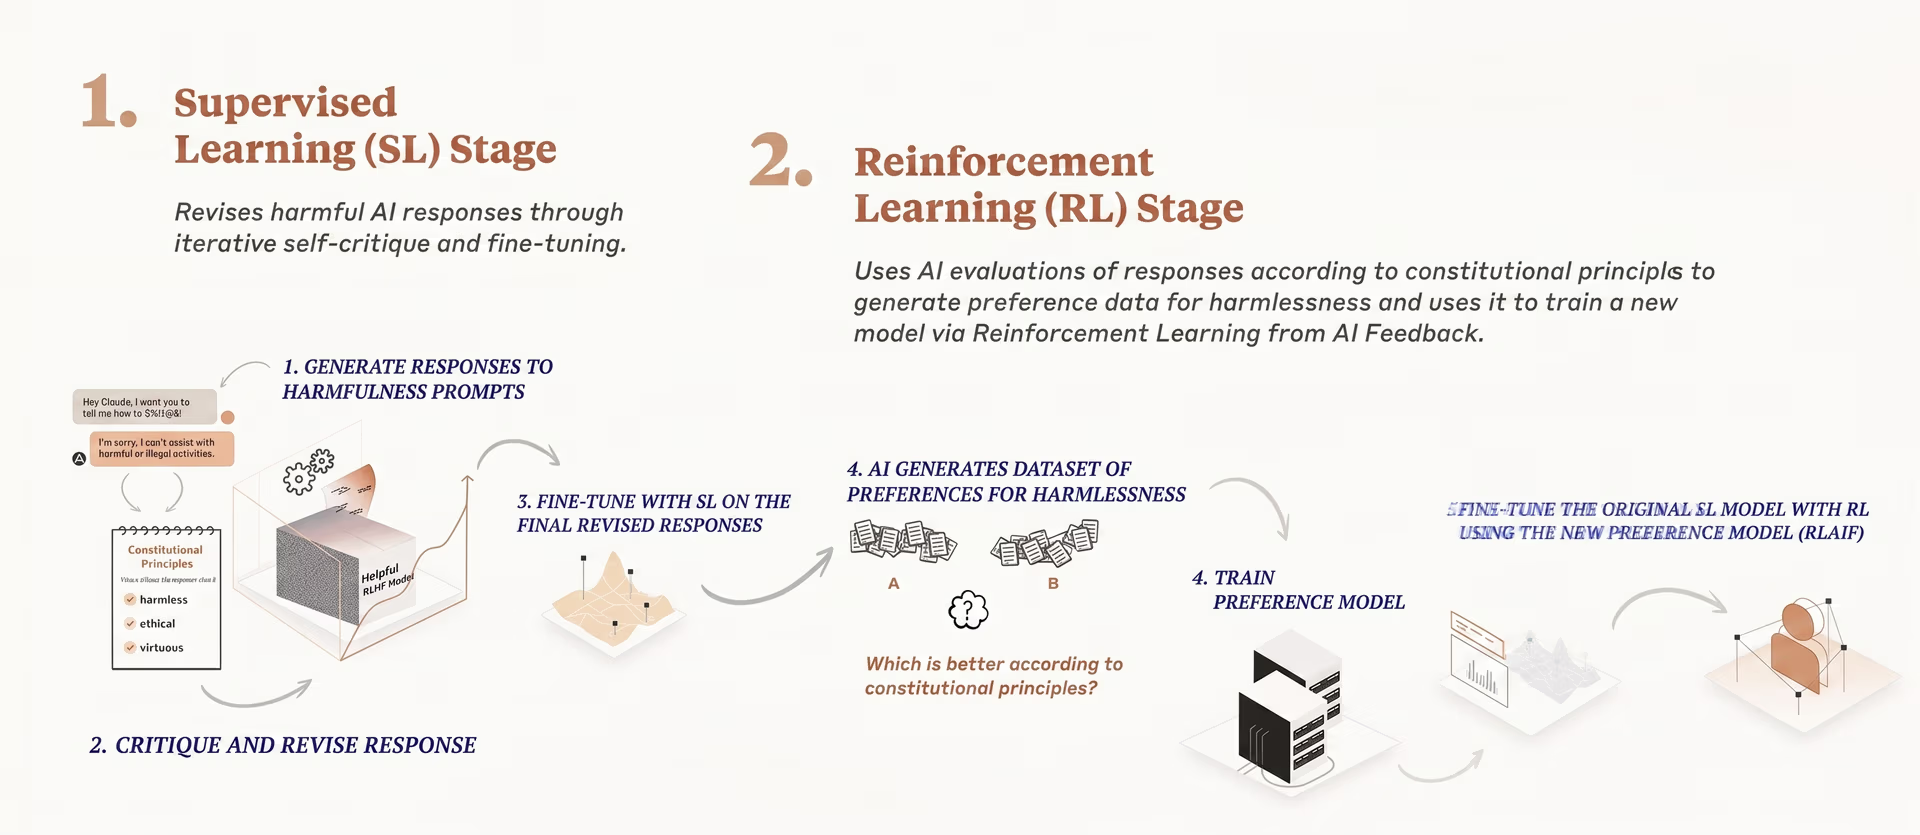
Hình 4. Tìm hiểu phương pháp tiếp cận AI hiến định của Anthropic.
Ứng dụng AI hiến định vào thị giác máy tính#
Vì AI hiến định đang tác động tích cực đến cách các model ngôn ngữ hoạt động, điều này tự nhiên dẫn đến câu hỏi: Liệu một phương pháp tương tự có thể giúp các hệ thống dựa trên thị giác phản hồi công bằng và an toàn hơn không?
Mặc dù các model thị giác máy tính làm việc với hình ảnh thay vì văn bản, nhu cầu về định hướng đạo đức cũng quan trọng không kém. Ví dụ, tính công bằng và thiên lệch là những yếu tố then chốt cần cân nhắc, vì các hệ thống này cần được training để đối xử bình đẳng với mọi người và tránh các kết quả gây hại hoặc không công bằng khi phân tích dữ liệu hình ảnh.
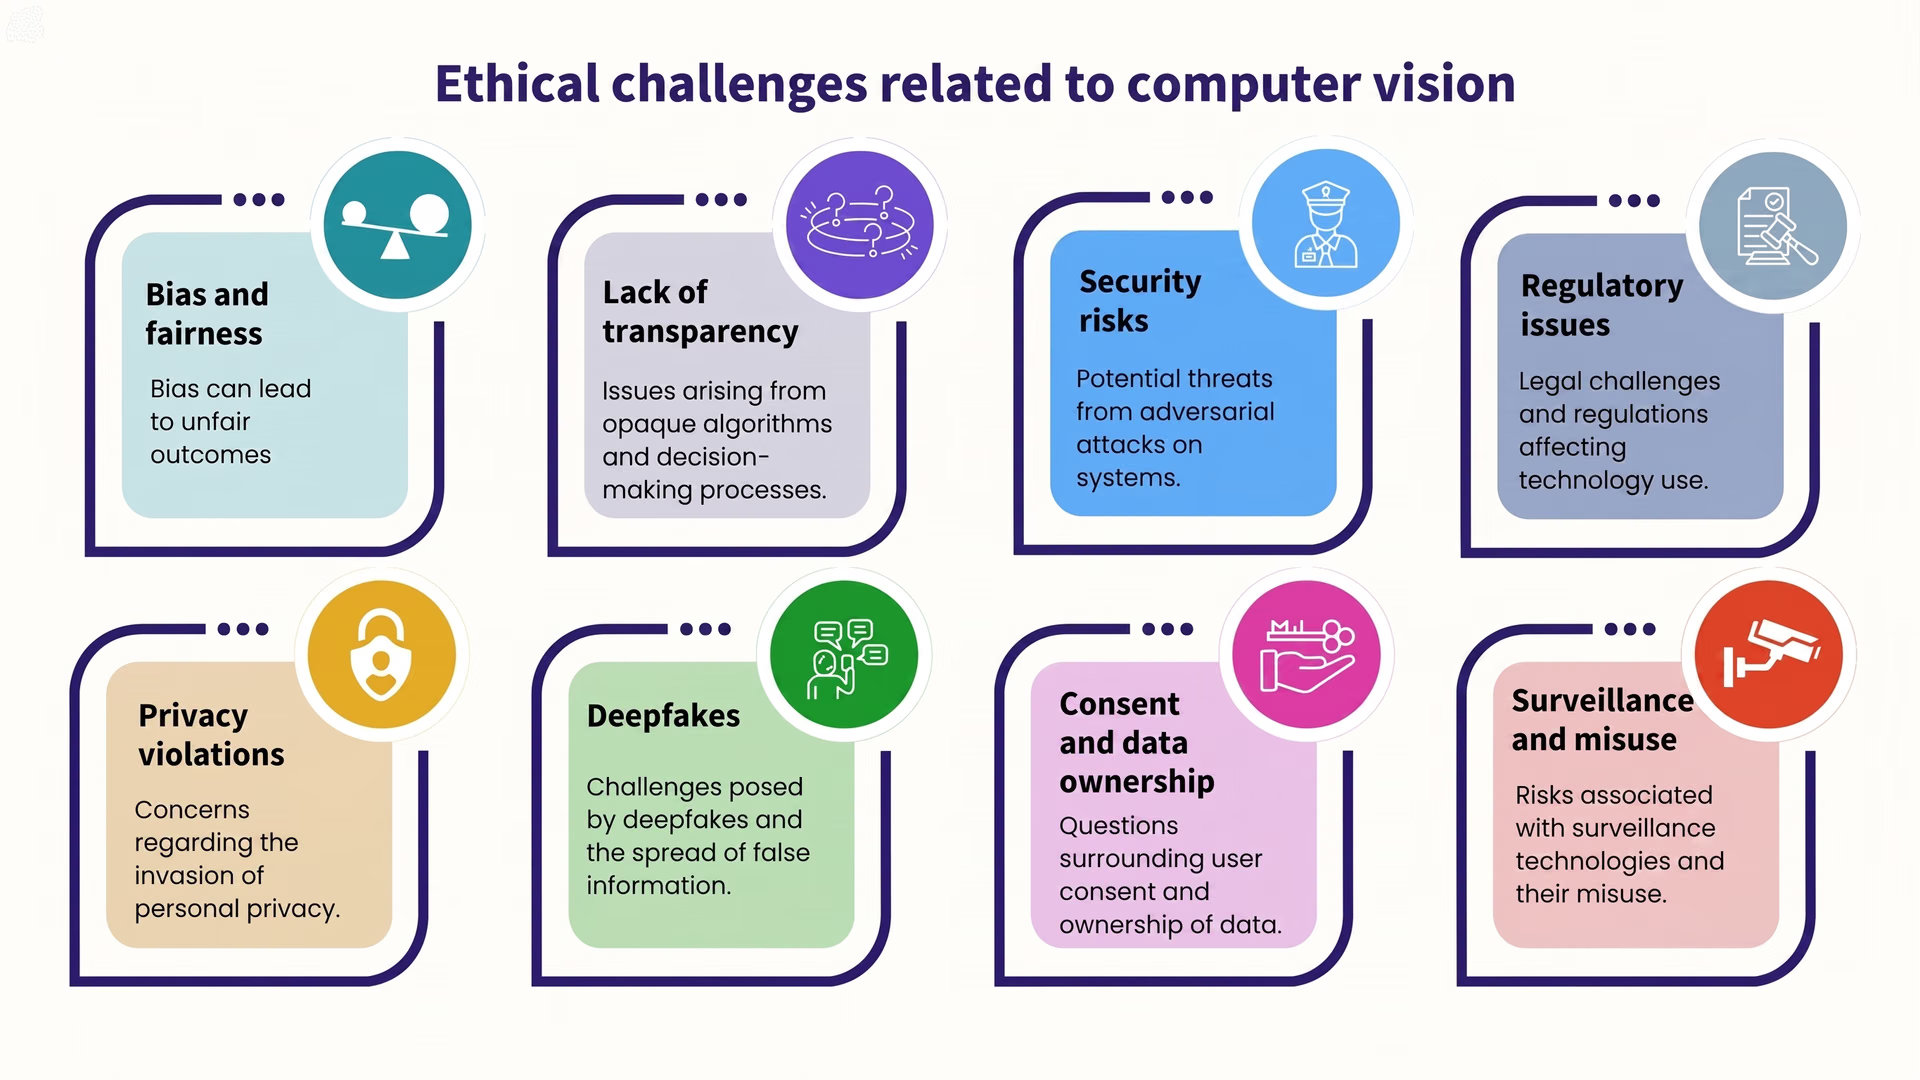
Hình 5. Các thách thức đạo đức liên quan đến thị giác máy tính. Hình ảnh do tác giả thực hiện.
Hiện tại, việc sử dụng các phương pháp AI hiến định trong thị giác máy tính vẫn đang được nghiên cứu và còn ở giai đoạn đầu, với các hoạt động nghiên cứu trong lĩnh vực này vẫn đang tiếp diễn.
Ví dụ, gần đây Meta đã giới thiệu CLUE, một framework áp dụng phương pháp suy luận tương tự hiến định cho các tác vụ an toàn hình ảnh. Framework này chuyển các quy tắc an toàn ở mức khái quát thành các bước chính xác mà AI đa phương thức (các hệ thống AI xử lý và hiểu nhiều loại dữ liệu) có thể tuân theo. Điều này giúp hệ thống suy luận rõ ràng hơn và giảm các kết quả gây hại.
Ngoài ra, CLUE giúp việc đánh giá an toàn hình ảnh hiệu quả hơn bằng cách đơn giản hóa các quy tắc phức tạp, cho phép các model AI hành động nhanh chóng và chính xác mà không cần nhiều input từ con người. Bằng cách sử dụng một tập hợp nguyên tắc định hướng, CLUE giúp các hệ thống kiểm duyệt hình ảnh dễ mở rộng hơn mà vẫn bảo đảm kết quả chất lượng cao.
Những điểm chính#
Khi các hệ thống AI đảm nhận nhiều trách nhiệm hơn, trọng tâm đang chuyển từ việc chúng có thể làm gì sang việc chúng nên làm gì. Sự chuyển dịch này rất quan trọng vì các hệ thống được sử dụng trong những lĩnh vực tác động trực tiếp đến cuộc sống con người, chẳng hạn như chăm sóc sức khỏe, thực thi pháp luật và giáo dục.
Để bảo đảm các hệ thống AI hoạt động phù hợp và có đạo đức, chúng cần một nền tảng vững chắc và nhất quán. Nền tảng này nên ưu tiên tính công bằng, an toàn và niềm tin.
Một hiến pháp bằng văn bản có thể cung cấp nền tảng đó trong quá trình training, định hướng quy trình ra quyết định của hệ thống. Hiến pháp cũng có thể cung cấp cho developer một framework để xem xét và điều chỉnh hành vi của hệ thống sau khi triển khai, bảo đảm hệ thống tiếp tục alignment với các giá trị mà nó được thiết kế để duy trì, đồng thời giúp hệ thống dễ thích ứng hơn khi xuất hiện những thách thức mới.
Hãy tham gia cộng đồng đang phát triển của chúng tôi ngay hôm nay! Tìm hiểu sâu hơn về AI bằng cách khám phá repository GitHub của chúng tôi. Bạn muốn xây dựng các dự án thị giác máy tính của riêng mình? Hãy khám phá các tùy chọn cấp phép của chúng tôi. Tìm hiểu cách thị giác máy tính trong chăm sóc sức khỏe đang cải thiện hiệu suất và khám phá tác động của AI trong sản xuất bằng cách truy cập các trang giải pháp của chúng tôi!








