Cải thiện độ vững chắc của model AI bằng tăng cường dữ liệu
Tìm hiểu cách bổ sung các biến thể thực tế vào dữ liệu huấn luyện thông qua tăng cường dữ liệu giúp cải thiện độ vững chắc và hiệu năng thực tế của model AI.
Kiểm thử là phần thiết yếu trong quá trình xây dựng mọi giải pháp công nghệ. Kiểm thử cho các nhóm thấy hệ thống thực sự hoạt động như thế nào trước khi đưa vào vận hành và giúp họ khắc phục vấn đề từ sớm. Điều này đúng với nhiều lĩnh vực, bao gồm cả AI, nơi các model được kỳ vọng xử lý những điều kiện khó đoán trong thực tế sau khi triển khai.
Ví dụ, thị giác máy tính là một nhánh của AI giúp máy móc hiểu hình ảnh và video. Các model thị giác máy tính như Ultralytics YOLO26 hỗ trợ những tác vụ như phát hiện đối tượng, phân đoạn thực thể và phân loại hình ảnh.
Các model này có thể được sử dụng trong nhiều ngành cho những ứng dụng như giám sát bệnh nhân, phân tích giao thông, thanh toán tự động và kiểm tra chất lượng trong sản xuất. Tuy nhiên, ngay cả với model tiên tiến và dữ liệu huấn luyện chất lượng cao, các giải pháp AI thị giác vẫn có thể gặp khó khăn khi đối mặt với những biến động trong thực tế như ánh sáng thay đổi, chuyển động hoặc vật thể bị che khuất một phần.
Điều này xảy ra vì model học từ các ví dụ được cung cấp trong quá trình huấn luyện. Nếu chưa từng thấy những điều kiện như chói sáng, nhòe do chuyển động hoặc vật thể chỉ hiển thị một phần, model sẽ khó nhận diện chính xác đối tượng hơn trong những tình huống đó.
Một cách cải thiện độ bền vững của model là sử dụng tăng cường dữ liệu. Thay vì thu thập lượng lớn dữ liệu mới, kỹ sư có thể thực hiện những thay đổi nhỏ nhưng có ý nghĩa đối với hình ảnh hiện có, chẳng hạn như điều chỉnh ánh sáng, cắt xén hoặc trộn hình ảnh. Điều này giúp model học cách nhận diện cùng một đối tượng trong phạm vi tình huống rộng hơn.
Trong bài viết này, chúng ta sẽ tìm hiểu cách tăng cường dữ liệu cải thiện độ bền vững của model và độ tin cậy của các hệ thống AI thị giác khi được triển khai bên ngoài môi trường được kiểm soát. Bắt đầu thôi!
Cách kiểm tra độ bền vững của model#
Trước khi tìm hiểu về tăng cường dữ liệu, hãy cùng thảo luận cách xác định liệu một model thị giác máy tính đã thực sự sẵn sàng được sử dụng trong thực tế hay chưa.
Một model bền vững tiếp tục hoạt động tốt ngay cả khi điều kiện thay đổi, thay vì chỉ hoạt động tốt với hình ảnh sạch, được gán nhãn hoàn hảo. Sau đây là một số yếu tố thực tế cần cân nhắc khi đánh giá độ bền vững của model AI:
- Thay đổi ánh sáng: Model có thể hoạt động khác nhau khi gặp ánh sáng mạnh, ánh sáng yếu, chói sáng hoặc bóng đổ; những yếu tố này có thể ảnh hưởng đến độ tin cậy khi phát hiện đối tượng.
- Che khuất một phần: Trong các cảnh thường ngày, vật thể thường bị những vật khác che khuất hoặc chỉ hiển thị một phần. Model bền vững hơn có thể nhận diện vật thể ngay cả khi thiếu thông tin hình ảnh.
- Cảnh đông đúc: Môi trường có nhiều vật thể chồng lấn khiến việc phát hiện trở nên khó khăn hơn. Các model hoạt động tốt trong những trường hợp này thường đáng tin cậy hơn trong bối cảnh phức tạp.
Kết quả tốt trên hình ảnh sạch, được ghi lại hoàn hảo không phải lúc nào cũng đồng nghĩa với hiệu suất cao trong thực tế. Kiểm thử thường xuyên trong nhiều điều kiện khác nhau giúp đánh giá mức độ hoạt động ổn định của model sau khi triển khai.
Tăng cường dữ liệu là gì?#
Hình dạng của một vật thể trong ảnh có thể thay đổi tùy theo ánh sáng, góc chụp, khoảng cách hoặc phông nền. Khi huấn luyện model thị giác máy tính, bộ dữ liệu mà model học cần bao gồm những biến thể này để model hoạt động tốt trong môi trường khó đoán.
Tăng cường dữ liệu mở rộng bộ dữ liệu huấn luyện bằng cách tạo thêm ví dụ từ những hình ảnh bạn đã có. Việc này được thực hiện bằng cách áp dụng các thay đổi có chủ đích, chẳng hạn như xoay hoặc lật hình ảnh, điều chỉnh độ sáng hoặc cắt một phần hình ảnh.
Ví dụ, hãy tưởng tượng bạn chỉ có một bức ảnh chụp mèo. Nếu xoay ảnh hoặc thay đổi độ sáng, bạn có thể tạo ra một số phiên bản mới từ bức ảnh đó. Mỗi phiên bản trông hơi khác nhau nhưng vẫn là ảnh chụp cùng một con mèo. Những biến thể này giúp dạy model rằng một vật thể có thể trông khác đi nhưng vẫn là cùng một vật thể.
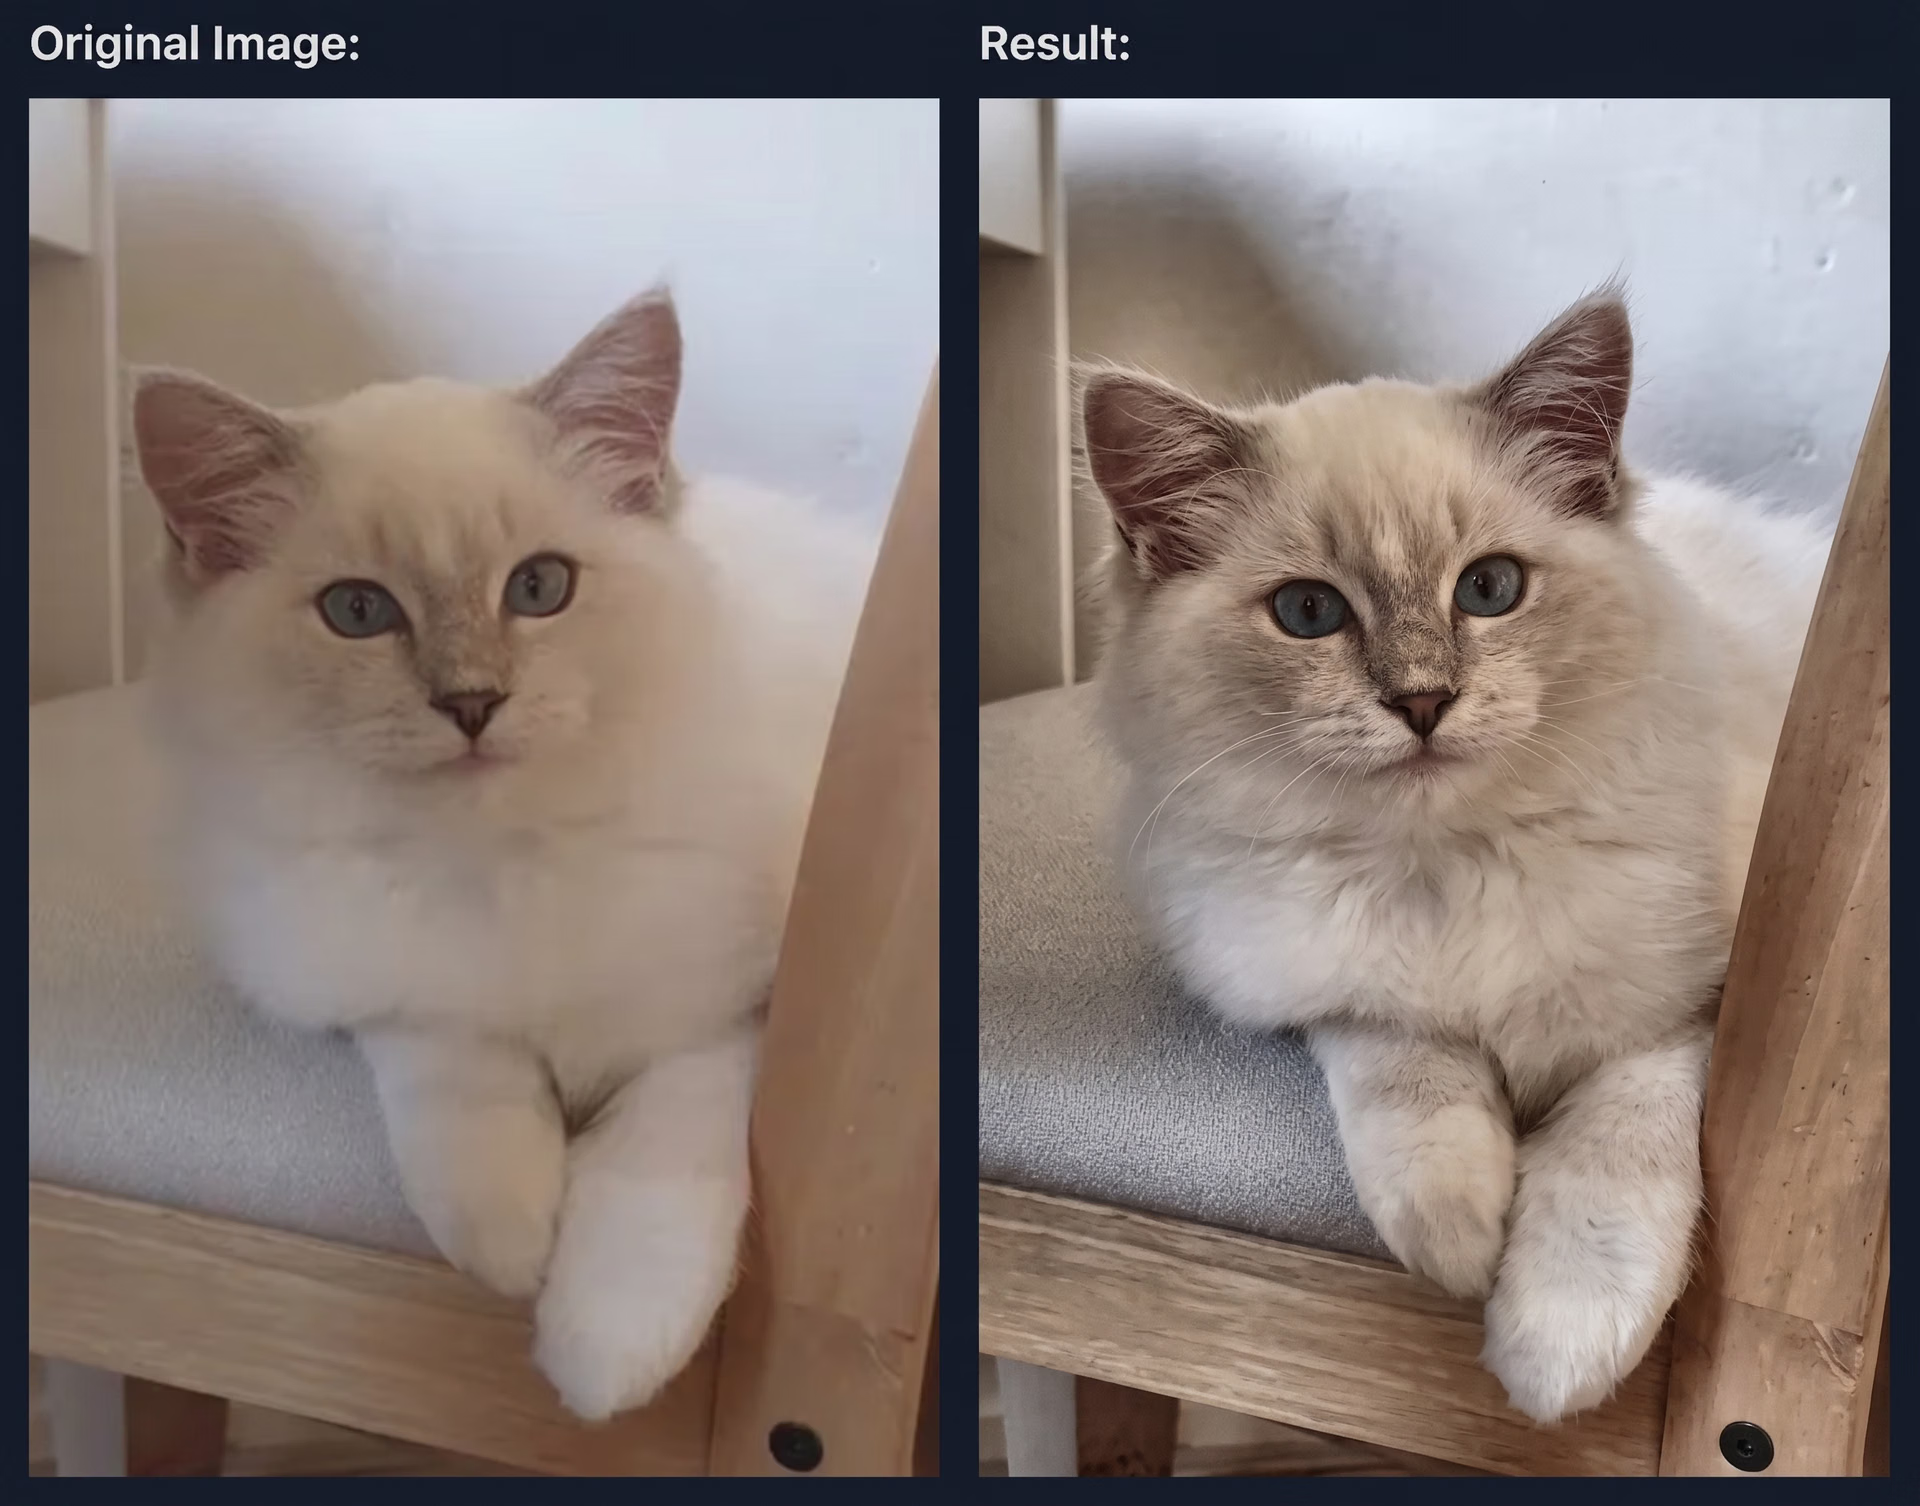
Hình 1. Minh họa tăng cường ảnh chụp mèo (Nguồn)
Cách tăng cường dữ liệu cải thiện hiệu suất model#
Trong quá trình huấn luyện model, tăng cường dữ liệu có thể được tích hợp trực tiếp vào pipeline huấn luyện. Thay vì tạo và lưu trữ thủ công các bản sao mới của hình ảnh, các phép biến đổi ngẫu nhiên có thể được áp dụng mỗi khi tải một hình ảnh.
Điều này có nghĩa là mỗi lần, model sẽ thấy một phiên bản hình ảnh hơi khác, chẳng hạn như sáng hơn, bị lật hoặc bị che khuất một phần. Các kỹ thuật như xóa ngẫu nhiên thậm chí có thể loại bỏ những vùng nhỏ trên hình ảnh để mô phỏng các tình huống thực tế khi vật thể bị che khuất hoặc chỉ hiển thị một phần.
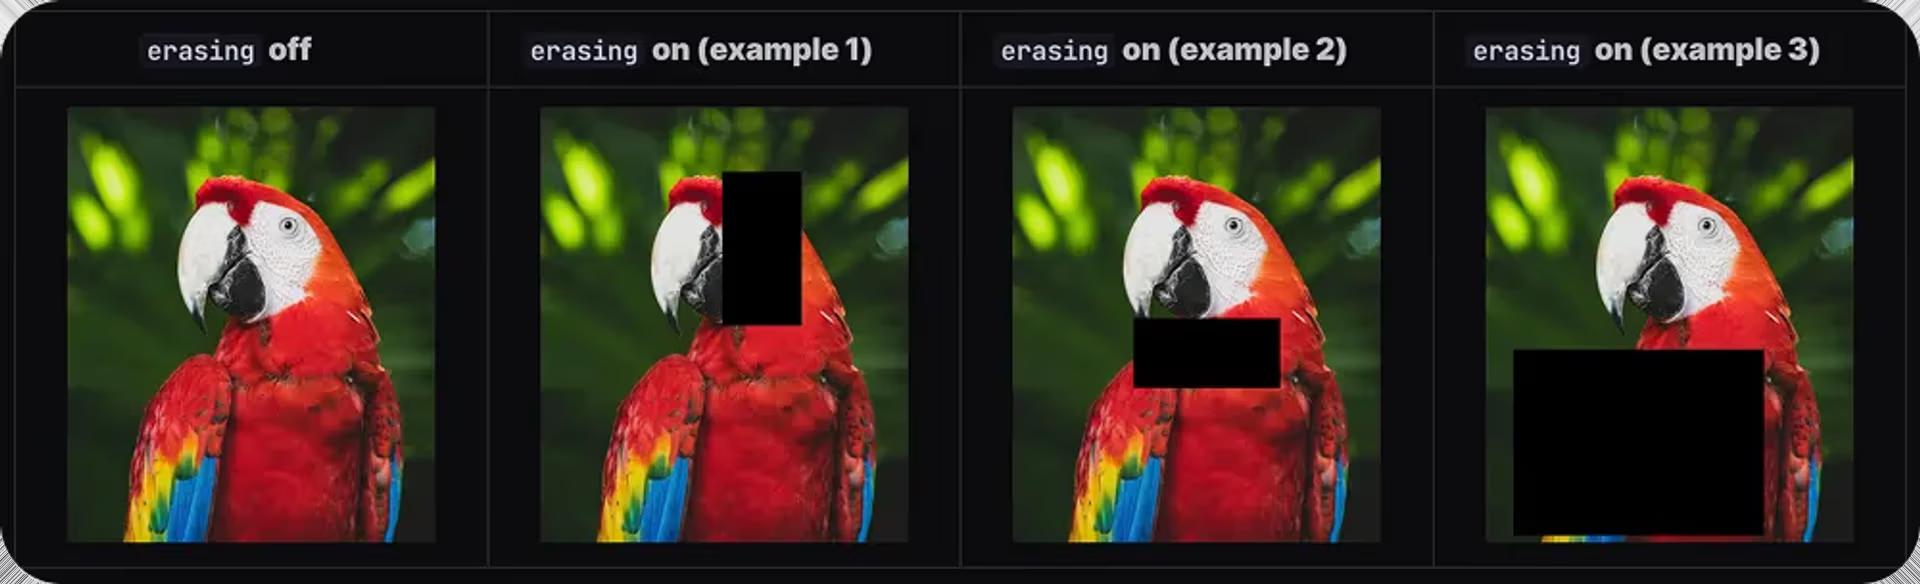
Hình 2. Ví dụ về tăng cường dữ liệu bằng cách xóa ngẫu nhiên (Nguồn)
Việc quan sát nhiều phiên bản khác nhau của cùng một hình ảnh giúp model học được những đặc trưng nào là quan trọng, thay vì phụ thuộc vào một ví dụ hoàn hảo duy nhất. Sự đa dạng này giúp tăng độ bền vững của model AI để model hoạt động đáng tin cậy hơn trong điều kiện thực tế.
Các kỹ thuật tăng cường dữ liệu phổ biến#
Dưới đây là một số kỹ thuật tăng cường dữ liệu được sử dụng để tạo biến thể cho hình ảnh huấn luyện:
- Biến đổi hình học: Những kỹ thuật này thay đổi cách một đối tượng xuất hiện về mặt không gian trong hình ảnh. Xoay, lật, thay đổi kích thước, cắt hoặc dịch chuyển hình ảnh giúp model hiểu được một đối tượng có thể được nhìn từ các góc độ hoặc khoảng cách khác nhau như thế nào.
- Điều chỉnh màu sắc và ánh sáng: Điều kiện ánh sáng trong thực tế hiếm khi ổn định. Hình ảnh có thể quá sáng, quá tối hoặc hơi lệch màu, tùy thuộc vào môi trường hoặc camera được sử dụng. Điều chỉnh độ sáng, độ tương phản, sắc độ và độ bão hòa giúp model xử lý những thay đổi về hình ảnh này và hoạt động tốt trong nhiều bối cảnh khác nhau.
- Biến đổi chất lượng hình ảnh: Độ mờ hoặc nhiễu hình ảnh có thể khiến hình ảnh trông không rõ nét. Thêm độ mờ hoặc nhiễu trong quá trình huấn luyện giúp model học cách xử lý hiện tượng nhòe do chuyển động, hình ảnh thiếu sáng hoặc kết quả từ camera chất lượng thấp, nhờ đó model ít nhạy cảm hơn với hình ảnh không hoàn hảo.
- Tăng cường dữ liệu dựa trên hiện tượng che khuất: Trong môi trường thực tế, các đối tượng thường bị những đối tượng khác che khuất một phần. Đây được gọi là hiện tượng che khuất trong hình ảnh. Việc ẩn hoặc che một vùng nhỏ của hình ảnh trong quá trình huấn luyện giúp model học cách phát hiện đối tượng ngay cả khi chỉ nhìn thấy một phần.
- Tăng cường dữ liệu đa hình ảnh: Những kỹ thuật này kết hợp các phần từ nhiều hình ảnh thành một mẫu huấn luyện duy nhất, qua đó có thể tăng số lượng đối tượng xuất hiện và cải thiện khả năng xử lý các cảnh phức tạp hoặc đông đúc của model.
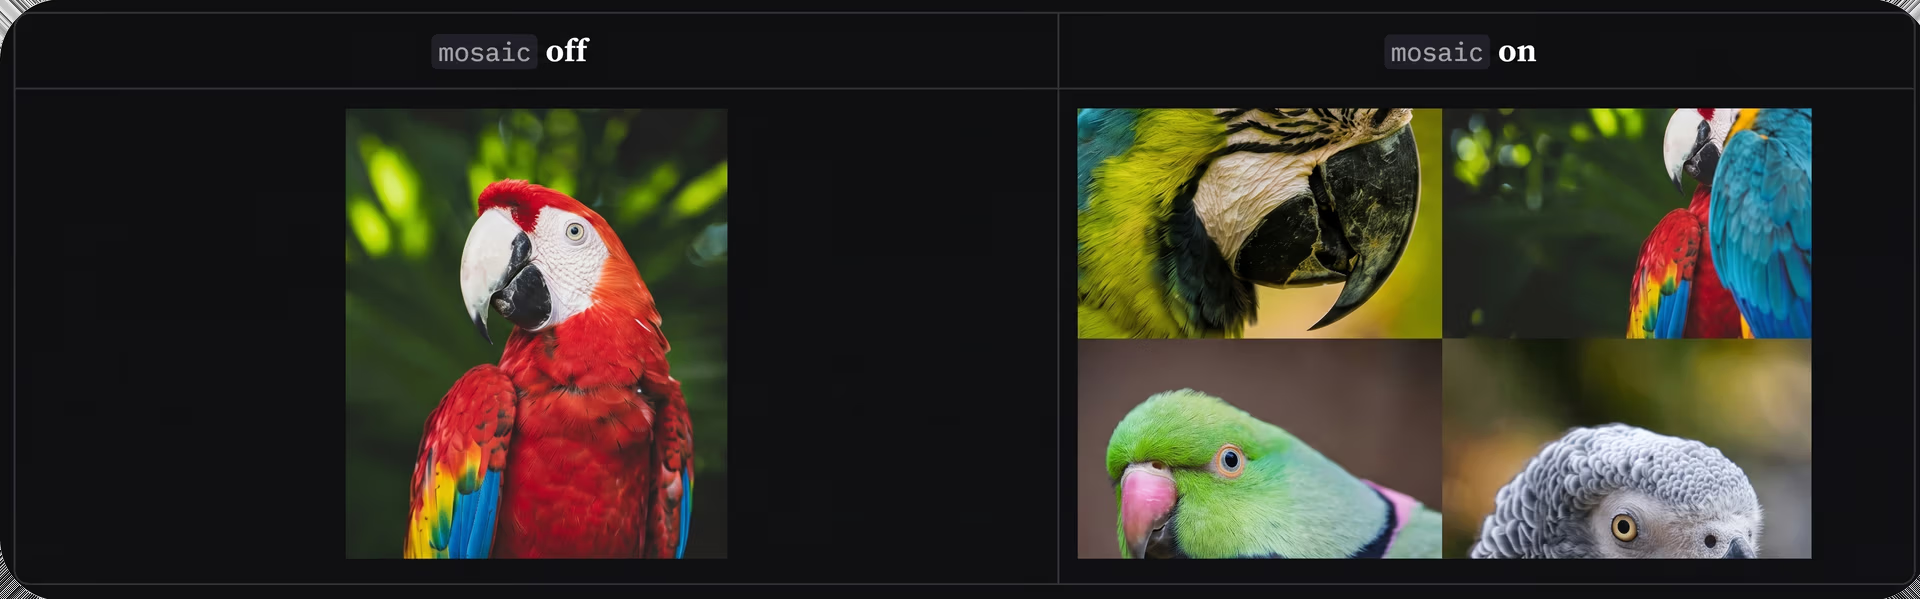
Hình 3. Ví dụ về tăng cường dữ liệu đa hình ảnh (Nguồn)
Tăng cường dữ liệu dễ dàng với package Ultralytics Python#
Quản lý dataset, tạo biến thể hình ảnh và viết code biến đổi có thể khiến quy trình xây dựng ứng dụng thị giác máy tính thêm nhiều bước. Package Ultralytics Python giúp đơn giản hóa quy trình này bằng cách cung cấp một giao diện thống nhất để huấn luyện, chạy và triển khai các model Ultralytics YOLO như YOLO26. Nhằm tinh giản quy trình huấn luyện, package này tích hợp sẵn các phương pháp tăng cường dữ liệu đã được Ultralytics kiểm thử và tối ưu cho model YOLO.
Package này cũng hỗ trợ các tích hợp hữu ích, giúp loại bỏ nhu cầu sử dụng công cụ riêng hoặc viết code tùy chỉnh. Cụ thể, để tăng cường dữ liệu, package tích hợp với Albumentations, một thư viện tăng cường hình ảnh được sử dụng rộng rãi. Tích hợp này cho phép tự động áp dụng các phép tăng cường trong quá trình huấn luyện mà không cần script bổ sung hoặc code tùy chỉnh.
Quản lý annotation và dataset đã tăng cường#
Một yếu tố khác ảnh hưởng đến độ bền vững của model là chất lượng annotation. Nhãn chính xác, rõ ràng được tạo và quản lý bằng các công cụ annotation như Roboflow giúp model hiểu vị trí và hình dạng của các đối tượng.
Trong quá trình huấn luyện, các phép tăng cường dữ liệu như lật, cắt và xoay được áp dụng linh hoạt, đồng thời annotation được tự động điều chỉnh để khớp với những thay đổi này. Khi nhãn chính xác, quy trình này diễn ra trơn tru và cung cấp cho model nhiều ví dụ thực tế về cùng một cảnh.
Nếu annotation không chính xác hoặc không nhất quán, những lỗi đó có thể lặp lại trên các hình ảnh đã tăng cường, khiến việc huấn luyện kém hiệu quả hơn. Bắt đầu với annotation chính xác giúp ngăn lỗi lan rộng và góp phần cải thiện độ bền vững của model.
Nâng cao ứng dụng AI thị giác bằng tăng cường dữ liệu#
Tiếp theo, hãy cùng xem các ví dụ về cách tăng cường dữ liệu góp phần nâng cao độ bền vững của model AI trong những ứng dụng thực tế.
Tăng độ chính xác phát hiện đối tượng trong môi trường thực tế#
Hình ảnh tổng hợp thường được dùng để huấn luyện hệ thống phát hiện đối tượng khi dữ liệu thực tế bị hạn chế, nhạy cảm hoặc khó thu thập. Hình ảnh tổng hợp giúp các nhóm nhanh chóng tạo ví dụ về sản phẩm, môi trường và góc camera mà không cần ghi hình mọi tình huống ngoài thực tế.
Tuy nhiên, đôi khi dataset tổng hợp trông quá hoàn hảo so với cảnh quay thực tế, nơi ánh sáng thay đổi, các đối tượng chồng lấp và khung cảnh có nhiều chi tiết nền gây nhiễu. Tăng cường dữ liệu giúp thu hẹp khoảng cách này bằng cách tạo ra các biến thể thực tế, chẳng hạn như thay đổi ánh sáng, thêm nhiễu hoặc thay đổi vị trí đối tượng, để model học cách xử lý những điều kiện sẽ gặp khi triển khai.
Ví dụ, trong một nghiên cứu gần đây, một model Ultralytics YOLO11 được huấn luyện hoàn toàn trên hình ảnh tổng hợp, đồng thời áp dụng tăng cường dữ liệu để bổ sung thêm biến thể. Điều này góp phần giúp model học cách nhận diện đối tượng trên phạm vi rộng hơn. Model hoạt động tốt khi được kiểm thử trên hình ảnh thực tế, dù chưa từng thấy dữ liệu thực tế trong quá trình huấn luyện.
Tăng độ tin cậy của giải pháp chẩn đoán hình ảnh y tế#
Dataset chẩn đoán hình ảnh y tế thường bị hạn chế, và bản thân ảnh quét có thể khác nhau tùy theo loại thiết bị, cài đặt chụp ảnh hoặc môi trường lâm sàng. Sự khác biệt về giải phẫu bệnh nhân, góc chụp, ánh sáng hoặc nhiễu hình ảnh có thể khiến model thị giác máy tính khó học được các mẫu tổng quát hóa tốt cho nhiều bệnh nhân và bệnh viện.
Tăng cường dữ liệu giúp giải quyết vấn đề này bằng cách tạo nhiều biến thể của cùng một ảnh quét trong quá trình huấn luyện, chẳng hạn như thêm nhiễu, dịch chuyển nhẹ hình ảnh hoặc áp dụng các biến dạng nhỏ. Những thay đổi này giúp dữ liệu huấn luyện phản ánh sát hơn các điều kiện lâm sàng thực tế.
Ví dụ, trong một nghiên cứu về chẩn đoán hình ảnh nhi khoa, các nhà nghiên cứu sử dụng Ultralytics YOLO11 để phân đoạn cấu trúc giải phẫu và huấn luyện model trên dữ liệu y tế đã tăng cường. Họ tạo các biến thể như thêm nhiễu, dịch chuyển nhẹ vị trí và biến dạng nhỏ để hình ảnh trông thực tế hơn.
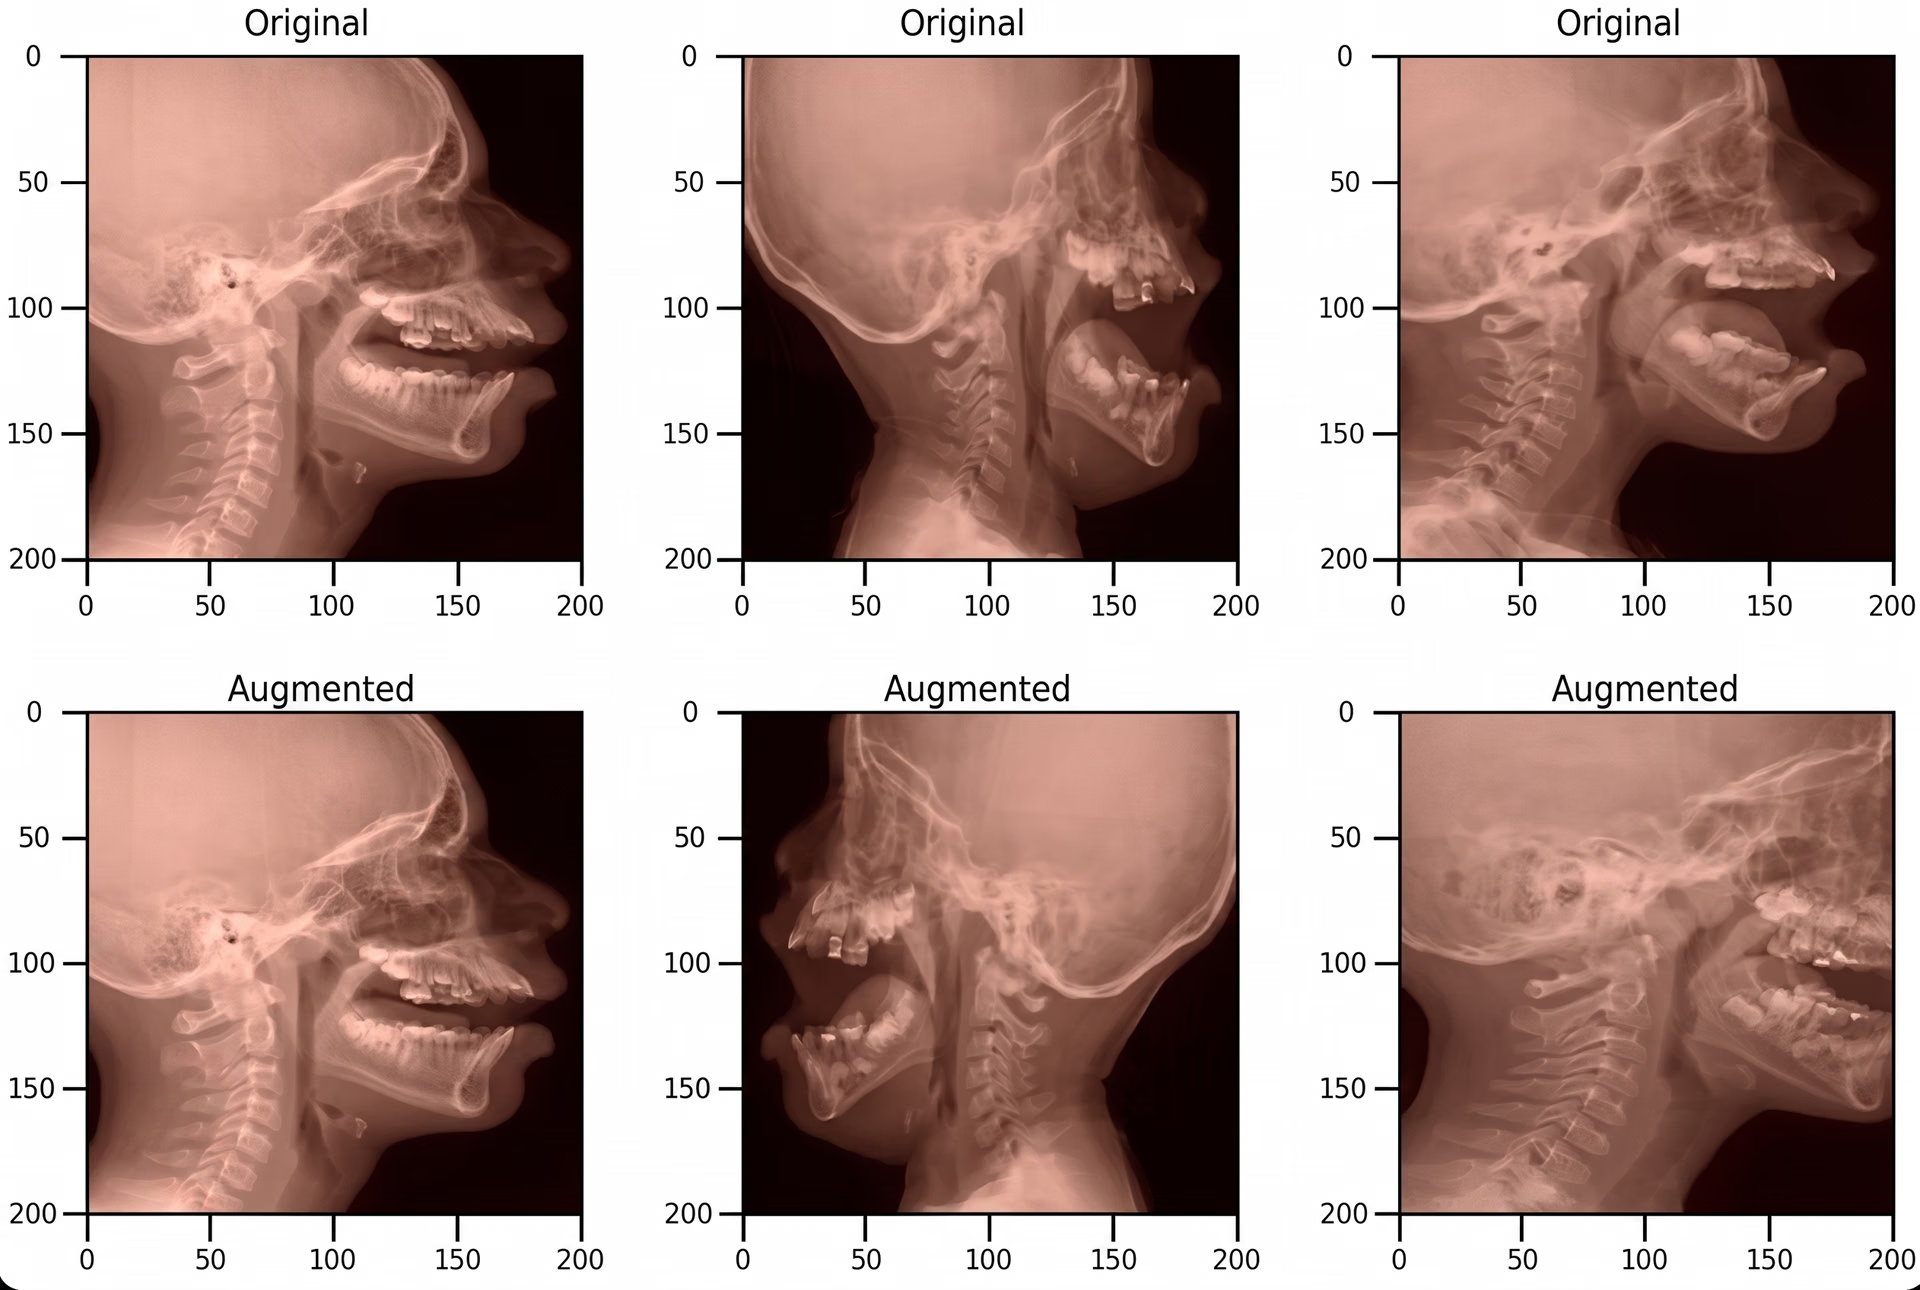
Hình 4. Hình ảnh y tế nhi khoa gốc và đã tăng cường (Nguồn)
Nhờ học từ những biến thể này, model tập trung vào các đặc trưng giải phẫu có ý nghĩa thay vì những khác biệt bề mặt. Điều này giúp kết quả phân đoạn ổn định hơn trên các ảnh quét và trường hợp bệnh nhân khác nhau.
Điểm chính cần ghi nhớ#
Việc thu thập dữ liệu đa dạng rất khó, nhưng tăng cường dữ liệu cho phép model học từ phạm vi điều kiện hình ảnh rộng hơn. Nhờ đó, model có độ bền vững cao hơn khi xử lý hiện tượng che khuất, thay đổi ánh sáng và cảnh đông đúc. Nhìn chung, điều này giúp model hoạt động đáng tin cậy hơn bên ngoài môi trường huấn luyện được kiểm soát.
Tham gia cộng đồng của chúng tôi và khám phá những cập nhật mới nhất về AI thị giác trên repository GitHub của chúng tôi. Truy cập các trang giải pháp để tìm hiểu cách những ứng dụng như AI trong sản xuất và thị giác máy tính trong y tế thúc đẩy tiến bộ, đồng thời xem các tùy chọn cấp phép để hỗ trợ giải pháp AI tiếp theo của bạn.









