最适合计算机视觉训练的合成数据工具
按方法比较计算机视觉合成数据工具:3D 仿真、生成模型和数据增强,以及如何使用 Ultralytics YOLO 测试它们。
 Miles Deans10 分钟阅读
最适合你的计算机视觉合成数据工具,取决于真实数据集缺少什么。3D 仿真工具(如 NVIDIA Isaac Sim 搭配 Omniverse Replicator,以及 BlenderProc)可以渲染带有标签的新场景。生成式工具(如 NVIDIA Cosmos 和 Ultralytics Platform 中的 Generate Similar Images 功能)可以为你已有的图像增加多样性。数据增强库(如 Albumentations)则会在训练期间转换真实图像。
无论选择哪种工具,都要用模型从未见过的真实图像来评估。在 Ultralytics 和 NVIDIA 对工业缺陷数据集进行的测试中,添加生成的缺陷后,Ultralytics YOLO26x 在 DAGM 类别上的 mAP75 提高了 0.11 至 0.32,但在 Real-IAD 上仅提高了 0.008(测试详情)。合成数据带来的收益因数据集和生成方式而异。
本指南按方法比较主要工具,说明每种工具能弥补什么数据缺口,并展示如何在决定使用合成数据前,先用 Ultralytics YOLO26 进行测试。如果你刚接触这个主题,可以先了解什么是合成数据以及它的用途。
生成合成训练数据的三种方法#
本指南将合成数据生成工具归纳为三种实用方法。这些方法解决的问题各不相同,因此建议先在同一种方法内比较工具。
| 方法 | 功能 | 标签 | 最适合 |
|---|---|---|---|
| 3D 仿真与渲染 | 利用 3D 资产构建场景、随机化场景并渲染图像 | 随图像一并生成(框、掩码、深度等) | 可用 3D 建模的物体、地点或传感器;机器人;罕见或危险情境 |
| 生成式图像模型 | 根据图像、提示词或仿真输入创建新图像 | 不一定:生成的图像需要重新标注,或者需要对照生成结果检查源标签 | 增加视觉多样性(光照、背景、天气)和罕见外观 |
| 数据增强 | 在训练期间转换真实图像(翻转、颜色、马赛克、复制粘贴) | 现有标签会随图像一起转换 | 充分利用你已有的图像 |
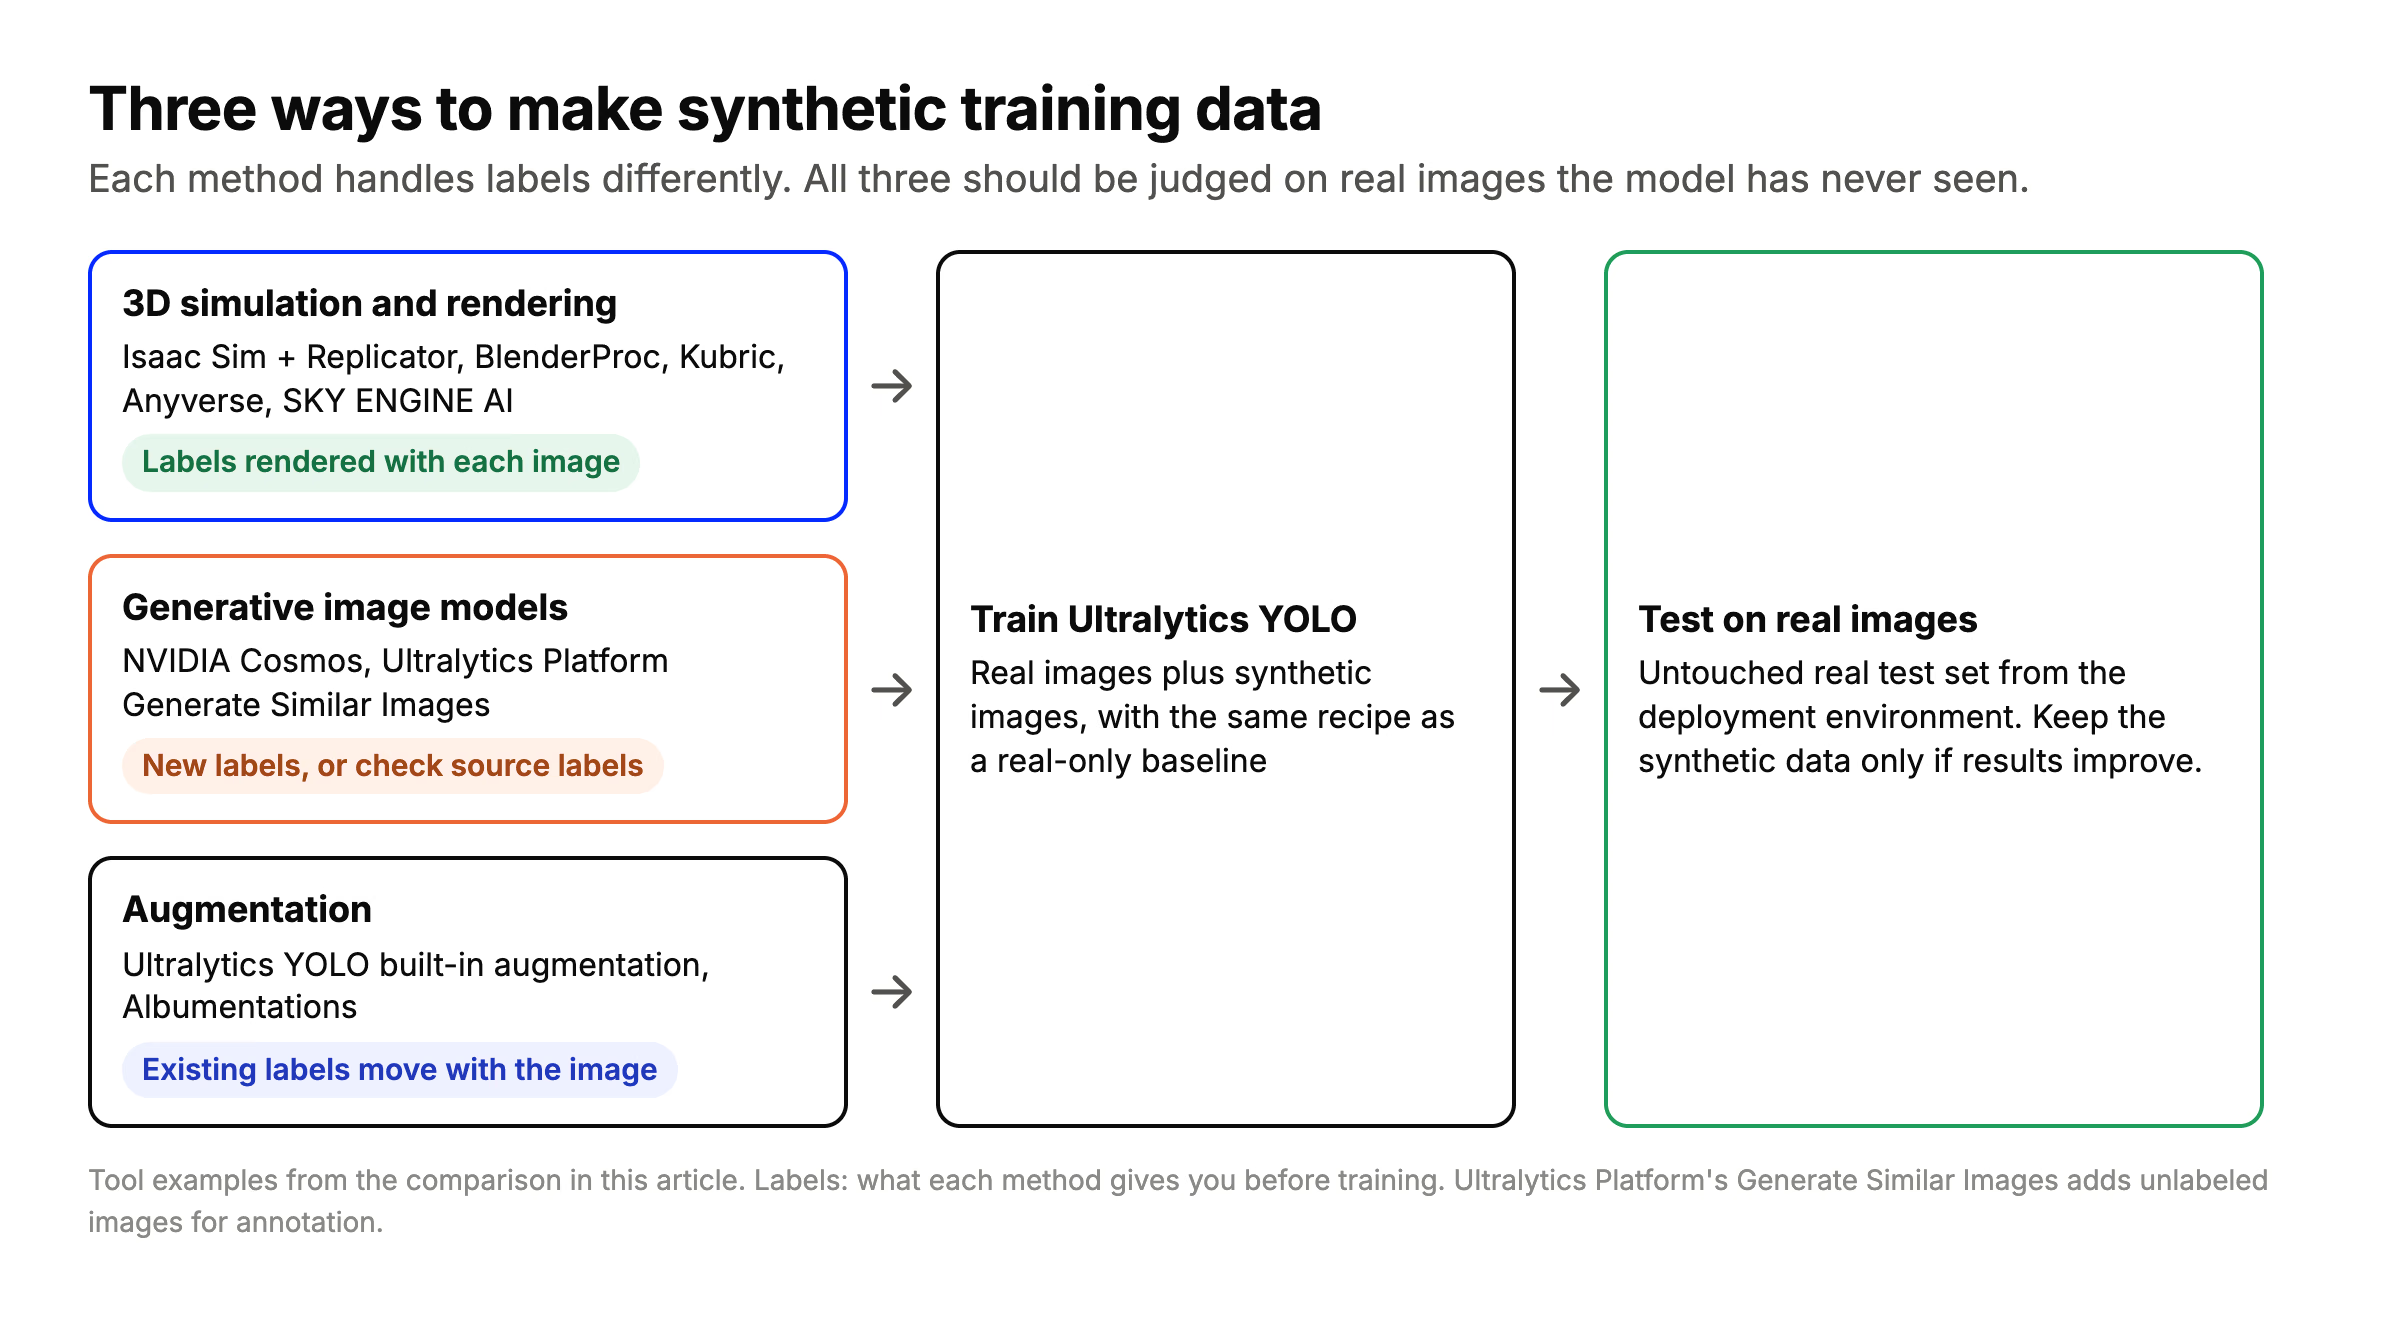
每种方法处理标签的方式各不相同,而且三种方法都应使用模型从未见过的真实图像来评估。
合成数据和数据增强有重叠之处:两者都会增加你未采集的训练样本。实际区别在于新图像的来源。数据增强会变换你已有的图像,而仿真和生成模型则能让模型看到数据集中完全不存在的内容。
合成数据工具对比#
工具按字母顺序排列;每一行的信息均在 2026 年 11 月对照工具官网或代码仓库进行了核实。
| 工具 | 方法 | 包含标签 | 运行方式 | 最适用场景 |
|---|---|---|---|---|
| Albumentations | 数据增强 | 是,标签会随图像一起变换 | Python 库。AlbumentationsX 采用 AGPL-3.0 或商业许可;原 MIT 版本已停止维护 | 让你已有的图像更多样 |
| Anyverse | 基于物理的仿真 | 是,提供特定于传感器的输出 | 云平台 | 驾驶、车内监控和国防;RGB-IR、NIR、激光雷达、雷达和热成像 |
| BlenderProc | 在 Blender 中进行 3D 渲染 | 是:深度、法线、分割、COCO 和 BOP 标注 | 开源(GPL-3.0),自托管 | 使用自有 3D 资产进行物体姿态估计、机器人和研究 |
| Duality AI Falcon | 数字孪生仿真(基于 Unreal Engine 的编辑器) | 请与供应商确认格式 | 云端工作流,支持 Python API 和 ROS/ROS 2 | 航空、反无人机系统和越野自动驾驶 |
| Kubric | 3D 渲染与物理仿真(Blender、PyBullet) | 是:实例掩码、深度、光流 | 开源(Apache-2.0),自托管;面向 Blender 2.93 | 研究和多物体视频 |
| NVIDIA Cosmos | 以深度、分割或边缘图为条件的生成式世界模型 | 不保证:请对照生成的物体检查源标签,并在需要时修正或重新生成 | 在 NVIDIA GPU 上自托管;Cosmos 3 代码和模型采用 OpenMDW-1.1 许可,较早版本采用不同许可 | 让仿真或真实场景呈现更多样、更逼真的效果 |
| NVIDIA Isaac Sim 和 Omniverse Replicator | 基于 OpenUSD 场景进行 3D 仿真 | 是:通过 Replicator 标注器生成框、分割、深度和法线 | 自托管;代码仓库采用 Apache 2.0 许可,而 Omniverse Kit 和其他 NVIDIA 组件则适用单独的许可条款 | 机器人、仓库和工业场景 |
| Parallel Domain | 根据真实驾驶或飞行日志进行重建,并支持传感器仿真 | 请与供应商确认格式 | 可接入现有 CI 流水线的 API | 汽车、无人机、机器人、卡车运输和国防;摄像头、激光雷达和雷达 |
| Rendered.ai | 基于物理的仿真平台 | 是:图像创建时即按你选择的标注格式完成标注 | 平台即服务,每月 5,000 美元起,另提供托管服务 | 地球观测和非可见光传感器:SAR、红外、多光谱、X 射线 |
| SKY ENGINE AI | 基于光线追踪的合成数据云平台 | 是:框、语义掩码、3D 关键点、深度图和法线图 | 云端 | 车内、机器人、制造、医学成像和无人机 |
| Ultralytics Platform(Generate Similar Images) | 基于你的某张图像生成多种视觉变化 | 否。图像会以未标注状态添加,然后在 Platform 中进行标注 | 在浏览器中使用;托管模型免费,付费提供商模型的费用由你自己的 API 密钥承担 | 围绕真实图像增加多样性,并保持在同一标注和训练工作流中 |
| Unity Perception | 在 Unity 中进行 3D 仿真 | 是,通过标注器实现(输出 SOLO 格式,可转换为 COCO) | 已停止开发,Unity 不再提供支持 | 仅适用于现有 Unity 项目 |
Ultralytics Platform 不是 3D 仿真工具。Generate Similar Images 会根据你的图像构思新场景,并为每个场景生成一张图像;使用的模型为 Ultralytics Image 4B(默认)或 Ultralytics Image 6B。新图像与源图像具有相同的主体和风格,但不会附带标签,因此你需要在训练前为其添加标注。如果你需要为可在 3D 中建模的物体生成像素级精准标签,仿真工具会是更好的选择。
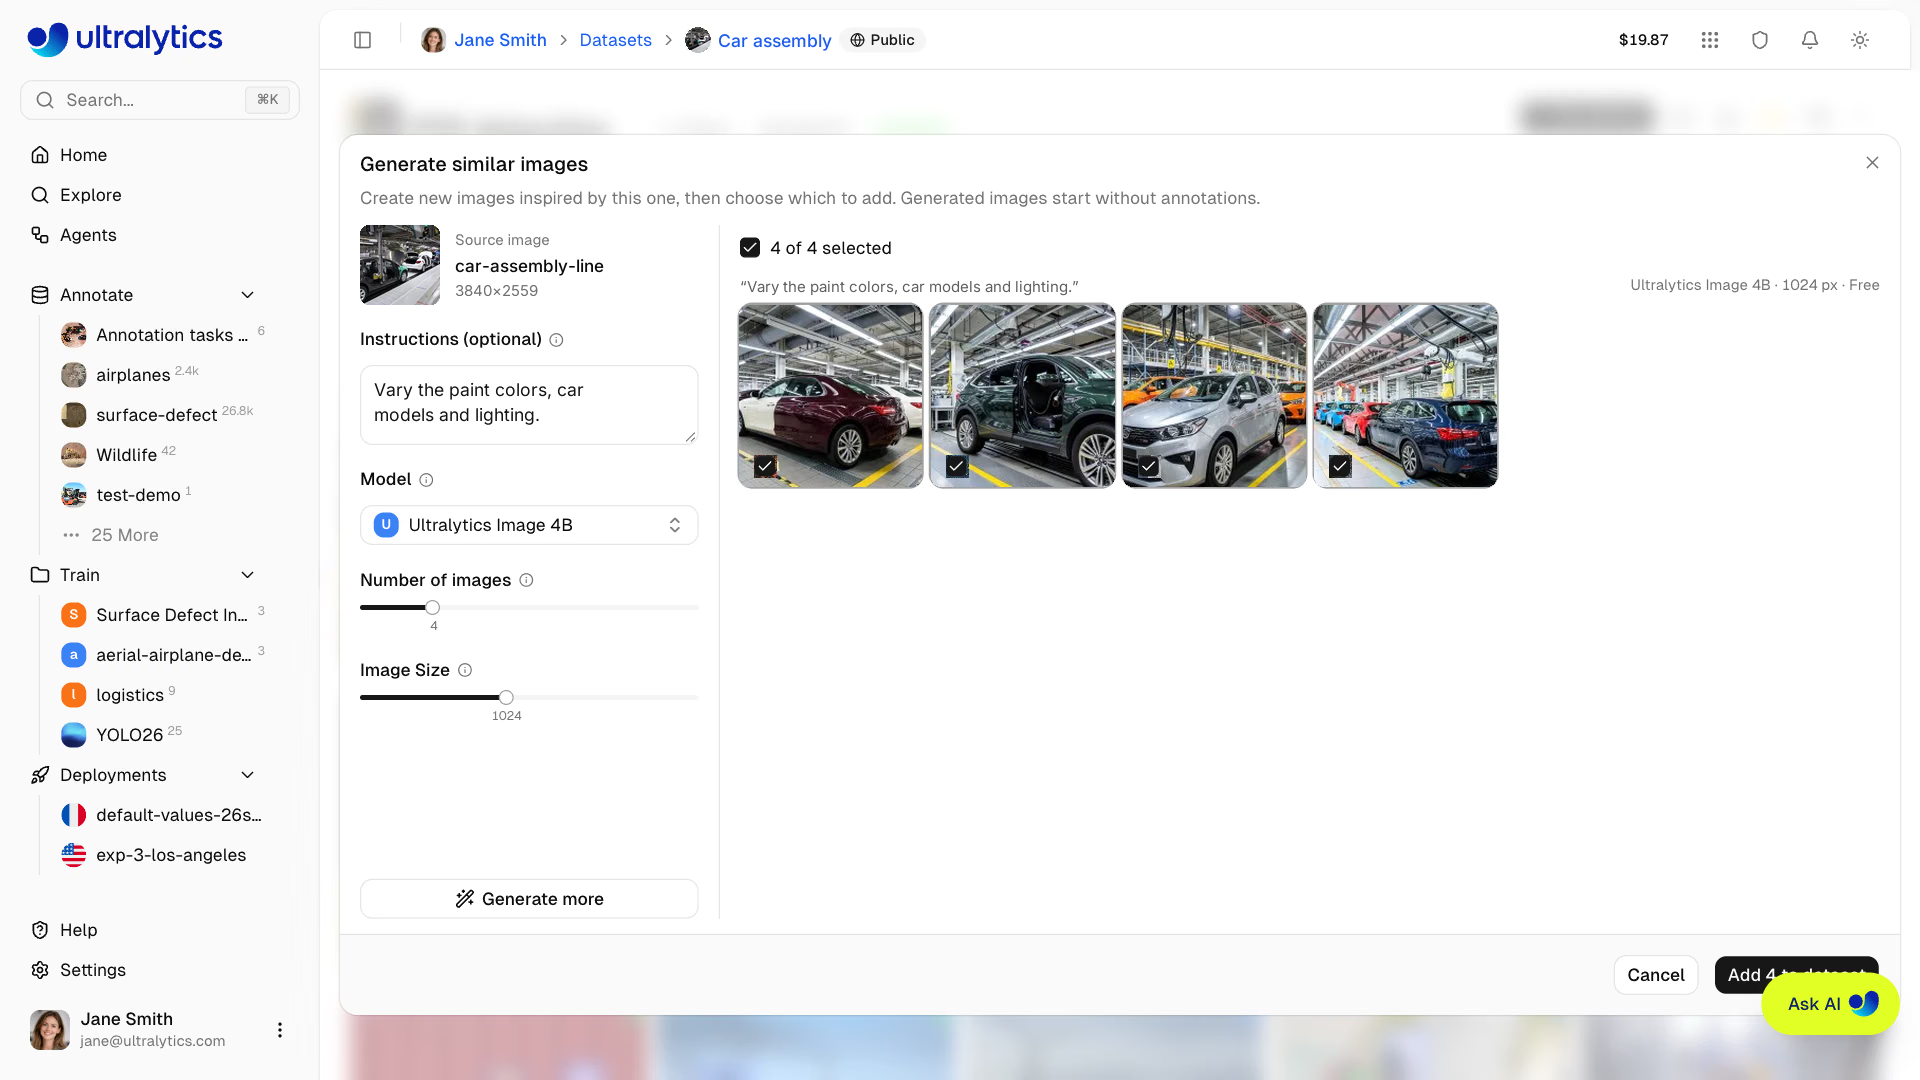
Ultralytics Platform 中 生成相似图像 功能的示意性合成图,展示了使用免费的 Ultralytics Image 4B 模型生成的四张实际输出图像。源照片:001 汽车工厂装配线 - 波兰格利维采的欧宝工厂,Marek Ślusarczyk (Tupungato),CC BY 3.0。图中展示的是 AI 生成的改编图像。
如何选择合成数据工具#
从数据缺口出发,而不是从工具出发。以下是最常见的数据缺口及适用工具。
罕见缺陷和异常#
罕见缺陷类型的真实样本往往难以采集。以下两种方法值得测试:
- 在真实图像上生成缺陷。在 Ultralytics 和 NVIDIA 的测试中,NVIDIA Cosmos Data Factory 生成了缺陷图像并自动完成标注,然后将这些图像加入真实训练图像。已发布的报告称,在其合成数据测试中,所有数据集的召回率均有所提高。目前,Cosmos 生成步骤仅作为示例和演示提供,并非已发布的集成方案。
- 复制粘贴数据增强。对于使用多边形标签进行的分割或 OBB 训练,启用
copy_paste,即可在图像内部或不同图像之间复制物体,从而提高罕见类别出现的频率。默认情况下,此功能处于关闭状态。
请参阅制造业中的计算机视觉,了解缺陷检测在生产线中的应用。
机器人、仓库和抓取放置#
如果你能在 3D 中对物体和空间建模,仿真就能为每张图像生成标注,并让你在不同渲染中改变姿态、光照和杂乱程度,这称为域随机化。你可以考虑使用 NVIDIA Isaac Sim 和 Omniverse Replicator,在 NVIDIA 硬件上进行机器人仿真;也可以使用 BlenderProc,从现有 3D 模型进行脚本化渲染。了解更多关于机器人计算机视觉的信息。
驾驶、无人机与多传感器系统#
对于摄像头、激光雷达和雷达仿真,或闭环测试,可以考虑专为多传感器自主系统打造的平台。Parallel Domain 根据真实驾驶和飞行日志构建重建场景。Anyverse 可模拟驾驶、车内和国防应用中的特定传感器输出。Duality AI Falcon 专注于空中和越野自主系统。
卫星、SAR 与其他非可见光传感器#
Rendered.ai 列出了 SAR、红外、热成像、多光谱、高光谱和 X 射线仿真。Anyverse 列出了近红外和热成像输出。
需要增加多样性的小型数据集#
先使用能反映模型实际使用环境的增强方法,因为这样可以保留标签。对于检测训练,Ultralytics YOLO 默认启用马赛克、颜色变化、缩放、平移和水平翻转,你还可以添加自己的 Albumentations 变换。如果增强无法覆盖你无法拍摄的环境条件,例如其他光照、背景或视角,可以根据场景和标注方式测试生成式变化或仿真。
如何测试合成数据是否有帮助#
只有当模型在真实图像上的表现更好时,合成数据才有价值。用相同实验运行两次,只更改训练图像:
- 保留真实测试图像。保留一组来自模型实际运行环境的真实图像作为测试集,绝不要向其中加入合成图像。
- 仅使用真实图像训练基线模型。
- 再次使用真实图像加合成图像进行训练,模型、轮数、优化器和随机种子都保持一致。
- 根据真实验证图像选择方案。如果尝试了几种合成数据用量,请使用真实验证图像进行比较。然后只在未触碰过的真实测试集上评估基线模型和你选定的方案。查看 mAP50-95 和召回率;如果边界框精度很重要,也要查看 mAP75。
使用 Ultralytics YOLO 时,训练划分可以列出多个文件夹,因此真实图像和合成图像在磁盘上仍保持分开。以相同方式创建 real.yaml,并将 train 仅设为 images/train_real。将近重复图像和来自同一场景的图像放在同一个划分中,并且只根据训练图像生成合成图像:
# real_plus_synthetic.yaml
path: datasets/defects
train: [images/train_real, images/train_synthetic] # real + synthetic training images
val: images/val_real # real images only
test: images/test_real # real images only, never seen in training
names:
  0: scratch
  1: dent
from ultralytics import YOLO
runs = {}
for name, data in [("real only", "real.yaml"), ("real + synthetic", "real_plus_synthetic.yaml")]:
model = YOLO("yolo26n.pt")
model.train( # same recipe for both runs
data=data, epochs=100, imgsz=640, batch=16,
optimizer="AdamW", lr0=0.001, seed=0,
)
runs[name] = model.trainer.best # path to the best weights
for name, weights in runs.items():
metrics = YOLO(weights).val(data="real_plus_synthetic.yaml", split="test") # same real test set
print(f"{name}: mAP50-95 {metrics.box.map:.3f}, mAP75 {metrics.box.map75:.3f}")此处比较的是有无合成图像时采用相同训练方案的结果,并在同一组真实测试图像上评分。轮数相同时,较大的数据集会获得更多训练步数,因此请使用几个随机种子重复实验,再判断较小的差异是否可信。请参阅 Train 和 Val 文档,了解所有设置;如需解读结果,请参阅模型评估见解。
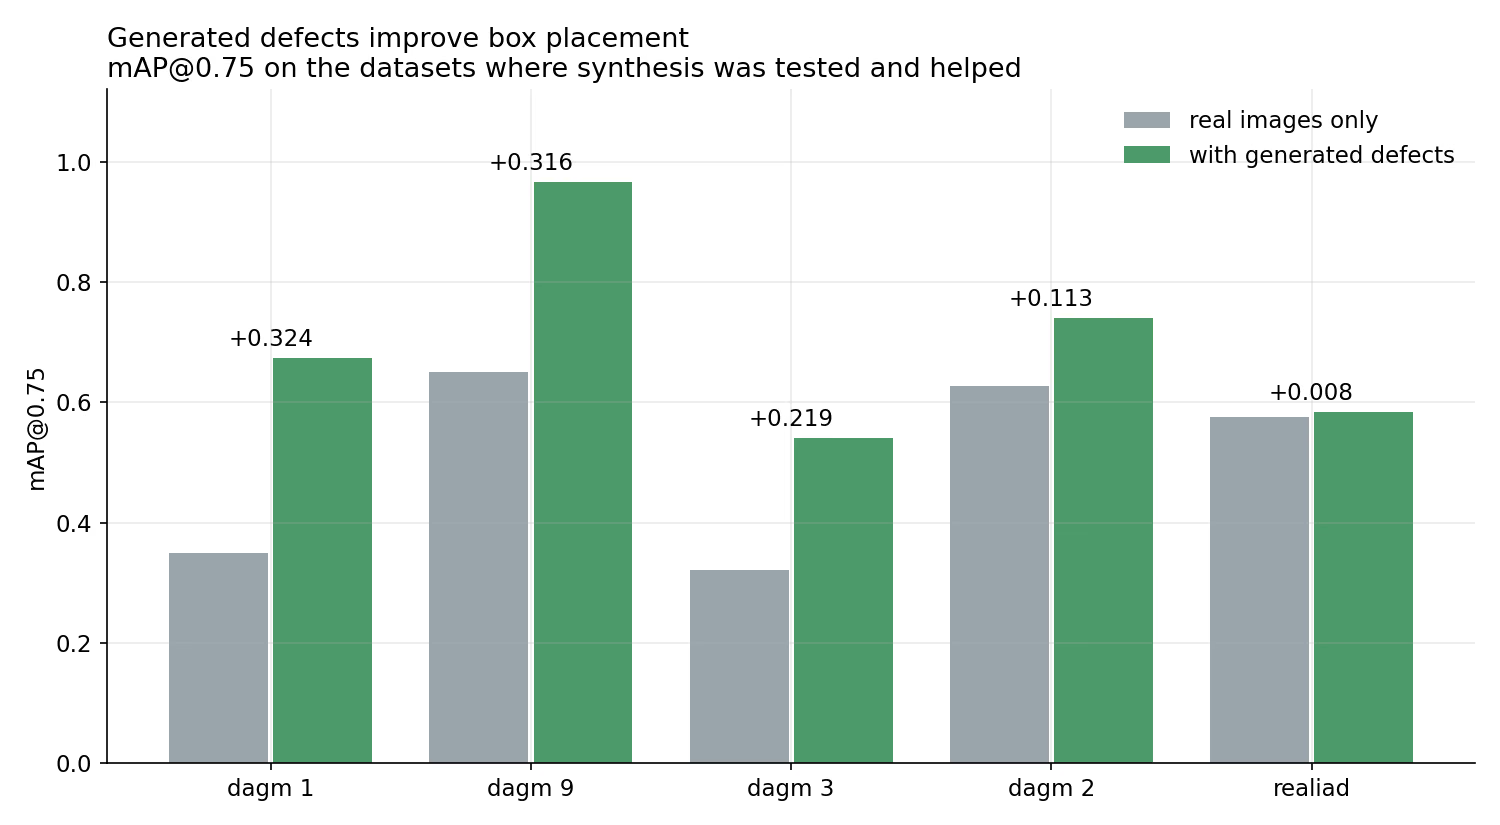
在合成数据经过测试且带来提升的数据集上,仅使用真实图像与使用生成缺陷时的 mAP75,数据来自 Ultralytics 与 NVIDIA 的测试。
Ultralytics 的测量结果#
- 生成缺陷(Ultralytics 与 NVIDIA 的测试)。在带有多边形标注的工业检测数据集上,将使用真实图像加 NVIDIA Cosmos Data Factory 生成的缺陷训练的 Ultralytics YOLO26x,与仅使用真实图像训练的同一模型进行比较。在 DAGM 各类别上,mAP75 提升了 0.11 到 0.32;例如,在 DAGM 第 9 类上,mAP75 从 0.650 升至 0.966。在 Real-IAD 上,提升幅度为 0.008。两个模型使用了相同的训练方案和相同的留出测试集(完整结果)。
- 合成深度数据。YOLO26 深度模型使用约 219 万张图像的混合数据进行预训练,其中包含 Hypersim 等合成数据集。Hypersim 从渲染场景中提供稠密深度真值,并屏蔽窗户和天空等无效像素。合成数据用于补充噪声较大的真实世界传感器数据,而非取而代之。
- 开放数据集中的生成图像。Ultralytics Construction-PPE结合了人工采集和生成的图像:1,000 张图像、12 个类别,以 CC BY 4.0 许可发布。该数据集没有单独的测试划分,其文档建议使用来自你自己的部署环境的独立图像进行评估。
应该添加多少合成数据#
没有通用的比例,因此应将其视为一个需要测试的设置。在 Ultralytics 与 NVIDIA 的测试中,合成图像数量上限分别设为真实训练图像的 25% 或 100%,也就是每四张真实图像对应一张合成图像,或真实与合成图像一比一。在生成的 11,448 张图像中,最终只保留了 1,481 张。从较小比例开始,根据真实验证图像选择比例,并保留未触碰过的真实测试集用于最终比较。
Ultralytics 的适用范围#
Ultralytics 不销售 3D 仿真引擎,而是涵盖合成数据相关的步骤:
- 训练并比较。Ultralytics YOLO 可以使用任何真实与合成图像混合数据进行训练,图像采用 YOLO 格式,可在你自己的硬件上训练,也可使用 Ultralytics Platform 上的云 GPU 训练。
- 为真实图像增加变化。Ultralytics Platform 中的“生成相似图像”功能每批最多可生成一张图像的 16 种变化,并支持添加“改变光照”或“添加雨水”等可选指令。
- 为生成的图像添加标注。Ultralytics Platform 中的智能标注使用 SAM 3.1、YOLO 和 YOLOE 为新图像添加标注,也支持对整个数据集进行批量标注。
- 默认进行增强。Ultralytics YOLO 训练包含内置增强,并支持自定义 Albumentations 变换。
常见问题
BlenderProc(GPL-3.0)和 Kubric(Apache-2.0)是开源工具,可在 Blender 中根据 3D 场景生成带标注的图像。NVIDIA Isaac Sim 和 Omniverse Replicator 是机器人领域的另一个选择;其 Omniverse 依赖项采用单独的许可条款。如果没有 3D 资产但需要增加多样性,数据增强免费提供,并且已内置于 Ultralytics YOLO 训练中。
无论如何,都要保留真实数据用于评估。对于训练,在决定合成图像能否取代任何真实样本之前,先比较仅用真实数据、仅用合成数据以及混合数据集。在 Ultralytics 与 NVIDIA 的缺陷测试中,生成缺陷带来的提升从 DAGM 各类别上的显著提升到 Real-IAD 上的微小提升不等,因此请在你自己的数据上进行测量。
进行测试。Ultralytics 与 NVIDIA 的测试将合成图像数量上限设为真实训练图像的 25% 或 100%。先从较小比例开始,根据真实验证图像选择比例,并保留单独的真实测试集用于最终检查。
这取决于所用方法。3D 仿真工具会为每张图像生成标签。增强变换会转换现有标签。即使生成式工具以现有场景为起点,也需要检查标签,因为物体可能会改变形状或位置。Ultralytics Platform 中的“生成相似图像”功能会添加无标签图像,你需要在训练前为其添加标注。
根据 Unity 的 GitHub 仓库,Unity 已停止 Perception 软件包的开发,不再提供支持。2023 年 8 月,Calcalist 报道称,合成数据公司 Datagen 在裁掉几乎所有剩余员工后濒临倒闭。如果你今天正在选择工具,请确认它仍在维护中。
两者有所重叠,但并不相同。数据增强会转换已有图像,例如翻转、重新着色或组合图像。合成数据则通过渲染 3D 场景或使用生成模型来创建新图像。两者可以结合使用:通过数据增强应对日常变化,通过合成数据填补特定缺口。
作者
评论
提出问题、分享你的结果,或帮助其他人。









