深入了解计算机视觉中的监督学习与无监督学习
了解计算机视觉中监督学习与无监督学习的区别,以及如何根据数据和项目目标选择合适的方法。
人工智能 (AI) 的核心理念是教会机器以类似人类智能的方式学习和推理。就像人们通过不同方式学习一样,例如直接接受指导,或观察规律和经验,AI 和机器学习系统也被设计为采用这些相同的方法。
具体来说,在机器学习算法中,系统通过数据进行训练和学习,而不是针对每项任务都进行明确编程。机器学习模型不依赖固定规则,而是识别数据中的规律,并利用这些规律进行预测或决策。
例如,计算机视觉是 AI 和机器学习的一个分支,专注于让系统能够解读和理解图像、视频等视觉信息。从识别物体到发现大型数据集中的隐藏规律,这些系统的能力在很大程度上取决于训练方式。
根据可用数据的类型和要解决的问题,可以采用各种 AI 学习技术来训练这些系统。
一些计算机视觉模型从带标签的数据中学习:每个输入都配有正确答案,也就是说,每张图像或每个数据点都有一个预定义标签,说明它代表什么。这样,模型就能学习输入与预期输出之间的关系,从而提升对新的、未见过的数据做出准确预测的能力。
其他视觉模型则从无标签数据中学习。由于没有预先提供答案,它们会专注于识别数据本身的规律和关系。这两种方法分别称为监督学习和无监督学习,是许多前沿计算机视觉系统的基础。
本文将介绍监督学习和无监督学习、它们在计算机视觉中的应用,以及如何为你的视觉 AI 项目选择最合适的方法。现在就开始吧!
AI 学习方法如何为计算机视觉提供支持#
你可以把人工智能想象成一把大伞,涵盖了多种技术,让机器能够执行通常需要人类智能的任务。在这把大伞下,机器学习是一个关键领域,它让系统能够从数据中学习,而不只是依赖固定规则。
在机器学习中,不同的学习技术决定了模型如何学习并随时间改进。监督学习(从带有正确答案的已标注数据中学习)、无监督学习(识别无标签数据中的规律)、强化学习(通过反馈或奖励进行试错学习)和半监督学习(结合少量已标注数据与大量无标签数据)等方法,决定了系统如何处理输入数据并生成输出数据。
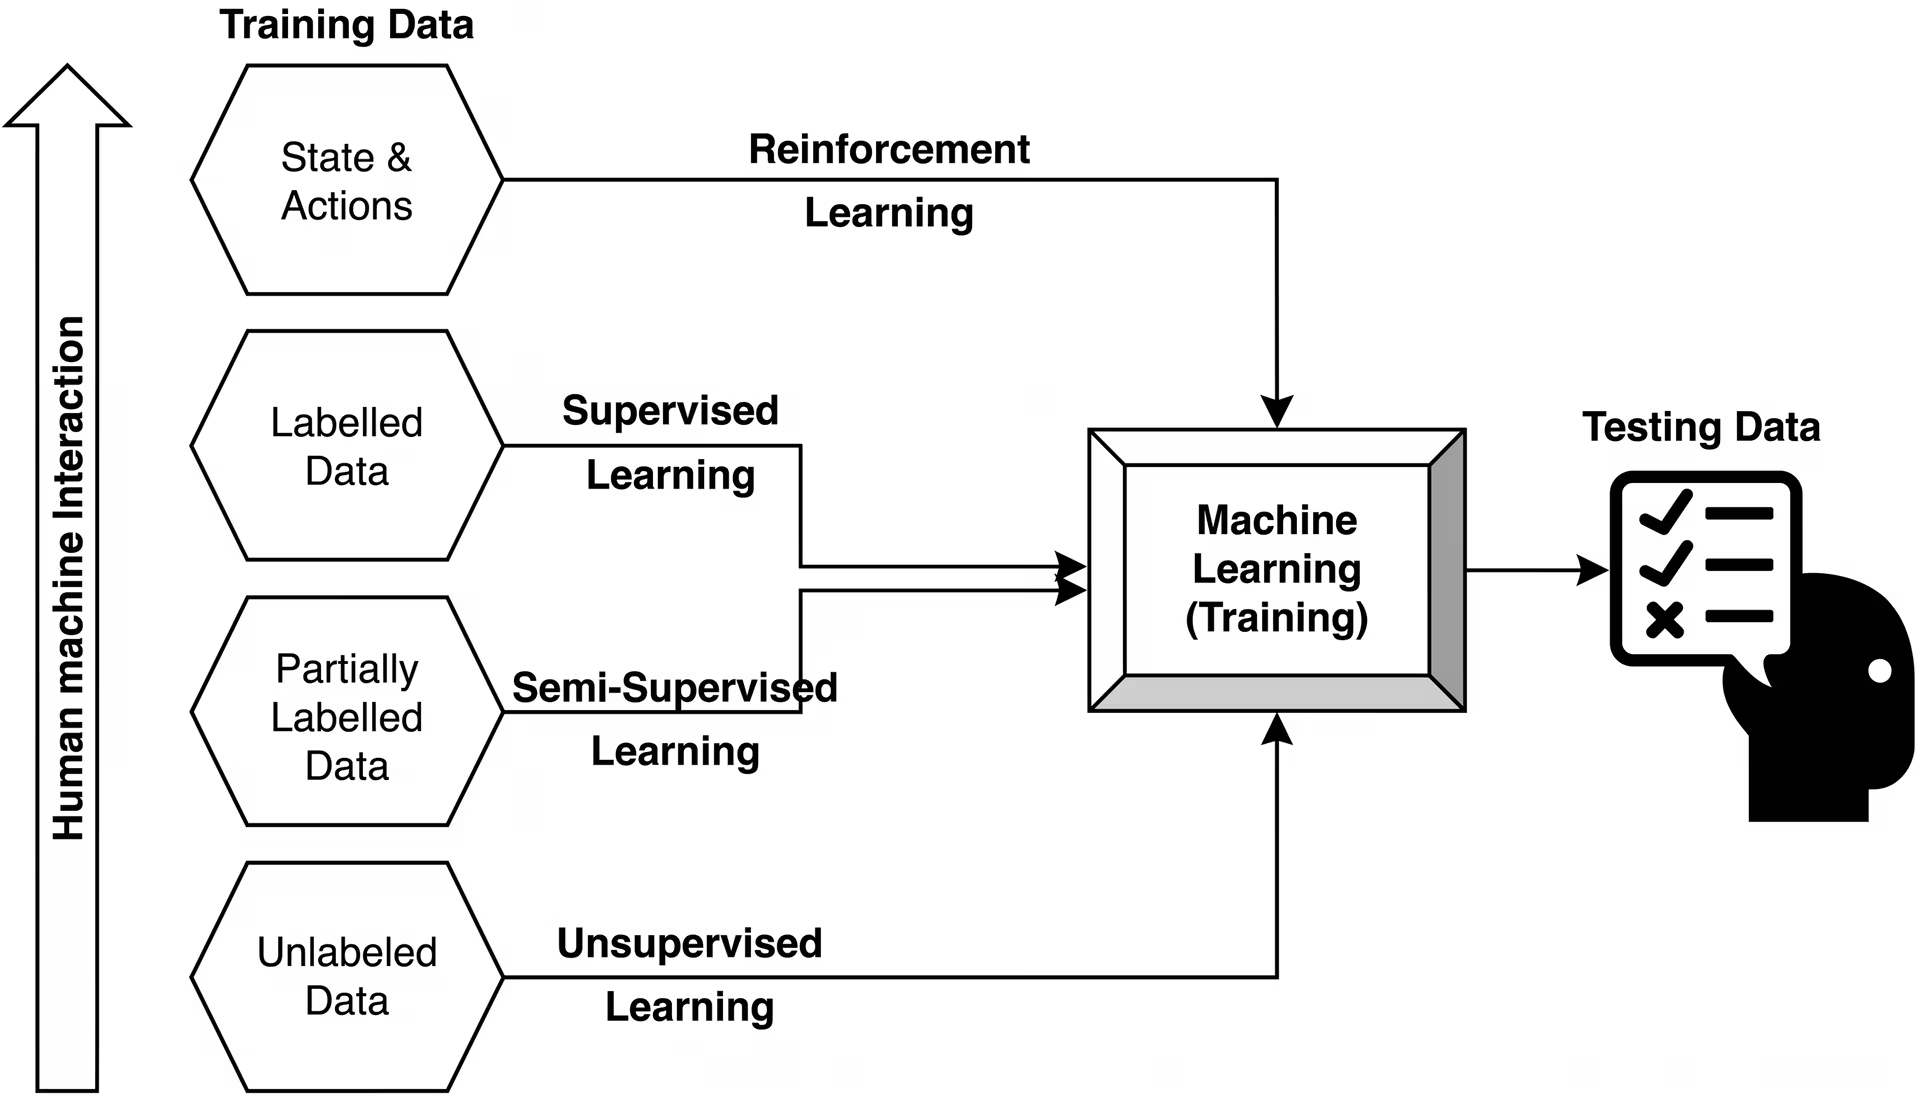
图 1. AI 学习方法概览(来源)
具体来说,计算机视觉系统采用这些学习方法来解读和理解视觉数据。监督学习是最常用的方法,因为它能让模型从明确标注的示例中学习,并产出准确、可靠的结果。
例如,可以使用标注为“猫”和“狗”的图像训练模型,让模型学习形状、耳朵和面部结构等特征,从而利用分类算法正确分类新图像。同时,计算机视觉也会用到无监督学习和半监督学习,通常用于探索数据中的规律,或在标注数据有限时提升性能。
了解监督学习模型在计算机视觉中的应用#
你可以把监督学习算法比作课堂教学:老师提供示例和正确答案,让学生学会辨别对错。在机器学习中,模型也以类似方式从带标签的数据中学习,每个输入都配有已知输出。
假设你正在构建一个用于自动分析棒球比赛的计算机视觉系统。你可以使用标注了球、球棒和球员等物体的图像或视频帧来训练类似 Ultralytics YOLO26 的模型。
每个物体都会标注其位置和类别,让模型学会要查找的目标。随着时间推移,模型能够在新视频中检测并定位这些物体,支持跨帧追踪球和检测球员等应用。
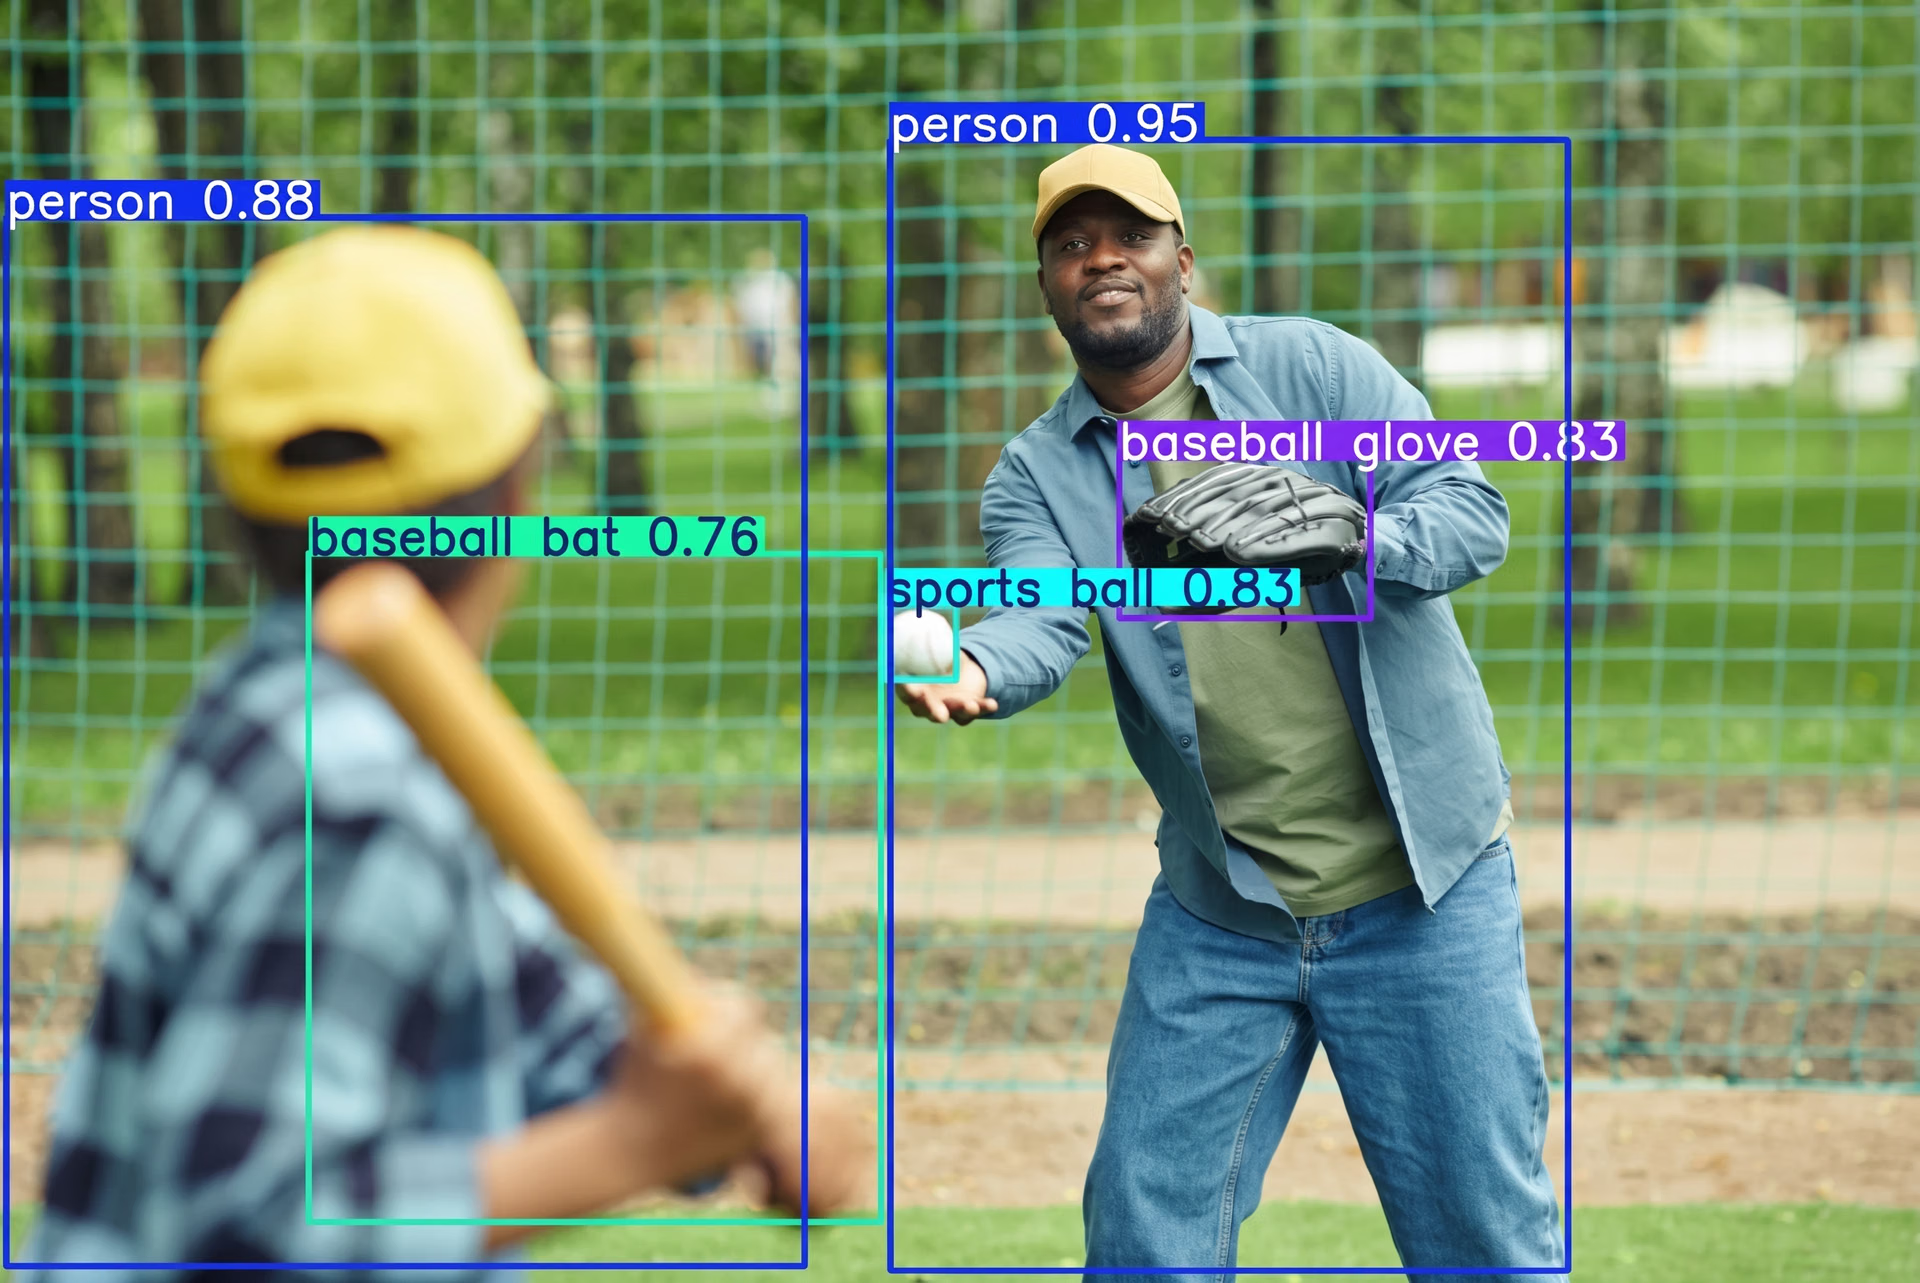
图 2. 监督学习实现目标检测的示例(来源)
除了目标检测,监督学习还广泛应用于多种计算机视觉任务,例如图像分类、实例分割和姿态估计,这些任务都对准确性和一致性有较高要求。在每项任务中,模型都会从带标签的数据中学习,以识别特定规律,并对新的输入做出可靠预测。
这些模型通常采用深度学习构建。深度学习是一种利用神经网络直接从数据中学习规律的机器学习方法。神经网络的设计方式在一定程度上受到人脑工作机制的启发,因此模型能够从大型数据集中学习复杂的视觉特征。
早期的计算机视觉方法通常依赖人工设计的特征,并结合支持向量机(SVMs 是通过寻找类别之间最佳边界来分类数据的模型)或决策树(通过将数据拆分成分支来做出决策的模型)等算法。
相比之下,如今的计算机视觉模型利用深度学习自动从数据中学习这些特征,因此更擅长处理大规模、高精细度的视觉任务。
了解视觉 AI 为何需要无监督学习模型#
虽然监督学习是计算机视觉中的首选方法,但有些视觉应用没有可用的标注数据,或者创建标注数据的成本和时间都太高。
在这些情况下,无监督学习算法可以作为一种实用的替代方案。假设你有大量来自野生动物相机的无标签照片。
这些图像没有标签来说明各自的内容,但你仍希望整理或理解这些数据。无监督模型可以分析图像并将相似图像归为一组,把外形相似的动物分成不同簇,即使模型不知道它们的确切标签也能做到。
无监督学习在计算机视觉中的工作原理#
那么,无监督机器学习是如何工作的?模型不是从正确答案中学习,而是自行识别数据中的规律和结构。它会查找数据之间的相似点和差异,而不依赖带标签的示例。
一种常见的应用是异常检测:模型先学习正常数据的特征,再识别任何偏离正常情况的内容。异常和离群点检测是影响深远的工业应用之一。例如,在生产线上发现有缺陷的物品、标记出需要放射科医生复查的异常医学扫描图像,或检测监控视频中的可疑活动。由于缺陷和异常通常罕见且种类繁多,给所有可能的情况标注数据并不现实,因此无监督方法很适合这类任务。
为此,通常会使用聚类和降维等技术,处理的往往是从图像中提取的特征,而不是图像原始数据本身。k-means 聚类等聚类方法会根据共同规律将相似图像归为一组;主成分分析 (PCA) 等降维技术则通过聚焦最重要的特征来简化数据。
这让模型更容易在大型复杂数据集中识别有意义的规律和结构。无监督学习的主要优势是能够有效处理无标签数据,并揭示不易察觉的规律。不过,与监督学习相比,无监督学习更难评估,对最终输出的控制也更少。
计算机视觉中的自监督学习和半监督学习#
在了解监督学习和无监督学习时,你可能会想:两者之间是否存在折中方案?有意思的是,自监督学习和半监督学习正好弥合了监督学习与无监督学习之间的差距。
这些方法让模型能够更有效地从无标签数据中学习。它们不只依赖带标签的示例,而是根据数据创建自己的学习任务,或将少量已标注数据与较大规模的无标签数据结合起来。
在自监督学习中,模型通过解决从数据本身创建的任务来学习。例如,可以给模型一张缺失部分内容的图像,让模型预测缺失区域应该是什么;也可以让模型学习识别同一物体的不同视角。这样,模型无需人工标注也能学到有用的特征。
另一方面,在半监督学习中,会将少量带标签的数据与更多无标签数据结合使用,以提升性能。在某些情况下,模型可以为无标签数据生成标签,并利用这些标签继续学习。
这些方法的主要优势是减少了对大型标注数据集的需求,而这类数据集通常成本高、制作耗时。不过,与完全监督的方法相比,这些方法的设计和评估可能更复杂。
监督学习与无监督学习的主要区别#
监督学习与无监督学习的区别,归根结底在于模型如何学习,以及模型的目标是什么。监督学习依赖带标签的数据和明确指导来学习特定任务;无监督学习则无需预先提供答案,而是专注于发现数据中的规律和结构。
例如,在交通监控系统中,可以使用带标签的图像训练监督学习模型,以检测车辆、行人或交通信号灯。相比之下,无监督模型可以分析大量视频片段,对相似的交通模式进行分组,或识别意外拥堵、异常移动等异常事件,而无需明确告知模型要查找什么。
何时在计算机视觉中使用监督学习#
如果计算机视觉任务的目标明确,并且需要模型将输入数据映射为准确输出,那么监督学习是很好的选择。尤其是在你拥有可靠的标注数据集,并且需要稳定、可预测的结果时,监督学习效果很好。
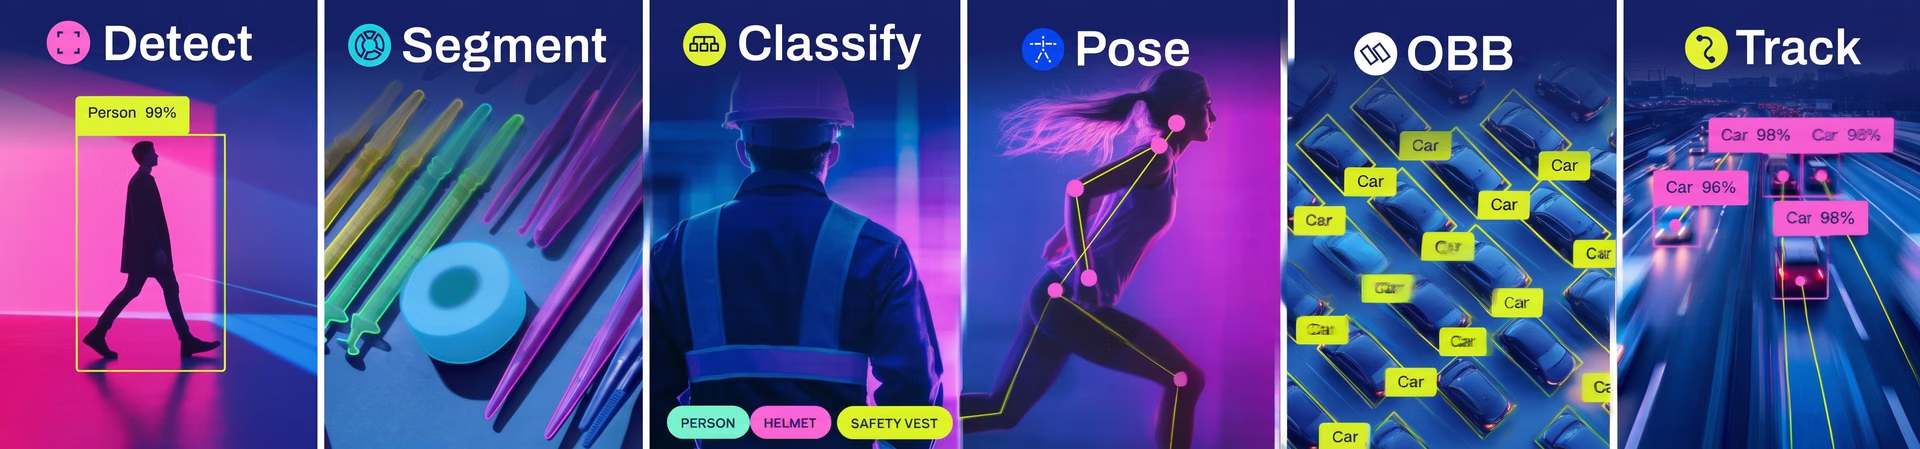
图 3. 由监督学习驱动的计算机视觉任务(来源)
它常用于模型必须区分已知类别或预测特定结果的问题。重点不是探索规律,而是从带标签的数据中学习精确的关系,让你更容易引导模型实现预期结果。
另一个重要优势是可控性。借助监督学习,你可以使用明确的指标更轻松地衡量性能、微调模型,并确保模型在部署期间稳定运行。因此,监督学习非常适合需要长期保持一致性和可靠性的系统。
不过,这也伴随着取舍。模型高度依赖标注数据的质量和规模,而收集和标注这类数据可能非常耗时。
监督式计算机视觉的实际应用示例#
像 Ultralytics YOLO models 这样的视觉 AI 模型利用监督学习执行目标检测等任务,并实现高准确率,尤其适用于实时应用。以下是一些监督学习发挥重要作用的常见视觉 AI 实际应用:
- 医疗保健和医学影像: 医生可以使用基于带标签扫描图像(如 X 光片或 MRI)的计算机视觉系统,通过分类器识别肿瘤或骨折等疾病,从而帮助更快、更准确地诊断。
- 工业质量检测: 在制造环境中,基于带标签数据训练的视觉系统可以分析多个质量相关特征来检查产品,例如形状、表面缺陷、纹理和尺寸。通过学习合格产品和缺陷产品的示例,这些系统可以持续识别故障并维持生产标准。
- 自动驾驶: 自动驾驶系统依赖基于带标签驾驶数据训练的模型来识别车道、车辆、行人和交通标志,帮助车辆实时安全行驶。
- 零售和结账系统: 商店使用基于带标签商品图像训练的模型来识别货架或收银台上的商品,从而实现自动结账并提高库存管理效率。将这些系统与其他数据结合使用,还可以支持客户细分等任务,帮助企业更好地了解购物模式。
- 农业和作物监测: 农民可以使用基于带标签图像训练的模型来检测和分类作物,例如识别并统计健康和受损的土豆,从而改进质量控制并减少损失。
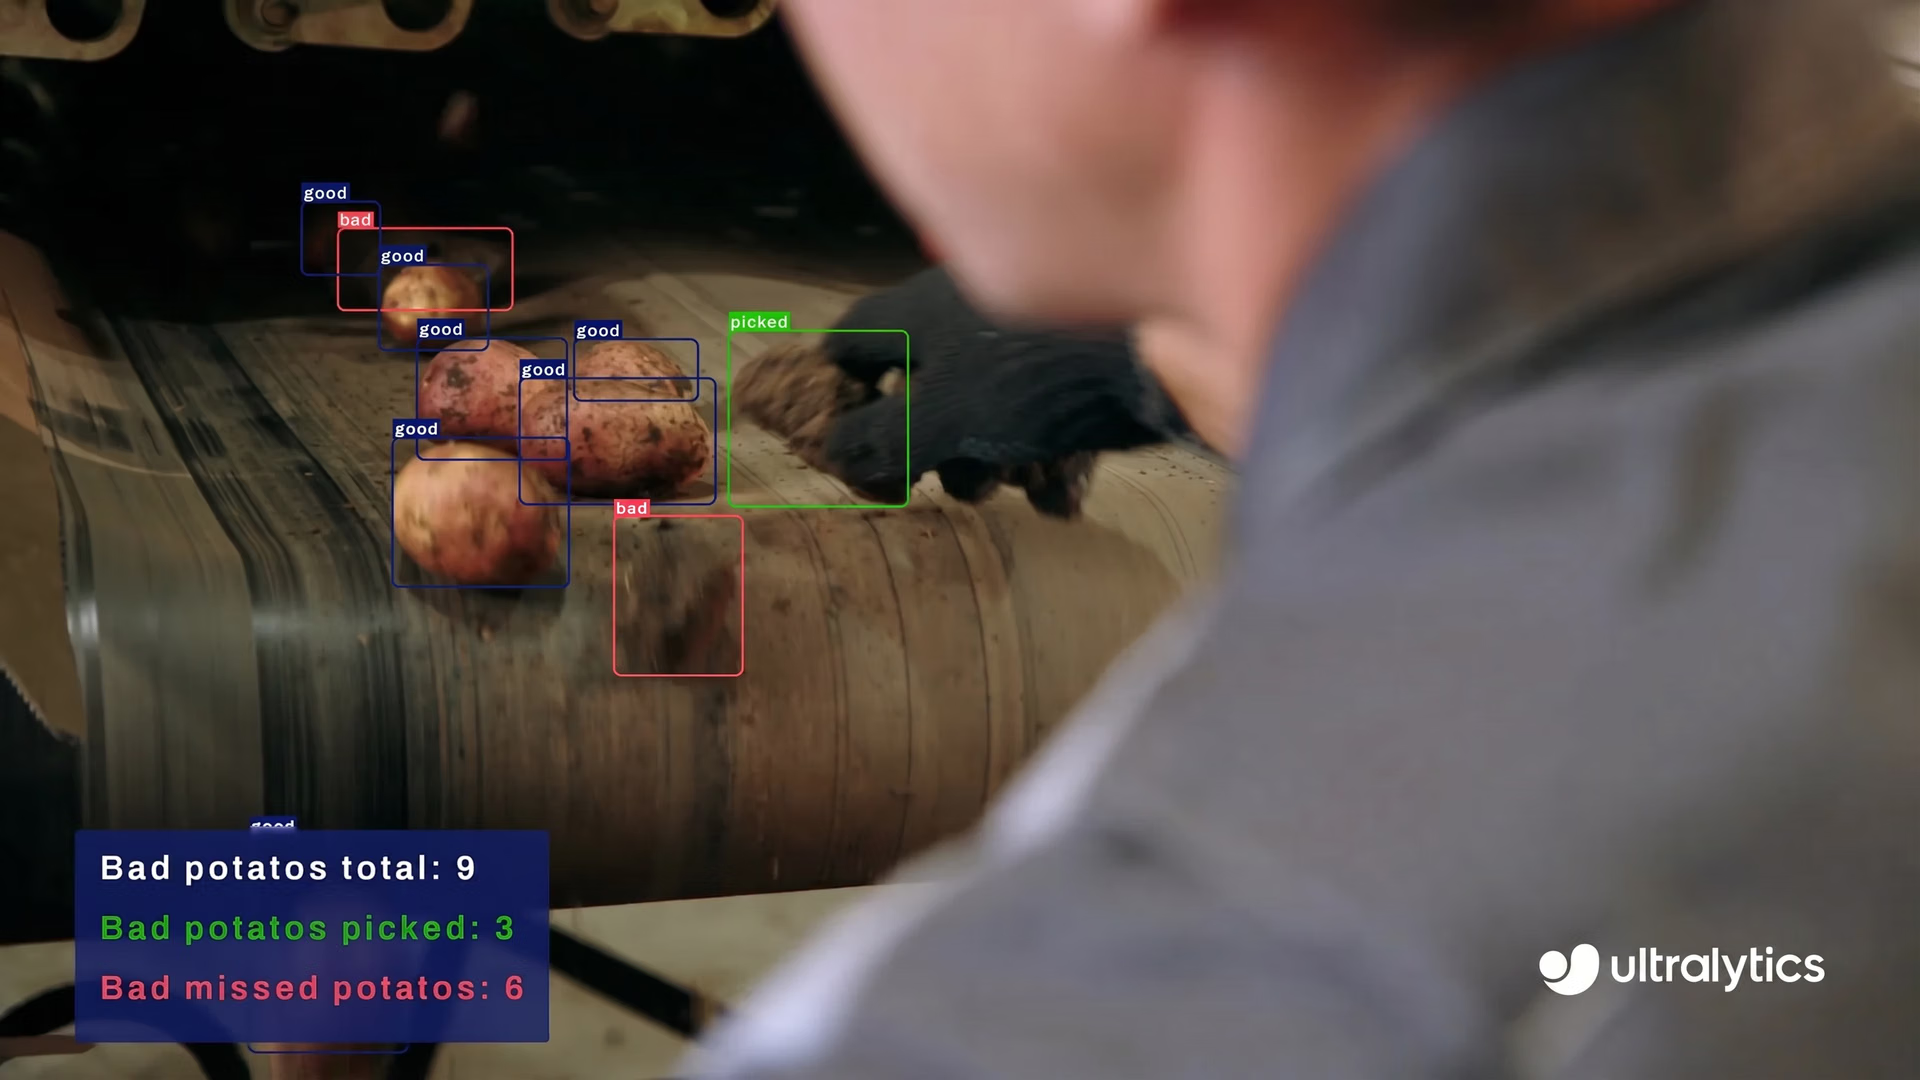
图 4. 使用 YOLO 检测并统计健康和有缺陷的土豆
无监督学习可以解决哪些计算机视觉问题#
如果你没有足够的标注数据,或者数据没有明确答案,无监督学习就很有用。在这些情况下,目标不是做出精确预测,而是理解数据中的规律和结构。
首次探索无标签数据集时,人们经常会使用无监督学习。你无需告诉模型要查找什么,而是让模型自行识别相似之处、将相关图像分组,或标出异常规律。
面对大量图像时,无监督方法可以帮助你将相似图像归为一组,或标记可能需要进一步关注的离群点。因此,无监督学习是数据科学项目中一个有用的起点。
生成模型包括 GAN、变分自编码器和扩散模型,它们学习图像的底层分布并生成全新的图像。这些模型为图像合成、图像修复、超分辨率和风格迁移等应用提供支持,也是当今生成式 AI 系统的基础。
在无监督分割中,有些方法会将像素或区域划分为连贯的片段,而不依赖带标签的掩码。当标注成本过高,或目标是发现结构而不是匹配预定义类别时,这种方法很有用。
处理大型数据集时,如果标注耗时过长或不切实际,无监督学习也能发挥重要作用。在这种情况下,你无需依赖带标签的训练数据,也能从数据中获取洞见。
无监督学习也常用于生成式 AI(创建图像、文本或音频等新数据的模型)和表示学习(从原始数据中学习有用特征或规律的模型)等领域,模型可以从大量数据中学习通用特征。总的来说,如果你的问题涉及数据探索、规律发现或无标签数据,无监督学习是一种灵活实用、值得考虑的方法。
无监督学习在计算机视觉中的实际应用示例#
以下是无监督学习在计算机视觉中的一些应用示例:
- 制造业中的异常检测: 模型可以学习正常产品的特征,无需针对每种可能的缺陷提供带标签的示例,就能标记缺陷或异常。
- 图像整理和搜索: 照片库或电子商务目录等大型图像集合可以根据视觉相似度自动分组,让数据科学家更轻松地整理、探索和搜索大型数据集。
- 监控和安防: 系统可以分析视频片段,识别异常规律或行为,例如意外移动或人群变化,而无需使用带标签的事件进行专门训练。
- 预处理和数据探索: 人们常在训练监督学习模型之前使用无监督方法来探索和整理原始图像数据,从而帮助提升数据质量并减少人工工作。
监督学习和无监督学习的实际局限#
尽管这两种学习方法各有优势,但也有一些局限需要考虑。构建计算机视觉模型时,以下是一些值得留意的实际因素:
- 监督学习模型的过拟合: 在监督学习中,模型可能会过度贴合训练数据,而不是学习通用规律。当数据集较小或缺乏多样性时,这种情况很常见。例如,使用一种产品的缺陷数据训练的模型,在新数据中的产品或光照条件稍有不同时,可能就无法准确检测缺陷。
- 聚类算法面临的挑战: 在无监督学习中,模型可以将相似的数据点分到一起。但如果数据有噪声、不一致或缺乏清晰结构,这种方法就可能失效。例如,在图像分组任务中,颜色相似但物体不同的图像可能会被错误地分到一起。
- 正确预处理的重要性: 训练前需要清理并准备数据。通常会使用处理图像和转换数据的 Python 库来完成这些工作。在计算机视觉中,这一点尤为重要,因为图像的尺寸、质量和光照条件可能各不相同。如果预处理不当,模型可能会从噪声而非有意义的规律中学习,导致性能不佳。
要点#
在计算机视觉中,监督学习和无监督学习都发挥着重要作用。该采用哪种方法,取决于你拥有的数据类型、数据是否带标签、你要解决的问题以及部署需求。
如果你的目标是实现高准确率并获得明确的输出,监督式机器学习通常是更好的选择。如果你正在探索数据或处理无标签数据,无监督学习可能更合适。
想进一步了解 AI?欢迎查看我们的社区和 GitHub 代码仓库。浏览我们的解决方案页面,了解机器人领域的 AI和农业中的计算机视觉。查看我们的许可选项,今天就开始使用计算机视觉构建应用吧!









