GPT-6.1 Terra 自动标注排名第一,击败 OpenAI 自家的旗舰模型
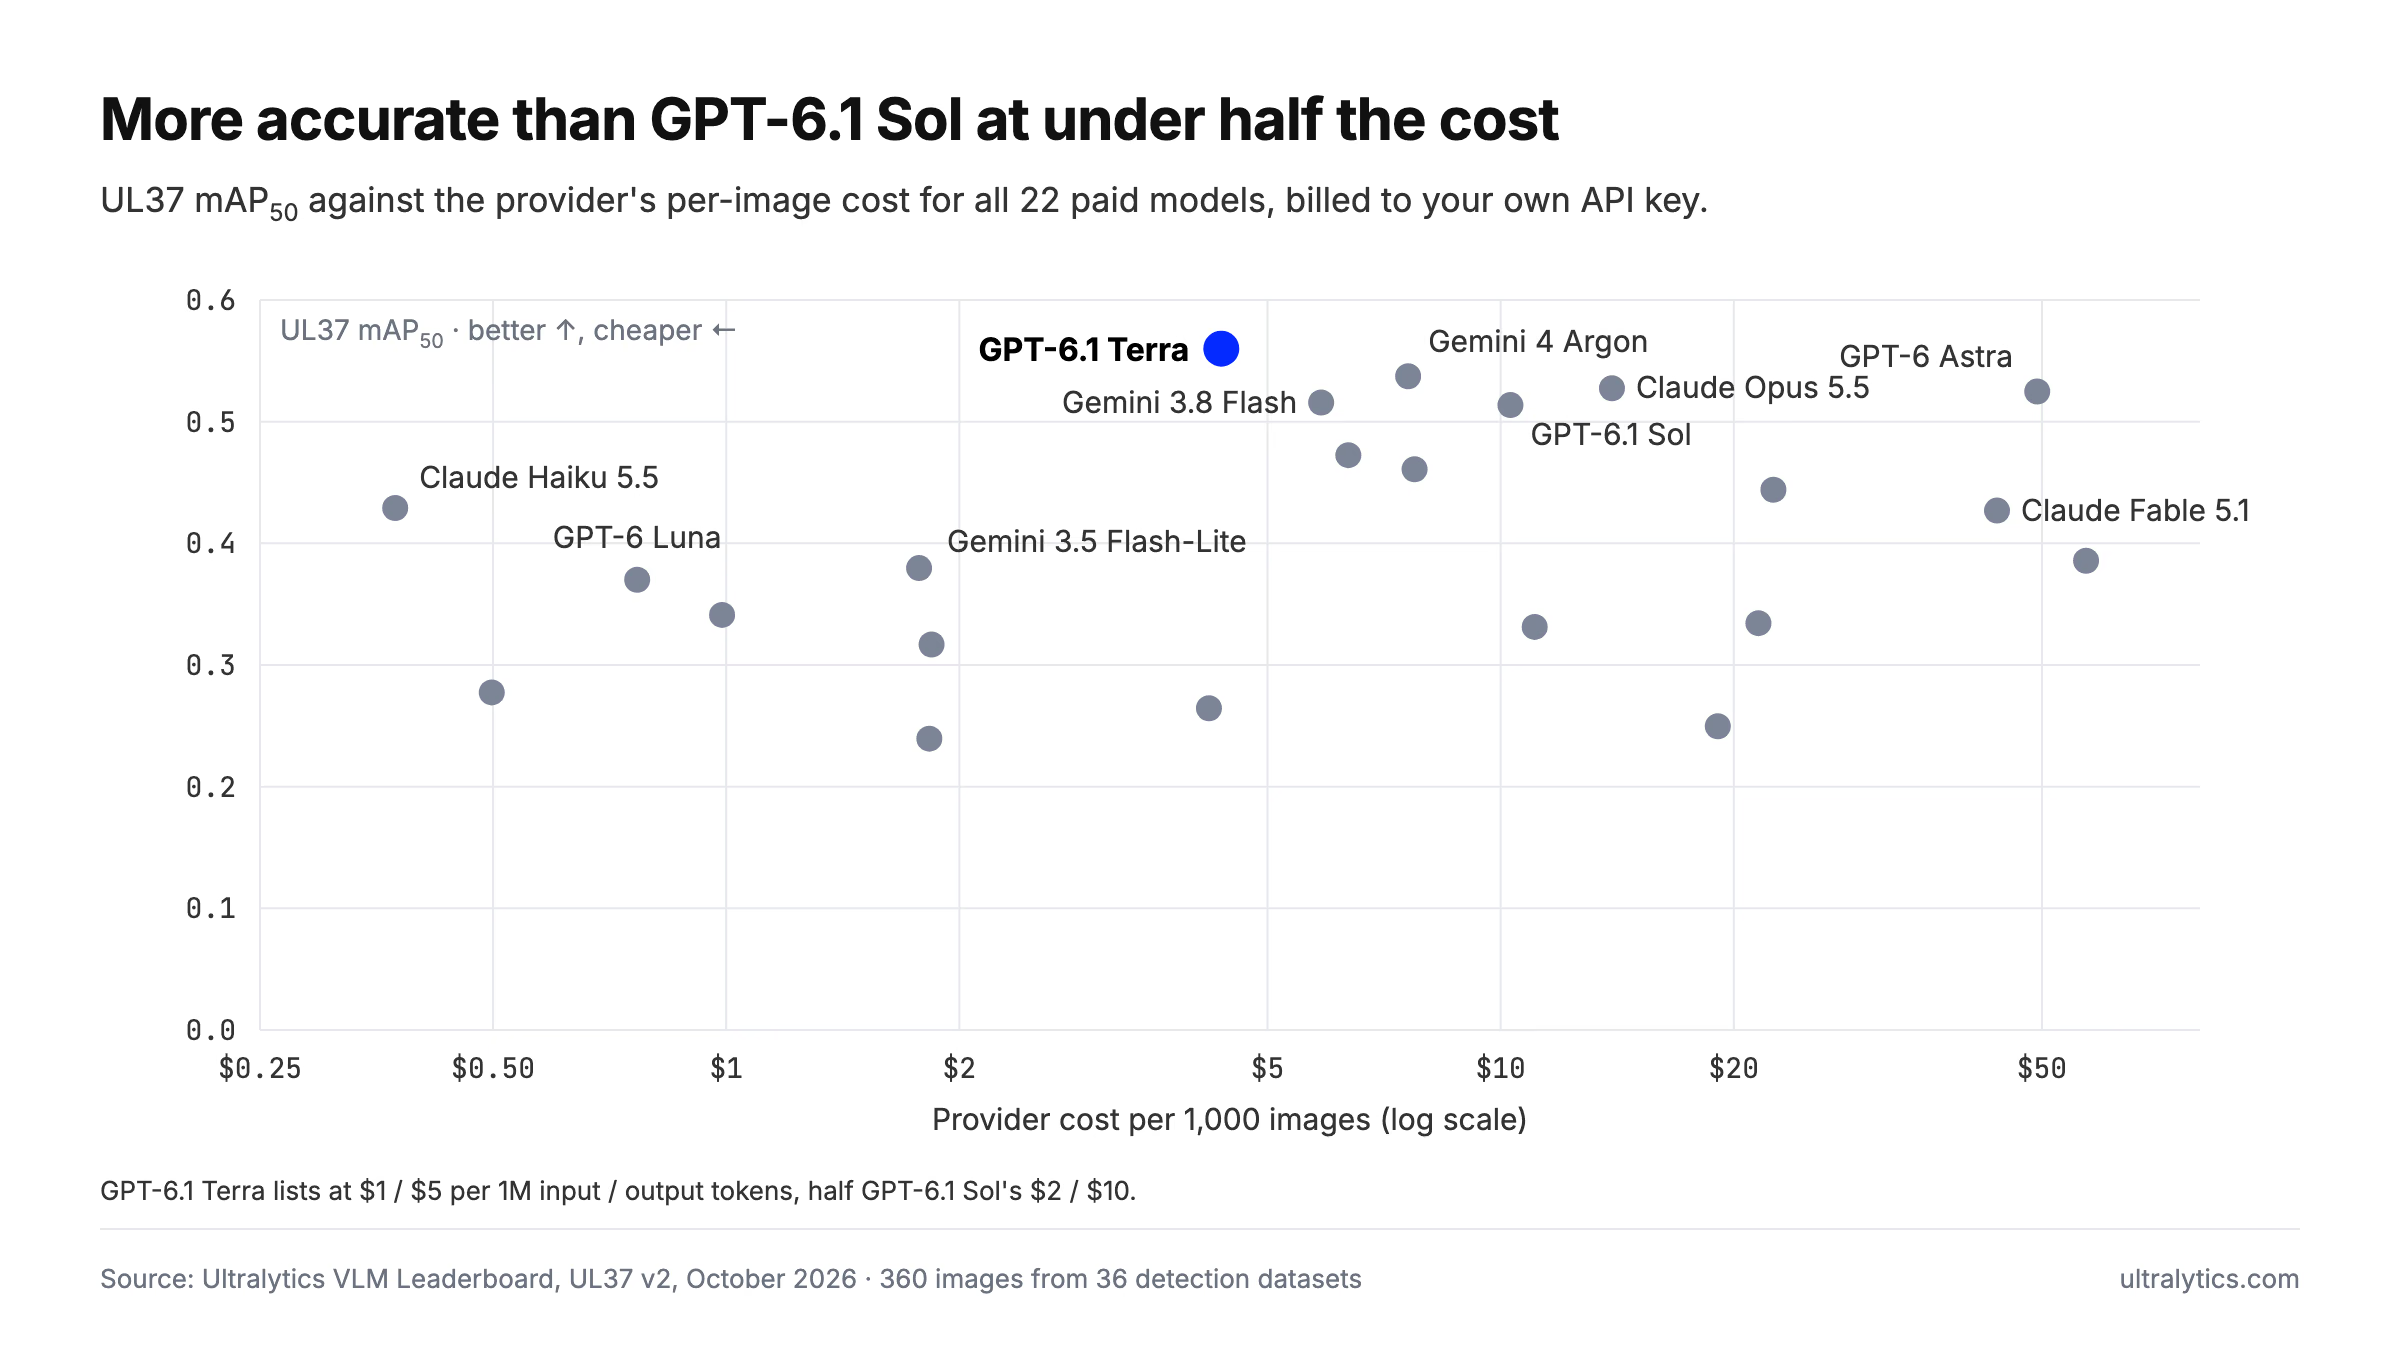
GPT-6.1 Terra 自动标注在我们的 VLM 排行榜上击败了 39 款模型:每 1,000 张图像仅需 $4.36,mAP50 达到 0.560,领先 GPT-6.1 Sol 和 Gemini 4 Argon。
OpenAI 的发布资料称,GPT-6.1 Terra 在视觉推理方面几乎能与更大的同系列模型媲美。当我们让它绘制边界框时,事实证明“几乎”并不是恰当的说法。
2026 年 10 月 26 日,也就是 OpenAI 发布 GPT-6.1 Terra 的当天,我们在 UL37(涵盖 36 个数据集的目标检测基准测试)中测试了它的自动标注表现。它获得 0.560 mAP50,在我们的 VLM 排行榜39 款模型中排名第一。OpenAI 这款中价位模型领先 GPT-6.1 Sol、旗舰 GPT-6 Astra,以及此前一直位居榜首的 Gemini 4 Argon。
它的成本为每 1,000 张图像 $4.36,单张图像耗时 5.1 秒,而且没有一次请求失败。你今天就可以在 Ultralytics Platform 中使用它。下面介绍它的优势、短板,以及如何判断它是否适合你的标注工作流。
GPT-6.1 Terra 在 UL37 中排名第一#
UL37 使用 360 张图像衡量模型预测框与人工标注的匹配程度:从 36 个真实目标检测数据集中各取 10 张,涵盖医学扫描、航空影像、零售货架、体育、文档、电路板等领域。每张图像都经过 Platform 用户所使用的同一套生产流程,使用数据集自身的类别名称,并由 SAM 3.1 对每个框进行精修。评测方法已公开。
以下是 Terra 的成绩单:
- mAP50: 0.560,39 款模型中排名第 1
- mAP50-95: 0.345,同样排名第 1,这意味着它的预测框贴合度高,而不只是大致准确
- 精确率和召回率: 0.646 和 0.613
- 服务提供商费用: 每 1,000 张图像 $4.36
- 单张图像中位耗时: 5.1 秒
- 失败请求: 无
在 UL37 上,有 6 款模型的得分超过 0.51,其中 Claude Opus 5.5 位列第三。Terra 是这 6 款模型中准确度最高、价格也最低的一款。
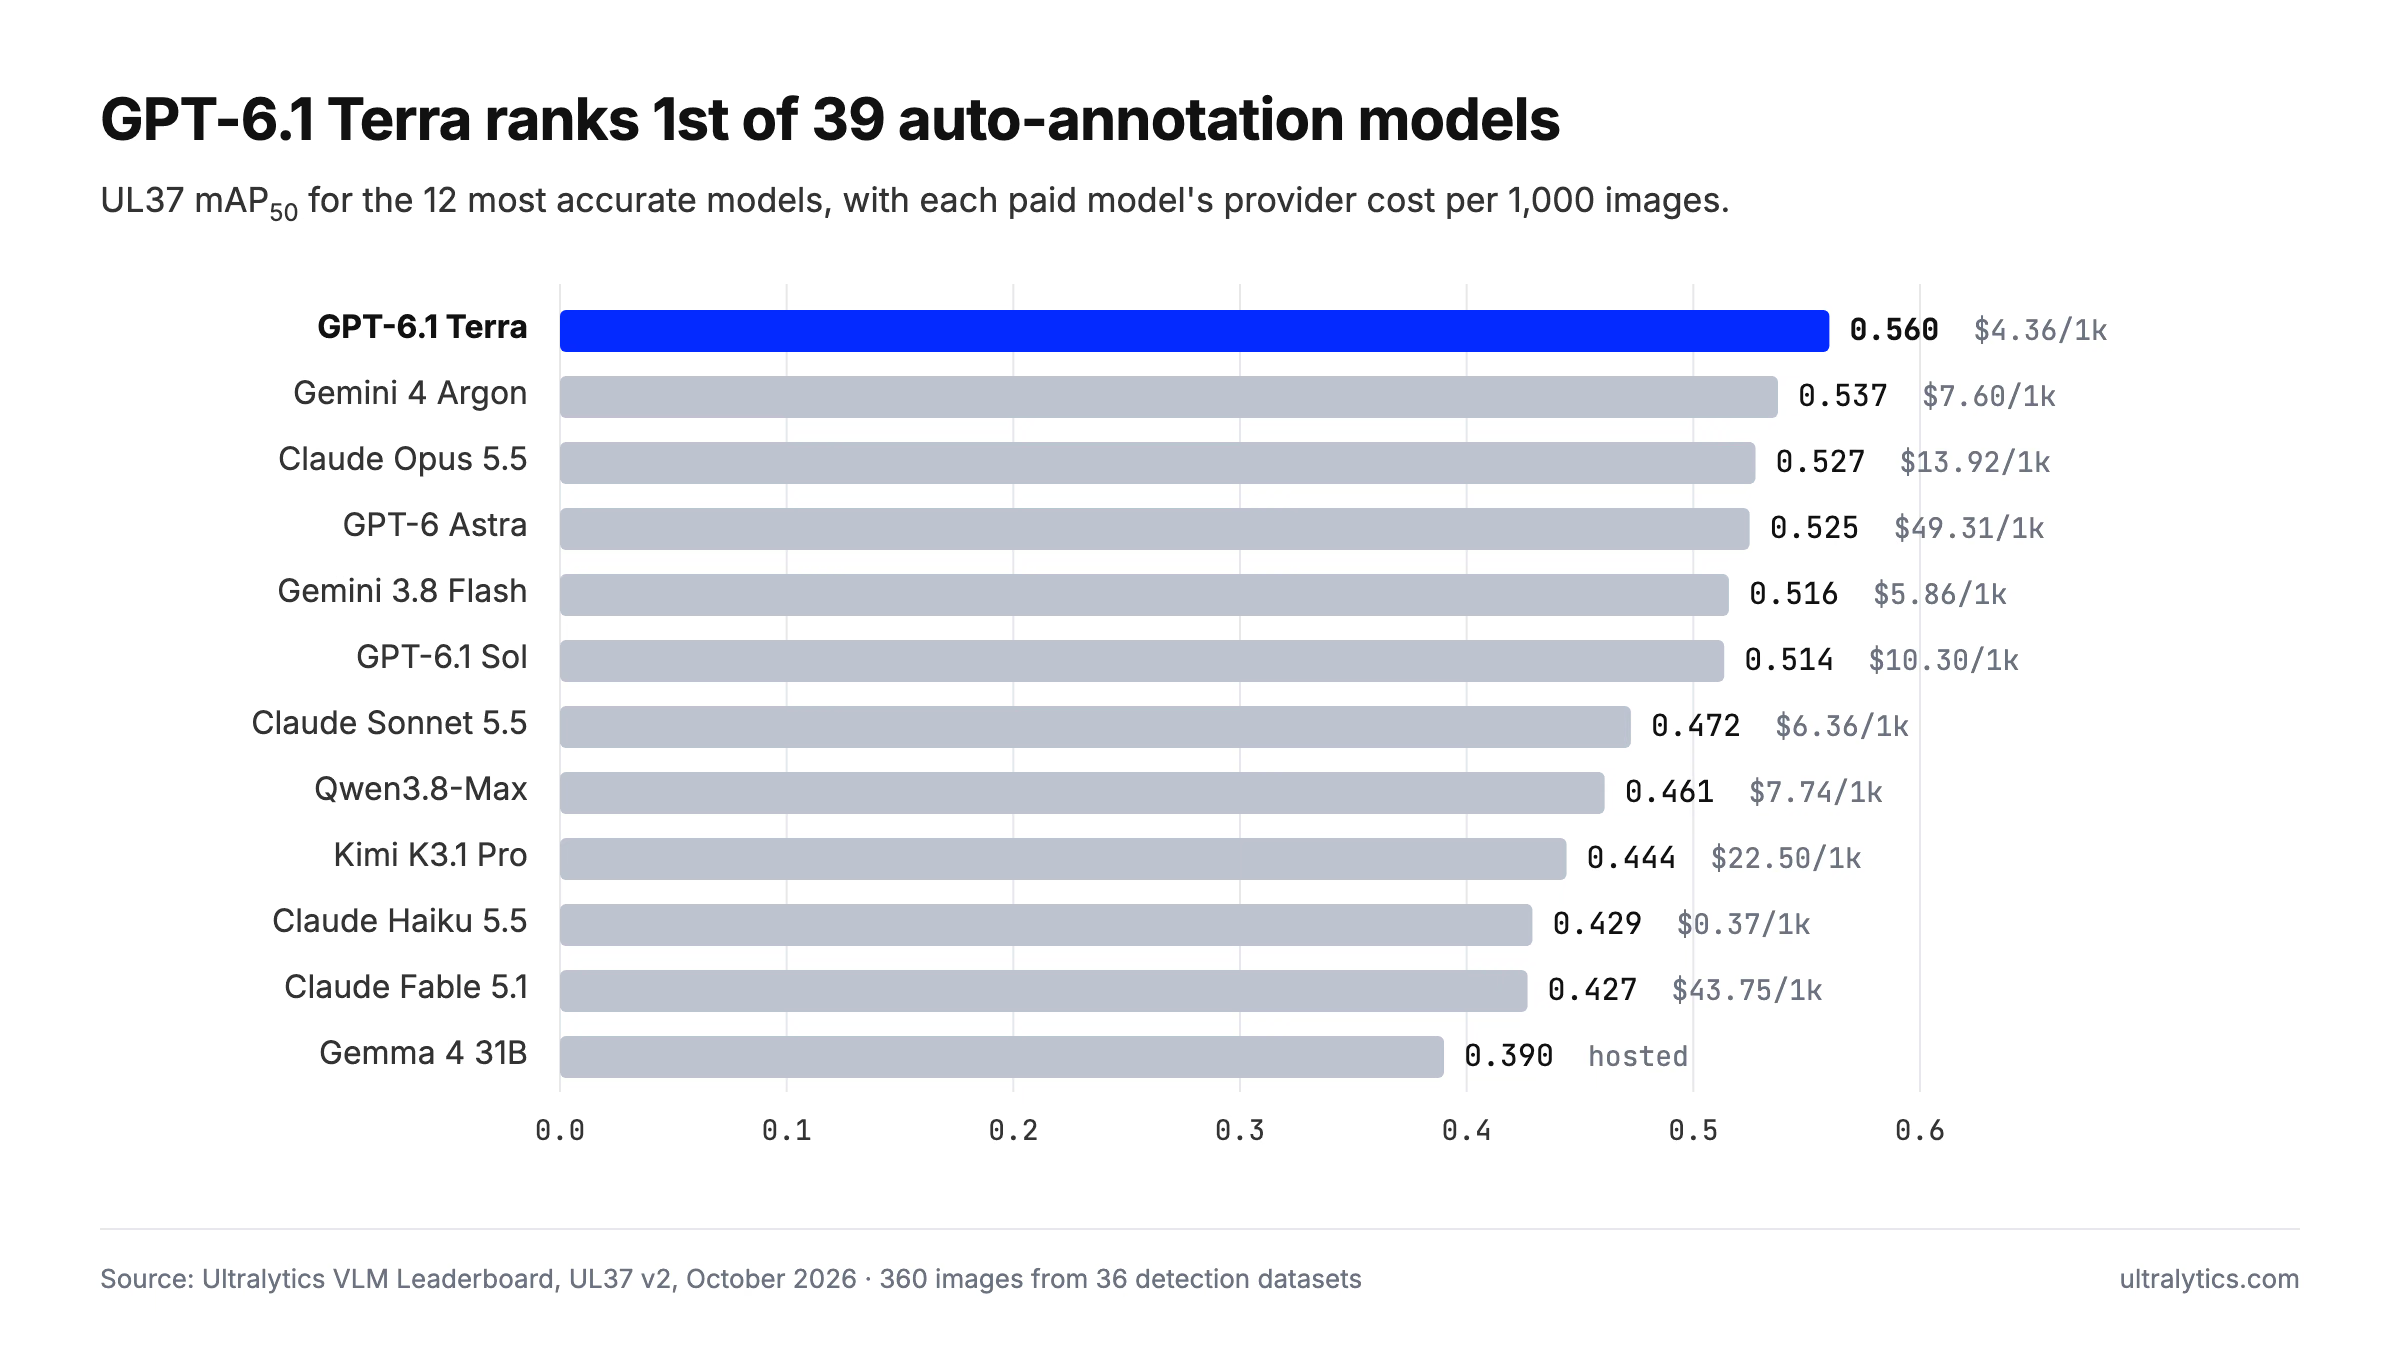
这个结果并非来自什么复杂的调参技巧。Terra 使用 OpenAI 默认的推理强度,其模型文档将其标为 medium。它在 Platform 中收到的请求与其他 OpenAI 模型相同,边界框坐标使用 0–1000 网格。我们接入模型后,它便直接登上榜首。
击败 OpenAI 旗舰模型的中价位模型#
OpenAI 将 GPT-6.1 Terra 定位为产品线中快速、高效的中间档。据 The Decoder 和 BleepingComputer 的发布报道,它是 GPT-5.6 Terra 的后继产品,面向计算机操作、视觉推理、编程和日常工作。它可通过 API 以 gpt-6.1-terra 的名称使用,也面向 Plus、Pro、Enterprise 和 Edu 用户提供于 ChatGPT Work 和 Codex 中。OpenAI 的文档将其描述为“一款快速、高效的模型,适用于视觉推理、精准的计算机操作以及清晰自然的写作”,支持文本和图像输入,上下文窗口为 1,050,000 个 token。
价格为每百万输入 token $1、每百万输出 token $5,缓存输入 token 每百万 $0.05。根据 OpenAI 的 GPT-6.1 Sol 和 GPT-6 Astra 页面,这个价格是 GPT-6.1 Sol($2 和 $10)的一半,也是 GPT-6 Astra($10 和 $50)的十分之一。
OpenAI 在发布基准测试中将 Terra 描述为接近而非超过更大的同系列模型。在视觉推理测试 MMMU-Pro 上,OpenAI 报告称 Terra 的表现几乎能与 Astra 和 Sol 持平。在 Terminal-Bench 4.0 上,OpenAI 报告的得分为 50.3%,高于 GPT-5.6 Terra 的 21.5%。对于难度最高的编程任务,OpenAI 仍建议使用 Sol 或 Astra。
从纸面表现来看,Terra 是一款折中之选。在我们的基准测试中,它却是 OpenAI 最强的检测模型。
| OpenAI 模型 | UL37 mAP50 | 每 1,000 张图像的成本 | 每张图像的中位耗时 |
|---|---|---|---|
| GPT-6 Luna | 0.370 | $0.77 | 11.9 s |
| GPT-6.1 Terra | 0.560 | $4.36 | 5.1 秒 |
| GPT-6.1 Sol | 0.514 | $10.30 | 10.5 s |
| GPT-6 Astra | 0.525 | $49.31 | 11.6 s |
Terra 的单张图像成本不到 GPT-6.1 Sol 的一半,也不到 GPT-6 Astra 的十分之一。它的响应速度也约为这两款模型的两倍。正面对比中,它在 36 个数据集中的 22 个上胜过 Sol。
OpenAI 称,Terra 完成任务的速度比 Sol 和 Astra 快三倍以上,这一说法针对的是智能体工作负载。标注是另一类任务;在这方面,我们测得 Terra 的速度约为 Sol 的两倍。标注数千张图像时,这种差异仍然很可观。
Terra 相比 Sol 的优势在于精确率#
这两款模型检测到的已标注目标比例相近。Terra 的召回率为 0.613,Sol 为 0.618。差距体现在精确率上:Terra 为 0.646,Sol 为 0.551。Terra 的预测框中,有真实目标且类别正确的比例高得多。
SKU110K 的结果很容易看出差异。图像中是摆满商品、密密麻麻的超市货架,所有商品都属于同一个类别。两款模型在该数据集上的召回率相近,Terra 为 0.73,Sol 为 0.77。但在这些货架图像上,Sol 的精确率为 0.49,Terra 则为 0.79。Sol 约有一半的预测框是误报,而 Terra 大约只有五分之一。Terra 在 SKU110K 上的 mAP50 达到 0.62,是所有模型迄今取得的最高分。
这对数据标注很重要,因为不同错误的代价并不相同。漏掉一个商品,只需补画一个框。多画一个框,则需要在几十个正确框中把它找出来并删除。误报越少,审核人员拿到的初稿就越干净。
医学影像是 GPT-6.1 Terra 最突出的优势#
Terra 的结果中最显著的特点体现在医学领域。UL37 包含 8 个医学数据集,Terra 在这些数据集上的平均 mAP50 为 0.505,在 39 款模型中排名第 1。紧随其后的是 Gemini 3.8 Flash(0.387)和 Gemini 4 Argon(0.379)。在排行榜的所有领域中,没有其他模型的领先幅度更大。
以下是它在全部 8 个数据集上的得分,以及其他 38 款模型中每个数据集表现最好的模型:
| 数据集 | GPT-6.1 Terra | 其他模型中的最佳成绩 |
|---|---|---|
| 甲状腺超声(TN5000) | 0.94 | Gemini 3.8 Flash,0.88 |
| 脑肿瘤 MRI(Cheng) | 0.90 | Gemma 4 31B,0.80 |
| 血细胞显微图像(TXL-PBC) | 0.89 | Gemini 4 Argon,0.78 |
| 结肠息肉内窥镜图像(Kvasir-SEG) | 0.71 | 7 款模型并列,包括 Gemini 4 Argon,0.81 |
| 儿童腕部 X 光片(GRAZPEDWRI-DX) | 0.27 | GPT-6 Astra,0.35 |
| 胸部结核 X 光片(TBX11K) | 0.14 | GPT-6 Astra,0.33 |
| 视网膜病变(DDR) | 0.13 | Claude Opus 5.5,0.13 |
| 牙科 X 光片(DENTEX) | 0.06 | Gemini 4 Argon,0.21 |
表格前三行体现了关键结果,而且这些任务都不只是找准位置。在 TN5000 上,每个框还需要标注数据集中的良性或恶性结节类别,正是临床医生必须确认的判断。Gemini 4 Argon 在该数据集上的得分为 0.29,GPT-6.1 Sol 为 0.53。脑部 MRI 的类别包括脑膜瘤、胶质瘤和垂体瘤,Sol 在该数据集上的得分为 0.52。血细胞数据集则要求 Terra 区分白细胞、红细胞和血小板。
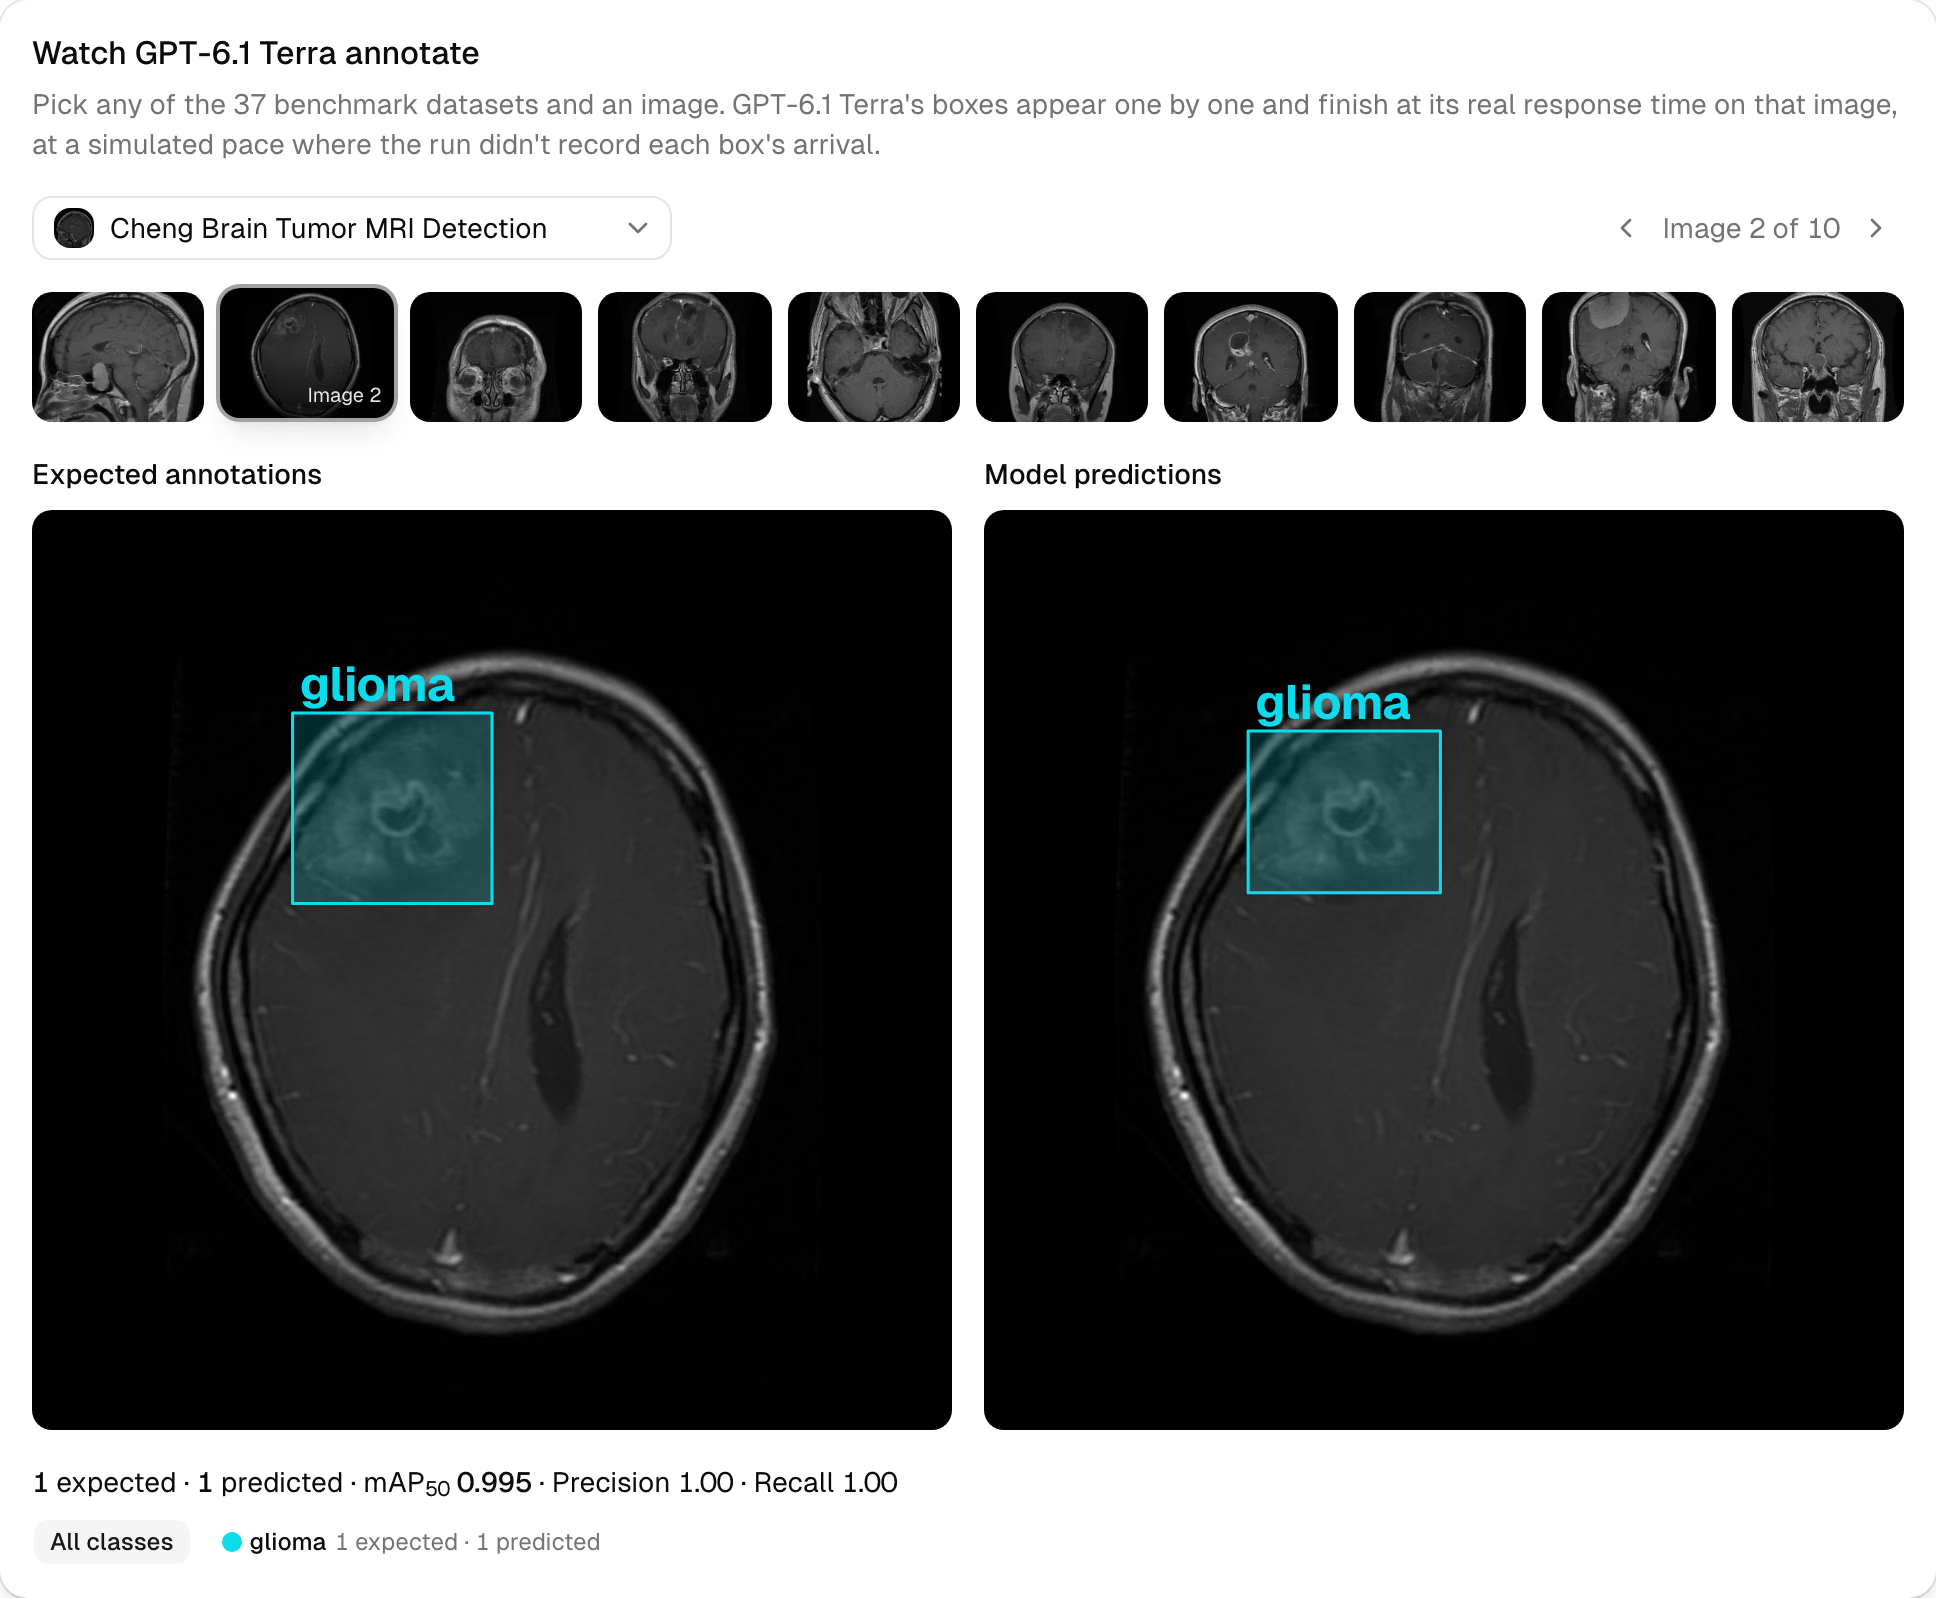
上方的回放来自 Terra 的模型页面,展示了一个典型的正确结果:脑部 MRI 上有一个胶质瘤,Terra 预测了一个框,位置和标签都与预期标注一致。
需要结合两个注意事项来看待这些数字。第一,每个数据集只有 10 张图像,因此单个数据集的分数只是值得进一步调查的信号,并非定论。第二,这些结果都不能用于诊断。对于医学影像分析团队,Terra 能快速为超声、MRI 和显微镜图像生成框的初稿,再由临床专家检查、修正并批准。这种人在回路中的审核正是整个工作流的核心,而不是可有可无的附加步骤。
GPT-6.1 Terra 的短板:X 光片和电路板#
表格底部体现出一个明显规律:在 UL37 的所有 X 光数据集上,无论是否属于医学领域,其他模型都表现更好。Terra 在儿童腕部、胸部和牙科 X 光片上的表现落后于领先模型;安检 X 光片的结果更差:在 IEDXray 上得分为 0.00,而 Gemini 4 Argon 达到 0.30。
IEDXray 是最明显的失利。其扫描图像包含笔记本电脑、手机、寻呼机、电池和简易装置,Terra 在其中任何一张图像上都没有生成正确的框。
电路板是另一个盲区。Terra 在我们的工业 PCB 数据集上的平均得分为 0.13,而 GPT-6.1 Sol 达到 0.39。在 DeepPCB 上,数据集涵盖开路、短路、鼠咬痕和毛刺等裸板缺陷,Terra 得分为 0.03,Sol 则为 0.39。对于 PCB 检测数据,Sol 是更好的 OpenAI 选择。
在这些领域中的任何一个领域开始标注大型数据集之前,先打开 GPT-6.1 Terra 模型页面。页面会回放 Terra 在全部 36 个基准数据集和 COCO 上记录的预测框,并与预期框并列展示,还会列出它在每个数据集上的得分。
GPT-6.1 Terra 对比 Gemini 4 Argon:实际差距比排名显示的更小#
Terra 出现之前,Gemini 4 Argon一直位居排行榜榜首,而两者的表现相近。Terra 在 19 个数据集上得分更高,Argon 在 16 个数据集上领先,另有一个数据集两者并列。
Terra 的 0.023 分领先优势很大一部分来自一个数据集。在 TN5000 甲状腺超声数据集上,Terra 得分为 0.94,Argon 为 0.29。去掉该数据集后,两者的平均分分别为 Terra 0.549、Argon 0.544,几乎持平。Terra 位居第一是实至名归,但这一优势主要来自医学影像。
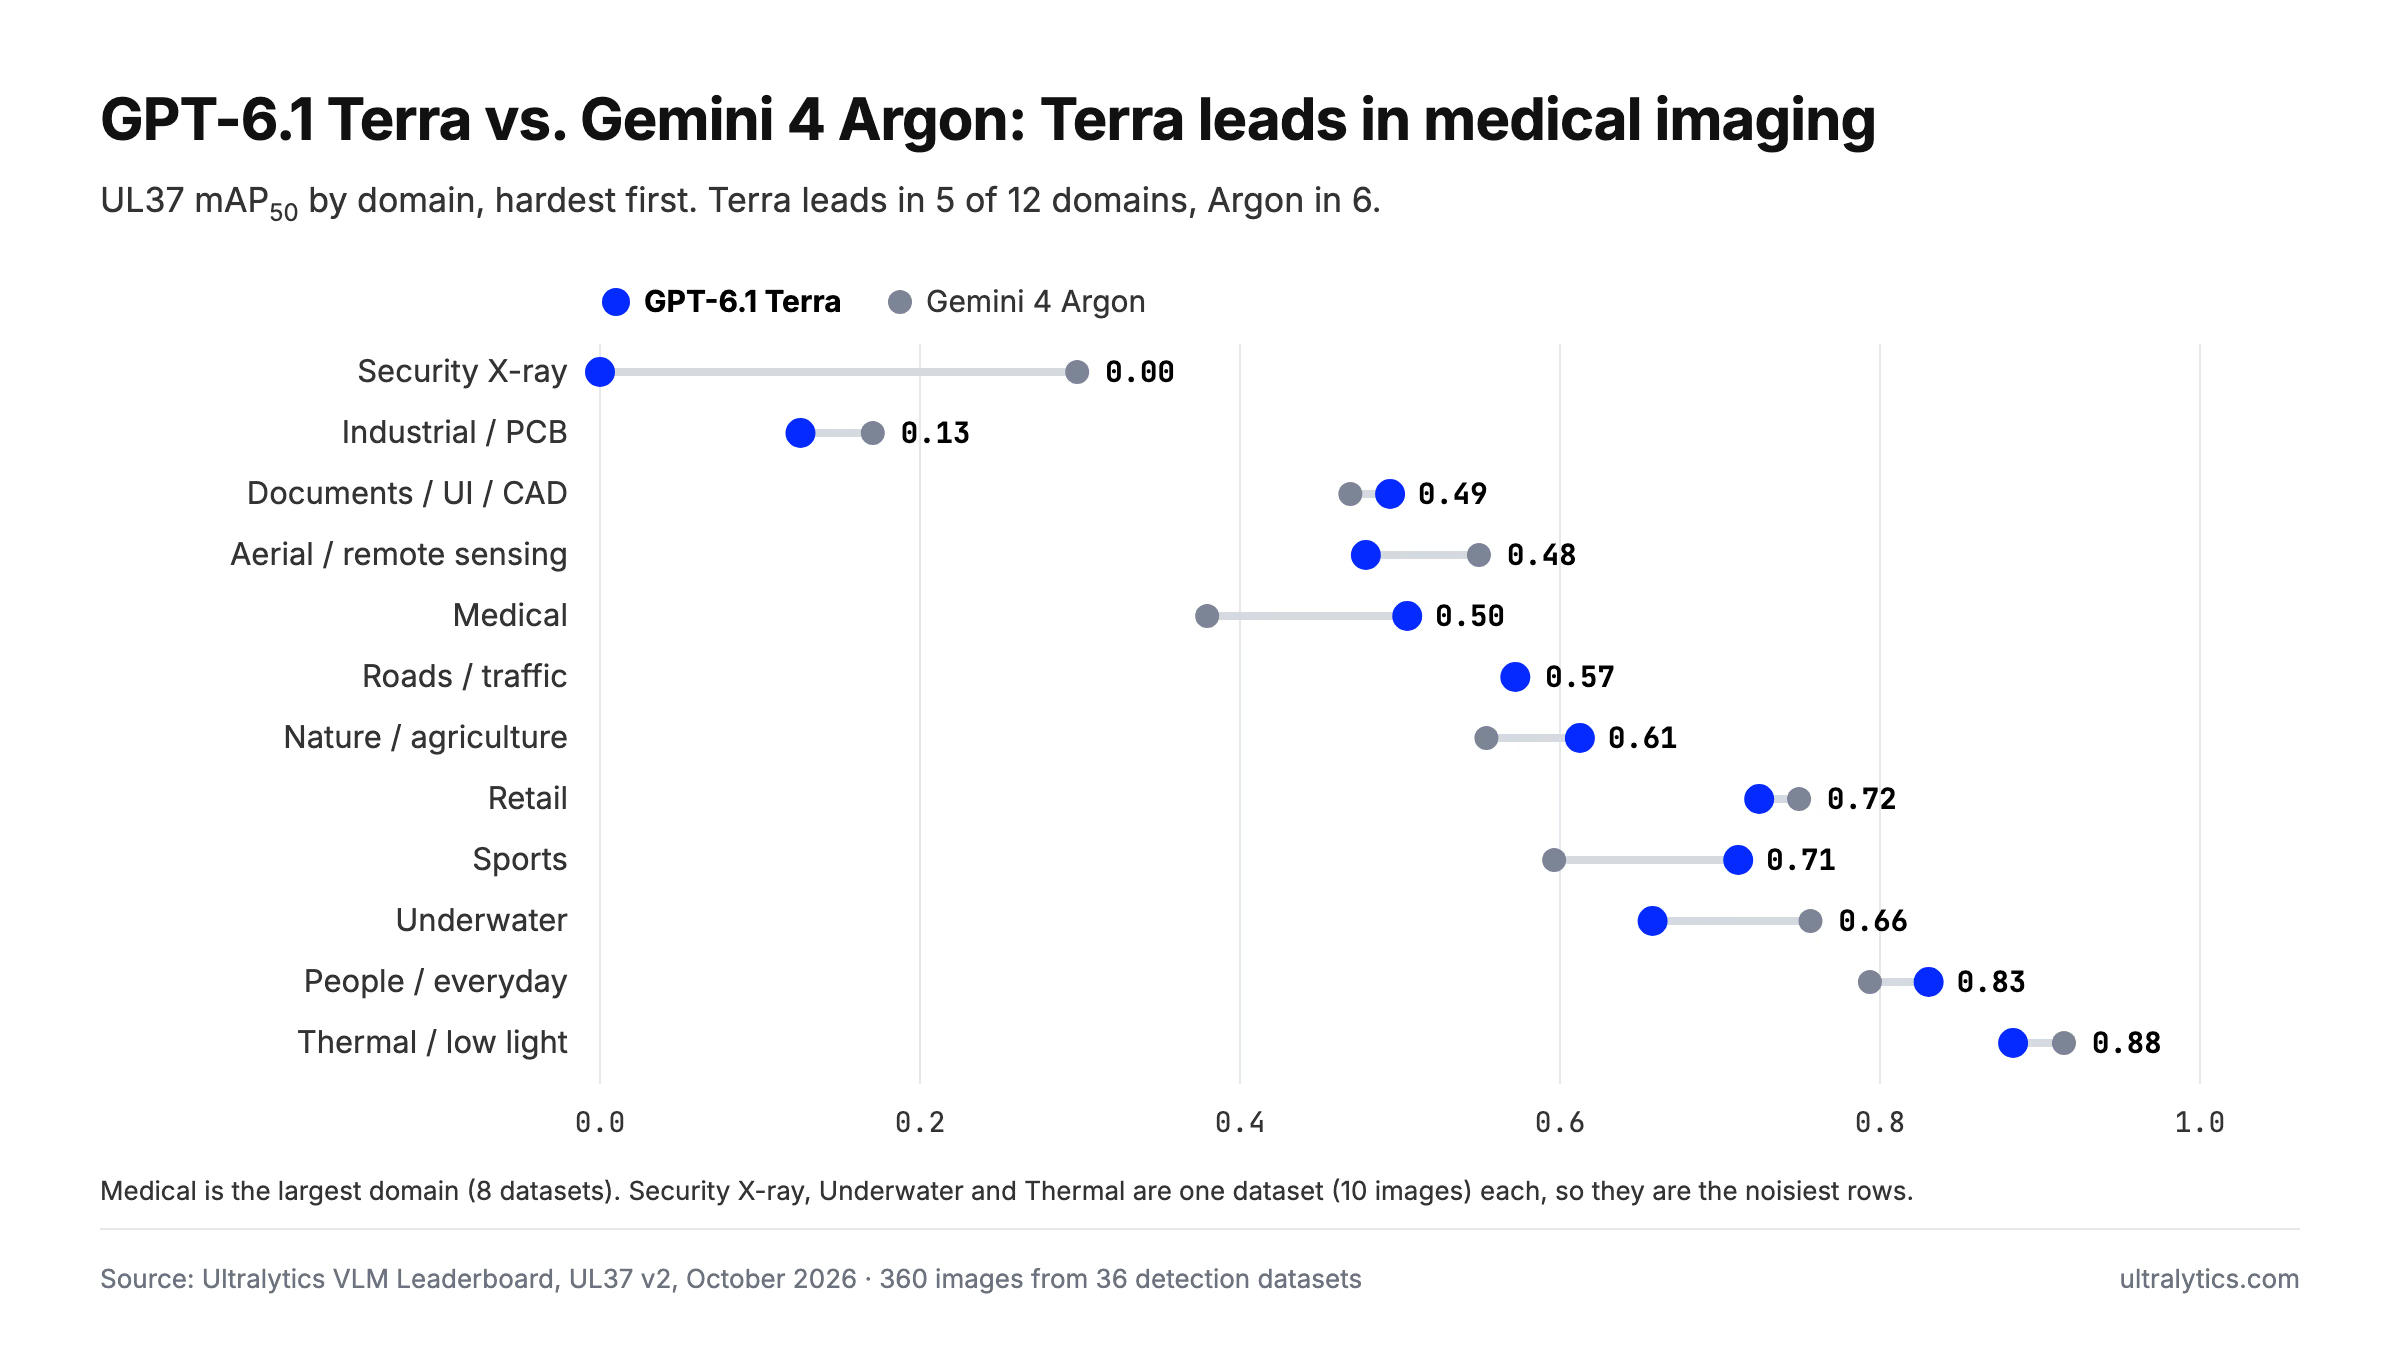
按领域来看,Terra 在 5 个领域领先,并在其中两个领域位列 39 款模型之首:医学,以及文档、UI 和 CAD。Argon 在 6 个领域领先,并继续保持航空影像、水下和热成像类别的优势。道路与交通领域则打成平手。
两款模型的错误类型也各不相同。Argon 的精确率略高,为 0.667,Terra 为 0.646;Terra 检测到的目标更多,召回率为 0.613,Argon 为 0.585。按 Google 的发布定价,Terra 每 1,000 张图像的成本为 $4.36,Argon 则为 $7.60。Argon 的速度稍快,单张图像耗时 4.6 秒。
实际选择上:医学、文档和体育图像优先选 Terra;航空影像、水下、热成像和安检图像优先选 Argon。我们的 Gemini 4 Argon 自动标注结果介绍了它的具体表现。
GPT-6.1 Terra 批量标注的成本#
每 1,000 张图像 $4.36 是服务提供商的费用,根据 OpenAI 报告的 token 用量和标准价格计算得出。每张图像的中位用量约为 1,300 个输入 token 和 370 个输出 token。批量标注还会收取 $1.00 的 Platform 处理费,因此处理 1,000 张图像的总费用约为 $5.36。
本次测试还有三个细节值得一提:
- 没有失败请求。 Terra 的所有基准测试请求都在 Platform 的 115 秒时限内完成。GPT-6.1 Sol 有 2 张图像请求失败,GPT-6 Astra 则有 4 张。
- 未经处理的预测框质量已经很高。 在 SAM 3.1 精修之前,Terra 的预测框得分为 0.559 mAP50。精修后提升到 0.560,说明绝大部分工作都是模型自己完成的。
- 无需配置。 使用默认推理强度和标准 OpenAI 请求即可。
如果预算比最后几个准确度点更重要,还有更便宜的选择。Claude Haiku 5.5每 1,000 张图像的费用为 $0.37,得分为 0.429;Gemini 3.5 Flash-Lite费用为 $1.77,得分为 0.380。托管模型(例如 Qwen3.8 27B、Gemma 4 26B 和 SAM 3.1 Text)完全不需要 API 密钥,你自己的 Ultralytics YOLO 模型也一样。
从 OpenAI 密钥到已标注数据集#
GPT-6.1 Terra 是一款由类别提示驱动的模型,适用于包含 1 至 200 个类别的检测数据集。它会根据数据集自身的类别名称返回边界框,由你审核后再保存。设置步骤如下:
- 在 OpenAI API 密钥页面创建密钥。
- 在拥有该数据集的 Platform 工作区中,将密钥添加到设置 > API 密钥。费用由 OpenAI 直接向你收取,Ultralytics 不会对 token 加价。服务提供商密钥文档介绍了详细信息。
- 在标注编辑器中切换到 Smart 模式,然后在模型选择器的 OpenAI 选项下选择 GPT-6.1 Terra。
- 点击 Predict,或使用
P,为当前图像生成标注。扩大规模前,先用几张能代表你数据的图像试试。 - 确认效果满意后,前往数据集页面,选择 更多操作 > 批量标注,一次性标注所有尚未标注的图像。Platform 会先保存一个数据集版本,因此你可以回滚。
- 审核并保存预测框,然后在同一工作区中使用结果训练 Ultralytics YOLO26 模型。训练文档会带你了解整个流程。
若想进一步了解这些模型如何融入编辑器,请参阅Ultralytics Platform 如何利用 AI 自动完成标注,以及我们的视觉语言模型入门介绍。
哪些人适合改用 GPT-6.1 Terra#
把 GPT-6.1 Terra 设为通用目标检测标注的默认付费模型吧。在我们测试过的模型中,它准确度最高,是前六名中价格最低的一款,而且在本次测试中从未出现请求失败。
对于需要专家审核的超声、MRI 和显微镜图像,以及误报容易堆积的密集零售货架,Terra 尤其适合作为初稿标注工具。各种 X 光片和 PCB 缺陷检测则建议选择其他模型,Gemini 4 Argon、GPT-6 Astra 或 GPT-6.1 Sol 在这些场景中表现更好。
如果你现在只是为了标注图像而购买 Sol 或 Astra,改用 Terra 很简单:它能以不到 Sol 一半的成本提供更好的预测框。
常见问题
擅长。在我们的 UL37 基准测试中,GPT-6.1 Terra 在 36 个真实检测数据集上的平均 mAP50 为 0.560,在 Ultralytics VLM 排行榜的 39 款模型中排名最高。它在更严格的 mAP50-95 指标上也位列第一,得分为 0.345。它最薄弱的领域是 X 光影像和电路板缺陷。
在我们的基准测试中,是的。Terra 的 mAP50 为 0.560,Sol 为 0.514;Terra 在 36 个数据集中的 22 个上胜出;每 1,000 张图像的费用为 $4.36,而 Sol 为 $10.30;运行速度约为 Sol 的两倍。对于 PCB 缺陷检测,Sol 仍是更好的 OpenAI 选择。
Terra 以 0.560 对 0.537 的 mAP50 领先,单张图像成本也更低,但两者差距很小:Terra 赢下 19 个数据集,Argon 赢下 16 个,另有一个数据集打平。去掉 TN5000 甲状腺超声数据集后,两者几乎持平。医学和文档图像选 Terra;航空影像、水下、热成像和安检 X 光图像选 Argon。
按提供商报告的 token 使用量计算,按每百万个输入 token 1 美元、每百万个输出 token 5 美元的标价,OpenAI 费用约为 4.36 美元。Ultralytics Platform 中的批量标注每 1,000 张图像收取 1.00 美元处理费。你通过自己的 API 密钥直接向 OpenAI 付款。
在我们的八个医学数据集中,它是表现最强的模型,平均 mAP50 为 0.505,并在甲状腺超声、脑肿瘤 MRI 和血细胞显微图像上取得最高分。它在 X 射线图像上的表现弱得多,在结肠息肉内窥镜图像上的表现也落后。你可以用它生成候选框供专家审核,但绝不能把它用作诊断工具。
不需要。Platform 会使用 OpenAI 默认的推理强度 medium 调用该模型,并像对所有 OpenAI 模型一样请求边界框,随后由 SAM 3.1 优化每个边界框。在我们的基准测试中,请求的中位耗时为 5.1 秒,且没有请求失败。









