计算机视觉托管式训练平台与自托管 GPU 对比
比较托管式 GPU 训练平台、云端 ML 服务、租用 GPU 和自有硬件在计算机视觉领域的表现:成本、设置、盈亏平衡点,以及各自适用的场景。
 Miles Deans8 分钟阅读
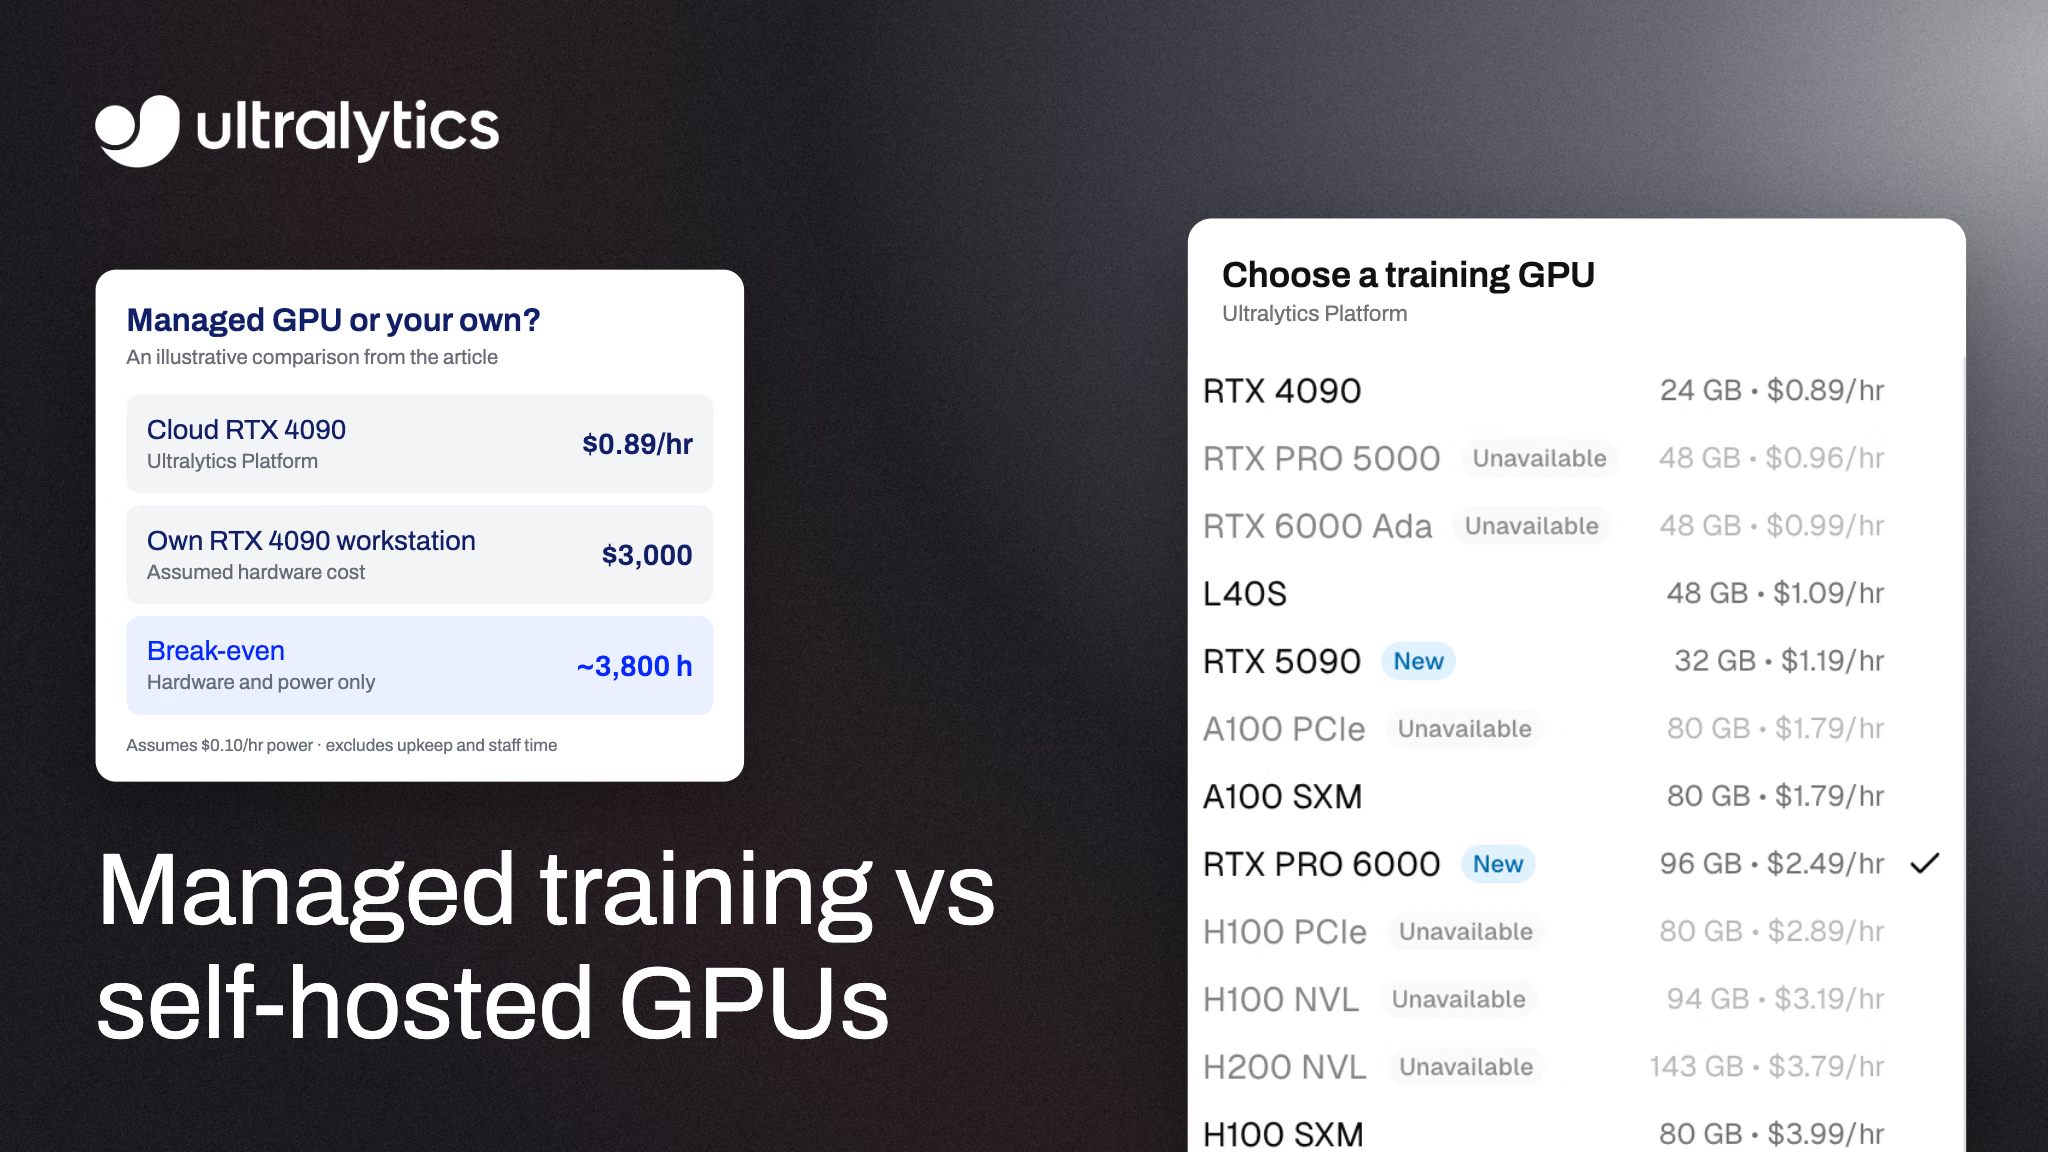
托管式训练平台为你运行训练基础设施,并按 GPU 使用时间计费;使用自托管 GPU 时,无论是租用机器还是购买机器,硬件和环境都由你的团队负责。托管式训练通常适合间歇性工作负载,以及希望减少基础设施工作的团队。持续保持较高利用率时,自有 GPU 的成本可能更低,但实际结果取决于硬件的使用频率、使用寿命、电费和工程投入。
本指南比较了 2026 年训练视觉模型的四种常见方案,介绍如何计算适合你自身工作负载的盈亏平衡点,并说明 Ultralytics Platform 的定位。
训练视觉模型的四种方案#
“托管式与自托管”通常涵盖四种不同的配置:
- 托管式视觉训练平台。 你上传或连接数据集,选择模型和 GPU,然后由平台运行训练。Ultralytics Platform 就是这样为 YOLO 模型提供服务的。
- 通用 ML 平台。 Amazon SageMaker、Google Vertex AI 和 Azure Machine Learning 等服务可在云实例上为多种框架运行训练作业。你需要配置训练作业、环境、权限和存储,计算资源及相关服务则单独计费,因此比较时应查看各服务商的官方定价页面,而不要只看 GPU 费率。
- 租用云 GPU。 RunPod 和 Lambda 等 GPU 云服务按使用时长出租机器。除非服务商提供的镜像已包含所需环境,否则你需要配置驱动、CUDA、Python 包和训练代码,并在完成后停止实例。
- 自有 GPU。 放在办公室或数据中心的工作站或服务器。你一次性购买硬件,并承担电费、制冷、维护以及确保设备持续运行所需的时间成本。
托管式训练与自托管 GPU 一览#
| 决策因素 | 托管式视觉平台 | 通用 ML 平台 | 租用云 GPU | 自有 GPU |
|---|---|---|---|---|
| 是否需要购买硬件 | 否 | 否 | 否 | 是 |
| 付费项目 | GPU 使用时长 | 实例使用时长及相关服务 | 实例运行期间的使用时长 | 硬件、电力、维护 |
| 首次运行前的设置 | 选择数据集、模型和 GPU | 配置作业、环境、权限和存储 | 设置或验证环境、代码和依赖项 | 硬件、操作系统、驱动、软件包 |
| 训练环境 | 由平台运行;你选择设置 | 服务和你的团队共同管理 | 主要由你的团队管理 | 你的团队 |
| 如何换用更大的 GPU | 选择其他可用 GPU | 选择其他实例类型 | 租用另一台机器 | 购买另一块 GPU |
| 数据位置 | 平台存储、连接的云存储桶(Pro 和 Enterprise),或本地部署的数据(Enterprise) | 你的云账户 | 你将数据复制到的任何位置 | 你的本地环境 |
| 适用场景 | 快速、可重复的视觉训练 | 已将某一家云服务的 ML 工具作为标准的团队 | 熟悉机器管理的工程师 | 持续、近乎不间断的训练,或严格的本地部署要求 |
托管式 GPU 训练如何计费#
在 Ultralytics Platform 上,训练运行的 GPU 部分很容易估算:
GPU cost = selected GPU hourly rate × billable GPU hours比较服务商时,应使用相同的工作负载和目标精度,并将订阅、存储、数据传输和工程时间的成本一并计入。
Ultralytics Platform 提供 26 种 NVIDIA GPU, 价格从每小时 $0.24 起,且没有最低使用量或承诺期限;Free 计划可使用其中 24 种,Pro 和 Enterprise 计划则可使用全部 26 种。以下是几种常见选择:
| GPU | 显存 | 每小时价格 |
|---|---|---|
| RTX 4090 | 24 GB | $0.89 |
| A100 SXM | 80 GB | $1.79 |
| RTX PRO 6000(推荐默认选择) | 96 GB | $2.49 |
| H100 SXM | 80 GB | $3.99 |
| B200(Pro 和 Enterprise 计划) | 180 GB | $7.99 |
计费依据实际 GPU 使用时长。已完成、已取消,以及 GPU 启动后失败的运行,均按已使用的 GPU 时长计费;GPU 启动前发生的失败则不收费。训练对话框会在你启动前估算时长和费用,每次估算至少会从余额中预留 15 分钟的 GPU 使用时长;这项预留决定了启动所需的余额,而实际计费仍依据实际 GPU 使用时长。
作为参考,Ultralytics 给出的 典型训练时长显示,在 RTX PRO 6000 上使用 1,000 张图像训练 100 个 epoch,YOLO26m 大约需要 15 分钟,YOLO26x 大约需要 30 分钟。按每小时 $2.49 计算,GPU 使用费用约为 $0.62 和 $1.25。实际运行时长会随图像尺寸、数据增强和批量大小而变化,因此这些数据只能作为初步参考,而非报价。
自托管 GPU 的实际成本#
自有 GPU 没有按小时收取的费用,但每次运行并非免费。总成本包括:
- 硬件,以及 GPU 所在工作站或服务器的其他部分。
- 每小时训练所需的电力和制冷。
- 用于处理驱动、CUDA 版本、软件包冲突和环境故障的工程时间。
- 闲置时间。 如果 GPU 每天只训练两小时,其余时间都处于闲置状态,每小时训练成本就会相应上升。
- 容量限制。 当模型所需的显存超过你现有的容量,或多个实验需要同时运行时,你只能等待或购买更多硬件。
简化硬件和电力成本比较时,假设自有 GPU 与云 GPU 的训练速度相同:
Break-even hours = hardware cost ÷ (cloud hourly rate − your power cost per hour)举例来说,假设一台 RTX 4090 工作站花费 $3,000,每小时训练的电费约为 $0.10。与每小时 $0.89 的 RTX 4090 云 GPU 相比,训练约 3,800 小时后达到盈亏平衡:全天候使用约需 5.3 个月,每天使用八小时则约需 15.8 个月。这还不包括制冷、闲置时的电力、维修、融资、转售价值和你投入的时间;只有在硬件的使用寿命内完成相应训练量,购置硬件才划算。请使用实际硬件报价、电价和预期训练时长进行计算;利用率不同,结果会有很大变化。
自托管 GPU 适用场景#
以下情况更适合购买自有硬件:
- GPU 持续繁忙。 持续重新训练、大规模超参数搜索,或团队整天共用一台机器,都能提高利用率,使其接近盈亏平衡点。
- 数据不能离开本地环境。 某些受监管或隔离网络环境完全禁止云端训练。
- 你已经有硬件。 如果有性能足够的 GPU 闲置着,在购买更多硬件前,应比较其运行成本和训练时长与云方案的差异。
- 你需要完全控制 驱动、内核或托管平台不支持的自定义训练代码。
托管式训练适用场景#
以下情况更适合使用托管式平台:
- 训练需求是间歇性的。 数据发生变化时进行训练,之后可能连续几天都不需要训练。
- 你想今天就开始。 首次运行前无需安装驱动、处理 CUDA 版本不匹配或调试环境。
- 模型大小不一。 你可以用小型 GPU 训练 nano 模型,也可以用 80 GB 或更大显存的 GPU 训练大型模型,而无需购买任何一款 GPU。
- 有多人参与训练。 运行记录、指标和检查点都集中存放在同一处,而不是分散在每个人的机器上。
混合方案:自有 GPU 搭配托管式仪表盘#
你不必非此即彼。Ultralytics Platform 支持远程训练:你使用 ultralytics 包在自有 GPU 上训练,将实时指标流式传输到与云端运行相同的 Platform 仪表盘,并在训练结束后上传最终权重。远程运行使用的是你自己的 GPU,而不是 Ultralytics 云 GPU,因此不会占用云 GPU 使用时长。
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.train(
    data="coco8.yaml",
    epochs=100,
    project="username/my-project",  # 你的 Platform 项目
    name="local-gpu-run",
)
先使用 export ULTRALYTICS_API_KEY="YOUR_API_KEY" 设置 API 密钥。Platform 集成要求 Python 3.11 或更高版本,以及 ultralytics 8.4.120 或更高版本。常见做法是先在本地 GPU 上进行快速实验,然后在本地机器繁忙时,将规模更大或时间要求更紧的运行任务交给云 GPU。
如何使用 Ultralytics Platform 在托管式 GPU 上训练 YOLO26#
- 创建账户:访问 platform.ultralytics.com。新账户可获得 $5 注册额度;验证工作邮箱后可获得 $25。
- 添加数据集:上传图像和标签,或在 Pro 或 Enterprise 计划下连接 Amazon S3 存储桶。
- 打开训练对话框,选择 YOLO26 模型,并设置 epoch 数和图像尺寸。
- 选择 GPU。 RTX PRO 6000 是推荐的默认选择;如需了解不同方案的取舍,请参阅如何选择云 GPU。
- 查看费用估算,启动训练,并持续查看实时指标,直到运行结束。
Free 计划最多可同时运行 3 个云端训练作业。每个席位每月 $29 的 Pro 计划将上限提高到 10 个,并为每个席位每月提供 $30 额度。
训练完成后,你可以导出模型,也可以将其部署为 API。如果你还在决定推理应在哪里运行,我们的云端与自托管视觉 AI 对比指南会比较部署成本、延迟和数据控制。
常见问题
有可能,尤其是在训练需求间歇性出现时,因为你只需为实际使用的 GPU 时长付费。请比较相同工作负载的总成本和完成时间;上文的盈亏平衡计算(硬件成本除以云端每小时费率减去每小时电力成本)只能作为起点,并非保证。
租用云 GPU 会为你提供一台机器,而你的团队需要配置训练工作负载,并检查或设置环境。托管式训练平台则负责更多工作流程:在 Ultralytics Platform 上,你选择数据集、模型和 GPU,平台会配置 GPU、运行训练、传输实时指标并保存检查点。
在 Ultralytics Platform 上,云 GPU 启动后失败的运行会按已使用的 GPU 时长收费;GPU 启动前失败则免费。取消的运行会按取消前的 GPU 使用时长收费。
可以。远程训练会在你的自有硬件上运行,将实时指标传输到 Platform,并上传最终权重,因此不会占用云 GPU 使用时长。
RTX PRO 6000(96 GB)是大多数作业的推荐默认选择。Ultralytics 推荐 RTX 4090 用于常规训练,A100 SXM 用于大批量或更大型的模型,H100、H200、B200 和 B300 GPU 则适用于对时效性要求高、显存需求大或规模最大的工作负载。
新的 Ultralytics Platform 账户可获得 5 美元注册额度,验证工作邮箱后额度将提高到 25 美元。Pro 套餐每月为每个席位提供 30 美元额度。
不能。Kubernetes 可以调度 GPU 工作负载,但其 GPU 调度文档要求在节点上安装 GPU 驱动程序和供应商设备插件。自行管理的训练集群仍需要有人负责环境、权限、作业监控和检查点,因此除了计算资源之外,也要为这部分工作预留预算。
作者
评论
提出问题、分享你的结果,或帮助其他人。









