计算机视觉推理中的 ONNX 与 TensorRT:基准测试及如何选择
ONNX Runtime 与 TensorRT 在计算机视觉推理中的对比:在 19 款 NVIDIA GPU 上测量 Ultralytics YOLO26 的速度和准确率,以及如何选择。
 Miles Deans9 分钟阅读
ONNX 和 TensorRT 并非真正的竞争对手。ONNX 是一种模型格式,而 TensorRT 是 NVIDIA 的推理引擎,通常以 ONNX 文件作为输入。真正需要选择的是如何运行该文件:使用 ONNX Runtime,它支持多种硬件,甚至可以将工作交给 TensorRT;或者将文件编译成独立的 TensorRT 引擎,但这种引擎只能在 NVIDIA GPU 上运行。在对 19 款 NVIDIA GPU 上的 Ultralytics YOLO26 进行的 Ultralytics Platform 基准测试中,每款 GPU 和每种模型尺寸下,TensorRT FP16 都比公布的 ONNX FP16 结果更快,准确率差异在 0.001 mAP50-95 以内。不同模型尺寸的中位数加速比为 1.85x 至 2.55x。基准测试没有说明 ONNX 结果使用了哪个 ONNX Runtime 执行提供程序,因此无法据此确定 ONNX Runtime 的整体表现,也无法确定它与 TensorRT 执行提供程序搭配时的表现。对于运行在 NVIDIA GPU 上的 Ultralytics YOLO26,如果延迟很重要,可以先尝试 TensorRT FP16;如果同一个模型文件需要在多种硬件上运行,则使用 ONNX Runtime。Ultralytics YOLO 只需一个参数即可导出为这两种格式。
从哪里开始使用 Ultralytics YOLO:
| 部署 | 从这里开始 | Ultralytics YOLO 导出 |
|---|---|---|
| NVIDIA GPU,且延迟很重要 | TensorRT FP16 | format="engine", quantize=16 |
| CPU、非 NVIDIA 硬件或混合设备集群 | ONNX Runtime | format="onnx" |
| NVIDIA GPU 上的 ONNX Runtime API | 搭配 TensorRT 执行提供程序的 ONNX Runtime | format="onnx" |
ONNX 与 TensorRT:格式、运行时和引擎#
这个比较涉及三种不同的东西:
- ONNX(开放神经网络交换)是一种文件格式,能够以不依赖框架的方式存储训练后模型的计算图和权重。你可以将模型从 PyTorch 导出为 ONNX,以便其他工具读取模型。
- ONNX Runtime 用于运行 ONNX 模型。它会将任务交给称为 执行提供程序 的硬件后端,例如 CPU、CUDA 和 TensorRT,因此同一个文件既能在笔记本电脑的 CPU 上运行,也能在云端 GPU 上运行。
- TensorRT 通过 ONNX 解析器读取模型,通常读取的是 ONNX 文件。它会融合层、为所构建的 GPU 上的每项操作选择最快的内核,并生成经过优化的 引擎。
所以,真正要比较的是 ONNX Runtime 和 TensorRT。ONNX Runtime 也可以通过其 TensorRT 执行提供程序调用 TensorRT,这样你就可以保留 ONNX Runtime 的 API,同时由 TensorRT 运行它支持的子图。ONNX Runtime 建议在其后注册 CUDA 执行提供程序,这样 TensorRT 不支持的节点就可以改由 CUDA 运行。
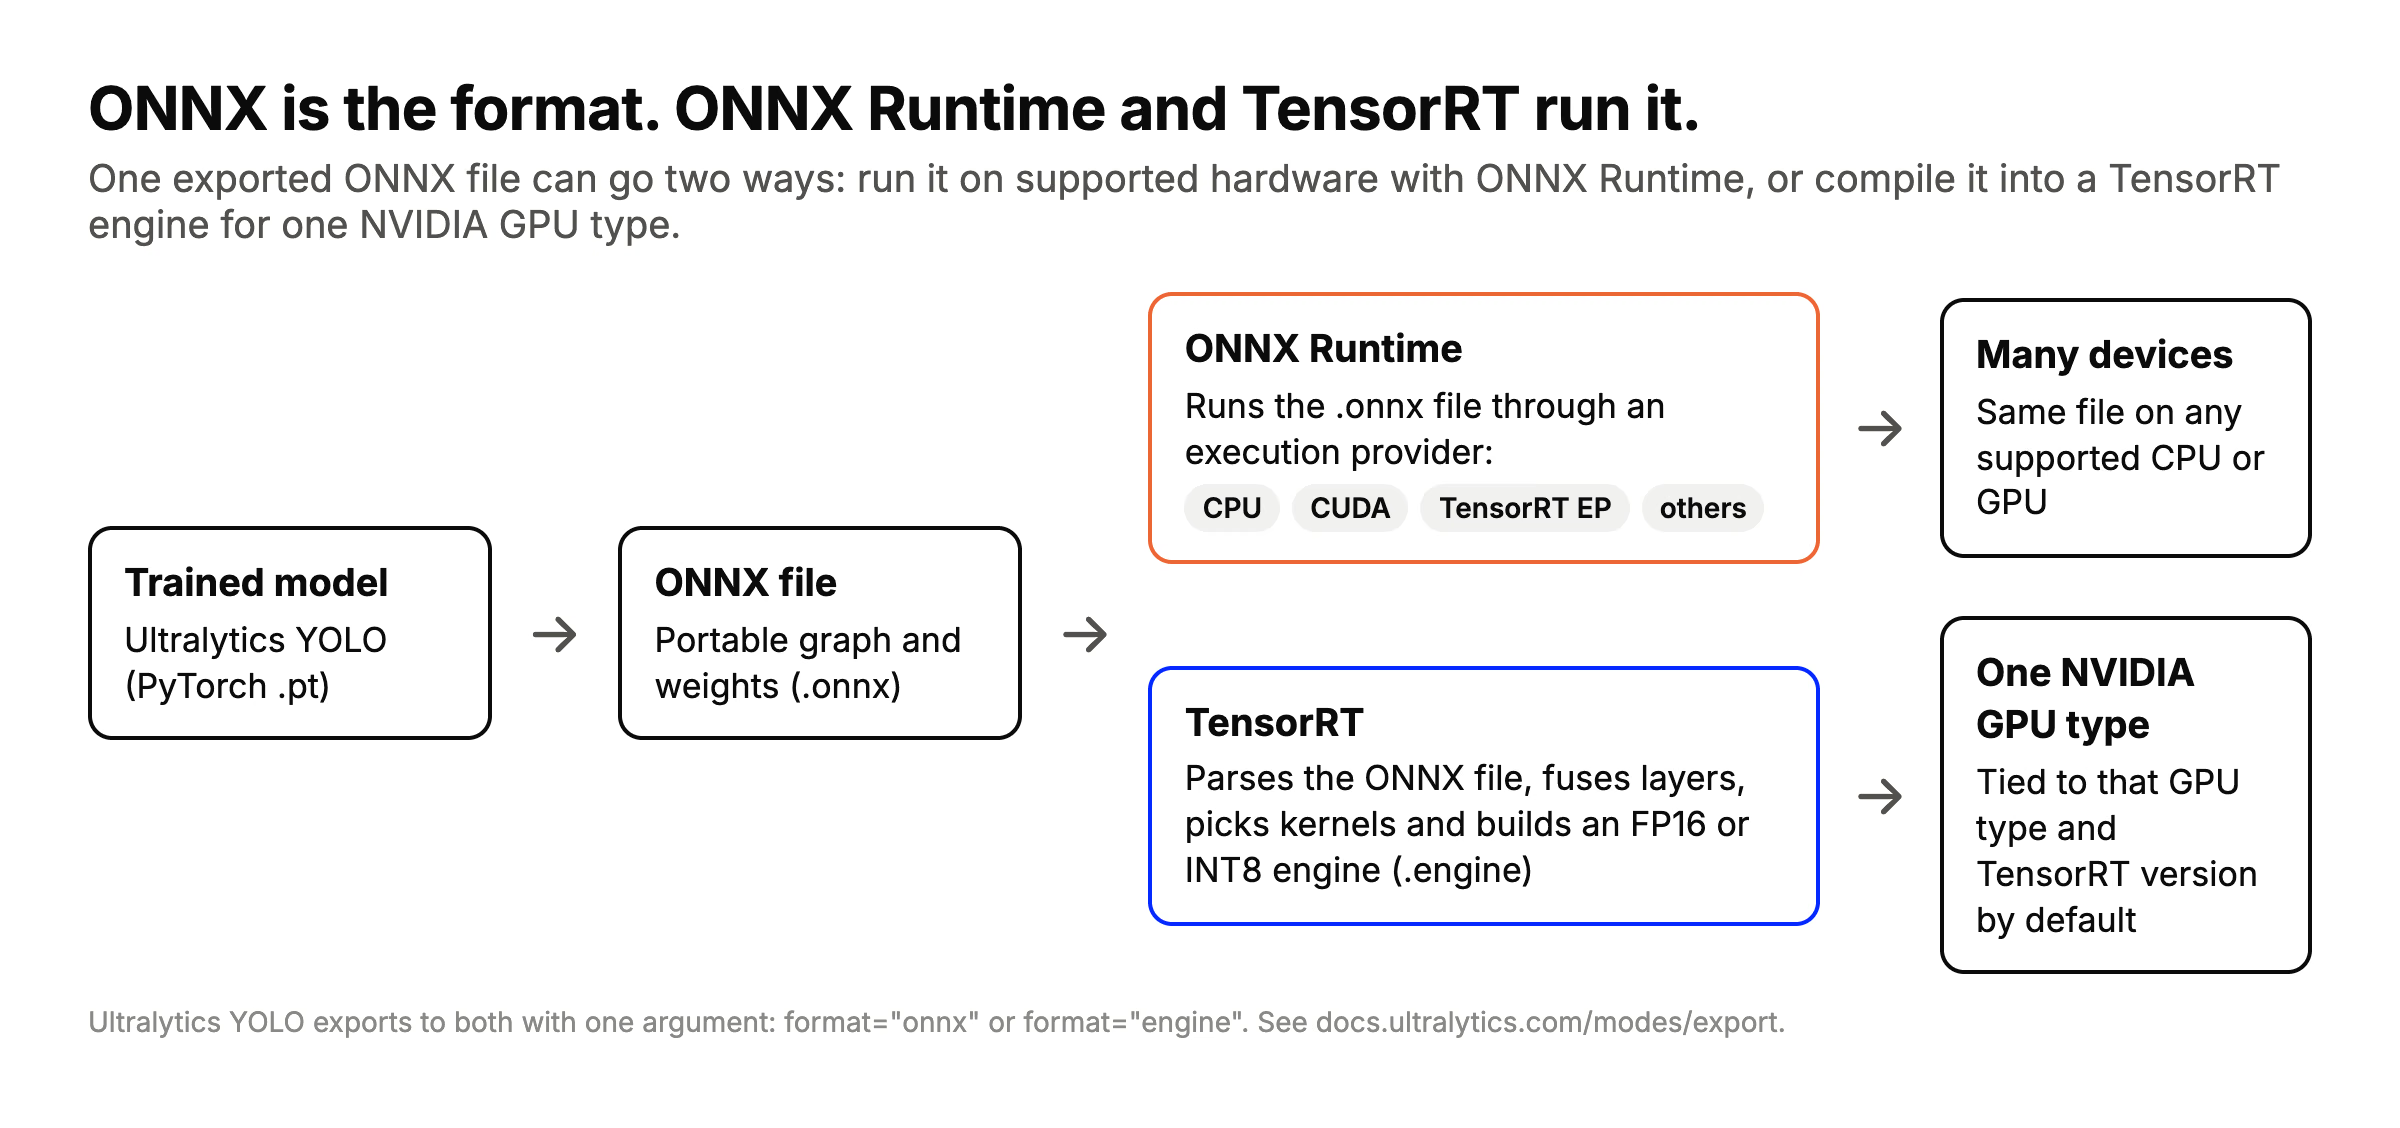
一个 ONNX 文件,两种路径:ONNX Runtime 可在支持的硬件上运行该文件,而 TensorRT 会将其编译成适用于一种 NVIDIA GPU 类型的引擎。Ultralytics YOLO 可导出为这两种格式。
基准测试:YOLO26 在 ONNX Runtime 与 TensorRT 上的表现#
以下数据来自 Ultralytics Platform 推理基准测试。每个 Ultralytics YOLO26 检测模型都导出为表中所示的格式,然后在 Ultralytics Platform GPU 上,以批次大小 1 和 640 像素的输入,在 COCO val2017 上测量其推理延迟;测量时排除了预热阶段,并对每次运行的耗时进行了 sigma 截断。准确率是模型在 COCO val2017 上的 mAP50-95,每种格式和精度各测量一次。比较范围为 19 款 NVIDIA GPU(Ampere、Ada 和 Hopper),这些 GPU 均有四种格式的测试结果。
基准测试页面未说明 ONNX 结果使用了哪个 ONNX Runtime 执行提供程序,也没有将任何结果标注为使用 ONNX Runtime 的 TensorRT 执行提供程序;后者会将模型中受支持的部分交给 TensorRT 运行。这些 ONNX 结果反映的是基准测试所用的配置;实际性能会因 ONNX Runtime 执行提供程序而异。如果你想使用底层由 TensorRT 执行的 ONNX Runtime API,请在自己的硬件上对这种组合进行基准测试。
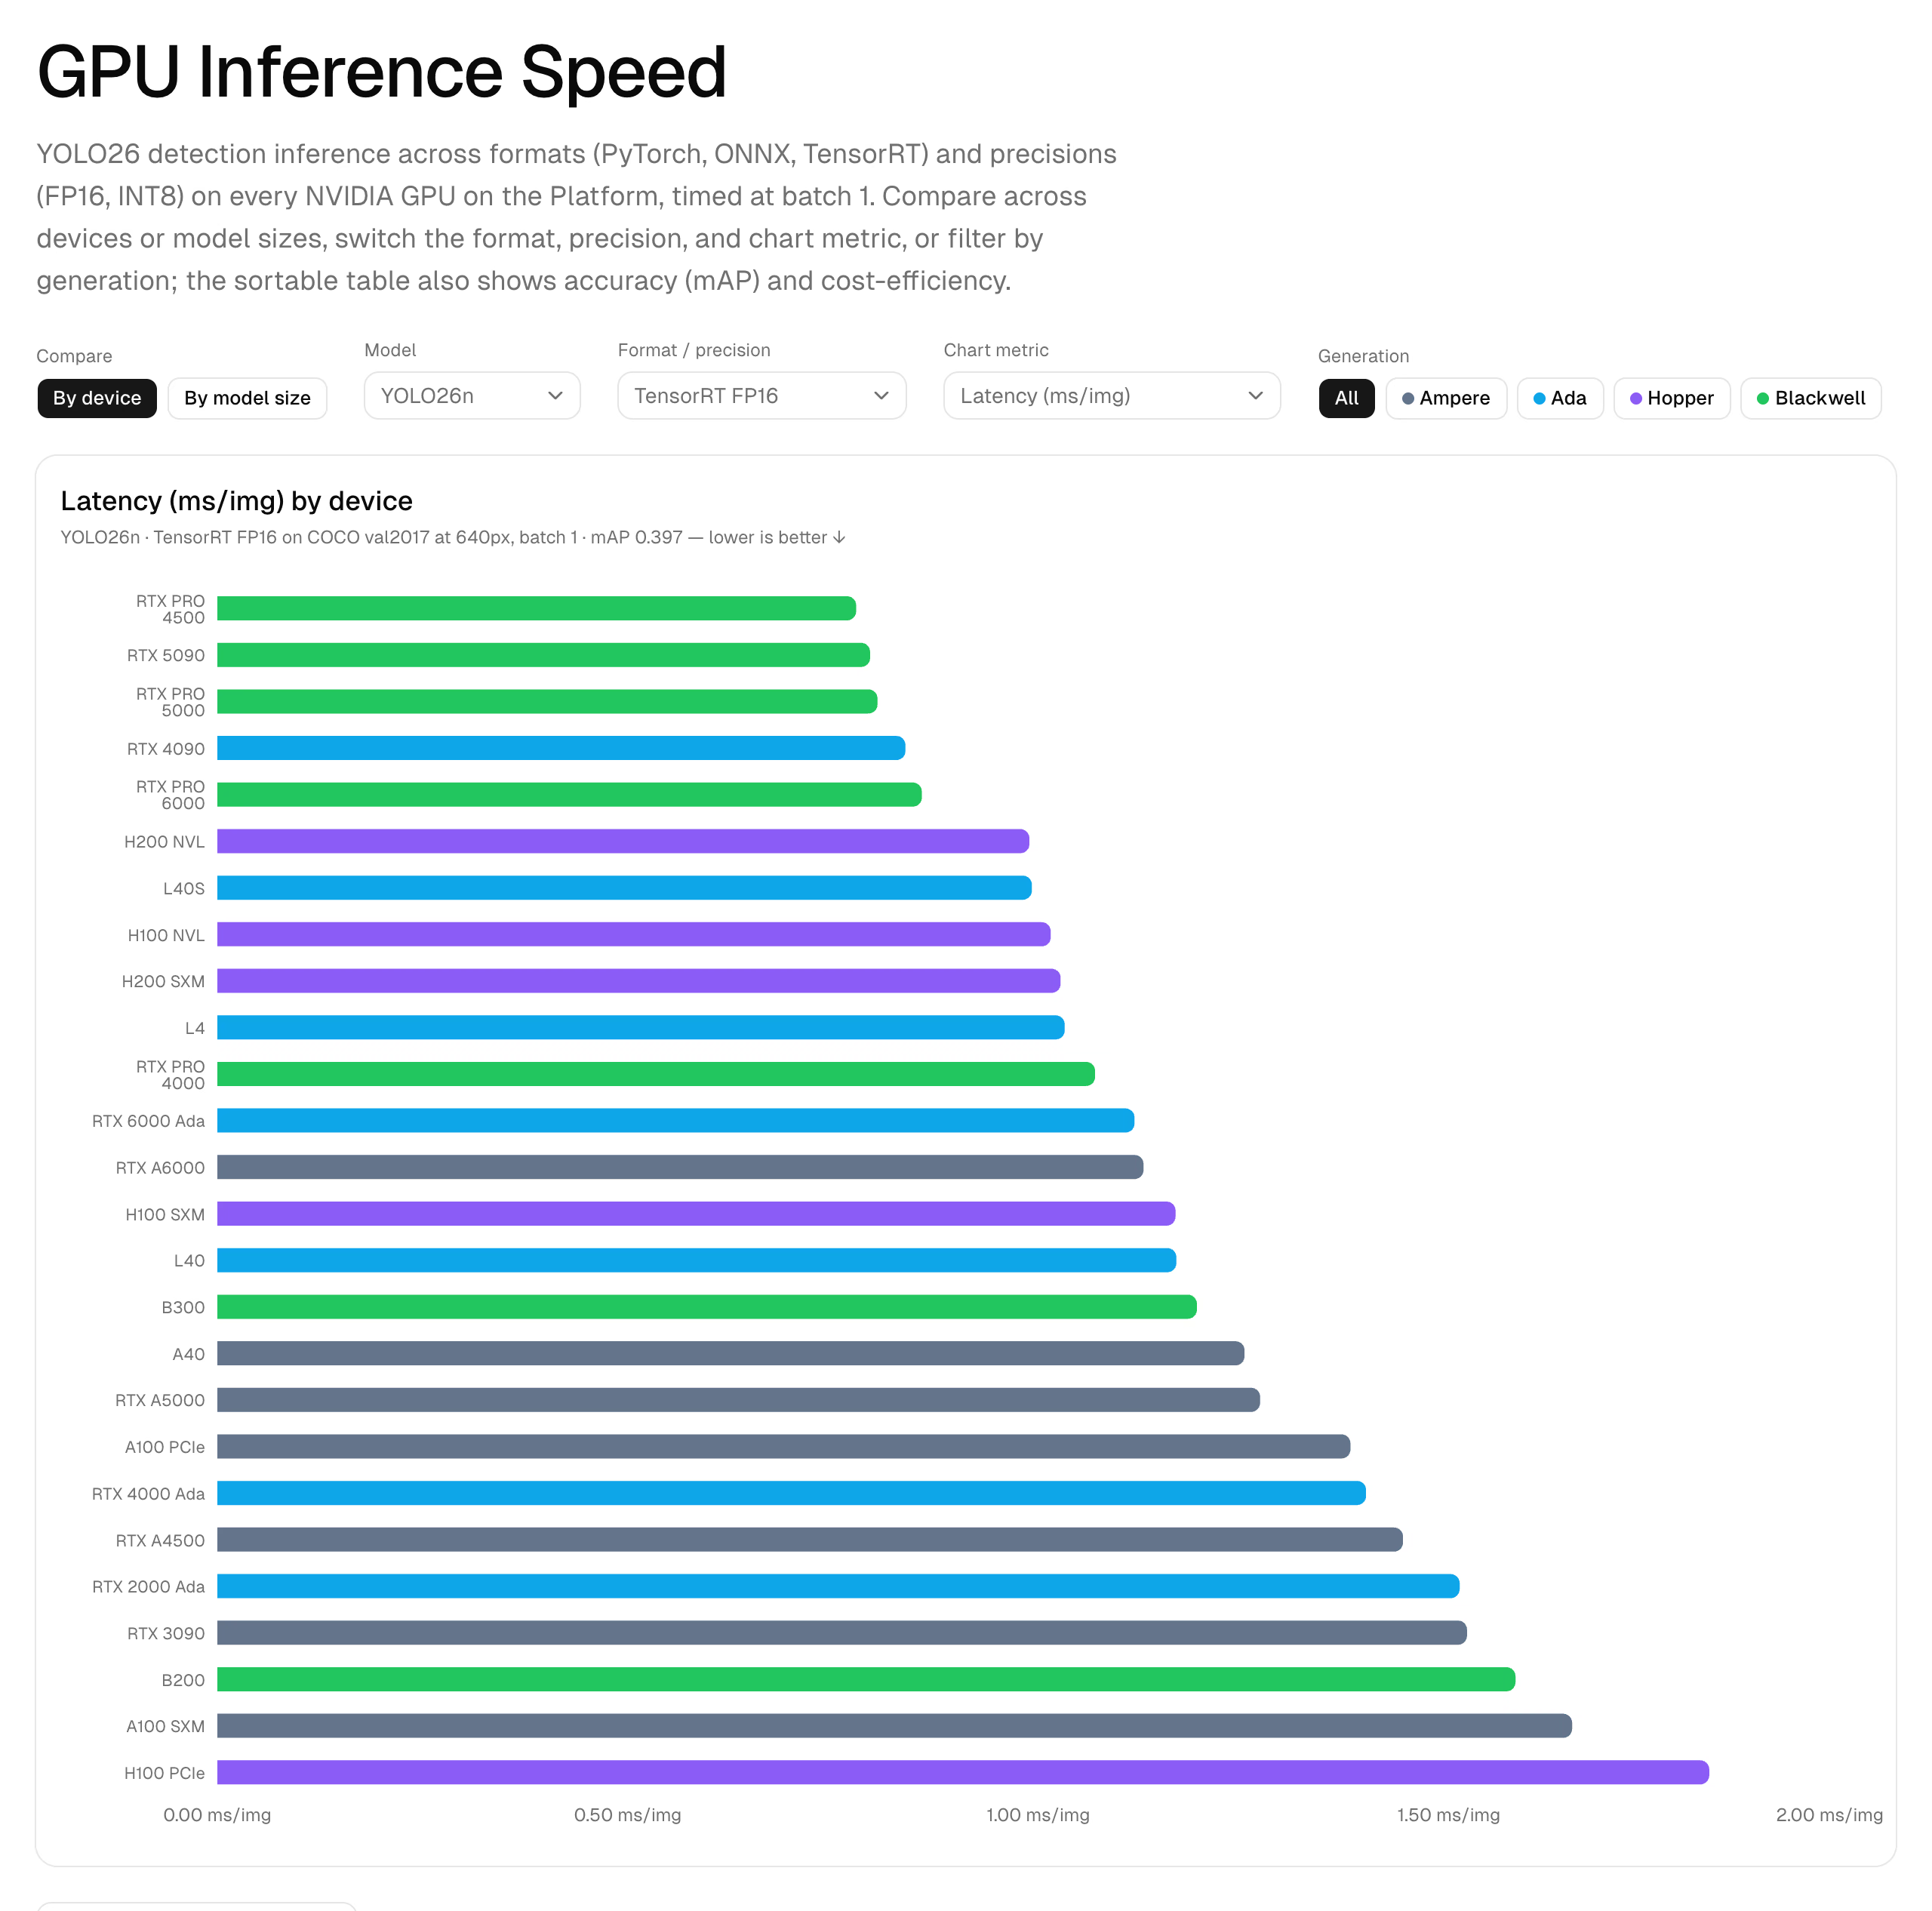
你可以在推理选项卡中切换模型尺寸、格式和精度,然后按延迟、准确率或成本对所有 GPU 排序。
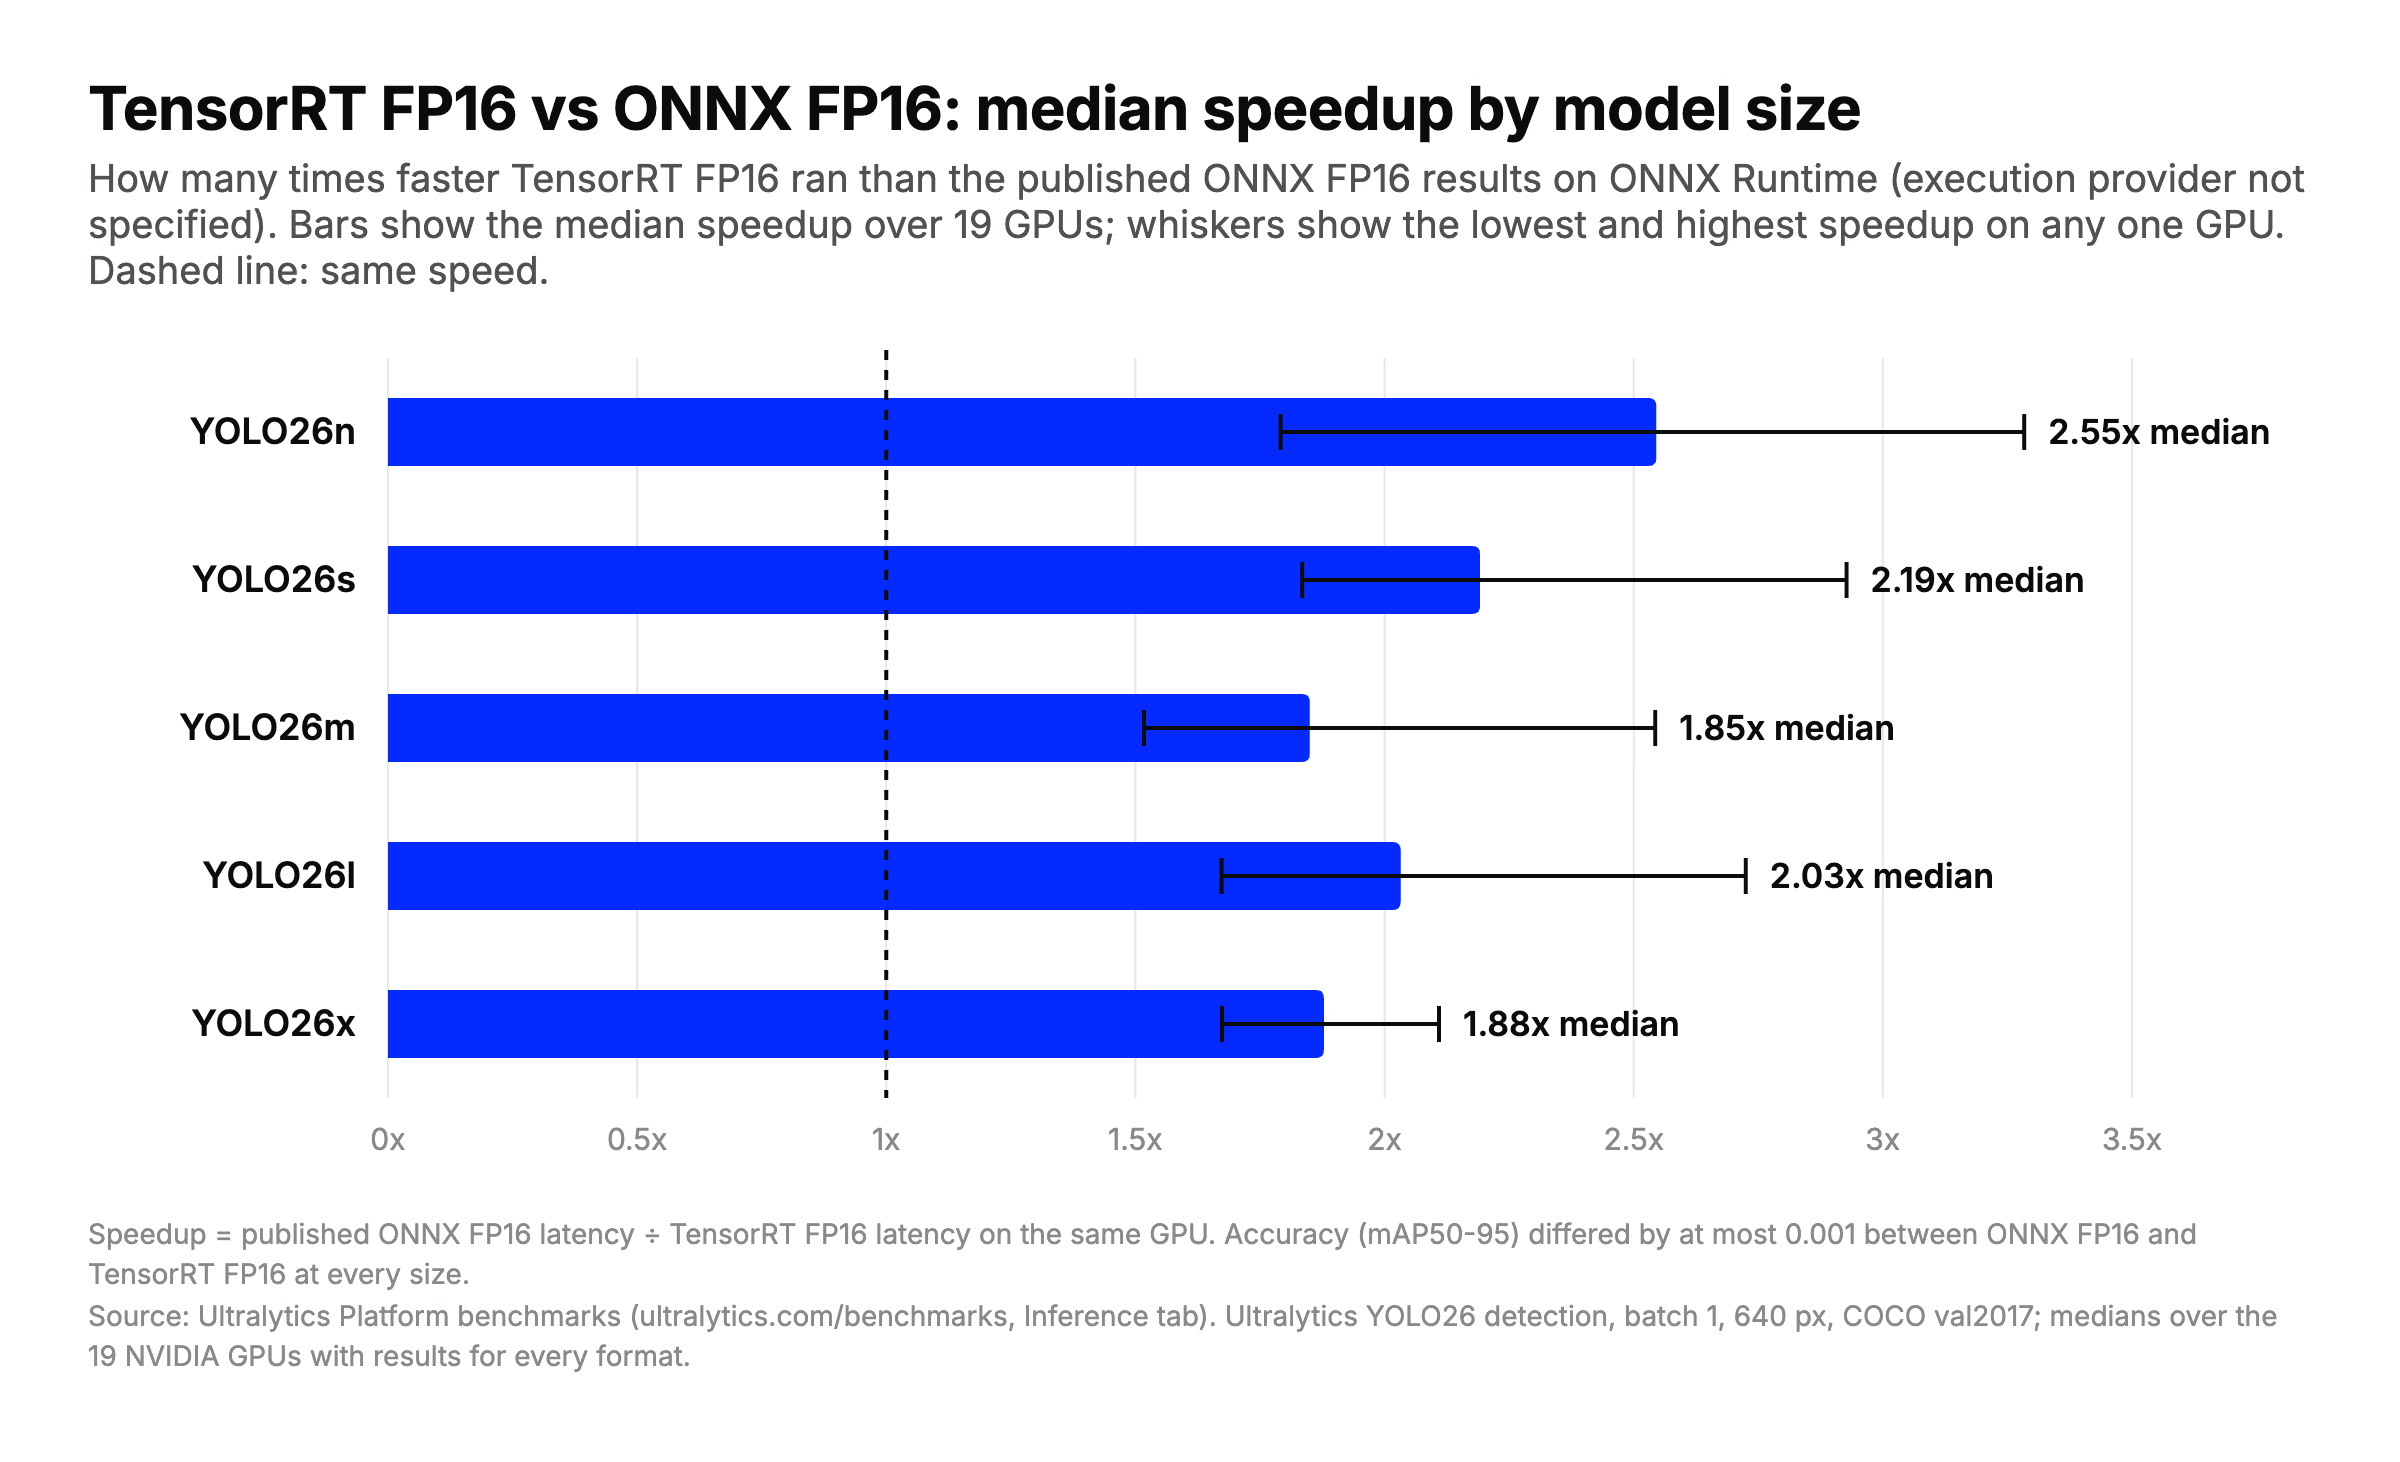
在每种模型尺寸和所有 GPU 上,TensorRT FP16 都比公布的 ONNX FP16 结果更快;页面未说明这些 ONNX 结果使用了哪个 ONNX Runtime 执行提供程序。柱状条显示 19 款 GPU 上的中位数加速比;误差线显示单款 GPU 上的最低和最高加速比。数据根据 Ultralytics Platform 推理基准测试计算。
| 模型 | mAP50-95:ONNX FP16 | mAP50-95:TensorRT FP16 | mAP50-95:TensorRT INT8 | TensorRT FP16 相较于 ONNX FP16 的加速比(中位数、范围) | TensorRT INT8 相较于 TensorRT FP16 的加速比(中位数、范围) |
|---|---|---|---|---|---|
| YOLO26n | 0.397 | 0.397 | 0.357 | 2.55x(1.79–3.28x) | 0.90x(0.79–1.07x) |
| YOLO26s | 0.471 | 0.471 | 0.436 | 2.19x(1.83–2.93x) | 1.04x(0.89–1.19x) |
| YOLO26m | 0.519 | 0.519 | 0.470 | 1.85x(1.52–2.54x) | 1.20x(0.90–1.38x) |
| YOLO26l | 0.536 | 0.535 | 0.501 | 2.03x(1.67–2.73x) | 1.08x(0.92–1.33x) |
| YOLO26x | 0.563 | 0.564 | 0.488 | 1.88x(1.67–2.11x) | 1.19x(0.92–1.67x) |
根据 Ultralytics Platform 推理基准测试计算。加速比的计算方式为同一款 GPU 上的 ONNX FP16 延迟 ÷ TensorRT FP16 延迟,或 TensorRT FP16 延迟 ÷ TensorRT INT8 延迟,因此大于 1x 表示 TensorRT FP16(或 INT8)更快。中位数基于拥有全部四种格式测试结果的 19 款 NVIDIA GPU 计算;范围为这些 GPU 上的最小值和最大值。准确率是每种格式和精度对应的报告 mAP50-95。ONNX FP16 指公布的 ONNX Runtime 结果,其执行提供程序未作说明。
基准测试页面公布的四款常见 GPU 延迟,单位为毫秒/图像:基准测试页面:
| GPU | 模型 | PyTorch FP16 | ONNX FP16 | TensorRT FP16 | TensorRT INT8 |
|---|---|---|---|---|---|
| L4 | YOLO26n | 4.98 | 2.04 | 1.03 | 1.09 |
| L4 | YOLO26x | 7.76 | 9.80 | 5.73 | 3.43 |
| RTX 4090 | YOLO26n | 6.67 | 2.56 | 0.84 | 1.00 |
| RTX 4090 | YOLO26x | 10.94 | 5.20 | 2.68 | 2.25 |
| A100 SXM | YOLO26n | 8.72 | 3.98 | 1.65 | 1.79 |
| A100 SXM | YOLO26x | 15.02 | 7.25 | 3.86 | 3.91 |
| H100 SXM | YOLO26n | 6.36 | 3.09 | 1.17 | 1.48 |
| H100 SXM | YOLO26x | 10.26 | 5.53 | 2.66 | 2.62 |
有三点值得注意:
- TensorRT FP16 在所有 GPU 和所有模型尺寸上的表现都优于公布的 ONNX FP16 结果,准确率差异在 0.001 mAP50-95 以内。如果你要在这些 NVIDIA GPU 上部署并且需要较低延迟,可以先尝试 TensorRT FP16。
- INT8 并非总能带来优势。在 YOLO26n 上,它在 19 款 GPU 中有 17 款的速度都慢于 TensorRT FP16,并且 mAP50-95 下降了 0.04。在较大的模型上,INT8 更常带来加速;例如,在 L4 上的 YOLO26x 加速比最高可达 1.67x,但 mAP50-95 会下降 0.034 至 0.076。
- 七款 Blackwell GPU 没有 ONNX 结果。基准测试页面将此归因于测试环境中的 ONNX Runtime 没有 Blackwell 内核。TensorRT 则在这七款 GPU 上都运行了。
这些结果涵盖了基准测试页面所示的配置,即批次大小为 1、输入为 640 像素;因此,在做出选择之前,请使用自己的数据,在部署设备上对自己的模型进行基准测试。
TensorRT 中的 FP16 与 INT8#
降低精度是另一个重要的优化手段,而基准测试说明了为什么需要进行测试:
- FP16(半精度)会将权重和激活值的大小减半,相较于 FP32。在 Ultralytics Platform 基准测试中,TensorRT FP16 的准确率与 ONNX FP16 和 PyTorch FP16 相差不超过 0.003 mAP50-95。
- INT8 使用 8 位整数存储权重和激活值,这是一种模型量化方式。它需要进行校准:使用一组有代表性的图像运行模型,以测量激活值范围。Ultralytics Platform 基准测试使用 NVIDIA ModelOpt,并以 COCO128 作为校准数据。
正如基准测试方法所述,INT8 在计算受限的大型模型上最能发挥优势。在最小的模型上,额外的量化操作可能与 FP16 的耗时相当,甚至会让速度变慢。请使用来自你自己领域的图像进行校准,并在部署 INT8 引擎之前用自己的数据验证准确率。
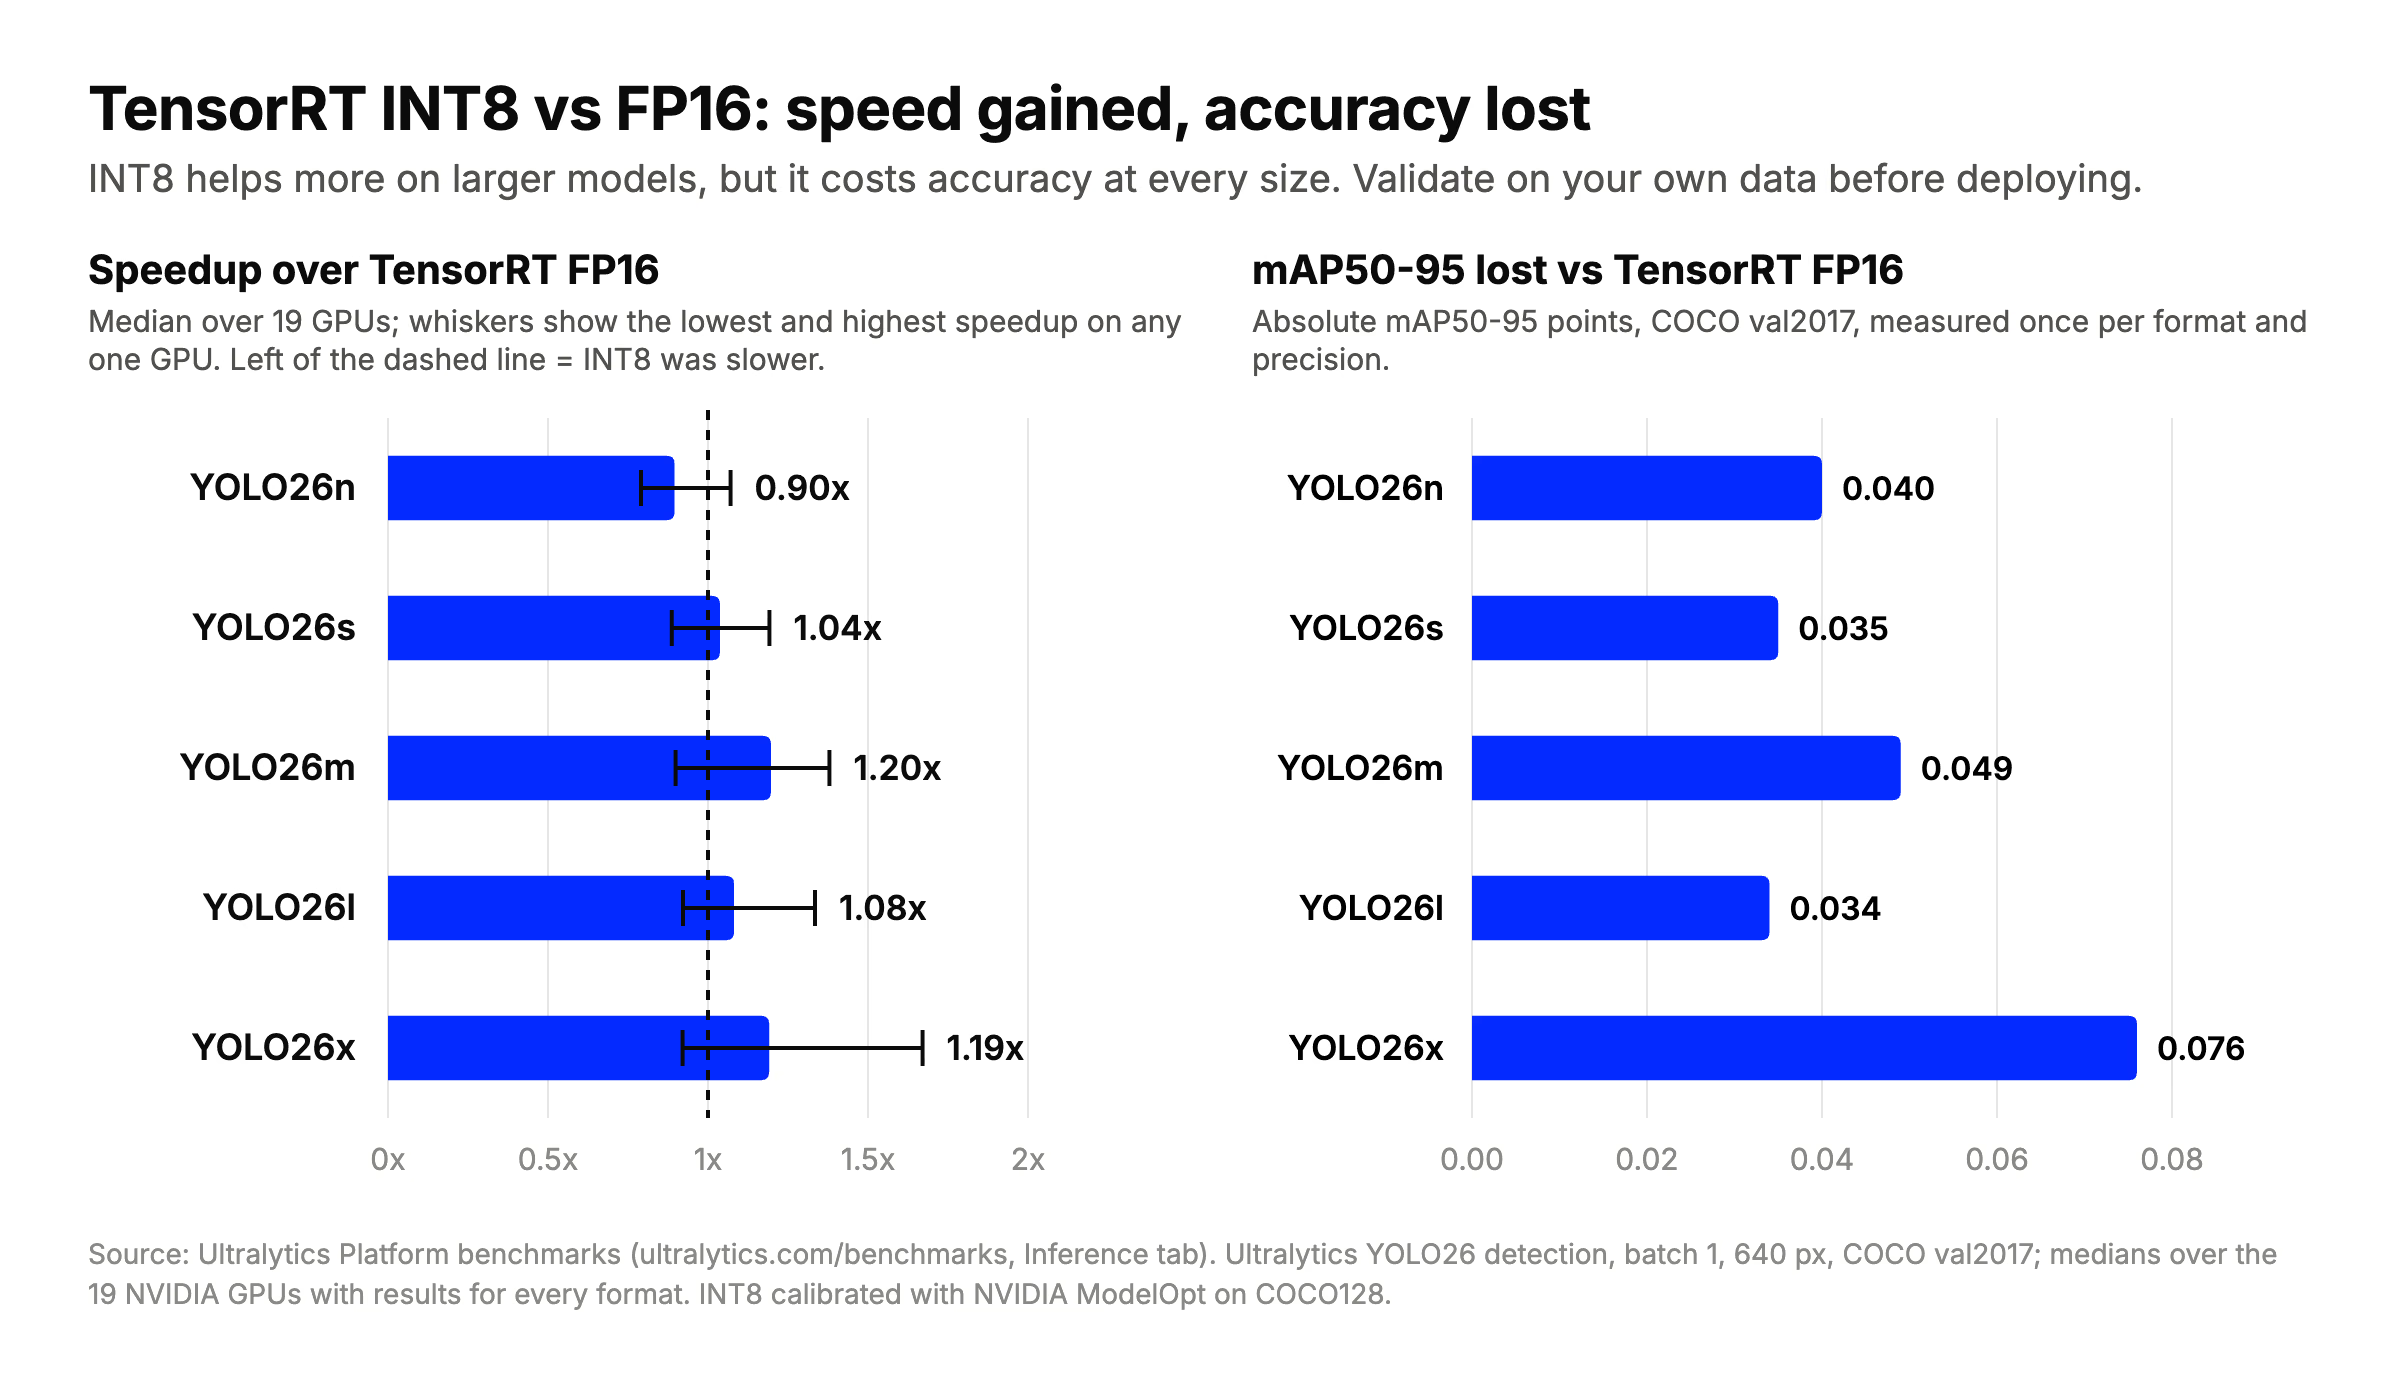
在 19 款 GPU 上,INT8 的中位数速度在 YOLO26n 上慢于 FP16,在较大的模型上最高快约 1.2x;但所有模型尺寸的 mAP50-95 都下降了 0.034 至 0.076。数据根据 Ultralytics Platform 推理基准测试计算。
引擎的可移植性与动态输入尺寸#
默认情况下,TensorRT 引擎与构建它的 GPU 和 TensorRT 版本绑定,因此,在 RTX 4090 上构建的引擎不适合直接复制到 H100 或 Jetson 上。TensorRT 提供了硬件和版本兼容性选项来放宽这些限制,但稳妥的默认做法是在要部署的设备上构建引擎,或为该设备构建引擎,并在升级 TensorRT 后重新构建。出于这个原因,Ultralytics Platform 的导出选项卡会要求你为 TensorRT 导出选择 GPU 类型。ONNX 文件没有这种限制:只要有 ONNX Runtime 和合适的执行提供程序,同一个文件就能运行。
两种格式都支持可变输入尺寸。对于 TensorRT,动态形状需要一个优化配置文件,用来设置输入尺寸的最小值、最优值和最大值;运行时的输入必须在该范围内。导出 Ultralytics YOLO 模型时,dynamic=True 会为 ONNX 和 TensorRT 启用动态输入形状。正如 NVIDIA 的动态形状指南所述,固定形状能让 TensorRT 有更多优化空间,因此只有在输入确实会变化时才使用动态形状,并对两种方式都进行基准测试。
何时选择 ONNX Runtime,何时选择 TensorRT#
- 云端或本地部署的 NVIDIA GPU,且延迟很重要:选择 TensorRT,从 FP16 开始。较大的模型可以尝试 INT8,但要先校准并验证。
- 边缘端的 NVIDIA Jetson:选择 TensorRT。请参阅 NVIDIA Jetson 指南。
- CPU、非 NVIDIA 硬件或混合设备集群:使用 ONNX 和 ONNX Runtime,并选择每台机器支持的执行提供程序。
- 还不确定部署硬件:先导出为 ONNX。之后你可以从同一个模型构建 TensorRT 引擎。
- Intel CPU、GPU 或 NPU:可以考虑使用 Intel 的推理工具包 OpenVINO。
如需了解格式完整列表及其对比,请参阅模型部署选项指南。精度也不是唯一的优化手段:模型尺寸和输入分辨率同样重要;我们的剪枝与量化指南还介绍了另外两种缩小模型的方法。
将 Ultralytics YOLO 导出为 ONNX 和 TensorRT#
使用一个 format 参数,Ultralytics YOLO 就能导出为这两种格式;你还可以直接使用导出的模型进行预测或验证:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

model.export(format="onnx", quantize=16)  # ONNX FP16,用于 ONNX Runtime
model.export(format="engine", quantize=16)  # TensorRT FP16 引擎,在此 GPU 上构建
# 若要改用 INT8,请使用数据集 YAML 进行校准(coco8.yaml 是一个小型演示数据集;请使用你自己的数据集):
# model.export(format="engine", quantize=8, data="coco8.yaml")

trt_model = YOLO("yolo26n.engine")
results = trt_model("https://ultralytics.com/images/bus.jpg")
quantize=16 用于选择 FP16,quantize=8 用于选择 INT8。两种引擎导出都会写入 yolo26n.engine,因此每次只运行其中一种。对于 INT8,请将 data 指向你自己的数据集 YAML,以便使用类似于实际部署场景的图像进行校准。如需了解所有选项,请参阅导出参数以及 ONNX 和 TensorRT 集成指南;也可以按照我们的分步文章学习导出为 ONNX和使用 TensorRT 优化。你也可以在 Ultralytics Platform 上通过浏览器导出训练好的模型。
常见问题
ONNX 是模型格式,而不是引擎,因此公平的比较对象是 ONNX Runtime 和 TensorRT。在对 19 款 NVIDIA GPU 上的 Ultralytics YOLO26 进行的 Ultralytics Platform 基准测试中,每款 GPU 上公布的 ONNX FP16 结果都慢于 TensorRT FP16;不同模型尺寸的计算所得中位数加速比为 1.85x 至 2.55x,mAP50-95 的差异最多为 0.001。基准测试没有说明 ONNX 结果使用了哪个 ONNX Runtime 执行提供程序,也没有任何结果标注为使用其 TensorRT 执行提供程序;如果你需要使用 ONNX Runtime 的 API,请自行测试这种组合。
可以。ONNX 通常是 TensorRT 的输入:TensorRT 的 ONNX 解析器会读取模型并据此构建引擎。ONNX Runtime 也可以通过其 TensorRT 执行提供程序调用 TensorRT。
不能。在 Ultralytics Platform 基准测试中,19 款 GPU 有 17 款在运行 YOLO26n 时,TensorRT INT8 的速度慢于 TensorRT FP16。在较大的模型上,INT8 更常带来加速;在能够运行所有格式的 19 款 GPU 上,YOLO26m 和 YOLO26x 的中位数加速比约为 1.2x。但每次都会损失 0.034 至 0.076 mAP50-95,因此请先用自己的数据验证 INT8 模型。
不要指望可以。默认情况下,TensorRT 引擎与构建它时使用的 GPU 和 TensorRT 版本绑定,因此应在要部署的设备上或为该设备构建引擎。请保留 ONNX 文件作为可移植副本,并为每个目标设备重新构建引擎。
通常选择 TensorRT:NVIDIA JetPack 内置 TensorRT;在 Jetson 本机上构建引擎可以针对该设备进行优化。上面的基准测试不包括 Jetson,因此请先在自己的模块上测量,再做决定。NVIDIA Jetson 指南介绍了 Ultralytics YOLO 的设置和导出步骤。
作者
评论
提出问题、分享你的结果,或帮助其他人。









