Qwen4-Max 自动标注:部分数据集表现突出,提升不均衡
Qwen4-Max 在我们的自动标注基准测试中位列 51 个模型中的第 13 名,在腕部 X 光片上排名第一,在零售货架场景中排名第二。准确率、成本以及运行方法。
 Miles Deans10 分钟阅读
阿里巴巴于 2026 年 11 月 16 日发布 Qwen4-Max,称其为迄今为止 Qwen 系列中能力最强的模型,支持原生视觉,并具有一百万 token 的上下文窗口。当天,我们就用 UL37——我们的 36 个数据集目标检测基准测试对它进行了测试。
总体而言,Qwen4-Max 在我们的 VLM 排行榜中位列 51 个模型中的第 13 名,mAP50 为 0.474,每 1,000 张图像的成本为 5.68 美元。这个平均分掩盖了更突出的表现。在儿童腕部 X 光片上,它的得分超过我们测试过的所有模型;在水下场景和货架商品密集排列的零售场景中,它仅次于 Gemini 4 Carbon。
Qwen4-Max 现已成为 Ultralytics Platform 中用于自动标注的阿里巴巴模型,取代了 Qwen3.8-Max。下文将介绍它的优势和不足、与其他备选模型的比较,以及一批标注任务的成本。
Qwen4-Max 在 UL37 上位列 51 个模型中的第 13 名,在腕部 X 光片上排名第一#
UL37 衡量模型预测框与人工标注的匹配程度,测试集包含 360 张图像,来自 36 个真实的目标检测数据集,每个数据集各取 10 张,涵盖医学扫描、航拍图像、零售货架、体育和电路板等场景。每个数据集在平均分中的权重相同。每张图像都经过 Platform 用户使用的同一套生产流程:使用数据集自己的类别名称,并通过 SAM 3.1 优化每个预测框。因此,这些分数反映的是优化后的流程,而不是模型的原始输出。评测方法已公开。
| Qwen4-Max | Qwen3.8-Max | GPT-6.1 Terra | Gemini 3.8 Flash | Kimi K3.1 Pro | |
|---|---|---|---|---|---|
| 排行榜排名 | #51 个模型中的第 13 名 | #51 个模型中的第 15 名 | #51 个模型中的第 3 名 | #51 个模型中的第 11 名 | #51 个模型中的第 16 名 |
| mAP50 | 0.474 | 0.461 | 0.560 | 0.516 | 0.444 |
| mAP50-95 | 0.301 | 0.295 | 0.345 | 0.321 | 0.281 |
| 精确率 | 0.595 | 0.572 | 0.646 | 0.656 | 0.560 |
| 召回率 | 0.561 | 0.524 | 0.613 | 0.555 | 0.483 |
| 提供商每 1,000 张图像的费用 | $5.68 | $7.74 | $4.36 | $5.86 | $22.50 |
| 每张图像的中位耗时 | 12.4 s | 13.1 s | 5.1 s | 7.4 s | 22.2 s |
| 请求失败数 | 0% | 1.7% | 0% | 0% | 6.4% |
Ultralytics VLM 排行榜的 UL37 结果,更新于 2026 年 11 月 19 日。Platform 已不再提供 Qwen3.8-Max。
Qwen4-Max 的所有主要指标都优于 Qwen3.8-Max,每张图像成本更低,并且完成了所有基准测试请求。但它的平均表现仍远逊于领先模型:GPT-6.1 Terra 的得分为 0.560,价格更低,耗时不到一半。
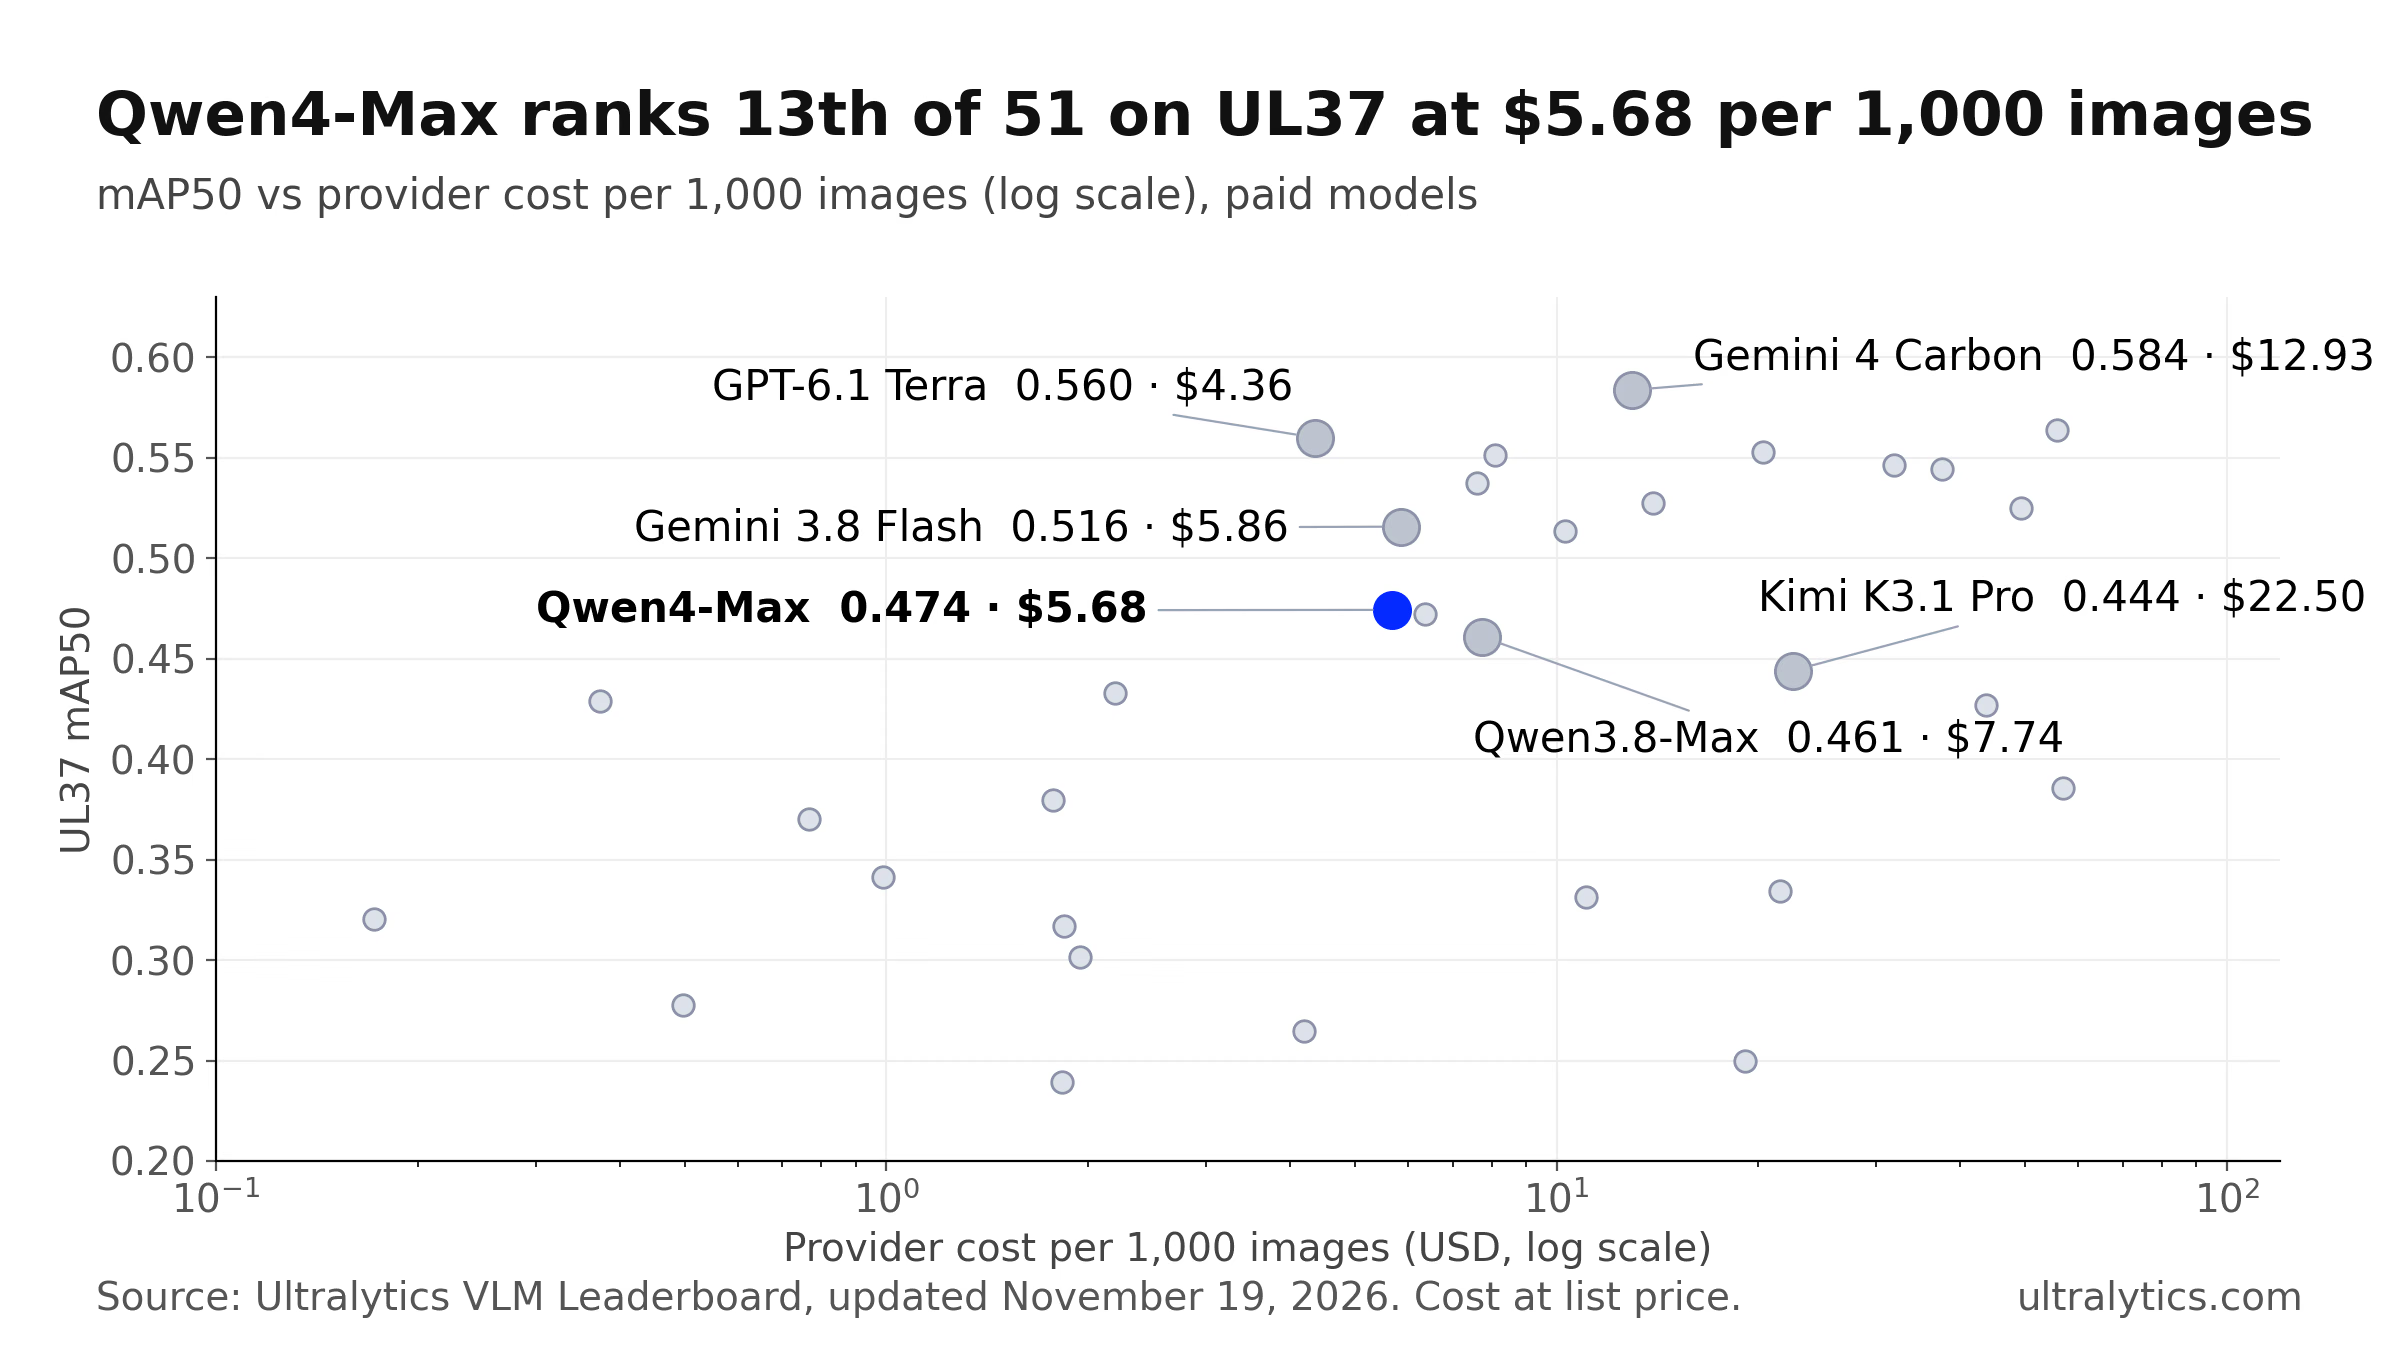
每个点代表 Ultralytics VLM 排行榜上的一个付费模型。
阿里巴巴打造 Qwen4-Max 的目标#
在发布公告中,阿里巴巴将 Qwen4-Max 描述为一种稀疏混合专家模型,总参数量为 2.4 万亿,每个 token 激活 710 亿个参数,并支持原生视觉。公告强调了它在编码、智能体任务和视觉推理方面的能力,并报告称,在阿里巴巴自有的 Work360 基准测试中,Qwen4-Max 的表现优于 Qwen3.8-Max,同时将每项任务的平均成本降低了约 60%。
阿里云的 Model Studio 发布说明将其称为“Qwen 系列的下一代旗舰多模态模型,融合了文本生成、图像与视频理解以及深度推理能力”。其国际版价格为每百万输入 token 1.50 美元、每百万输出 token 4.50 美元,低于 Qwen3.8-Max 的 2 美元和 6 美元。该模型可通过阿里巴巴的 API 使用;阿里巴巴表示,后续还将推出更小的开放权重 Qwen4 模型。
发布公告和发布说明都没有提供目标检测结果,因此我们对其进行了测量。
Qwen4-Max 与 Qwen3.8-Max 对比:成本更低,提升不均衡#
Qwen4-Max 在 19 个数据集上胜过前代模型,在 16 个数据集上落后,在 1 个数据集上打平。其 mAP50 平均提升 0.013,来自部分数据集的大幅进步,这些进步超过了其他数据集上的明显退步。
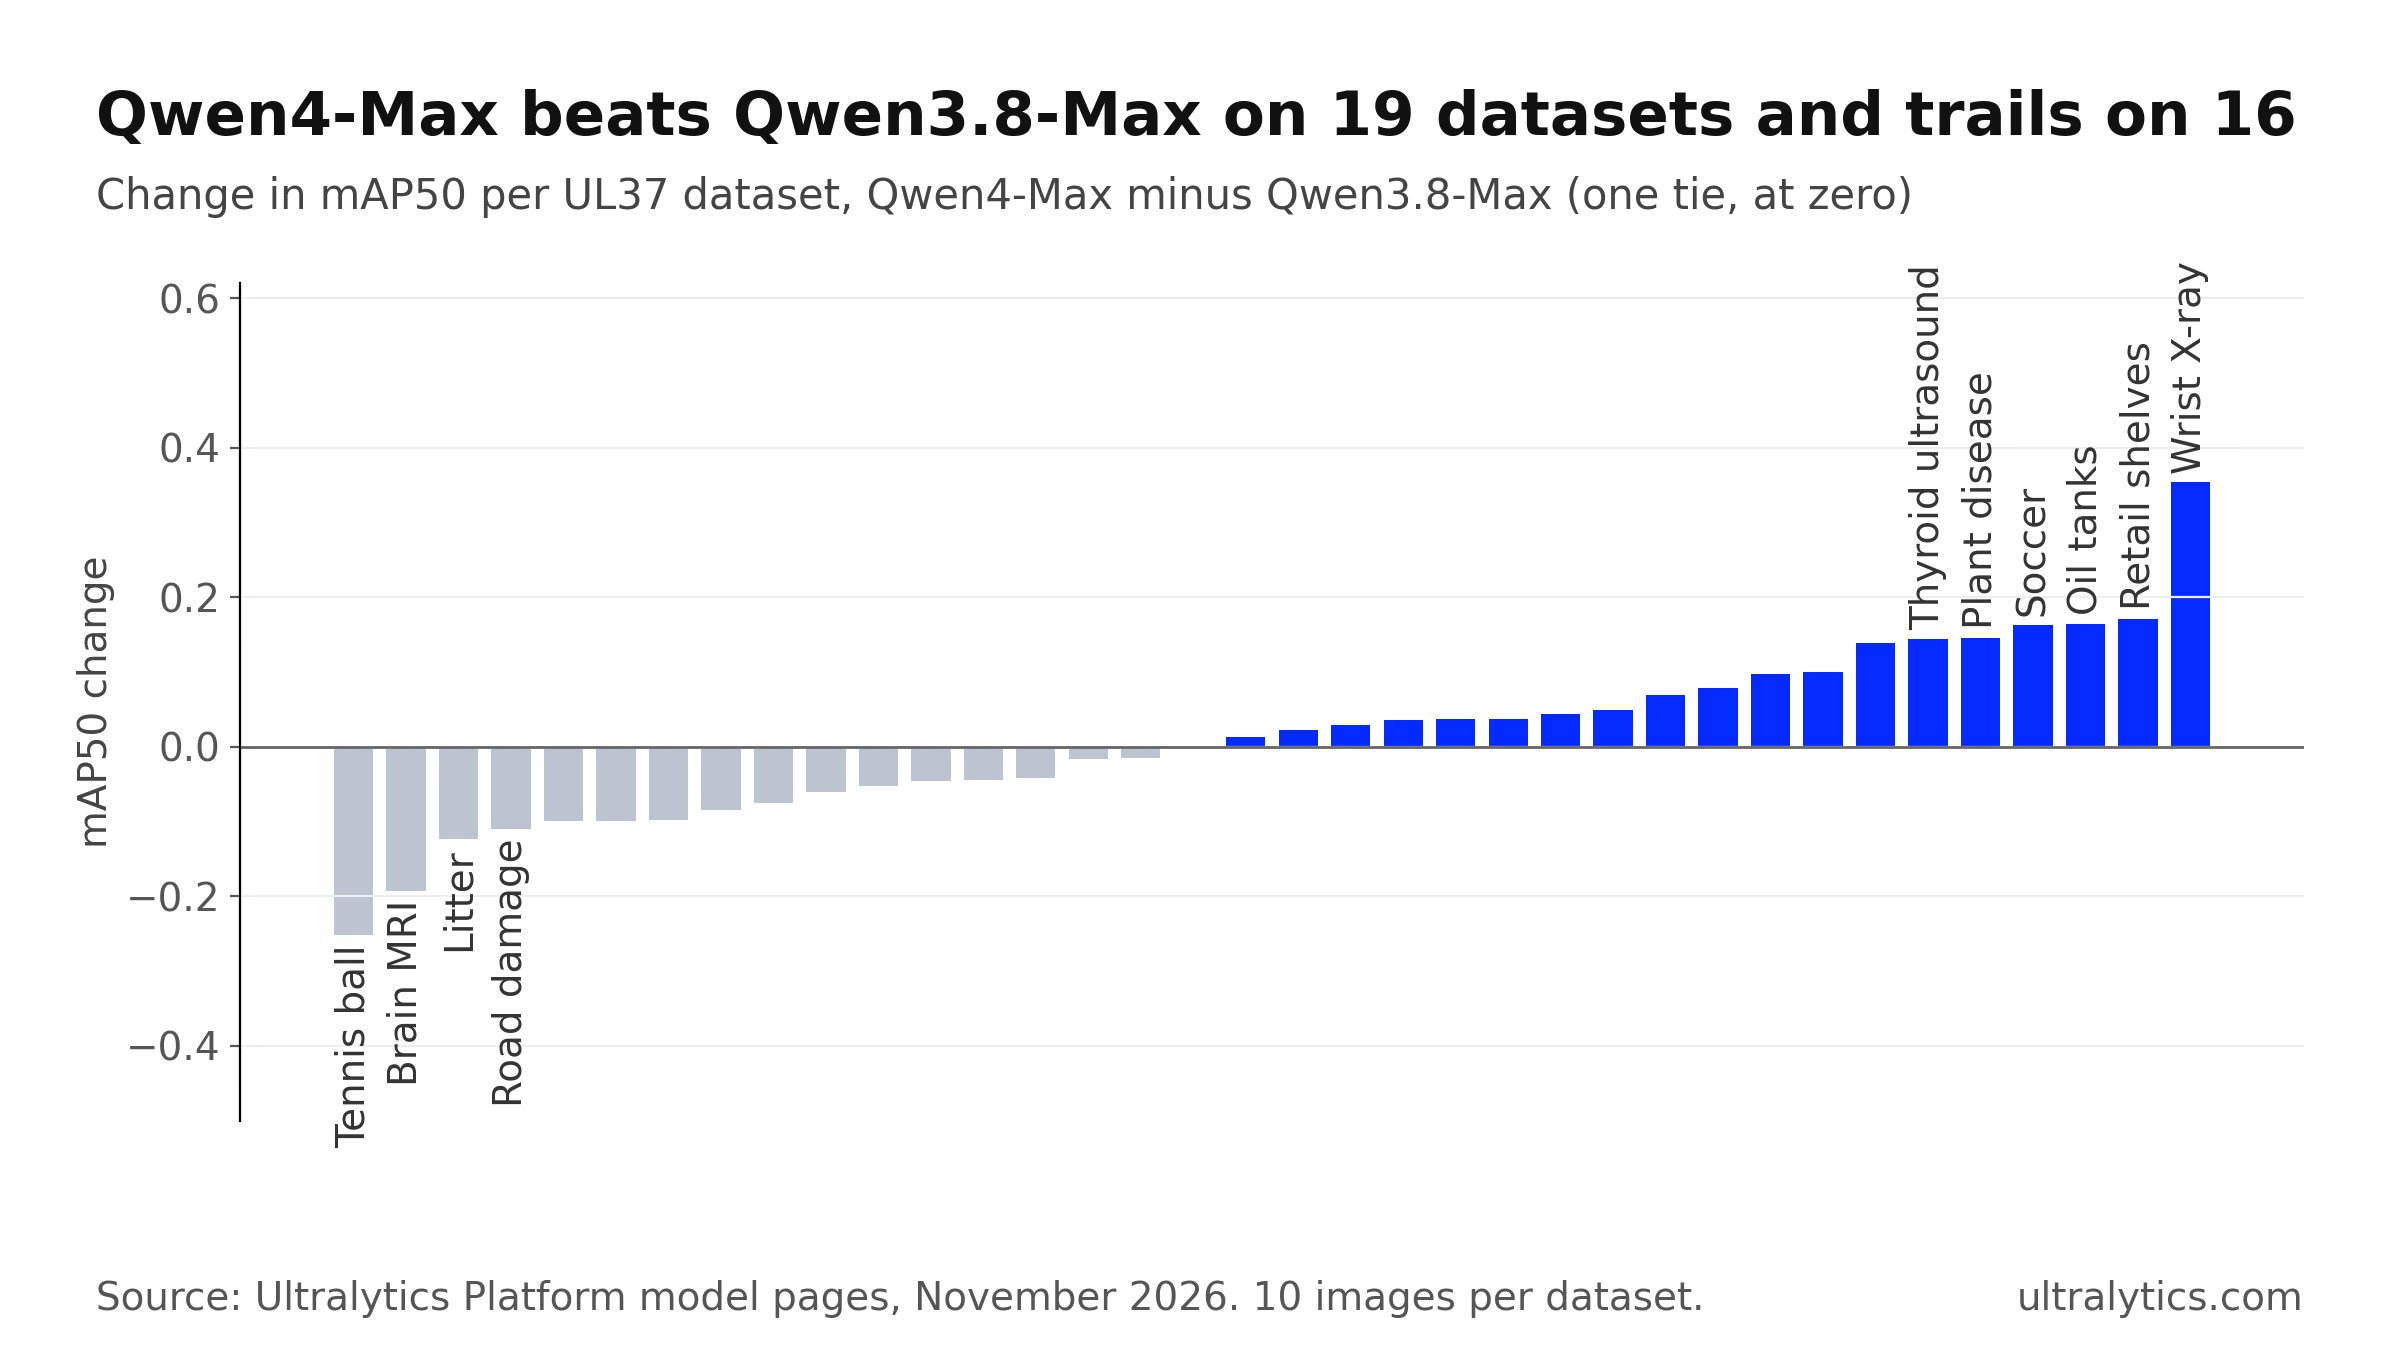
每根柱代表一个 UL37 数据集,按从最大跌幅到最大涨幅排序。
| 数据集 | Qwen4-Max | Qwen3.8-Max | 变化 |
|---|---|---|---|
| GRAZPEDWRI-DX 儿童腕部 X 光片 | 0.4975 | 0.1437 | +0.3538 |
| SKU110K 密集的零售货架 | 0.6230 | 0.4516 | +0.1714 |
| Airbus 石油储罐 | 0.3005 | 0.1363 | +0.1642 |
| SoccerDB 足球 | 0.8345 | 0.6715 | +0.1630 |
| RacketVision 网球 | 0.3775 | 0.6299 | −0.2524 |
| Cheng 脑肿瘤 MRI | 0.4421 | 0.6350 | −0.1929 |
UL37 各数据集的 mAP50,每个数据集 10 张图像,显示到小数点后四位,因此每项变化都与对应的两个分数一致。
成本下降更为明显。在我们的测试中,Qwen4-Max 每 1,000 张图像的成本为 5.68 美元,而 Qwen3.8-Max 为 7.74 美元,因此每张图像的成本约低 27%。阿里巴巴公布的约 60% 降幅来自不同基准测试和不同设置,因此两者不能直接比较。
Qwen4-Max 的突出表现#
有三项结果让 Qwen4-Max 跻身整个排行榜的前列,而不只是 Qwen 系列中的佼佼者。
| 数据集 | Qwen4-Max | 在 51 个模型中的排名 | 领先模型 |
|---|---|---|---|
| GRAZPEDWRI-DX 儿童腕部 X 光片 | 0.4975 | 1st | Qwen4-Max(下一名:Muse Ember 1.0,0.378) |
| RUOD 水下物体 | 0.774 | 2nd | Gemini 4 Carbon,0.788 |
| SKU110K 密集的零售货架 | 0.623 | 2nd | Gemini 4 Carbon,0.671 |
UL37 各数据集的 mAP50。在 Ultralytics VLM 排行榜的全部 51 个模型中的排名。
腕部 X 光片。在儿童腕部创伤 X 光片上,Qwen4-Max 得分为 0.4975,超过我们测试过的所有其他模型,是 Qwen3.8-Max 的三倍多。每个数据集只贡献 10 张图像,因此应将其视为值得测试的有力信号,而非最终结论。这也不代表诊断或临床验证:在医学图像分析研究标注中,Qwen4-Max 可生成初步预测框,供临床专家检查和修正。
零售货架。在 UL37 的两个零售数据集上取平均后,Qwen4-Max 得分为 0.752,高于 GPT-6.1 Terra 的 0.724。在 SKU110K 上,货架上商品密集排列且全部属于同一类别,Qwen4-Max 仅次于 Gemini 4 Carbon。
水下场景。在 RUOD 水下物体数据集上,Qwen4-Max 得分为 0.774,在 51 个模型中排名第二,高于 GPT-6.1 Terra 的 0.658。
Qwen4-Max 的不足之处#
它的短板和优势一样明显。在 DeepPCB 裸板缺陷数据集上,Qwen4-Max 得分为 0.000;在 IEDXray 安检扫描数据集上,得分为 0.05,而 Gemini 4 系列模型约为 0.30。结核病胸部 X 光片上的得分为 0.037;在脑肿瘤 MRI 数据集上,它也落后于 GPT-6.1 Terra,得分分别为 0.442 和 0.904。
按领域取平均后,Qwen4-Max 在文档、UI 和 CAD 图纸(0.357 对 0.494)、道路和交通(0.396 对 0.572)以及整体医学影像(0.325 对 0.505)方面也落后于 GPT-6.1 Terra。在这些领域中的任何一个进行大规模标注之前,请先打开 Qwen4-Max 模型页面,查看页面如何在每个基准数据集上回放其已记录的预测框,并与预期标签并排对照。
Qwen4-Max 与 GPT-6.1 Terra、Gemini 3.8 Flash 和 Kimi K3.1 Pro 对比#
| 正面对比:36 个 UL37 数据集 | Qwen4-Max 胜出 | 落败 | 打平 |
|---|---|---|---|
| 对比 GPT-6.1 Terra | 11 | 23 | 2 |
| 对比 Gemini 3.8 Flash | 17 | 18 | 1 |
| 对比 Kimi K3.1 Pro | 21 | 14 | 1 |
| 对比 Qwen3.8-Max | 19 | 16 | 1 |
GPT-6.1 Terra 是综合表现更强的选择:它在 23 个数据集上胜过 Qwen4-Max,后者胜出 11 个;GPT-6.1 Terra 成本更低,中位响应时间也不到其一半。Gemini 3.8 Flash 在数据集上的表现与 Qwen4-Max 几乎不相上下,价格相近,但平均分更高。与 Kimi K3.1 Pro 相比,Qwen4-Max 以约四分之一的单张图像成本在 21 个数据集上胜出,Kimi K3.1 Pro 则胜出 14 个。
Ultralytics Platform 如何运行 Qwen4-Max#
有两项设置会影响 Qwen4-Max 在 Platform 中的结果。首先,它采用阿里巴巴的“low”推理强度,而非默认的“high”。Ultralytics 在 370 张基准图像(360 张计分图像加 10 张 COCO 参考图像)上测试发现,默认设置有 11 个请求超出 Platform 的 115 秒请求时限,而“low”设置有 3 个超时,两种设置的 mAP50 相同。其次,Platform 要求 Qwen 模型输出紧凑的 JSON,因为不这样做会导致 mAP50 下降约 0.02。
你无需采取任何操作来应用这两项设置:只需在模型选择器中选择 Qwen4-Max,Platform 就会自动应用这两项设置。
Qwen4-Max 标注一批图像的成本#
服务商成本根据阿里巴巴报告的 token 用量,按 Platform 为该模型设定的价格计算,以每 1,000 张成功完成标注的图像为单位;你自己的图像可能会使用更多或更少的 token。Batch Annotation 另收 Platform 处理费,每 1,000 张图像 1.00 美元,每次运行最低收费 0.01 美元。
| 每 1,000 张图像 | Qwen4-Max |
|---|---|
| 阿里巴巴收费 | $5.68 |
| Ultralytics Platform 处理费 | $1.00 |
| 总计 | $6.68 |
你通过自己的 API 密钥直接向阿里巴巴付费,包括你先行运行的测试预测;Ultralytics 不会对 token 收取加价。如果你完全不想使用付费密钥,可以在 Platform 上使用托管版 Qwen3.8 27B,无需密钥,其 UL37 mAP50 为 0.351。
如何在 Ultralytics Platform 中运行 Qwen4-Max 自动标注#
Qwen4-Max 是一款基于类别提示的模型,适用于包含 1 到 200 个类别的检测数据集。它会根据你数据集自身的类别名称返回边界框,然后由你检查并修正。
- 在阿里云 Model Studio 中为国际(新加坡)区域创建 API 密钥;Platform 使用的就是该区域的端点。
- 请让工作区所有者在存放你数据集的工作区中,前往 Settings > API Keys,并在 Alibaba 下添加该密钥。服务商密钥文档介绍了具体细节。
- 在标注编辑器中切换到 Smart 模式,然后在模型选择器的 Alibaba 下选择 Qwen4-Max。
- 在几张能代表你数据的图像上点击 Predict,或运行
P。 - 满意后,打开数据集页面并选择 更多操作 > 批量标注,为所有未标注图像添加标签。Batch Annotation 支持托管在 Platform 上且最多包含三个图像通道的数据集;Platform 会先保存一个数据集版本,方便你回滚。
- 检查边界框并保存,然后在同一工作区中基于结果训练 Ultralytics YOLO26 模型。
标注文档详细介绍了 Smart 模式和 Batch Annotation;我们的如何根据精确率和召回率选择 VLM 指南则能帮助你为审核工作流选对模型。
哪些人适合使用 Qwen4-Max#
| 如果你需要…… | 从这里开始 |
|---|---|
| 通用付费标注模型 | GPT-6.1 Terra:UL37 得分更高、成本更低、速度也快于 Qwen4-Max |
| 用于专家审核的儿童腕部 X 光片初步标注 | Qwen4-Max:在该数据集的 51 个模型中,UL37 得分最高 |
| 密集的零售货架或水下场景 | Qwen4-Max,并在你自己的图像上与 Gemini 4 Carbon 比较 |
| 阿里巴巴模型,或从 Qwen3.8-Max 迁移 | Qwen4-Max:得分更高、单张图像成本更低,并且我们的测试中没有请求失败 |
| 没有付费 API 密钥 | 在 Platform 中使用托管版 Qwen3.8 27B、Gemma 4 26B 或 SAM 3.1 Text |
对于大多数标注任务,GPT-6.1 Terra 仍是更好的默认选择。如果你的数据与 Qwen4-Max 表现突出的数据集相似,它就值得一试;因此请先用你自己的一小批图像进行测试。
常见问题
它在我们的基准测试中位列 51 个模型中的第 13 名,并在少数场景中表现突出。在 UL37 基准测试中,它的 mAP50 为 0.474,在 51 个模型中排名第 13,且没有请求失败。它在儿童腕部 X 光片上排名第一,在水下物体和密集零售货架场景中排名第二,但在电路板缺陷和安检 X 光片上的得分较低。
平均来看,是的。Qwen4-Max 的 mAP50 为 0.474,高于 Qwen3.8-Max 的 0.461;每 1,000 张图像的成本为 5.68 美元,低于后者的 7.74 美元;此外,Qwen3.8-Max 有 1.7% 的请求失败,而 Qwen4-Max 完成了所有请求。提升并不均衡:它在 19 个数据集上胜过 Qwen3.8-Max,在 16 个数据集上落后;在网球检测和脑部 MRI 检测上则出现了大幅退步。
对于通用标注,GPT-6.1 Terra 的得分为 0.560 mAP50,在与 Qwen4-Max 对比的 36 个数据集中赢得 23 个,处理每 1,000 张图像的费用为 4.36 美元,中位响应时间为 5.1 秒。如果你的数据与 Qwen4-Max 表现最好的数据集相似,例如手腕 X 光片、商品密集的零售货架或水下场景,可以选择 Qwen4-Max,并用你自己的图像进行验证。
它可以为研究标注生成待专家审核的框,但不能用于诊断。在儿童手腕 X 光片上,它的 UL37 得分在 51 个模型中最高,为 0.4975 mAP50;但在我们的 8 个医学数据集上,平均得分为 0.325,低于 GPT-6.1 Terra 的 0.505,而且在胸部 X 光片上的得分很低。
阿里巴巴收取的费用约为 5.68 美元:按每 1,000 张成功完成标注的图像计算,使用阿里巴巴报告的 token 用量,并按该模型在 Platform 的价格计费。阿里巴巴的国际标价为每百万输入 token 1.50 美元、每百万输出 token 4.50 美元。Ultralytics Platform 另收取每 1,000 张图像 1.00 美元的 Batch Annotation 费用,总计约 6.68 美元。
创建一个阿里巴巴云 Model Studio 国际版 API 密钥,让工作区所有者在 Settings > API Keys 的 Alibaba 项下添加该密钥,然后在标注编辑器的 Smart 模式中选择 Qwen4-Max。先测试几张图像,再运行 Batch Annotation、审核边界框,并在同一工作区中训练 Ultralytics YOLO26 模型。
作者
评论
提出问题、分享你的结果,或帮助其他人。









