5 Gründe, warum Computer-Vision-Modelle in der Produktion versagen
Erfahre, warum Computer-Vision-Modelle in der Produktion versagen – von Datenabweichungen bis hin zu Latenz – und wie Teams die Modellleistung in realen Vision-KI-Systemen verbessern können.
 Abirami Vina8 Min. Lesezeit
Computer Vision ist inzwischen eine wichtige Technologie der künstlichen Intelligenz, die in den meisten Branchen zum Einsatz kommt. Sie ermöglicht es Maschinen, visuelle Daten für vielfältige Aufgaben zu interpretieren und zu analysieren. Diese Systeme unterstützen zahlreiche Anwendungen in der Praxis, von medizinischer Bildgebung und Robotik bis hin zu Fertigung und Einzelhandelsautomatisierung.
Ein Computer-Vision-System zu entwickeln, ist jedoch nicht immer einfach. Dazu gehört in der Regel die Entwicklung eines Vision-KI-Modells, das darauf trainiert wird, Muster in Bildern und Videos zu erkennen, um Aufgaben wie Objekterkennung und -verfolgung zu unterstützen.
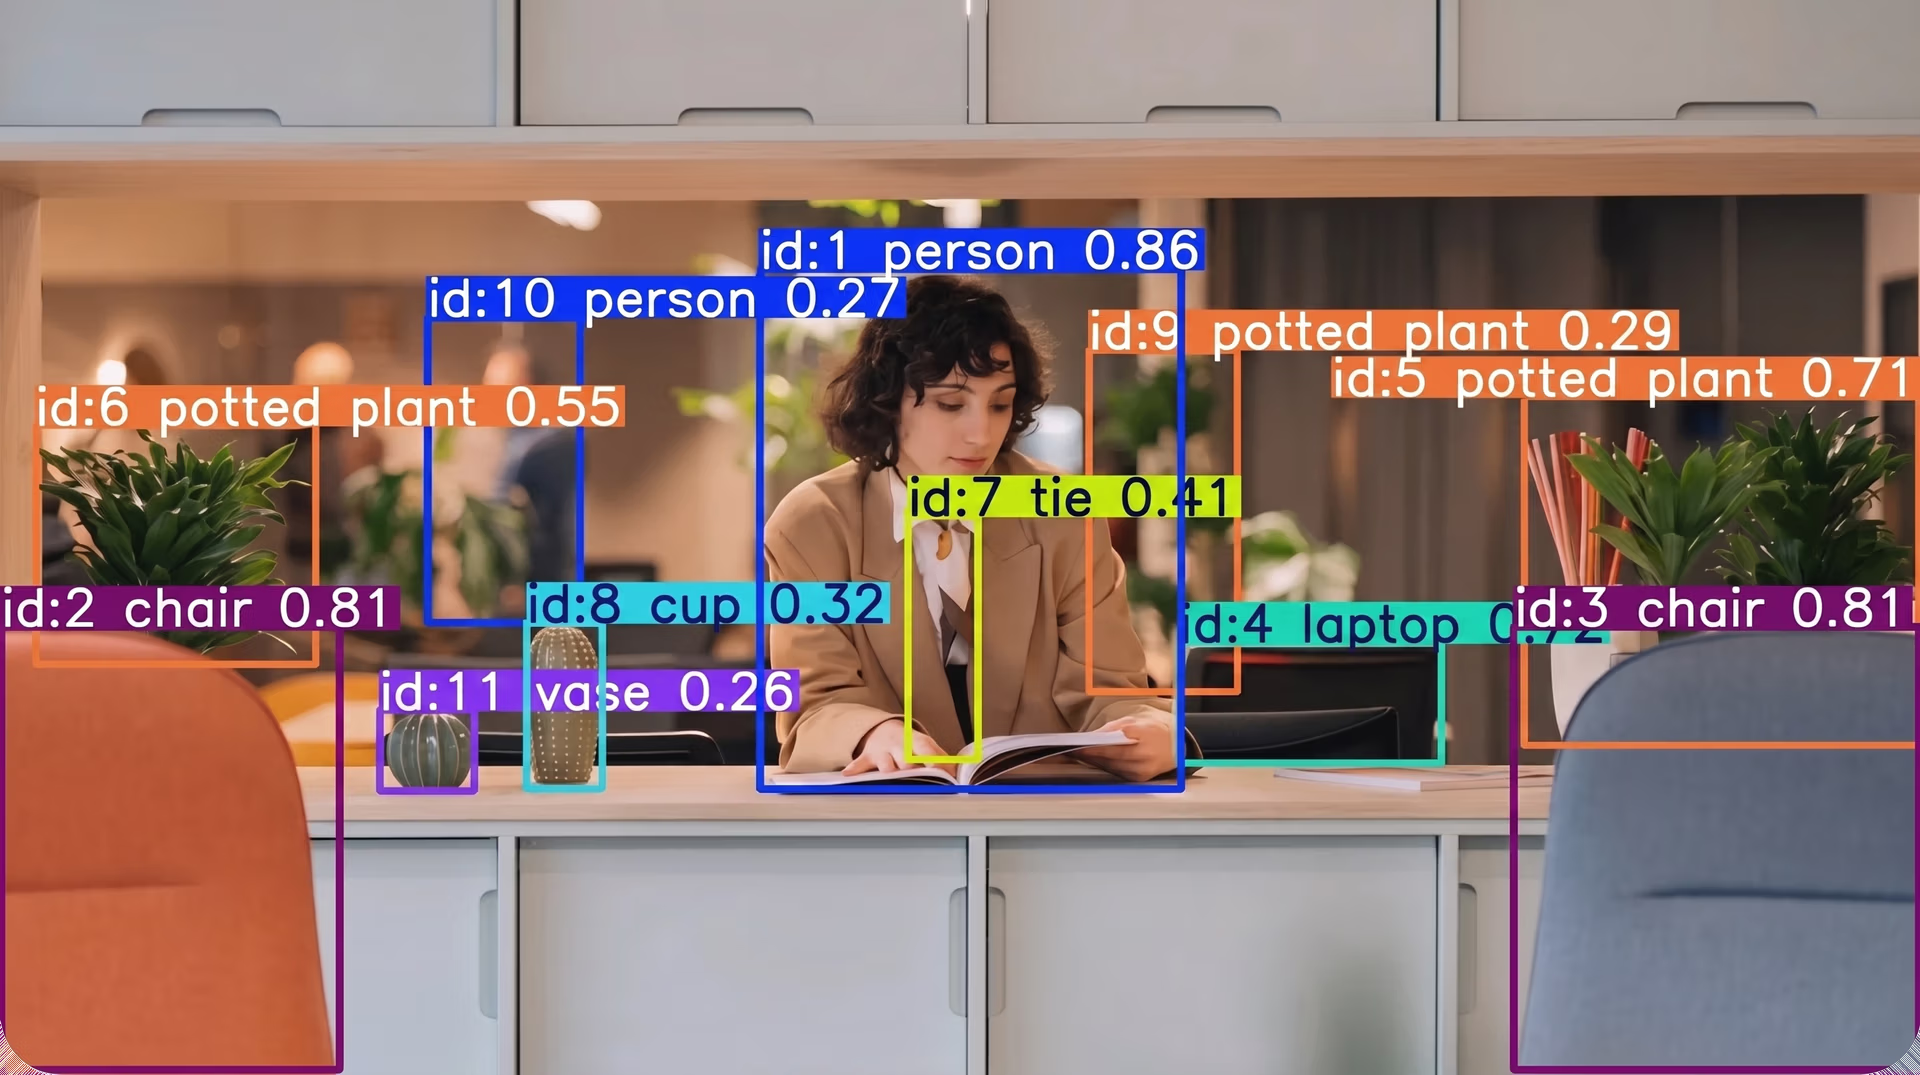
Abb. 1: Beispiel für Objekterkennung und -verfolgung (Quelle)
Obwohl Computer-Vision-Modelle im Laufe der Jahre immer leistungsfähiger geworden sind, können sie sich während der Entwicklung anders verhalten als nach der Bereitstellung in realen Umgebungen. Denn der Einsatz von Modellen außerhalb kontrollierter Entwicklungsumgebungen bringt neue und oft unerwartete Herausforderungen mit sich.
Faktoren wie mangelnde Vielfalt in Datensätzen, unzureichende Modellüberwachung und Infrastrukturbeschränkungen können dazu führen, dass sich dasselbe Modell nach der Bereitstellung in der Praxis anders verhält.
In diesem Artikel stellen wir fünf häufige Gründe vor, warum Computer-Vision-Modelle in der Produktion möglicherweise nicht die erwartete Leistung erbringen.
Die Lücke zwischen Modelltraining und Produktivbetrieb#
Modelltraining findet in der Regel in einer kontrollierten Umgebung statt. In dieser Phase arbeiten KI-Entwickler mit sorgfältig vorbereiteten Trainingsdatensätzen.
Diese umfangreichen Sammlungen visueller Daten enthalten gut strukturierte Annotationen oder Labels, die den Inhalt jedes Bildes beschreiben. Auch das Training findet unter gleichbleibenden Bedingungen statt, sodass Vision-KI-Modelle visuelle Muster effektiv erlernen können.
Um sicherzustellen, dass diese Muster korrekt erlernt werden, lassen sich Modelle während der Entwicklung systematisch anhand standardisierter Bewertungsmetriken und Benchmark-Datensätze evaluieren. Wie die Trainingsdatensätze werden auch diese Benchmark-Datensätze sorgfältig vorbereitet.
Die Daten, auf die Computer-Vision-Systeme in der Praxis treffen, können sich jedoch stark von den Daten unterscheiden, die beim Training und bei der Evaluierung verwendet wurden. Nach der Bereitstellung arbeiten diese Modelle nur selten unter kontrollierten Bedingungen.
Sie können Bilder und Videos aus unvorhersehbaren Umgebungen verarbeiten müssen, in denen sich die Beleuchtung ständig ändert, Kamerawinkel variieren und Hintergründe sich im Laufe der Zeit verändern. Ein für die Verkehrserkennung trainiertes Vision-KI-Modell kann beispielsweise nachts Schwierigkeiten haben, Fahrzeuge zu erkennen, wenn es hauptsächlich mit Tageslichtaufnahmen trainiert und evaluiert wurde.
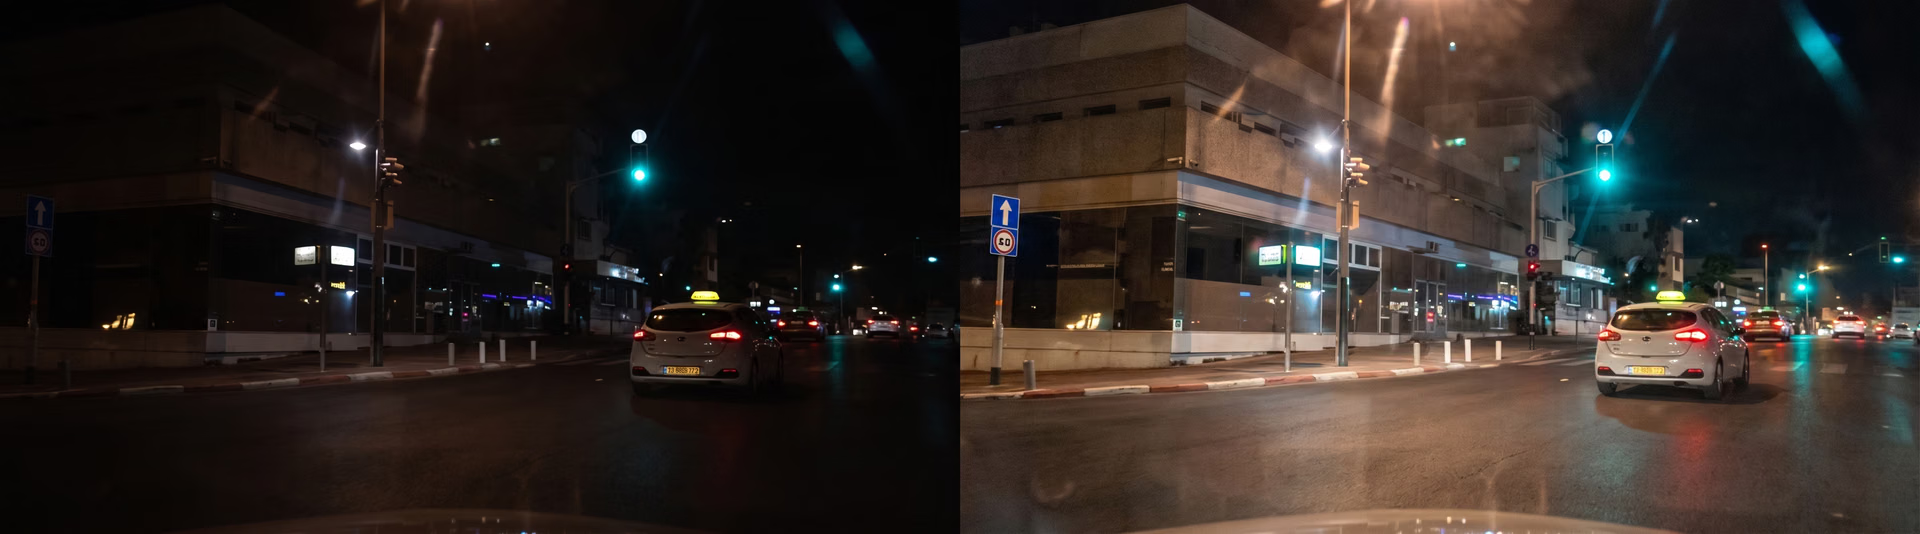
Abb. 2: Auch nach einer Bildverbesserung lassen sich Nachtaufnahmen von Modellen, die mit Tageslichtbildern trainiert wurden, nur schwer interpretieren. (Quelle)
Dieser Unterschied zwischen Entwicklung und Einsatz in der Praxis wird als Lücke zwischen Training und Produktion bezeichnet. Aufgrund dieser Lücke werden viele Modellfehler erst nach der Bereitstellung sichtbar. Deshalb ist es entscheidend, den Weg vom Labor in die Produktion frühzeitig zu verstehen, um zuverlässigere und robustere Computer-Vision-Systeme zu entwickeln.
5 häufige Gründe für das Versagen von Computer-Vision-Modellen im Produktivbetrieb#
Sehen wir uns nun fünf häufige Gründe genauer an, warum Computer-Vision-Modelle im Produktivbetrieb versagen.
1. Trainingsdatensätze von geringer Qualität#
Datensätze spielen beim Training von Computer-Vision-Modellen eine zentrale Rolle, da sie bestimmen, was das Modell während des Trainings lernt und wie es nach der Bereitstellung auf Eingaben aus der Praxis reagiert. Besonders wichtig ist dies beim überwachten Lernen, bei dem Modelle anhand gekennzeichneter Beispiele lernen, was auf den einzelnen Bildern zu sehen ist.
Viele Deep-Learning-Modelle, darunter konvolutionale neuronale Netze (CNNs), sind auf diese gekennzeichneten Beispiele angewiesen, um Muster in visuellen Daten zu erkennen. Wenn der Trainingsdatensatz jedoch nicht die Bedingungen in der Praxis widerspiegelt, kann das Modell Muster erlernen, die nicht vollständig abbilden, wie Objekte außerhalb der Trainingsdaten aussehen.
Ein Modell, das beispielsweise mit einem Datensatz großer Rissschäden trainiert wurde, erkennt möglicherweise einen seltenen Typ kleiner Risse in realen Fertigungsabläufen nicht. Auch die Qualität der Annotationen kann das Modellverhalten beeinflussen. Uneinheitliche Labels oder fehlende Details in gekennzeichneten Daten können dazu führen, dass das Modell während des Trainings falsche Informationen erlernt.
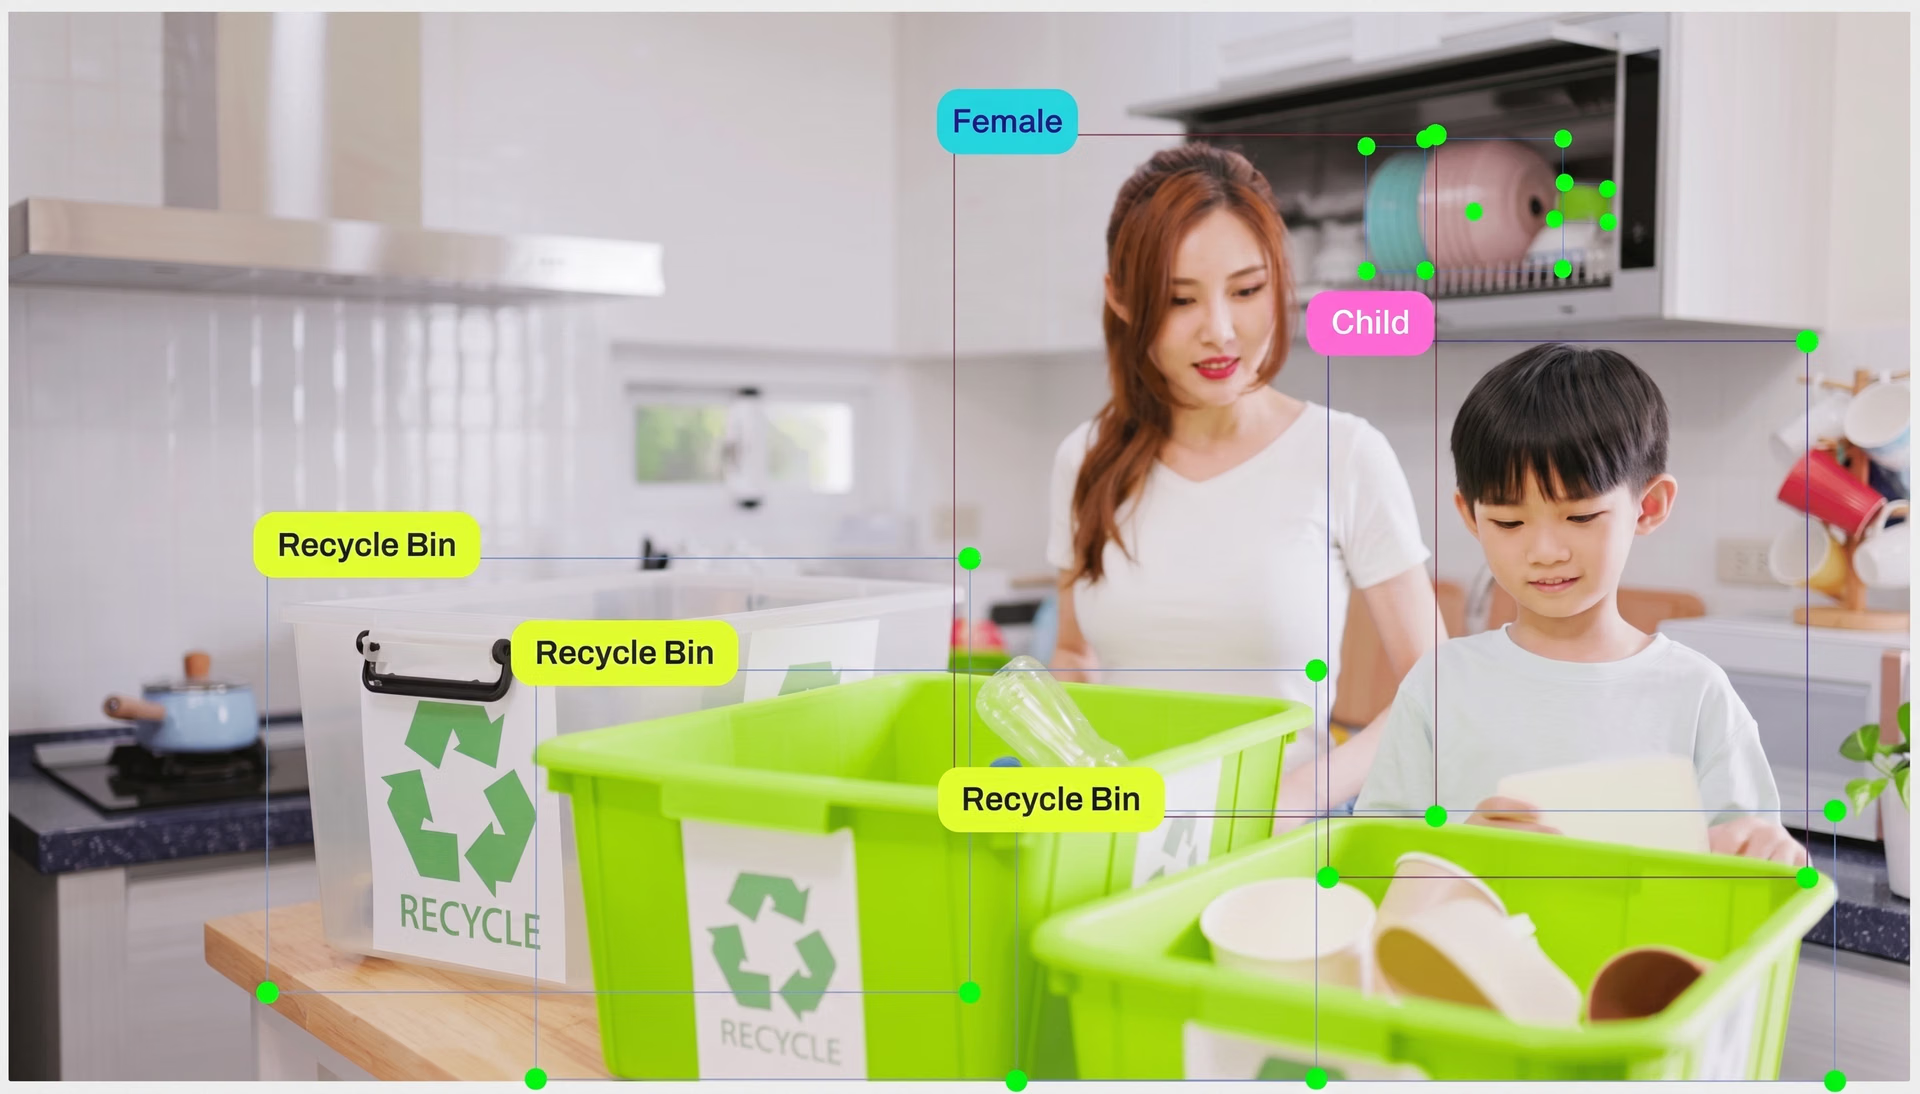
Abb. 3: Einblick in Bildannotationen (Quelle)
Insgesamt sind Qualität und Vielfalt der Trainingsdaten entscheidend und können bestimmen, wie gut ein Modell in realen Anwendungen funktioniert. Sind Datensätze repräsentativ und präzise annotiert, arbeitet ein Modell nach der Bereitstellung in der Regel zuverlässiger.
2. Überanpassung und Generalisierung#
Modelle des maschinellen Lernens, etwa Vision-Modelle, lernen Muster aus Trainingsdatensätzen. Manchmal stützt sich ein Modell jedoch zu stark auf wenige Muster.
Anstatt umfassendere visuelle Zusammenhänge zu erlernen, kann es die begrenzten Muster aus den Trainingsdaten auswendig lernen. Dieses Verhalten wird als Überanpassung bezeichnet.
Überanpassung tritt meist auf, wenn Trainingsdatensätze klein sind oder nicht genügend Datenvielfalt bieten. In solchen Fällen erkennt das Modell Bilder, die es bereits gesehen hat, zuverlässig, hat jedoch Schwierigkeiten, neue Daten oder unbekannte Eingaben zu interpretieren.
Deshalb kann ein Modell bei Testdaten gute Ergebnisse erzielen, weil diese den Trainingsdaten ähneln, sich nach der Bereitstellung unter neuen Bedingungen jedoch anders verhalten. Daher ist die Generalisierung so wichtig. Einfach gesagt beschreibt sie, wie gut ein Modell das während des Trainings Gelernte auf neue Szenarien übertragen kann.
Um Overfitting zu verringern, trainieren Fachleute Modelle häufig mit vielfältigeren Datensätzen und setzen Datenaugmentation ein. Dabei werden Trainingsbilder leicht verändert, um für mehr Variation in den Daten zu sorgen. Werden diese Aspekte nicht berücksichtigt, kann die Modellleistung schnell abfallen, sobald das System in realen Umgebungen eingesetzt wird.
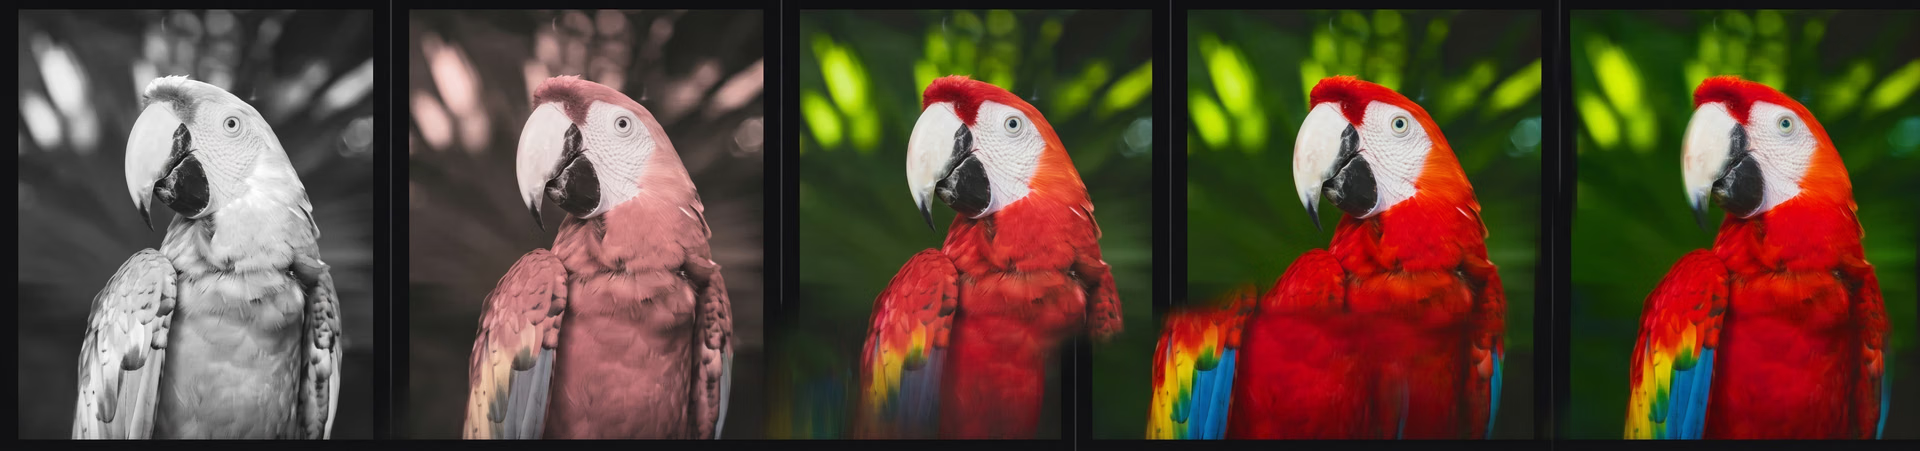
Abb. 4: Datenerweiterung kann Variationen desselben Bildes innerhalb eines Datensatzes erzeugen. (Quelle)
3. Verborgene Sonderfälle in realen Umgebungen#
Selbst wenn Computer-Vision-Modelle gut auf neue Daten generalisieren, können in realen Umgebungen unerwartete Sonderfälle auftreten. Dabei handelt es sich um ungewöhnliche Situationen, die von den typischen Mustern abweichen, die das Modell während des Trainings erlernt.
Viele dieser Szenarien lassen sich während der Entwicklung nur schwer erfassen, da sie selten auftreten, schwer nachzustellen oder als Trainingsdaten teuer zu sammeln sind. Objekte können beispielsweise ungewöhnliche Formen haben, sich unvorhersehbar bewegen oder teilweise von anderen Objekten verdeckt werden.
Auch Änderungen der Beleuchtung, der Kamerawinkel oder der Hintergrundbedingungen können Situationen schaffen, die das Erkennen erschweren. Solche Sonderfälle werden oft erst sichtbar, wenn das System in realen Anwendungen eingesetzt wird.
In der Robotik und der Fertigungsautomatisierung können Gegenstände beispielsweise anders abgelegt oder positioniert sein als erwartet. Dadurch entstehen Situationen, für die das Modell nicht ausgelegt wurde. Vorhersagen, die während des Testens zuverlässig wirkten, können inkonsistenter werden, sobald das System in realen Umgebungen arbeitet.
4. Mangelnde Überwachung und Fehlerbehebung nach der Bereitstellung#
Neben der Entwicklung eines Vision-KI-Modells ist es wichtig, seine Leistung zu überwachen und zu verbessern. Sobald ein System jedoch läuft, liegt der Fokus oft eher darauf, den Betrieb aufrechtzuerhalten, als seine Leistung im Zeitverlauf genau zu verfolgen. Dadurch können Änderungen im Modellverhalten unbemerkt bleiben.
Gleichzeitig können Faktoren wie Änderungen der eingehenden Daten, Kameraeinstellungen oder Einsatzumgebungen allmählich beeinflussen, wie präzise das Modell Objekte erkennt oder klassifiziert. Solche Veränderungen sind nicht immer offensichtlich und können im täglichen Betrieb unbemerkt bleiben.
Die Überwachung der Modellausgaben und des Systemverhaltens insgesamt kann Teams dabei helfen, solche Probleme früher zu erkennen. Regelmäßige Überprüfungen, Validierungsroutinen und Arbeitsabläufe zur Fehlerbehebung ermöglichen es Teams, ungewöhnliche Ergebnisse zu untersuchen und ihre möglichen Ursachen zu verstehen.
In Bereichen wie der Fertigung kann ein Modell Objekte auf einer Montagelinie plötzlich falsch identifizieren, nachdem die Kamerakonfiguration geändert wurde. Wenn du das Verhalten eines bereitgestellten Vision-KI-Systems im Blick behältst, kannst du leichter auf solche Änderungen reagieren und eine stabile Leistung in realen Umgebungen aufrechterhalten.
5. Infrastrukturbeschränkungen und Latenz#
Viele Computer-Vision-Systeme müssen in Echtzeit laufen, was Hardware, Netzwerke und Verarbeitungsketten erheblich belasten kann. Bei begrenzten Ressourcen können Verzögerungen bei der Berechnung oder Netzwerkverzögerungen auftreten. Dadurch treffen Vorhersagen zu spät ein und die Gesamtleistung des Systems leidet.
In manchen Fällen können fortgeschrittene Deep-Learning-Modelle auch infrastrukturelle Herausforderungen mit sich bringen. Transformer-basierte Architekturen sind beispielsweise darauf ausgelegt, große Mengen visueller Daten zu verarbeiten und komplexe Zusammenhänge innerhalb von Bildern zu erlernen. Dafür benötigen sie jedoch häufig erhebliche Rechenressourcen. Für ihren Einsatz kann daher leistungsfähigere oder teurere Hardware erforderlich sein.
Ohne geeignete Optimierung können selbst Modelle, die während des Testens schnell laufen, nach der Bereitstellung langsamer werden oder sich uneinheitlich verhalten. Um dem entgegenzuwirken, optimieren Teams häufig Verarbeitungsketten, verringern nach Möglichkeit die Modellkomplexität und stimmen Genauigkeit und Geschwindigkeit aufeinander ab.
Dazu können große Modelle in kleinere Versionen komprimiert, effizientere Architekturen verwendet oder Bilder mit geringerer Auflösung verarbeitet werden, damit das System auf der verfügbaren Hardware reibungslos läuft. In vielen Fällen entscheiden sich Teams auch für leichte und schnellere Modelle wie Ultralytics YOLO26, um die Einschränkungen bei der Bereitstellung zu erfüllen.
Bewährte Vorgehensweisen zur Vermeidung von Ausfällen bei Computer-Vision-Modellen#
Hier sind einige bewährte Vorgehensweisen, mit denen sich Ausfälle bei der Bereitstellung von Computer-Vision-Modellen im Produktivbetrieb verringern lassen:
- Setze stufenweise Bereitstellungsstrategien ein: Führe Modelle schrittweise im Produktivbetrieb ein, damit Teams ihr Verhalten beobachten und bei Bedarf Anpassungen vornehmen können.
- Baue Feedbackschleifen ein: Sammle neue Bilder und überprüfe falsche Vorhersagen, um Modelle mit aktualisierten Datensätzen erneut zu trainieren und die Leistung im Laufe der Zeit zu verbessern.
- Dokumentiere die Grenzen des Modells: Halte Situationen, in denen das Modell Schwierigkeiten haben könnte, klar fest, damit Teams mögliche Probleme bei der Bereitstellung vorhersehen können.
- Auf Schwankungen in der Praxis ausgelegt: Wenn du Variationen bei Beleuchtung, Kamerawinkeln, der Position von Objekten oder den Hintergrundbedingungen im Voraus einplanst, können Modelle in unterschiedlichen Einsatzszenarien stabil bleiben.
Die wichtigsten Erkenntnisse#
Computer-Vision-Modelle versagen selten, weil die Algorithmen selbst schwach sind. Meist liegt die eigentliche Herausforderung in den Umgebungen, in denen diese Systeme arbeiten. Modelle, die während des Trainings gut funktionieren, treffen oft auf unvorhersehbare Bedingungen in der Praxis, die ihr Verhalten beeinflussen können.
Deshalb reicht es nicht aus, einfach nur ein Modell zu trainieren, um zuverlässige Vision-KI-Systeme zu entwickeln. Dazu gehört auch, Datensätze sorgfältig vorzubereiten, die Modellleistung nach der Bereitstellung zu überwachen und Systeme kontinuierlich an reale Bedingungen anzupassen.
Möchtest du mehr über Vision-KI erfahren? Werde Teil unserer Community und lies über Anwendungen wie KI in der Automobilindustrie und Computer Vision in der Logistik. Informiere dich über unsere Lizenzoptionen, um mit Computer-Vision-Projekten loszulegen. Besuche unser GitHub-Repository, um mehr zu erfahren.
Verfasst von
Content Creator · Ultralytics
Kommentare
Stelle eine Frage, teile deine Ergebnisse oder hilf anderen.









